Не подавать холодным! Прогрев JVM перед запуском трафика
Всем привет! Меня зовут Александр, я бэкенд-инженер в Банки.ру.
Пару месяцев назад мы поймали проблему, которая жила у нас довольно долго и которую мы упорно списывали на случайность [1]. После каждой выкатки сервис первые несколько минут отвечал заметно медленнее обычного, а потом сам собой приходил в норму. Ушло около десяти релизов, прежде чем мы перестали считать это совпадением, и еще пара дней, чтобы найти настоящую причину. Ей оказался холодный старт JVM, а точнее то, что Kubernetes пускал на новые поды боевой трафик раньше, чем они были к нему готовы.
Дальше расскажу, что мы видели на графиках, какие версии проверили и отбросили, что происходит внутри JVM в первые минуты жизни процесса и как мы сделали так, чтобы прогрев оплачивали не пользователи.
Кстати, подписывайтесь на наш телегам‑канал по ссылке [2] или ищите: @bankirudev.
Тут на Хабре мы публикуем в основном лонгриды, а там — короткие посты про разработку, команду, мемы и всякое такое.
Что мы видели
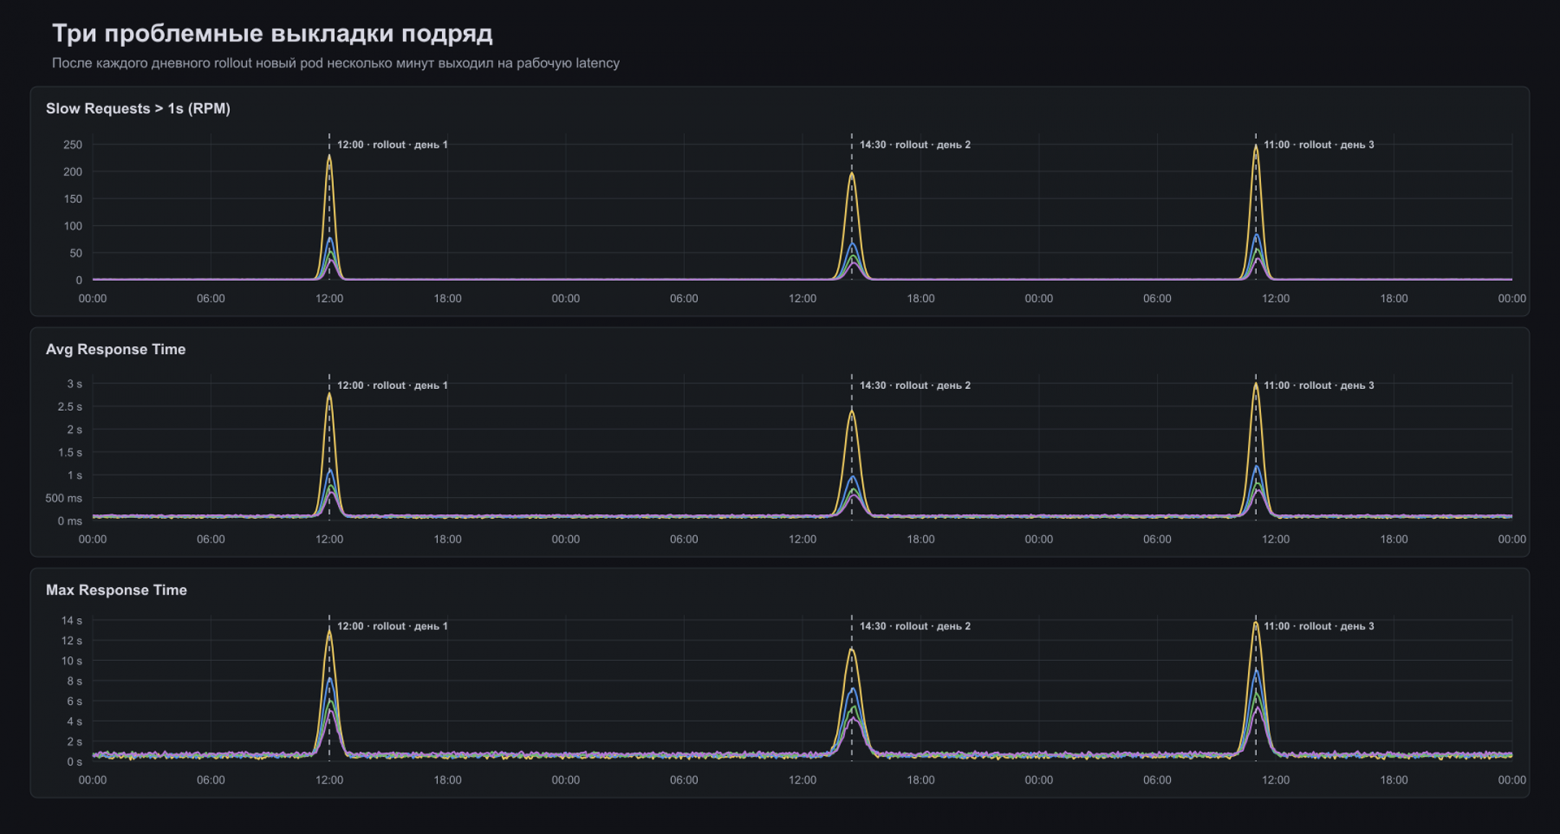
Проблема выглядела так. Выкатываем новую версию, все разворачивается штатно, ошибок нет. Но первые несколько минут часть запросов отрабатывает ощутимо дольше обычного, а через десять минут график возвращается к норме сам.
Цифры на пике одной из таких выкаток:
-
около 250 запросов с временем ответа больше секунды, хотя обычно таких нет вообще
-
максимальное время ответа доходило до 13 секунд, встречались ответы по 10 секунд
-
среднее время ответа поднималось примерно до 3 секунд
Важная оговорка: большая часть запросов продолжала отвечать нормально, но хвост распределения заметно ухудшался: рос p95, увеличивалось число запросов дольше секунды, а отдельные ответы занимали около 13 секунд.
Для банка такое было бы критично: если у человека не прошла операция, это совсем другая история. У нас масштаб был скромнее, и именно поэтому мы так долго не приоритизировали разбор. Каждый раз в момент релиза горели свои задачи, проблема выглядела как случайность, и мы говорили себе «ну бывает».
Три раза «ну бывает» подряд, и стало понятно, что дело в релизах.
Версии, которые не подтвердились
Дальше начался перебор гипотез. Мы шли по списку своих старых болячек, потому что за годы работы сервиса накопилась приличная коллекция проблем, и почти все они уже когда-то случались.
1. Пул соединений с базой. Первое подозрение. Сервис постоянно ходит в базу за акциями и бонусами, а соединения берет из пула, чтобы не устанавливать их заново на каждый запрос. Управляет этим HikariCP. Если пул не успевает прогреться или соединений не хватает, запросы встают в очередь. Пошли смотреть метрики: соединения готовы, очереди ожидающих запросов нет. Версия отпала, хотя раньше проблемы с базой у нас случались регулярно.
2. Инфраструктура и соседние сервисы. Проверили сеть, серверы, состояние сервисов, с которыми промо связан. Все в порядке. Смущало одно: почему тогда это происходит строго при релизах.
3. Внешние сервисы. Тоже мимо. Другие сервисы в те же моменты работали нормально.
4. Redis и кэш. Знакомая история, у нас уже бывало, что сервис долго подключался к Redis на старте. Проверили, оказалось не то.
5. Внутренние службы по расписанию. Внутри сервиса есть задачи, которые запускаются по крону: что-то раз в день, что-то раз в час, что-то раз в минуту. Появилась мысль, что при старте одновременно взводится большая пачка таких задач и глушит сервис. Посмотрели на другие сервисы с похожей схемой, там никаких проблем нет. Снова не то.
Зато по пути нашлась важная подсказка. Старые поды в момент выкатки работали нормально, тормозили именно новые, только что поднятые. Значит, дело не во внешних зависимостях и не в инфраструктуре, а в самом процессе на старте.
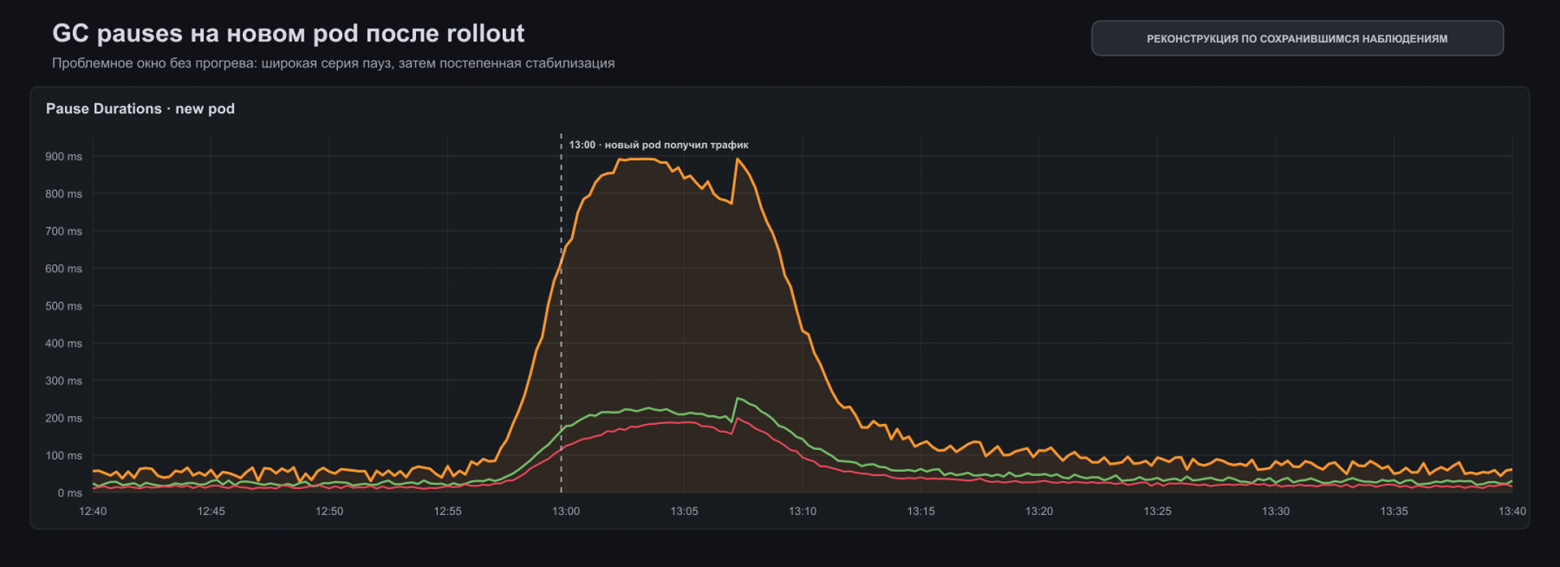
А потом мы посмотрели на метрики сборщика мусора и увидели закономерность: паузы сборки мусора на новых подах доходили до секунды, тогда как на других сервисах обычно укладываются примерно в 200 миллисекунд. Всплески по времени совпадали с ростом задержек.
Что происходит в JVM первые минуты
Дальше пришлось разобраться, что вообще делает JVM сразу после запуска. Если вы пишете на Java, этот абзац будет для вас очевидным, смело пролистывайте.
Сервис написан на Java, и работает он не напрямую, а внутри виртуальной машины, которая запускает код и управляет памятью [3]. При сборке исходный код превращается в промежуточные инструкции, байт-код, который можно запускать на любой платформе.
После старта JVM выполняет эти инструкции в базовом режиме и одновременно наблюдает за программой: какие методы вызываются, какие вызываются часто, какие ветки реально используются под нагрузкой, а какой код мертвый. Горячие участки она постепенно переводит в машинный код под конкретный процессор. Механизм называется JIT, компиляция во время работы.
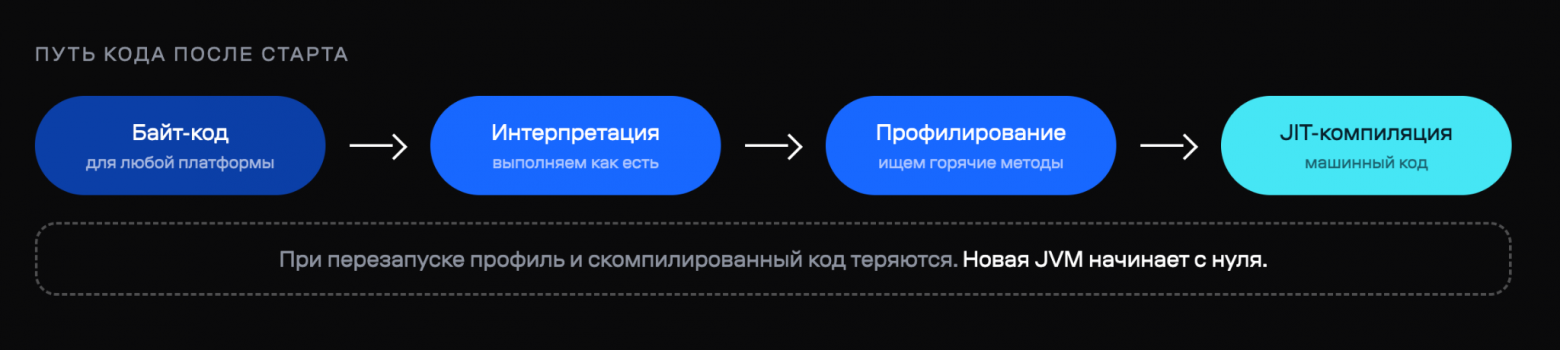
Если совсем на пальцах: сначала JVM едет по общей дороге и параллельно смотрит, куда мы ездим чаще. Для самых популярных маршрутов она строит новую дорогу, гораздо более быструю.
Проблема в том, что при перезапуске все эти построенные дороги пропадают. Накопленное состояние старого процесса не переезжает, и новая JVM должна заново увидеть реальные маршруты.
Параллельно работает сборщик мусора, который освобождает память от объектов, ставших ненужными. В Java он на время своей работы останавливает все приложение целиком, это называется stop the world. Если мусора накопилось много, пауза может занять сотни миллисекунд, а у нас доходило до секунды. Секунда полной остановки сервиса это очень много.
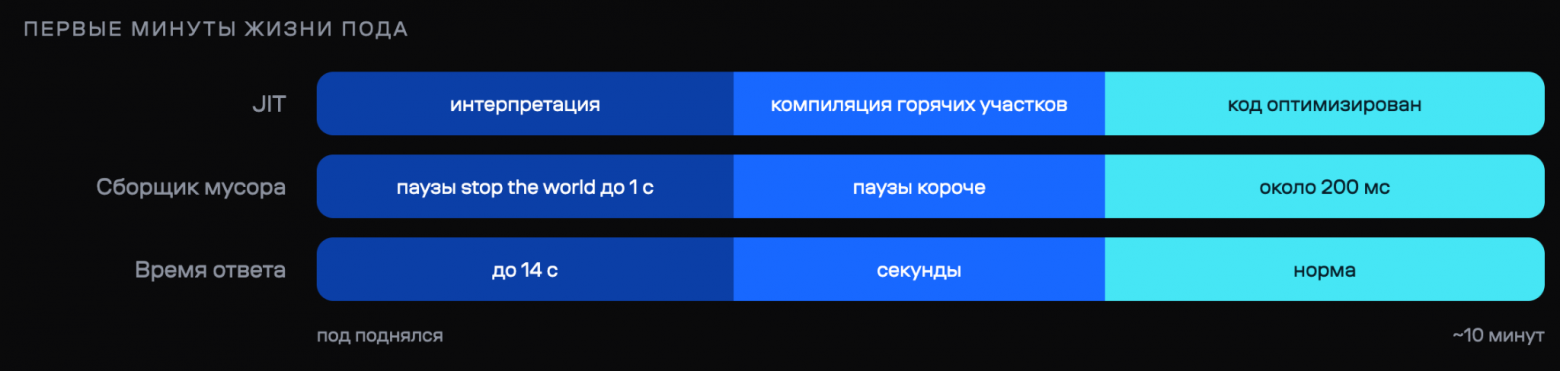
Сложите два фактора: код еще не оптимизирован, а сборщик мусора регулярно ставит приложение на паузу. И все это в момент, когда на под уже льется весь боевой трафик.
Отдельно стоит сказать, что прогревается не только сам Java-код. Реальный запрос проходит через Spring, через фильтры, через преобразования JSON, и все эти пути тоже надо прогреть. Поэтому недостаточно несколько раз дернуть один метод, нужно пройти весь путь запроса целиком.
Кто вообще решает, что под готов
Когда стало понятно, что происходит, вопрос сместился. JVM ведет себя нормально: она честно чистит память и честно стартует. Вопрос в том, кто и в какой момент отправляет на нее пользователей.
Все наши сервисы крутятся в Kubernetes. Он периодически спрашивает у каждого нового пода, “жив ли тот” и “готов ли отвечать”. Как только под отвечает “готов”, Kubernetes начинает лить на него трафик.
И вот здесь была загвоздка. Наш сервис поднимался, не обработав ни одного запроса, и сразу давал зеленый свет: я жив, я готов. Kubernetes честно верил и переключал на него пользователей. То есть прогрев JVM оплачивали своим временем первые пользователи, которым попали на свежий под.
Решение: прогреть себя самим
Идея простая: раз кто-то все равно должен пройти по этим маршрутам первым, пусть это будем мы.
После запуска приложения Spring вызывает специальный компонент-раннер. Он может выполнить любую работу на старте. Мы сделали так, что раннер берет из конфигурации список сценариев и отправляет обычные HTTP-запросы на этот же сервис. Это не пользовательские запросы, а их аналоги, но проходят они по тому же полному пути.
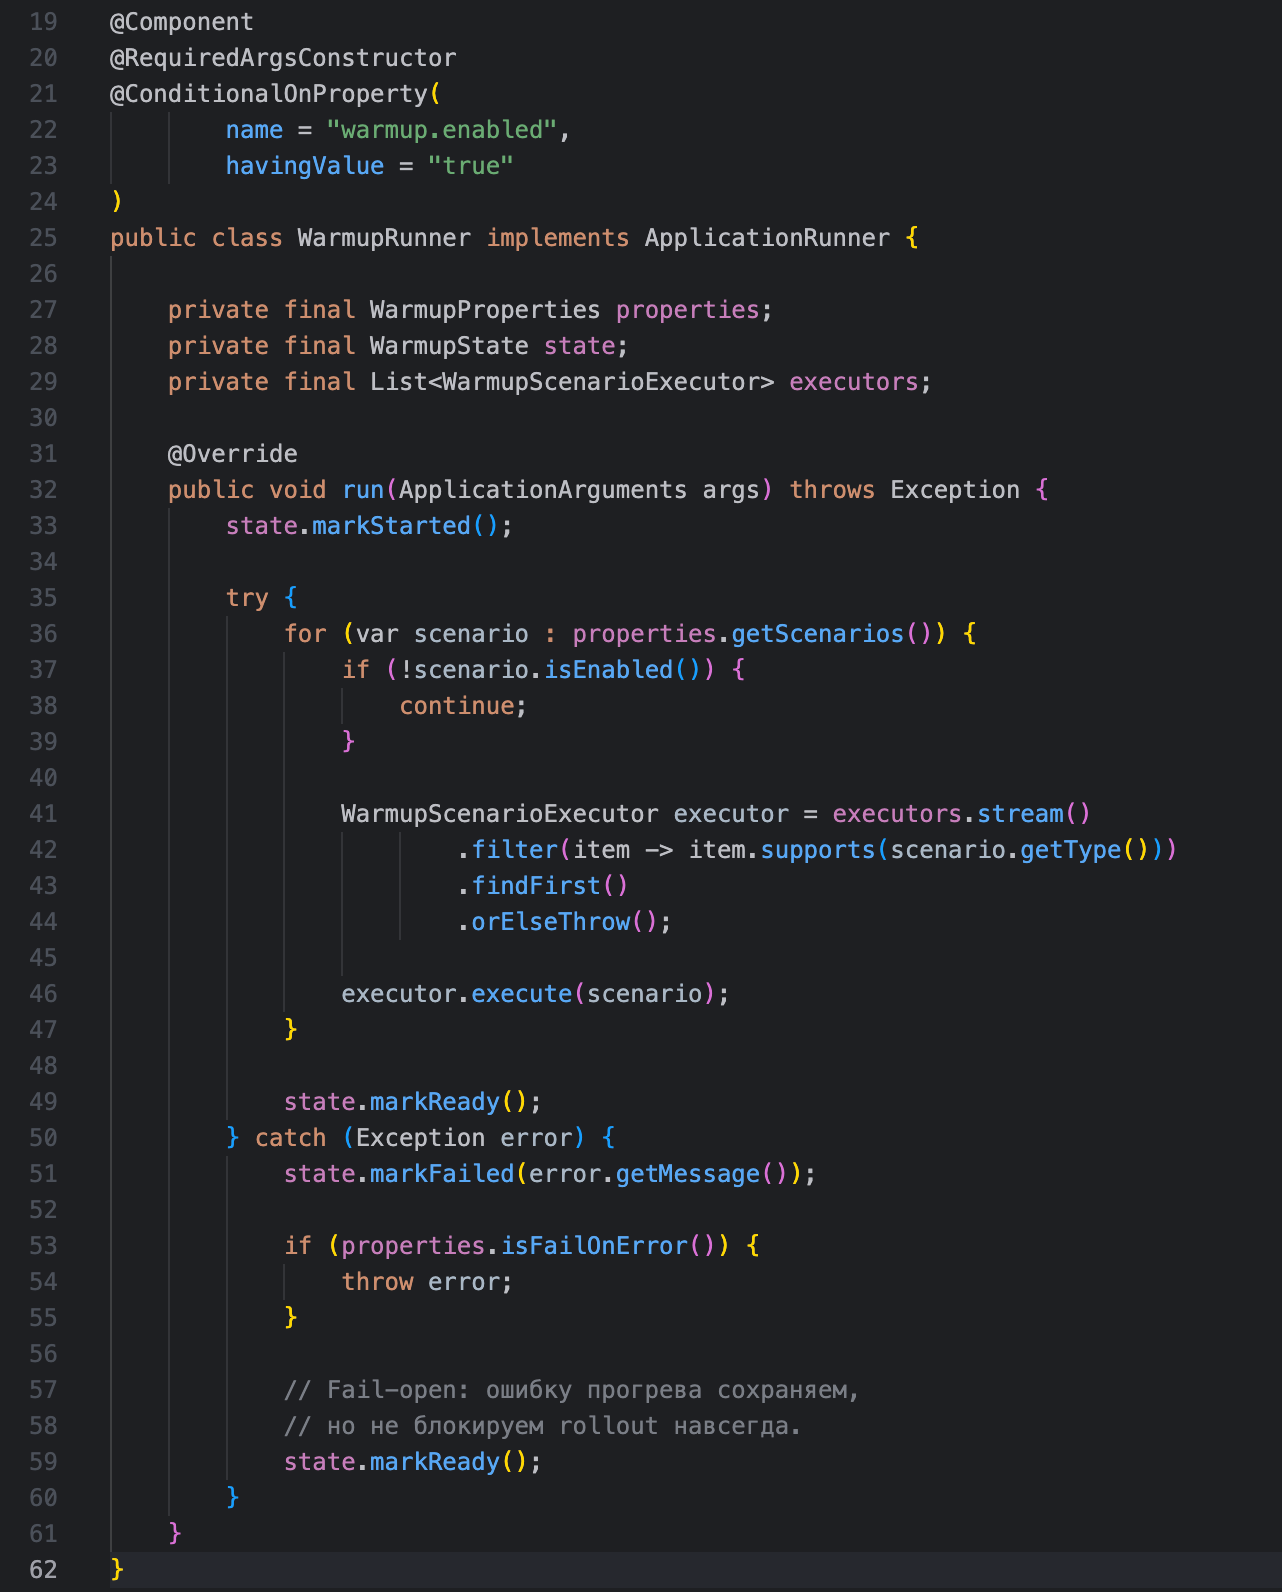
Ключевой момент: все это происходит до того, как сервис отдаст Kubernetes зеленый свет. Сначала прогреваемся, потом сервис говорит «я готов», и только потом на нас переключают реальный трафик.
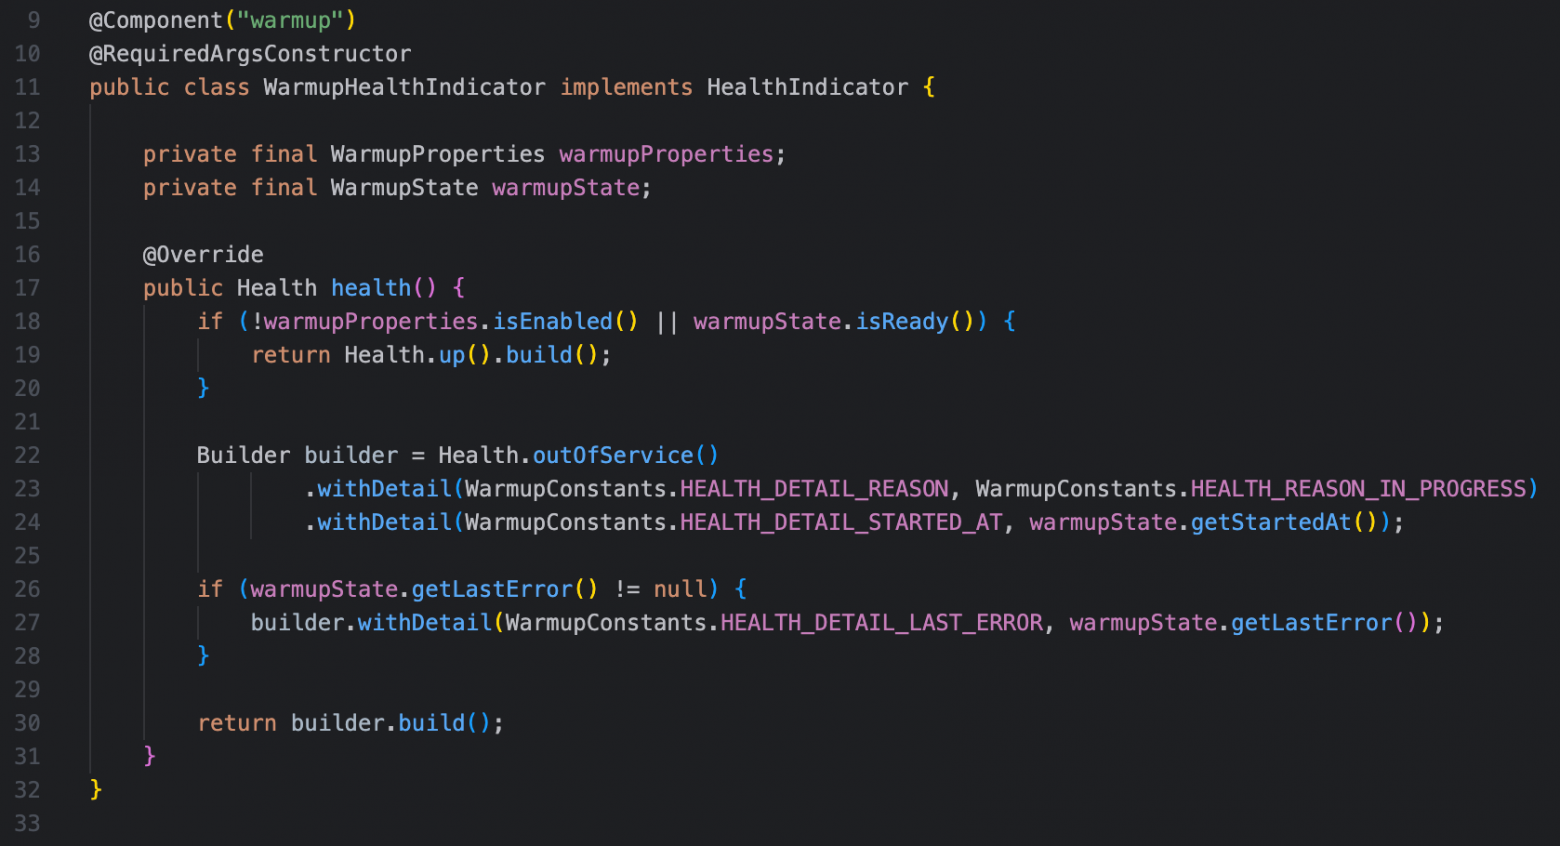
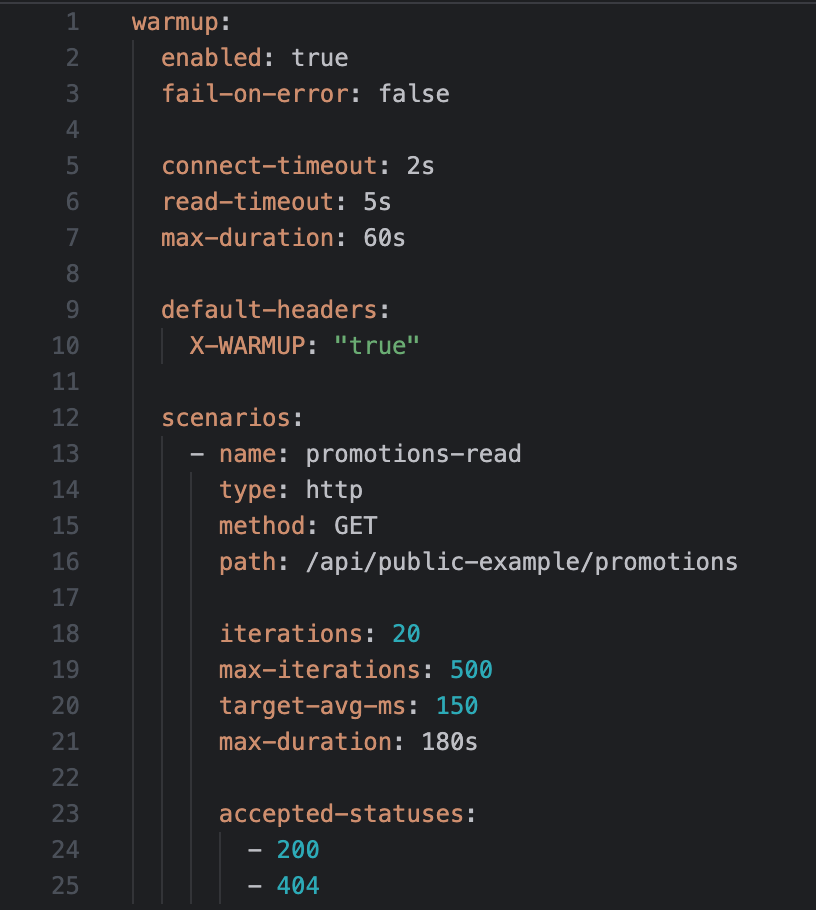
Прогрев настраивается конфигурацией для каждого метода отдельно, потому что методы разные. Один вызывается десять раз в секунду, другой в разы чаще. Один легкий и прогревается за десяток вызовов, другой тяжелый, и его лучше вызвать побольше раз.
В конфиге у нас три ключевых параметра на метод:
-
количество итераций, сколько раз дергаем ручку
-
целевое среднее время ответа, при достижении которого считаем метод прогретым
-
максимальное время прогрева одной ручки
Грабли: почему нужен лимит по времени
Третий параметр появился не сразу, и это как раз то место, где мы чуть не сделали себе больно.
Логика [4] «грей, пока не достигнешь целевого времени» выглядит красиво, но работает только если цель достижима. А это не всегда так. Можно поставить методу целевые 150 миллисекунд, а он физически никогда быстрее 200 не отработает, потому что внутри навешана тяжелая логика.
Без ограничения по времени сервис в такой ситуации будет греться до бесконечности. Мы бы выкатывались 100 минут и не выкатились.
Поэтому на каждую ручку стоит потолок: не успел прогреться за отведенное время, окей, оставляем как есть и идем дальше. Наш ориентир по времени релиза, около десяти минут максимум, никуда не делся, и прогрев должен в него укладываться.
Отсюда практический вывод: за конфигами прогрева нужно следить и ставить аккуратные жесткие лимиты. Иначе инструмент, который должен ускорять, начнет тормозить релизы.
Что получилось
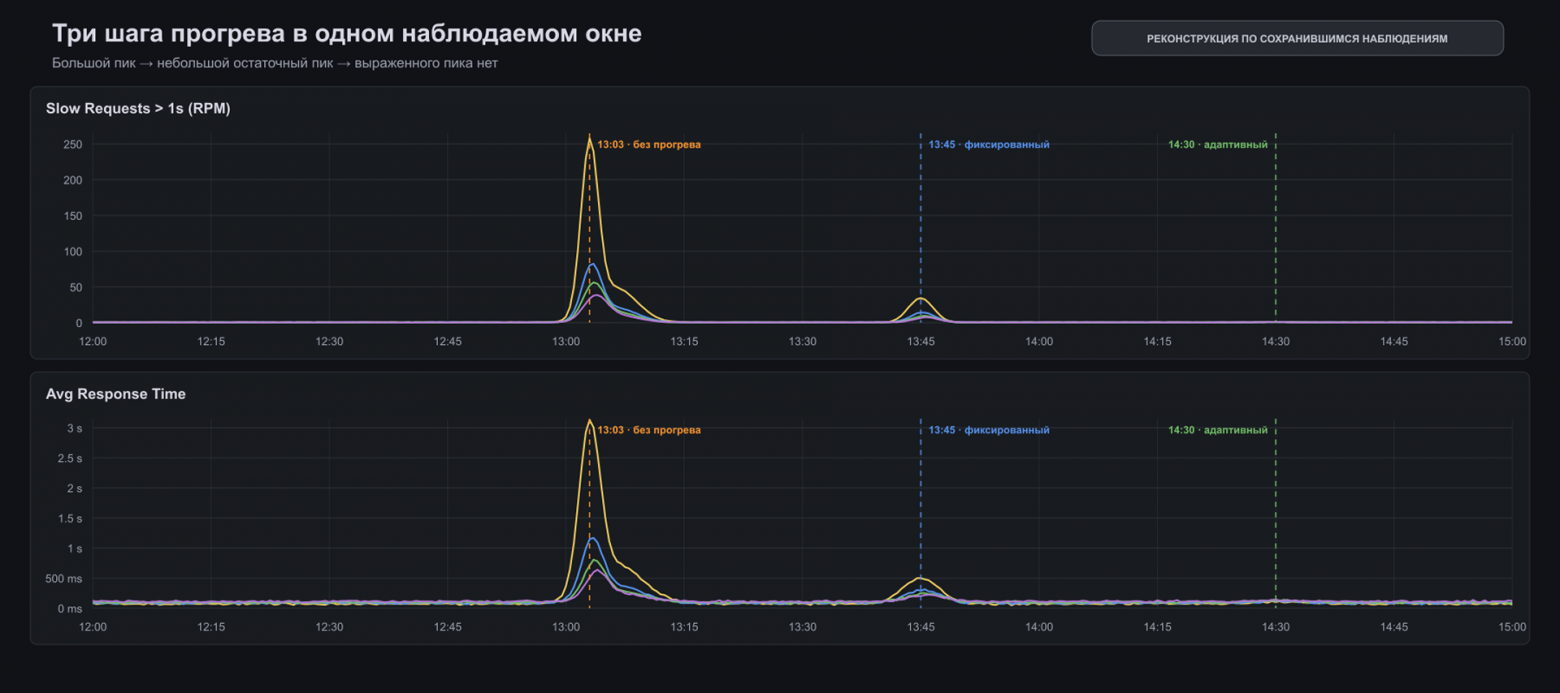
Мы смотрели на три последовательные выкатки.
Первая, без прогрева. Те самые пики: сотни запросов дольше секунды, максимумы в районе 14 секунд.
Вторая, с частичным прогревом. Прогревали не все методы и с небольшим числом итераций. Уже заметно лучше: количество запросов дольше секунды сильно уменьшилось, огромного пика не было, остался небольшой всплеск.
Третья, с полноценным прогревом. Выкатка вообще никак не отразилась на графиках.
Пара слов про то, как мы это придумали
Общую концепцию конфига мы набросали вместе с ИИ, потом обсудили и допилили руками.
Показательно, где именно ИИ ошибся. Он предложил греть метод до достижения целевого времени и не поставила ограничение по длительности. Ровно те грабли, про которые я писал выше: с таким конфигом сервис на некоторых методах не выкатился бы никогда. Скелет получился рабочий, но опасное место пришлось находить самим.
Что дальше
Прогрев у нас работает, но это не финальная точка.
Во-первых, наблюдаемость. Отдельные метрики по прогреву мы завели, но следим за ними пока не так системно, как хотелось бы.
Во-вторых, конфиги живут своей жизнью. Методы меняются, тяжелеют, появляются новые. Если за целевыми временами не следить, прогрев начнет молча упираться в лимиты и перестанет приносить пользу.
В-третьих, остается исходная проблема с тяжелыми методами. Прогрев маскирует ее на старте, но в обычной работе она никуда не девается.
Если вы решали ту же задачу, интересно послушать, как. Похожий подход я нашел только у Alibaba [5], у них стек другой, но идея та же и проработано основательнее. У остальных крупных команд докладов на эту тему не встречал, хотя проблема наверняка есть у всех, кто катит Java в Kubernetes.
Спасибо, что дочитали. Буду рад вопросам в комментариях!
Автор: AlexBossov
Источник [6]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/34310
URLs in this post:
[1] случайность: http://www.braintools.ru/article/6560
[2] на наш телегам‑канал по ссылке: https://t.me/+P01gRe9Kdko1YmQy
[3] памятью: http://www.braintools.ru/article/4140
[4] Логика: http://www.braintools.ru/article/7640
[5] только у Alibaba: https://habr.com/ru/company/jugru/blog/436266/
[6] Источник: https://habr.com/ru/companies/banki/articles/1069534/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1069534
Нажмите здесь для печати.