Диффузионная LLM технически умеет глушить свой контекст. Я попробовал этим воспользоваться
У авторегрессионной модели контекст — это то, что уже случилось. Токен выдан, и переписать его нечем: генерация умеет только дописывать справа.
У диффузионной всё иначе. На каждом шаге она делает полный двунаправленный проход по всей последовательности и переоценивает каждую позицию. Решение «эту фиксируем, эту оставляем открытой» принимает встроенный механизм уверенности: прошёл максимум softmax порог — токен приморожен, не прошёл — остаётся маской и будет переписан. То есть у диффузионной модели структурно есть возможность, которой у авторегрессии нет: глушить сигналы внутри собственного контекста. Не коммитить то, в чём не уверена. Стереть то, что мешает. Мне стало интересно, можно ли этим воспользоваться на практике — заставить модель самой вычистить мусор из выданного ей контекста.
Модель — LLaDA-8B‑Instruct [1] в Q4_K_M через llama.cpp.
Задача — RAG над графом знаний: 150 вопросов RoG-WebQSP [2], на вопрос 25 триплетов, на пути к ответу — по медиане один. Остальные 24 заведомо лишние, выбраны BFS к золоту
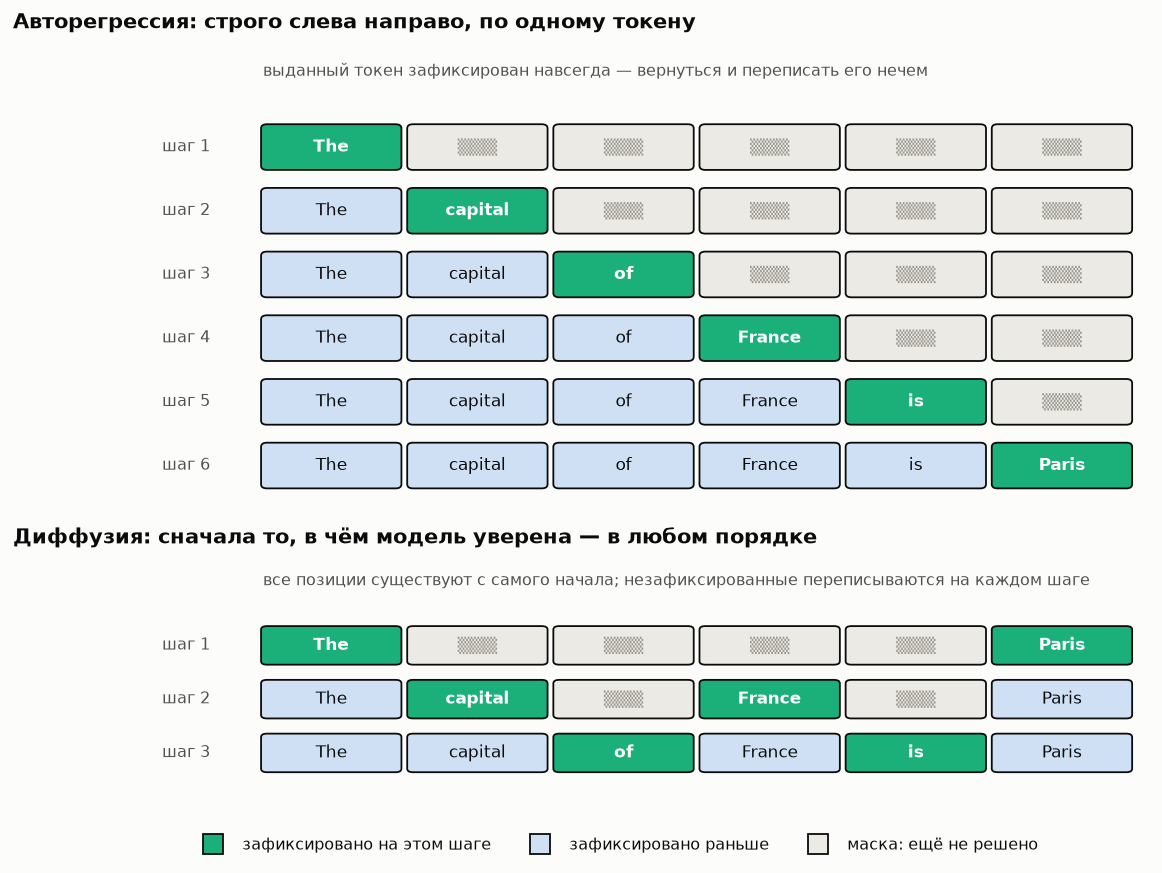
Как работает диффузионная LM, если коротко
Авторегрессия порождает текст слева направо, по одному токену. Маскированная диффузионная модель начинает с последовательности, целиком состоящей из масок, и предсказывает все замаскированные позиции сразу. Порядок раскрытия ничем не задан: первым фиксируется то, в чём модель уверена, а не то, что левее.
Используем механизм c порогом из FastDLLM [3], confidense 0.9
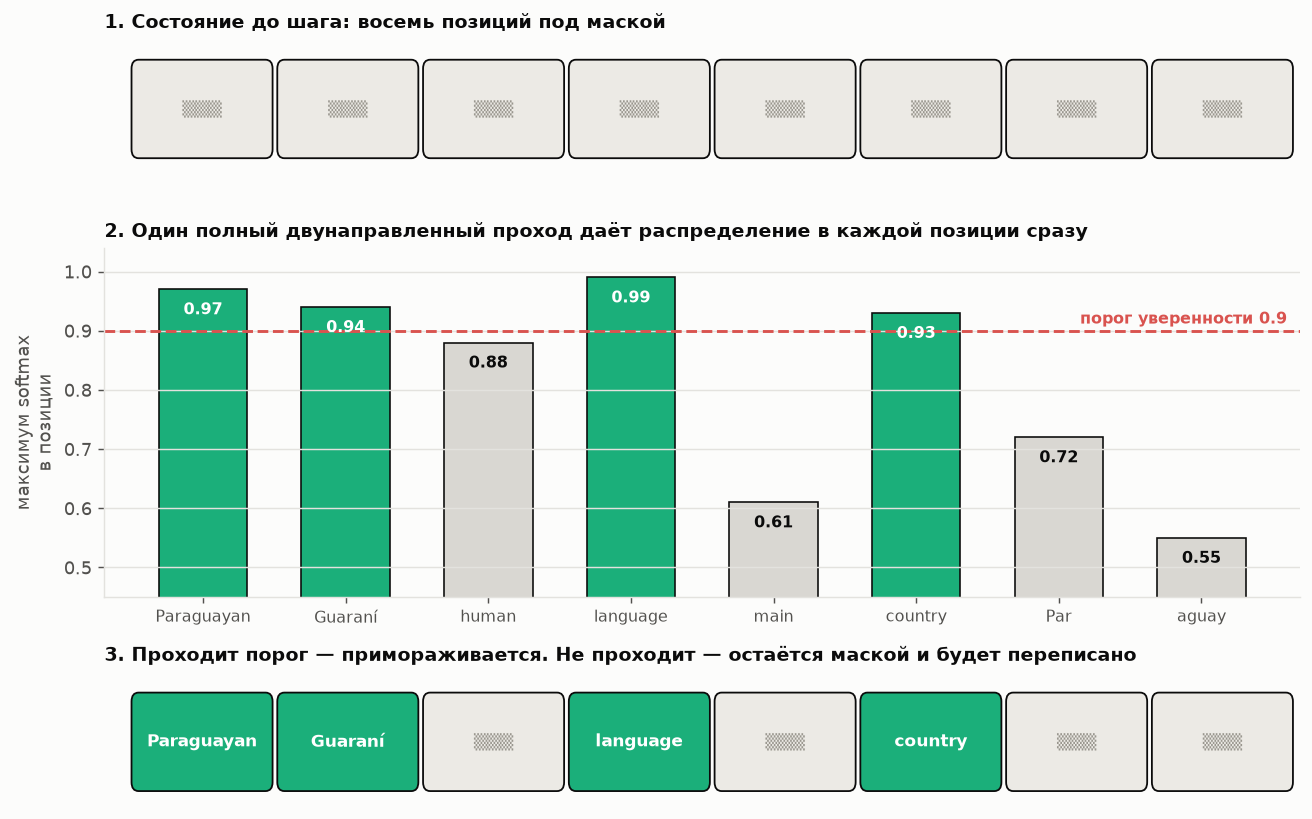
Если подробнее [4], но самое главное что мы попытаемся экслуатировать я описал
Идея: положить граф не в промпт, а под маску
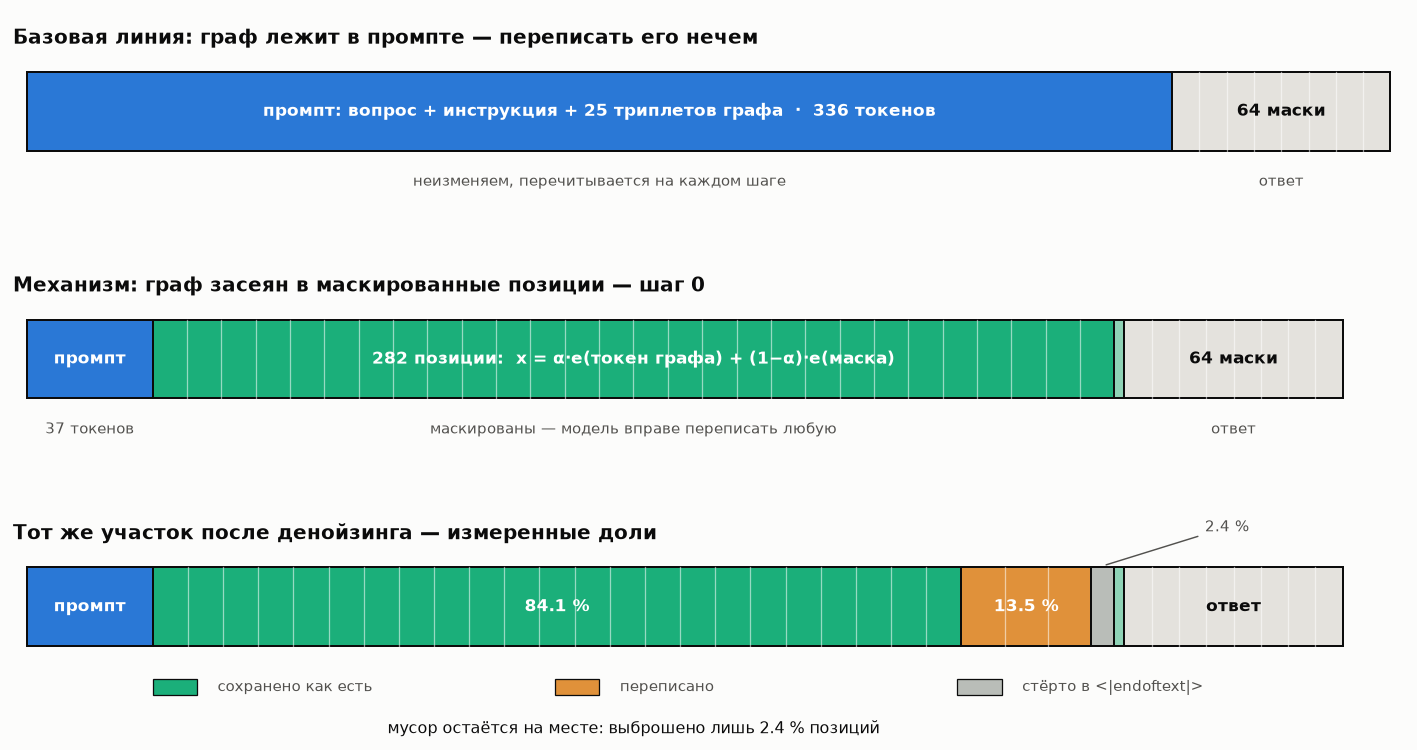
Обычно retrieved-контекст кладут в промпт, а промпт неизменяем — модель обязана нести все 25 триплетов через каждый шаг. Что если положить граф в перезаписываемую область масок?Тогда она физически сможет стереть ненужное.
То же самое пытались эксплуатировать, но для коррекции ответа слабой модели более мощной, читать тут [5], у нас гипотеза интереснее, может ли dLLM отбирать нужные факты. что нужные ей для ответа.
Идея, вообще говоря, не из мира текста. Ретрив внутрь диффузии впервые принесли в компьютерном зрении [6]: retrieval-augmented diffusion models [7] подмешивают соседей из внешней базы изображений прямо в процесс денойзинга, а не подают их как неизменяемое условие.
Технически мы планируем подавать вместо конкретных эмбеддингов определённых токенов — их смесь.

где  — i-й токен линеаризованного графа.
 — жёсткий граф в перезаписываемых слотах,
 — чистая маска. в тестах использовался

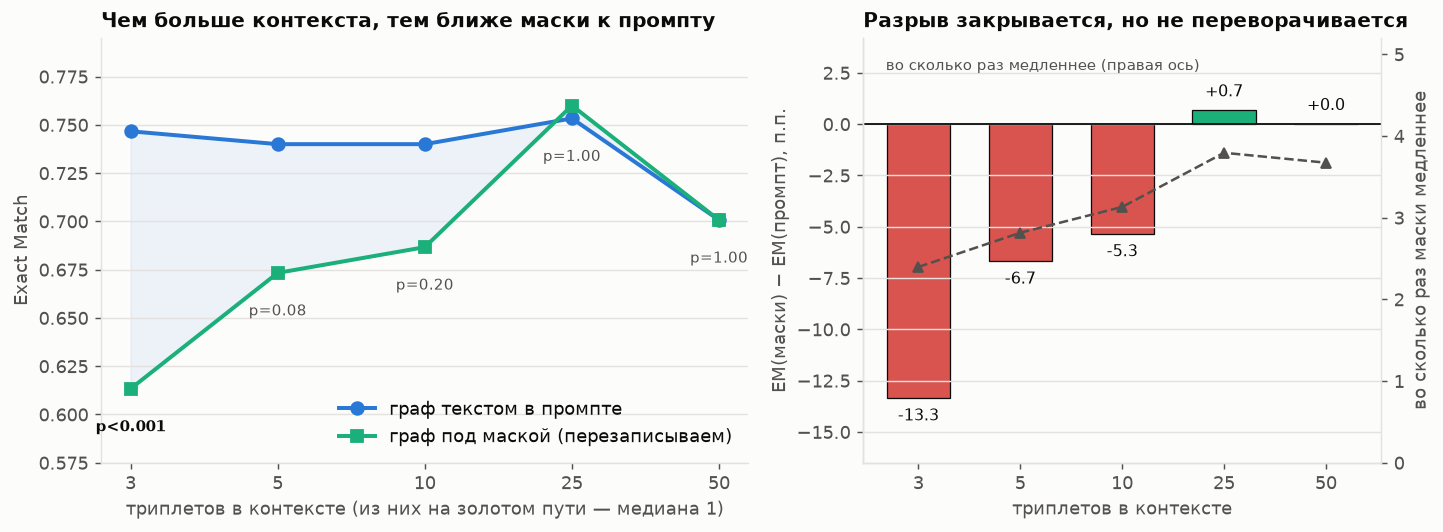
Результат 1: паритет, вчетверо дороже
Доля мусора здесь — параметр, который я задаю сам, поэтому сделал её независимой переменной.
Ответ присутствует в контексте при всех бюджетах, включая три триплета, так что различия по EM – это цена отвлечения, а не потеря факта.
|
Триплетов |
Граф в промпте |
Граф под маской |
Разрыв |
McNemar |
|---|---|---|---|---|
|
3 |
0.747 |
0.613 |
−13.3 |
+3/−23, p<0.001 |
|
5 |
0.740 |
0.673 |
−6.7 |
+8/−18, p=0.076 |
|
10 |
0.740 |
0.687 |
−5.3 |
+11/−19, p=0.200 |
|
25 |
0.753 |
0.760 |
+0.7 |
+9/−8, p=1.000 |
|
50 |
0.701 |
0.701 |
0.0 |
+11/−11, p=1.000 |
Разрыв закрывается монотонно, и не за счёт просадки промпта: промптовая кривая плоская, а масочная растёт с 0.613 до 0.760. Но нигде не переворачивается. Лучшее, чего механизм добился, — статистический паритет, и достался он вчетверо дороже: 18.7 шага против 4.8.
Ответ на это можно найти в «Masks Can Be Distracting» [8]: лишние mask-токены работают как дистракторы, и понимание контекста падает с их количеством. Механизм, который для работы требует длинной маскированной области, платит за неё сразу и он не окупается.
Результат 2: модель не вычищает мусор, она его ассимилирует
Самое интересное обнаружилось, когда я посмотрел, что стало с засеянной областью. Ожидал чистку: релевантное сохранено, на месте нерелевантого что то. Увидел ассимиляцию под вопрос.
Q: what are the two official languages of paraguay?
Gold: Spanish Language, Paraguayan Guaraní
GOLD
|
сохр |
что положили |
что осталось |
|---|---|---|
|
1.00 |
Paraguayan Guaraní human language main country Parag |
Paraguayan Guaraní human language main country Parag |
|
0.70 |
Spanish Language human language countries spoken in |
Spanish Language human language spoken country main |
Дистракторы
|
сохр |
что положили |
что осталось |
|---|---|---|
|
0.71 |
Ecuador country languages spoken Spanish Language. |
Ecuador human language spoken Spanish Language. |
|
0.67 |
Progressive Democratic Party organization geographic |
Christian Democratic Party headquarters geographic l |
|
0.67 |
Aguaray location containedby Paraguay. |
Aguaré location containedby |
Мусор никуда не делся — он переписан в мусор другими словами. Причём характерно: дистракторное отношение country languages spoken дрейфует в human language spoken, заимствуя формулировку у золотого триплета.
Модель ведёт себя как денойзинг-автоэнкодер: делает текст более «типичным», а не более релевантным.
Результат 3: отбор есть, он вопрос-обусловлен и крошечный
Теперь главный вопрос: различает ли встроенный механизм уверенности релевантный факт и мусор?
Я добавил дамп уверенности по каждой позиции на нулевом шаге. Первое, что оттуда видно: 72 % позиций области графа проходят порог 0.9 сразу.
Отбор виден. При α=0.5 модель фиксирует 75.6 % позиций золотого факта против 65.3 % позиций дистрактора — разрыв 10.4 пункта.
Вот только сам по себе он ничего не доказывает: золотые триплеты могут просто состоять из более предсказуемого текста. Нужен контроль — тот же граф, но чужой вопрос. Если разрыв держится и там, это предсказуемость токенов, а не отбор.
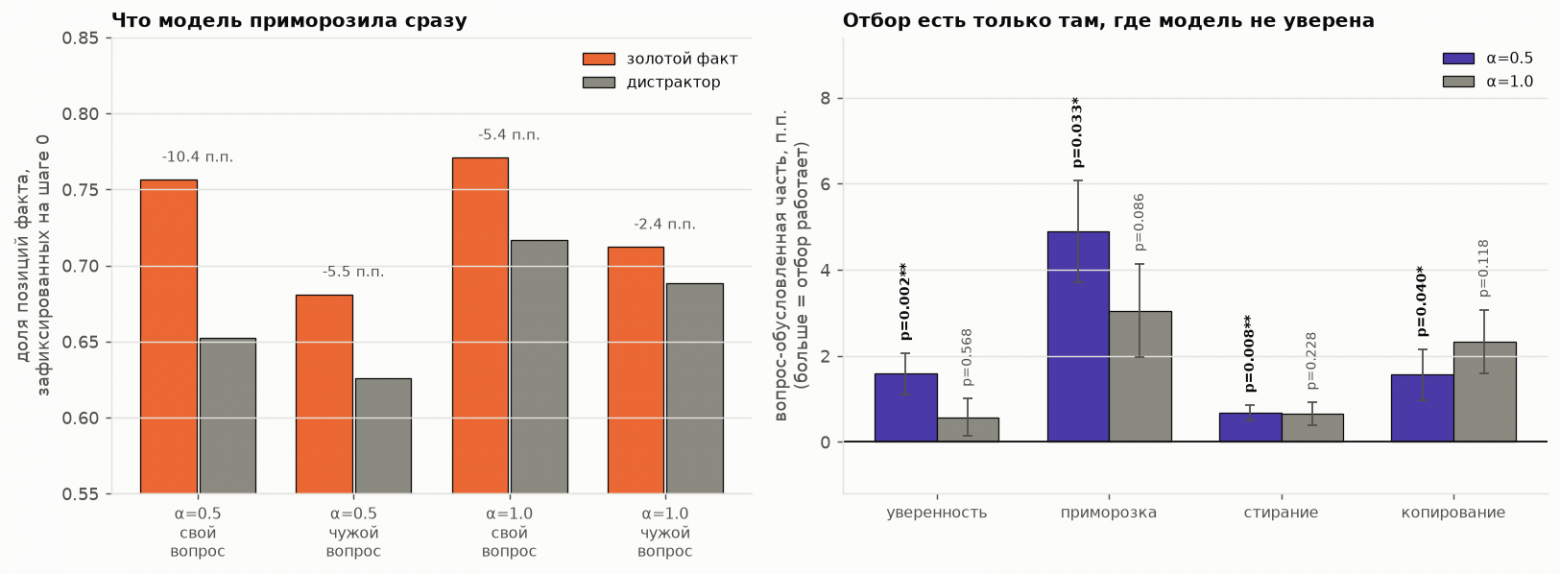
Контроль показывает, что часть эффекта тривиальна: при чужом вопросе разрыв падает с 10.4 до 5.5 пункта. Вопрос-обусловленная часть — разница между ними — и есть то единственное, что можно назвать отбором.
на гистограммах также показана обусловленная часть для удаления, копирования и уверенности.
Заключение:
Гипотеза была красивой: если у диффузионной модели структурно есть то, чего нет у авторегрессии — право не коммитить неуверенное и переписывать уже выданное, — то почему бы не отдать ей на откуп чистку retrieved-контекста? Не мы решаем, какие триплеты лишние, а сама модель, по уверенности, стирает мусор и оставляет нужное.
Практика гипотезу не подтвердила — по крайней мере в том виде, в каком я её сформулировал. обусловленнасть присутсвует но как её эксплуатировать открытый вопрос.
Оговорки
-
Одна модель, один датасет, квантизация Q4_K_M. Ничего не обобщается без проверки.
-
Рост масочной кривой по бюджету идёт вместе с ростом числа шагов (12.9 → 18.7), так что «выгода от работы с содержимым» и «просто больше вычислений» этим свипом не разведены.
-
Наблюдение про ассимиляцию — качественное, на нескольких вопросах, не квантифицировано.
Ссылки
-
LLaDA — Large Language Diffusion Models [1] (arXiv:2502.09992)
-
Fast-dLLM — Fast-dLLM: Training-free Acceleration of Diffusion LLM [3] (arXiv:2505.22618)
-
Masks Can Be Distracting — Masks Can Be Distracting [8] (arXiv:2511.21338)
-
RDM — Retrieval-Augmented Diffusion Models [7] (arXiv:2204.11824)
-
RoG — Reasoning on Graphs: Faithful and Interpretable LLM Reasoning [2] (arXiv:2310.01061)
-
Context-aware correction — Context-aware correction of weak models by strong models [5] (arXiv:2512.19004)
-
Теормин по dLLM — Обзор диффузионных языковых моделей, AIRI [9] (Хабр, AIRI)
Автор: khasanov_maxim
Источник [10]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/35536
URLs in this post:
[1] LLaDA-8B‑Instruct: https://arxiv.org/abs/2502.09992
[2] RoG-WebQSP: https://arxiv.org/abs/2310.01061
[3] FastDLLM: https://arxiv.org/abs/2505.22618
[4] подробнее: https://habr.com/ru/companies/airi/articles/1066880/?ysclid=mtzqqvae82357043395#8
[5] тут: https://arxiv.org/html/2512.19004
[6] зрении: http://www.braintools.ru/article/6238
[7] retrieval-augmented diffusion models: https://arxiv.org/abs/2204.11824
[8] «Masks Can Be Distracting»: https://arxiv.org/abs/2511.21338
[9] Обзор диффузионных языковых моделей, AIRI: http://habr.com/ru/companies/airi/articles/1066880/?ysclid=mtzqqvae82357043395#8
[10] Источник: https://habr.com/ru/articles/1082546/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1082546
Нажмите здесь для печати.