Бесплатного интеллекта не бывает: кто оплачивает данные для LLM
По первому образованию я юрист. Успел поработать в прокуратуре и арбитражном суде, потом ушёл в ИТ и последние 13 лет занимаюсь инфраструктурой, разработкой и DevOps. Сейчас строю MLOps-платформы.
Этот опыт [1] мешает мне спокойно читать споры об авторском праве и генеративном ИИ. Юрист видит пробелы учета прав в копировании чужих книг. Инженер — цепочку операций: crawler, raw storage, очистку, дедупликацию, training mix, веса, API. Между «скачали страницу» и «модель ответила пользователю» слишком много разных операций, чтобы обсуждать их одним словом «обучение».
Отправной точкой для этого разбора стала колонка Мэтта Столлера [2] о внутренних материалах OpenAI и Microsoft. Столлер пишет прежде всего о политике и неравном применении закона. Меня зацепил другой вопрос: как тот же конфликт [3] выглядит на уровне движения данных по ML-конвейеру — и что с этим вообще может сделать инженерная команда.
Мой тезис такой: главная проблема уже не только в том, какой закон применить. Часто невозможно восстановить факты, к которым этот закон нужно применить. Мы умеем прослеживать происхождение кода и контейнеров заметно лучше, чем происхождение данных, на которых строим модели.
Это не юридическая консультация. Американский fair use, нормы ЕС и российское авторское право устроены по-разному. Я разбираю инженерную сторону проблемы и несколько американских дел — выводы из них нельзя автоматически переносить на любую модель и юрисдикцию.
Вопрос «можно ли обучать ИИ на интернете» поставлен слишком широко
Популярная аналогия звучит убедительно: человек может прочитать тысячу книг, научиться писать и не платить авторам за каждую новую фразу. Почему модель должна?
Но человек не начинает чтение с массового создания цифровых копий. Он не складывает семь миллионов книг в хранилище компании, не прогоняет их через ETL и не выпускает систему, которая производит тексты промышленно. И сама модель не решает, обходить ли paywall и откуда брать следующий корпус. Это делают люди — иногда после вполне предметного обсуждения рисков.
Поэтому полезнее спросить иначе:
Какие операции мы выполнили с конкретным произведением, откуда получили копию, на каком основании её храним и в какие артифакты она попала?
У этого вопроса уже есть техническая форма.
Где в pipeline теряется происхождение данных
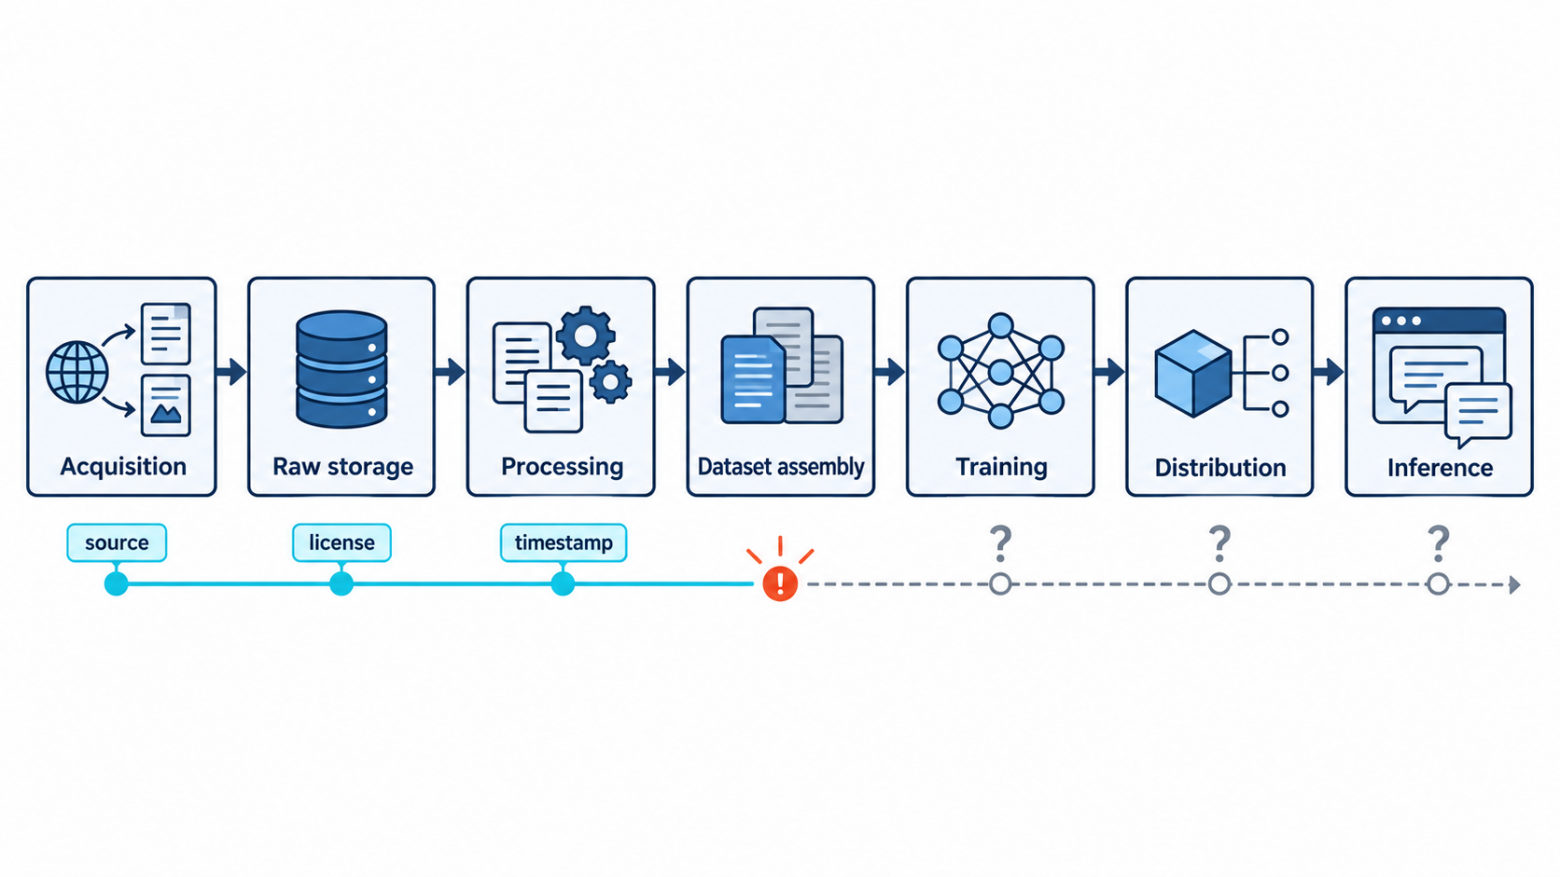
|
Этап |
Что происходит |
Что потом придётся доказать |
|
Acquisition |
crawler, API, Common Crawl, архив, torrent, покупка корпуса |
Откуда получена копия и был ли доступ законным |
|
Raw storage |
полные тексты попадают в object storage или data lake |
Зачем и как долго хранится копия |
|
Processing |
OCR, очистка, фильтрация, дедупликация |
Сохранилась ли связь документа с источником и лицензией |
|
Dataset assembly |
формируется конкретный training mix |
В какую версию набора вошёл документ |
|
Training |
токены участвуют в обновлении весов |
Для какой модели и цели использовались данные |
|
Distribution |
публикуются API, приложение или веса |
Какие ограничения переданы дальше |
|
Inference |
модель строит ответ |
Не воспроизводит ли она исходник и не замещает ли его на рынке |
На первой стадии ещё есть URL, дата скачивания и название исходного набора. После нескольких преобразований остаются parquet-файлы, хэши и внутренние идентификаторы. README с лицензией лежит где-то рядом, но уже непонятно, к каким строкам он относится.
В инфраструктуре такой класс ошибок хорошо знаком: артефакт жив, а контекст его появления умер. Только здесь потерянный контекст — не номер коммита, а основание использования чужого произведения.
Data BOM: скучная идея, которой не хватает ML
В software supply chain есть SBOM — перечень компонентов, версий и лицензий. Для данных нужен похожий объект. Назовём его Data Bill of Materials, или Data BOM.
Не каталог из миллиардов URL, опубликованный в открытом доступе, а машиночитаемая история происхождения набора. В минимальном варианте, на мой взгялд, она могла бы выглядеть так:
dataset_id: news-corpus-2026-04
version: 3
purpose: pretraining

sources:
  - source_type: licensed_archive
    provider: example-publisher
    acquired_at: 2026-04-12
    license_id: contract-1842
    allowed_uses: [pretraining]
    retention_until: 2029-04-12

  - source_type: web_crawl
    snapshot: crawl-2026-03
    policy_snapshot: s3://provenance/policies/2026-03.parquet
    rights_signal: robots_and_metadata

processing:
  pipeline_version: git:4f6c2d1
  deduplication: minhash-v2
  pii_filter: ner-policy-7

derived_datasets: [training-mix-v18]
model_runs: [run-2026-05-17-llm42]
Очевидно, что файл рядом с датасетом ничего не решит. Provenance должен ехать через ETL вместе с объектом, а изменения — попадать в журнал. И далее по конвейру в метаданные MLFlow и т.д. Иначе получится ещё одна декларация, которая расходится с реальностью.
С ответственностью тоже лучше определиться заранее:
-
владелец датасета отвечает за полноту записи и решение о включении источника;
-
data platform обеспечивает перенос метаданных, версии и неизменяемый журнал;
-
юристы задают правила для лицензий и сигналов об отказе;
-
ML governance проверяет исключения и выпуск конкретного training mix.
Если владельца нет, Data BOM быстро превращается в ничейный YAML.
Здесь есть неприятный контраргумент. Полный provenance дорог. Для старых корпусов он иногда технически невосстановим, а детальный список источников может раскрывать коммерческую тайну и облегчать атаки на датасет. Значит, прозрачность не обязана быть одинаковой для всех: публике можно дать агрегированное описание, а аудитору, суду или регулятору — детальный журнал при наличии оснований. Но «невозможно опубликовать всё» и «можно не учитывать ничего» — всё-таки разные позиции.
Теперь посмотрим, зачем эта скучная инфраструктура понадобилась юристам.
Anthropic: один корпус, три разных правовых вывода
В деле Bartz v. Anthropic [5] компания собрала центральную библиотеку книг. Часть получила из Books3, LibGen и PiLiMi; позднее стала покупать бумажные экземпляры, срезать переплёты, сканировать страницы и уничтожать оригиналы. Из этой библиотеки формировались наборы для обучения [6] Claude.
В определении от 23 июня 2025 [7] года суд разделил операции:
-
использование книг для обучения конкретных моделей в обстоятельствах этого дела признал
fair use; -
создание цифровой замены законно купленной и уничтоженной бумажной книги — тоже;
-
хранение пиратских копий в универсальной библиотеке «навсегда» — нет.
Это не общее разрешение обучать любые модели на любых книгах. Это вывод одного американского суда по конкретным истцам, произведениям и доказательствам. Но для инженера здесь важна сама декомпозиция: источник копии, цель её хранения и дальнейшее использование оказались разными вопросами.
В 2026 году суд окончательно утвердил соглашение на 1,5 млрд долларов, охватывающее более 482 тысяч произведений. Оно закрывает требования по прошлым нарушениям и не выдаёт Anthropic лицензию на будущие книги; актуальный статус соглашения описывает Associated Press [8].
Если в реестре есть только source_url, отличить купленную книгу от копии из LibGen уже не получится. Нужны как минимум способ получения, правообладатель или поставщик, разрешённые цели, срок хранения и список производных наборов.
Meta выиграла конкретное дело, а не весь спор
Через два дня вышло определение по делу Kadrey v. Meta [9]. Авторы обвиняли Meta в использовании их книг для обучения Llama. Компания выиграла на стадии summary judgment, и заголовки быстро сократили это до «суд разрешил обучение LLM на книгах».
Само определение осторожнее. Суд счёл использование трансформирующим, но отдельно разобрал возможное размытие рынка. Обычный автор пишет одну новую книгу; генеративная система позволяет выпускать огромное количество конкурирующих текстов с низкими предельными затратами. В другом процессе этот эффект может стать аргументом против fair use.
Почему авторы проиграли? Они не принесли достаточных доказательств рыночного ущерба именно своим произведениям и построили дело на более узкой теории. Суд прямо предупредил, что решение не означает законности обучения LLM во всех случаях.
Юридически разница большая: «Meta выиграла на этих доказательствах» не равно «практика разрешена всем и навсегда». Для data governance вывод тоже не самый удобный. Сегодняшняя победа не освобождает от необходимости завтра показать состав набора, версию модели и влияние её output на рынок.
OpenAI, Microsoft и фраза «ah nice»
В сентябре 2026 года в споре издателей с OpenAI и Microsoft раскрыли часть внутренних материалов. В меморандуме истцов [11] приводится переписка: сотрудник рассказал президенту OpenAI Грегу Брокману о способе обхода paywall The New York Times, а тот ответил «ah nice». Там же цитируются сотрудники Microsoft, обсуждавшие присвоение чужого труда и риск для индустрии контента.
Важно не перескочить через стадию процесса. Это позиция истцов, а не установленные судом факты; часть приложений остаётся закрытой. Microsoft заявляла, что резкие слова отражали мнение отдельного сотрудника. Краткий обзор опубликованных материалов есть у Nieman Journalism Lab [10].
Тем не менее переписка ломает удобную безличную формулу «модель прочитала интернет». Способы доступа обсуждают люди. Кто-то одобряет источник, кто-то пишет crawler, кто-то решает сохранить копию. Нормальный журнал должен оставлять след этих решений.
robots.txt — сигнал, а не реестр прав
Можно запретить crawler в robots.txt, но этот файл управляет поведением [12] бота на конкретном сайте. Он не следует за произведением по агрегаторам, архивам и чужим площадкам. Фотограф может владеть правами на снимок и не управлять доменом, где лежит его копия.
Даже знаменатель здесь легко перепутать. Cloudflare сообщала [13], что доля GPTBot в наблюдаемом ею трафике AI-only crawlers выросла примерно с 5% в мае 2024 года до 30% в мае 2025-го. Это не 30% всего бот-трафика интернета и не доказательство нарушения, лишь масштаб одного класса автоматизированного доступа в выборке Cloudflare.
Управление авторского права США [14] тоже отмечает, что правообладатель может не контролировать площадку, а сигнал на одном сайте не охватывает остальные копии. Ведомство при этом не предлагает ни полный запрет обучения, ни иммунитет для моделей: применимость fair use зависит от источника, цели, мер против воспроизведения и влияния на рынок.
То есть законы не исчезли. В 2024 году FTC (Federal Trade Commission), например, применила обычные правила против вводящих в заблуждение практик к нескольким AI-продуктам в рамках Operation AI Comply [15]. Слово AI не создаёт исключения. Труднее другое: применить норму, когда одна сторона владеет исходными данными, логами и инфраструктурой, а вторая должна вслепую доказать, что её произведение вообще прошло через конвейер.
ЕС уже требует часть этой прозрачности
Статья 53 EU AI Act [16] требует от поставщиков general-purpose AI models иметь политику соблюдения авторского права ЕС, учитывать выраженный правообладателями запрет на text and data mining и публиковать достаточно подробное резюме контента, использованного для обучения.
Это не Data BOM в описанном выше смысле и не автоматическая выплата каждому автору. Регламент оставляет место для коммерческой тайны, а публичное резюме может описывать крупные коллекции и категории источников. Но направление совпадает: разработчик должен хотя бы уметь объяснить, из чего строил модель.
Прозрачность не делает спорное использование законным. Она лишь не даёт спору утонуть в ответе «мы не знаем, откуда это взялось».
Что я бы сделал в обычной ML-команде
Большинство команд не обучает foundation model с нуля. Те же вопросы возникают в RAG, fine-tuning и evaluation-наборах, только объём меньше и отговорок, честно говоря, тоже меньше.
Я бы начал со следующих вещей:
-
Версионировал перечень источников вместе с датасетом и training run.
-
Сохранял лицензию, условия использования и rights-сигналы на дату получения данных.
-
Разделял законность доступа, право хранить копию и допустимость конкретной цели.
-
Не смешивал лицензированные, публичные и спорные источники без построчного или объектного provenance.
-
Добавил процедуру исключения источника из будущих сборок и честное описание ограничений machine unlearning.
-
Тестировал модель на воспроизведение длинных фрагментов, сохраняя методику и результаты.
-
Назначил владельца набора, которому нельзя ответить: «это зона юристов» или «это сделал crawler».
Этот список не гарантирует победу в суде. Он даёт более скромный результат: через год команда сможет восстановить собственные решения.
Вместо вывода
GPU оплачивается по часам. Облако — по запросам и трафику. Инженеры получают зарплату. Стоимость данных оказывается в другой системе учёта: автор должен обнаружить использование произведения, найти источник копии и несколько лет спорить о влиянии модели на рынок.
Аргумент компаний понятен: получить разрешение у миллионов правообладателей трудно. Но сложность учёта обычно приводит к появлению инфраструктуры учёта, а не к признанию ресурсов бесхозными.
Поэтому требование, с которого я бы начинал разговор о зрелом регулировании LLM, звучит почти буднично:
Покажите источник, версию, основание обработки и журнал изменений.
Бесплатного интеллекта [17] не бывает. Бывает архитектура, в которой стоимость данных пока не попала в billing.
Как это устроено у вас? Сохраняете provenance обучающих и RAG-данных или после импорта остаётся только ссылка на исходный dataset? И кто владеет этим процессом — ML-команда, data platform, юристы или отдельная функция governance?
Полезные ссылки
-
Bartz v. Anthropic — определение о fair use https://law.justia.com/cases/federal/district-courts/california/candce/3:2024cv05417/434709/437/ [5]
-
Kadrey v. Meta — определение о fair use https://law.justia.com/cases/federal/district-courts/california/candce/3:2023cv03417/415175/598/ [9]
-
Bartz v. Anthropic — окончательно утверждённое соглашение https://apnews.com/article/74b140444023898aeba8579b6e9f0d63 [8]
-
Доклад U.S. Copyright Office об обучении генеративного ИИ https://www.copyright.gov/ai/Copyright-and-Artificial-Intelligence-Part-3-Generative-AI-Training-Report-Pre-Publication-Version.pdf [14]
-
Статья 53 EU AI Act https://eur-lex.europa.eu/eli/reg/2024/1689/oj/eng [16]
-
Cloudflare: трафик AI-crawlers в 2025 году https://blog.cloudflare.com/from-googlebot-to-gptbot-whos-crawling-your-site-in-2025/ [13]
-
FTC: Operation AI Comply https://www.ftc.gov/news-events/news/press-releases/2024/09/ftc-announces-crackdown-deceptive-ai-claims-schemes [15]
Автор: KulakovK
Источник [18]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/35778
URLs in this post:
[1] опыт: http://www.braintools.ru/article/6952
[2] колонка Мэтта Столлера: https://www.thebignewsletter.com/p/ai-is-an-elite-crime-spree
[3] конфликт: http://www.braintools.ru/article/7708
[4] Brecht Corbeel: https://unsplash.com/@brechtcorbeel
[5] Bartz v. Anthropic: https://law.justia.com/cases/federal/district-courts/california/candce/3:2024cv05417/434709/437/
[6] обучения: http://www.braintools.ru/article/5125
[7] определении от 23 июня 2025: https://storage.courtlistener.com/recap/gov.uscourts.cand.434709/gov.uscourts.cand.434709.231.0.pdf
[8] Associated Press: https://apnews.com/article/74b140444023898aeba8579b6e9f0d63
[9] Kadrey v. Meta: https://law.justia.com/cases/federal/district-courts/california/candce/3:2023cv03417/415175/598/
[10] статьи : https://www.niemanlab.org/2026/09/an-astonishing-theft-of-unprecedented-proportions-court-records-show-what-microsoft-and-openai-actually-thought-about-ai-training/
[11] меморандуме истцов: https://storage.courtlistener.com/recap/gov.uscourts.nysd.640396/gov.uscourts.nysd.640396.1977.1.pdf
[12] поведением: http://www.braintools.ru/article/9372
[13] Cloudflare сообщала: https://blog.cloudflare.com/from-googlebot-to-gptbot-whos-crawling-your-site-in-2025/
[14] Управление авторского права США: https://www.copyright.gov/ai/Copyright-and-Artificial-Intelligence-Part-3-Generative-AI-Training-Report-Pre-Publication-Version.pdf
[15] Operation AI Comply: https://www.ftc.gov/news-events/news/press-releases/2024/09/ftc-announces-crackdown-deceptive-ai-claims-schemes
[16] EU AI Act: https://eur-lex.europa.eu/eli/reg/2024/1689/oj/eng
[17] интеллекта: http://www.braintools.ru/article/7605
[18] Источник: https://habr.com/ru/articles/1084566/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1084566
Нажмите здесь для печати.