Как робот из Китая превратился в тысячи «посетителей» сайта
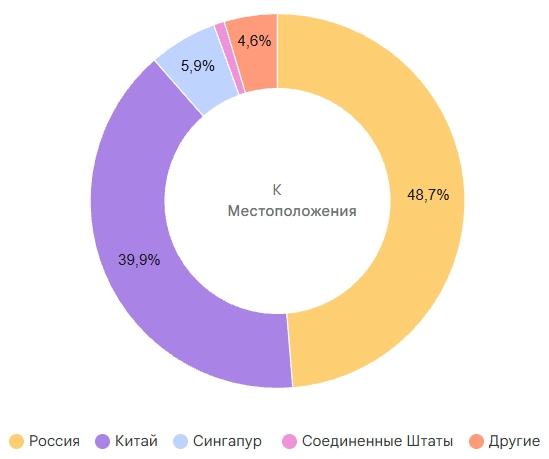
Всё началось со странности в Google Analytics. Для регионального новостного сайта сервис неожиданно стал показывать очень большую долю посетителей с настольных компьютеров.
Это выглядело неправдоподобно: реальная аудитория новостных сайтов сегодня в основном приходит со смартфонов. Но ещё интереснее оказалось другое — значительная часть новых «читателей» якобы находилась в китайском городе Ланьчжоу. Я решил разобраться, откуда взялись эти люди и люди ли это вообще.
Тысячи одинаковых посетителей
При более подробном анализе выяснилось, что практически все посетители из Ланьчжоу выглядят одинаково:
-
настольный компьютер;
-
Windows 10;
-
браузер Chrome;
-
преимущественно прямой заход на сайт;
-
очень низкая вовлечённость.
За исследуемый период Google Analytics насчитал более 18 тысяч активных пользователей из Ланьчжоу. Для сравнения: настоящая аудитория из Миасса, Челябинска и Екатеринбурга выглядела совершенно иначе — там ожидаемо преобладали смартфоны. Неестественной оказалась и динамика китайского трафика. Несколько дней шёл большой и довольно ровный поток, затем он почти мгновенно обрывался, спустя некоторое время снова появлялся. Так люди обычно себя не ведут. При этом «посетители» открывали не одну страницу, а самые разные реальные новости сайта.
Что рассказали серверные логи
Следующим шагом я изучил серверные логи — технический журнал, в котором сервер фиксирует каждое обращение к сайту: откуда оно пришло, какая страница была запрошена, какой браузер использовался и многое другое. Именно там появился главный след. Обнаружилась группа китайских IP-адресов: 202.46.62.0/24
За исследованный период из этой сети сервер получил 61 162 запроса со 120 различных IP-адресов. Причём 59 918 запросов использовали фактически один и тот же профиль браузера: Windows 10 + Chrome 133.0.6943.141 Это практически точно совпадало с тем, что до этого показывал Google Analytics. Но гораздо интереснее оказался характер этих обращений.
Это не простой робот, который скачивает текст страницы и уходит. Он загружает сайт почти так же, как обычный браузер:
-
открывает публикации;
-
получает изображения;
-
загружает JavaScript и стили;
-
выполняет динамические запросы;
-
обращается к внутренним механизмам WordPress.
Из примерно 61 тысячи обращений 32 964 были POST-запросами. Ещё показательнее то, что 14 391 запрос пришёлся на /wp-admin/admin-ajax.php — механизм WordPress, используемый для динамической работы страниц. Получается, что автоматическая система не просто читает HTML-код. Она достаточно полно воспроизводит работу браузера. Именно поэтому, скорее всего, на странице запускается код Google Analytics — и робот начинает выглядеть для GA4 как настоящий человек.
След привёл к Baidu
Следующим вопросом стало происхождение этой сети. Диапазон связан с китайской сетевой инфраструктурой, маршрутизируемой через AS55967 Beijing Baidu Netcom Science and Technology. Baidu — крупнейшая китайская поисковая компания, своего рода аналог Google или Яндекса. Естественно, возникла версия: может быть, это просто поисковый робот Baidu, который индексирует сайт? Я отдельно проверил и это.
Официальный поисковый робот Baidu должен представляться как Baiduspider или Baiduspider-render. В исследованных серверных логах таких обозначений не оказалось вообще. Вместо этого автоматическая система представлялась обычным браузером Chrome. То есть связь используемой инфраструктуры с Baidu существует, но оснований считать этот поток обычной полезной поисковой индексацией нет.
Google Analytics и Яндекс.Метрика увидели разных «посетителей»
Особенно интересным оказалось сравнение с Яндекс.Метрикой. В обычной статистике Метрики та же китайская сеть 202.46.62.xxx [1] дала всего 117 визитов. И даже эти визиты выглядели крайне подозрительно:
-
97% отказов;
-
глубина просмотра — 1 страница;
-
время на сайте — менее 1 секунды.
Но самое интересное обнаружилось в отдельном отчёте Яндекс.Метрики «Роботы». За месяц Метрика зафиксировала 74 516 роботных событий, из которых 74 441 были отфильтрованы по поведенческим признакам. И здесь становится понятна одна из причин сильного расхождения между двумя системами аналитики.
Google Analytics получает события от работающего браузерного окружения. Если автоматическая программа выполняет JavaScript и ведёт себя достаточно похоже на браузер пользователя, GA4 может записать её в обычную статистику.
Яндекс.Метрика дополнительно анализирует характер поведения [2] и в данном случае значительно успешнее отделяет автоматический трафик от людей. Это не значит, что Google Analytics «считает неправильно». События действительно происходят. Проблема в другом: часть этих событий создают не реальные читатели. Поэтому в нынешней ситуации при оценке именно человеческой аудитории сайта данные Яндекс.Метрики выглядят гораздо правдоподобнее. Абсолютные показатели Google Analytics пока приходится использовать с осторожностью.
Оказалось, что такая проблема есть не только у нас
После этого я начал искать похожие случаи. Выяснилось, что владельцы сайтов в разных странах уже обсуждают резкие всплески необычного трафика из Lanzhou, China, а также из Сингапура. Картина во многих случаях похожая:
-
неожиданное увеличение desktop-трафика;
-
очень низкая вовлечённость;
-
прямые заходы;
-
резкие волны активности;
-
статистика, не соответствующая реальной аудитории сайта.
Есть и ещё одно интересное совпадение. Диапазон 202.46.62.0/24 уже встречается в специализированных базах, собирающих сведения о подозрительной автоматической активности. Отдельные IP-адреса этой сети имеют многочисленные жалобы на автоматический обход сайтов, а в чужих серверных журналах встречается даже знакомая комбинация: Windows 10 + Chrome 133.0.6943.141 То есть, судя по всему, речь идёт не о странности одного конкретного сайта, а о более крупной автоматизированной системе.
Зачем роботу всё это нужно?
На этот вопрос точного ответа пока нет. По характеру работы можно предположить несколько вариантов:
-
массовый сбор содержимого сайтов;
-
анализ веб-страниц и их структуры;
-
создание собственной базы информации;
-
автоматизированное тестирование;
-
сбор данных для поисковых систем;
-
сбор информации для систем искусственного интеллекта [3].
Последняя версия сегодня особенно интересна. Современным AI-системам нужны огромные объёмы текстов, фотографий и другой информации. Для машины ценны не только крупные энциклопедии или мировые СМИ. Обычные местные новости тоже содержат огромное количество сведений о реальной жизни: события, людей, организации, места, даты, язык и повседневные ситуации. Поэтому версия о массовом сборе данных для AI выглядит вполне возможной.
Но важно подчеркнуть: прямых доказательств того, что конкретно этот робот собирает информацию для искусственного интеллекта, пока нет. Мы знаем, как он работает. Знаем, откуда приходит. Видим, какие страницы открывает. Но его настоящая задача пока остаётся неизвестной.
Что удалось выяснить
Расследование началось с простого вопроса: почему в Google Analytics вдруг появилось огромное количество странных посетителей с компьютеров? В результате удалось проследить практически всю цепочку: Google Analytics → Ланьчжоу → Windows и Chrome → серверные логи → конкретная группа IP-адресов → полноценная браузерная автоматизация → инфраструктура, связанная с Baidu → сравнение с Яндекс.Метрикой → аналогичные случаи на других сайтах.
Главный вывод уже вполне определённый. Это не тысячи китайских читателей. Это автоматизированная система, которая умеет настолько хорошо изображать обычного пользователя, что Google Analytics в значительной степени принимает её за человека. Причём проблема не ограничивается испорченной статистикой. Робот действительно приходит на сервер, загружает страницы, изображения и программы, выполняет динамические запросы. На всё это расходуются процессорное время, оперативная память [4] и интернет-канал.
А ресурсы сервера не бесплатны и не бесконечны. При достаточно большой автоматической нагрузке сайт может начать работать медленнее именно для настоящих посетителей. Поэтому следующий этап уже практический — точечно ограничить доступ для обнаруженного автоматизированного потока, не затрагивая нормальных пользователей и настоящих поисковых роботов. После этого будет интересно снова сравнить Google Analytics и Яндекс.Метрику и посмотреть, насколько изменится картина реальной посещаемости.
Но один вопрос пока остаётся без ответа: зачем этой сложной китайской автоматической системе понадобились новости небольшого российского города?
Автор: papex_rus
Источник [5]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/35812
URLs in this post:
[1] 202.46.62.xxx: http://202.46.62.xxx
[2] поведения: http://www.braintools.ru/article/9372
[3] интеллекта: http://www.braintools.ru/article/7605
[4] память: http://www.braintools.ru/article/4140
[5] Источник: https://habr.com/ru/articles/1084966/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1084966
Нажмите здесь для печати.