Галлюцинации недели: Jev, везде и сразу
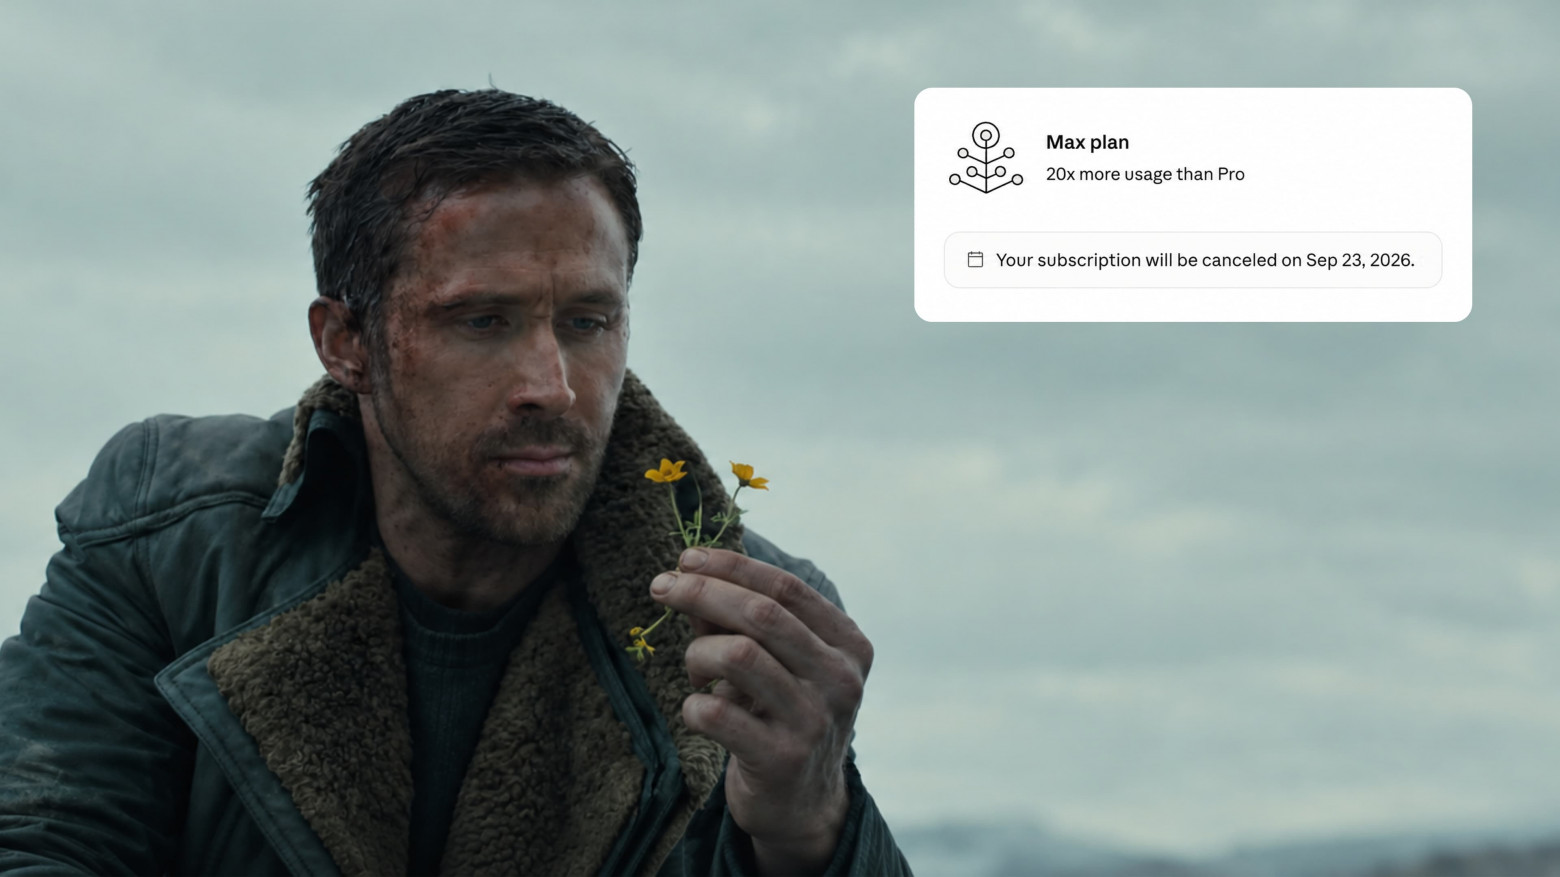
В Claude Code появились Projects: один агент становится координатором, каждая задача уезжает в свою облачную ветку и продолжает работать после закрытия ноутбука. Оплачивать этот праздник оркестрации предлагается из квоты, которую с 14 сентября подрезали на 17% относительно летней. А вы, кстати, слышали про Jev?
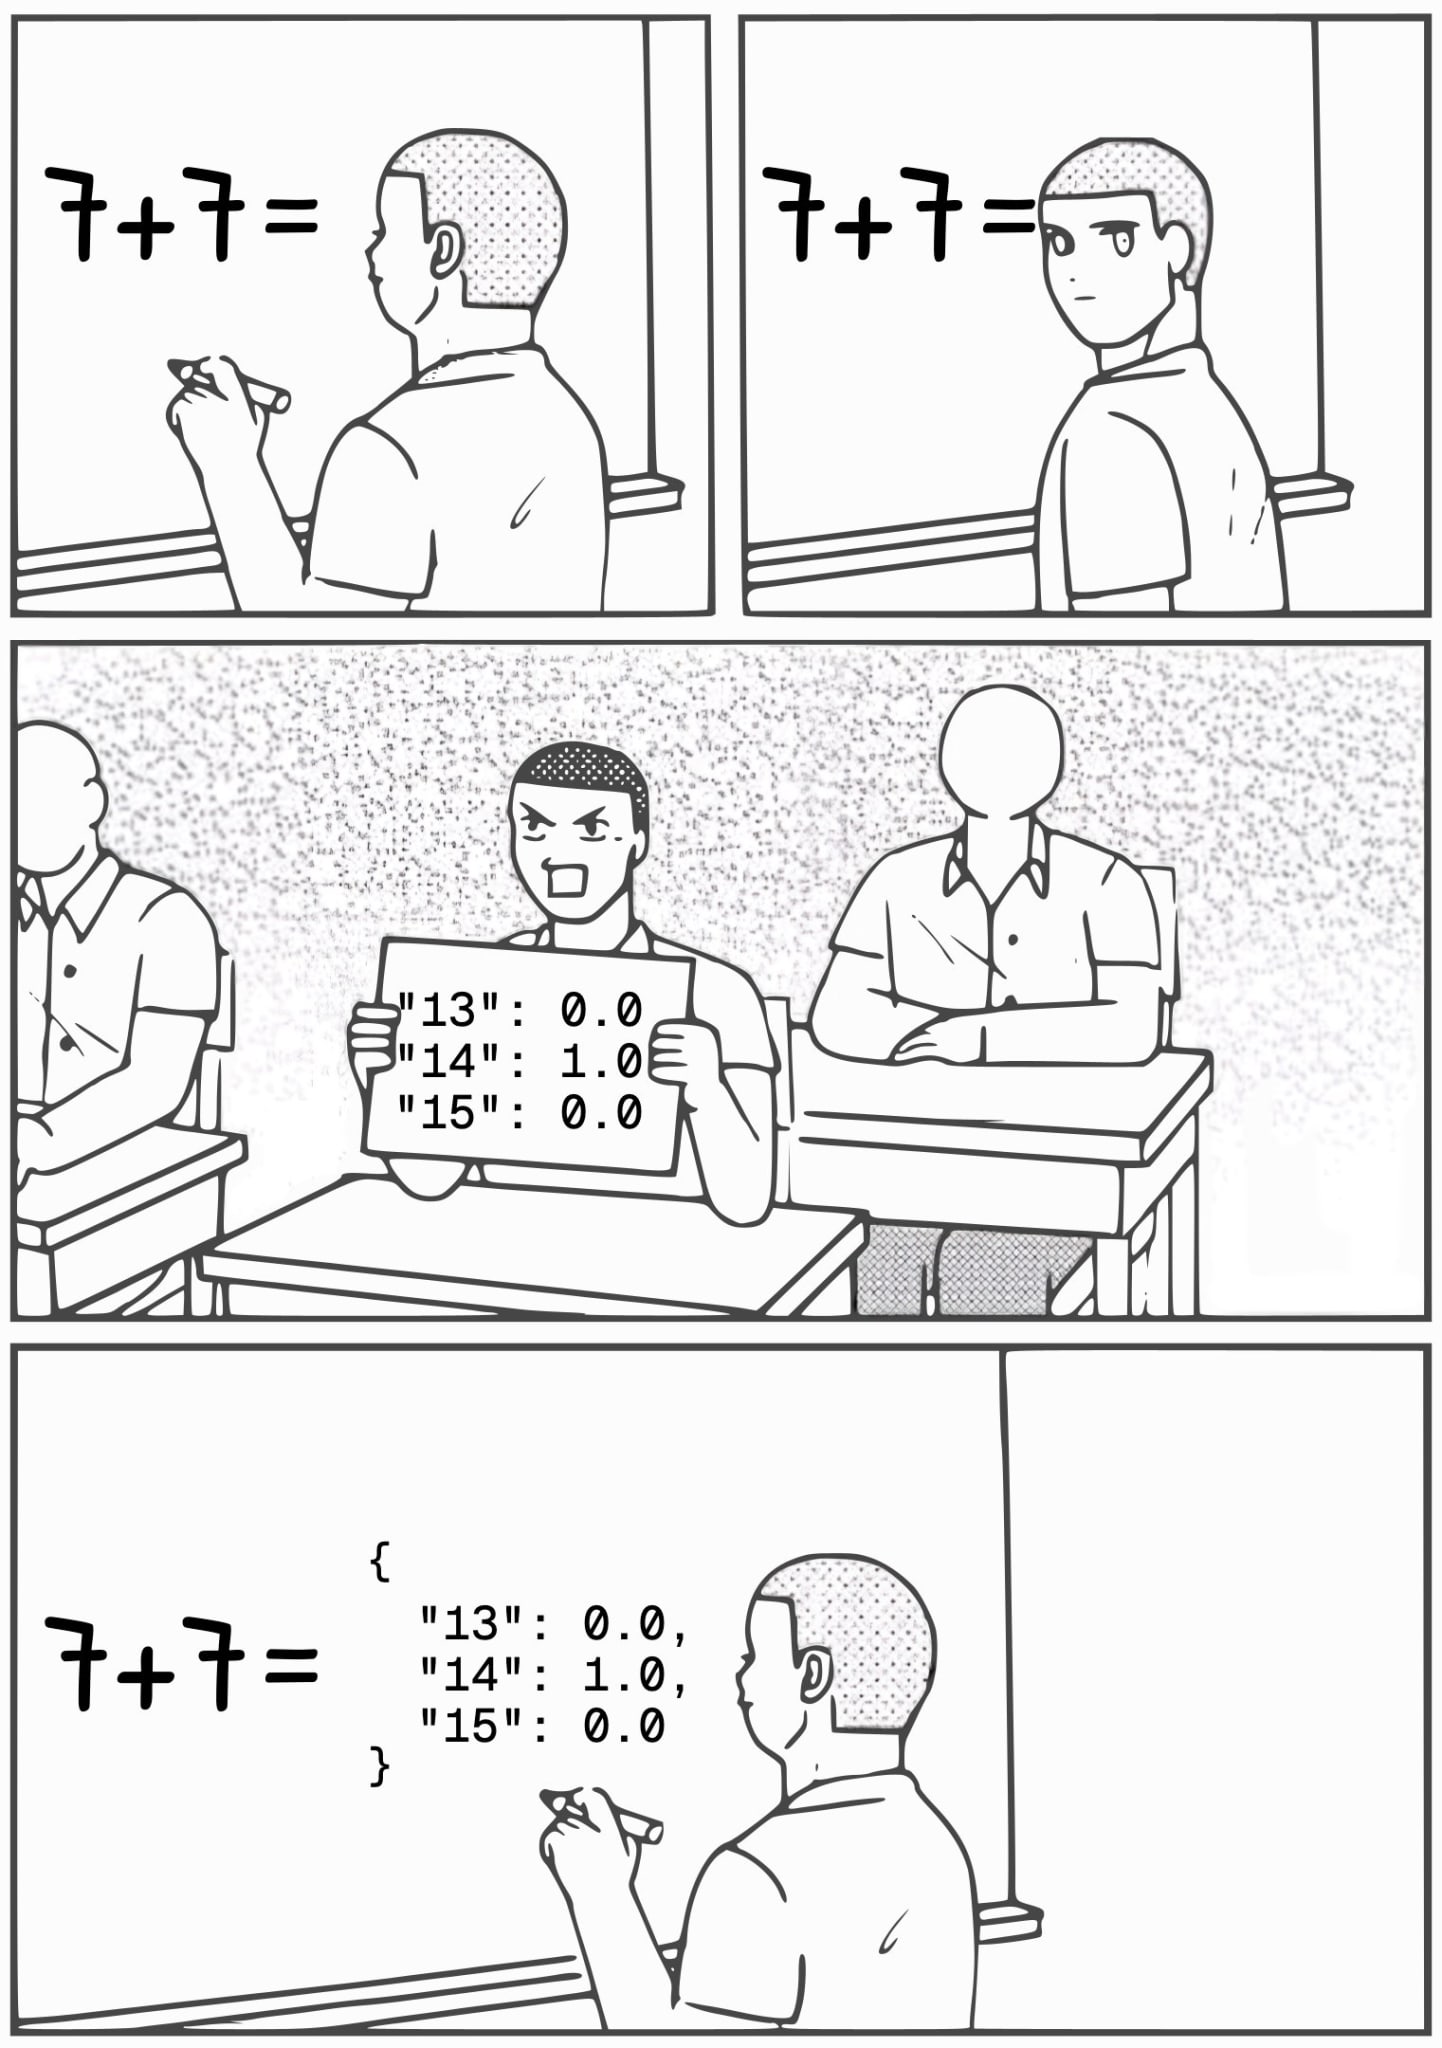
Компания TypeSafe выпустила Jev [1], модель, которая не пишет текст. Она принимает вопрос вместе со списком заранее описанных вариантов и возвращает вероятность по каждому. Заявлено, что это в 20–200 раз быстрее и в 40–400 раз дешевле обычной модели, а выходные токены не тарифицируются вообще, потому что их попросту нет. Свободный текст Jev выдать не умеет и языковой моделью общего назначения не является.
Звучит как шаг назад в 2018 год, и в первые дни комьюнити реагировало именно так: те, кто пришёл в ML после ChatGPT, восприняли это как откровение, а те, кто застал эпоху классификаторов, недоумевали, из-за чего шум. Практический смысл при этом есть. В продакшене огромная доля вызовов LLM приходится не на творчество [2], а на развилки: к какому агенту отправить запрос, годится ли полученный ответ, какую из пяти цитат подставить, эскалировать тикет или закрыть. На такой развилке авторегрессия, то есть пословная генерация ответа, оказывается чистым накладным расходом.
Я уже разобрал API решений Jev и пятнадцать проектов на нём [3], бегом читать! Jev выигрывает ровно тогда, когда вы сами заранее корректно описали пространство допустимых ответов. Если список вариантов кривой, быстрая и дешёвая модель просто быстро и дёшево ошибётся.
Веса TypeSafe не открыла, и за два дня комьюнити выкатило шесть клонов [4]. В Bespoke Labs собрали Nimble [5]: LoRA-дообучение Qwen3.5-9B (правят небольшую добавку к весам вместо полного переобучения) на 2676 примерах контрастной разметки. Для обучения [6] берут два почти одинаковых текста, меняют один факт, и правильный ответ переворачивается. На своей отложенной выборке из 324 примеров Nimble совпала с эталоном в 90,12% случаев против 93,21% у Jev и 66,36% у необученной Qwen, медиана времени ответа на H100 составила 106 мс против 246,7 мс у облачного Jev.
В Laya [7] всего 421 млн параметров на энкодере ModernBERT-large. Её обучали на примерах со строго заданными правилами оценки, чтобы выданная вероятность означала ровно то, что написано, а не просто ранжировала варианты. Авторы заявляют 32,8 мс на вопрос и точность 0,766 против 0,727 у Jev на собственном наборе типизированных решений. Репозиторий за три дня собрал 6,3 тысячи звёзд. Самый компактный вариант, Kev-0.5B [8], построен на Qwen2.5-0.5B и запускается на MacBook Pro.
Цифры у всех трёх посчитаны на своих же данных, и это главная проблема свежей категории. Общего бенчмарка для моделей-решателей пока не существует, поэтому демки соревнуются в скорости, а не в качестве, и сравнивать их между собой честно нечем. Техноблогер Theo [9] раскритиковал одно из модных применений Jev: гонять модель построчно на компактизацию, то есть на сжатие накопленной истории агента под размер контекста, значит не понимать, как эта история работает. Выбрасывая скрытые куски рассуждений, вы деградируете флагманскую модель, а любая правка истории обнуляет кеш префикса, и править историю получается дороже, чем оставить её как есть. В LangChain при этом считают работу с браузером [10] лучшим применением Jev из увиденного: там развилок много, они мелкие и однотипные.
Две новые работы об обвязке модели пришли к разным выводам. Microsoft в Is Bash All You Need? [11] сравнила пять вариантов инструментария на TheAgentCompany и APEX-Agents, двух наборах офисных и корпоративных задач для агентов, с Opus 4.8 и GPT-5.5. Голый bash обошёл типизированные каталоги инструментов на 21,8–24,5 пункта на первом наборе и на 4,8–7,4 на втором, потратив при этом на 19–72% меньше токенов. Добавление типизированных инструментов поверх bash прироста не дало вовсе.
Вторая работа, An Empirical Study of Harness Design for Coding Agents [12], прогнала 176 конфигураций обвязки на четырёх моделях через SWE-bench Verified и даёт более аккуратный вывод. Модели, которые хорошо владеют bash, действительно дешевле работают вообще без предопределённых инструментов, а вот моделям послабее типизированный набор помогает. Планирование ведёт себя похоже: слабым оно подпирает точность, сильным экономит деньги. Я разбирал исходники Codex, OpenCode и Pi [13] летом и тогда же писал, что архитектура обвязки решает больше самой модели.
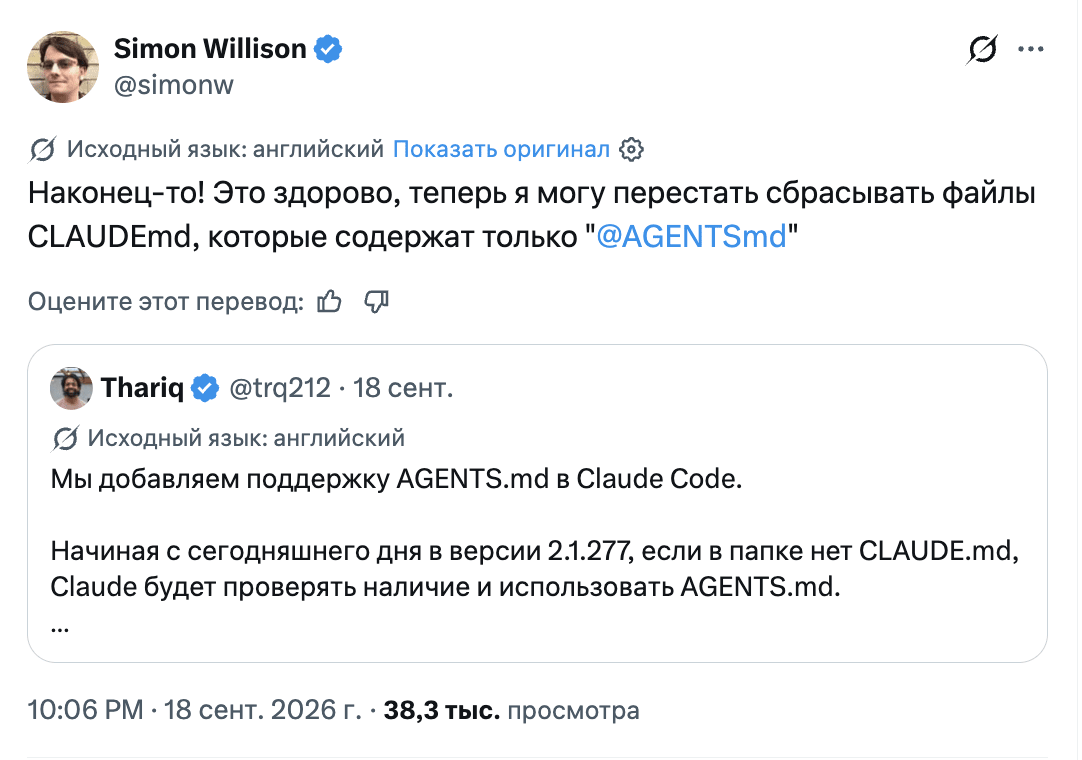
Наконец закончилась война форматов файла с инструкциями для агента. В Claude Code 2.1.277 [14] появилось чтение AGENTS.md [15]: если в проекте нет CLAUDE.md [16], агент берёт инструкции оттуда. Режим можно переключить через /config, но на Bedrock, Vertex и Foundry эта поддержка пока не работает. Саймон Уиллисон [17], который давно ведёт хронику инструментов вокруг LLM, сразу отметил практический итог: больше не нужны файлы-заглушки, которые всю дорогу ссылались друг на друга. AGENTS.md [15] поддерживают Codex, Cursor, Copilot, Jules и ещё пара десятков инструментов, так что последним держаться за свой формат было уже незачем.
Там же, в Claude Code, появились Projects [18]. Один разговор превращается в координатора: вы кидаете туда баг-репорт, трейс или список задач, а Claude заводит под каждую свою ветку. Каждая ветка это полноценная облачная сессия Claude Code, ветки идут параллельно, продолжают работать после закрытия ноутбука, а следить за ними и поправлять их можно с телефона. Пока это публичная бета на Pro и Max, раскатывают постепенно и начали с тех, кто уже пользовался облачными сессиями, на Team и Enterprise не завезли.
Оплачивать этот праздник оркестрации предлагается из сократившейся квоты. Акция с повышенными на 50% недельными лимитами, которая шла с 13 мая, закончилась 13 сентября, и с 14-го недельный лимит Claude Code зафиксирован на 25% выше доакционного уровня для Pro, Max, Team и Enterprise с оплатой по местам. Относительно того, чем люди пользовались всё лето, это минус 17%, и в r/ClaudeCode встретили новость соответственно [19]. В соседнем треде [20] владелец тарифа Max 20x показывает скриншот, где недельный лимит по всем моделям выбран на 100% при 78% по Fable, и жалуется, что сотня долларов кредитов ушла за полчаса. Совет в комментариях единодушный: кредиты не докупать, они сгорают быстрее, чем кажется.
Лично я отменил свою Claude Max за $200. До этого держал его вместе с ChatGPT Pro за те же $200 и распределял между ними разные задачи. Сначала казалось, что я выбираю между Astra/Sol и Fable/Opus. Потом понял, что при прочих равных выбор сводится к другому: писать код три дня (Claude) или четыре, да ещё и с возможностью сброса лимитов (ChatGPT).
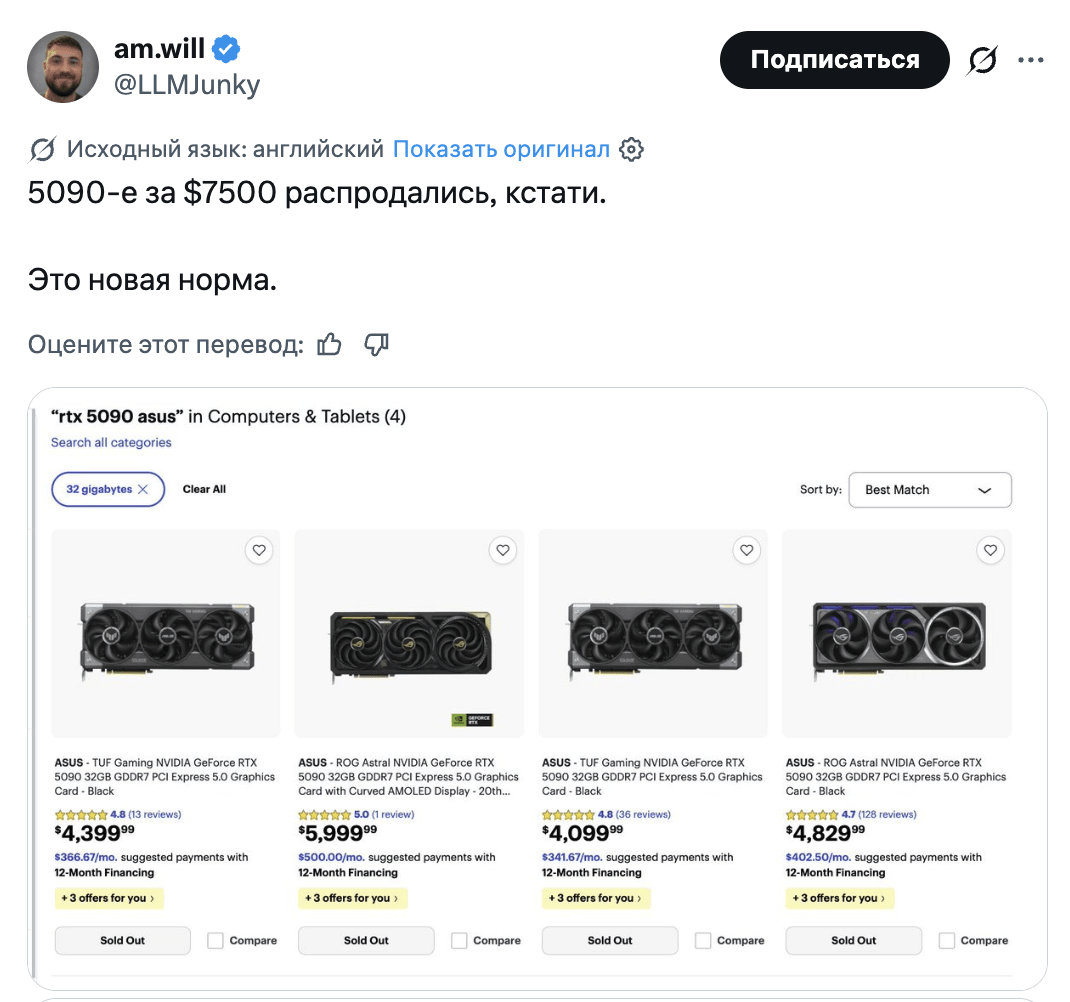
RTX 5090 при рекомендованной цене $1999 пропала из американской розницы [21], а у сторонних продавцов доходит до $9500. На r/LocalLLaMA пишут [22], что в ближайшем Micro Center из больших карт остались только RTX 6000 Pro примерно за $14000, а ноутбук с мобильной 5090 спустя год продаётся почти по цене покупки. Причины скучные и устойчивые: дефицит памяти [23] GDDR7 наложился на спрос со стороны инференса, и каждая карта, уехавшая крутить модели, это минус одна карта на полке. NVIDIA выложила спецификации RTX PRO 5500 Blackwell [24]: 84 ГБ памяти GDDR7 с коррекцией ошибок, 1398 ГБ/с, PCIe Gen 5 x16, до 600 Вт и MIG на два полностью изолированных инстанса: карту можно разрезать на две независимые виртуальные. Статус “coming soon”, цены нет, и в комьюнити гадают, не выйдет ли это отбракованным кристаллом от RTX PRO 6000.
Дарио Амодеи, глава Anthropic, написал личный пост про торможение [25] из трёх пунктов: встроенные сторонние оценщики, координация между демократиями и попытка договориться с авторитарными государствами. Первый пункт Anthropic берёт на себя в одностороннем порядке прямо сейчас: внешним оценщикам обещают столы в офисах, пропуска, корпоративные ноутбуки, доступ к рабочим средам, инструментам и правам примерно на уровне внутренних команд оценки рисков. Про Китай он осторожнее: сначала удержать технологический отрыв через ограничение продаж чипов, защиту весов от кражи и борьбу с несанкционированной дистилляцией, и только после этого заходить на глобальные договорённости.
AI Evaluator Forum, объединение оценщиков, куда входят METR, RAND, Transluce, SecureBio и другие, уже опубликовал минимальные условия встраивания оценщиков [26] за подписью больше сотни человек, включая нобелевского лауреата Джеффри Хинтона. Пунктов там пять: полный редакторский контроль и никаких выплат, зависящих от выводов; несколько организаций с разной экспертизой, а не одна; узкие NDA и право публиковать находки; защита от судебного давления и устойчивое финансирование даже после неприятных отчётов; права уровня привилегированного сотрудника с прямым доступом к людям и системам. Отдельно оговорено, что встроенные оценщики всех задач надзора не закрывают и внешнюю проверку не заменяют. Неделю назад я разбирал четыре инцидента Anthropic [27], в которых Claude во время испытаний вышел к реальным сторонним системам и зарегистрировал вредоносный пакет в PyPI, а расследование отдали METR. Теперь METR подписывает документ о том, на каких условиях вообще имеет смысл смотреть изнутри.
Оставайтесь любопытными.
Пишу об искусственном интеллекте [28], языковых моделях и инструментах для разработчиков. Тестирую модели и сервисы на реальных задачах, а выводами делюсь в телеграм-канале [29].
Автор: controlled_hallucinations
Источник [30]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/35813
URLs in this post:
[1] Jev: https://www.latent.space/p/ainews-jev-a-system-one-model-that
[2] творчество: http://www.braintools.ru/creation
[3] разобрал API решений Jev и пятнадцать проектов на нём: https://habr.com/ru/articles/1084030/
[4] шесть клонов: https://www.latent.space/p/ainews-here-are-6-clones-of-jev-in
[5] Nimble: https://github.com/bespokelabsai/nimble
[6] обучения: http://www.braintools.ru/article/5125
[7] Laya: https://github.com/NandhaKishorM/laya
[8] Kev-0.5B: https://x.com/jaredpalmer/status/2101028325472841920
[9] Theo: https://x.com/theo/status/2100762304862384257
[10] работу с браузером: https://x.com/hwchase17/status/2101054310037790814
[11] Is Bash All You Need?: https://arxiv.org/abs/2609.11999
[12] An Empirical Study of Harness Design for Coding Agents: https://arxiv.org/abs/2609.20804
[13] разбирал исходники Codex, OpenCode и Pi: https://habr.com/ru/articles/1060250/
[14] Claude Code 2.1.277: https://github.com/anthropics/claude-code/releases/tag/v2.1.277
[15] AGENTS.md: http://AGENTS.md
[16] CLAUDE.md: http://CLAUDE.md
[17] Саймон Уиллисон: https://x.com/simonw/status/2101025043098812807
[18] Projects: https://code.claude.com/docs/en/claude-projects
[19] встретили новость соответственно: https://www.reddit.com/r/ClaudeCode/comments/1wfwl6k/the_limits_have_been_reduced_even_further_now_its/
[20] соседнем треде: https://www.reddit.com/r/ClaudeCode/comments/1wf9uuf/wth_is_going_on_with_claude_usage_limits/
[21] пропала из американской розницы: https://www.tomshardware.com/pc-components/gpus/nvidias-rtx-5090-vanishes-from-online-retail-in-the-us-third-party-sellers-now-demand-as-much-as-usd9-500-for-nvidias-fastest-gpu
[22] пишут: https://www.reddit.com/r/LocalLLaMA/comments/1wft5v9/5090_stock_is_almost_gone/
[23] памяти: http://www.braintools.ru/article/4140
[24] RTX PRO 5500 Blackwell: https://www.nvidia.com/en-eu/products/workstations/professional-desktop-gpus/rtx-pro-5500/
[25] личный пост про торможение: https://darioamodei.com/post/we-must-pace-the-frontier
[26] минимальные условия встраивания оценщиков: https://aievaluatorforum.org/initiatives/embedded-evaluation-letter
[27] разбирал четыре инцидента Anthropic: https://gotacat.dev/blog/weekly-ai-hallucinations-deepseek-v-4-1-flash-meta-muse-gpt-6-astra-fable-5-1
[28] интеллекте: http://www.braintools.ru/article/7605
[29] телеграм-канале: https://t.me/+A_SuHPWU_CIyZjAy
[30] Источник: https://habr.com/ru/news/1084884/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1084884
Нажмите здесь для печати.