Давай по новой, Миша: speculative decoding от черновика до проверки
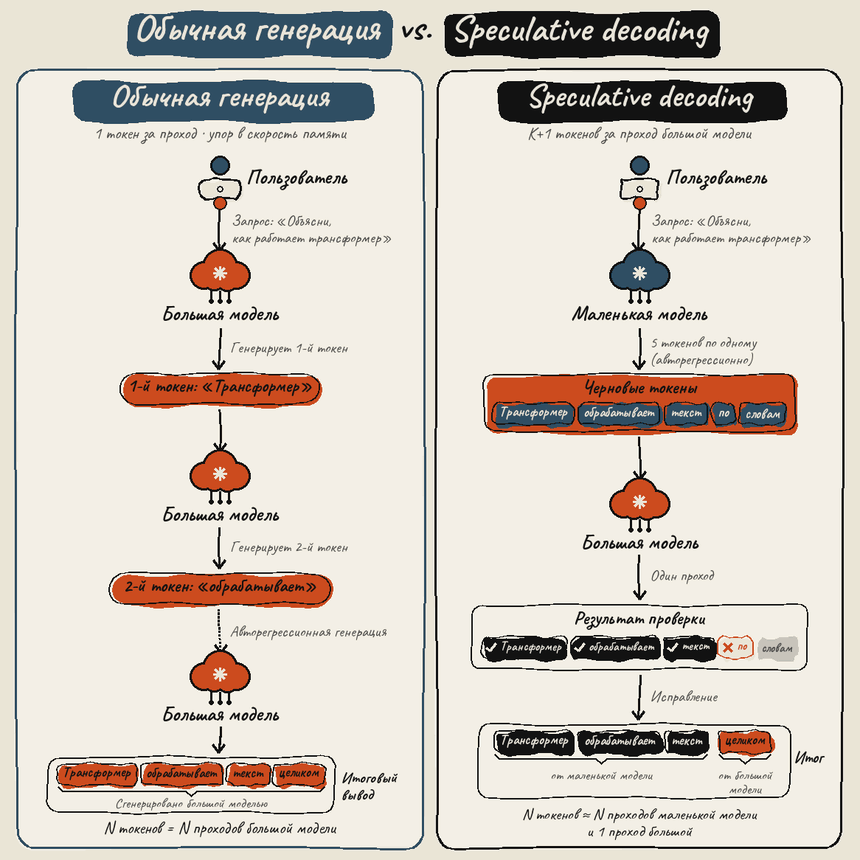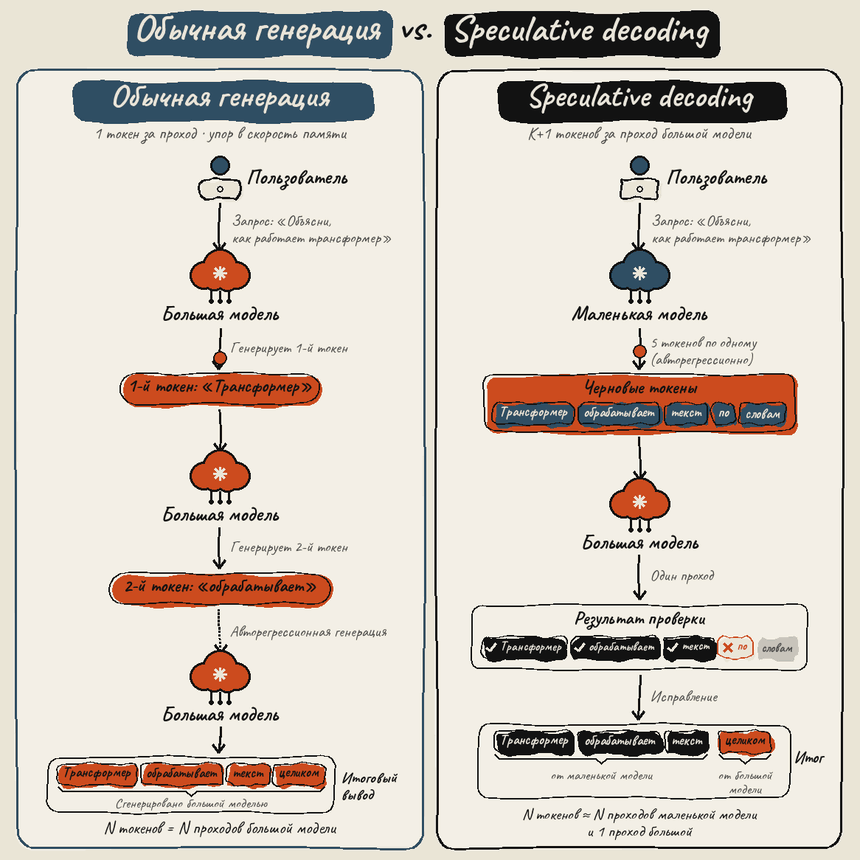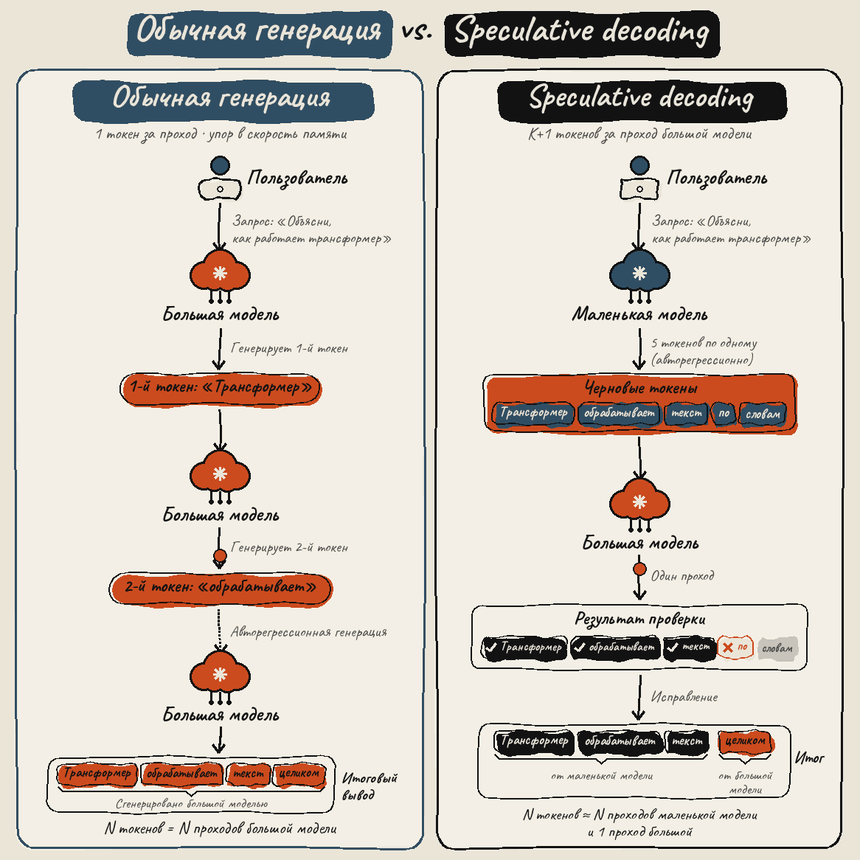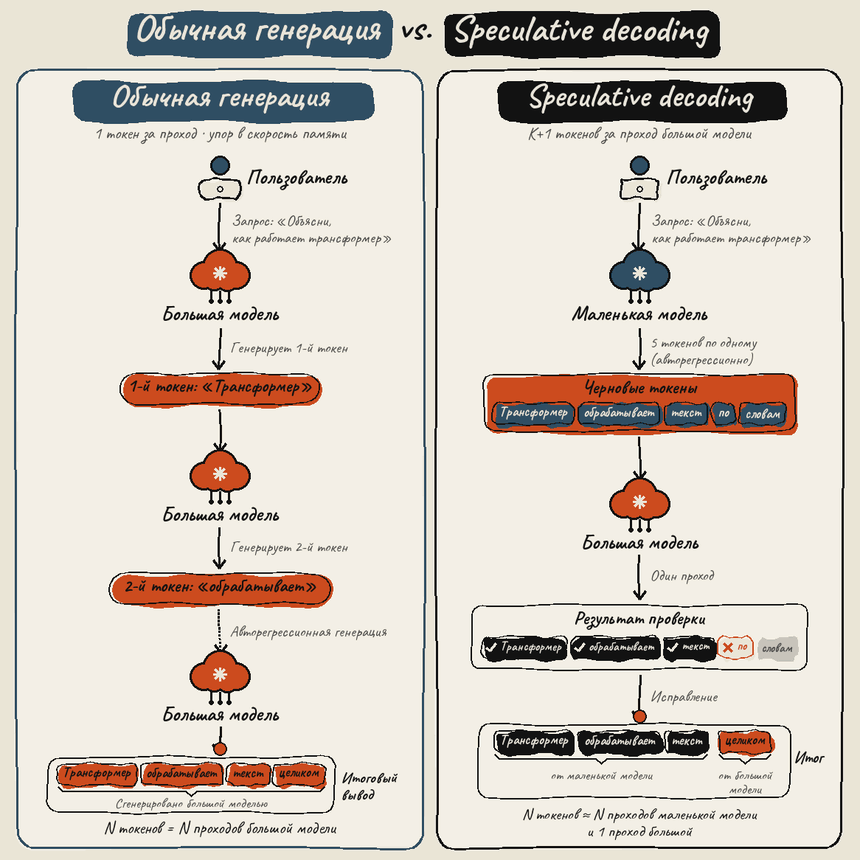
Маленькая модель быстро генерирует несколько следующих токенов, а большая проверяет их сразу одной пачкой. Подходящие токены принимаются, а с первого расхождения большая модель продолжает генерацию сама. При корректной реализации итоговое распределение остаётся тем же, что и при обычном декодировании. В speculative decoding большая модель буквально говорит черновой: «Давай по новой, Миша».
На первый взгляд кажется, что ускорение здесь обязательно покупается ценой качества. Но нет: это как раз тот случай, когда можно ускорить генерацию без такого компромисса.
Причина в том, как работает инференс большой модели. При генерации каждого следующего токена ей приходится обращаться к огромному объёму весов в памяти [1]. Для современных LLM это десятки, а иногда и сотни гигабайт данных. Поэтому генерация часто упирается не столько в вычислительную мощность GPU, сколько в пропускную способность памяти.
Speculative decoding позволяет часть этой последовательной работы объединить. Вместо проверки одного токена за проход большая модель проверяет сразу несколько предложенных токенов, лучше загружая GPU.
Далее попытаемся разобраться во всем цикле: как работает черновая модель, по какому правилу принимаются токены, какого размера должен быть draft, почему важен одинаковый токенизатор и как всё это включить в Transformers и vLLM. Отдельно посмотрим на подходы, где вторая модель вообще не нужна: EAGLE, Medusa, LayerSkip и DFlash.
Google использует [2] технику speculative decoding в AI Overviews. Типичный выигрыш – 2–3×, но он сильно зависит от доли принятых токенов и цены черновика.
Почему генерация вообще такая медленная?
Модель на 70 млрд параметров в FP16 занимает примерно 140 ГБ. И каждый токен требует полного прохода по всем этим весам. Генерация авторегрессионная: следующий токен не посчитать, не получив предыдущий.
Прикинем порядок величины. Пропускная способность памяти H100 около 3,35 ТБ/с. Значит, только перемещение 140 ГБ весов занимает примерно 42 мс на токен. То есть верхняя граница получается около 24 токенов в секунду и мы ещё ничего не вычислили, просто перегнали веса.
Есть, конечно, важная оговорка, 140 ГБ весов не помещаются в одну H100 с 80 ГБ памяти. На практике такую модель распределяют между несколькими GPU, например с помощью tensor parallelism. Если использовать две карты, каждая хранит и читает примерно половину весов около 70 ГБ. Теоретическое время чтения сокращается примерно до 21 мс, но теперь появляется другая цена: на каждом слое картам приходится обмениваться данными.
Конкретные цифры меняются в зависимости от железа, размера батча, квантизации и схемы параллелизма, но общая картина остаётся той же: при последовательной генерации LLM часто упирается прежде всего в пропускную способность памяти.
Отсюда и многие способы ускорения инференса. Квантизация уменьшает объём весов, который приходится читать. Батчинг позволяет использовать один проход по весам сразу для нескольких запросов. MoE активирует только часть параметров модели. Speculative decoding подходит к той же проблеме с другой стороны: пытается получить больше одного полезного токена за один проход большой модели.
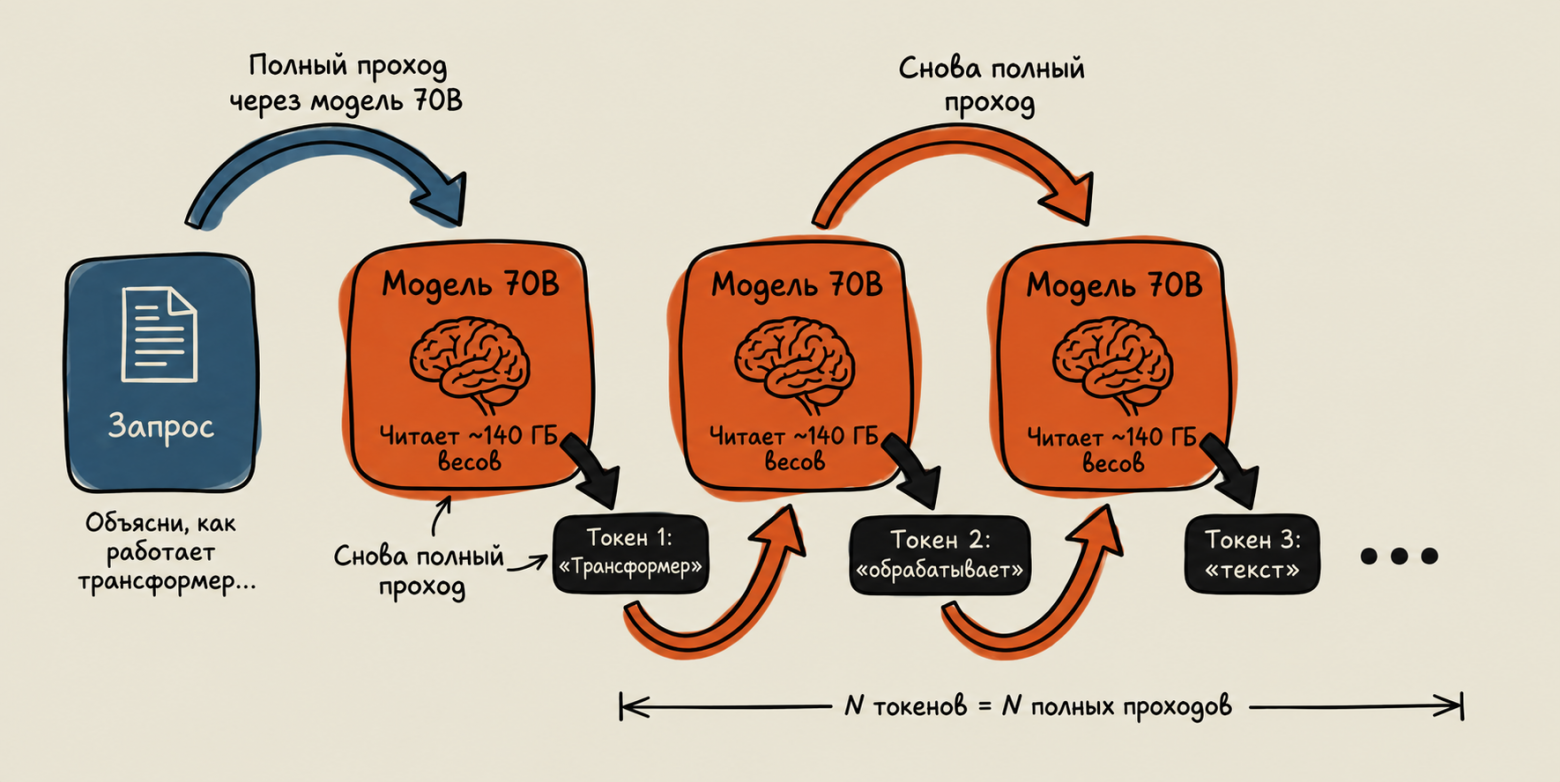
И вот наблюдение, на котором держится вся идея: заметная часть токенов предсказуема. В устойчивых выражениях продолжение тоже нередко очевидно. То же касается служебных слов, знаков пунктуации и многих фрагментов кода. Для таких случаев модель, которая в десятки раз меньше основной, часто предлагает тот же следующий токен.
Так зачем запускать большую модель отдельно ради каждого такого токена?
Как это работает
Возьмём простую схему из двух моделей: небольшой draft-модели (черновой) и целевой, target-модели.
-
Черновая модель (например, Qwen2.5-0.5B) авторегрессионно генерирует
 токенов, скажем 5. Она в сто раз меньше целевой, так что это стоит порядка процента-двух от одного прохода большой модели.
-
Целевая модель (например, Qwen2.5-7B) обрабатывает все 5 токенов черновика за один проход, структурно это то же самое, что префилл. В этот момент GPU наконец загружен вычислениями, а не ожиданием памяти.
-
Токены черновика проверяются слева направо. Первые подряд совпавшие принимаются, на первом расхождении целевая модель подставляет свой токен (он уже посчитан в том же проходе), всё, что правее, отбрасывается.
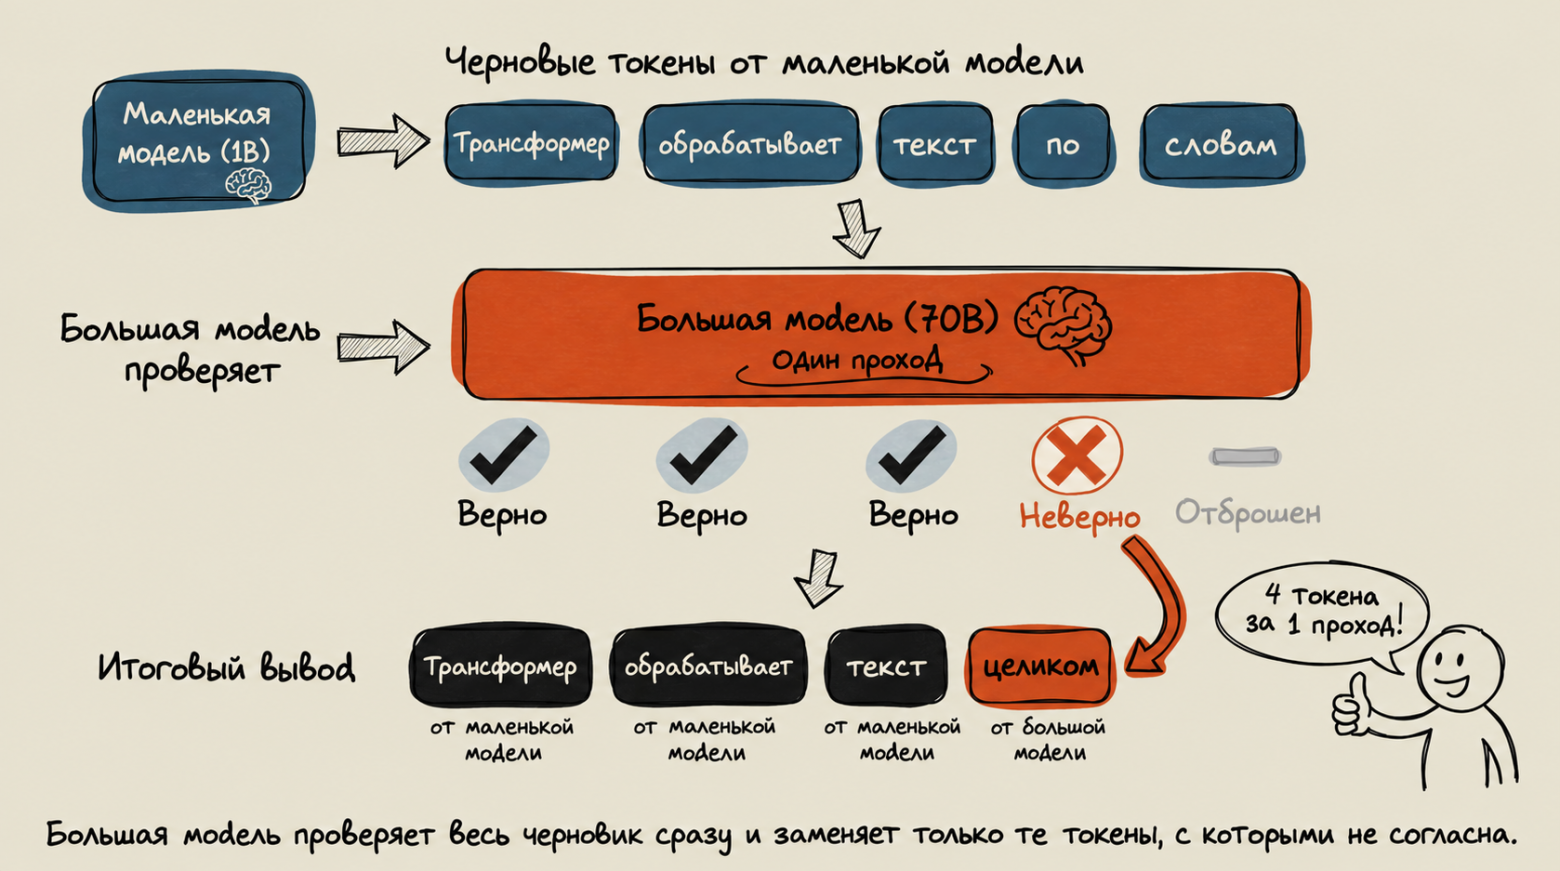
В лучшем случае основная модель принимает все пять предложенных токенов. При классической схеме из того же прохода можно получить ещё один следующий токен – итого шесть токенов вместо шести последовательных запусков большой модели.
В худшем случае первый же токен черновика не проходит проверку. Тогда за итерацию получится примерно тот же один полезный токен, что и при обычном декодировании, только к стоимости основной модели добавится работа draft-модели.
То есть speculative decoding не гарантирует ускорение на каждом шаге. Всё решает то, насколько часто черновая модель угадывает продолжение достаточно хорошо.
Для sampling схема проверки немного сложнее: токены не просто сравниваются на равенство. Используется вероятностное правило принятия, которое и позволяет сохранить исходное распределение target-модели. К нему вернёмся ниже.
Почему ответ не портится?
Часто объясняют так: токен принимается, только если большая модель предсказала бы тот же самый. Для жадного декодинга (temperature = 0) это правда, там проверка и сводится к сравнению argmax. Но при сэмплировании работает другой механизм и именно он даёт гарантию.
Пусть  – это вероятность токена у черновой модели,
 — у целевой. Токен черновика принимается с вероятностью
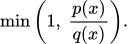
Если токен отвергнут, новый токен сэмплируется из остаточного распределения
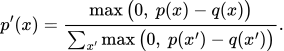
Именно эта коррекция компенсирует те токены, которые черновая модель предлагала слишком часто. В результате после процедуры принятия и отклонения итоговый токен имеет то же распределение  , что и при обычном сэмплировании непосредственно из целевой модели.
Качество draft-модели на эту гарантию не влияет. Если она плохо предсказывает продолжение, большая часть токенов будет отклоняться и ускорение исчезнет. Но само распределение результата от этого не изменится.
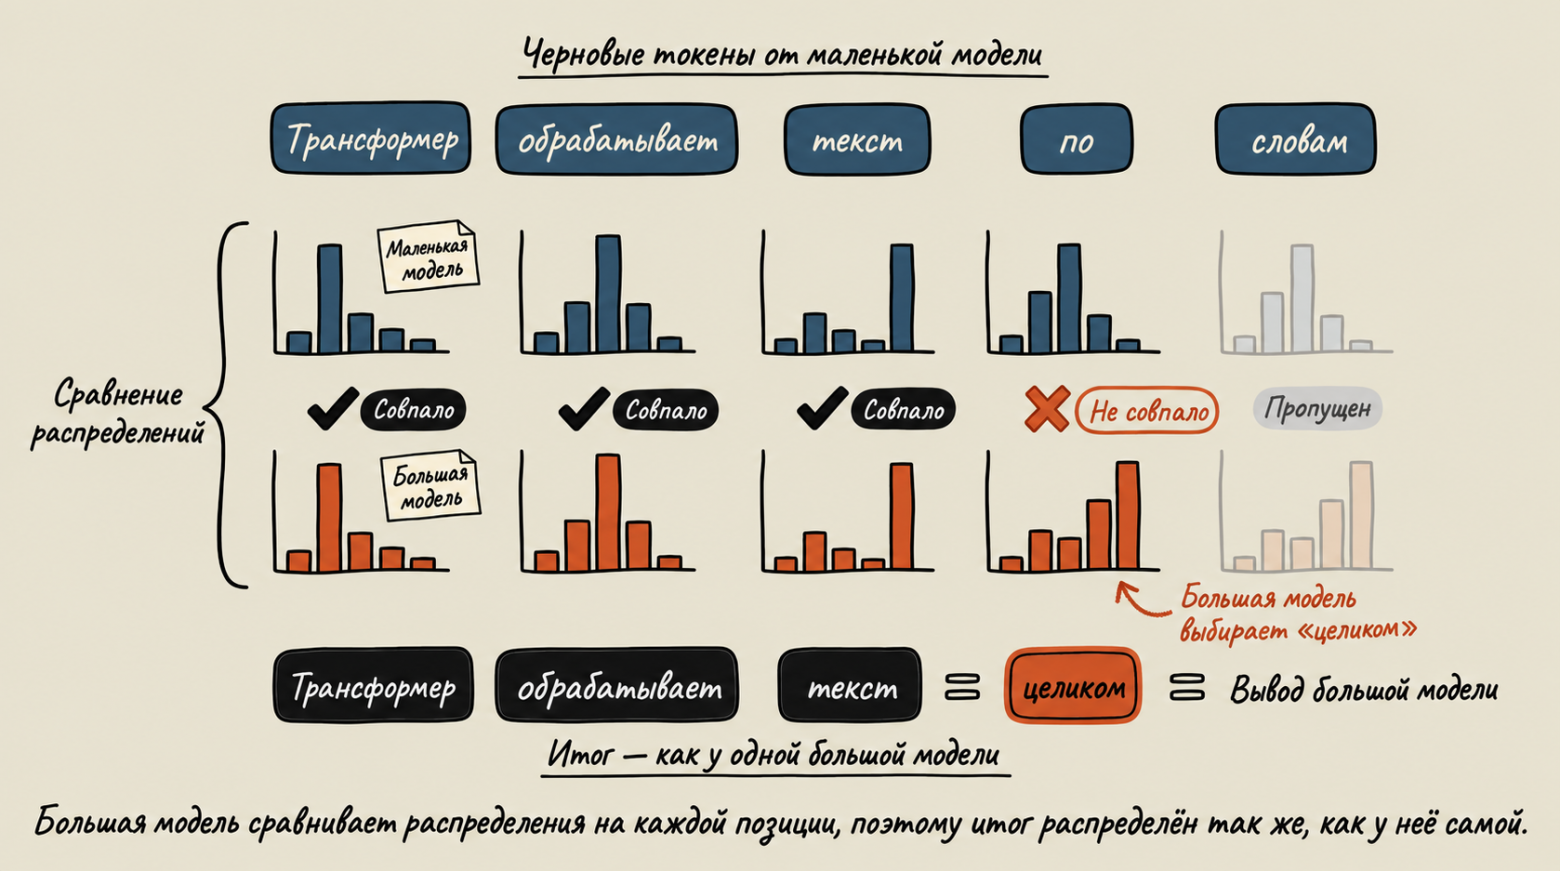
Здесь есть важное уточнение. «То же распределение» не означает «та же последовательность токенов». При сэмплировании генерация изначально случайна, поэтому два запуска могут дать разные ответы даже без speculative decoding.
И даже при жадном декодинге абсолютная побитовая воспроизводимость на GPU не всегда гарантирована. Обычный decode и проверка сразу нескольких токенов могут использовать разные CUDA-ядра и другой порядок операций с плавающей точкой. Обычно это ни на что не влияет, но при почти равных логитах небольшой численный сдвиг иногда способен изменить argmax.
Если регрессионные тесты требуют полного совпадения строк между разными режимами инференса, этот эффект стоит учитывать.
Сколько это даёт?
Теперь можно оценить, какой выигрыш вообще возможен.
Обозначим через  вероятность, что токен черновика будет принят (acceptance rate), и для простоты она не зависит от позиции. Тогда ожидаемое число токенов за один проход целевой модели при длине черновика
 это формула из исходной статьи Leviathan et al. [3]:
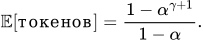
Если один проход черновой модели стоит долю  от прохода целевой, ожидаемое ускорение по времени:
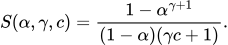
Удобнее пощупать это кодом:
def expected_tokens(alpha: float, gamma: int) -> float:
    return (1 - alpha ** (gamma + 1)) / (1 - alpha)

def speedup(alpha: float, gamma: int, c: float) -> float:
    return expected_tokens(alpha, gamma) / (gamma * c + 1)


def best_gamma(alpha: float, c: float, max_gamma: int = 15) -> tuple[int, float]:
    g = max(range(1, max_gamma + 1), key=lambda k: speedup(alpha, k, c))
    return g, speedup(alpha, g, c)


print(f"{expected_tokens(0.8, 5):.2f}")  # 3.69 токена за проход
print(f"{speedup(0.8, 5, 0.05):.2f}")    # 2.95x
print(best_gamma(0.6, 0.2))              # (2, 1.40...)
Ускорение при  :
|
Цена черновика |
|
|
|
|
|---|---|---|---|---|
|
0,01 |
2,27× |
2,80× |
3,51× |
4,46× |
|
0,05 |
1,91× |
2,35× |
2,95× |
3,75× |
|
0,10 |
1,59× |
1,96× |
2,46× |
3,12× |
|
0,20 |
1,19× |
1,47× |
1,84× |
2,34× |


Из таблицы хорошо видны несколько вещей.
Доля принятых токенов важнее всего. При  рост
 с 0,6 до 0,8 увеличивает ускорение с 1,91× до 2,95×. Для сравнения: если оставить
 , но сделать draft в пять раз дешевле, ускорение вырастет только с 1,91× до 2,27×.
Поэтому хороший draft это не обязательно самый маленький. Он должен быть достаточно дешёвым, но при этом хорошо предсказывать target-модель.
**Длину черновика надо подбирать, а не ставить «побольше».**Каждый дополнительный токен увеличивает шанс продвинуться дальше, но за него приходится платить ещё одним шагом draft-модели.
При  и
 максимум этой простой модели находится примерно на
 : около 3,09×. А при
 и
 оптимальны всего два токена примерно 1,40×. Дальнейшее увеличение черновика уже начинает съедать выигрыш.
Большая черновая модель не всегда лучше. Хороший пример есть в бенчмарке AMD с Llama 3.1 70B. С Llama 3.2 1B в роли draft они получили ускорение 2,31×, с Llama 3.2 3B – 2,28×, а с Llama 3.1 8B – 2,04×.
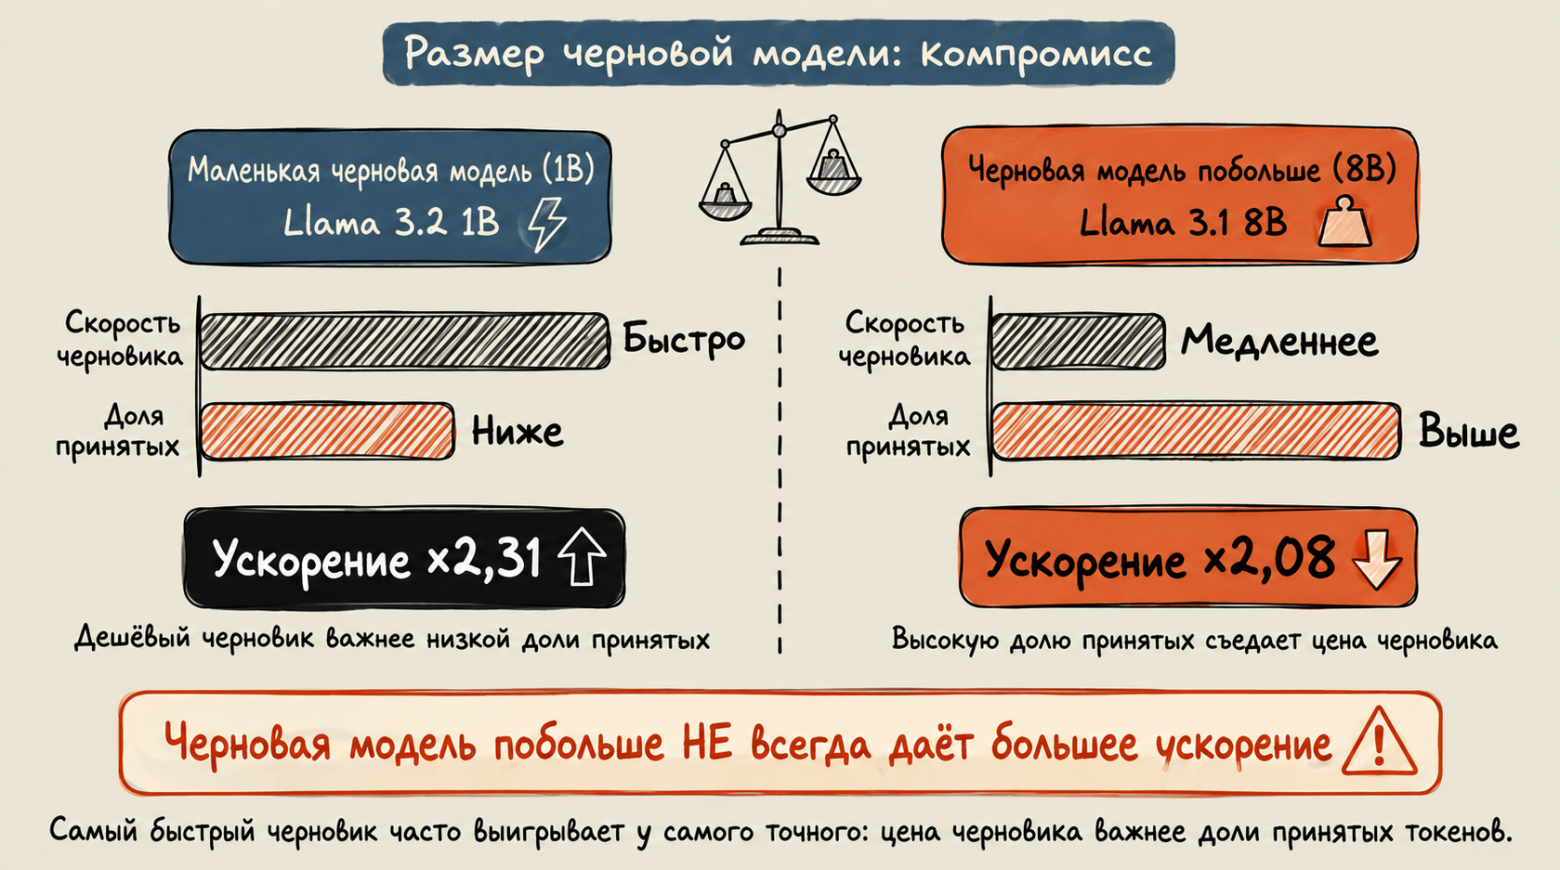
Причина ровно та, которую показывает формула: более сильный draft может чаще попадать в распределение target-модели, но если каждый его шаг стал заметно дороже, дополнительный acceptance rate уже не окупается.
С температурой картина тоже меняется. При greedy decoding обе модели просто сравниваются по наиболее вероятному токену, и близкие модели часто хорошо совпадают. При sampling важнее уже не совпадение argmax, а то, насколько похожи распределения  и
 . Поэтому изменение temperature может заметно поменять acceptance rate и итоговое ускорение. Как именно, это уже зависит от конкретной пары моделей и задачи.
И здесь важно не воспринимать формулу как предсказатель реальной скорости до второго знака. Она хорошо показывает баланс между длиной черновика, его ценой и acceptance rate, но настоящий результат дополнительно зависит от реализации verification, размера батча, KV-cache, длины контекста, параллелизма и конкретного железа.
Попробовать за пять минут: Hugging Face Transformers
В Transformers speculative decoding включается практически одной строкой: достаточно передать черновую модель через assistant_model в generate().
Для простого примера возьмём OPT-6.7B в качестве основной модели и OPT-125M в качестве черновой. Они используют один токенизатор, поэтому дополнительного согласования токенов не требуется.
import time

import torch
from transformers import AutoModelForCausalLM, AutoTokenizer


TARGET = "facebook/opt-6.7b"
DRAFT = "facebook/opt-125m"

tokenizer = AutoTokenizer.from_pretrained(TARGET)

target = AutoModelForCausalLM.from_pretrained(
    TARGET,
    torch_dtype=torch.float16,
    device_map="auto",
)

draft = AutoModelForCausalLM.from_pretrained(
    DRAFT,
    torch_dtype=torch.float16,
    device_map="auto",
)

inputs = tokenizer(
    "Explain how transformers process input tokens.",
    return_tensors="pt",
).to(target.device)


def timed(**kwargs):
    torch.cuda.synchronize()
    t0 = time.perf_counter()

    out = target.generate(
        **inputs,
        max_new_tokens=200,
        do_sample=False,
        **kwargs,
    )

    torch.cuda.synchronize()
    elapsed = time.perf_counter() - t0
    n_tokens = out.shape[1] - inputs.input_ids.shape[1]

    return elapsed, n_tokens / elapsed


# Прогреваем CUDA и обе схемы генерации.
target.generate(
    **inputs,
    max_new_tokens=10,
    do_sample=False,
)

target.generate(
    **inputs,
    max_new_tokens=10,
    do_sample=False,
    assistant_model=draft,
)

# Сравниваем обычную генерацию с генерацией через черновую модель.
baseline_time, baseline_tps = timed()
spec_time, spec_tps = timed(assistant_model=draft)

print(
    f"Без speculative decoding: {baseline_time:.2f} с, "
    f"{baseline_tps:.1f} ток/с"
)
print(
    f"Со speculative decoding: {spec_time:.2f} с, "
    f"{spec_tps:.1f} ток/с"
)
print(f"Ускорение: ×{spec_tps / baseline_tps:.2f}")
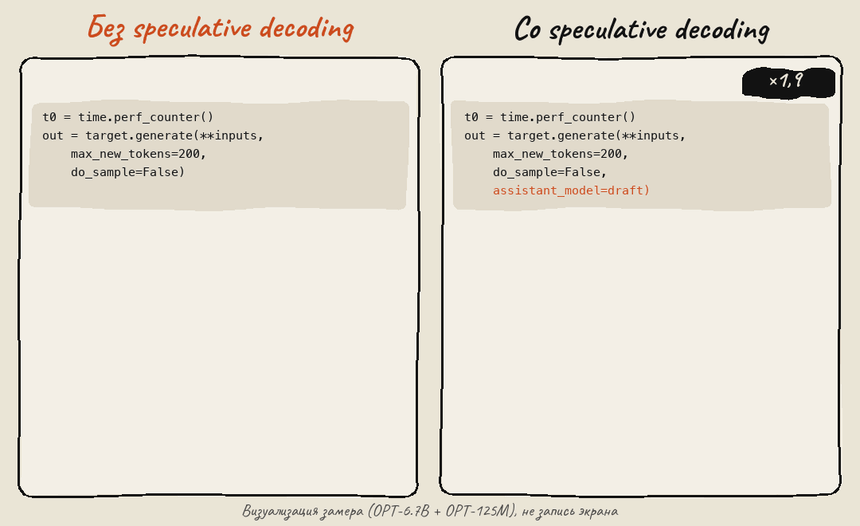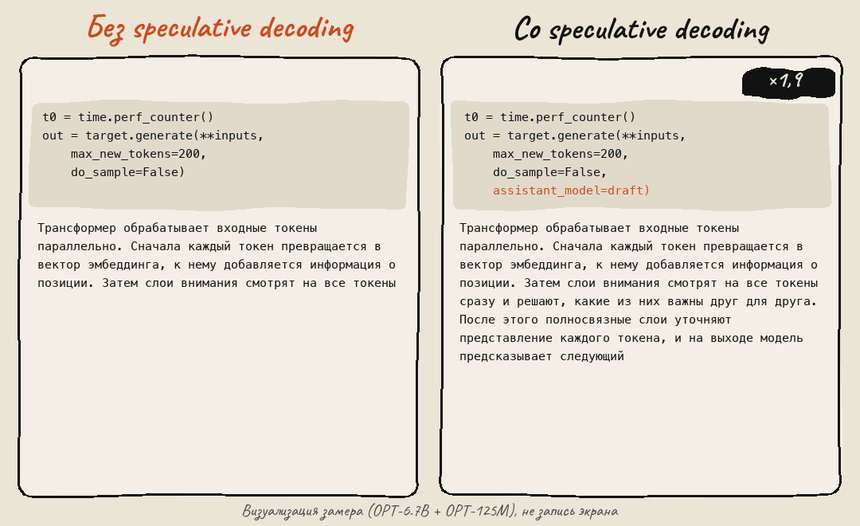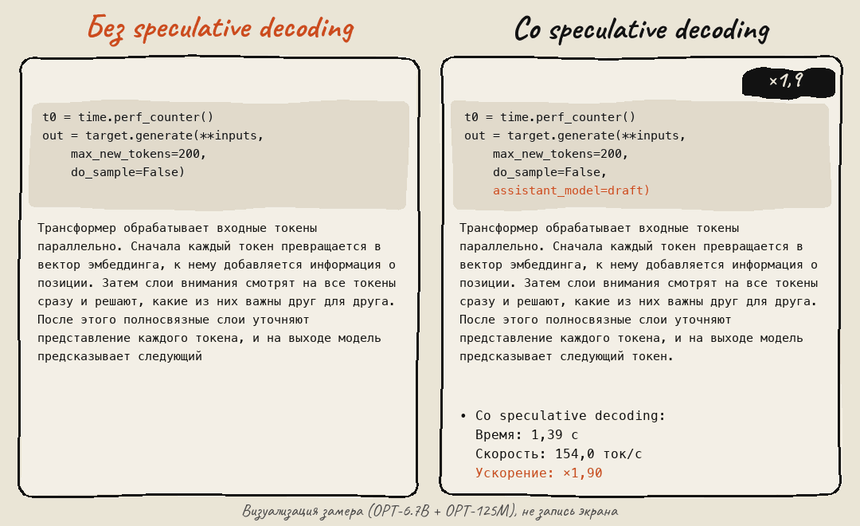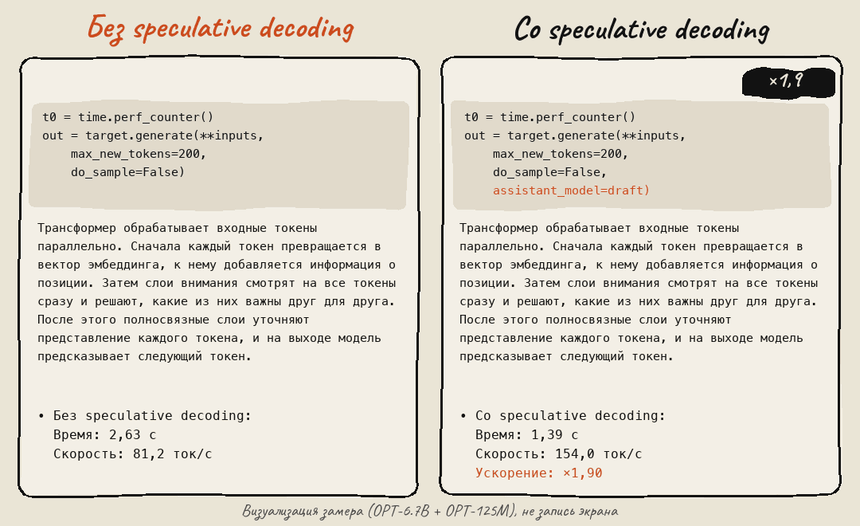
На конкретном железе цифры будут другими, но вывод может выглядеть примерно так:
Без speculative decoding:   2,63 с,   81,2 ток/с
Со speculative decoding:    1,39 с,  154,0 ток/с
Ускорение:                  ×1,90
Здесь важно сравнивать именно две схемы на одной и той же машине, с одинаковым промптом и параметрами генерации. Абсолютное число токенов в секунду сильно зависит от GPU, версии PyTorch и Transformers, длины контекста и других деталей реализации.
Если добавить TextStreamer, разница становится заметна и без секундомера. При обычном декодировании текст появляется почти равномерно, токен за токеном. С speculative decoding вывод может приходить небольшими рывками: когда несколько предложений draft-модели проходят проверку, целевая модель принимает сразу несколько токенов.
Сам assistant_model – это только самый простой вариант. Transformers умеет динамически менять длину черновика в зависимости от того, насколько уверенно работает assistant-модель, поэтому реальная схема уже не обязана проверять фиксированные пять токенов на каждой итерации.
Почему нельзя взять любую маленькую модель?
В классическом speculative decoding у target и draft-моделей должен совпадать токенизатор.
Причина довольно простая. Проверка идёт по токенам: для каждой позиции нужно сопоставить предложение черновой модели с распределением целевой. Если словари разные, такой прямой проверки уже не получается.
Один и тот же текст две модели могут разбить по-разному. У одной слово окажется двумя токенами, у другой тремя. После этого не совпадают ни позиции, ни сами идентификаторы токенов.
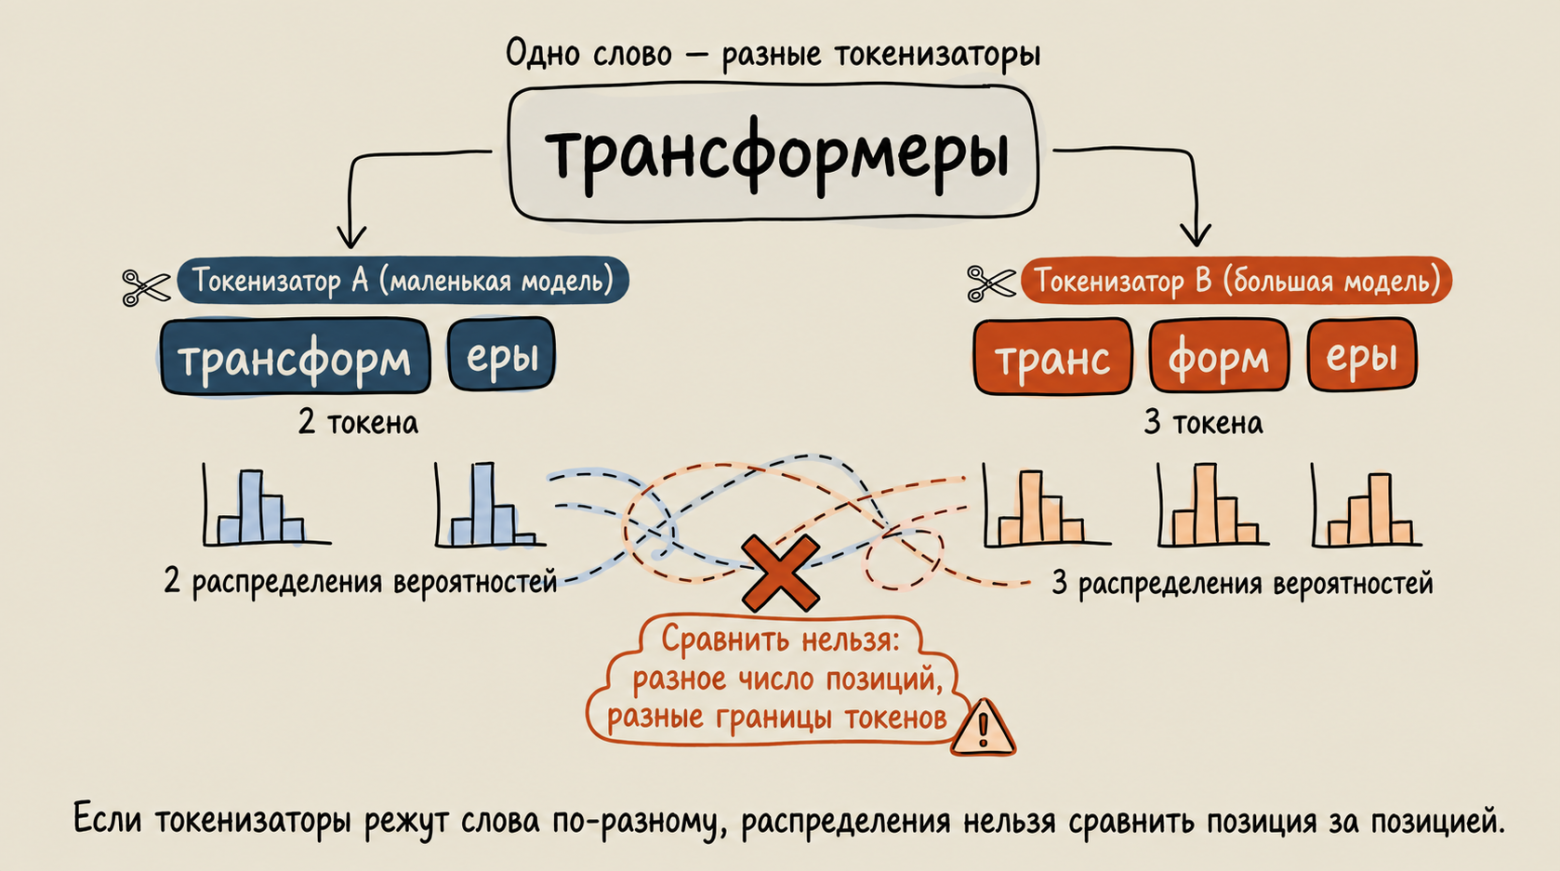
Поэтому первые реализации обычно использовали модели с общим токенизатором: например, маленькую и большую Llama или две модели Qwen одного поколения.
Это серьёзно ограничивало выбор draft-модели. У большой модели может просто не оказаться достаточно маленького родственника: формально подходящая модель есть, но она слишком тяжёлая и съедает большую часть выигрыша.
В Transformers 4.46 (октябрь 2024) появился Universal Assisted Generation [4]. UAG декодирует токены черновика обратно в текст, перекодирует токенизатором целевой модели и выравнивает последовательности. Это позволяет ставить черновик из другого семейства, например, маленький Qwen к Gemma.
Идея в том, чтобы переводить продолжение между двумя токенизациями.
Draft-модель генерирует несколько токенов своим токенизатором. Они декодируются обратно в текст, после чего этот текст кодируется токенизатором target-модели. Получившуюся последовательность уже можно передать большой модели на проверку.
На следующей итерации нужен обратный перевод: подтверждённое target-моделью продолжение преобразуется в представление draft-модели, чтобы та могла продолжить генерацию.
Простого decode → encode здесь недостаточно. Из-за особенностей BPE и других токенизаторов границы токенов около места склейки могут измениться. Поэтому Transformers дополнительно выравнивает старую и новую последовательности и ищет их общую часть.
В коде отличие минимальное: generate() нужно передать оба токенизатора.
from transformers import AutoModelForCausalLM, AutoTokenizer


TARGET = "google/gemma-2-9b"
DRAFT = "double7/vicuna-68m"

target_tok = AutoTokenizer.from_pretrained(TARGET)
draft_tok = AutoTokenizer.from_pretrained(DRAFT)

target = AutoModelForCausalLM.from_pretrained(
    TARGET,
    device_map="auto",
)

draft = AutoModelForCausalLM.from_pretrained(
    DRAFT,
    device_map="auto",
)

inputs = target_tok(
    "The capital of France is",
    return_tensors="pt",
).to(target.device)

out = target.generate(
    **inputs,
    assistant_model=draft,
    tokenizer=target_tok,
    assistant_tokenizer=draft_tok,
    max_new_tokens=64,
)
Теперь draft и target вообще не обязаны принадлежать одному семейству.
Но «можно использовать любую маленькую модель» ещё не означает «любая маленькая модель даст ускорение». Перекодирование и выравнивание добавляют накладные расходы, а сама draft-модель всё ещё должна достаточно хорошо предсказывать target. Если она слишком часто предлагает неподходящее продолжение, выигрыш исчезнет.
Поэтому общий токенизатор по-прежнему остаётся самым простым и обычно самым дешёвым вариантом. Universal Assisted Decoding нужен прежде всего тогда, когда у большой модели нет хорошего маленького аналога.
Грабля: одинаковый токенизатор – не всегда одинаковый vocab_size
У совместимых моделей есть ещё одна неочевидная деталь. Одинаковый токенизатор не обязательно означает одинаковый размер выходного слоя модели.
Возьмём Qwen2.5-7B-Instruct и Qwen2.5-0.5B-Instruct:
from transformers import AutoTokenizer

t1 = AutoTokenizer.from_pretrained("Qwen/Qwen2.5-7B-Instruct")
t2 = AutoTokenizer.from_pretrained("Qwen/Qwen2.5-0.5B-Instruct")

print("Размер словаря:     ", t1.vocab_size, "и", t2.vocab_size)
print("Словари равны:      ", t1.get_vocab() == t2.get_vocab())
print("Шаблоны чата равны: ", t1.chat_template == t2.chat_template)
Токенизаторы у них фактически совпадают:
Размер словаря:      151643 и 151643
Словари равны:       True
Шаблоны чата равны:  True
Но generate(..., assistant_model=draft) всё равно падает:
ValueError: The main and assistant models have different tokenizers.
Please provide `tokenizer` and `assistant_tokenizer` to `generate()`
Первое подозрение – разные шаблоны чата. Но вывод выше показывает, что они совпадают. Настоящая причина закопана в коде Transformers: проверка перед генерацией сравнивает не токенизаторы, а config.vocab_size двух моделей, то есть число строк в матрице эмбеддингов. А её в Qwen2.5 дополняют до разных размеров:
|
Модели |
|
|---|---|
|
Qwen2.5-0.5B, 1.5B, 3B |
151 936 |
|
Qwen2.5-7B, 14B, 32B, 72B |
152 064 |
Противоречия здесь нет. tokenizer.vocab_size описывает реальный словарь токенизатора, а config.vocab_size определяет размер embedding- и output-матриц модели. Их могут дополнить лишними строками ради удобного выравнивания размеров на железе. Токенизатор эти дополнительные ID никогда не генерирует.
В старых реализациях assisted generation такая разница могла стать неприятным сюрпризом: код ожидал одинаковых размеров словаря даже там, где фактическая токенизация совпадала.
В актуальном Transformers этот случай уже обрабатывается отдельно. Внутри есть отображение между пространствами токенов target и assistant, причём Qwen2.5-7B с Qwen2.5-0.5B прямо приведены в исходниках как пример моделей с общим токенизатором, но разным vocab_size.
Поэтому сегодня такая пара сама по себе не повод отказываться от speculative decoding.
Но перед бенчмарком всё равно полезно проверить обе величины:
print(target.config.vocab_size, draft.config.vocab_size)
В продакшене: vLLM
Для сервинга speculative decoding поддерживается в vLLM из коробки: отдельная черновая модель, EAGLE и EAGLE-3, Medusa, MTP, n-gram и даже DFlash. Настройка задаётся через speculative_config:
from vllm import LLM, SamplingParams

# Отдельная черновая модель того же семейства
llm = LLM(
    model="meta-llama/Llama-3.1-70B-Instruct",
    tensor_parallel_size=2,
    speculative_config={
        "method": "draft_model",
        "model": "meta-llama/Llama-3.2-1B-Instruct",
        "num_speculative_tokens": 5,
    },
)

# Без второй модели: черновик из n-грамм самого промпта
llm_ngram = LLM(
    model="meta-llama/Llama-3.1-8B-Instruct",
    speculative_config={
        "method": "ngram",
        "num_speculative_tokens": 5,
        "prompt_lookup_min": 2,
        "prompt_lookup_max": 4,
    },
)

out = llm.generate(["Explain speculative decoding."], SamplingParams(temperature=0, max_tokens=200))
Формат приведён по текущей документации vLLM [5]; в старых версиях ключи назывались иначе, так что сверяйтесь со своей.
Отдельно отмечу n-gram-черновик, его вспоминают незаслуженно редко. Ни второй модели, ни дополнительного KV-кэша – он просто подсматривает в промпт. И хорошо работает там, где ответ повторяет фрагменты входа: правка кода, извлечение из документа, RAG с цитированием.
Если у вас такой профиль нагрузки, то начинайте с него, а не с подбора второй модели. Это одна строчка конфига.
А можно вообще без второй модели?
У классического speculative decoding есть дополнительная цена: отдельную draft-модель нужно подобрать, разместить в памяти и вести для неё собственный KV-кэш. Причём хороший маленький аналог существует далеко не для каждой большой модели.
Поэтому появилось несколько подходов, где полноценная вторая LLM вообще не нужна.
EAGLE: черновик из скрытых состояний самой модели
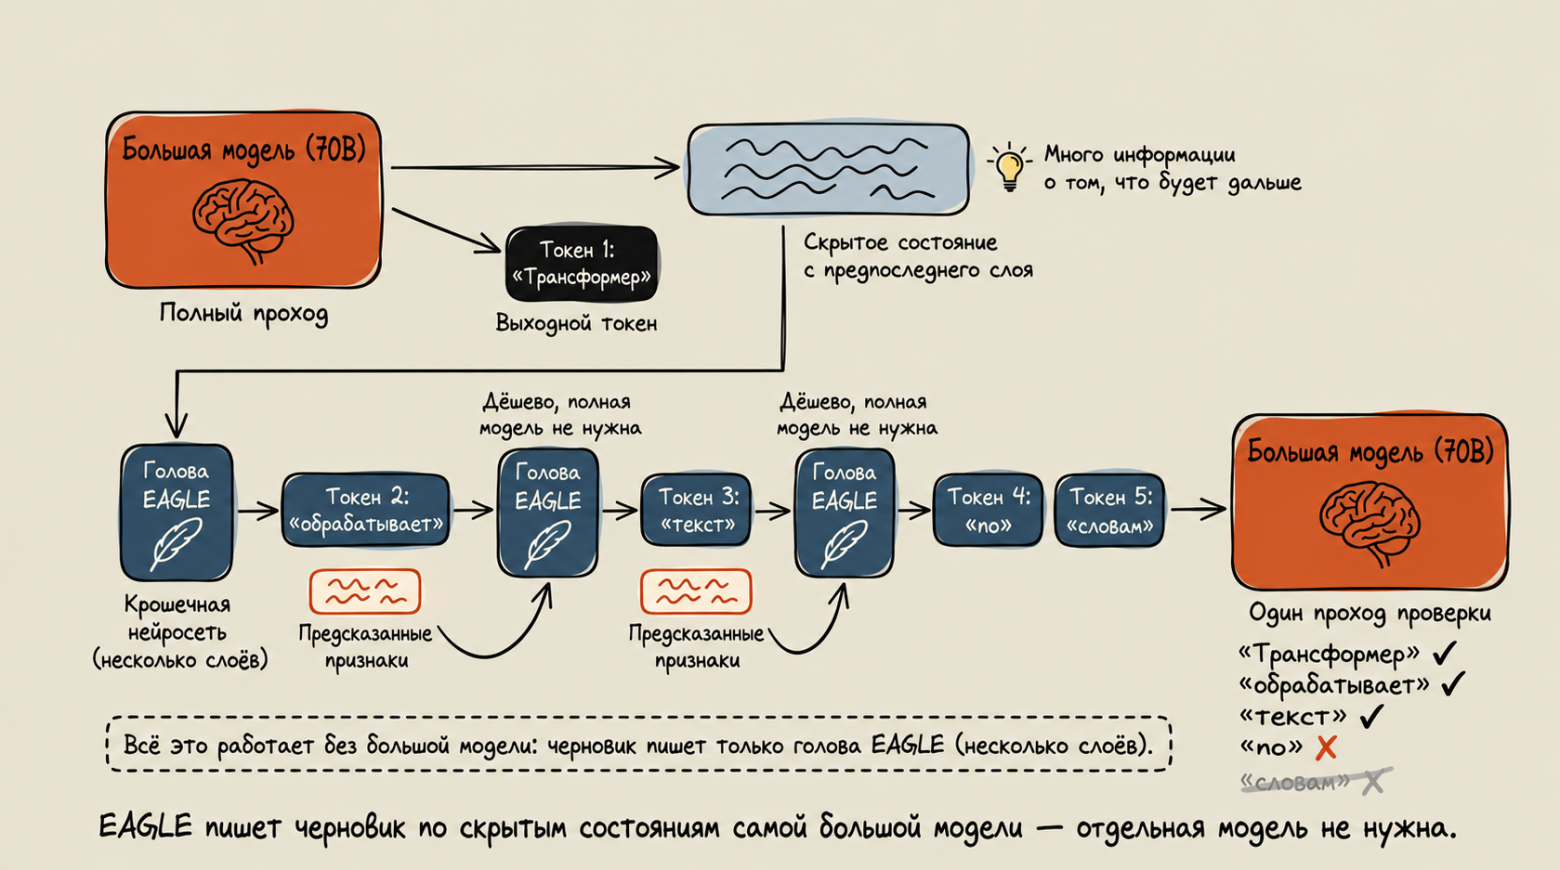
EAGLE [6] использует небольшую обучаемую draft-часть, которая работает не только с токенами, но и со скрытыми представлениями целевой модели.
В оригинальном EAGLE ключевая идея такая: предсказывать следующее представление на уровне предпоследнего слоя проще, чем сразу следующий токен. Draft-модуль получает скрытые состояния target-модели и уже выбранные токены, предсказывает следующее скрытое состояние, а через LM head превращает его в распределение следующего токена.
Черновик при этом всё ещё строится авторегрессионно: полученный токен участвует в предсказании следующего. После нескольких таких шагов кандидаты проверяются основной моделью.
Плюс в том, что draft опирается на гораздо более богатый сигнал, чем просто последовательность токенов. При этом отдельная полноценная маленькая LLM не нужна, а пространство токенов автоматически совпадает с target-моделью. Для LLaMA2-Chat 70B авторы EAGLE сообщили ускорение 2,7–3,5× при сохранении распределения исходной модели.
Позже появились EAGLE-2 и EAGLE-3. В EAGLE-2 дерево кандидатов строится динамически с учётом их вероятности принятия, а EAGLE-3 использует признаки сразу с нескольких уровней target-модели вместо первоначального предсказания одного типа скрытых состояний.
Medusa: несколько голов, несколько позиций сразу
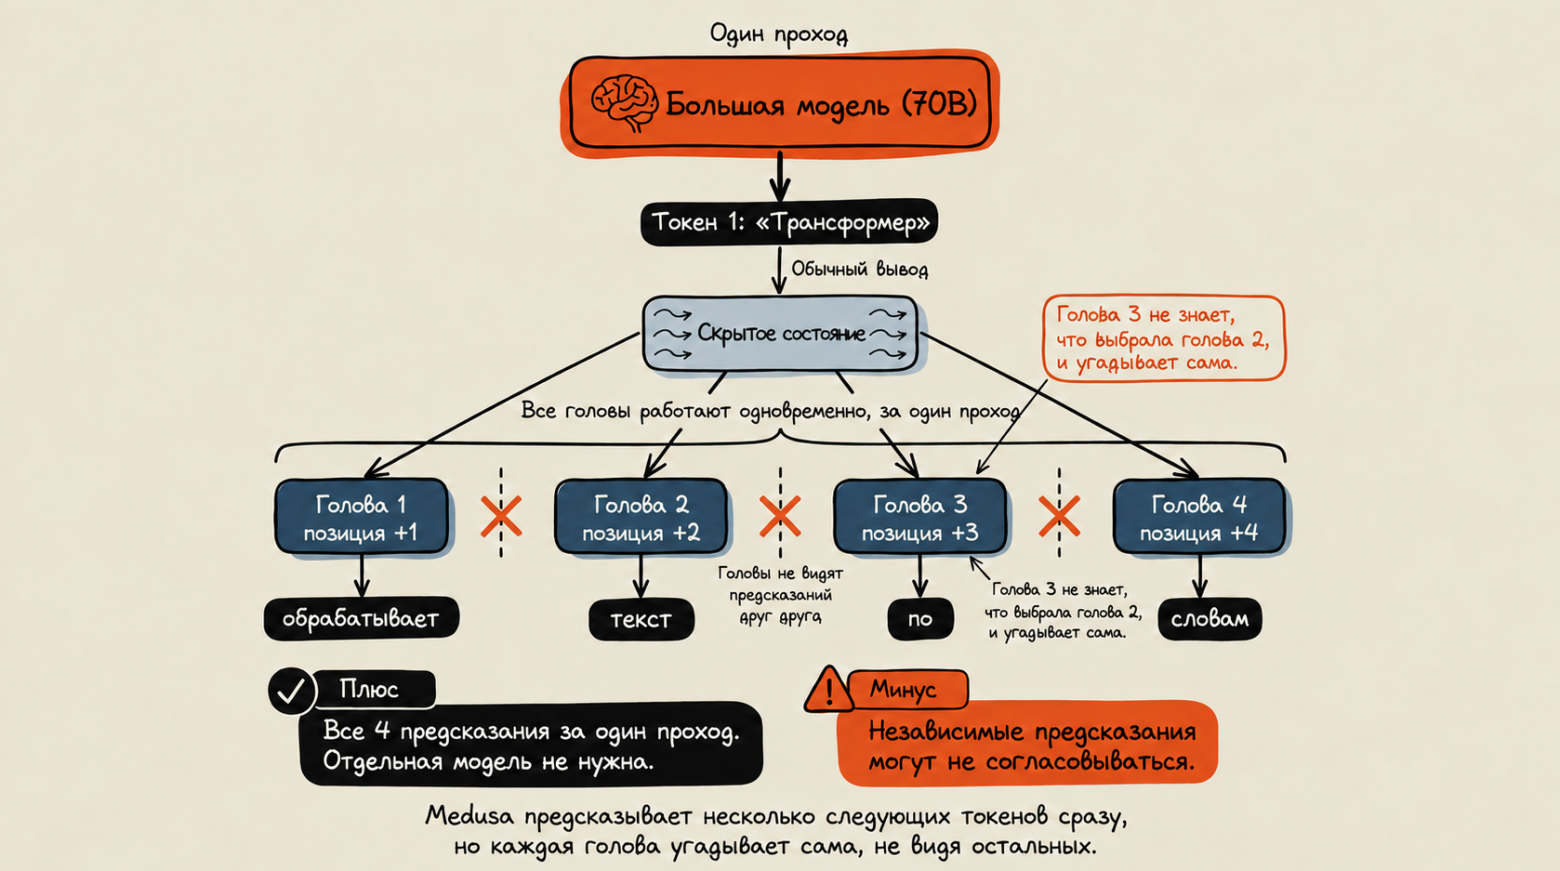
Medusa [7] идёт другим путём. К основной модели добавляется несколько небольших decoding heads: одна пытается предсказать следующий токен, другая токен через одну позицию, следующая ещё дальше.
Главное отличие от EAGLE, это то, что эти предсказания можно получить параллельно за один проход.
Но за параллелизм приходится платить. Голова для третьей позиции заранее не знает, какой именно токен будет выбран на второй. Поэтому Medusa получает несколько возможных продолжений, собирает из них дерево кандидатов и затем проверяет его основной моделью с помощью tree attention.
Есть две основные версии метода. В Medusa-1 обучаются только дополнительные головы, а сама LLM остаётся замороженной. Авторы получили более 2,2× ускорения без изменения основной модели. В Medusa-2 вместе с головами дообучается и backbone; заявленное ускорение в экспериментах составило 2,3–3,6×.
Self-speculative: ранний выход из той же модели
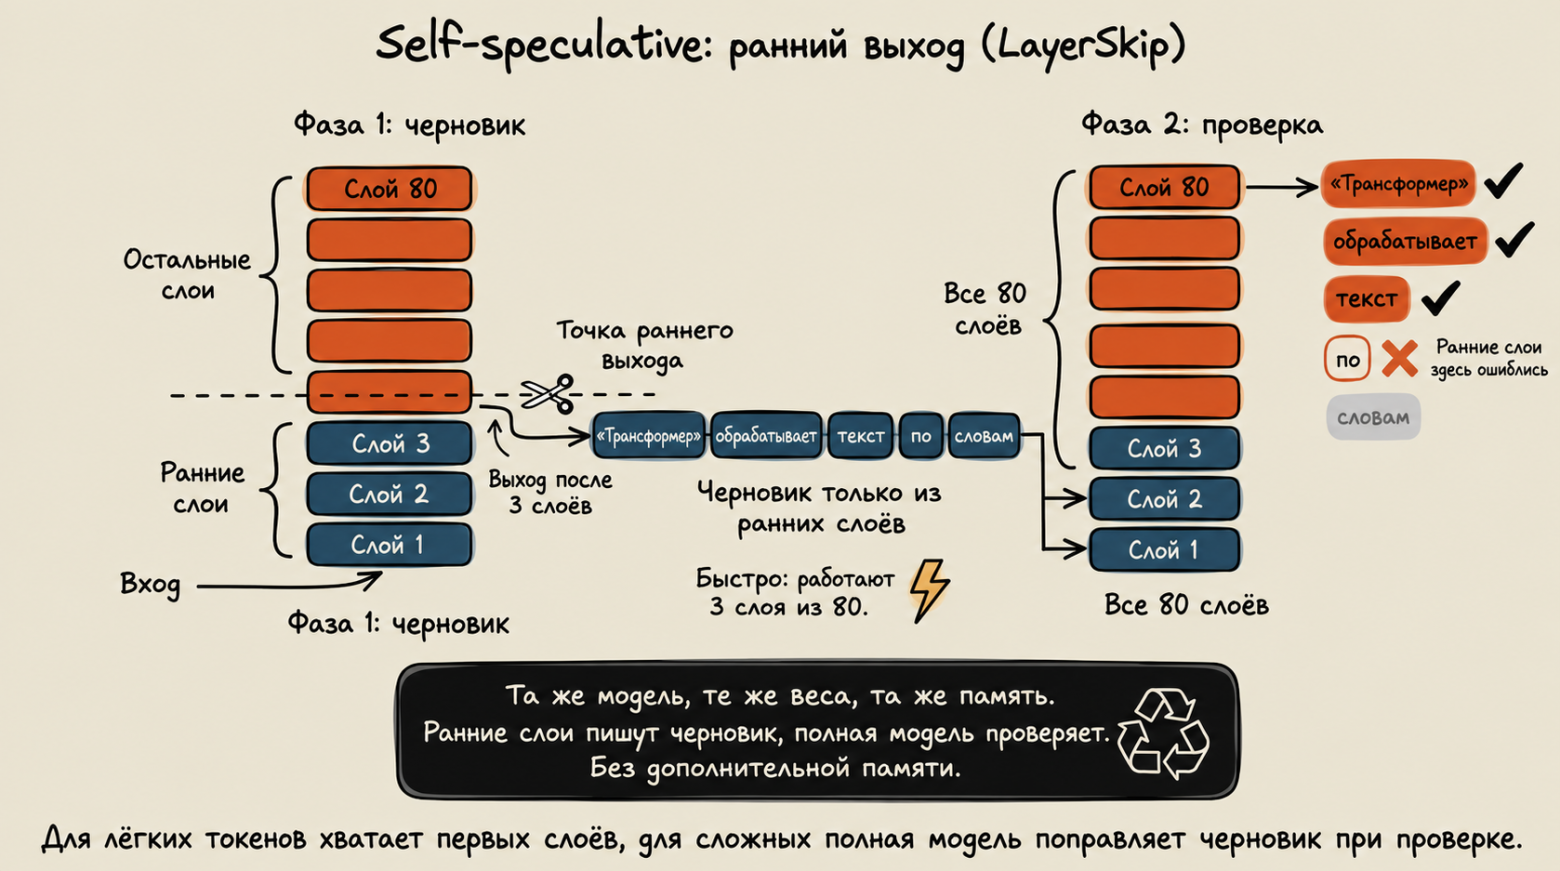
В LayerSkip [8] отдельного draft-модуля нет вообще. Черновик генерирует сама target-модель, но только первыми слоями.
Например, вместо всех 80 слоёв можно пройти первые 12 и сделать ранний выход. Полученные таким образом токены становятся черновиком, а затем оставшиеся слои той же модели их проверяют и при необходимости исправляют.
То есть verification здесь не обязательно означает ещё один полный проход модели с нуля: draft и проверка могут переиспользовать часть вычислений и активаций.
Чтобы ранние выходы действительно умели предсказывать токены, LayerSkip специально обучает модель с layer dropout и дополнительным loss на промежуточных слоях. Просто взять произвольную Llama и начать выходить после двенадцатого слоя это не то же самое.
Авторы получили до 2,16× на суммаризации CNN/DM, до 1,82× на генерации кода и до 2,0× на TOPv2.
Главный плюс это никаких дополнительных весов draft-модели. Минус, для хорошего результата сама target-модель должна быть подготовлена к раннему выходу.
DFlash: черновик за один проход через диффузию
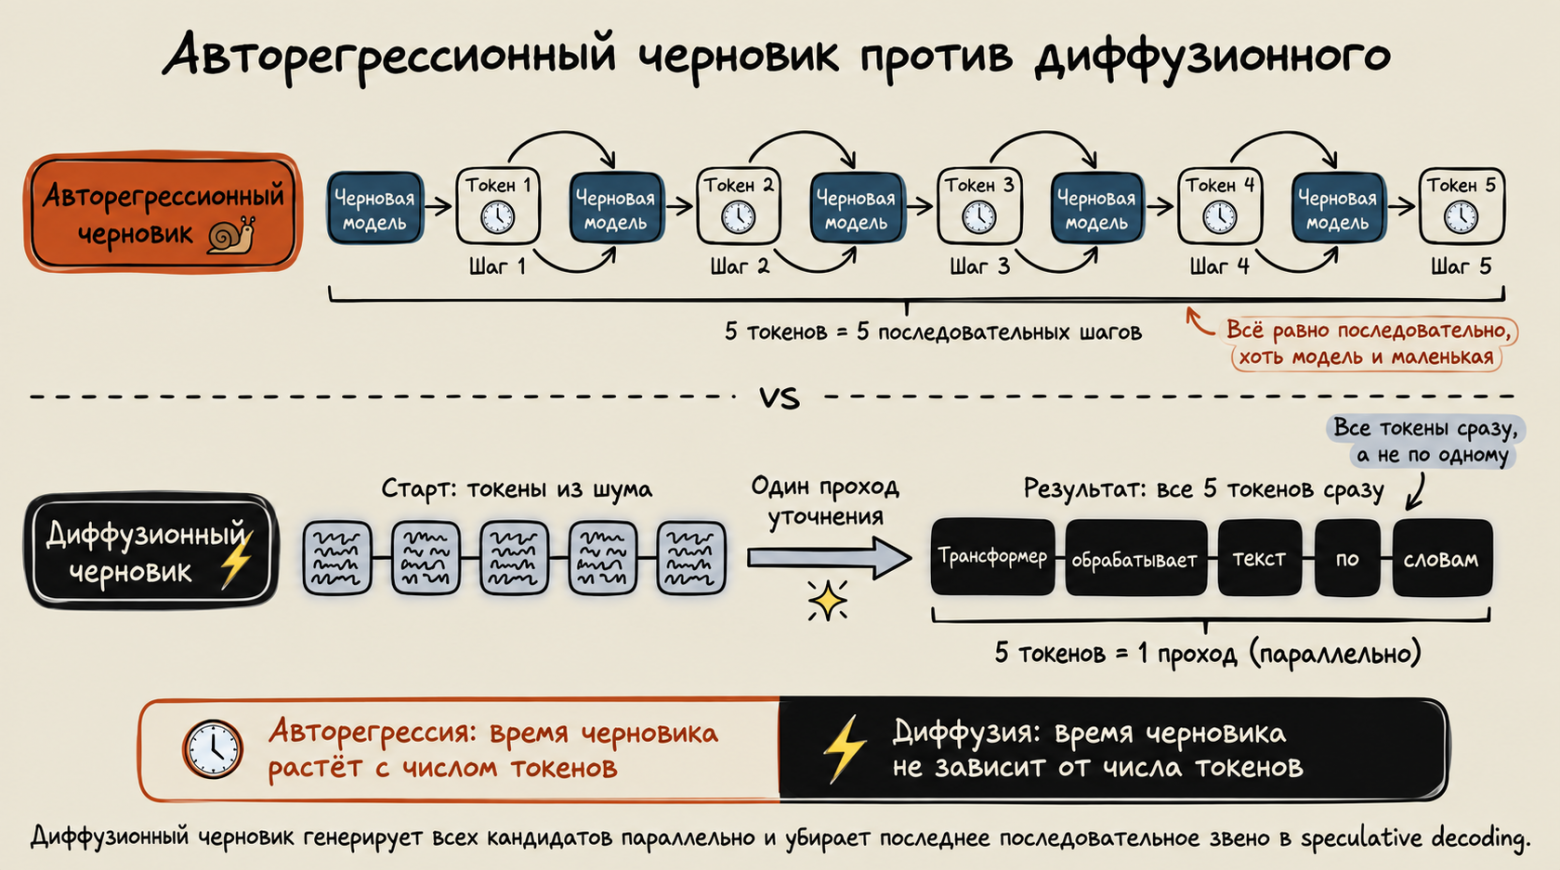
У классической draft-модели и у EAGLE остаётся одна общая проблема: черновик строится авторегрессионно.
Диффузионная модель генерирует блок токенов параллельно: начинает с шума и за несколько шагов уточняет всю последовательность целиком. DFlash [9] обучает небольшую диффузионную голову, обусловленную скрытыми состояниями целевой модели, и получает весь черновик за один проход. И вот тут происходит интересное: цена черновика перестаёт расти с его длиной. В терминах формулы выше  больше не умножается на
 .
Авторы сообщают более 6× ускорения без потерь и до 2,5× относительно EAGLE-3.
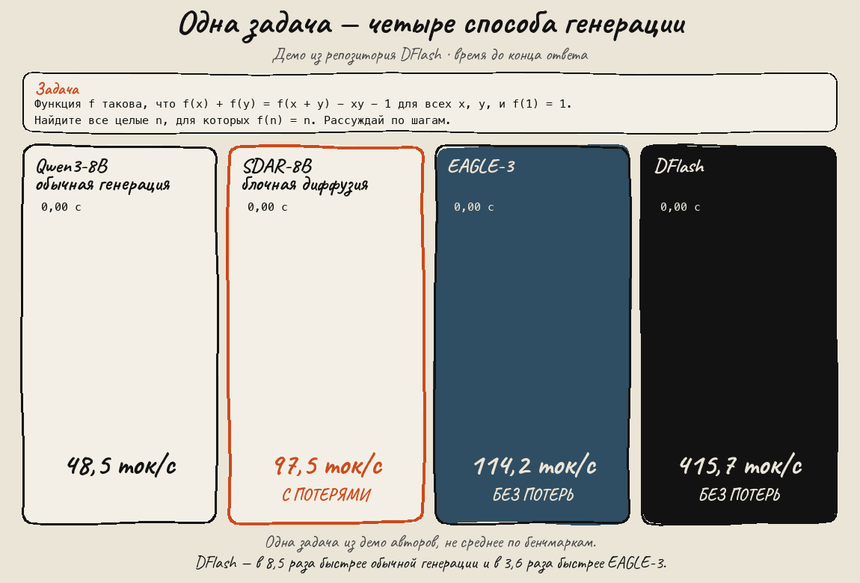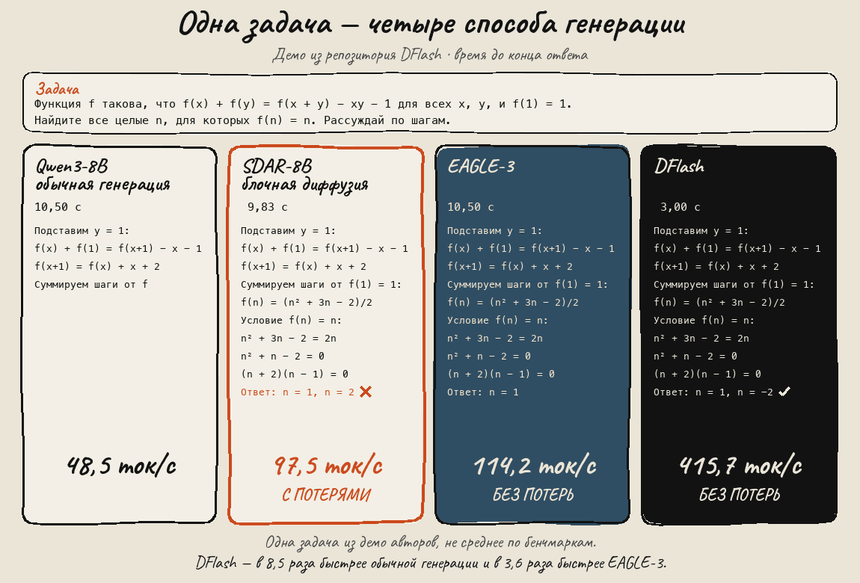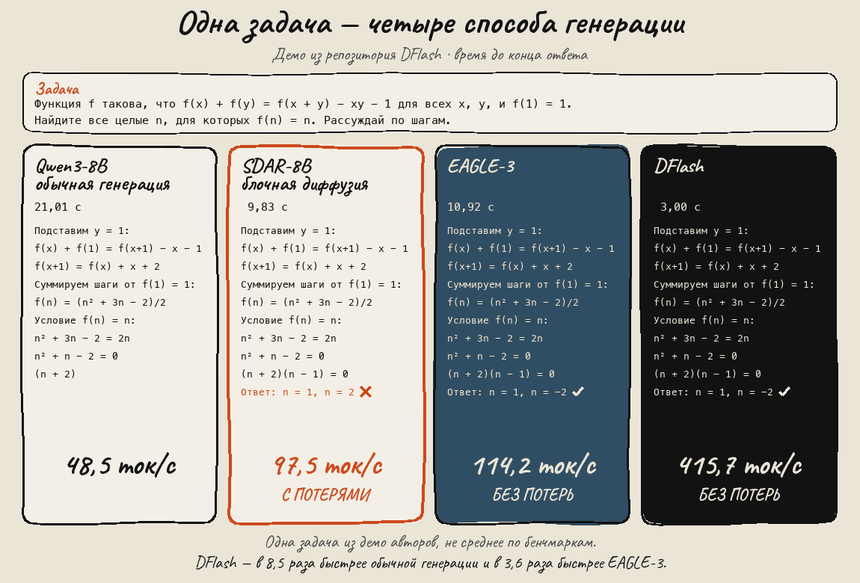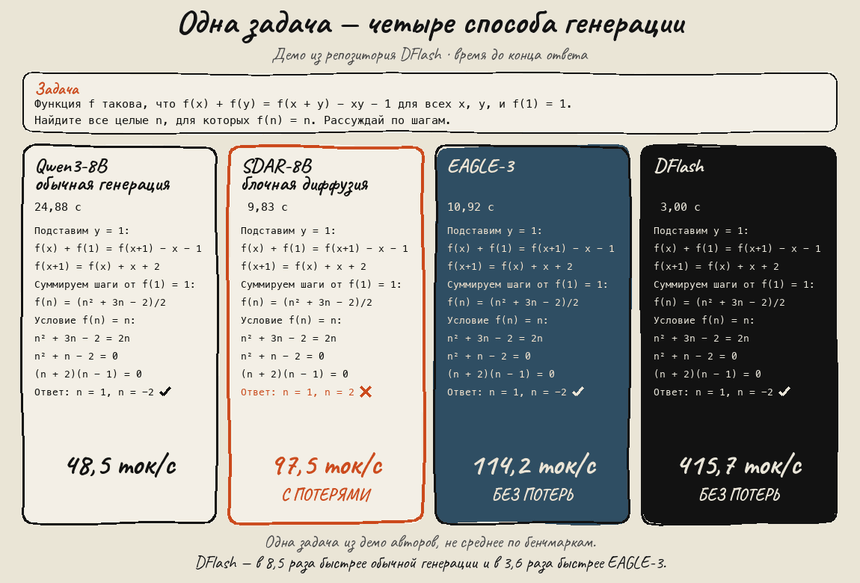
В демонстрации из репозитория DFlash на одной математической задаче это выглядит так: авторегрессионная Qwen3-8B – 48,5 ток/с, блочная диффузия SDAR-8B как самостоятельная модель – 97,5 ток/с с потерей качества, EAGLE-3 – 114,2 ток/с, DFlash – 415,7 ток/с без потерь. Это один пример, а не среднее по бенчмаркам.
Когда это не нужно
Speculative decoding хорошо выглядит на схеме, но ускорение получается не при любой нагрузке. Есть несколько случаев, где выигрыш быстро сокращается или вообще превращается в замедление.
Большой батч и высокая загрузка GPU. При маленьком batch size декодирование обычно упирается в память, а вычислительные блоки GPU недогружены. Именно эти свободные вычислительные ресурсы speculative decoding и использует для проверки нескольких кандидатов сразу.
С ростом батча ситуация меняется. Если для каждой из  последовательностей проверить ещё по
 speculative-токенов, эффективный объём работы приближается к
 . Когда GPU уже загружен вычислениями, отклонённые кандидаты перестают быть почти бесплатными и начинают отнимать пропускную способность.
Поэтому фиксированные пять или восемь speculative-токенов, которые хорошо работают при одном запросе, могут оказаться плохим выбором при сотне одновременных. Современные движки умеют уменьшать глубину speculation с ростом нагрузки.
Sampling и открытая генерация. Здесь тоже нет простого правила вроде «чем выше temperature, тем ниже acceptance rate». Всё зависит от того, как после применения sampling-параметров меняется перекрытие распределений draft- и target-модели.
На практике открытые задачи часто оказываются сложнее для черновика, чем продолжение кода, суммаризация или генерация, сильно привязанная к входному тексту. Если draft часто расходится с target, большая часть дополнительной работы пропадает впустую.
Поэтому acceptance rate лучше измерять на реальных запросах, а не переносить число из чужого бенчмарка.
Память под draft-модель. Классическая схема требует хранить не только её веса, но и отдельный KV-кэш для активных запросов. Если target-модель и без того занимает почти всю память GPU, несколько гигабайт под draft могут уменьшить доступный batch size и выигрыш в latency придётся оплачивать потерей общей пропускной способности.
В такой ситуации интереснее методы с небольшим speculator-модулем, MTP, EAGLE или варианты вообще без нейросетевого draft вроде n-gram и suffix decoding.
Побитовое совпадение результатов. Lossless speculative decoding означает сохранение распределения целевой модели, а не обязательное совпадение каждого вычисления с плавающей точкой.
Другой размер батча, другой порядок операций или другое CUDA-ядро могут немного изменить logits. Обычно это ни на что не влияет, но при почти равных вероятностях даже greedy decoding иногда способен выбрать другой токен.
Если тесты требуют полного совпадения выходных строк между разными режимами инференса, это стоит проверять отдельно.
KV-кэш и speculative decoding работают вместе
Speculative decoding не заменяет KV-кэш – наоборот, без него практического смысла в такой схеме было бы гораздо меньше.
При обычном декодировании KV-кэш сохраняет ключи и значения для уже обработанного контекста, чтобы на каждом новом токене не прогонять всю последовательность заново.
В классической схеме draft-модель ведёт собственный KV-кэш и благодаря этому дешёво генерирует следующие кандидаты. Target-модель, в свою очередь, проверяет весь speculative-блок и сохраняет состояние для той его части, которая действительно была принята. Вычисления для отвергнутого хвоста дальше не используются.
Получаются две независимые оптимизации:
KV-кэш не даёт заново пересчитывать уже обработанный контекст; speculative decoding уменьшает число последовательных decode-шагов большой модели.
Они решают разные части одной проблемы и почти всегда используются вместе.
Шпаргалка: что брать
|
Ситуация |
Что включать |
Ориентир |
|---|---|---|
|
Есть маленькая модель того же семейства, важна задержка одного запроса |
Отдельный черновик: assistant_model в Transformers, draft_model в vLLM; длину черновика подобрать по формуле |
1,5–3× |
|
Ответ переписывает куски промпта: правка кода, RAG с цитатами, извлечение полей |
N-gram-черновик: ни второй модели, ни лишней памяти |
Зависит от доли повторов, на удачных задачах — как у отдельного черновика |
|
Подходящей маленькой модели нет, память занята целевой |
EAGLE или EAGLE-3: лёгкая голова поверх целевой модели |
2,7–3,5× |
|
Модели только из разных семейств, дообучать нечего |
UAG: передать оба токенизатора в generate() |
1,5–1,9× |
|
Целевую модель можно дообучить |
Medusa-2 или LayerSkip с ранним выходом |
2,3–3,6× и до 2,16× |
|
Сервер держит большой батч, важна пропускная способность |
Ничего: GPU загружен и так, выигрыша почти нет |
≈1×, при неудачной настройке медленнее |
Итого
Главная идея speculative decoding довольно простая: последовательная генерация большой LLM часто упирается в пропускную способность памяти, тогда как проверку нескольких следующих позиций можно выполнить гораздо эффективнее, чем несколько отдельных decode-шагов.
Маленький или специализированный drafter пытается угадать несколько токенов вперёд, а большая модель проверяет их одной пачкой.
При sampling качество сохраняется не потому, что «большая модель согласилась с маленькой». В классическом speculative sampling за этим стоит правило принятия и корректирующее распределение, которые сохраняют распределение target-модели.
А скорость в первом приближении определяется тремя вещами: насколько часто draft оказывается прав, сколько он сам стоит и сколько токенов предлагается за одну итерацию.
Поэтому главный практический совет здесь простой: не выбирайте speculative decoding по красивому числу из статьи. Измерьте acceptance rate и latency на своём трафике, при своём batch size и на том же железе, где система будет работать.
Таблица с ускорениями выше показывает, насколько сильно результат зависит от условий: от 1,19× до 4,46×. Один и тот же алгоритм, разница почти в четыре раза.
Если запомнить из статьи одну вещь, пусть это будет она: хватит гонять веса туда-сюда.
Источники: проверка ассистента в generation/utils.py [10], Hugging Face Transformers; Fast Inference from Transformers via Speculative Decoding [3], Leviathan et al.; Looking back at speculative decoding [2], Google Research; Universal Assisted Generation [4], Hugging Face; EAGLE [6]; Medusa [7]; LayerSkip [8]; DFlash: Block Diffusion for Flash Speculative Decoding [9].
Автор: GG1KENOBI
Источник [11]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/35828
URLs in this post:
[1] памяти: http://www.braintools.ru/article/4140
[2] использует: https://research.google/blog/looking-back-at-speculative-decoding/
[3] исходной статьи Leviathan et al.: https://arxiv.org/abs/2211.17192
[4] Universal Assisted Generation: https://huggingface.co/blog/universal_assisted_generation
[5] текущей документации vLLM: https://docs.vllm.ai/en/latest/features/speculative_decoding/
[6] EAGLE: https://arxiv.org/abs/2401.15077
[7] Medusa: https://arxiv.org/abs/2401.10774
[8] LayerSkip: https://arxiv.org/abs/2404.16710
[9] DFlash: https://arxiv.org/abs/2602.06036
[10] проверка ассистента в generation/utils.py: https://github.com/huggingface/transformers/blob/main/src/transformers/generation/utils.py
[11] Источник: https://habr.com/ru/articles/1081826/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1081826
Нажмите здесь для печати.