Семантический слой на TypeDB: как уйти от паутины SQL-джойнов к декларативной модели данных
Кратко (TL; DR):
● Реляционные базы и классические графы теряют смысловую структуру при моделировании сложных многосторонних связей, вынуждая разработчиков дублировать бизнес-логику в SQL-запросах, коде микросервисов и витринах данных.
● Тот же разрыв всплывает, когда поверх данных ставят LLM или ИИ-агента: без явных связей между сущностями модель галлюцинирует на корпоративных данных.
● Семантический слой переносит сущности, роли участников и доменные правила на уровень схемы, превращая модель данных в строгий контракт — единый и для аналитики, и для языковых моделей.
● СУБД TypeDB обеспечивает нативную поддержку n-арных отношений первого класса и динамический логический вывод на уровне ядра.
● На сквозном датасете из 65 752 заказов и 469 977 веб-событий показываем, как декларативный подход заменяет громоздкие каскады JOIN на компактные ролевые паттерны, предотвращая раздувание строк и расхождение бизнес-метрик.
Все больше команд разворачивают поверх корпоративных данных большие языковые модели и автономных агентов — и сталкиваются с общей проблемой: система уверенно возвращает правдоподобные, но неверные ответы, путает сущности, подставляет несуществующие статусы и суммы. Причина, как правило, не в самой модели: классический RAG передает ей плоские фрагменты текста, отобранные по векторному сходству, тогда как связи между сущностями, которые и формируют смысл запроса, в этих фрагментах отсутствуют. Не располагая ими, модель достраивает недостающее предположением.
Однако это не проблема искусственного интеллекта [1] как такового — он лишь обнажает более раннюю. В практике компании Neoflex при проектировании корпоративных платформ данных для крупных клиентов в ритейле, логистике и финтехе мы регулярно наблюдаем одну и ту же архитектурную проблему: когда система масштабируется, реляционные схемы перестают отражать реальные процессы компании. Данные разложены по хранилищам, микросервисы исправно генерируют события, но как только бизнесу требуется сквозная аналитика (например, аудит рекламаций через пять независимых систем или динамическая валидация регламентов доставки) — или корректный контекст для LLM — инженеры упираются в лавинообразный рост сложности SQL-запросов и дублирование логики. Смысл происходящего перемещается в код, который эти данные извлекает и склеивает, и каждый новый потребитель, будь то аналитик или языковая модель, вынужден собирать его заново.
Исправлять здесь нужно не отдельный запрос и не промпт, а саму модель данных — вернуть ей смысл на уровне схемы, а не кода. Именно это делает семантический слой. В рамках внутренних R&D мы протестировали такой подход на базе специализированной СУБД TypeDB. Ниже делимся выводами, методологией декомпозиции и сравнением с традиционными подходами на реальных данных, а в финале возвращаемся к тому, какой контекст этот слой дает языковым моделям и агентам.
Разрыв между схемой данных и реальностью
Когда логика [2] связей не заложена в саму модель данных, система обрастает архитектурными компромиссами:
● Логика размазывается по стеку. Правила объединения сущностей и расчета показателей дублируются в аналитических витринах, на бэкенде микросервисов и в формулах BI — и при любом изменении их приходится искать и править в десятках мест.
● Многосторонние связи не выражаются напрямую. Реляционная модель описывает парные отношения между строками, но реальное событие связывает нескольких участников с ролями, контекстом и временными рамками — приходится плодить промежуточные таблицы или складывать контекст в нетипизированные документы, теряя гарантии целостности.
● Высокая когнитивная нагрузка на потребителей. Чтобы ответить на простой вопрос о процессе, инженер или аналитик должен знать не столько предметную область, сколько физическую реализацию: какие таблицы, какие фильтры и через какие промежуточные звенья соединять.
Роль семантического слоя
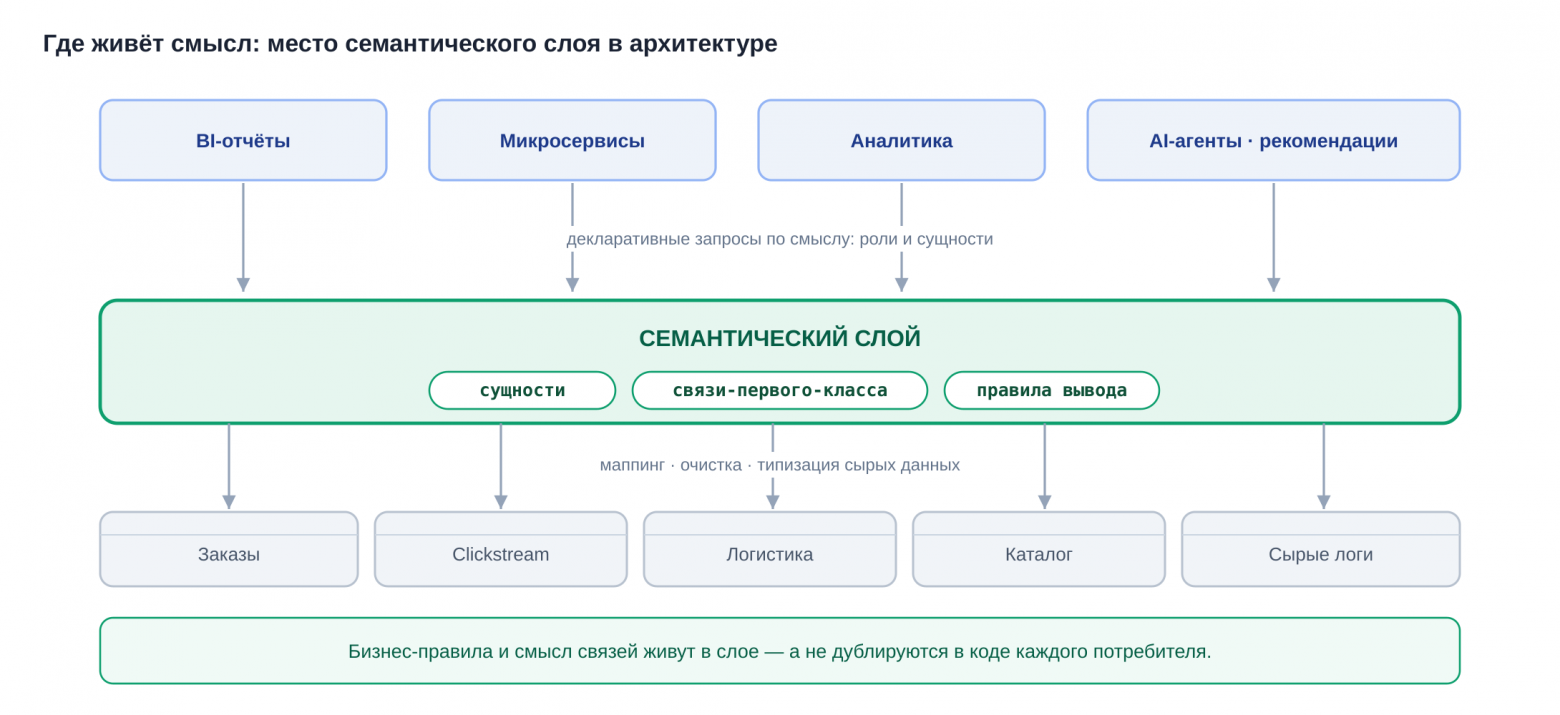
Семантический слой — это уровень абстракции над физическим хранилищем, который переводит низкоуровневые таблицы и сырые записи на строгий язык предметной области. Он формализует, какие концепции существуют в системе, какими свойствами они обладают и по каким законам взаимодействуют между собой.
Главная задача этого слоя — забрать ответственность за смысловые связи и бизнес-правила у разрозненных скриптов и зафиксировать их прямо в структуре данных как единый декларативный контракт.
Где это применяется на практике
● Сквозная трассировка процессов: восстановление полной цепочки событий от первого действия пользователя в интерфейсе до финального финансового и операционного результата.
● Поиск первопричин и диагностика инцидентов: автоматизированный анализ цепочек зависимостей, позволяющий понять, какое именно первичное событие в инфраструктуре или процессах привело к сбою на последующих этапах.
● Централизованное исполнение политик и ограничений: фиксация допустимых состояний, прав и контекстных правил в едином месте, исключающая расхождение проверок между различными сервисами.
● Поставка качественного контекста для прикладных систем: передача структурированных графов взаимосвязей в алгоритмы маршрутизации, рекомендательные модули и автоматизированные агенты, которым для работы требуются явные связи, а не плоские выгрузки.
Архитектура семантического слоя в теории
Если абстрагироваться от конкретных СУБД, форматов хранения и инструментов трансформации, семантический слой представляет собой декларативную систему типов и правил, которая моделирует предметную область независимо от физического представления данных.
Его задача — отделить хранение сырых байтов от представления смысла этих данных для прикладных систем.
Базовые строительные блоки модели
В теоретическом вакууме архитектура семантической модели опирается на четыре фундаментальных компонента:
● Сущности (Entities). Независимые объекты предметной области с устойчивой идентичностью. Сущность не привязана к конкретной строке в таблице: она существует как концепт, который может собираться из нескольких источников одновременно.
● Отношения и роли (Relations & Roles). Взаимодействия между сущностями. Отношение определяет, какие именно роли играют участвующие в нем объекты, и само по себе может обладать свойствами, жизненным циклом и собственным контекстом.
● Атрибуты и типизация (Attributes). Характеристики, описывающие как сами сущности, так и отношения между ними. Требуют строгой типизации свойств, чтобы исключить разночтения на стыке сервисов.
● Правила логического вывода и инварианты (Rules & Constraints). Декларативные ограничения предметной области. Они задают допустимые состояния системы и логику автоматического вывода новых фактов на основе уже известных связей.
Методология декомпозиции: что и куда относить
Чтобы модель не превратилась в хаотичный набор связей, декомпозиция предметной области проводится по строгим критериям:
● Сущность — обладает собственной идентичностью и жизненным циклом, существует независимо (клиент, заказ, товар).
● Атрибут — значение, которое теряет смысл в отрыве от носителя (статус, сумма, вес).
● Отношение — факт взаимодействия нескольких участников, каждый в своей роли; его нельзя свернуть в поле одного из объектов (например, закрепление ресурса за исполнителем).
Критерии отбора данных: что пускать в модель
Семантический слой не должен служить слепой копией сырого хранилища данных. Перенос абсолютно всех полей и технических логов приводит к замусориванию схемы, падению производительности и потере наглядности.
Принцип фильтрации строится на разделении уровней ответственности:
1. Что входит в семантический слой: сущности, отношения и атрибуты, которые напрямую участвуют в бизнес-логике, влияют на правила валидации, определяют маршрутизацию процессов или связывают между собой разные домены компании.
2. Что остается за бортом: низкоуровневый технический шум (сырые дампы сетевых пакетов, промежуточные трейсы микросервисов, временные токены, отладочные флаги). Эти данные продолжают жить в неизменяемых логах и объектных хранилищах, а в семантическую модель попадает только агрегированный результат или значимый факт события, если он меняет состояние бизнеса.
Жизненный цикл и потоки данных
В рамках концепции обработка информации делится на три последовательных этапа:
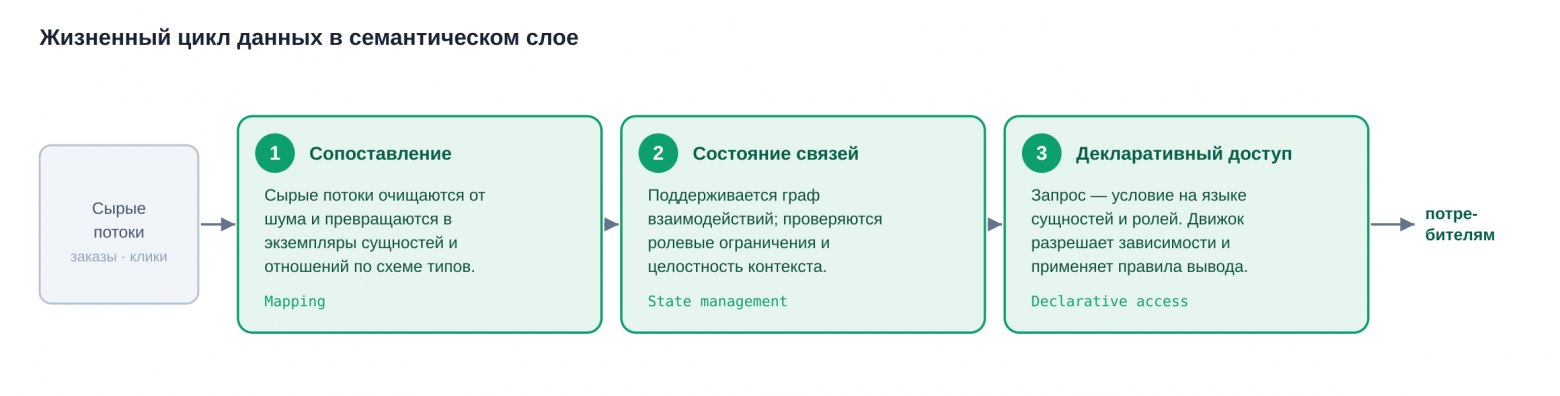
1. Слой сопоставления (Mapping). Сырые входящие потоки данных очищаются от шума и преобразуются в экземпляры определенных сущностей и отношений согласно заданной схеме типов.
2. Слой управления состоянием связей. Система поддерживает граф взаимодействий между сущностями, непрерывно контролируя выполнение ролевых ограничений и целостность контекста.
3. Декларативный интерфейс доступа. Потребители запрашивают данные не через процедурные инструкции обхода таблиц, а через условия на языке сущностей и отношений. Движок модели самостоятельно разрешает зависимости и применяет правила вывода для формирования корректного ответа.
Почему TypeDB: теоретический фундамент и устройство СУБД
Когда возникает задача положить описанную модель в реальную базу данных, классический стек быстро упирается в ограничения своих моделей данных:
● В реляционных базах (SQL) нет концепции самостоятельных связей. Отношения существуют только как совпадение внешних ключей в строках промежуточных таблиц. Чтобы выразить сложное событие, приходится создавать искусственные таблицы-связки, теряя наглядность схемы и строгий контроль ролей.
● В популярных графовых СУБД (Labeled Property Graphs вроде Neo4j) ребра принципиально бинарны — они связывают строго два узла. Если в бизнес-событии участвуют три стороны или само событие должно стать участником другой связи, разработчик вынужден превращать ребро в отдельный узел (reification). В этот момент теряется типизация ролей, а граф превращается в плотную паутину однотипных вершин.
Теоретическое обоснование: иерархия выразительности
Ограничения существующих систем строго описаны в исследовательской работе Мэтью Олфорда «The Equivalence Theorem: First-Class Relationships for Structurally Complete Database Systems» (arXiv:2603.13603).
В работе доказана строгая иерархия выразительности моделей данных. Переход на каждый следующий уровень устраняет фундаментальные структурные потери предыдущих систем:
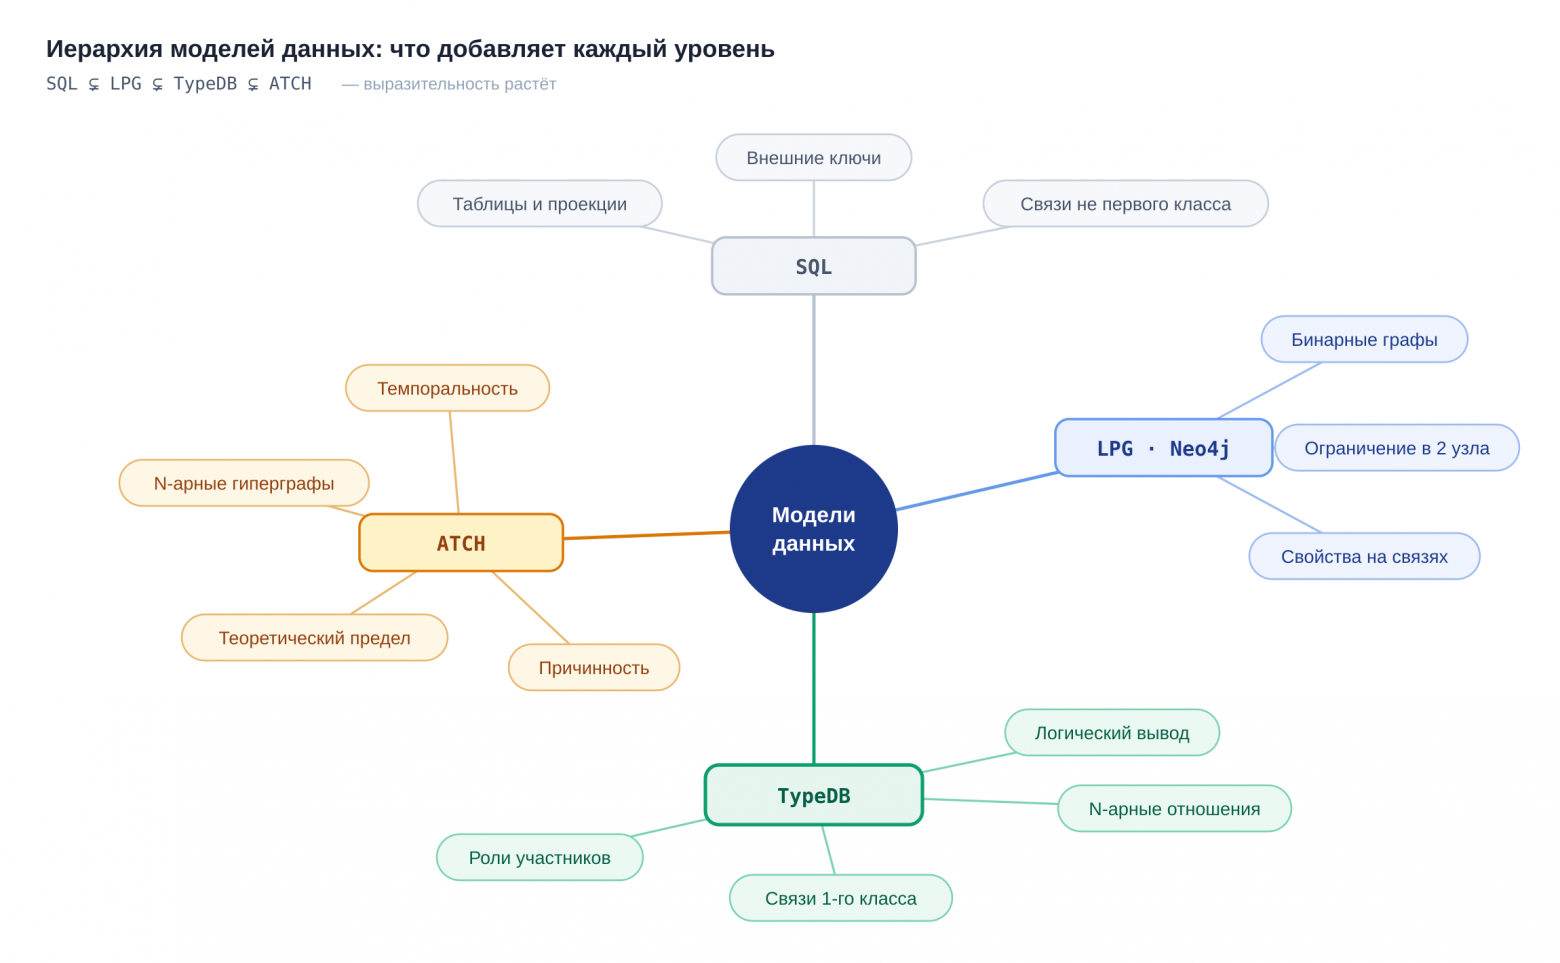
Согласно этой классификации:
1. SQL сводит связи к проекциям кортежей без собственной идентичности.
2. Графы LPG добавляют ребрам свойства и идентификаторы, но остаются строго бинарными.
3. TypeDB реализует полиморфную модель сущностей и связей (PERA), где n-арные отношения и вложенные связи поддерживаются на уровне ядра СУБД.
Связи в TypeDB являются объектами первого класса (first-class objects). Отношение может связывать произвольное количество сущностей с явным указанием их ролей, иметь собственные атрибуты и само выступать участником других отношений без создания искусственных узлов.
Стек и архитектура TypeDB
TypeDB (разработка компании TypeDB Ltd, ранее известной как Vaticle) спроектирована специально для работы со сложными доменными моделями и логическим выводом:
● Язык и ядро. Исторически ядро разрабатывалось на Java, но начиная с версии TypeDB 3.0 движок был полностью переписан на Rust. Это обеспечило высокую скорость обработки графовых структур, эффективную работу с памятью [3] и предсказуемую производительность при параллельном исполнении транзакций.
● Язык запросов TypeQL. Декларативный язык, позволяющий описывать схемы, выполнять сопоставление с шаблонами и запрашивать данные через семантические роли, а не через физические пути обхода.
● Встроенный движок логического вывода (Reasoning Engine). TypeDB позволяет задавать декларативные правила вывода. Движок динамически генерирует виртуальные связи и факты во время исполнения запроса без физической записи на диск.
● Модель типизации. Поддерживает строгое наследование типов для сущностей, отношений и атрибутов, а также полиморфные запросы, когда один запрос корректно обрабатывает разные подтипы данных.
Модель лицензирования
TypeDB распространяется гибридно:
● Бесплатная Community Edition под лицензией AGPLv3 включает полноценное ядро, TypeQL, движок правил и драйверы для основных языков — этого достаточно для семантического слоя.
● Коммерческая TypeDB Cloud / Enterprise добавляет кластеризацию, репликацию и корпоративную аутентификацию для промышленной эксплуатации.
Парадигма работы с TypeDB: базовые принципы
Взаимодействие с TypeDB ведется на декларативном языке TypeQL и на уровне концептов предметной области, а не физических таблиц: схема задает жесткий ролевой контракт, в блоке match описывается искомый подграф (оператора JOIN здесь нет — движок сам строит план обхода), а доменные правила выводят новые связи на лету. Специфику синтаксиса и работу этих механизмов мы разберем сразу на сквозном практическом датасете.
Подготовка данных и методология загрузки в TypeDB
Чтобы продемонстрировать построение семантического слоя на реальном примере, мы взяли два разнородных источника данных:
1. Транзакционный массив заказов и логистики. Содержит денормализованные записи о покупках, покупателях, географии, товарных позициях, скидках, сроках доставки и статусах исполнения.
2. Журнал веб-активности (Clickstream). Содержит сырые записи просмотров страниц: метки времени, IP-адреса и идентификаторы товаров.
Очистка данных и выделение строительных блоков
Следуя описанной ранее методологии, мы отсекаем технический шум (маскированные пароли, дублирующиеся URL, отладочные флаги) и декомпозируем плоские строки на независимые сущности и роли, разделенные по предметным контурам:
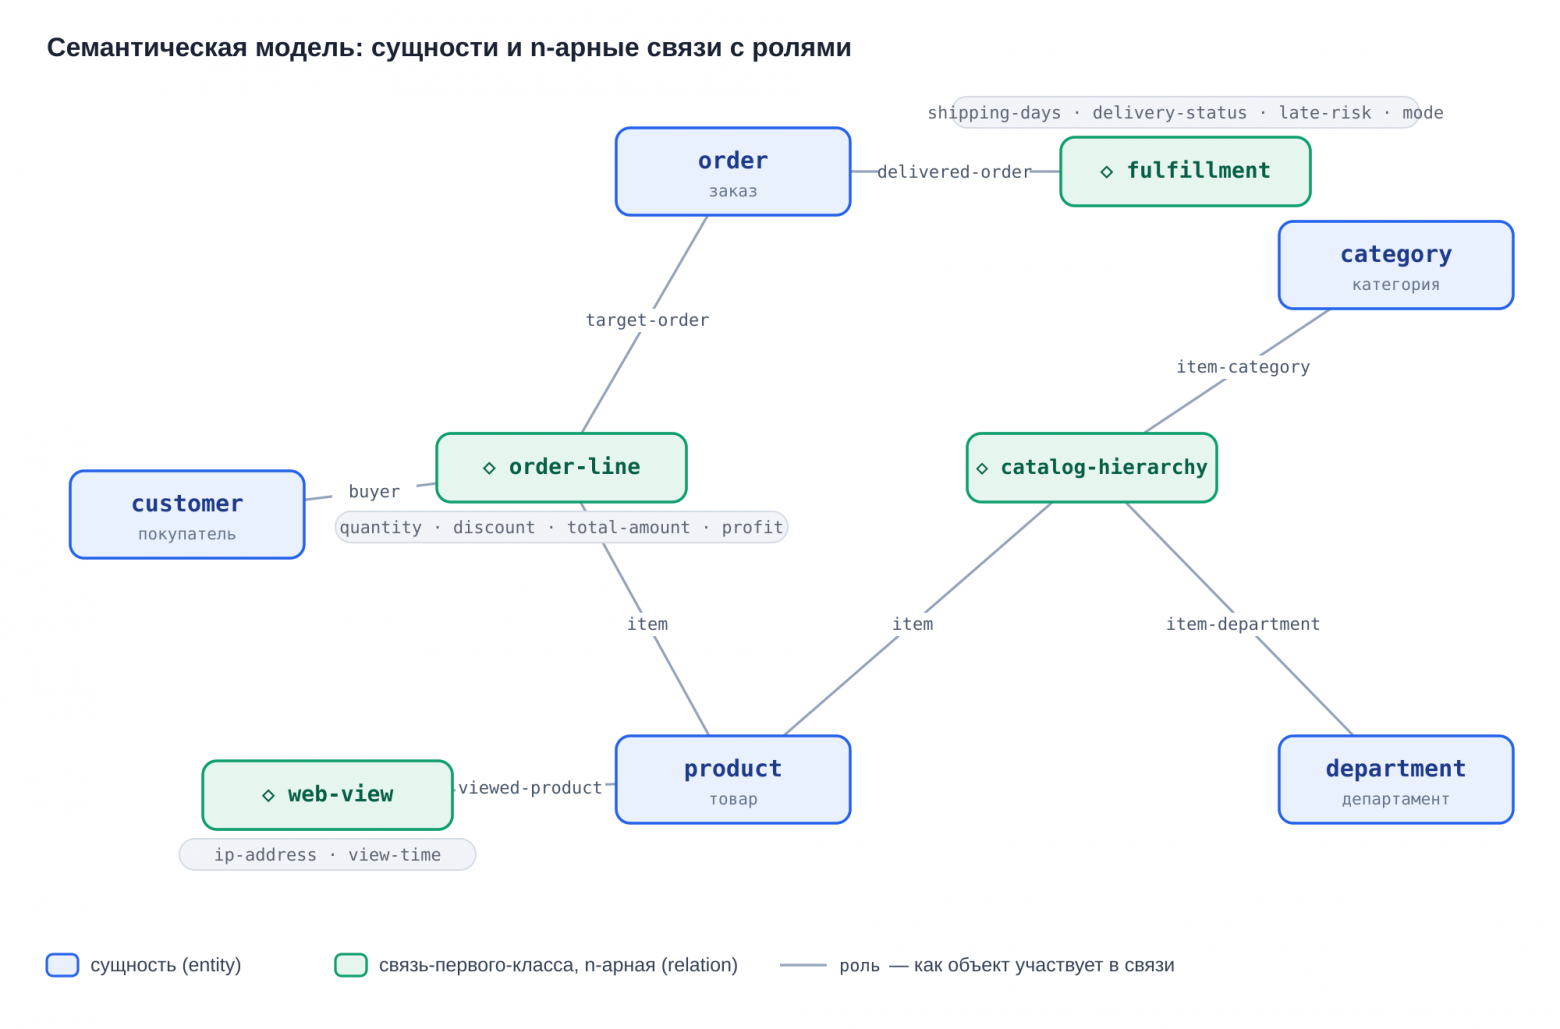
Структурная схема в TypeQL
Вместо перечисления десятков скалярных атрибутов сосредоточимся на каркасе модели — сущностях, ролях и многосторонних отношениях:
define

entity customer,
    owns customer-id, owns first-name, owns last-name,
    owns customer-segment, owns city,
    plays order-line:buyer;

entity product,
    owns product-id, owns product-name, owns product-price,
    plays catalog-hierarchy:item,
    plays order-line:item,
    plays web-view:viewed-product;

entity category, owns category-name, plays catalog-hierarchy:item-category; entity department, owns department-name, plays catalog-hierarchy:item-department;

entity order,
    owns order-id, owns order-date, owns order-status,
    plays order-line:target-order,
    plays fulfillment:delivered-order;

relation catalog-hierarchy,
    relates item, relates item-category, relates item-department;

relation order-line,
    owns quantity, owns discount, owns total-amount, owns profit,
    relates buyer, relates target-order, relates item;

relation fulfillment,
    owns shipping-days-real, owns shipping-days-scheduled, owns delivery-status,
    relates delivered-order;

relation web-view,
    owns ip-address, owns view-time,
    relates viewed-product;
Отношение fulfillment моделирует логистический процесс доставки как самостоятельное событие: даже если на этапе базового датасета в нем участвует только заказ, выделение доставки в отдельное отношение позволяет в дальнейшем связывать в нем перевозчиков, склады и курьеров без изменения контракта заказа.
В статье приведен каркас схемы с ключевыми сущностями и ролями. Полные примеры описания сложных промышленных схем со множеством атрибутов можно найти в официальном репозитории TypeDB: https://github.com/typedb/typedb-examples [4].
Пайплайн загрузки через Python-драйвер
Перенос данных выполняется двухфазно: сначала атомарно фиксируются базовые сущности, затем создаются n-арные связи с распределением ролей участников.
Суть пайплайна наглядно видна на фрагменте загрузки:
from typedb.driver import TypeDB, TransactionType

with TypeDB.driver(TypeDB.DEFAULT_ADDRESS) as driver:
    # Фаза 1: атомарная вставка сущностей
    with driver.transaction("supply_chain", TransactionType.WRITE) as tx:
        tx.query(f"""
            insert
            $c isa customer,
                has customer-id "{row['Customer Id']}",
                has first-name "{row['Customer Fname']}",
                has last-name "{row['Customer Lname']}",
                has customer-segment "{row['Customer Segment']}";
            $o isa order, has order-id "{row['Order Id']}", has order-status "{row['Order Status']}";
            $p isa product,
                has product-id "{row['Product Card Id']}",
                has product-name "{row['Product Name']}",
                has product-price {row['Product Price']};
        """)
        tx.commit()

# Фаза 2: связывание сущностей через роли в отношении order-line
    with driver.transaction("supply_chain", TransactionType.WRITE) as tx:
        tx.query(f"""
            match
            $c isa customer, has customer-id "{row['Customer Id']}";
            $o isa order, has order-id "{row['Order Id']}";
            $p isa product, has product-id "{row['Product Card Id']}";
            insert
            $ol isa order-line,
links (buyer: $c, target-order: $o, item: $p),
                has quantity {row['Order Item Quantity']},
                has profit {row['Order Profit Per Order']};
        """)
        tx.commit()
Фрагмент выше иллюстрирует логику двухфазной записи. Эталонные шаблоны скриптов пакетной загрузки через Python-драйвер с обработкой транзакций и батчингом доступны в репозитории примеров разработчиков: https://github.com/typedb/typedb-driver-examples [5].
Практический кейс: решение сквозной бизнес-задачи в TypeDB против SQL
Для численного подтверждения гипотезы мы развернули тестовый стенд на срезе данных цепочки поставок и веб-логов:
● 65 752 уникальных заказа (order);
● 180 519 позиций заказов (order-line);
● 20 652 уникальных клиента (customer);
● 118 позиций товарного каталога (product);
● 469 977 записей логов просмотров (web-view).
Бизнес-задача: выявить проблемные инциденты обслуживания клиентов и сопоставить их с активностью в веб-каталоге.
Критерии выборки:
1. Покупатель из сегмента Consumer оформил заказ.
2. В заказе присутствует товар из департамента Fitness.
3. Заказ оказался убыточным для компании (profit < 0), при этом доставка была задержана (delivery-status == “Late delivery” или реальный срок доставки превысил плановый).
4. Требуется локализовать список проблемных инцидентов (имена клиентов, номера заказов, названия товаров и суммы убытка) для разбора клиентского опыта [6], сохранив контекст сопутствующей веб-активности каталога без декартова раздувания отчета.
Реализация задачи в классическом SQL
В реляционной базе данных эти сведения раскиданы по отдельным таблицам: клиенты, заказы, позиции заказов, параметры доставки, товары, категории, департаменты и сырой лог просмотров.
Запрос на чистом SQL выглядит следующим образом:
SELECT
    c.first_name,
    c.last_name,
    o.order_id,
    p.product_name,
    ol.profit,
    f.shipping_days_real,
    f.shipping_days_scheduled,
    w.ip_address
FROM orders o
JOIN customers c ON o.customer_id = c.customer_id
JOIN order_items ol ON o.order_id = ol.order_id
JOIN products p ON ol.product_id = p.product_id
JOIN categories cat ON p.category_id = cat.category_id
JOIN departments d ON cat.department_id = d.department_id
JOIN fulfillment f ON o.order_id = f.order_id
LEFT JOIN web_views w ON p.product_id = w.product_id
WHERE c.customer_segment = 'Consumer'
  AND d.department_name = 'Fitness'
  AND ol.profit < 0
  AND (f.delivery_status = 'Late delivery' OR f.shipping_days_real > f.shipping_days_scheduled);
В чем недостатки и скрытые ловушки такого подхода:
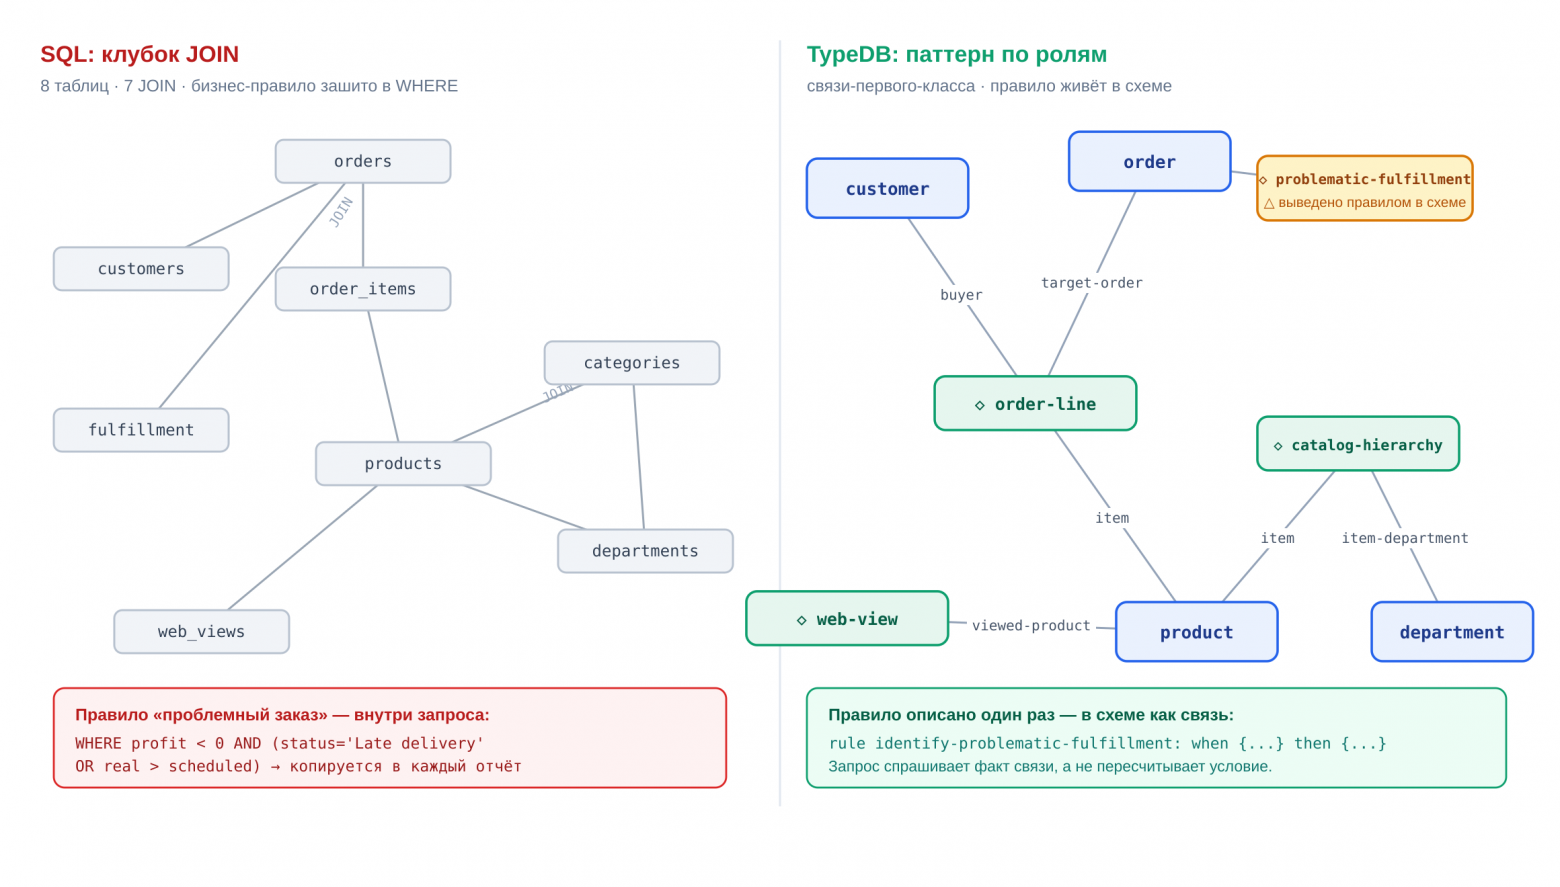
● Проблема раздувания строк (Fan-out trap). В исходном датасете из 65 752 заказов указанному условию соответствуют ровно 136 проблемных инцидентов (135 уникальных клиентов и 14 конкретных товаров). Однако из-за того, что эти товары активно просматривались в каталоге другими пользователями, сырой SQL-запрос вернул выборку из 737 884 строки вместо 136. Произошло декартово раздувание выборки в 5 426 раз: на каждую реальную строку заказа пришлось в среднем по 5 426 дубликатов (а по самому популярному товару — до 13 275 дубликатов). Чтобы схлопнуть выборку обратно до 136 строк, разработчик вынужден оборачивать запрос в тяжелые группировки с ARRAY_AGG(DISTINCT w.ip_address) и GROUP BY по 7 полям, создавая избыточную нагрузку на процессор и оперативную память СУБД.
● Высокая связанность с физической структурой: запрос требует точного знания всех семи таблиц и промежуточных внешних ключей (category_id, department_id, product_id). Если классификатор каталога изменится, запрос перестанет работать.
● Размытие бизнес-логики: критерий проблемного обслуживания жестко зашит в предикаты WHERE. Если другой разработчик забудет про условие shipping_days_real > shipping_days_scheduled, данные в отчетах разойдутся.
Реализация задачи в TypeDB через семантический слой
В TypeDB 3.0 логика выявления проблемной доставки выносится в декларативную функцию прямо в схему данных:
define

fun problematic_orders() -> { order }:
    match {
        $o isa order;
        fulfillment (delivered-order: $o),
            has delivery-status "Late delivery";
    } or {
        $o isa order;
        fulfillment (delivered-order: $o),
            has shipping-days-real $real,
            has shipping-days-scheduled $sched;
        $real > $sched;
    };
    return { $o };
Функция вызывается прямо в блоке сопоставления шаблона, а иерархический оператор fetch позволяет забрать сопутствующий контекст веб-просмотров в виде вложенного JSON-массива без уплощения данных:
match
$c isa customer,
    has first-name $fname,
    has last-name $lname,
    has customer-segment "Consumer";

$p isa product,
    has product-name $pname;

$d isa department,
    has department-name "Fitness";

catalog-hierarchy (item: $p, item-department: $d);

let $o in problematic_orders();
$o has order-id $orderId;

$ol isa order-line,
    links (buyer: $c, target-order: $o, item: $p),
    has profit $prof;
$prof < 0;

fetch {
    "first_name": $fname,
    "last_name": $lname,
    "order_id": $orderId,
    "product_name": $pname,
    "profit": $prof,
    "catalog_views_ips": [
        match web-view (viewed-product: $p), has ip-address $ip;
        return { $ip };
    ]
};
Сравнение результатов и метрик
Результаты тестового прогона на стенде (извлечение 136 целевых клиентских инцидентов с контекстом для LLM-агента):
● TypeDB вернул ровно 136 структурированных документов. В сыром SQL плоский LEFT JOIN размножил выборку в 5 425 раз (до 737 884 строк), требуя тяжелых GROUP BY по 7 полям. Иерархический оператор fetch компактно упаковал историю просмотров во вложенный массив catalog_views_ips, защитив контекстное окно модели от мусора и переполнения.
● В SQL разработчик привязан к физической топологии 7 таблиц и обязан вручную прописывать промежуточные звенья (JOIN categories), а бизнес-правила дублировать в WHERE. В TypeDB запрос формулируется как декларативный ролевой паттерн без транзитного мусора (catalog-hierarchy (item: $p, item-department: $d)), а критерии проблемности централизованы в функции схемы problematic_orders().
● Реляционный движок отдал выборку за 0.034 секунды, тогда как TypeDB выполнял запрос 249 секунд (~4.1 мин). Причина разрыва — в природе графового ядра: TypeDB на лету выполнял динамический обход и агрегацию сотен тысяч связей web-view (суммарно более 700 000 вхождений) и строил дерево объектов в памяти, тогда как SQL выполнял быстрое линейное сканирование.
Сравнение с SQL и Cypher/GQL: какую нишу занимает семантический слой
Чтобы точно определить место семантического слоя на базе TypeDB в корпоративном стеке, сопоставим его с базовыми парадигмами работы со связанными данными: реляционным SQL и классическими графовыми СУБД (LPG на базе Cypher/ISO GQL).
Эти технологии представляют три ступени эволюции выразительности: от плоских таблиц через парные цепочки к многосторонним концептуальным связям.
Сравнительная таблица подходов
|
Критерий |
SQL (Реляционные СУБД) |
Cypher / GQL (Бинарные графы LPG) |
TypeQL (Гиперграфы TypeDB) |
|
Модель связей |
Внешние ключи и промежуточные таблицы; связь не имеет собственной идентичности |
Строго бинарные ребра (A→B); многосторонние события требуют узлов-костылей |
Нативные N-арные отношения первого класса без искусственных узлов, типизированные роли |
|
Логика запроса данных |
Процедурные каскады JOIN с риском декартова раздувания строк |
Жесткая навигация по топологии: ручная прокладка путей через узлы-посредники |
Декларативное сопоставление по ролям участников; движок сам строит план выборки |
|
Бизнес-правила и логика |
Внешний код приложений, хранимые процедуры или каскады SQL-представлений |
Зашиваются вручную в предикаты WHERE каждого отдельного запроса |
Встроенный логический инференс: СУБД сама генерирует виртуальные связи на лету |
|
Сильные стороны |
Максимальная скорость линейных выборок, тяжелые OLAP-агрегаты, зрелая экосистема |
Эффективный поиск путей произвольной длины, анализ топологии сетей и фрод-графов |
Моделирование сложных доменов без искажения бизнес-сути, инкапсуляция правил в схему |
|
Ограничения |
Экспоненциальный рост сложности запросов при росте связности, потеря контекста |
Замусоривание графа техническими узлами-связками, отсутствие встроенного логического вывода |
Не предназначен для массового сканирования терабайтов сырых логов (OLAP), нишевая экосистема |
Архитектурное позиционирование
Таблица наглядно показывает разделение зон ответственности:
1. Реляционные и колоночные базы (PostgreSQL, ClickHouse) остаются фундаментом для хранения сырых фактов, тяжелых аналитических выборок и транзакционного CRUD-процессинга с плоской структурой.
2. Бинарные графовые СУБД (Neo4j, Memgraph) закрывают задачи сетевого анализа, где критически важен поиск путей и цепочек (социальные графы, маршрутизация, расследование мошенничества).
3. Семантический слой на TypeDB занимает доменный контур со сложной смысловой связностью: избавляет от необходимости превращать бизнес-события в промежуточные узлы-костыли и переносит правила валидации из кода запросов прямо в схему данных.
Целевая ниша семантического слоя
Использование семантического слоя на базе TypeDB оправдано в следующих архитектурных узлах:
● Доменный контур с высокой плотностью связей (Core Domain Layer). Ситуации, когда бизнес-логика связывания сущностей настолько разветвлена, что поддержание десятков связующих таблиц и каскадов JOIN в SQL приводит к деградации читаемости и частым ошибкам в аналитических отчетах.
● Централизованный репозиторий бизнес-правил. Перенос логики категоризации, политик валидации и выявления проблемных состояний (как в разобранном примере с проблемной доставкой) непосредственно в схему данных. Это исключает дублирование одних и тех же условий в коде сервисов, витринах dbt и дашбордах BI.
● Питание контекстом прикладных алгоритмов. Предоставление чистого, типизированного графа зависимостей для модулей маршрутизации, рекомендательных движков и аналитических агентов, которым для работы требуются строгие семантические роли и связи, а не плоские массивы идентификаторов.
Итоги и куда развивать подход
Семантический слой не заменяет реляционные СУБД и аналитические озёра данных — он закрывает разрыв между физическим хранением байтов и реальной моделью бизнеса. Связи первого класса и декларативные функции в TypeDB убирают каскады JOIN, а бизнес-правила получают единую точку определения в схеме: меняется одна строка правила — и все потребители сразу работают с актуальной логикой.
Тот же слой оказывается готовым контекстом для LLM. Результат нашего запроса — не плоская выборка, а 136 структурированных документов с ролями, выведенным фактом проблемной доставки и вложенной веб-активностью: ровно то, чего не хватает модели в сценарии из начала статьи. Наивный RAG заставил бы её догадываться о связях по похожим фрагментам — здесь агент получает заземлённые, проверяемые факты и разбирает клиентский инцидент, не выдумывая ни статусов, ни сумм. Эмбеддинги это не отменяет — для поиска по неструктурированному тексту они по-прежнему нужны, на практике это гибрид, — но там, где важна не похожесть, а правота, слой даёт фундамент из фактов.
Куда развивать дальше: битемпоральность (хранить не только текущие связи, но и период их валидности), параметризованные функции TypeDB 3.0 для скоринга и поиска аномалий на лету, и гибридная связка «холодные сырые факты в ClickHouse/S3 Lakehouse + компактное семантическое ядро в TypeDB.
Автор: neoflex
Источник [7]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/35951
URLs in this post:
[1] интеллекта: http://www.braintools.ru/article/7605
[2] логика: http://www.braintools.ru/article/7640
[3] памятью: http://www.braintools.ru/article/4140
[4] https://github.com/typedb/typedb-examples: https://github.com/typedb/typedb-examples
[5] https://github.com/typedb/typedb-driver-examples: https://github.com/typedb/typedb-driver-examples
[6] опыта: http://www.braintools.ru/article/6952
[7] Источник: https://habr.com/ru/companies/neoflex/articles/1085748/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1085748
Нажмите здесь для печати.