Федеративное обучение без единой инфраструктуры: Docker, Kubernetes и Slurm в одной федерации
VK Cloud [1] перевела материал о том, как NVIDIA FLARE помогает участникам проекта федеративного обучения [2] работать вместе, даже если у них разные инфраструктуры. Рассказываем, зачем платформе двухуровневая архитектура и как каждая организация сохраняет контроль над своими данными и вычислительными ресурсами.
Введение
Проекты федеративного обучения (FL) часто начинаются с простой схемы: один сервер, несколько клиентов и по одному набору данных у каждого участника. Но по мере роста проекта на первый план выходит уже не сам алгоритм, а общая инфраструктура. Нужно выделять GPU под задачи, разграничивать исследования и при этом сохранять за каждой организацией контроль над её данными, секретами и правилами использования вычислительных ресурсов.
Задача усложняется, когда участники работают в разных средах. У одних есть сервер с Docker, у других — кластер Kubernetes, а исследовательский центр может распределять задачи на GPU через Slurm. Если для совместной работы всем придётся перейти на одинаковую инфраструктуру, её унификация станет дополнительным препятствием.
NVIDIA FLARE решает эту проблему: отделяет постоянно работающие сервисы федерации от процессов, которые выполняют отдельные задания.
Благодаря двухуровневой архитектуре FLARE каждая площадка может использовать подходящую ей среду выполнения — например, Docker, Kubernetes или Slurm — и при этом оставаться частью одной федерации. Участники сами определяют, как выделять вычислительные ресурсы и какие наборы данных, образы и секреты использовать в каждом исследовании. Правила запуска заданий тоже остаются под их контролем.
Поддержка Docker и Kubernetes доступна в NVIDIA FLARE 2.8. В версии 2.9 добавлена поддержка Slurm.
Разделение координации федерации и выполнения задач
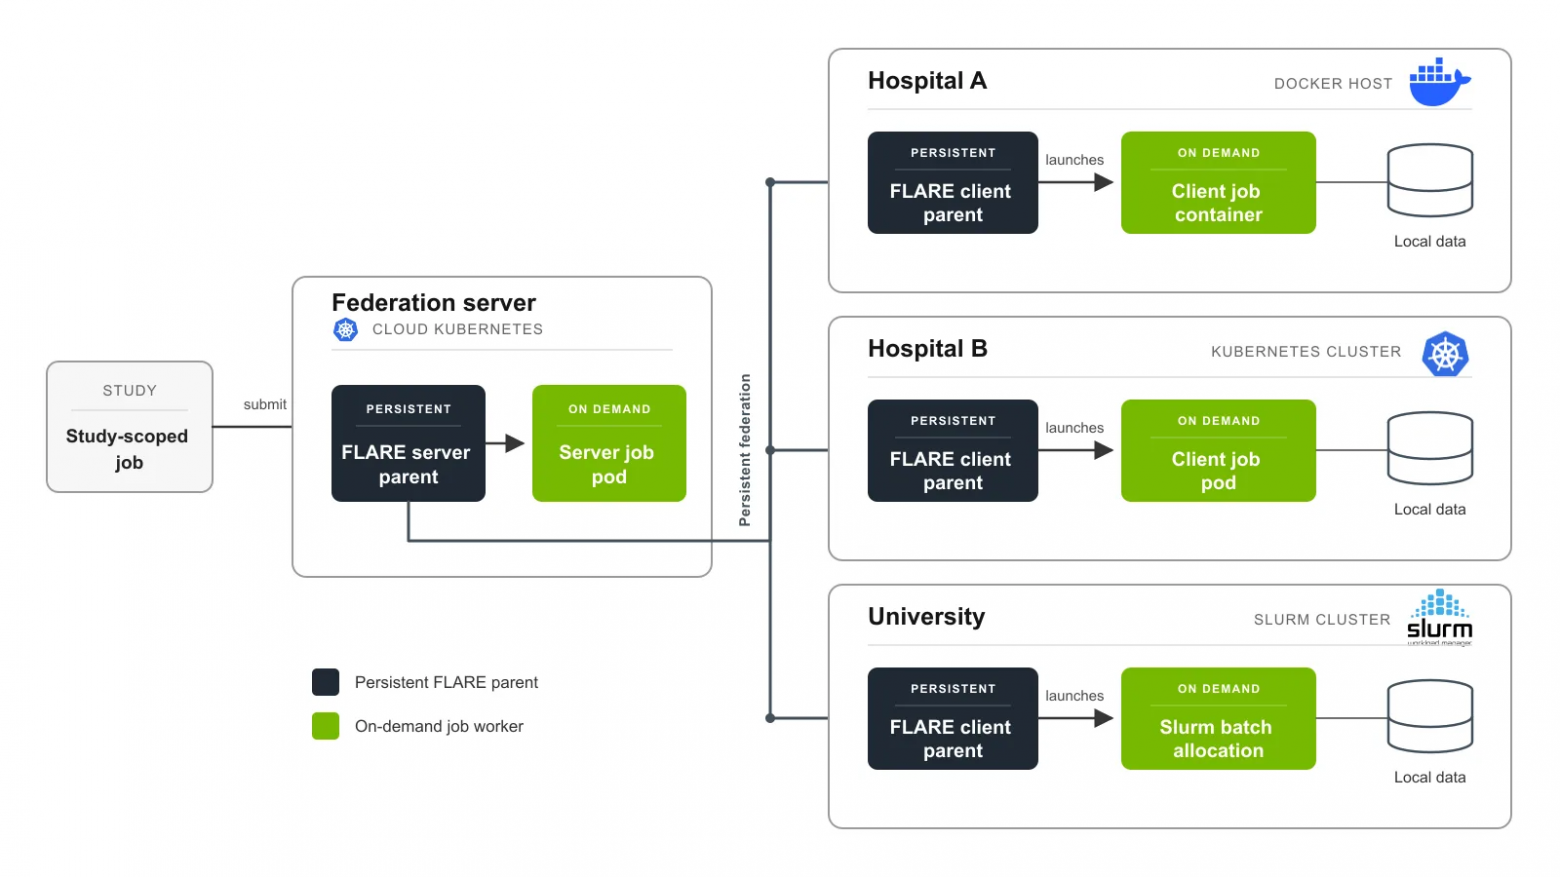
Развёртывание FLARE состоит из двух операционных слоёв. Долгоживущие родительские процессы сервера и клиента поддерживают федерацию, аутентифицируют соединения и координируют работу. Отдельные job worker сервера и клиента выполняют отправленную задачу FL.
Благодаря такому разделению задачи выполняются с учётом фактической потребности [3] в ресурсах. Родительские процессы могут оставаться доступными, не занимая GPU, необходимые для обучения. Когда дата-сайентист отправляет задачу, каждый родительский процесс запускает worker через настроенную для него исполняющую платформу. Worker получает задачу, использует запрошенные ресурсы, возвращает результаты и завершается, когда его работа выполнена.
Задача описывает требования к ресурсам отдельно от деталей платформы. Задача может запросить GPU, целые планируемые единицы CPU и память [4] хоста. Launcher каждой площадки объединяет эти требования с локальной конфигурацией study и переводит их в Docker-контейнер, Kubernetes-под или Slurm-allocation.
Вместе эти слои поддерживают доступность федеративных сервисов, а job worker и их ресурсы создаются по требованию на каждой площадке.
Развёртывание job worker в Docker, Kubernetes и Slurm
NVIDIA FLARE интегрируется со стандартными системами развёртывания и планирования. Оператор площадки выбирает исполняющую среду, которая соответствует локальному окружению, и отвечает за её политики.
|
Исполняющая среда |
Типичная среда |
Динамическая единица выполнения |
Распорядитель ресурсов |
|
Docker |
Рабочая станция или однохостовая площадка |
Job-контейнер |
Docker-хост |
|
Kubernetes |
Облачный или локальный кластер |
Job-под |
Планировщик Kubernetes |
|
Slurm |
HPC или общий GPU-кластер |
Batch-allocation |
Планировщик Slurm |
Docker для контейнеризированного выполнения на одном хосте
Docker [5] хорошо подходит для рабочей станции, лабораторного сервера, edge-системы или другой однохостовой среды. Постоянный сервер или клиент FLARE выполняется в родительском контейнере, собранном из родительского образа. Для каждой отправленной задачи FLARE динамически запускает отдельный job-контейнер, собранный из job-образа.
Родительский образ содержит runtime FLARE и компоненты, необходимые для запуска контейнеров. Отдельный job-образ может содержать фреймворк обучения, код модели и зависимости приложения. Площадки могут предоставлять запрошенные GPU job-контейнерам через NVIDIA Container Toolkit и использовать настройки Docker для общей памяти, точек монтирования, сети и других особенностей, специфичных для хоста.
Разделение родительских и job-образов также упрощает обновления. Владельцы инфраструктуры могут поддерживать стабильность родительского окружения, а исследователи независимо обновляют своё окружение для обучения, соблюдая принятую на площадке политику утверждения образов и кода.
Kubernetes для динамически планируемых job-подов
В Kubernetes [6] Helm-чарт устанавливает каждый постоянный сервер или клиент FLARE как родительский под. Для каждой отправленной задачи родительский под создаёт отдельный job-под сервера или клиента. Планировщик Kubernetes размещает этот под в соответствии с его требованиями к CPU, памяти, GPU, хранилищу и размещению.
Такой подход связывает задачи FLARE со знакомыми возможностями Kubernetes. Площадка может использовать пространства имён, сервисные учётные записи, Secret, persistent volume, селекторы узлов, toleration и admission policies. Например, один study может использовать шаблон пода для выбора узлов H100, а другой study использует другой пул узлов.
Операторы платформы настраивают классы хранилища, учётные данные реестра, сетевую политику, включение GPU и управление доступом на основе ролей (RBAC) для своих кластеров. FLARE использует эти сервисы для запуска и мониторинга job-подов.
Slurm для планируемых GPU- и многоузловых allocation
Многие университеты, исследовательские центры и корпоративные вычислительные среды используют Slurm [7] для совместного использования GPU-кластеров. Launcher Slurm в FLARE отправляет каждый job worker сервера или клиента как пакетную задачу. Slurm выбирает вычислительные узлы и следит за соблюдением запрошенных ограничений по GPU, CPU, памяти, partition, аккаунту, качеству обслуживания (QoS) и времени.
Задачи могут запрашивать один узел или несколько узлов. FLARE отправляет allocation, отслеживает его состояние, передаёт информацию о завершении или сбое и отменяет его при необходимости. Launcher поддерживает непосредственное выполнение (без sandbox), контейнеры Pyxis/Enroot и контейнеры Apptainer.
Slurm остаётся распорядителем ресурсов. Его аккаунты, association, partition, правила QoS, cgroups, права доступа файловой системы и средства управления устройствами определяют, что может использовать allocation. Это сохраняет операционную модель, которую администраторы кластера уже используют для нефедеративных рабочих нагрузок.
NVIDIA FLARE обеспечивает аутентификацию участников, защищённую связь и авторизацию, а исполняющая платформа каждой площадки применяет локальные политики в отношении ресурсов и рабочих нагрузок. Операторы площадок настраивают безопасность хоста и кластера, утверждённые образы, секреты и средства управления доступом, а также проверяют изоляцию рабочих нагрузок для выбранной ими исполняющей среды.

Lakehouse-платформа для аналитики и ML
Объединяйте данные из разных систем и снижайте расходы на хранение в 7–10 раз
Разделение исследований с помощью study
Совместное использование инфраструктуры порождает ещё один вопрос: как несколько команд могут выполнять FL study, не смешивая пользователей, задачи или данные?
FLARE study задают логическую мультитенантную границу в рамках одного развёртывания. Каждый study определяет свои участвующие клиентские площадки и администраторов, которые могут открыть для него сессию. Операции с учётом study ограничивают видимость задач, статус клиента, адресаты отправки и карты развёртывания рамками активного study.
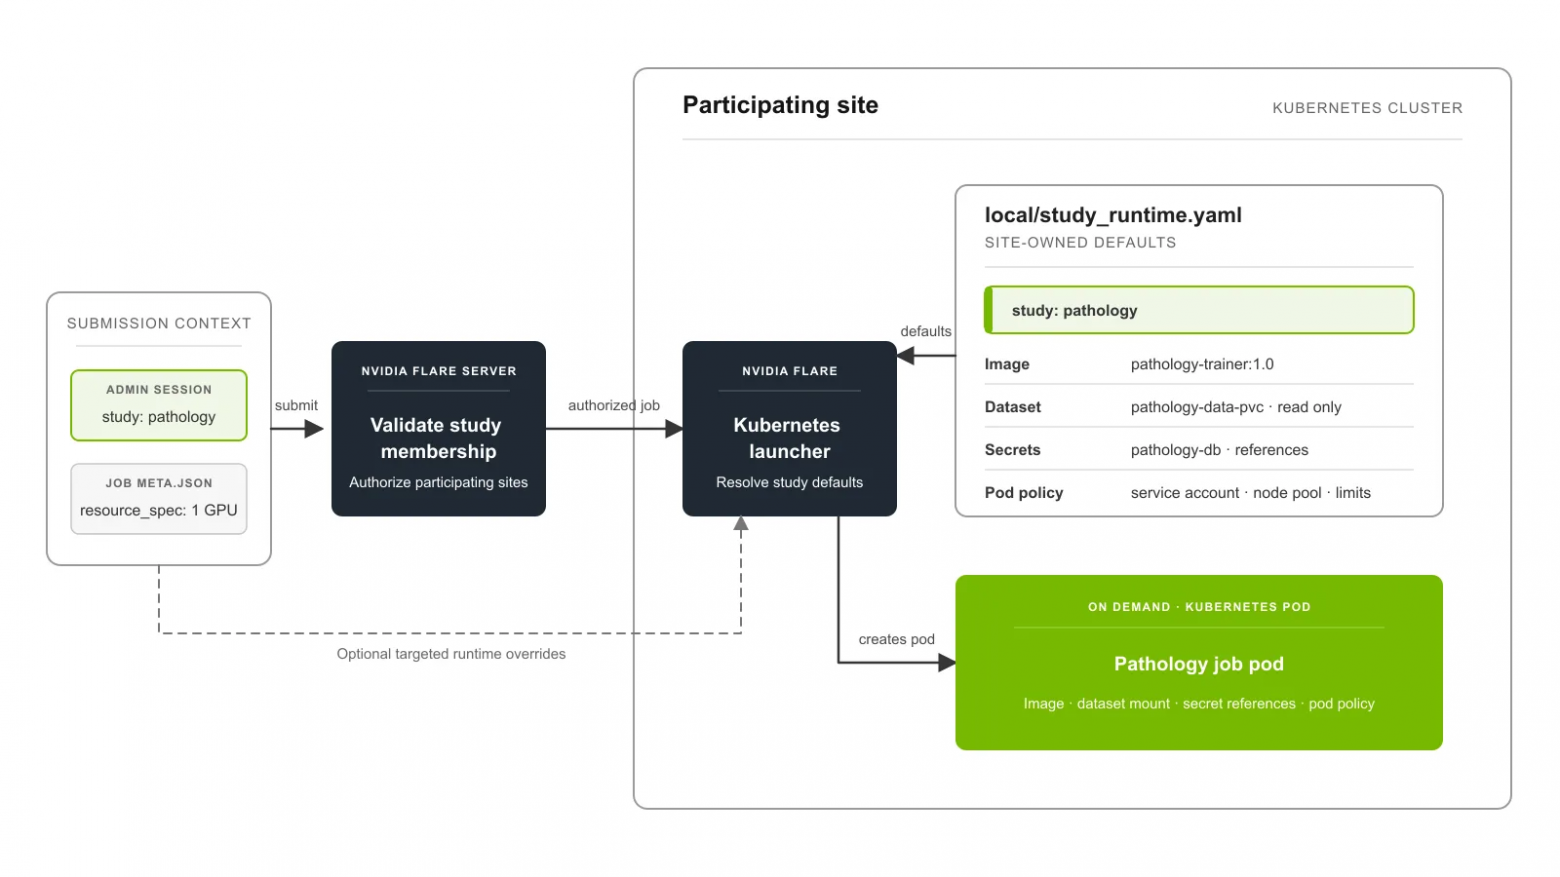
Граница study распространяется на каждую участвующую площадку. Файл local/study_runtime.yaml, которым владеет площадка, сопоставляет study с ресурсами, которые он может использовать локально. В зависимости от исполняющей среды эта конфигурация может определять:
-
Монтирования наборов данных
-
Переменные окружения
-
Переменные окружения и монтирования файлов на основе секретов
-
Одобренный площадкой job-образ по умолчанию
-
Шаблоны подов Kubernetes
-
Настройки исполняющей среды Docker
-
Sandbox, partition, account и политика QoS в Slurm
Дата-сайентист выбирает study, открывая привязанную к нему сессию. Задачи, отправленные из этой сессии, наследуют контекст study. Задачи не выбирают произвольные локальные пути к наборам данных и не передают значения секретов. Сервер FLARE проверяет принадлежность к study, прежде чем задача попадёт на площадку, а оператор площадки контролирует сопоставление этого study с локальными ресурсами.
Следующий сокращённый пример для Kubernetes сопоставляет study по патологии с томом данных, которым владеет площадка, и учётными данными базы данных. Конфигурация содержит ссылки на Secret, а не их значения.
format_version: 2
studies:
  pathology:
    container:
      image: registry.example.com/pathology-trainer:1.0
    datasets:
      slides:
        source: pathology-data-pvc
        mode: ro
    secret_env:
      DB_USER: {source: pathology-db, key: username}
      DB_PASSWORD: {source: pathology-db, key: password}
Когда задача из сессии, привязанной к study по патологии, попадает на эту площадку, launcher для Kubernetes выбирает соответствующую запись studies.pathology. Launcher использует образ study как локальный по умолчанию и монтирует том pathology-data-pvc только для чтения по пути /data/pathology/slides внутри job-контейнера. Путь монтирования формируется из имён study и набора данных как /data/<study>/<dataset>.
Записи secret_env становятся ссылками Kubernetes secretKeyRef в спецификации пода. Kubernetes подставляет значения username и password из Secret pathology-db при запуске пода. Так учётные данные остаются в хранилище секретов площадки, а worker study получает нужное окружение.
Study предназначены для организаций, которые используют общий сервер FLARE и общую инфраструктуру открытых ключей (PKI), но нуждаются в логическом разделении между экспериментами. Организациям, которым нужны отдельная PKI, отдельный администратор инфраструктуры или отдельный радиус поражения при сбое, следует использовать отдельные развёртывания FLARE.
Объединение неоднородной федерации
В федерации, показанной на рисунке 1 выше, study по патологии объединяет обе больницы и университет, используя GPU worker и одобренные каждой площадкой наборы данных изображений. Study по исходам включает только больницы и использует CPU worker для анализа структурированных клинических данных.
Оба study используют общие постоянные сервисы федерации. Принадлежность к study определяет, какие площадки участвуют, а конфигурация study на каждой площадке предоставляет наборы данных, образы, секреты и настройки планирования для её worker. Исследователи отправляют задачи из соответствующей сессии study, и локальные launcher применяют эти настройки.
Отправка задачи
FLARE 2.9 поддерживает переносимые требования к GPU, CPU и памяти хоста в resource_spec внутри meta.json задачи. Переносимые ключи: num_of_gpus, num_of_cpus и memory. Значения CPU выражаются целым числом планируемых единиц CPU, а для памяти используются положительные целые значения с единицами Mi, Gi или Ti.
Запись @default применяет один профиль ресурсов ко всем целевым площадкам, включая сервер. Именованная запись клиента или сервера задаёт только те значения, которые отличаются. В этом примере обе больницы наследуют один GPU, четыре единицы CPU и 64 ГиБ памяти. Университет переопределяет количество GPU, а сервер обнуляет его. Оба наследуют одинаковые требования к CPU и памяти.
{
  "resource_spec": {
    "@default": {
      "num_of_gpus": 1,
      "num_of_cpus": 4,
      "memory": "64Gi"
    },
    "server": {"num_of_gpus": 0},
    "university": {"num_of_gpus": 8}
  }
}
Каждый launcher переводит вычисленные значения в собственные настройки среды. Docker преобразует четыре единицы CPU в nano_cpus=4000000000, переводит 64 ГиБ в mem_limit, выраженный в байтах, и применяет запрос GPU-устройства. Kubernetes задаёт соответствующие запросы и лимиты CPU и памяти и добавляет запрос GPU. Slurm генерирует --cpus-per-task=4, --mem=65536M и соответствующее значение --gres для GPU.
Дата-сайентист открывает сессию, привязанную к study, и один раз отправляет задачу на сервер FLARE, который разворачивает её участникам study. На каждой площадке настроенный launcher применяет локальные настройки исполняющей среды по умолчанию для этого study. Затем он создаёт worker. FLARE координирует федеративный workflow и сообщает статус задачи, а Docker, Kubernetes и Slurm управляют локальными ресурсами.
Используйте launcher_spec для топологии и политик, зависящих от конкретной исполняющей среды, например для раскладки узлов Slurm или образа, привязанного к исполняющей среде. Конфигурация исполняющей среды study предоставляет одобренные локальные настройки по умолчанию для образов, наборов данных, секретов и политики выполнения на каждой площадке.
Что это даёт
Инфраструктура федеративного обучения не обязана быть единообразной для всех участников. FLARE отделяет постоянные сервисы федерации от динамически запускаемых job worker, чтобы каждая площадка могла использовать Docker, Kubernetes или Slurm. Study добавляют принадлежность, ограниченную своей областью действия, и сопоставления данных, секретов, образов и политики планирования, которыми владеет площадка.
Благодаря этим возможностям федерация может охватывать локальные системы и облака, не вынуждая каждую организацию переходить на одну и ту же платформу. Площадки могут выделять GPU и другие ресурсы, когда они нужны задачам, сохранять привычные инструменты операционного контроля и выполнять несколько study над независимо управляемыми данными. Неоднородная инфраструктура становится частью архитектуры федерации, а не барьером для её масштабирования.
Чтобы начать, изучите документацию NVIDIA FLARE [9] и репозиторий NVIDIA FLARE на GitHub [10].
Автор: levashove
Источник [11]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36136
URLs in this post:
[1] VK Cloud: https://cloud.vk.ru/?utm_source=habr&utm_medium=referral&utm_campaign=vkcloud_article_1087398&utm_content=habr
[2] обучения: http://www.braintools.ru/article/5125
[3] потребности: http://www.braintools.ru/article/9534
[4] память: http://www.braintools.ru/article/4140
[5] Docker: https://www.docker.com/
[6] Kubernetes: https://kubernetes.io/
[7] Slurm: https://slurm.schedmd.com/
[8] Получить консультацию: https://cloud.vk.ru/data-platform/?utm_source=habr&utm_medium=referral&utm_campaign=vkcloud_article_1087398
[9] документацию NVIDIA FLARE: https://nvflare.readthedocs.io/en/main/
[10] репозиторий NVIDIA FLARE на GitHub: https://github.com/NVIDIA/NVFlare
[11] Источник: https://habr.com/ru/companies/vktech/articles/1087398/?utm_campaign=1087398&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.