Человек напишет хоть один текст сам? Как работают детекторы ИИ
Библию несколько раз прогоняли через популярные детекторы ИИ-текста и получали вердикт: «Написано нейросетью». Каждый год тысячи студентов бездоказательно получают обвинения в использовании ИИ, а преподаватели ставят неуд текстам, которые человек писал от начала до конца сам. Одновременно выходят Анти ИИ-детекоры, созданные специально, чтобы бороться с ИИ-детекторами. Вынуждены признать, что на данный момент детекторы в схватке проигрывают — разибраем, что они делают не так с точки зрения [1] науки машинного обучения [2].
Как ИИ-детекторы определяют сгенерированный текст
Основные сервисы измеряют два параметра. Поняв только их, можно уловить 80% того, как работает эта технология.
Перплексия показывает, насколько предсказуемо следующее слово в тексте. Низкая перплексия означает, что текст следует ожидаемым статистическим паттернам — это признак генерации нейросетью. Высокая перплексия означает использование неожиданных и нетривиальных словосочетаний, конструкций, больше напоминающих оригинальный авторский стиль. ИИ-текст всегда имеет более низкую перплексию по сравнению с человеческим письмом, потому что языковая модель склонна выбирать статистически наиболее вероятную последовательность слов. Проще говоря: нейросеть всегда выбирает «правильное» слово. Человек же свободен намеренно выбрать «неправильное» — но именно это сделает его текст живым.
Бурстинесс измеряет вариативность длины и сложности предложений. Сгенерированный текст однороден: примерно 15–25 слов в предложении, плавные переходы и пресловуто нейтральный тон. Человеческий текст может содержать как предложение из трёх слов, так и длинное с несколькими придаточными, отступлением и возвратом к основной мысли. Попросите ChatGPT написать про что угодно и увидите, что почти каждое предложение выйдет в 15–25 слов с формальной лексикой. Человек, к счастью, не будет намеренно высчитывать количество слов, чтобы причесать свой текст — банально не хватит времени.
Кто играет на поле детекции
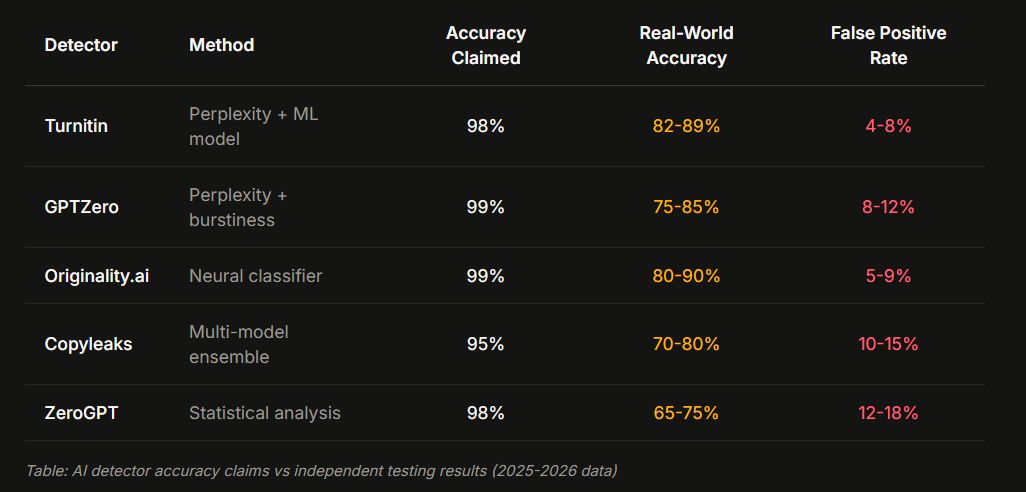
GPTZero — популярный ИИ-детектор, созданный студентом Принстонского университета в 2023 году: так Эдвард Тян хотел помочь преподавателям в проверке студенческих работ. Сейчас у сервиса 17 миллионов пользователей, и он позиционируется как инструмент номер один в категории. Разработчики заявляют о высокой точности распознавания: 99% для полностью сгенерированных текстов и 96,5% для смешанных. Кроме того, GPTZero — единственный детектор, оптимизированный под тексты не-носителей английского языка. Благодаря устранению системных ошибок (дебайасингу) создателям удалось снизить долю ложноположительных срабатываний на таких текстах всего до 1%.
Однако на независимых текстах количество ложных срабатываний сильно колеблется: от 1% на контролируемых бенчмарках до 11% на текстах из реальной практики. Более того, в отдельных исследованиях этот показатель достигал 61,3%. По уровню защиты от обхода GPTZero держится «середнячком». Его базовый подход, основанный на анализе вариативности и непредсказуемости текста, вполне надежен, если текст не подвергается глубокой реструктуризации.
Turnitin считается золотым стандартом и самым сложным детектором для обхода. Он работает внутри институциональных систем и обучен на миллиардах студенческих работ — такими данными не может похвастаться ни один конкурент. Turnitin также может сравнивать текущую работу с предыдущим стилем письма студента через институциональную историю. Система признает текст сгенерированным, если итоговая оценка составляет от 20% до 100%. При этом в пограничном диапазоне (от 1% до 19%) фиксируется повышенная частота ложных срабатываний, поэтому такие низкие показатели никогда не используют как решающий аргумент.
Originality — третий по надёжности сервис. Он обновляется чаще конкурентов и использует нейронный классификатор, более тонкий, чем простой анализ перплексии. Популярен у издателей и контент-агентств, которым регулярно нужно проверять большие объёмы текста.
ZeroGPT и Copyleaks — самые простые в обходе из основных детекторов. Их модели обновляются реже, и они более склонны как к ложным срабатываниям, так и к ложным пропускам реального ИИ-текста.
Можно ли доверять точности ИИ-детектеров?
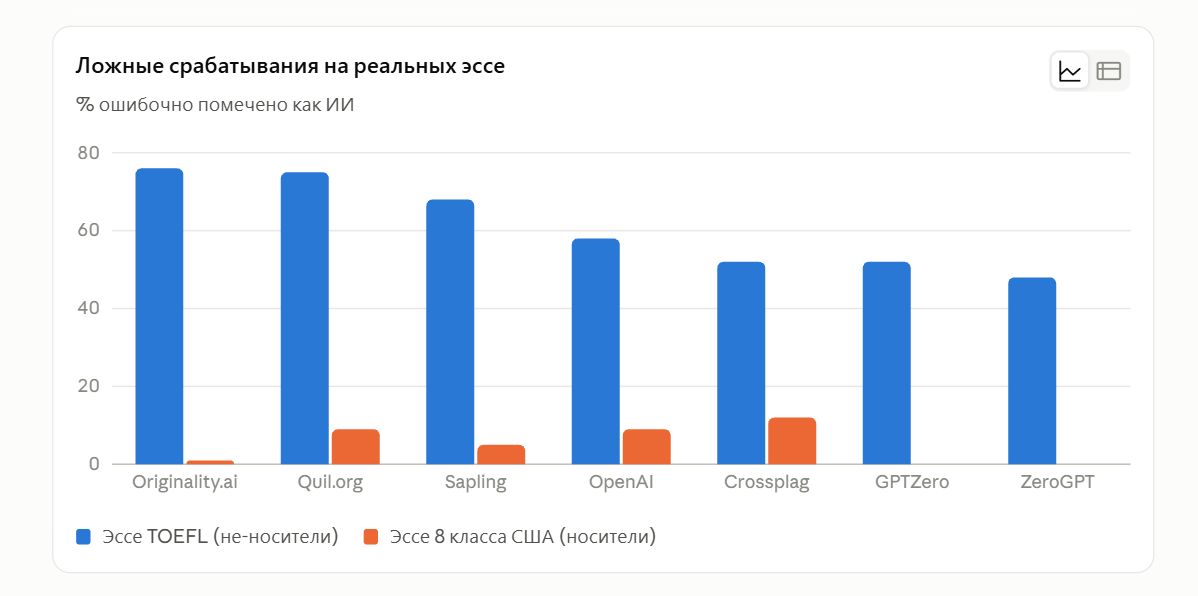
Разработчики, как это часто бывают, заявляют впечатляющие цифры: 99% точности у GPTZero и менее 1% ложных срабатываний у Turnitin. Однако независимые исследования показывают совсем другую картину. Так, ученые из Стэнфорда выяснили [3], что детекторы систематически клеймят тексты не-носителей английского языка как «сгенерированные ИИ». При этом работы носителей языка система распознает безошибочно. Это приводит к скрытой дискриминации: авторов наказывают просто за то, что английский, которому их учили в школе, звучит слишком строго и формально.
Масштабный тест [4] шести популярных детекторов показал среднюю точность всего в 39,5%. А если текст минимально обработать для обхода защиты, этот показатель падает до 17,4%. В ходе другого эксперимента Turnitin пометил как «сгенерированные» около 95% студенческих эссе, хотя на самом деле ИИ использовался лишь в 45% работ. Более того, использование модели парафразирования Dipper от Google Research обрушило точность детектора DetectGPT с 70,3% до 4,6%. При этом доля ложных обвинений осталась прежней (1%) — система перестала видеть ИИ-текст, но продолжала ошибочно штрафовать людей.
Создатели GPTZero признают: ни один ИИ-детектор не обеспечивает 100% точности, а сами технологии генерации постоянно меняются. Поэтому вердикт программы никогда не должен использоваться как окончательное доказательство или повод для наказания.
Почему же детекторы проигрывают
Ахиллесова пята детекторов — их опора на хрупкие статистические паттерны (частоту слов, показатели перплексии, геометрию эмбеддингов), а не на понимание смысла текста. Чтобы обмануть систему, часто достаточно поверхностного рерайта с сохранением сути.
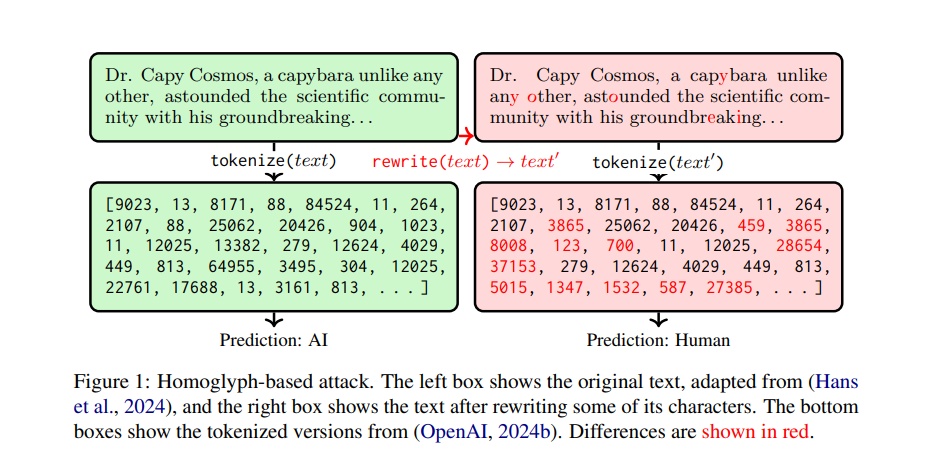
Уязвимости таких систем детально описаны в научных работах. Например, исследование группы Creo [5](2024 год) показало, что точность детекторов резко падает, если просто вставить в текст невидимые Unicode-символы (гомоглифы) или случайные знаки препинания. А обычное перефразирование, согласно данным команды Perkins (2024 год), снижает эффективность распознавания примерно на 17 процентных пунктов.
Единственным исключением можно назвать детектор RADAR — это пока единственная модель, которую специально обучили противостоять парафразам. Она распознает измененный текст на 31,64% точнее аналогов. Однако даже этот сервис не успевает за темпами появления новых инструментов обхода.
Попытки объединить несколько детекторов в единую сеть (ансамбль) тоже не спасают ситуацию: уязвимость одного алгоритма, как правило, легко переносится на другие. Фундаментальная проблема в том, что любой злоумышленник с минимальным бюджетом может быстро дообучить нейросеть (например, через легковесную технологию LoRA) для обхода конкретного детектора, мгновенно умножив все усилия разработчиков защиты на ноль.
Ложные срабатывания: ядро проблемы
Ложное срабатывание — это ситуация, когда текст, полностью написанный человеком, ошибочно помечается как сгенерированный нейросетью. В ее основе лежит глубокий лингвистический парадокс [6].
Когда грамотный студент из России, Китая или Испании пишет на английском, он тщательно выверяет грамматику, использует стандартные книжные конструкции и избегает редких идиом. Проблема в том, что именно так и пишет искусственный интеллект [7] — правильно, предсказуемо и стерильно. В итоге ИИ-детекторы, настроенные на поиск «роботизированного» стиля, в 61,3% случаев путают старательного иностранного студента с чат-ботом.
Систему клинит на людях, которые приложили максимум усилий, чтобы выучить язык. Ложное обвинение в академическом мошенничестве для таких студентов становится двойным ударом: их наказывают не за лень, а за академическую дисциплину.
Что делает текст «человеческим» для детектора
Если вы написали материал через ИИ, для обхода детектора текст нужно подредактировать вручную. Что можно сделать:
-
Намеренная вариация длины предложений — например, короткое предложение, потом очень длинное с множеством запятых, уточнений и отступлений от основной мысли. И так вразнобой.
-
Конкретные детали и примеры вместо обобщений.
-
Придумайте парочку острых метафор или сравнений — так текст будет живее.
-
Нарушение шаблона «тезис → доказательство → анализ → переход» из раза в раз. Смешивайте длины абзацев, добавляйте отступления и не бойтесь экспериментировать.
Что точно не сработает — не стоит даже тратить время:
-
Замена слов синонимами — Turnitin анализирует паттерны всего документа, а не отдельные слова.
-
Лёгкие правки без изменения структуры предложений.
-
Использование ИИ-«гуманизаторов» текста без ручного редактирования. Парадоксально, но многие из них сами грешат, оставляя статистический след, который детекторы новых поколений уже научились замечать.
Цифровые водяные знаки
Параллельно развивается технология цифровых водяных знаков: статистические паттерны вшиваются в материал при генерации, которые в финальной версии текста уловить невозможно.
Например, инструмент SynthID от Google успешно маркирует аудио и видео, добавляя в них невидимые метаданные. С текстом всё сложнее, и разработчики сталкиваются с фундаментальной проблемой: обычный парафраз легко обнуляет водяной знак, обходя детекторы. Смысл текста остается прежним, а вот уникальный цифровой след, по которому можно было бы распознать работу нейросети, полностью стирается.
Рейтинг детекторов по сложности обхода
По данным независимого тестирования [8] 2026 года детекторы можно ранжировать так. Turnitin — самый сложный для обхода: миллиарды проверенных работ в базе, сравнение с личной историей письма студента, продвинутая стилометрическая модель, при этом точность падает с 90% до 30% при умелом парафразировании.
Originality занимает второе место за счёт частых обновлений и более тонкого нейронного классификатора. GPTZero — средний уровень сложности обхода: доступен бесплатно до 10 000 слов в месяц, работает на перплексии и бурстинессе, поддаётся при достаточной реструктуризации текста. ZeroGPT и Copyleaks — самые слабые из основных детекторов на рынке.
Где детекторы применяют кроме учёбы
Академическая среда — не единственная сфера, где используют детекторы ИИ-текста. Издатели и контент-агентства применяют Originalityi и похожие сервисы для проверки статей от внештатных авторов перед публикацией — доверяй, но проверяй, как говорится.
HR-отделы иногда прогоняют сопроводительные письма кандидатов через детекторы, хотя это довольно сомнительная практика. У формального делового письма и без того низкая перплексия просто потому, что того требует жанр. SEO-специалисты проверяют собственный контент перед публикацией, чтобы понимать, как его оценят поисковые системы, хотя прямой связи между результатом детектора и позициями в поиске исследования не подтверждают.
Общий принцип один: результат детектора — это вероятностная оценка, основанная на статистических паттернах. Использовать его как основание для увольнения, отказа в найме или дисквалификации текста явно не стоит, учитывая задокументированную частоту ложных срабатываний.
Технические ограничения
Детекторы работают заметно хуже на коротких текстах — большинству моделей перплексии и бурстинесс нужен достаточный объём материала чтобы вычислить статистику.
Смешанные тексты — где часть написана человеком, а часть отредактирована или дополнена нейросетью — проанализировать еще сложнее. Большинство детекторов сканируют подобный материал как единое полотно. И говорить не стоит, что такой текст почти неизбежно получает результат, который почти невозможно грамотно интерпретировать.
Языковые модели, на которых обучены детекторы, тоже устаревают. Детектор, откалиброванный под паттерны GPT-3.5, может слабее распознавать текст от более новых моделей.
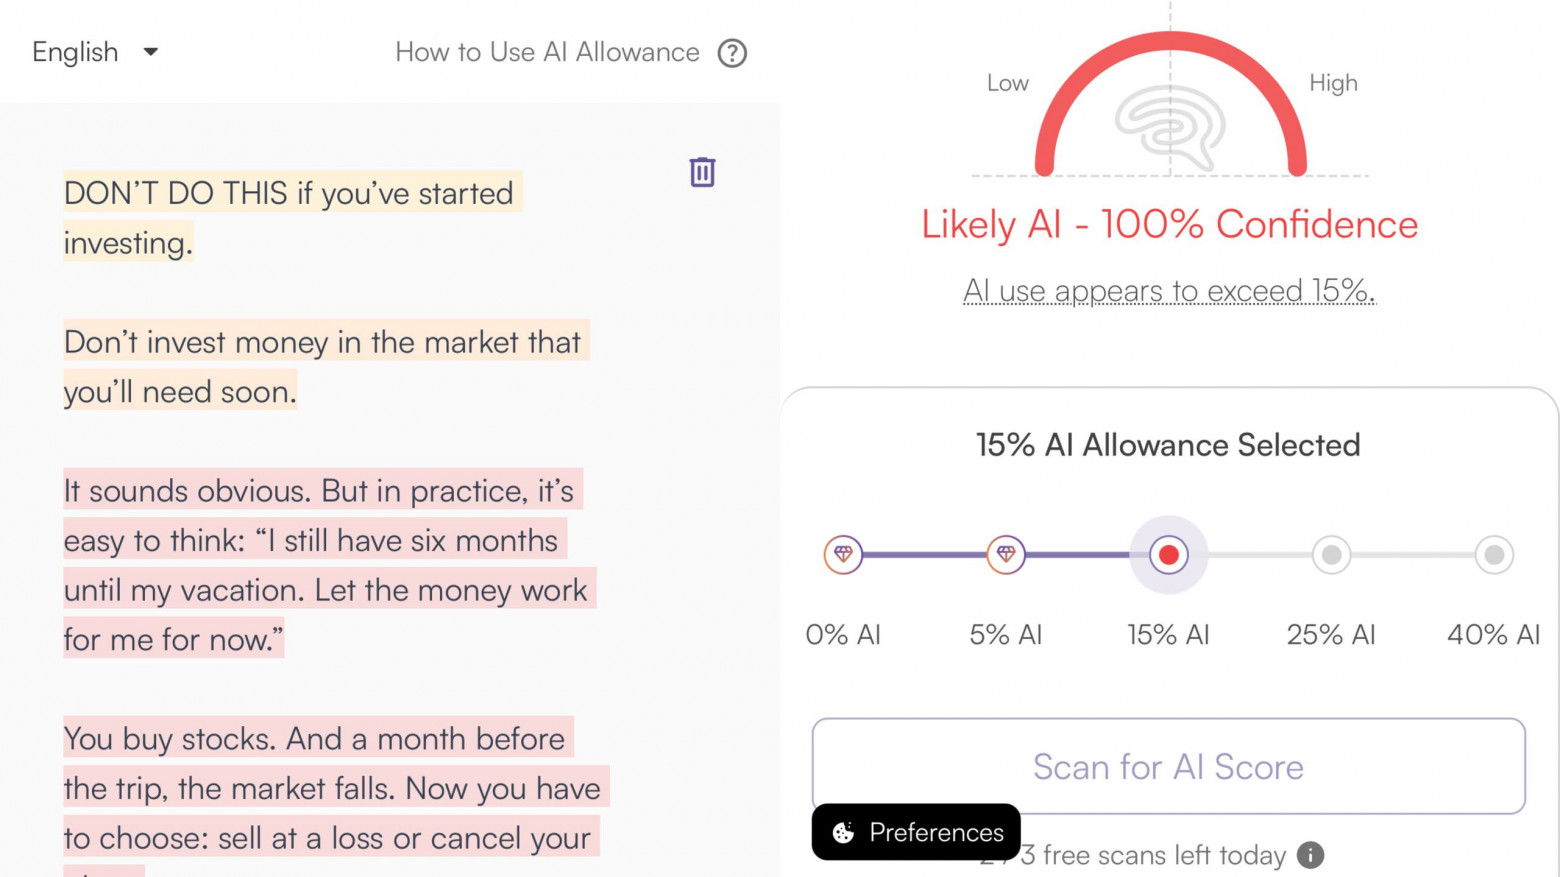
Так, мы проверили текст, который был полностью сгенерирован ChatGPT-6 Astra на SpeShu.AI [9].
Частые вопросы
Можно ли доверять результату ИИ-детекторов на 100%?
Нет. Даже создатели GPTZero сами заявляют, что ни один детектор не даёт стопроцентной точности, а результаты не должны использоваться как окончательный вердикт. Независимые исследования фиксируют среднюю точность основных детекторов на уровне около 39,5%, которая падает до 17,4% на слегка изменённых текстах.
Почему детекторы чаще ошибаются на текстах иностранных студентов?
Не-носители языка часто пишут более формально и очень грамотно, потому что такому английскому их учат в школах. Для детектора такой идеальный текст статистически похож на генерацию нейросети — из-за низкой перплексии и ровной структуры предложений. В отдельных исследованиях доля ложных срабатываний для такого текста достигала 61,3%.
Какой детектор ИИ-текста самый надёжный?
Turnitin считается самым сложным для обхода благодаря базе из миллиардов студенческих работ и сравнению с личной историей письма, но даже его точность падает с 90% до 30% при грамотном парафразировании. Originality.ai [10] — второй по надёжности, GPTZero — средний уровень, ZeroGPT и Copyleaks — самые простые в обходе.
Помогает ли простая замена слов синонимами обойти детектор?
Нет. Такие сервисы, как Turnitin, анализируют статистические паттерны всего документа целиком, а не отдельные слова — замена нескольких слов почти не меняет общую перплексию и бурстинесс текста. Работает структурная переработка: варьирование длины предложений, добавление конкретных деталей, нарушение шаблонной логики абзацев.
Заключение
Ни один детектор ИИ-текста не является на 100% точным инструментом. Что бы ни писали разработчики, данные независимых исследований нередко опровергают заявления вендоров. Вопрос не в том, написал человек текст сам или за него это сделал ИИ — а в том, что человек реально вложил в этот текст: собственный опыт [11], конкретные детали, живую, неровную мысль, которую пока не умеет убедительно имитировать ни одна статистическая модель.
Автор: SpeShuAI
Источник [12]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36327
URLs in this post:
[1] зрения: http://www.braintools.ru/article/6238
[2] обучения: http://www.braintools.ru/article/5125
[3] ученые из Стэнфорда выяснили: https://arxiv.org/abs/2304.02819
[4] Масштабный тест: https://arxiv.org/abs/2403.19148
[5] исследование группы Creo : https://arxiv.org/abs/2406.11239https://arxiv.org/abs/2406.11239
[6] парадокс: http://www.braintools.ru/article/8221
[7] интеллект: http://www.braintools.ru/article/7605
[8] По данным независимого тестирования: https://aihumanizer.so/blog/how-to-bypass-ai-detection
[9] SpeShu.AI: https://speshu.ai/?utm_source=media&utm_medium=habrcorp&utm_campaign=chelovek-napishet-hot-odin-text-sam
[10] Originality.ai: http://Originality.ai
[11] опыт: http://www.braintools.ru/article/6952
[12] Источник: https://habr.com/ru/companies/speshu_ai/articles/1088894/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1088894
Нажмите здесь для печати.