Китайские GPU — две новинки, которые стоит рассмотреть в паре
За последние несколько дней Huawei и Alibaba практически одновременно представили новое железо для ИИ. Huawei [1] — 17 сентября на HUAWEI CONNECT 2026 в Шанхае, Alibaba [2] — 22 сентября на Apsara Conference в Ханчжоу. Это разные китайские компании с разными стратегиями, но если сопоставить их анонсы, то вырисовывается некая общая логика [3]. Китайская GPU-индустрия не пытается повторить архитектуру NVIDIA. Вместо этого она начинает создавать собственные решения проблемы «как связать тысячи чипов», когда доступ к западным технологиям ограничен. Подробности — под катом.
Что анонсировали Huawei

Главный анонс — Atlas 960E SuperPoD, первый в индустрии SuperPoD на базе NPO (near-packaged optics). SuperPoD — это блок из нескольких тысяч ускорителей (NPU/GPU), связанных между собой интерконнектом. Можно сказать, что все устройства в кластере работают как единый компьютер с общей памятью [4]. Это критично для больших ИИ-моделей. Huawei не раскрыла точное число стоек для Atlas 960E, но если ориентироваться на архитектуру предыдущих поколений Atlas 950 SuperPoD с 8192 NPU, то схема состояла из 160 стоек:
-
128 вычислительных стоек (compute, с NPU и CPU),
-
32 коммутационные стойки (технология UnifiedBus).
Предположу, что у Atlas 960E SuperPoD масштаб вдвое меньше и число стоек составит порядка 80 штук.
Характеристики Atlas 960E SuperPoD: до 4096 NPU в одном блоке, 8 EFLOPS на FP8 и 16 EFLOPS на FP4. Через UnifiedBus или RoCE несколько SuperPoD объединяются в SuperCluster. В нем уже до 512 000 NPU по clos-топологии, а в сочетании с многоканальной топологией — до миллиона. В основе Atlas 960E SuperPoD — оптический модуль Hi-ONE: 7,2 Тбит/с на один узел со встроенным источником света. Идея в том, чтобы вместо 48 000 отдельных 800G-трансиверов применить 5 500 модулей Hi-ONE, впаянных прямо рядом с чипом. Экономия — свыше 550 кВт на систему, а доступность системы с точки зрения [5] надежности растет до 99,8%. Устройство может оснащаться ускорителями Ascend 960, разделенными на две версии под разные задачи:
-
960DT для обучения [6] моделей: до 2 PFLOPS FP8 / 4 PFLOPS FP4, 288 ГБ HBM с пропускной способностью 9,6 ТБ/с, выход — в Q1 2027 года;
-
960PR для инференса: до 8 PFLOPS FP4, 192 ГБ памяти с пропускной способностью 2,4 ТБ/с, выход — в Q3 2027 года.
Отдельно интересен апгрейд систем TaiShan 950 SuperPoD. Это та же архитектура, но для CPU общего назначения. Устройство вмещает до 4 096 узлов, выдает единый пул памяти на 256 ТБ. В комплекте также идет OceanStor M900 — хранилище KV-кэша петабайтного масштаба для того, что Huawei называет «слоем L3.5» (контекстная память между GPU-памятью и обычным диском).
И третья новинка — это CANN, программный стек для Ascend, который официально переведен на модель community-driven open source. Выглядит как признание проблемы: ранее закрытый стек не успевал за экосистемой PyTorch и vLLM.
Что анонсировали Alibaba
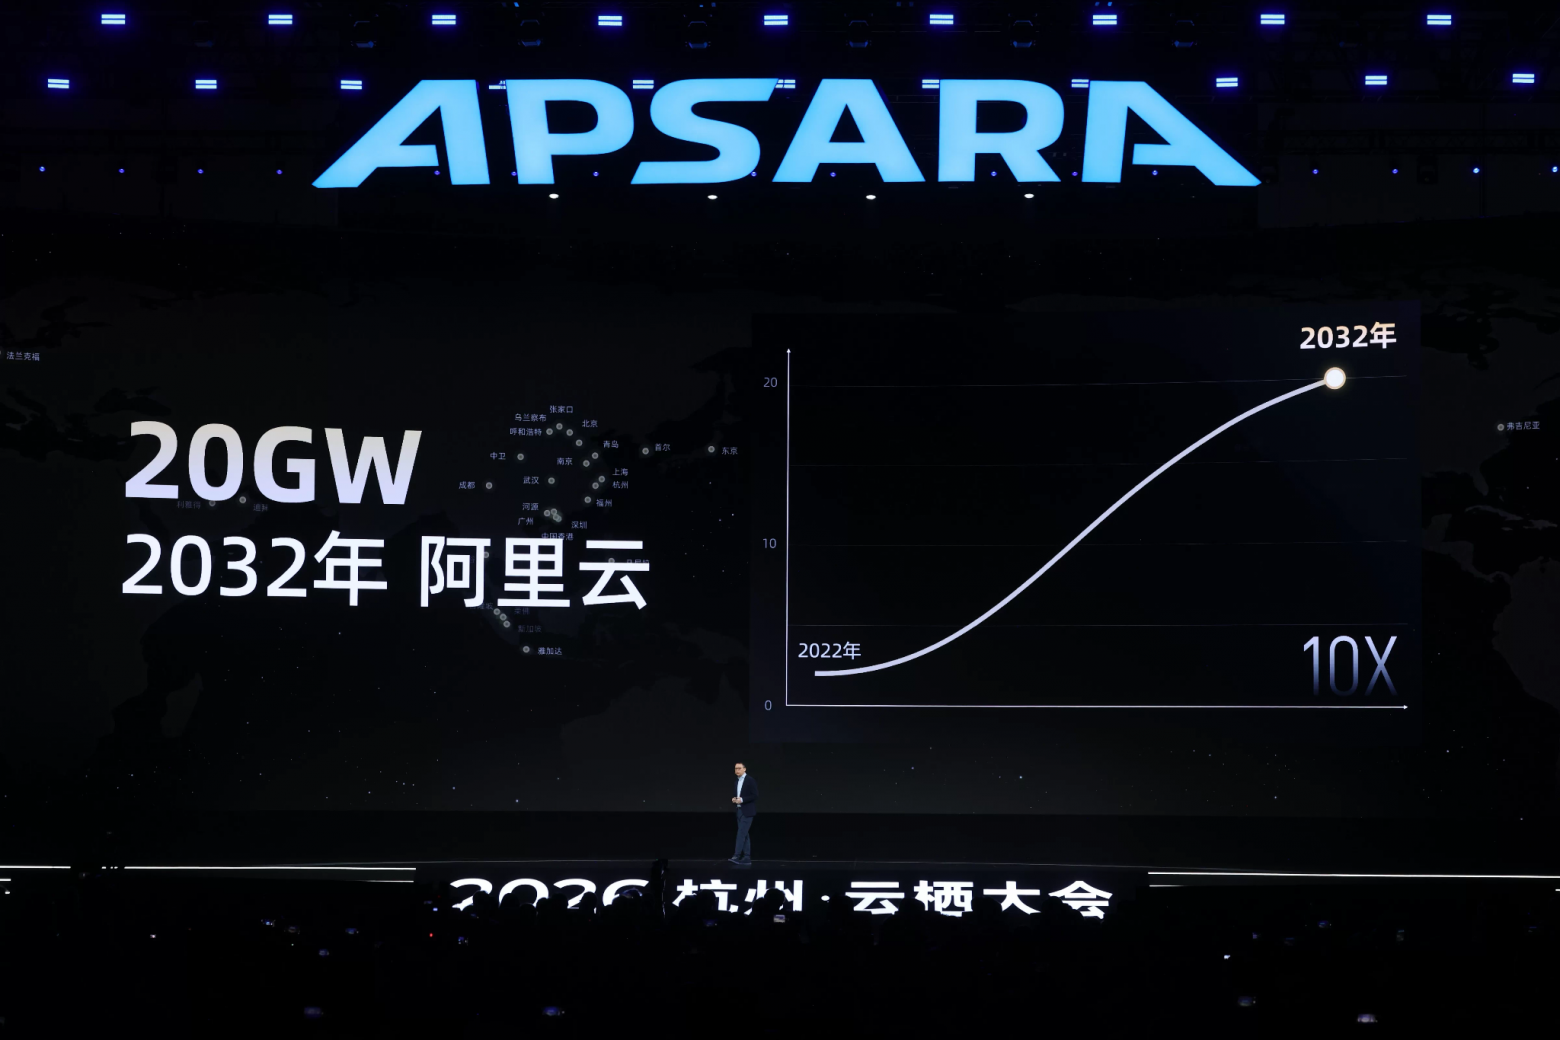
Alibaba представила Zhenwu V900. Разработчиком является подразделение T-Head Semiconductor (Pingtouge). По собственному заявлению компании, Zhenwu V900 на сегодня — самый мощный ИИ-чип, сделанный в Китае. Заявлено трехкратное превосходство по производительности над предыдущим Zhenwu M890, но точных цифр FLOPS компания не раскрыла, ограничившись формулировкой «в три раза быстрее».
Подтвержденные характеристики:
-
216 ГБ HBM,
-
поддержка вычислений от FP32 до FP4,
-
обновленные тензорные ядра с повышенной точностью на FP8/FP4,
-
межчиповый интерконнект на 1,2 ТБ/с.
Важная деталь — настраиваемые размеры блоков в MXFP8 и MXFP4. Эта технология позволяет стабилизировать производительность при масштабировании обучения и инференса, минимизируя просадки при увеличении числа карт в кластере. Кластеры на V900 масштабируются через фирменные коммутаторы ICN Switch до 500 000 ускорителей. Этого, по словам компании, достаточно для моделей на 5–10 трлн параметров. Серийное производство запланировано на Q1 2027 года.
ИИ‑роутер — доступ к 300+ моделям из одной панели
Подключите OpenAI‑совместимый шлюз по единому API‑ключу. Настраивайте сквозную аналитику, отслеживайте лимиты и квотируйте ресурсы.
Тогда же, в первом квартале 2027 года, ожидается суперускоритель Panjiu. Это связка Zhenwu V900, ICN Switch, сетевых карт SmartNIC Panmai и контроллеров Zhenyue — фактически весь аппаратный стек Alibaba в одном узле. Отдельно T-Head показала предварительную версию Zhenwu J900 следующего поколения на собственной архитектуре параллельных вычислений, релиз которой запланирован на Q3 2028 года.
Также был представлен роадмап по процессорам: CPU Yitian 720 и Yitian 730, заточенные под задачи агентного ИИ. Ожидается, что процессоры Yitian 730 выйдут на RISC-V, став первыми решениями от T-Head на собственной микроархитектуре. Предшественник Yitian 710 использовал ARM. Это прямой шаг к отказу от лицензируемой архитектуры в пользу полностью собственных разработок. Глава Alibaba У Юнмин обозначил стратегию тремя словами: «ИИ-модели, ИИ-чипы, ИИ-облако». Он подтвердил, что T-Head закрыла весь набор чипов для ЦОД: ускорители Zhenwu, CPU Yitian, сетевые карты Panmai и интерконнект ICN. Теперь Alibaba располагает полным проприетарным стеком для построения ИИ-кластеров.
Из софта заметнее всего Agent Context и AgentCore. Это попытка закрыть тот самый «L3.5»-контекст, про который параллельно говорит и Huawei через OceanStor M900. У обеих компаний агентные нагрузки требуют не столько FLOPS, сколько дешевой и быстрой памяти под контекст, поэтому оба гиганта строят для этого отдельный аппаратный слой.
Кого еще мы встречали: MTT S5000 и DF1000
Huawei и Alibaba — яркие примеры новинок, но заслуживают внимания [10] и другие китайские решения, попавшие в поле зрения [11].
Moore Threads MTT S5000 — это универсальные GPU [9] на архитектуре PingHu, поддерживающие квантование от FP8 до FP64 и имеющие заявленную совместимость с PyTorch, vLLM и SGLang без переписывания кода. На примере DeepSeek V3 компания сравнивает производительность своих систем с поколением Hopper® от NVIDIA®. Ставка на классику: попытка копировать модель NVIDIA (CUDA-совместимый стек, универсальный GPU), но на своем кремнии.
Dongfang Suanxin DF1000 представляет собой полную противоположность. Заведомо не самый топовый 14-нм техпроцесс, вообще без HBM-памяти. Взамен применяется 3D-стекинг по технологии near-memory. Заявлено 520 TFLOPS на BF16, 900 ГБ/с scale-up и 6,4 ТБ/с пропускной способности памяти (а это превосходит показатели NVIDIA® H200). Идея состоит в том, чтобы обойти ограничения на техпроцесс и HBM архитектурно, а не производственно. При этом сама компания признает, что обогнать хотя бы H200 — уже задача следующего поколения DF2000, а не текущего DF1000. А объем памяти на чип вообще не раскрыт, что не позволяет оценить, сколько карт нужно под конкретную модель.
Список не исчерпывающий, ограничен только доступностью информации о китайских устройствах.
Сравнение с лидерами
Ну и как же не сравнить новинки с западными лидерами рынка? В таблицах ниже разделяю сущности на чипы и полностоечные решения.
Уровень чипа
|
Параметр |
Ascend 960DT |
Zhenwu V900 |
NVIDIA® R100 (Vera Rubin™) |
NVIDIA® B300 |
AMD MI355X |
|
HBM |
288 ГБ |
216 ГБ |
288 ГБ HBM4 |
288 ГБ HBM3e |
288 ГБ HBM3e |
|
Пропускная способность памяти |
9,6 ТБ/с |
Не раскрыто |
до 22 ТБ/с |
8 ТБ/с |
8 ТБ/с |
|
Межчиповый интерконнект |
2,2 ТБ/с |
1,2 ТБ/с |
NVLink 6, 3,6 ТБ/с |
NVLink 5, 1,8 ТБ/с |
Infinity Fabric (точные цифры не публикуются) |
|
FP8 (dense) |
2 PFLOPS |
Не раскрыто |
17.5 PFLOPS |
5 PFLOPS |
4.6 PFLOPS |
|
FP4 (dense) |
4 PFLOPS |
Не раскрыто |
50 PFLOPS |
15 PFLOPS |
9.2 PFLOPS |
|
TDP |
Не раскрыто |
Не раскрыто |
~2 300 Вт |
1 400 Вт |
1 400 Вт |
|
Доступность |
Q1 2027 |
Q1 2027 (серийное производство) |
Q4 2026 |
Уже поставляется (с января 2026) |
Уже поставляется |
Если соотнести характеристики и даты выхода продуктов, то заметно, что китайцы только планируют роадмапы. При этом NVIDIA и AMD выигрывают за счет уже выведенных на рынок и реально поставляемых решений.

Арендуйте GPU за 1 рубль!
Выберите нужную конфигурацию в панели управления Selectel. *
Подробнее → [12]
Стоечные решения
|
Параметр |
Atlas 960E SuperPoD |
Panjiu (Alibaba, на V900) |
NVL72® (Vera Rubin™) |
AMD Helios™ (, 72 × MI455X) |
|
Число ускорителей |
4 096 NPU |
Не раскрыто на уровне одной стойки* |
72 GPU |
72 GPU |
|
Суммарная HBM |
До 1 ПБ |
Не раскрыто |
~21 ТБ |
~31 ТБ |
|
FP8 |
8 EFLOPS |
Не раскрыто |
~1.26 EFLOPS |
1.4 EFLOPS |
|
FP4 |
16 EFLOPS |
Не раскрыто |
2.5–3.6 EFLOPS |
2.9 EFLOPS |
|
Интерконнект |
Hi-ONE (5 500 модулей) + UnifiedBus |
ICN Switch |
NVLink 6, 260 ТБ/с агрегат на стойку |
Infinity Fabric / масштабируемая связь |
|
Макс. масштаб кластера |
До 512 000 NPU (до 1 млн c multi-rail) |
До 500 000 карт (через ICN Switch) |
NVL72 — базовая единица масштабирования |
Кластеры из нескольких Helios-стоек |
|
Доступность |
~Q3 2027 |
Q1 2027 |
Уже поставляется |
Уже анонсирован (октябрь 2026) |
* Предыдущее поколение — Panjiu AL128 — было стойкой на 128 чипов M890. Для новой версии на V900 Alibaba не раскрыла число чипов на стойку, указав только предел масштабирования всего кластера (500 000 карт через ICN Switch).
Здесь видна разница в подходах: одна стойка NVL72® перформит как 1/6 большого кластера Huawei на 4 096 NPU (занимающего примерно 80 стоек). Однако горизонтальное масштабирование в системах NVIDIA не будет работать линейно по производительности и, возможно, вообще не повторяет возможности SuperPoD-архитектуры Huawei.
Наш тест Zhenwu 810E
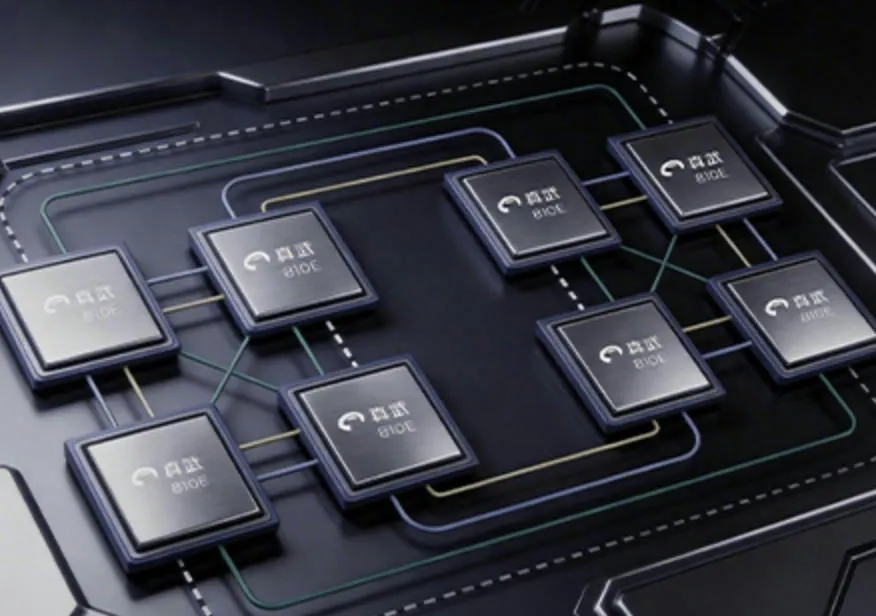
Мы в Selectel [14] протестировали сервер на PPU Zhenwu 810E — раннем предшественнике новинки V900. Спойлер: скоро выйдет полноценная статья. Ключевая проблема для нас заключалась не столько в железе, сколько в топологии и незрелости стека.
Про железо: реальная пропускная способность ICN была неравномерной. Одни пары PPU связывались двумя линками, другие — одним, а часть трафика и вовсе шла через медленный SYS-путь (~14 ГБ/с). В итоге суммарный All-to-All на 16 чипах PPU (~1,2 ТБ/с) оказался ниже, чем на системе HGX™ H200 с вдвое меньшим числом карт, тем более ниже, чем на B300 (~5,1 ТБ/с). Квантизация была ограничена BF16/FP32 и W8A8/AWQ/GPTQ. Увы, популярные FP8 и стандарт Blackwell™ NVFP4 не поддерживались. По сути, это отставание на два поколения по сравнению с актуальным стеком NVIDIA.
Операционная сложность: нет аналога nvidia-container-toolkit, нет публичного DCGM-аналога для мониторинга, веса моделей на ModelScope.cn [15] появляются с задержкой, а документация доступна преимущественно на китайском языке. Заявленные для V900 216 ГБ памяти и 1 200 ГБ/с интерконнекта звучат как реальный прогресс по сравнению с 810E. Однако перевод CANN от Huawei в open source и обещания «native support» от Alibaba — это пока те же слова, что мы слышали и раньше. Без независимых тестов V900 или Atlas 960E в реальных нагрузках стоит относиться к заявленным цифрам как к предварительным, а не проверенным.
Итог
Обе новости — не про то, что Китай догнал NVIDIA по производительности чипов (увы, пока не догнал). Они о том, что китайские компании ищут обходные пути для ограничений: в топологии, как Huawei, или в вертикальной интеграции, как Alibaba. А может вообще в архитектуре памяти, как Dongfang Suanxin, или в совместимости с существующим стеком, как Moore Threads. Для реального применения в проде вопрос по-прежнему один: готовы ли стек и окружение под конкретную нагрузку и сколько реальных токенов в секунду это дает, а не что написано в пресс-релизе.
Автор: skovalev
Источник [16]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36332
URLs in this post:
[1] Huawei: https://www.huawei.com/en/news/2026/9/hc-ascend960-supernode
[2] Alibaba: https://www.alibabacloud.com/en/press-room/alibaba-unveils-roadmap-on-full-stack-ai-strategy?_p_lc=1
[3] логика: http://www.braintools.ru/article/7640
[4] памятью: http://www.braintools.ru/article/4140
[5] зрения: http://www.braintools.ru/article/6238
[6] обучения: http://www.braintools.ru/article/5125
[7] Источник: https://www.alibabacloud.com/blog/603589
[8] Запустить ИИ‑роутер →: https://promo.selectel.ru/ai-router/?utm_source=habr.com&utm_medium=referral&utm_campaign=airouter_article_chinese-gpu-ai_011026_banner_ord
[9] Источник: https://en.mthreads.com/product/S5000
[10] внимания: http://www.braintools.ru/article/7595
[11] поле зрения: http://www.braintools.ru/article/9711
[12] Подробнее →: https://selectel.ru/services/dedicated/?tab=configuratorGpu&c=385%3A1&simpleRamMode=true&utm_source=habr.com&utm_medium=referral&utm_campaign=dedicated_article_chinese-gpu-ai_011026_banner_ord
[13] Источник: https://selectel.ru/blog/zhenwu-m890/
[14] в Selectel: https://selectel.ru/services/dedicated/?utm_source=habr.com&utm_medium=referral&utm_campaign=dedicated_article_chinese-gpu-ai_011026_content
[15] ModelScope.cn: http://ModelScope.cn
[16] Источник: https://habr.com/ru/companies/selectel/articles/1088454/?utm_campaign=1088454&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.