От справочника метаданных к инфраструктуре доверия: как изменился российский рынок Data Catalog за три года
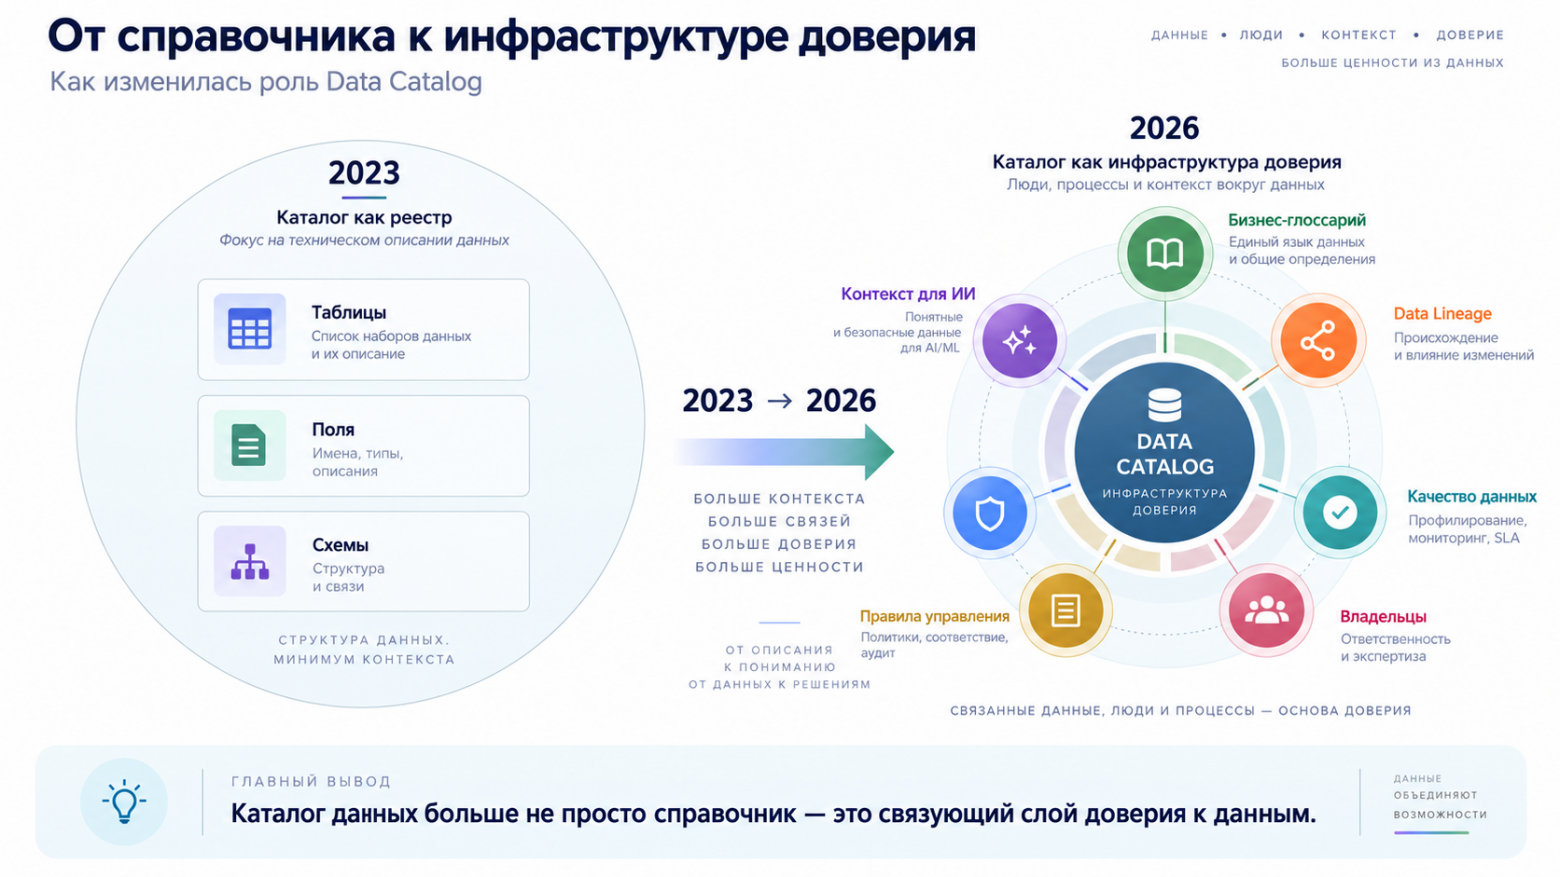
Главный сдвиг — Data Catalog перестал быть просто справочником метаданных и становится инфраструктурой доверия к данным и источником контекста для аналитиков, процессов и ИИ-агентов.
Три года назад мы выпустили исследование российских каталогов данных. Тогда для сравнения решений хватало около 20 вопросов: есть ли автоматическая каталогизация, Data Lineage, бизнес-глоссарий и другие базовые функции.
В отчёте «Data Catalog Круг Громова 2026» – количество критериев выросло до 325. За три года рынок заметно изменился, и прежней методики стало недостаточно. В этой статье расскажем не о результатах сравнения продуктов, а о главных изменениях рынка — в том числе тех, которых мы сами не ожидали увидеть.
2023 vs 2026: как изменилось исследование
|
Что сравниваем |
Исследование 2023 |
Исследование 2026 — что усилили |
|
Задача исследования |
Обзор рынка и навигация по классу Data Catalog: российские, open-source и международные решения. |
Фокус на практическом выборе российской платформы для корпоративного контура и проверке её промышленной применимости. |
|
Периметр сравнения |
5 российских продуктов плюс большой обзор open-source и международных каталогов. |
7 российских платформ в основном сравнении; OpenMetadata — референсный профиль. Зарубежные коммерческие решения исключены из основного сравнения. |
|
Методика |
Около 20 укрупнённых характеристик: каталогизация, поиск, lineage, глоссарий, профилирование, ML и др. |
325 критериев, 5 групп и 39 подгрупп. Вместо бинарного «есть / нет» оценивается глубина реализации функции. |
|
Проверяемость |
Основной формат — описательные профили и сводные таблицы характеристик. |
Добавлена верификация множества источников: анкеты, документация, API, демонстрации/trial, экспертные сессии, кейсы и рыночные данные. Функциональность и подтвержденность оцениваются отдельно. |
|
Глубина функционального анализа |
Например, Data Lineage рассматривался в основном как наличие функции и уровень детализации. |
Lineage разложен на механизмы: table/column-level, source-to-target mapping, impact analysis, автоматический захват из ETL/ELT, API/OpenLineage, редактирование и др. |
|
Архитектура и эксплуатация |
Фиксировались способ развёртывания, системные требования, лицензия и базовые интеграции. |
Отдельно оцениваются масштабируемость, производительность, отказоустойчивость, резервное копирование, мониторинг, обновления, миграция, SLA и работа в закрытом контуре. |
|
Российский контекст и ИБ |
Импортозамещение было отдельным трендом; рынок российских решений ещё формировался. |
Импортозамещение и локализация стали самостоятельной группой из 43 критериев: реестр ПО, сертификация, российские ОС/СУБД/BI, технологическая независимость, закрытые контуры и регуляторные требования. |
|
ИИ и машинное обучение [1] |
ИИ/ML рассматривались как перспективный тренд; у российских каталогов ML почти не был представлен. |
ИИ стал отдельной зоной сравнения: генерация описаний, интеллектуальный поиск, классификация чувствительных данных, AI-assisted governance, агенты и MCP. Разброс оценок: 23–94 из 100. |
|
Практическая применимость |
Главный результат — справочник по решениям и сводная сравнительная таблица. |
Добавлены профили, тепловые карты и карта специализации «Круг Громова», рекомендации по пилоту и внедрению, разбор экономического эффекта и TCO. Сравнивается соответствие платформы сценарию заказчика, а не сумма функций. |
Главное изменение методики 2026 года: мы перестали сравнивать каталоги по принципу «функция есть или её нет» и стали проверять, насколько глубоко она реализована, подтверждена и пригодна для реальной корпоративной эксплуатации.
Крупнейшие игроки российского рынка Data Catalog 2026
Первое: список участников сменился наполовину
В отчёте 2023 года российские каталоги стояли в одном ряду с международными платформами и с открытыми проектами. Это было естественно: рынок только формировался, отечественных продуктов было пять, и сравнивать их имело смысл именно с тем, что заказчик мог купить или развернуть.
В исследовании 2026 года зарубежных платформ нет вообще. Единственный упомянутый неотечественный продукт – это OpenMetadata, и тот – в роли референсного профиля, потому что часть российских решений построена на его базе. Так сегодня выглядит рынок: в корпоративных закупках зарубежные каталоги перестали рассматриваться как опция.
Из пяти российских продуктов, которые мы разбирали в 2023-м, в сравнительный контур 2026 года вошли лишь три. Два ушли с рынка или сменили формат. Зато появились четыре новых участника, которых три года назад в такой список никто бы не поставил. То есть за три года состав обновился примерно наполовину. Для рынка, который принято считать сложившимся, это много.
Второе: оценка стала глубже
Самое интересное в старом отчёте сегодня не результаты, а список критериев. Тогда «есть ли Data Lineage» был осмысленным разделяющим вопросом: у части продуктов Data Lineage действительно не было. Сегодня он есть у всех семи, и разделяет уже не факт наличия, а глубина.
Поэтому в новом выпуске на один прежний признак приходится одиннадцать критериев. Это lineage на уровне таблиц, на уровне колонок, source-to-target mapping, анализ влияния изменений в обе стороны, автоматический захват из ETL-процессов, lineage через API и очереди сообщений, интерактивная графовая визуализация, ручное редактирование, версионирование. Один и тот же ответ «да» за этими критериями означает семь разных степеней готовности.
То же произошло с бизнес-глоссарием. Как справочник терминов он есть у всех, и оценки по этой подгруппе у всех участников высокие. А вот там, где нужна управляемость определения (workflow согласования, версии, история изменений, связь термина с правилом расчёта), картина расходится сильно. Разница между «есть глоссарий» и «глоссарием можно управлять» в 2023 году просто не имела способа проявиться в таблице.
Общий вывод, который мы для себя сделали, таков: старая методика перестала различать продукты, и переписывать её пришлось именно поэтому. Когда базовый контур закрыт у всех участников, инструмент сравнения обязан стать точнее, иначе он показывает семь одинаковых продуктов там, где их семь разных.
Третье и самое неожиданное – ИИ
Разрыв между замерами по этому параметру оказался самым сильным. В сравнительной таблице 2023 года признак, отвечавший за алгоритмы искусственного интеллекта [2] и машинного обучения, не был проставлен ни одному из пяти российскому каталогу.
При этом тогда мы писали в разделе трендов:
«Эти возможности заявляются как сильные стороны продуктов, но на настоящий момент эти технологии находятся на раннем этапе: пользователи часто остаются не удовлетворёнными из-за большой остаточной ручной работы и не соответствующих ожиданиям результатов».
Сегодня этап формулировка верна наполовину. Разброс оценок по расширенным AI-возможностям в новом выпуске составил от 23 до 94 баллов из ста. Это самый широкий разброс во всём исследовании: ни в одной другой подгруппе продукты не расходятся так сильно. То есть маркетинговые обещания по-прежнему опережают реализацию, и проверять их надо на пилоте, а не по документации. Но у верхней части выборки за обещаниями уже стоит работающий функционал.
И появилось то, чего в 2023 году не было даже в виде вопроса. У одного из участников поверх каталога написан MCP-сервер, который открывает ИИ-агентам доступ к метаданным, техническим описаниям и скриптам расчёта. Работает он в контуре крупной компании, а не на демостенде. Три года назад мы спрашивали, умеет ли каталог сам автоматически расставлять метки. Сегодня осмысленный вопрос звучит иначе: может ли внешний агент получить из каталога контекст, достаточный, чтобы не выдумывать ответ.
Именно в этом, на наш взгляд, и состоит главное изменение класса продуктов за три года. Метаданные стали пригодны для машины, а не только для человека. Каталог перестал быть местом, куда ходит аналитик, и стал источником контекста для всего остального: для агентов, для пайплайнов и процессов согласования.
Что умеют каталоги данных в 2026 году?
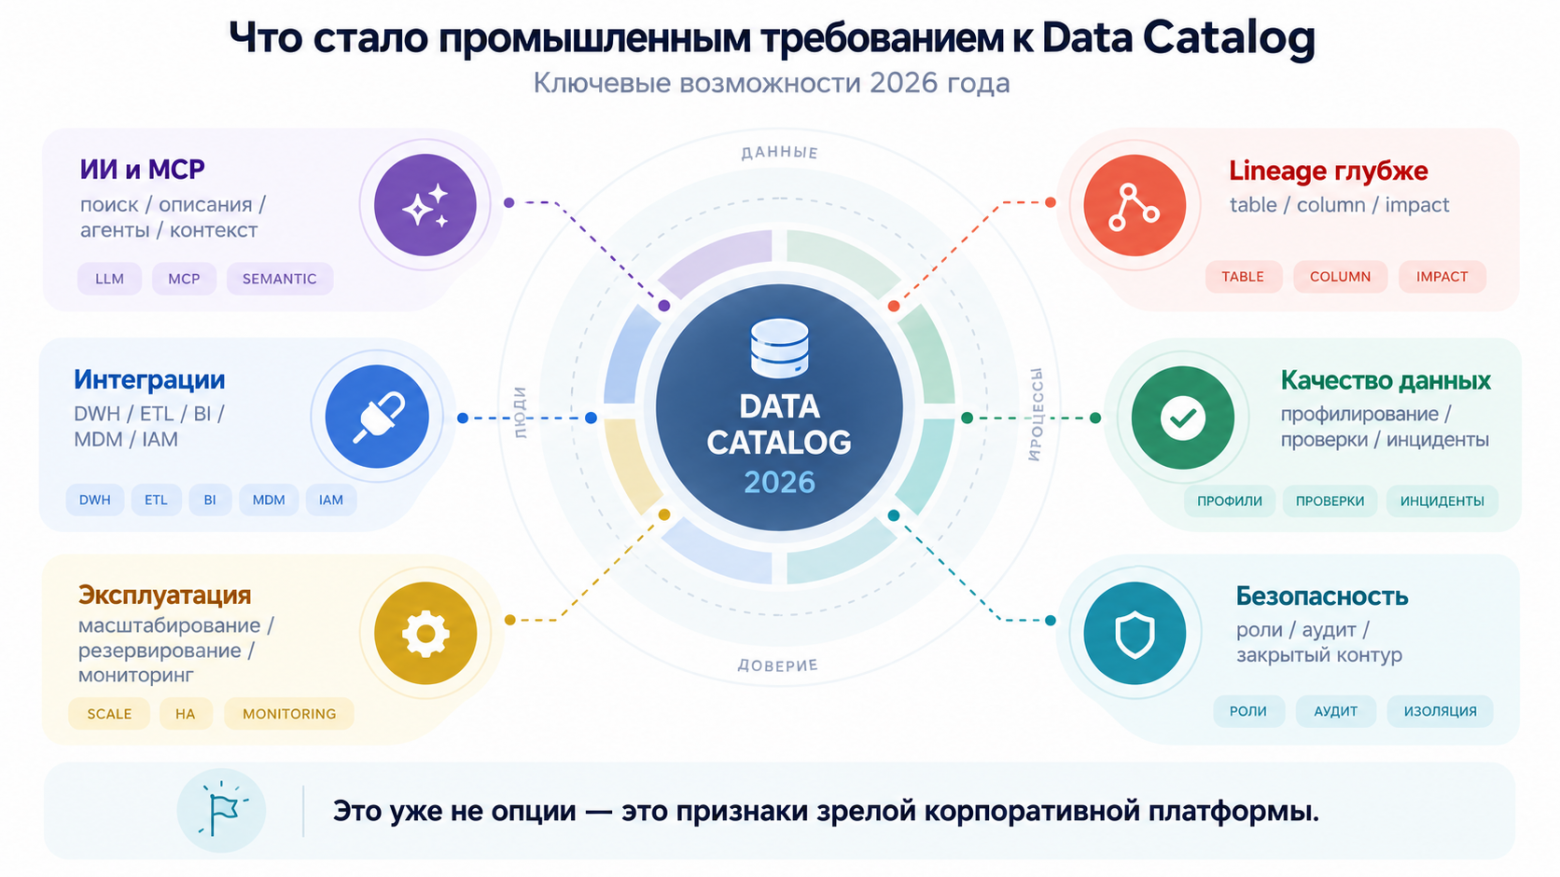
Если суммировать без привязки к конкретным продуктам, за три года в классе появились и стали проверяемыми несколько ключевых параметров.
-
Промышленный column-level lineage и анализ влияния изменений в обе стороны: от источника к потребителям и от отчёта к исходным данным. В 2023-м это было свойством дорогих зарубежных платформ.
-
Классификация чувствительных данных с привязкой к регуляторным категориям, включая персональные данные по 152-ФЗ, с управляемым сроком действия маркировки.
-
Контроль качества данных внутри контура каталога, а не отдельной системой рядом: проверки, профилирование, инциденты качества, видимые прямо на объекте.
-
Ролевая модель, аудит действий и работа в закрытом контуре как условие допуска. Каталог хранит карту корпоративной архитектуры, и доступ к этой карте сам по себе стал предметом требований информационной безопасности.
-
Встроенность в платформенный стек: хранилища, озёра, ETL, BI, MDM, качество, управление доступом. Отдельно стоящий каталог сегодня почти не рассматривают.
За всем этим стоит измеримый эффект для заказчика: меньше времени на поиск данных, меньше конфликтующих версий отчётности, быстрее анализ последствий изменений, дешевле сопровождение сложного ландшафта.
Где проходит новая граница
А теперь честная часть, ради которой появилась эта статья.
Зрелый каталог отвечает на четыре вопроса: какие данные есть, где они лежат, кто ими владеет и как они связаны между собой. Этого достаточно, чтобы найти витрину и выйти на ответственного. Этого не хватает для ответа на пятый вопрос, который в корпоративной отчётности звучит чаще остальных: почему один и тот же показатель в двух отчётах даёт разные цифры.
Пример, который узнает любой, кто работал с корпоративной отчётностью. Финансы считают активным клиентом того, у кого была хотя бы одна оплата за квартал. Маркетинг относит к активным всех, кто заходил в личный кабинет за последние тридцать дней. Риски используют свой признак из скоринговой модели. Все три определения корректны внутри своего контура, все три опираются на согласованный глоссарий, и все три дают разные числа в отчёте на совете директоров.
Каталог покажет, что есть три витрины и у каждой свой владелец. На вопрос, какая цифра идёт в отчётность, он не ответит. И дело не в зрелости конкретных продуктов, а в природе класса. Каталог описывает то, что уже есть: собирает метаданные из источников и поддерживает актуальность этого отражения. Определения показателей никто не собирает из источников, их проектируют. У них другой жизненный цикл: согласование, утверждение, версия, дата вступления в силу, история изменений. И другой владелец: не владелец таблицы, а владелец методологии расчёта.
Отсюда вывод, который мы вынесли в отдельный раздел исследования. Требовать от каталога управления определениями показателей значит ставить задачу, для которой класс не предназначен, а потом читать закономерный результат как незрелость продукта. Инструмент задаёт форму, но ответственность за определения он не создаёт. Каталог за три года дошёл до этой границы и упёрся в неё. Дальше начинается зона, где работают уже не настройки платформы, а владельцы показателей и регламент изменений.
Как проверить это на себе
Проверка занимает недели, а не месяцы, и не требует полноценного внедрения. Возьмите пять-десять показателей, по которым в компании уже были расхождения, и пройдите по шагам.
-
Опишите их целиком: формула, зависимости, владелец, источники.
-
Измените формулу одного показателя, входящего в несколько витрин, и посмотрите, покажет ли система полный список затронутых объектов до применения изменения, а не после инцидента в отчётности.
-
Воспроизведите расчёт по состоянию на прошлый квартал и убедитесь, что версия определения восстанавливается однозначно.
-
Проведите полный цикл изменения силами бизнес-аналитика, без участия инженера данных, и зафиксируйте, где процесс упирается в разработку.
-
Проверьте обмен метаданными в обе стороны: попадают ли определения и связи в каталог и приходят ли обратно сведения о физических объектах, владельцах и статусах.
Результат этого мини-пилота обычно информативнее, чем сравнение функциональных таблиц двух вендоров.
Главные выводы исследования
-
За три года российский каталог данных перестал быть справочником таблиц и стал инфраструктурой доверия к данным.
Изменился не только список вопросов, которые стоит задавать вендорам, но и состав рынка. Появились возможности, которых в предыдущем замере не было даже в виде критерия.
-
При этом каталог не отменяет необходимости навести порядок в собственных процессах.
Он делает беспорядок видимым и управляемым, а это уже много: пока расхождения не видны, их не с чем сравнивать и некому исправлять. Выбирать платформу стоит по тому, насколько её профиль совпадает с устройством вашей организации, а длина списка функций тут мало что решает.
Полная версия исследования «Data Catalog Круг Громова 2026» доступна на russianbi.ru [3]: методология, сравнительные профили, тепловые карты, карта специализации «Круг Громова», разбор экономики внедрения и отдельный раздел про слой определений показателей.
А теперь вопрос:
Сколько вариантов расчёта одного и того же показателя существует в вашей компании — и какой из них считается официальным? 😊
P.S. Чек-лист традиционно оставлю в комментарии.
Автор: GromovBI
Источник [4]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36355
URLs in this post:
[1] обучение: http://www.braintools.ru/article/5125
[2] интеллекта: http://www.braintools.ru/article/7605
[3] russianbi.ru: http://russianbi.ru
[4] Источник: https://habr.com/ru/articles/1089102/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1089102
Нажмите здесь для печати.