Зачем Авито нужна своя Inference-платформа для ML-LLM-сервисов: PaaS vs отдельное решение
Меня зовут Антон Алексеев, я ML Ops-инженер в Авито [1].
В этой статье я разберу, почему существующий PaaS — отличный инструмент для веб-сервисов, но плохо подходит для ML/LLM-Inference, и с какими похожими проблемами сталкиваются крупные компании, у которых те же задачи.
Также расскажу, почему было принято решение не дорабатывать PaaS под Inference, а строить отдельную Inference-платформу на базе готового open-source ядра, и почему этот путь оказался предпочтительнее.
Содержание
История возникновения проблемы
Много лет Авито прекрасно жил и продолжает жить на PaaS-платформе, которая отлично подходит для веб-сервисов. За последние несколько лет вокруг неё выросла целая система инструментов для ML: фичесторы, коллекторы, целая ML-платформа [8] отдельным кластером. Как будто бы при таком наборе можно закрыть любую задачу. Но тут встал вопрос: как катить в прод обученные модели?
Изначально так и стали катить всё в PaaS как веб-сервисы, но столкнулись с проблемами. Что если нам нужно поддерживать несколько моделей? Можно ли разместить разные модели на одном сервере? Как управлять несколькими графическими процессорами на одном узле? Эффективно ли мы обрабатываем операции ввода-вывода?
В Авито для веб-сервисов топовое решение — это PaaS-платформа. А вот для ML- и LLM-моделей, которые до сих пор пытались жить внутри PaaS или разрозненных самодельных решений, пока отдельной платформы под свои задачи нет. Для Inference-сервисов необходима отдельная Inference-платформа на базе open-source решения KServe, чтобы комьюнити помогало продвигать дополнительные фичи, которых нет в существующем PaaS.
Проблема была в том, что наша PaaS-платформа не содержит весь перечень функциональности, который нужен ML-Inference, а его добавление — это годы разработки, так как система изначально под это не была заточена.
Как устроен PaaS Авито и для чего он создавался
PaaS в Авито изначально строился вокруг задачи дать разработчику выкатить микросервис одним кликом и убрать с его плеч всю возню с инфраструктурой: CI/CD, интеграция с базами данных, логирование, метрики, автоскейлинг по нагрузке. Это классическая платформа для stateless-сервисов, написанных преимущественно на Go, с предсказуемым профилем потребления ресурсов: CPU и оперативная память [10], горизонтальное масштабирование числом реплик, деплой новой версии за минуты. Подробнее как устроен PaaS Авито можно почитать здесь [11].
Всё это отлично работает, пока речь идёт о бэкенд-сервисах с бизнес-логикой. Но как только в эту модель пытаешься внедрить ML-модель, особенно LLM, начинают вылезать нестыковки на каждом уровне.
Почему ML и LLM — это не «ещё один микросервис»
Разница между обычным веб-сервисом и ML/LLM-Inference не сводится к нужен GPU вместо CPU. Она влияет на весь жизненный цикл сервиса.
Платформа должна брать на себя только Inference-специфичные вещи, а бизнес-логика продуктов должна жить снаружи и обращаться к платформе через понятный интерфейс, но не быть зашитой внутрь сервинга.
Бизнес-логику нужно уводить из Inference, потому что между ними большая разница.
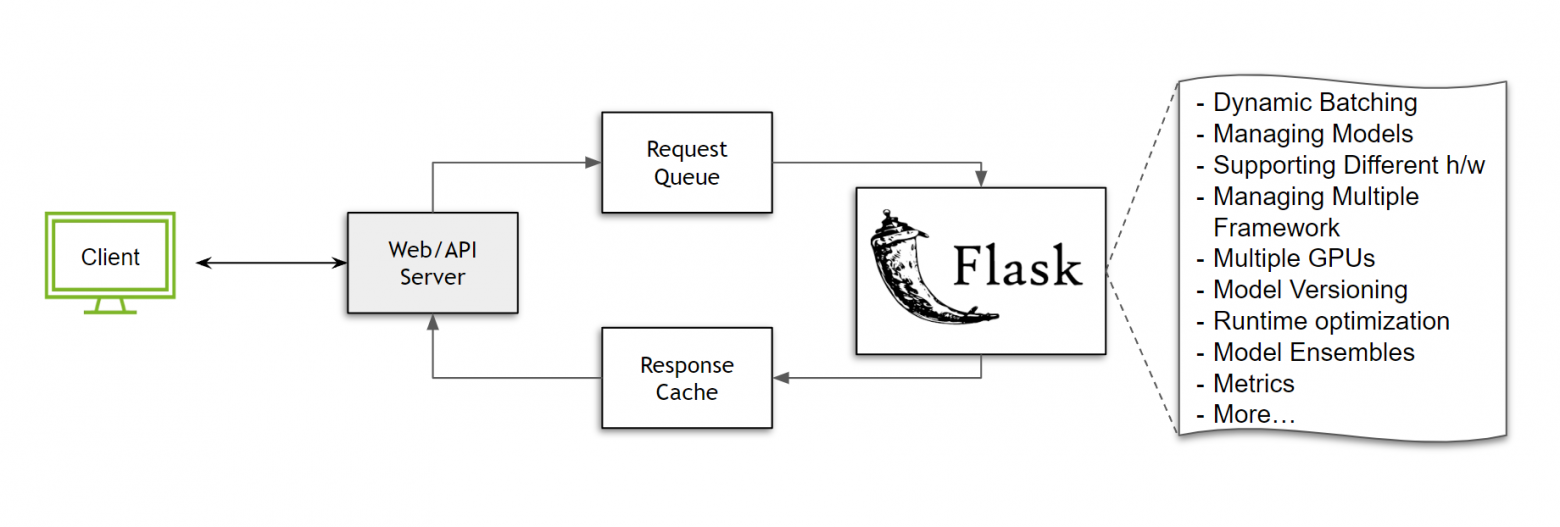
Причин выносить бизнес-логику из Inference целая масса: батчинг, очередь запросов, кэш ответов, поддержка нескольких моделей одновременно, мультифреймворковость, управление несколькими GPU на одной ноде, оптимизация рантайма, мониторинг метрик сервера, версионирование моделей, зависимость от архитектуры железа.
Динамический батчинг: Причина в экономике GPU, ведь Inference — это в первую очередь throughput-игра, и GPU простаивает при batch=1, потому что узкое место — не compute, а memory bandwidth (загрузка весов) для LLM-моделей. Динамический батчинг склеивает независимые запросы разных клиентов в один forward pass, и разница в utilization может быть 5-10x. Написать это руками в PaaS технически можно, но там сразу вылезают вопросы: как не увеличивать latency ожидающих запросов, как учитывать padding для разной длины последовательностей, как совместить асинхронный приём запросов с блокирующим forward pass без деградации latency — на чистом Python это упирается в GIL. Это ровно то место, где самодельное решение обычно либо не работает, либо превращается в собственную маленькую Inference-платформу.
Очередь запросов: Без очереди с backpressure под нагрузкой веб-процесс либо захлёбывается (thread pool exhaustion), либо начинает отвечать с деградирующей latency без возможности сказать подожди. Очередь не убирает перегрузку, а превращает её в задержку. Вместо того чтобы упасть под пиковой нагрузкой, сервис продолжает укладываться в SLA, но с ростом latency. Для продакшена это вопрос выживаемости системы, а не оптимизации. Короче говоря, очередь запросов — не столько фича, сколько защита от каскадных отказов.
Железо: Это единственная причина в списке, которая не про производительность, а про то, что бизнес-логика в принципе не должна знать, что модель квантована в FP8 и крутится на конкретном Inference-движке под конкретный ускоритель. Если это размазано по веб-фреймворку, вы получаете hard dependency: смена GPU-поколения или бэкенда требует трогать код, который отвечает за HTTP-роутинг. Разделение — это в чистом виде разделение ответственности (separation of concerns), а не про скорость.
PaaS оптимизирован под распределение ресурсов между CPU и RAM: подов много, каждый лёгкий, ресурсы делятся гранулярно, спецификация нод скрыта от разрабов, потому что им в большей степени всё равно, на каком железе запустится их сервис. GPU — дефицитный и дорогой ресурс, который плохо дробится, а простаивающий GPU — это большие деньги на ветер.
Нужно понимать, что есть различные архитектуры GPU, от чего зависит производительность сервиса. Разные архитектуры требуют разной поддержки в рантайме, разных CUDA capability, разных оптимизаций, и платформа должна это абстрагировать. Чем круче архитектура, тем GPU дороже.
Жизненный цикл обновлений: обычный сервис обновляется по коммиту в репозиторий, потому что новая версия весит лишь МБ и катится за секунды.
LLM-модель обновляется по-другому: релиз — это новые веса размером в десятки ГБ, которые нужно скачать, прогреть, провалидировать перед тем, как переключить на них трафик. Холодный старт LLM — это не поднять под за пару секунд, а загрузить образ с библиотеками для GPU (несколько ГБ, иногда 15-20+), загрузить модель на диск, потом в сам GPU, инициализировать движок, что может занимать десятки минут.
ML-модель занимает МБ, но в ней важно, что её можно часто обновлять и выкатывать, и это не должно требовать перезагрузки самого сервиса.
Масштабирование: веб-сервис масштабируется по RPS почти линейно (stateless-слой): добавили реплик, разложили нагрузку балансировщиком и готово.
У LLM-Inference есть батчинг запросов, KV-кэш, который растёт вместе с длиной контекста, и совершенно нелинейная зависимость latency от одновременной нагрузки. Стандартный HPA по CPU/RAM тут не поможет, а «из коробки» он и не умеет смотреть на загрузку GPU. Чтобы завести автоскейлинг по GPU-метрикам, нужна отдельная связка вроде DCGM Exporter и Prometheus Adapter, которую ещё нужно встроить в платформу. Плюс к этому будет принципиально другая модель отказоустойчивости: не перезапустить под, а аккуратно слить трафик с модели, которая ещё проводит батчинг.
У ML-Inference (CV, ранжирование, рекомендательные модели) картина третья: нет авторегрессии и растущего KV-кэша, зато вычисление обычно однопроходное и предсказуемое: время Inference почти не зависит от истории запроса, только от размера входа и батча. Масштабирование во многом сводится к правильной динамической батчировке на GPU и скейлингу по загрузке видеокарты, а не по CPU/RAM. Те же ограничения автоскейлинга, что и у LLM, только без нелинейности от контекста. Не вся ML-Inference нагрузка в ранжировании/рекомендациях крутится на GPU. Классические сценарии массово живут на CPU, там логика [12] автоскейлинга снова ближе к CPU-метрикам. Отказоустойчивость при этом ближе к веб-сервису: под с моделью можно перезапустить относительно безболезненно, поскольку для feature-based ranking/CV-моделей нет долгоживущего состояния вроде KV-кэша, которое нужно аккуратно досливать.
Дорабатывать под всё это PaaS, спроектированный для CPU-сервисов, значит тянуть в общую платформу логику, нужную маленькой части пользователей, и рисковать стабильностью для всех остальных. Поэтому тут встаёт естественный вопрос: не как встроить это в PaaS, а нужна ли отдельная платформа?
PaaS vs отдельная Inference-платформа
В таблице привожу плюсы и минусы обоих решений: доработать существующий PaaS и запилить отдельную Inference-платформу.
|
Действие |
Плюсы (+) |
Минусы (−) |
|
Доработать существующий PaaS |
Не плодить сущности, использовать уже знакомые разработчикам инструменты и процессы |
GPU-Inference далёк от архитектуры CPU-сервисов. Каждая доработка угрожает стабильности платформы, на которой держится весь бэкенд, и требует квартал + разработки |
|
Построить отдельную inference-платформу |
Можно спроектировать инструмент под требования ML/LLM-нагрузки, не думая, как это повлияет на тысячи обычных сервисов |
Дублирование части инфраструктурной логики и необходимость поддерживать ещё одну платформу. Также нужно обеспечить тот же уровень надёжности, к которому привыкли в PaaS |
В нашем случае решающим аргументом стало то, что доработка PaaS под конкретный сценарий Inference потребовала бы либо компромиссов в архитектуре общей платформы, либо создания внутри PaaS фактически отдельного подмодуля, то есть той же отдельной платформы, только более запутанной организационно и технически.
Почему не с нуля, а на базе open-source ядра
Мы решили сделать отдельную Inference-платформу на open-source движке, интегрировать её с PaaS как внешнюю зависимость, ведь строить отдельную платформу не значит писать оркестрацию Inference с нуля.
Выбор в пользу open-source движка относительно собственной разработки для деплоя веб сервисов в PaaS сделали, потому что:
– По времени реализации стабильного базового функционала решения схожи;
– На дополнительный функционал (например, LLM специфичные фичи, динамический батчинг) в PaaS будут потрачены кварталы;
– В случае с абстрактным PaaS-сервисом, который не связан с Inference, в дальнейшем добавление нового функционала для ML, который сейчас развивается особенно быстро, будет занимать сильно больше времени. За последние пару лет в Kubernetes оформился стандарт для serving ML-моделей. Community-операторы вроде KServe берут на себя базовую механику: Custom Resource для описания модели, интеграцию с Inference-движками вроде vLLM, Triton, TensorFlow Serving и TorchServe, автоскейлинг, health-check, версионирование.
Также сравнили KServe в ML-платформе или KServe в PaaS и решили оставить в ML платформе, потому что:
-
команда ML Platform имеет бо́льшую экспертизу по ML- / LLM-Inference (есть компетенции MLOps, SRE, MLE)
-
находимся в контакте с DS / LLM инженерами, т.к у нас уже есть платформа для обучения [14] и оффлайн Inference
-
единый интерфейс Inference-платформы, который объединяет: model registry, feature store, обучение и оффлайн Inference
-
по многим пунктам наши доработки совпадают: новый кластер, изменение в ci/cd при деплое с новыми манифестами, добавление у ML специфичных рантаймов кастомных метрик и дашбордов. Из дополнительного нам понадобится интеграция с mesh PaaS, чтобы обеспечить минимальный оверхед в latency при походах из PaaS в сервисы Inference-платформы.
-
текущая инсталляция paas на 3 дц реализована через отдельные control plane (на каждый дц свой), что может усложнить процесс доставки Inference и автоскейлинг
Среди open-source движков мы выбирали между несколькими:
-
KServe
-
Seldon
-
Ray Serve
-
Yatai (Bento ML)
-
vLLM Production Stack
Основные выводы по сравнению
-
PaaS имеет ограниченную функциональность, где из коробки не будет доступно большинство фич LLM. Требует дополнительной разработки.
-
KServe обладает наибольшей функциональностью для Inference LLM, доступной в opensource. Имеет несколько режимов деплоя, для LLM рекомендован стандартный, для ML моделей — Knative. Стоит либо по умолчанию использовать стандартный режим (если нет необходимости в scale to zero), либо гибридный с явным указанием в Inference режима деплоя.
-
Ray Serve и BentoML порождают поверх k8s дополнительные сущности в виде «кластеров», некие k8s внутри k8s. Это позволяет реализовывать multi-node Inference, но в остальных случаях может создавать оверхед.
-
Seldon Core v2 основные фичи для LLM поддерживает в enterprise версии, например LLM module.
-
VLLM production stack ограничен только функциональностью Inference LLM моделей, завязан на конкретный движок VLLM. Не имеет явных преимуществ по сравнению с KServe.
-
Результат по LLM — тоже KServe.
Сравнивая возможные варианты, выбрали KServe как наиболее популярное и стабильное решение как для ML, так и для LLM Inference, у него наиболее активное развитие среди специализированных inference-операторов и более широкий функционал (если рассматривать именно Inference, не полный функционал как ML платформу).
Для справки:
KServe — это open-source фреймворк для запуска, масштабирования и управления ML-моделями, «швейцарский нож» для Inference. Пользователь описывает манифест (
InferenceService), а KServe сам поднимает модель как сервис. Также для него есть Knative — платформа для поставки и управления рабочими нагрузками с помощью бессерверных вычислений, serverless-слой: request-driven автоскейлинг, scale-to-zero, revision-based деплой. Он опционален: есть RawDeployment-режим без него. Манифест проходит через два вебхука (валидация и мутация), затем попадает в KServe-контроллер, который управляет сетевым слоем (Knative/Gateway), автоскейлингом (HPA/KPA/KEDA) и кэшем моделей (Local Model Cache). Раньше и для ML, и для LLM был один CRD (InferenceService), но сейчас появился отдельныйLLMInferenceService, построенный на архитектуре llm-d (KV-cache aware scheduling, disaggregated prefill-decode, prefix-cache-aware роутинг по инстансам и распределённый Inference) и интегрированный с Kubernetes Gateway Inference Extension.
Логика здесь простая: зачем изобретать шедулинг GPU-подов и протоколы общения с vLLM- и ML-Inference, если это уже сделано, стало стандартом в индустрии, обкатано в проде десятков компаний и активно развивается сообществом? Вместо написать оператор задачей становится адаптировать готовое ядро под требования компании, а это более узкая и понятная работа.
На практике адаптация укладывается в несколько крупных блоков, вокруг которых и строится платформа.
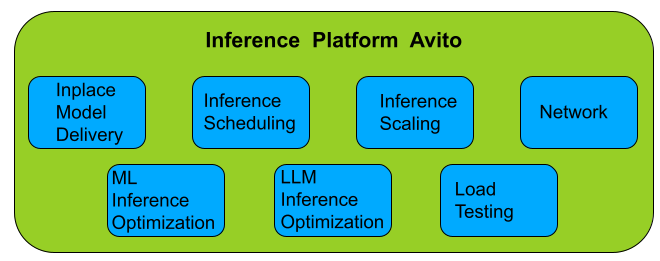
– Inplace Model Delivery: Можно обновлять модели без перезапуска тяжёлого движка/пода.
– Inference Scheduling: Размещение моделей на GPU-пуле с учётом того, что дробление карты работает не так, как шеринг CPU-ядра: доступны лишь ограниченные схемы разбиения (MIG, MPS, TimeSlicing) с разным балансом изоляции и гибкости, и разницу в нагрузке разных моделей на одном GPU нужно учитывать отдельно.
– Inference Scaling: Автоскейлинг, реагирующий на реальную загрузку Inference (очередь запросов, утилизация KV-кэша), а не на CPU/RAM, которые для GPU-нагрузки почти ничего не говорят о фактическом состоянии сервиса.
– Network: Сетевая специфика, которая становится критичной при распределённом Inference тяжёлых моделей на нескольких GPU одновременно.
– ML/LLM Inference optimization: Оптимизации, специфичные для каждого класса моделей. Важно понимать: то, что ускоряет ML-Inference, не всегда применимо к LLM, и наоборот.
– Load testing: Нагрузочное тестирование Inference как отдельная задача, потому что профиль нагрузки (батчинг, очереди, latency при параллельных генерациях) сильно отличается от привычного тестирования веб-сервисов.
Эти блоки составляют разницу между взять community-оператор и поднять его как есть и построить платформу, которой можно доверить прод с реальным SLA.
Где сейчас находится проект
Разработка Inference-платформы ведётся с начала года. Платформа уже используется несколькими клиентами внутри Авито, идёт обкатка на реальном трафике, то есть речь не про пилотный прототип на бумаге, а про постепенный перенос прод-нагрузки с ручных решений на общую платформу. Результатом этого будут цифры по экономии GPU-часов, ускорению релиза моделей и снижению latency.
В дальнейшем чем больше команд в компании будут использовать LLM и ML-модели в проде, тем острее будет ощущаться разница между раскатать веб-сервис за пять минут через PaaS и выкатить модель, для которой нужен GPU, прогрев и особый мониторинг. Отдельная Inference-платформа — это попытка сделать второй сценарий таким же простым, каким для разработчиков давно стал первый.
Автор: antonaleks605
Источник [16]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36403
URLs in this post:
[1] Авито: https://clc.to/LV3FBg
[2] История возникновения проблемы: #section1
[3] Как устроен PaaS Авито и для чего он создавался: #section2
[4] Почему ML и LLM — это не «ещё один микросервис»: #section3
[5] PaaS vs отдельная Inference-платформа: #section4
[6] Почему не с нуля, а на базе open-source ядра: #section5
[7] Где сейчас находится проект: #section6
[8] ML-платформа: https://habr.com/ru/companies/avito/articles/1050838/
[9] Тут еще больше контента: https://telegram.me/+ShQQPXymxoViNzFi
[10] память: http://www.braintools.ru/article/4140
[11] здесь: https://habr.com/ru/companies/avito/articles/762160/
[12] логика: http://www.braintools.ru/article/7640
[13] Жми сюда!: https://clc.to/MDY_jw
[14] обучения: http://www.braintools.ru/article/5125
[15] Кликни здесь и узнаешь: https://clc.to/vtMlJg
[16] Источник: https://habr.com/ru/companies/avito/articles/1089128/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1089128
Нажмите здесь для печати.