Docs-as-code для медицинских систем: как перевести 1160 страниц из MS Word в Asciidoctor и автоматизировать сборку
Вам в наследство досталось руководство пользователя МИС на 1160 страниц в формате .docx, тысячи повторяющихся скриншотов, процесс обновления вызывает глубокую грусть. Что с этим «добром» делать?
В этой статье я расскажу о своём проекте по переводу такой документации на рельсы docs-as-code: переосмысление структуры, укрощение размера скриншотов, борьба с кириллицей в Asciidoctor, настройка автоматической сборки HTML и PDF через GitLab CI/CD.
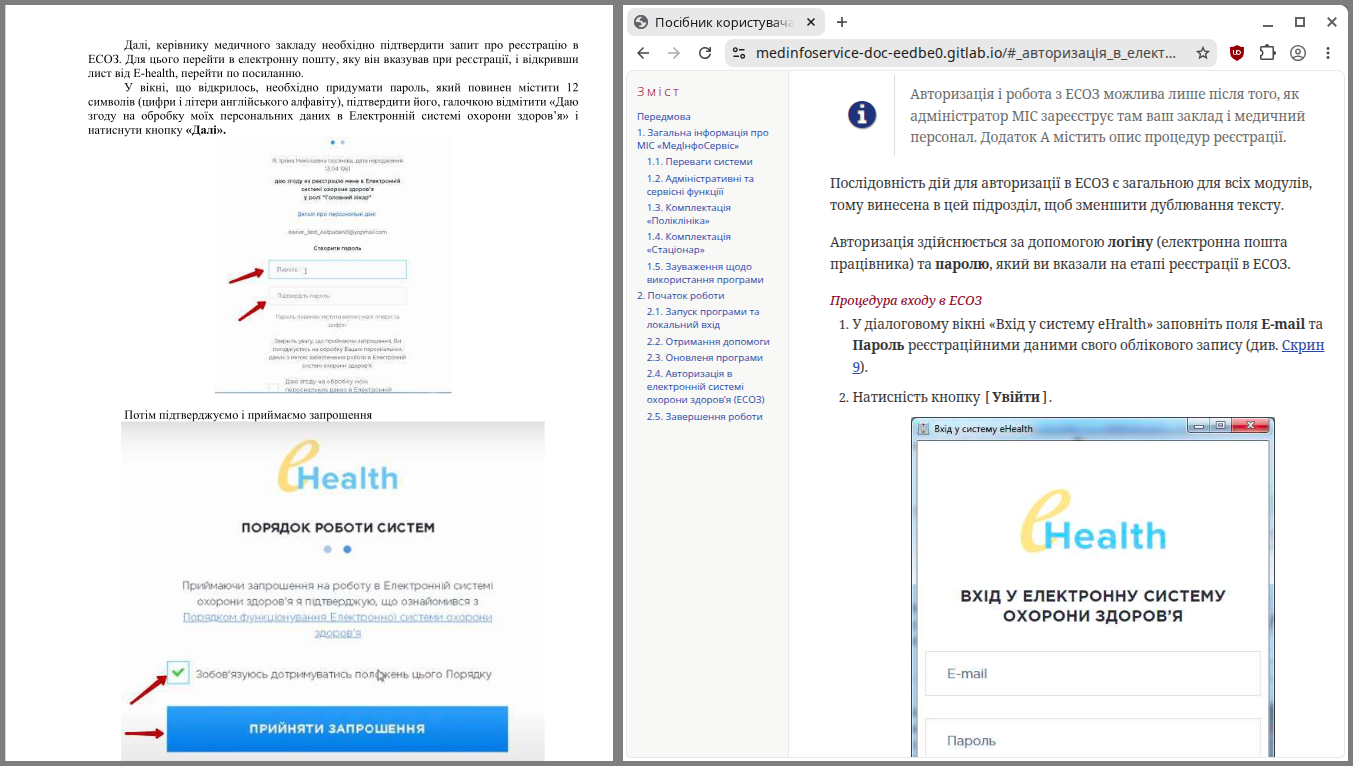
Наследие MS Word и синдром «талмуда»
За окном 2026 год. Представьте себе толстенный документ, набранный в MS Word 2010. Это официальное руководство пользователя для крупной медицинской информационной системы (МИС), которая ежедневно управляет потоками данных — от локальных карт пациентов до разнообразных видов взаимодействия с центральным компонентом электронной системы охраны здоровья (eHealth).
Чистый размер текстового массива составляет 1 Мб, но главная проблема в другом: документ написан кондовым языком с фиксацией на интерфейсе. Вместо того чтобы вести врача по процессам его реальной работы (оформление приёма, создание электронного направления и т.п.), «талмуд» описывает буквально каждый элемент: «При нажатии на кнопку А открывается окно Б, содержащее поле В». Когда интерфейс живой системы эволюционирует, поддержание такой книги превращается в ад: вёрстка «плывёт» от любого чиха, одновременная работа нескольких авторов невозможна, а контроль версий превращается во всем знакомое Руководство_v4_final_исправлено_copy(2).docx.
Как человек с бэкграундом в системном администрировании и опытом [1] литературной правки, я не мог спокойно смотреть на это. Документация должна жить по законам разработки, и я инициировал пилотный проект по переработке и миграции этого руководства на рельсы “документация как код“.
Выбор инструментария для работы
В мире docs-as-code есть три популярных пути, но для масштабной технической книги в данном случае подошёл только один.
-
Markdown. Слишком примитивен. Попробуйте сверстать на нём большой многостраничный документ с перекрёстными ссылками между главами, сложной структурой модульных включений (придерживаясь принципа «единого источника») и кастомными стилями — вы быстро упрётесь в ограничения синтаксиса или зоопарк несовместимых диалектов.
-
DITA / DocBook (XML). Профессионально, мощно, но неоправданно дорого и избыточно для гибкой разработки. XML-теги превращают чтение исходного кода в мучение, а порог входа для авторов весьма высок.
-
AsciiDoc (Asciidoctor). Легковесный разметчик, который читается глазами так же легко, как Markdown, но обладает мощью семантических блоков, родной поддержкой включений (
include::[]), условий, сложной вёрстки таблиц и готовым рендерингом в HTML и PDF «из коробки» (через плагины).
Инструменты для проекта разворачивались на обычном ноуте Lenovo ThinkPad под управлением Linux Mint. Рабочее место получилось спартанским, но максимально производительным:
-
VS Code + плагин Asciidoc в качестве основного текстового редактора.
-
Freeplane — мощная бесплатная программа для создания сложных интеллект-карт, которая ориентирована на структурирование больших объемов информации, анализ и планирование.
-
Emacs Org-mode для ведения “бортового журнала” разработчика (чтобы прочувствовать весь спектр текстового гиковства и усложнить себе жизнь).
-
Pomodorot — полезная программа, которая не даёт очманеть от работы, блокируя экран для отдыха каждые полчаса.
Планирование работы
Цель проекта формулировалась так: взять репрезентативный кусок старого руководства, безжалостно переработать его структуру под логику [2] врача, очистить от «воды» и тяжёлых фраз, перевести в AsciiDoc и настроить автоматическую сборку через GitLab CI/CD.
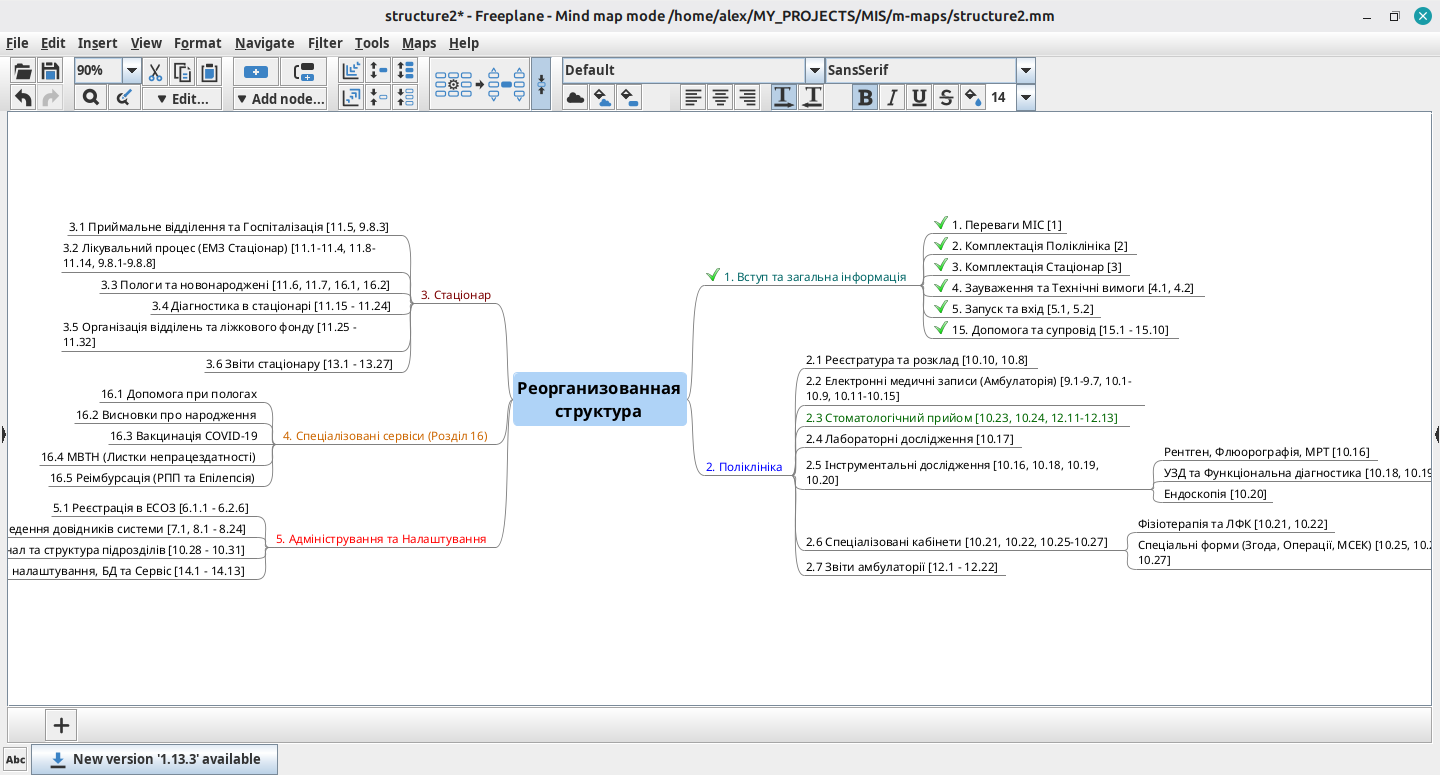
Последовательность работ проекта со сроками я разработал в ProjectLibre (впоследствии в нём обнаружился огромный минус: в pdf-файл не выводится кириллица), а новую структуру документации (со ссылками на пункты исходной) — во Freeplane. При анализе структуры и её реорганизации здорово помог ИИ, без него перелопатить такой объём информации было бы куда сложнее.
Графический квест: выковыривание и чистка 5100+ скриншотов
В подопытном документе оказалось более пяти тысяч скриншотов! Они годами копились внутри вордовского файла, сделанные в разных версиях Windows, с кучей дубликатов и диким весом pdf-ки (без малого 100 мегабайт!).
Тащить этот графический хаос в новый проект — преступление против Git-репозитория и здравого смысла. Нужен был автоматизированный процесс очистки.
Для максимальной гибкости я решил обрабатывать файлы в терминале Linux и для этой цели выбрал несколько утилит.
1. pdfimages
Первым делом я выпотрошил из документа абсолютно всю графику в PNG-формат:
$ pdfimages -png legacy-guide.pdf ./screenshots_extractКоманда работала почти 10 минут и выдала картинок аж на 588 Мб.
2. jdupes
Хранить идентичные картинки по меньшей мере глупо. Для просмотра дублей сгодилась команда, которая сравнивает файлы по контрольным суммам:
$ jdupes -rMS screenshots_extractЕё вывод был красноречив:
3295 duplicate files (in 658 sets), occupying 173 MB
Узнать число групп дублей (они разделяются пустой строкой) можно и такой командой:
$ jdupes -r /путь/к/папке | grep -c "^$"Из любопытства захотелось узнать минимальное, максимальное и среднее количество элементов в группе. Для решения этой задачи в терминале лучше всего подошла утилита awk, которой скармливается файл с протоколом работы jdupes.
1: Получение списка размеров групп.
Команда ниже превращает файл в список чисел, где каждое число — количество строк в одной группе.
$ awk -v RS='' '{print NF}' имя_файлаRS='' — настройка awk, которая заставляет его считать разделителями записей (блоков) пустые строки;
NF — количество «полей» (слов/строк) в этом блоке.
Чтобы узнать именно количество строк, а не слов, нужно слегка изменить команду:
$ awk -v RS='' '{print gsub(/n/, "n") + 1}' имя_файлаВ моём случае результат был одинаков.
2: Подсчёт Min, Max и Average
$ awk -v RS='' '{n = gsub(/n/, "n") + 1; print n}' имя_файла |
  awk 'BEGIN {min=999999; max=0} {
         sum += $1;
         count++;
         if($1 > max) max=$1;
         if($1 < min) min=$1;    }
       END{
         if(count>0) print "Min: " min, "| Max: " max, "| Avg: " sum/count;
         else print "Групп не найдено";
       }'
Первый awk разбивает файл на блоки по пустым строкам и для каждого блока выводит одно число (количество строк внутри), а второй собирает и выводит статистику. На моих файлах получился такой результат:
Scanning: 5136 files, 1 items (in 2 specified) Min: 2 | Max: 1440 | Avg: 6,0076
Дополнительный анализ показал, что аж 68% всех групп состояли из двух файлов.
Наконец, для автоматического удаления дубликатов использовалась команда fdupes:
$ fdupes -rdN /путь/к/папке-r — рекурсивно (искать во всех подпапках)-d — удалять-N — noprompt (не спрашивать подтверждение для каждого файла, оставить первый найденный).
После автоматического удаления дубликатов осталось 1840 файлов. Уже полегче!
3. findimagedupes
Для визуального сравнения и ручного удаления оставшихся дубликатов среди похожих изображений (например, один и тот же скриншот, но пересохранённый с разным сжатием или сдвинутый на пару пикселей) я использовал утилиту findimagedupes и просмотрщик pix:
$ findimagedupes -t 98% -p `which pix` ./screenshots_extractЭта процедура позволила убить ещё 186 файлов.
4. optipng
Оптимизировать объём файлов изображений без потери качества помогает команда:
$ find . -name "*.png" -exec optipng -o2 {} ;Параллельная обработка на нескольких ядрах даже при значительно большем коэффициенте сжатия ускоряет процесс в 8–10 раз:
$ time find . -name "*.png" -print0 |
       xargs -0 -P 8 -I {} optipng -o5 -strip all "{}"
Какое шаманство здесь происходит?
find . -name "*.png" -print0: ищет все PNG. Опция -print0 нужна, чтобы корректно обработать имена файлов с пробелами (в тандеме с -0 у xargs).
-P 8: запускает 8 параллельных процессов (по одному на каждый поток).
-o5 -strip all: оптимальное сжатие и полное удаление метаданных (цветовые профили монитора и прочее).
time: выводит общее время работы всей цепочки:
-
real: сколько реально времени вы просидели за чашкой чая, пока шёл процесс (именно этот показатель нам и нужен);
-
user: суммарное время работы всех ядер (оно будет в несколько раз больше real, это нормально);
-
sys: время, затраченное процессором в режиме ядра.
Можно ли ещё сильнее ужать файлы? В скриншотах программы используется много цветов из-за сглаживания шрифтов. Если после optipng объём будет всё ещё велик, можно добавить флаг -nc (no color reduction) или преобразовать изображения в индексированные цвета (если это не портит вид).
Скрипт c разделением процесса обработки на этапы и выводом результатов
#!/usr/bin/env bash

# Конфигурация
LC_ALL=C
OPTDIR=optim_imgs
TIMEFORMAT="%R"

# Подсчёт файлов
COUNT=$(find . -maxdepth 1 -name "*.png" | wc -l)
if [ "$COUNT" -eq 0 ]; then
   echo "PNG файлы не найдены в текущей папке."
   exit 1
fi

# Проверка и удаление старой папки
if [ -d "$OPTDIR" ]; then
   echo -e "nУдалена старая папка $OPTDIR/"
   rm -rf "$OPTDIR"
fi
mkdir -p "$OPTDIR"

# Основной процесс с замером времени
echo "Оптимизация $COUNT файлов на 8 потоках..."
ELAPSED=$( { time find . -maxdepth 1 -name "*.png" -print0 |
      xargs -0 -P 8 -I {} optipng -o5 -quiet -strip all "{}"
      -out "$OPTDIR/{}"; } 2>&1 )

# Расчёт времени
MIN=$(awk "BEGIN {print int($ELAPSED / 60)}")
SEC=$(awk "BEGIN {printf "%.2f", $ELAPSED % 60}")
AVG=$(awk "BEGIN {printf "%.2f", $ELAPSED / $COUNT}")

# Расчёт размеров
OLD=$(du -Ssb . | cut -f1)
NEW=$(du -sb "$OPTDIR/" | cut -f1)
DIFF=$((OLD - NEW))
PERCENT=$(awk "BEGIN {printf "%.2f", ($DIFF/$OLD)*100}")

# Вывод протокола работы
echo -e "n--- ПРОТОКОЛ ОПТИМИЗАЦИИ ---"
echo "Обработано файлов: $COUNT шт."
echo "Общее время:       $MIN мин. $SEC сек."
echo "Среднее на файл:   $AVG сек."
echo "----------------------------"
echo "Исходный объём: $(numfmt --to=iec $OLD)"
echo "Новый объём:    $(numfmt --to=iec $NEW)"
echo "Экономия:       $(numfmt --to=iec $DIFF) ($PERCENT%)"
Файлы после обработки складываются в папку optim_imgs в текущей папке. При перезапуске скрипта она удаляется и пересоздаётся автоматом. После отработки скрипта получился такой вывод:
Удалена старая папка optim_imgs/
Оптимизация 1654 файлов на 8 потоках…
— ПРОТОКОЛ ОПТИМИЗАЦИИ —
Обработано файлов: 1654 шт.
Общее время: 27 мин. 35,69 сек.
Среднее на файл: 1,00 сек.
—————————-
Исходный объём: 408M
Новый объём: 388M
Экономия: 21M (5,00%)
В итоге скриншотов стало втрое меньше (1654 вместо 5136), а их объём уменьшился на 200 МБ. Основную экономию дала очистка дубликатов, а optipng — ещё 5%. Файлы получили сквозную нумерацию, готовую к импорту в AsciiDoc.
Грабли с кириллицей
Когда структура проекта устаканилась и был готов первый adoc-файл, пришло время компиляции в PDF. И тут я столкнулся с суровой реальностью open-source инструментов, изначально заточенных под английский язык.
Попытка собрать документ дефолтным вызовом asciidoctor-pdf mis-doc.adoc выдало гирлянду сообщений: WARNING: The following text could not be fully converted to the Windows-1252 character set, а в pdf-файле — мешанину крокозябр вместо букв. Родные шрифты движка не имели понятия о существовании кириллицы.
Решением было создать кастомную тему оформления в формате YAML и подключить TTF-шрифты с кириллицей (я взял проверенные семейства Liberation). Для лучшей переносимости проекта я положил шрифты в отдельную локальную папку.
Фрагмент конфигурационного файла theme.yml со шрифтами:
font:
  catalog:
    merge: false
    LiberationSans:
      normal: LiberationSans-Regular.ttf
      bold: LiberationSans-Bold.ttf
      italic: LiberationSans-Italic.ttf
      bold_italic: LiberationSans-BoldItalic.ttf
    LiberationMono:
      normal: LiberationMono-Regular.ttf
      bold: LiberationMono-Bold.ttf
      italic: LiberationMono-Italic.ttf
      bold_italic: LiberationMono-BoldItalic.ttf
    M+ 1mn:
      normal: mplus1mn-regular-subset.ttf
      bold: mplus1mn-bold-subset.ttf
      italic: mplus1mn-italic-subset.ttf
      bold_italic: mplus1mn-bold_italic-subset.ttf
    fallbacks:
    - M+ 1mn
    main:
      family: LiberationSans
Asciidoctor-pdf при наследовании темы (extends: default) рассчитывает найти стандартные шрифты для кода и кнопок. Если вы отключаете слияние каталогов (merge: false), но не описываете эти шрифты в своём файле, движок впадает в панику. Поэтому пришлось положить в папочку и шрифт M+ 1mn.
Очень рекомендую проверять реальные имена шрифтов с помощью утилиты fc-query. Найти установленные шрифты с кириллицей можно так:
fc‑list :lang=ru family fileНу а если что-то не работает — читайте предупреждения в консоли (asciidoctor-pdf выводит их в stderr), а для вывода деталей об ошибках добавьте ключ --trace.
Итак, сборка завелась, но тут же вылезла вторая проблема: конфликт [3] абзацных отступов. Чтобы книга выглядела солидно, я включил в тему отступ для первой строки абзаца:
prose:
  first-line-text-indent: 18   # НЕДОКУМЕНТИРОВАННЫЙ ПАРАМЕТР!
  margin-bottom: 8      # уменьшаем стандартный отступ после абзаца
Однако теперь этот отступ применяется вообще ко всему, включая текст внутри ячеек таблиц и элементы списков. Таблицы стали выглядеть странно. Пришлось выкручиваться на уровне разметки: либо использовать тип форматирования ячеек d| (literal/raw data), который полностью сбрасывает стилизацию абзаца, либо оформлять вводные фразы перед списками как заголовки списков, защищая их от отступов. Что ж, красота требует жертв.
Борьба с галлюцинациями ИИ
Один из поучительных уроков этого проекта — не верить нейросетям на слово, когда дело касается специфических YAML-конфигураций. В большинстве случаев он чертовски помогал, но было и так, что бесцеремонно врал: например, предлагал ключи с подчеркиваниями вместо дефисов (font_family вместо font-family, page_size вместо page-size и т.д.). На сайте документации Asciidoctor я нашёл лишь одно исключение из общей схемы: bold_italic.
Мораль здесь такова: ИИ — отличный подмастерье для генерации идей и «рыбы» вашей документации, но синтаксис специфических предметных DSL-языков за ним нужно перепроверять буквально с лупой.
Пайплайн сборки в GitLab CI/CD
Облачным репозиторием был выбран GitLab, поскольку там приватные проекты можно размещать бесплатно. Я настроил лёгкий пайплайн .gitlab-ci.yml, использующий официальный Docker-образ asciidoctor/docker-asciidoctor:latest. При каждом git push система автоматически генерирует свежий PDF-документ и публикует статический HTML-сайт в GitLab Pages:
image: asciidoctor/docker-asciidoctor:latest
stages:
  - build
  - deploy

# Сборка  PDF
build_pdf:
  stage: build
  script:
    - asciidoctor-pdf -r asciidoctor-diagram mis-doc.adoc -o mis-user-guide.pdf
  artifacts:
    name: "docs-pdf-${CI_COMMIT_REF_SLUG}"
    paths:
      - mis-user-guide.pdf
    expire_in: 1 week
  only:
    - main  # сборка выполняется при обновлении ветки main

# Публикация на GitLab Pages
pages:
  stage: deploy
  script:
    - mkdir public
    - asciidoctor -r asciidoctor-diagram mis-doc.adoc -o public/index.html
    # скопировать PDF в ту же папку, чтобы его можно было скачать по ссылке
    - cp mis-user-guide.pdf public/ || true
    # скопировать папку со скриншотами в public, чтобы сайт их увидел
    - cp -r images public/ || true
  artifacts:
    paths:
      - public
  only:
    - main
Итоги проекта
Этот проект показал, что MS Word плохо подходит для больших руководств в плане гибкости и сопровождения. Рефакторинг текста и перевод документации на технологию docs-as-code коренным образом изменил ситуацию:
-
Вместо описания кнопок интерфейса — описание логики сценариев работы врача.
-
Текст после рефакторинга сократился в 3,5 раза за счёт смысловой оптимизации.
-
Скриншотов стало втрое меньше, а их общий объём сократился более чем на треть.
-
Вся документация теперь хранится в обычном Git-репозитории, легко версионируется, поддаётся сквозному поиску через
grepи готова к быстрому внесению изменений под обновляющиеся требования eHealth. -
Интерактивное руководство пользователя (HTML) и его печатная PDF-версия собираются в CI/CD за несколько минут.
Asciidoctor в связке с простыми консольными утилитами Linux и GitLab CI/CD показал себя как мощный инструмент. Использование диаграмм типа PlantUML в ряде случаев позволит заменить текстовое описание процедур наглядными схемами.
Одностраничный HTML с оглавлением выглядит очень прилично, а с генератором сайтов Antora пользоваться руководством станет ещё удобнее.
Автор: kosmonix
Источник [4]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36405
URLs in this post:
[1] опытом: http://www.braintools.ru/article/6952
[2] логику: http://www.braintools.ru/article/7640
[3] конфликт: http://www.braintools.ru/article/7708
[4] Источник: https://habr.com/ru/articles/1089588/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1089588
Нажмите здесь для печати.