FAIRouter. Мы научили ИИ выбирать лучшую LLM модель для каждой задачи
Мы выложили в открытый доступ библиотеку FAIRouter [1], которая выбирает LLM-исполнителя под задачу, а после ответа принимает у него работу.
В мире, где количество больших языковых моделей (LLM) растет в геометрической прогрессии, а их возможности и стоимость сильно варьируются, встает вопрос: как выбрать именно ту модель, которая идеально подойдет для конкретной задачи, обеспечит наилучшее качество и при этом будет экономически эффективной? Для решение вышеописанной проблемы мы разработали обучаемую систему автоматической маршрутизации запросов FAIRouter.
Библиотека распространяется под Apache 2.0, две независимые реализации: C# на .NET 10 и Python 3.11, где из зависимостей только numpy.
Мы сами работаем с множеством LLM и почти сразу уперлись в неудобный вопрос: как понять, что роутер выбрал правильно? Ответ, которым мы в итоге остались довольны, звучит так: пусть выбор проверяет судья, а судью проверяет человек. Ниже в статье — как запустить проверку вашего промта для выбора LLM, как это устроено, что показали замеры и где мы сами набили шишки.
А в видео за полторы минуты показали полны флоу работы выбора модели и работу критика.
Проблема выбора: Зоопарк LLM и головная боль разработчика
Каждый, кто работает с LLM, сталкивался с дилеммой: какую модель использовать? Claude Opus 5, GPT-6 Astra, DeepSeek 4 flash, а может быть Llama 3, Gemini, Mixtral — список можно продолжать. У каждой модели свои сильные стороны, свои нюансы в ответах, своя производительность и, конечно, своя цена. Если вы преимущественно по работе решаете одни и те же задачи – достаточно выбор сделать один раз, но что, если задачи всегда разные (а у 90% людей это так)?
-
Качество: одна модель прекрасно генерирует креативные тексты, другая, может быть сильна в коде, третья, точной в фактах внутри одной доменной области. Но универсальной, лучшей во всем, не существует.
-
Стоимость: разные модели, а также провайдеры (что особенно характерно, когда модель открытая и развернута у многих хостеров) имеют разную тарификацию. Слать все в самую мощную модель дорого, а если слать все в дешевую, то можно потерять качество на сложных или специализированных задачах.
-
Быстродействие: задержки могут быть критичны для интерактивных систем, а также систем с большим объемом генерации. Например, когда необходимо написать книгу может быть 2-3 десятка вызова к модели и после разложения на ярусы, 5-6 ярусов и ждать становится очень долго при малых скоростях (комфортно 100+ токенов/сек).
Традиционные подходы часто сводятся к жесткой привязке к одной модели, эвристическим правилам или ручному переключению, что неэффективно и плохо масштабируется.
Насколько велик разброс, видно по каталогу LLM сервиса OpenRouter [2]: из 428 моделей цена выхода различается в тысячу раз, от 0,03 до 25 долларов за миллион токенов (а генерация картинок еще дороже).
А простому пользователю важно не соотношение цены и качества, а скорее вопрос достаточности качества для его задачи при минимальной цене и минимальной задержки. Если ответ не годится, пользователь просто уйдет в другой сервис и сэкономленные токены на запросе не имеют ценности для пользователя. Поэтому мы в библиотеке реализовали такой подход: сначала отсеиваем тех, кто прогнозируемо не обеспечивает необходимого качества, и только потом среди оставшихся ищем оптимального кандидата по нашей метрике, о которой ниже.
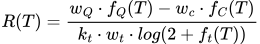
, где T – контекст в токенах (все токены входа), – веса вклада качества, стоимости и времени соответственно.
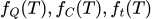 – функции прогнозирующие качество, стоимость и время.
Самое сложное это прогноз качества, он производится следующим образом LLM извлекает параметры ТЗ, и далее мы смотрим скалярное произведение с обучаемым вектором весов для каждой модели. Остальное прогнозировать легче, необходим узнать объем выход, а зная объем входа и выхода можно точно узнать и стоимость и время.
Установка и быстрый старт
Ставим библиотеку с Гитхаба:
pip install "git+https://github.com/MASFractal/FAIRouter"Для Python версии файл, из которого делаем вызов помещаем в папку библиотеки FAIRouterPython
Достаточно импортировать библиотеку и указать модели. Весь контур собран в один объект.
Для Python:
from fai_router import FaiRouter

router = FaiRouter.from_openrouter(
    api_key="...",
    model_ids=["google/gemini-2.5-flash", "openai/gpt-4.1-mini", "anthropic/claude-haiku-4.5"],
    database_path="fai-router.db",
)

answer = router.ask("Напиши обзор методов кластеризации на 1500 знаков в научном стиле")
print(answer.winner, answer.score)   # кто ответил и оценка судьи
print(answer.critic)                 # расхождения с заданием по пунктам

router.feedback(answer.round_id, 1.0)   # отзыв человека, если есть
router.train(epochs=10)                 # обучение по журналу
router.save()
Для C#:
Settings.LLM = new LLMWithOpenRouterClient(new LLMOptions { ApiKey = "...", ModelName = "openai/gpt-4o-mini" });

FaiRouter router = new(candidates, (candidate, messages) => Ask(candidate.Name, messages), "fai-router.db");

RouterAnswer answer = await router.AskAsync("Напиши обзор методов кластеризации на 1500 знаков");
Console.WriteLine($"{answer.Winner.Name}: {answer.Score}");
Console.WriteLine(answer.Critic);

router.Feedback(answer.RoundId!.Value, 1.0);
router.Train(epochs: 10);
router.Save();
Кандидатов (LLM, среди которых происходит выбор) достаточно перечислить идентификаторами моделей: цены, размер окна и возможности мы берем из каталога поставщика, начальную скорость — из замеров Artificial Analysis (данные есть по 147 моделям каталога), стартовое качество по типам задач — из наших датасетов. Если нужен полный контроль, кандидата можно описать руками: RoutedElement("Sonnet 4.6", tps=60, dpmt_inp=3, dpmt_outp=15). Для диалога с черновиком есть router.ask_messages(messages) — задание распознается по последней реплике, а исполнителю уходит вся история.
Ключ Api api_key=“…”, создается в OpenRouter, однако вам необязательно привязываться к этому сервису, можно использовать любой OpenAi-совместимый провайдер LLM, например FaiRouter.from_fractalrouter для FractalRouter [3], FaiRouter.from_openrouter для OpenRouter и FaiRouter.from_openai_compatible(base_url, ...) для любого сервера по протоколу OpenAI chat completions.
Классификатор, который выбирает оптимальную LLM находится в файле БД database_path=”fai-router.db”. Он был инициализирован на данных сервиса Арена. Вот как выглядит отчет критика на реальном прогоне:
Стиль: заказано Scientific, получено Conversational
Таблицы: заказано 1, получено 0
Ссылки на источники: заказано True, получено False
Объем в символах: заказано 4000, получено 243
Разделы: заказано 4, получено 1
...
Провалено пунктов 12 из 20
Если хочется просто «любую подходящую модель» внутри агента, мы поднимаем FAIRouter как OpenAI-совместимый сервер с единственной моделью auto — так он подключается, например, к OpenClaw:
OPENROUTER_API_KEY=... python -m fai_router.server
    --models google/gemini-2.5-flash,openai/gpt-4.1-mini,anthropic/claude-haiku-4.5
    --db ~/.openclaw/fai-router.db --port 8412
Как работает выбор LLM на практике
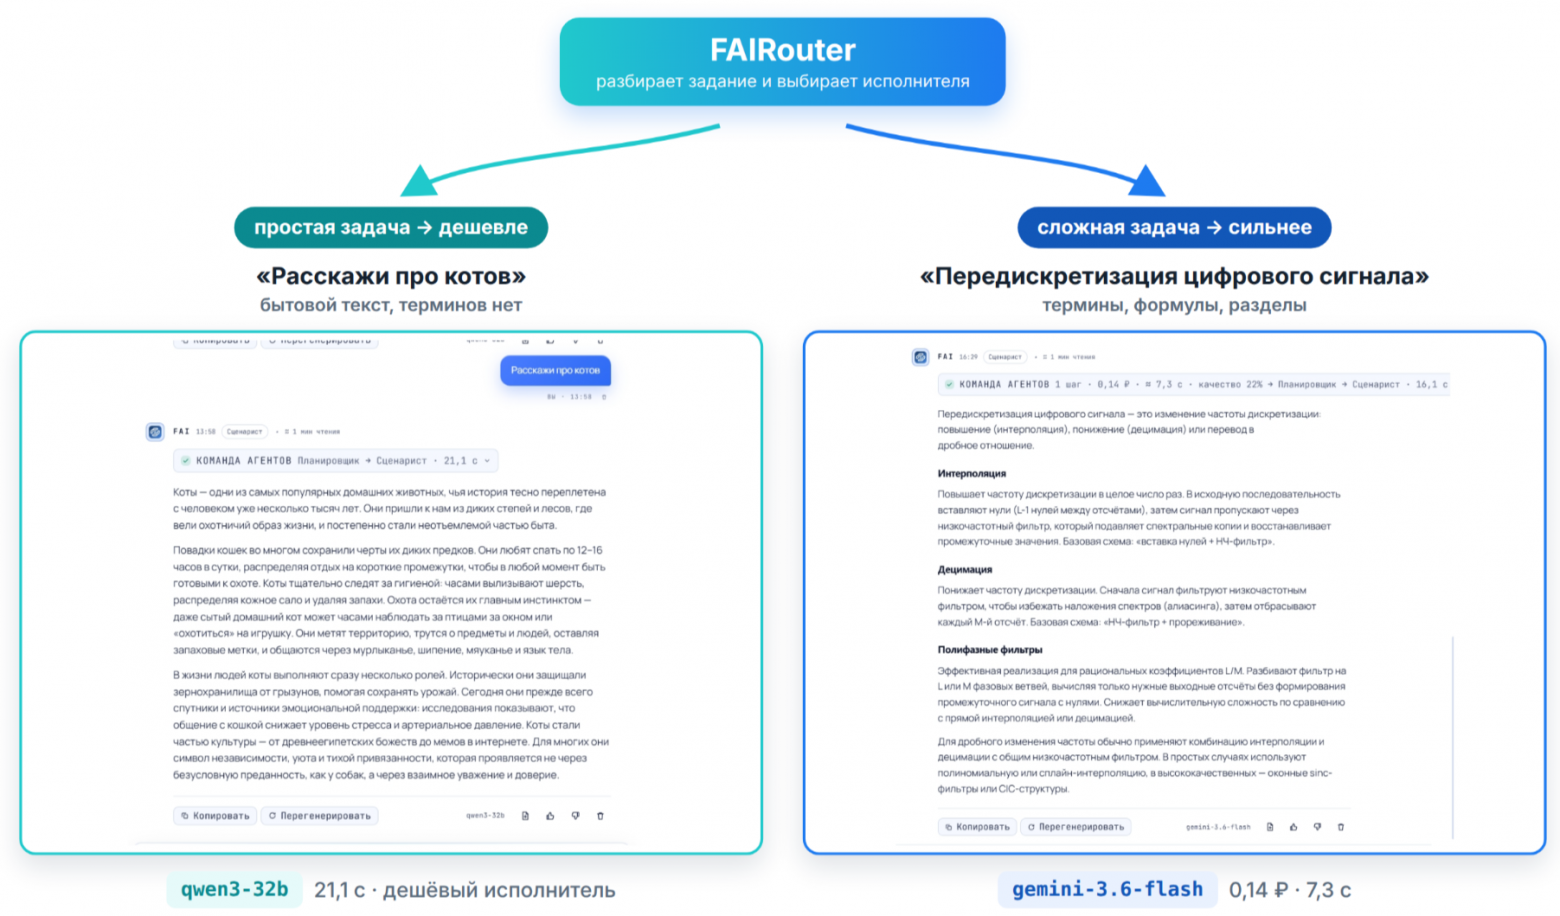
Если задача явно простая роутер выберет дешевую модель, например “расскажи про котов” – ответит Qwen 32b, если же вопрос о “обзоре и аналитике научных работ по дискретизации цифрового сигнала” – будет выбрана Gemini-3.6-flash.
Кратко о функциональности FAIRouter
FAIRouter — это не просто маршрутизатор между LLM. Это интеллектуальный диспетчер, который учится и адаптируется. Вот три ключевых тезиса, что он позволяет делать:
-
FAIRouter автоматически направляет входящий запрос к той модели, которая, по его “мнению”, справится с ним лучше всего, основываясь на заданных критериях и накопленном опыте [4] (распределение вычисляется по вышеописанной метрике R).
-
В система базируется на тн механизме “Судьи”, который оценивает качество ответов моделей. Судья также учится на обратной связи от человека, если Судья ошибся в оценке, и человек указал на это, Судья корректирует свои внутренние параметры, становясь умнее с каждой итерацией. Этот подход, позволяет системе постоянно улучшаться, адаптируясь к меняющимся требованиям и нюансам человеческой оценки. Это похоже на известный подход LLM-as-a-judge [5]. Подробнее о методике сравнения моделей в роли судьи можно прочитать в нашем репозитории [6].
-
Мы создавали FAIRouter с прицелом на реальные бизнес-сценарии. Система позволяет определять, что именно является “хорошим” результатом для вашего бизнес-запроса, и настраивать метрики оценки соответственно. Это могут быть не только точность и релевантность, но и скорость, стоимость, соответствие корпоративному стилю и многое другое.
Как правило, традиционные бенчмарки далеки от реальных запросов – потому что отражают внутренние способности LLM (например, знание языка, или умение отвечать на вопросы), а пользователь оценивает jobs-to-be-done – то есть то, как с помощью знания языка модель решает конкретную задачу написания письма, коммерческого предложения или создания отчета из нескольких разрозненных файлов (агентные сценарии).
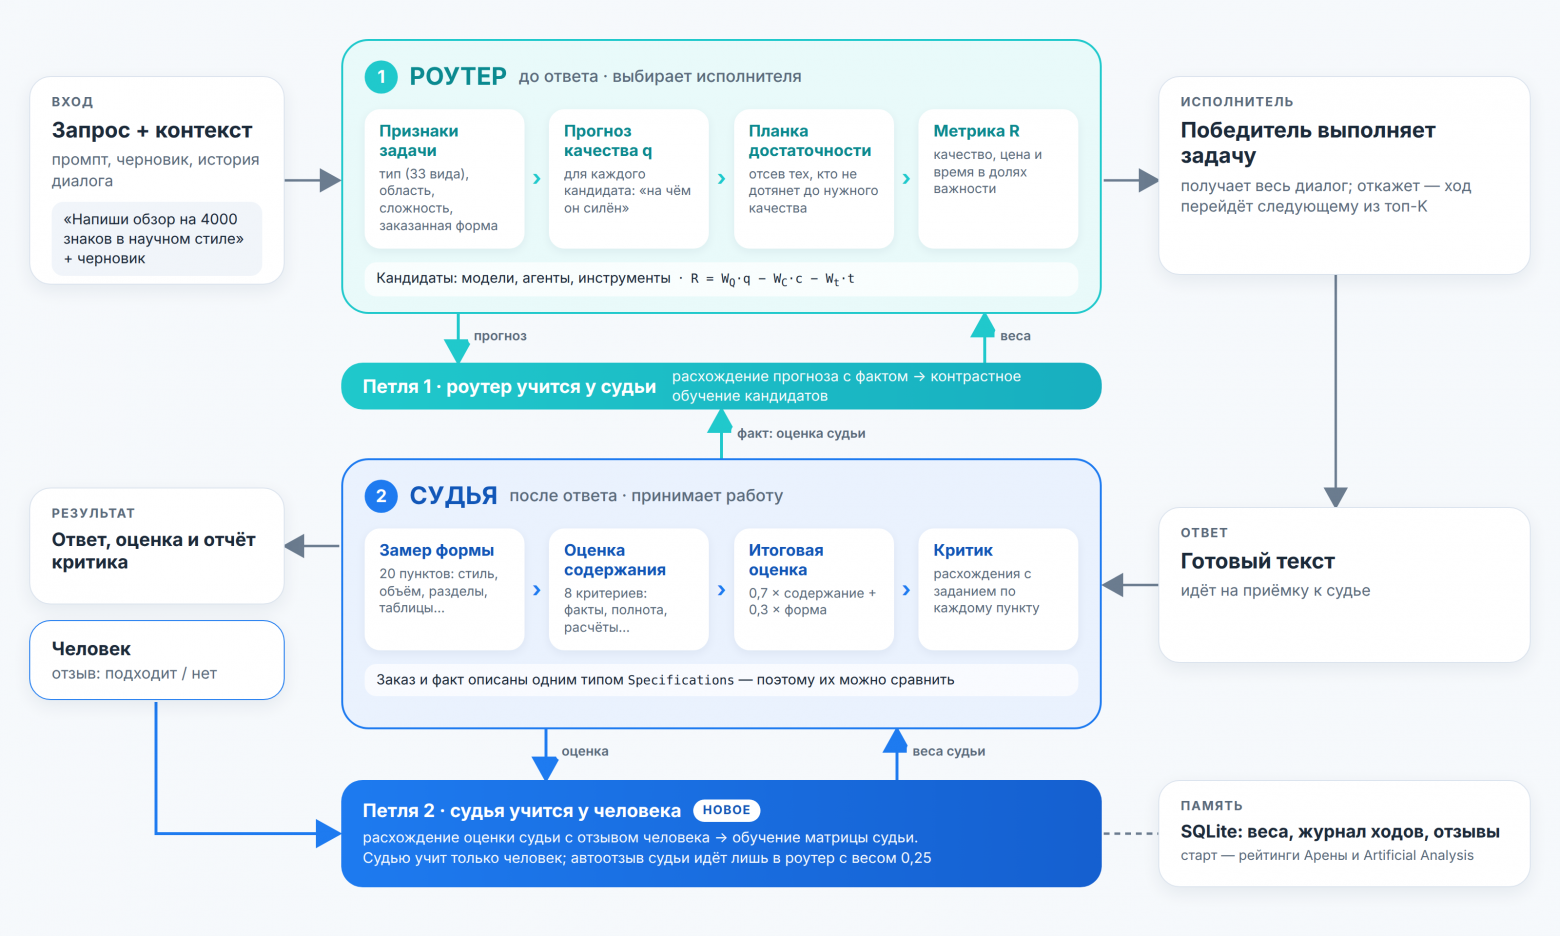
Устройство образуют два контура, (они же две петли на логотипе библиотеки, кстати). Величина «качество» живет здесь в двух видах, а разница между ними служит сигналом обучения.
Роутер работает на опережение: он предсказывает финал по одному лишь тексту запроса, еще до старта задачи. Судья же подключается постфактум, когда результат уже на руках. Отсюда и логика [8] обучения: роутер учится на собственных ошибках, когда его прогноз расходится с суровой реальностью, а судью поправляют каждый раз, когда его вердикт не совпадает с оценкой живого человека.
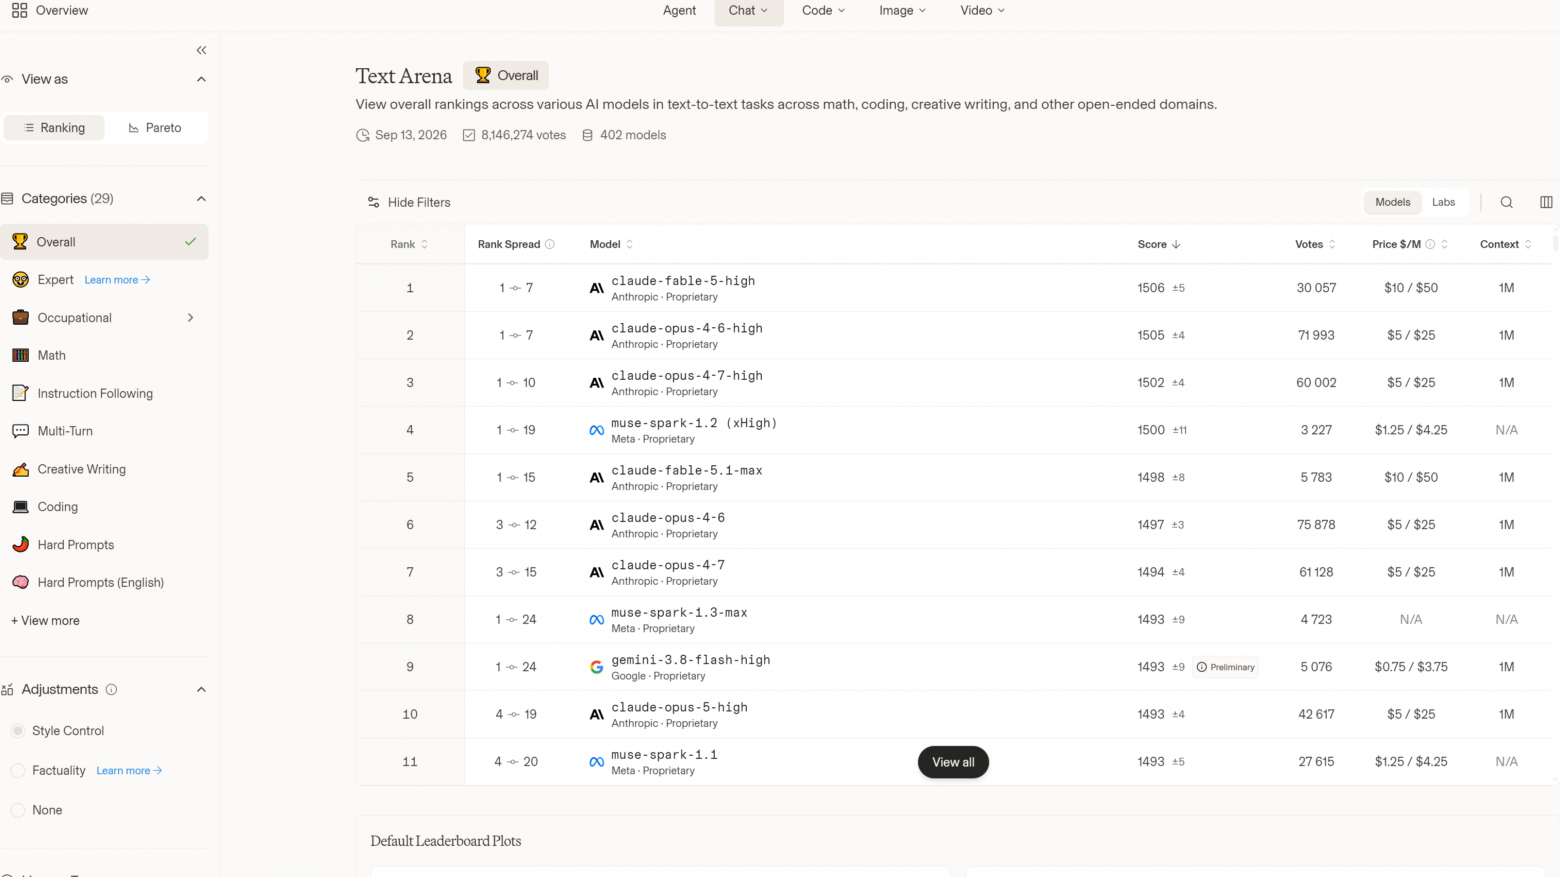
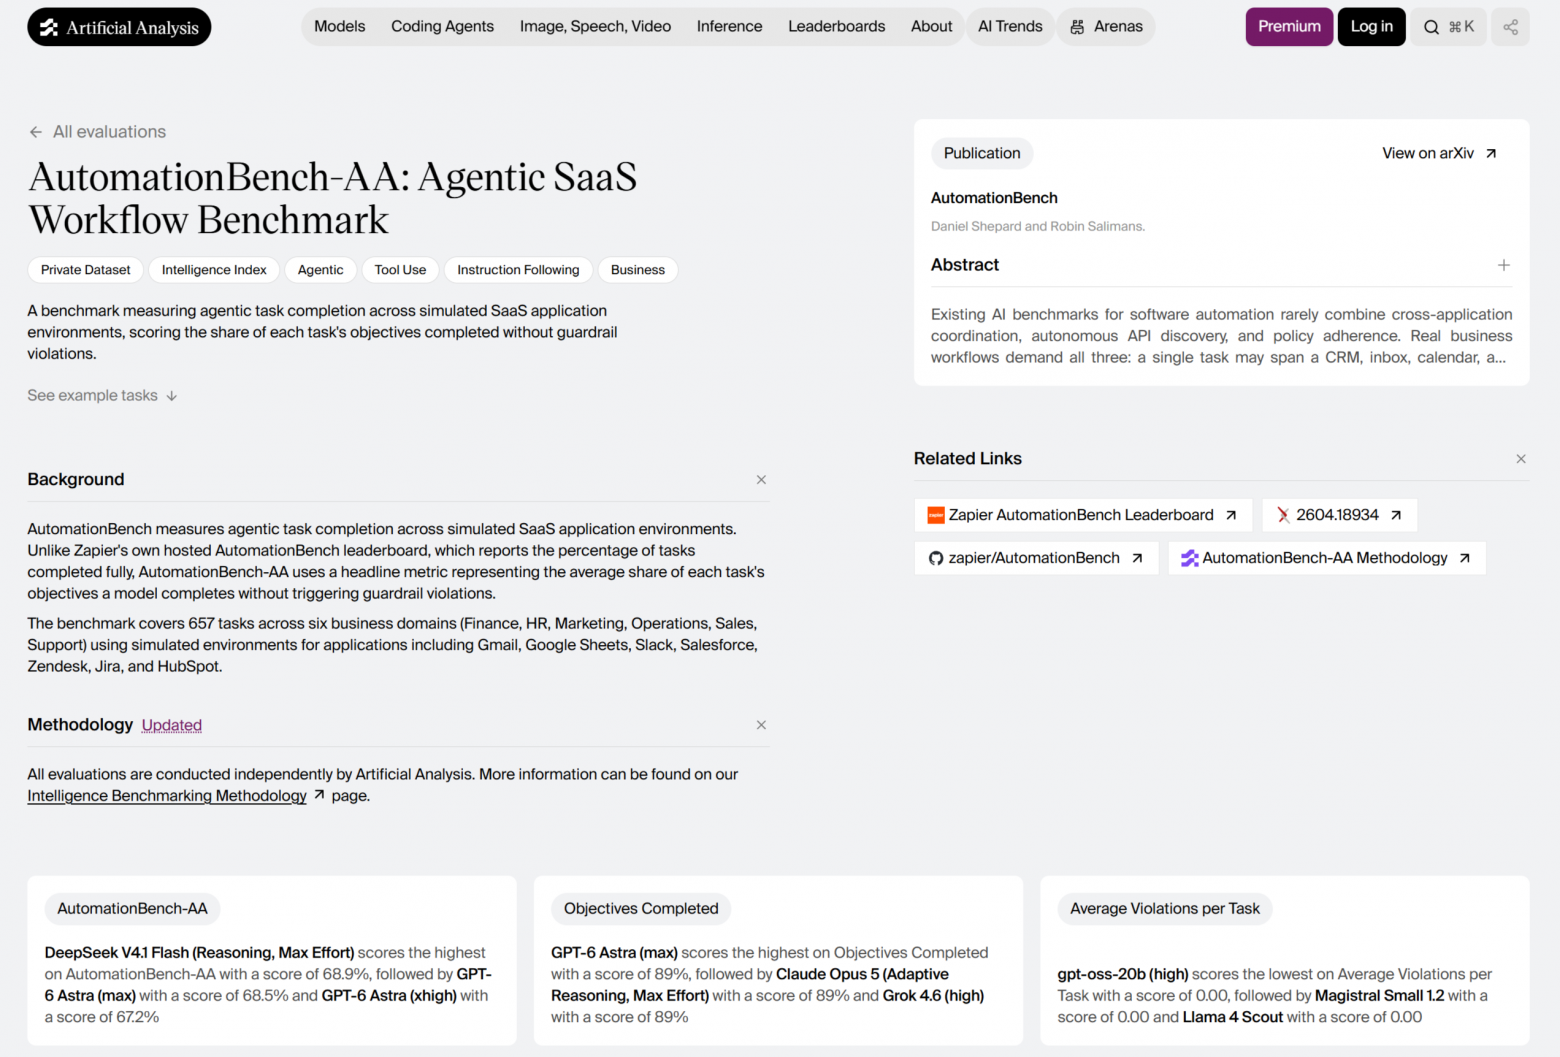
Признаки задачи мы не придумывали с нуля. Таксономию задач, которые реально компании решают с помощью LLM взяли у сервиса Арена [9] (бывшая LMArena) — все 29 текстовых категорий, и у сервиса глубокой аналитики моделей Artificial Analysis [10]: 118 серий, включая отраслевые индексы, фактологию по областям знаний и бизнес-функции AutomationBench [11].
Отдельный слой — наш собственный сервис с ИИ-агентами Fractal Agents. Мы запустили его в ноябре 2025го, и пользователи оставили нам богатую статистику: обезличенные логи запросов(более 118тыс. запросов), распределение по темам(130+ тем, после кластеризации), оценки и обратную связь(классические палец вверх и палец вниз, в 9% кейсов – категориальная). Эту статистику мы разобрали по категориям и добавили в таксономию как слой реальных пользовательских сценариев.
Отдельно мы опирались на крупнейшее исследование OpenAI о том, как реально люди используют ChatGPT: «How People Use ChatGPT» (Chatterji et al., NBER Working Paper 34255, 2025), основанное на анализе 1,5 млн обезличенных диалогов. Оно показало, что почти 80% всех обращений — это практические инструкции, поиск информации и написание текстов, а рабочее использование растёт медленнее, чем личное. Официальная страница исследования: https://openai.com/index/how-people-are-using-chatgpt/ [12] и ссылка на полный отчет с графиками в pdf [13]. Эти данные подтвердили, какие типы задач действительно доминируют у пользователей, и мы использовали их при разметке таксономии — в частности, при выделении групп «письма и коммуникации», «отчёты и аналитика», «консультации и планы».
Ещё один важный слой — открытый датасет GDPval от OpenAI, доступный на Hugging Face: https://huggingface.co/datasets/openai/gdpval [14]. GDPval — это бенчмарк, который оценивает возможности AI-моделей на реальных экономически значимых задачах. Он охватывает 44 профессии в 9 секторах, которые вносят наибольший вклад в ВВП США, с как минимум 30 задачами на профессию в полном наборе (и 5 задачами в открытом gold-сабсете из 220 задач). Задачи построены на основе реальной работы профессионалов со средним опытом 14 лет, а для каждой задачи в датасете приведены рубрики оценки (rubric_json и rubric_pretty), включающие критерии с весами и оценками. Мы использовали таксономию профессий и секторов GDPval, а также структуру его рубрик при проектировании критериев «Содержания» — в частности, для настройки таких критериев, как «Полнота по сути», «Выполнение указаний» и «Пригодность для дела». Наличие готовых человеческих рубрик с весами и оценками позволило нам не изобретать шкалы с нуля, а опираться на уже валидированную разметку.
Так публичные источники дополняются живыми данными, а не только внешними рейтингами. Стартовые веса кандидатов берутся из открытых рейтингов и каталогов, которые допускают такое использование: из 349 моделей каталога OpenRouter хотя бы в одном открытом рейтинге нашлись 199, в обоих сразу — 134. Поэтому FAIRouter полезен сразу после установки, с первого запуска, а не после месяца накопления статистики.
Что оценивает библиотека
Оценок три группы. Признаки задачи известны до ответа — по ним идет выбор. Человек в любой бизнес-задаче оценивает суть, то есть “содержание”, и то, как эта информация оформлена, то есть “форму”. Содержание и форма измеряются после, итог складывается как 0,7 содержания и 0,3 формы, и на нем учится роутер.
Мы также оцениваем не только качество финального ответа LLM, но и соответствие ответа постановке задачи пользователем (“заказу”) – ведь если вы просили короткий ответ, а получили полотно текста задача не выполнена, не смотря на то, что факты и логика ответа могут быть великолепными.
Мы назвали наш подход Task-level Quality-Guaranteed Downgrade. Формулировка следующая: «Мы не выбираем модель под промпт. Мы находим для каждого повторяющегося шага вашего бизнес-процесса самую дешёвую модель, которая держит вашу планку качества — доказанную на ваших же данных — и удерживаем её при выходе новых моделей.»
Единица решения — не промпт, а шаг бизнес-процесса (извлечение полей из инвойса, классификация тикета, драфт ответа клиенту, суммаризация звонка, генерация SQL по схеме).
Признаки задачи.
|
Группа |
Признаки |
Откуда взят |
|
Тип задачи |
33 вида в 8 группах: письма и коммуникации, отчеты и аналитика, маркетинг и продажи, документы и право, код и ИТ, наука [15] и обучение, творчество [16] и медиа, консультации и планы |
сервис Fractal Agents: бизнес-задачи пользователей, каждый вид сопоставлен категории арены или индексу AA, |
|
Область |
15 областей: 8 отраслевых категорий арены, маркетинг, финансы, продажи, кадры, поддержка, операции, инженерия |
Арена, AutomationBench, индексы AA, сервис Fractal Agents |
|
Предмет |
язык программирования, область науки, язык ответа |
Арена, знание языков программирования у AA,сервис Fractal Agents |
|
Сложность |
трудность (Hard Prompts), экспертность (Expert), число явных ограничений (Instruction Following), длина диалога (Multi-Turn), опора на факты (Factuality) |
Арена, сервис Fractal Agents |
|
Заказанная форма |
стиль, объем, разделы, списки, таблицы, код, формулы, глубина заголовков, читаемость, терминология, формальность, ссылки |
наша библиотека, сервис Fractal Agents |
Содержание: восемь критериев судьи. Каждый мы брали не из головы, а с оглядкой на то, каковы реальные потребности [17] пользователей.
|
Критерий |
Что проверяет |
Откуда взят |
|
Фактология |
атомарные проверяемые утверждения (до 12) и вероятность истинности каждого |
рейтинг фактологии Арены |
|
Полнота по сути |
раскрыт ли каждый смысловой пункт заказа, а не число разделов |
GDPval [14], рубрика MAS |
|
Выполнение указаний |
доля соблюденных явных ограничений |
Instruction Following Арены, IFBench |
|
Верность рассуждений и расчетов |
выводы следуют из данных, числа сходятся |
аналитическое качество Briefcase у AA |
|
Экспертная глубина |
уровень, которого ждет специалист области |
мануал из Expert Арены |
|
Наполнение структуры |
таблицы и списки содержательны, без пустых и выдуманных строк |
наша практика |
|
Качество источников |
источники существуют, по делу и подтверждают утверждения |
сервис Fractal Agents, поисковая Арена |
|
Пригодность для дела |
можно ли отдать результат заказчику как есть |
GDPval, работа со знаниями у AA |
Неприменимые к задаче критерии мы исключаем из расчета среднего балла. Логика проста: если в запросе нет жестких ограничений, то их не нужно выполнять, а если в сгенерированном ответе нет проверяемых фактов, то и верифицировать нечего.
Оценка формата состоит из 20 параметров — от стиля и объема до языка программирования. При этом структурные требования проверяются алгоритмически (строгой логикой), а за анализ стиля и лексики отвечает ML-модель.
Отдельного упоминания заслуживает самый «капризный» параметр — шкала терминологии. Это метрика от 0 до 1, отражающая концентрацию специфической лексики: где 0 — это простые бытовые формулировки, а 1 — хардкорный узкоспециализированный текст. Модель оценивает этот параметр дважды: для исходного запроса и для итогового ответа, чтобы эвалюатор («судья») мог сопоставить их между собой.
Поначалу эта шкала отказывалась работать: модель выдавала 0,1 и для фундаментального научного обзора, и для короткой реплики в чате. Проблему решили добавлением жестких опорных точек прямо в описание поля (например: «0.05 — бытовая речь; 0.45 — технический текст; 0.90 — узкоспециальный»). После этого калибровка пришла в норму: научная статья стала получать адекватные 0,70, а бытовые реплики — 0,05. Важный архитектурный нюанс: описание этой шкалы мы храним в одном месте и подставляем в обе схемы оценки. «Линейка» обязана быть строго идентичной, иначе сравнивать ожидание с реальностью не имеет смысла.
В финале алгоритм-«критик» агрегирует все расхождения в единый построчный отчет. Он включает подробный разбор по всем 20 параметрам формы, каждому смысловому блоку, заданному ограничению и всем фактологическим утверждениям с оценкой их вероятности.
Выглядит это так:
Содержание 0.26, форма 1.00, итог 0.48
Смысловой пункт «вывод о рентабельности»: заказано раскрыть, получено не раскрыт
Качество источников: заказано 1, получено 0
Факт «Рентабельность выросла на 40%»: заказано верно, получено верно с вероятностью 0.10
Верность рассуждений и расчетов: заказано 1, получено 0.2
Экспертность: заказано 0.8, получено 0.3
Смысловой пункт «сравнить три тарифа по цене»: заказано раскрыть, получено раскрыт частично
- в таблице выдуманные цены
- вывода о рентабельности нет
Обратите внимание [18]: форма совпала с заказом пользователя полностью, и все равно разбор называет девять расхождений по содержанию.
Что дальше
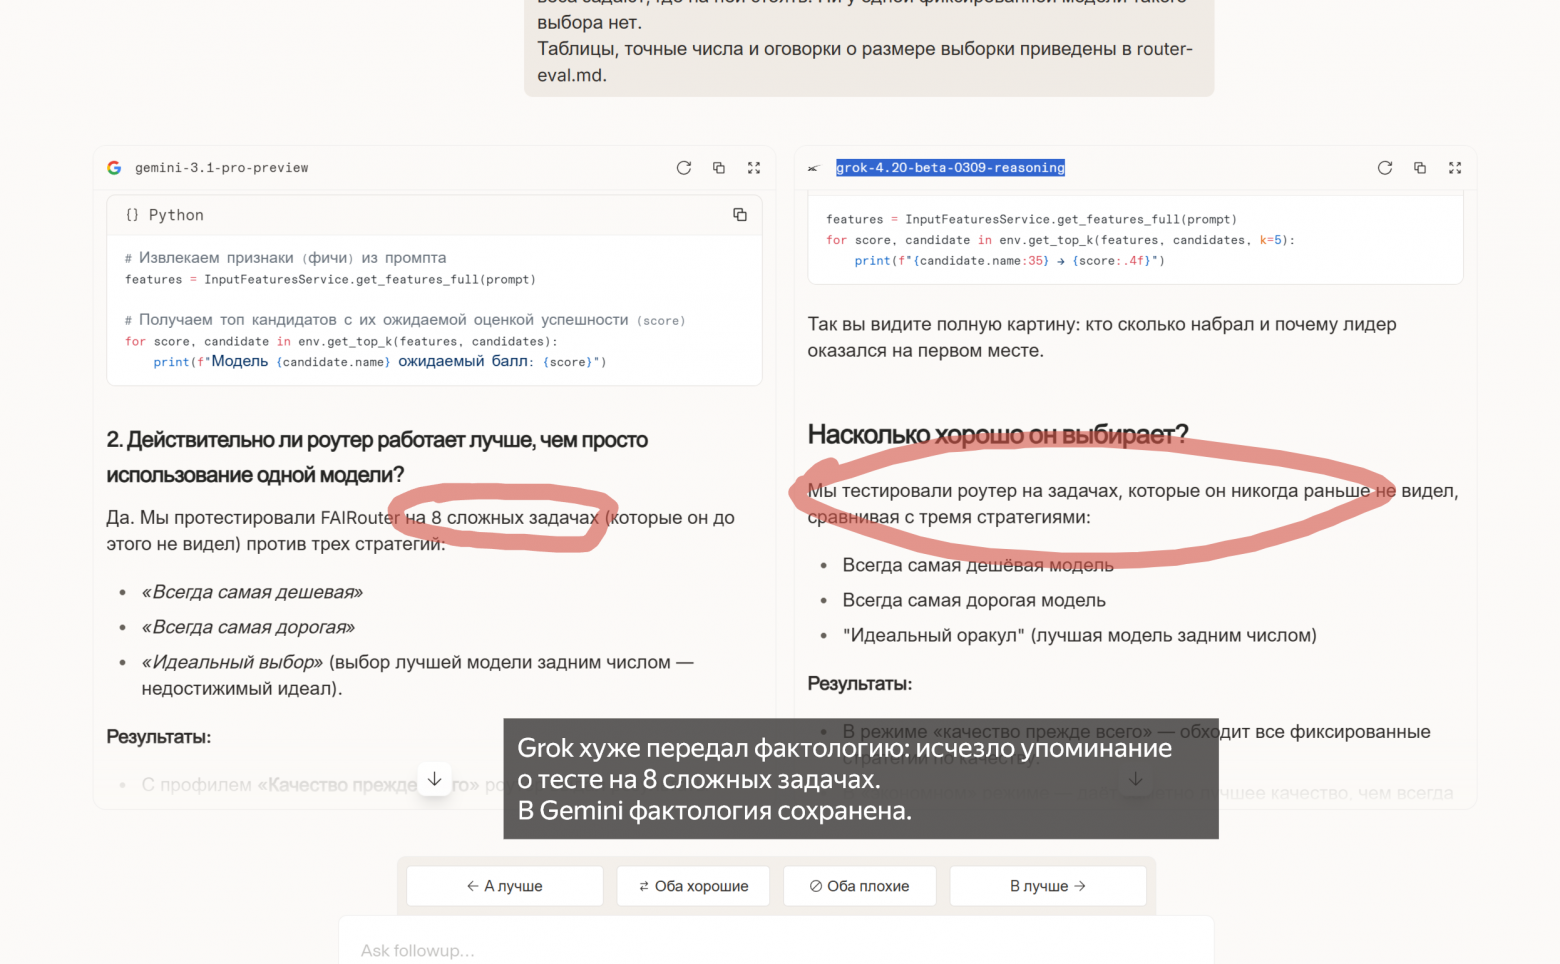
Сейчас работают полный ход роутинга, извлечение ТЗ, замер факта, критик, обучение обеих обучаемых величин, холодный старт по рейтингам, планка достаточности с калибровкой, поправка цены на переделки и журнал ходов с отзывами в SQLite.
Чего пока нет: обучения на большом объеме живых человеческих отзывов — их нужно накопить, и это наша ближайшая задача. Также судья содержания сейчас проверяет факты сам, без веба; делегат для внешней проверки в библиотеке предусмотрен, но в замерах мы им не пользовались.
-
Репозиторий: github.com/MASFractal/FAIRouter [1]
-
Python: pip install -e Python (3.11+, из зависимостей только numpy), C#: .NET 10
-
Все замеры с методикой и стендами для повторения [19]: docs/research [20]
-
Попробовать FAIRouter [23] в действии в агентной системе Fractal Agents
Нам особенно интересны те, кто выбирает модели под бизнес-задачи. Какие критерии приемки вы проверяете у себя руками и чего не хватает в наших восьми? Расскажите в комментариях — самое полезное мы добавим в судью.
В следующей статье планируем рассказать о том, как проводили рисеч и замеры, какие при этом возникали сложности и как мы их преодолели.
Автор: Zachar_5
Источник [24]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36407
URLs in this post:
[1] FAIRouter: https://github.com/MASFractal/FAIRouter
[2] OpenRouter: https://openrouter.ai
[3] FractalRouter: https://fractalrouter.ru/
[4] опыте: http://www.braintools.ru/article/6952
[5] LLM-as-a-judge: https://huggingface.co/learn/cookbook/llm_judge
[6] репозитории: https://github.com/MASFractal/FAIRouter/blob/main/docs/research/judge-models.md
[7] обучения: http://www.braintools.ru/article/5125
[8] логика: http://www.braintools.ru/article/7640
[9] Арена: https://arena.ai/leaderboard/text
[10] Artificial Analysis: https://artificialanalysis.ai/
[11] AutomationBench: https://artificialanalysis.ai/evaluations/automationbench-aa
[12] https://openai.com/index/how-people-are-using-chatgpt/: https://openai.com/index/how-people-are-using-chatgpt/
[13] полный отчет с графиками в pdf: https://www.nber.org/system/files/working_papers/w34255/w34255.pdf
[14] https://huggingface.co/datasets/openai/gdpval: https://huggingface.co/datasets/openai/gdpval
[15] наука: http://www.braintools.ru/article/7634
[16] творчество: http://www.braintools.ru/creation
[17] потребности: http://www.braintools.ru/article/9534
[18] внимание: http://www.braintools.ru/article/7595
[19] повторения: http://www.braintools.ru/article/4012
[20] docs/research: https://github.com/MASFractal/FAIRouter/tree/main/docs/research
[21] YouTube: https://youtu.be/FMesl7rxbYo
[22] VK Video: https://vkvideo.ru/video-233381656_456239019
[23] Попробовать FAIRouter: https://mas2.fractalagents.ai/app/chat
[24] Источник: https://habr.com/ru/articles/1086786/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1086786
Нажмите здесь для печати.