Nano Banana 2.1 vs Nano Banana 2: три одинаковых промпта и то, что видно на картинках
Google выпустила Nano Banana 2.1 и обещает улучшения «по всем фронтам»: качество, текст в кадре, консистентность персонажей при многократном редактировании, инфографика. Я прогнал три одинаковых промпта через Nano Banana 2 и 2.1 и посчитал результаты по чек-листу. Новая версия выиграла не там, где обещали.
Сразу оговорюсь про масштаб: это не бенчмарк. Три задачи, по одному прогону на модель, один оценщик. Такой прогон показывает, где искать разницу, а не измеряет её. Числа Google я привожу отдельно, и отдельно отмечаю: независимых замеров на 8 октября 2026 года нет, все издания о релизе ссылаются на одну таблицу разработчика.
Короткий ответ
-
Текст в кадре: обе отрисовали кириллицу и цифры чисто, но двойка выполнила задание точнее – 10 пунктов из 10 против 9. Единственный пункт, который потеряла 2.1, – лишнее слово, которого в промпте не было.
-
Инфографика: ничья по фактам. Восемь подписей из восьми, восемь попаданий выносок из восьми у обеих. Вёрстка аккуратнее у 2.1, зато заголовок, которого я не просил, появился только у неё.
-
Сцена из трёх персонажей: чище здесь 2.1 – ни одной лишней детали, приметы розданы верно.
-
Самое интересное: главный пункт релиза, рост точности инфографики с 0,179 до 0,521, на одной схеме не виден. Обе версии сделали её без фактических ошибок.
Что за модель и что в ней заявлено
Nano Banana 2.1 – обновление Nano Banana 2, о котором Google сообщила 6 октября 2026 года. Обе модели из линейки Flash: 2.1 работает на Gemini 3.6 Flash, двойка – на Gemini 3.1 Flash Image. Флагманская Nano Banana Pro осталась на Gemini 3 Pro Image. Дальше только о первых двух: 2.1 вышла как замена двойки, а не как отдельная линейка.
Что заявлено в карточке модели и материалах Google:
-
улучшение качества изображения и реализма на всех поддерживаемых разрешениях;
-
улучшение отрисовки текста и вёрстки инфографики;
-
консистентность персонажей и объектов при многократном редактировании, то есть в нескольких шагах подряд;
-
широкие панорамы и соотношения сторон до 8:1;
-
до 14 референсных изображений в одном запросе, с сохранением до четырёх персонажей и десяти объектов;
-
обращение к поиску Google, когда модель изображает реально существующие объекты;
-
уровни рассуждения minimal, medium и high, где medium стоит по умолчанию;
-
редактирование по маске: пользователь выделяет область, и меняется только она.
Из всего списка практичнее прочего выглядит маска. В интерфейсе Gemini она мелькала ещё в марте, но рабочей функцией стала только сейчас, и у двойки её в таком виде нет. В моём тесте маска не проверялась: все три задачи были про генерацию с нуля.
Сравнить версии напрямую по параметрам можно так:
|
Параметр |
Nano Banana 2 |
Nano Banana 2.1 |
|---|---|---|
|
Базовая модель |
Gemini 3.1 Flash Image |
Gemini 3.6 Flash |
|
Разрешения |
1K, 2K, 4K |
1K, 2K, 4K |
|
Соотношения сторон |
в релизе 2.1 не сопоставлены |
до 8:1 |
|
Референсные изображения |
в релизе 2.1 не сопоставлены |
до 14 изображений; до 4 персонажей, до 10 объектов |
|
Обращение к поиску |
веб-поиск |
поиск Google |
|
Уровни рассуждения |
minimal и high |
minimal, medium (по умолчанию), high |
|
Редактирование по маске |
есть |
заявлено как ключевое улучшение |
Числа, которые привёл сам Google
Это тесты разработчика: сравнение пар изображений живыми оценщиками, результат в баллах Elo, плюс отдельная автооценка фактической точности инфографики. С Elo её сравнивать нельзя, шкала другая, от 0 до 1.
|
Тест |
2.1 (с рассуждением) |
2.1 (без) |
Nano Banana 2 |
Nano Banana Pro |
|---|---|---|---|---|
|
Текст → изображение, общее предпочтение |
1050 |
1015 |
990 |
935 |
|
Дизайн инфографики |
1048 |
1001 |
961 |
912 |
|
Фактическая точность инфографики (0-1) |
0,521 |
0,328 |
0,179 |
0,265 |
|
Общее редактирование |
1026 |
980 |
938 |
939 |
|
Консистентность одного персонажа |
1028 |
1021 |
981 |
991 |
|
Консистентность нескольких персонажей |
1106 |
1068 |
978 |
1011 |
|
Редактирование по маске |
1049 |
1042 |
965 |
927 |
|
Консистентность продукта |
1024 |
981 |
955 |
965 |
|
Редактирование по нескольким референсам |
1066 |
1041 |
988 |
989 |
Из таблицы видно две вещи, и вторая важнее первой. Flash-модель обошла собственную Pro-версию по всем строкам, а это против привычного порядка: обычно младшая линейка догоняет флагман, а не обгоняет. И самые крупные отрывы там, где речь не про красоту, а про дисциплину, – консистентность нескольких персонажей и точность инфографики.
Тут нужна остановка. Независимых прогонов этих чисел на 8 октября 2026 года нет. The Decoder, Notebookcheck и Unite.AI пересказывают одну и ту же таблицу Google, а Notebookcheck пишет прямым текстом: «Independent tests are not yet available». Всё, что попадалось у сторонних авторов, – сравнения на нескольких промптах без методологии и без счёта. Поэтому дальше я проверяю не числа, а три вещи, которые из них следуют.
Как я сравнивал
-
Промпты одинаковые дословно, по одному прогону на задачу для каждой модели. Генерации – в SYNTX, где обе модели лежат в одном интерфейсе: так один и тот же текст задания уходит двум версиям без переключения между сервисами и без правок по памяти [1].
-
Оценка – чек-лист «да/нет», без шкал. Пункты двоичные: подпись совпадает посимвольно или нет, выноска попадает в деталь или нет.
-
Оценщик один – я. Сравнение не было слепым, я знал, где какая модель, поэтому в отчёте нет «нравится больше», только то, что можно перепроверить по картинкам.
-
Разрешение и уровень рассуждения я не выставлял и не сверял, отдаёт ли их интерфейс. По этим двум параметрам условия неизвестны. Это пункт для проверки, а не факт.
-
Время генерации не замерял. О скорости здесь не будет ничего.
Тест 1. Текст в кадре: кириллица и цифры
Проверял то, что ломается чаще всего и при этом легко считается: точное воспроизведение надписей. Задача – панель мониторинга сервера с русскими подписями, десятичными дробями и логом моноширинным шрифтом.
Сгенерируй изображение: скриншот панели мониторинга сервера, тёмная тема, 16:9.
Заголовок страницы, точный текст: «Кластер: prod-moscow-1»
Три плитки с метриками, подпись и значение в каждой:
1) «Загрузка CPU» — 78,4 %
2) «Свободно на диске» — 1,2 ТБ
3) «Задержка p95» — 247 мс
Под плитками лог из четырёх строк, моноширинный шрифт:
[12:04:11] INFO  workers=16 queue=0 ok
[12:04:19] WARN  retry=2 node=eu-3
[12:04:26] ERROR timeout=30s shard=7
[12:04:31] INFO  recovered
Других надписей нет. Кириллица и латиница — ровно так, без искажений.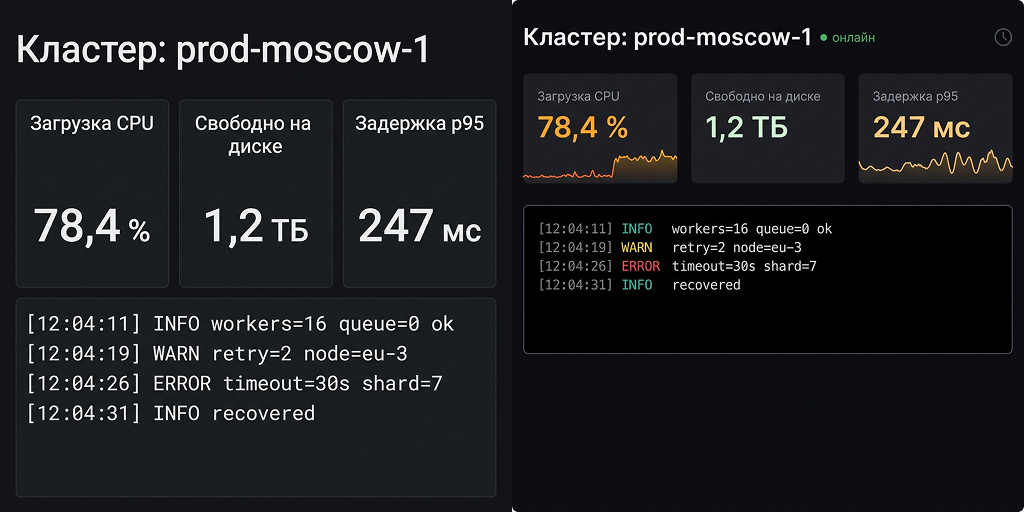
|
Пункт |
Nano Banana 2 |
Nano Banana 2.1 |
|---|---|---|
|
Заголовок «Кластер: prod-moscow-1» |
да |
да |
|
«Загрузка CPU» и 78,4 % |
да |
да |
|
«Свободно на диске» и 1,2 ТБ |
да |
да |
|
«Задержка p95» и 247 мс |
да |
да |
|
Четыре строки лога целиком |
4 из 4 |
4 из 4 |
|
Лишних надписей нет |
да |
нет: добавила «онлайн» |
|
Символы не искажены, латиница читается как латиница |
да |
да |
|
Итого |
10 из 10 |
9 из 10 |
Разница в одну строку, не критично, но не в пользу новой версии. Двойка сделала ровно то, что просили, простыми средствами. Зато у 2.1 аккуратнее собрана сама имитация интерфейса: уровни INFO, WARN и ERROR различаются по цвету, колонки выровнены, в плитках появились иконки и мини-графики. Вместе с ними пришло лишнее слово «онлайн» и пустое поле внизу кадра, примерно треть высоты.
Из-за этой строки я и не пишу, что 2.1 лучше работает с текстом. По инструкции «других надписей нет» двойка прошла, а 2.1 – нет.
Тест 2. Инфографика с проверяемым фактом
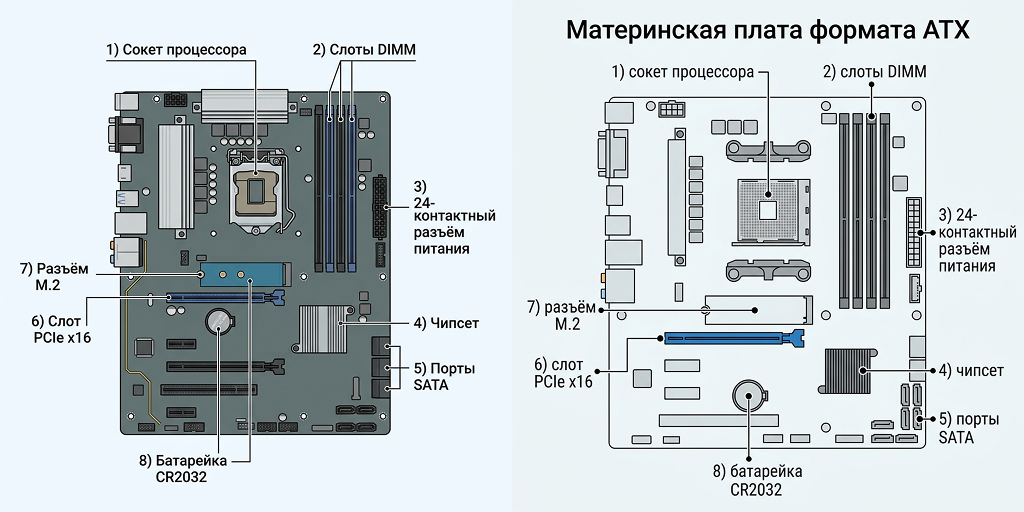
Здесь заявлен самый большой отрыв: фактическая точность инфографики выросла почти втрое. Проверять такое нужно там, где у картинки есть правильный и неправильный ответ. Я взял схему материнской платы: у ATX стандартное расположение элементов, и выноска либо попадает в деталь, либо нет.
Сгенерируй учебную схему-инфографику: материнская плата формата ATX, вид сверху,
светлый фон, подписи на русском.
Восемь выносок ровно на эти элементы:
1) сокет процессора
2) слоты DIMM
3) 24-контактный разъём питания
4) чипсет
5) порты SATA
6) слот PCIe x16
7) разъём M.2
8) батарейка CR2032
Каждая выноска указывает на нужную деталь и на её правильное место на плате.
Слоты DIMM — справа от сокета, 24-контактный разъём питания — справа по кромке.
Стиль: аккуратный технический рисунок, без фотографизма. Других подписей нет.
|
Пункт |
Nano Banana 2 |
Nano Banana 2.1 |
|---|---|---|
|
Подписи 1-8 дословно |
8 из 8, но все с заглавной буквы |
8 из 8, регистр как в промпте |
|
Выноски указывают на нужный элемент |
7 из 8 |
8 из 8 |
|
Лишних подписей нет |
да |
нет: добавила заголовок «Материнская плата формата ATX» |
|
Выноски не пересекают друг друга и соседние детали |
нет: одна тянется через соседний слот |
да |
|
Стороны не перепутаны: DIMM справа от сокета, питание у правой кромки |
да |
да |
По фактам здесь ничья: все восемь элементов на местах, все восемь подписей корректны, включая «24-контактный разъём питания» с дефисом. Путаницы лево-право, которой обычно грешат генеративные модели, не было ни разу ни у одной.
Разошлось оформление. У 2.1 связи не наезжают друг на друга и регистр сохранён. У двойки одна выноска идёт через соседний элемент, одна ошибочно указывает на неверный элемент, а все восемь подписей она начала с заглавной буквы. Зато 2.1 второй раз подряд дописала то, чего не просили: заголовок, притом что в промпте стояло «других подписей нет».
Что это значит для заявленных 0,521 против 0,179. На одной схеме такой разрыв не воспроизводится: обе версии фактически корректны. Может быть, дело в сложности, и на схемах с длинными подписями и десятками элементов разница проявилась бы. Проверить это можно только отдельным тестом, и одного кадра для вывода о трёхкратном росте мало. Ни подтверждать, ни опровергать числа Google я по этому кадру не стану.
Тест 3. Три персонажа в одном кадре
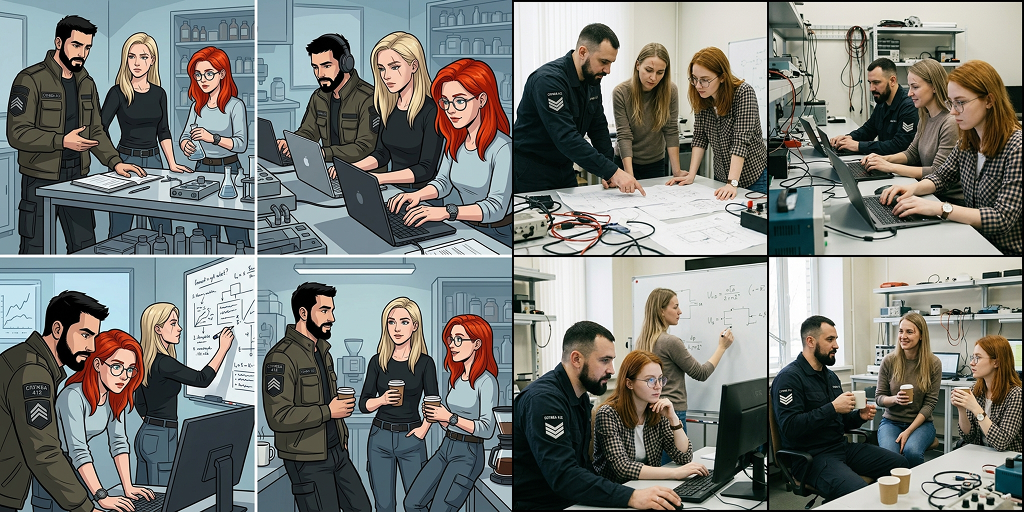
Самый большой отрыв в таблице Google – консистентность нескольких персонажей, 1106 против 978. В чистом виде это про редактирование, где одна сцена меняется шаг за шагом. У меня один кадр, так что я взял ближайшее доступное: три персонажа с разными приметами в четырёх панелях одной картинки. У каждого ровно одна яркая деталь, и если модель её теряет или меняет местами, это видно сразу.
Сгенерируй одно изображение: сетка 2×2 из четырёх панелей одинакового размера.
В каждой панели одни и те же три персонажа, все трое видны:
— Марк: короткая стрижка, чёрная борода, шеврон на левом рукаве с текстом «СЛУЖБА 412»
— Ирина: длинные светлые волосы, тонкий шрам над левой бровью
— Лена: рыжие волосы, круглые очки, механические часы на левом запястье
Позы по панелям: 1) все стоят у стола; 2) все сидят за ноутбуками;
3) Марк и Лена смотрят на экран, Ирина пишет на доске; 4) все пьют кофе.
Фон — одна и та же лаборатория во всех четырёх панелях, ракурс немного разный.
Никаких других надписей, кроме текста на шевроне.
|
Что смотрел |
Nano Banana 2 |
Nano Banana 2.1 |
|---|---|---|
|
Стиль по умолчанию |
рисованный, ближе к комиксу |
фотографический |
|
Лена: рыжие волосы, очки, часы на левом запястье |
4 панели из 4 |
4 из 4 |
|
Марк: шеврон на левом рукаве |
4 из 4 |
4 из 4 |
|
Ирина: длинные светлые волосы в одинаковом виде |
да |
да |
|
Ирина: шрам над левой бровью |
3 из 4, положение смещается, пропал на последнем кадре |
4 из 4, положение слегка смещается, не виден на кадре со спины |
|
Текст на шевроне читается |
нет |
нет |
|
Лишние детали, которых не было в промпте |
одна (деталь у Марка во второй панели) |
нет |
|
Один и тот же фон во всех панелях |
да |
да |
Здесь 2.1 выглядит сильнее. Лишнего она не добавила: ни посторонних предметов, ни деталей одежды, а вот во второй панели двойки такой элемент появляется. Приметы розданы верно: никто из персонажей не обменялся очками или бородой, а шрам у Ирины держится в трёх панелях из четырёх, где лицо вообще видно. По положению он слегка смещается, но не исчезает.
Дальше оговорка, без которой вывод будет неверным. В промпте не задан стиль, и модели взяли свои настройки по умолчанию: двойка ушла в рисованную манеру, 2.1 – в фотографическую. Реализм в этом тесте сравнивать нельзя, сравнились настройки, а не способности. В итоговую таблицу фотореализм не идёт.
И второе: надпись «СЛУЖБА 412» на шевроне не читается до конца ни у одной модели. В третьей панели, где рука крупнее, она ближе к нужному, но буквы всё равно плывут. Ту самую слабость с мелким текстом, которую Google признаёт в карточке, обе версии показывают одинаково охотно.
Что получилось в сумме
|
Что проверял |
Nano Banana 2 |
Nano Banana 2.1 |
|---|---|---|
|
Текст в кадре (10 пунктов) |
10 из 10 |
9 из 10 |
|
Инфографика: подписи |
8 из 8 |
8 из 8 |
|
Инфографика: попадание выносок |
7 из 8 |
8 из 8 |
|
Инфографика: лишние подписи |
нет |
есть |
|
Инфографика: пересечения выносок |
есть |
нет |
|
Сцена: лишние детали |
одна |
нет |
|
Сцена: сохранение примет персонажей |
без грубых ошибок |
без грубых ошибок |
Вывод получился не тот, что подсказывает релизная таблица. По трём задачам 2.1 ни разу не проиграла в аккуратности внутри кадра и ни разу не выиграла там, где решает точное следование заданию. Обе её особенности, чистая вёрстка и реалистичная подача по умолчанию, идут в одной упряжке с привычкой добавлять от себя. В тесте 1 это лишнее слово, в тесте 2 – лишний заголовок. Двойка оба раза просто сделала, что просили.
Есть и другое объяснение, и я не могу его отбросить. То, что я записал в лишнее, может быть работой уровня рассуждения medium, которого у двойки нет. Модель, которая больше думает о вёрстке, охотнее достраивает интерфейс до правдоподобного. Проверить это можно прогонами на minimal и high, чего я не делал.
Где ломается: что Google называет сама
Самое полезное в карточке модели – список ограничений, который разработчик приводит сам. Границы лучше официального признания не покажет никакой тест. Google готова признать следующее:
-
мелкий текст размывается, особенно на разрешении 1K;
-
длинные абзацы и текст во всю страницу даются нестабильно;
-
облик персонажа не всегда совпадает с референсом;
-
редактирование по маске иногда выполняет только часть инструкции и сохраняет исходную позу;
-
модель путает лево и право;
-
ограничены знания о мире, трёхмерные рассуждения и распознавание фактов;
-
возможны галлюцинации, а также периодические замедления и таймауты.
Первые три пункта совпали с тем, что я видел своими глазами: нечитаемый шеврон – это мелкий текст, а «онлайн» и заголовок – та же область, где модель достраивает контекст вместо того, чтобы следовать заданию. Четвёртый, про маску, стоит держать в голове: это самая интересная функция 2.1 и единственная, до которой у меня не дошли руки.
Что этот тест не показывает
-
Скорость. Время генерации не замерял, поэтому ничего о ней не утверждаю.
-
Трёхкратный рост точности инфографики. Одна схема из восьми элементов – слишком простой случай, чтобы разрыв 0,179 против 0,521 проявился.
-
Редактирование по маске и многократные правки. А это как раз то, что 2.1 заявляет главным улучшением.
-
Работу с референсными изображениями и лимит в 14 картинок. Не проверял вообще.
-
Воспроизводимость. Один прогон на задачу не отделяет свойство модели от случайности [2]. Текст в кадре у генеративных моделей ломается как повезёт: три прогона одной задачи могли бы дать другую картину.
-
Уровни рассуждения. Разницу между minimal, medium и high я не измерял, хотя именно medium теперь стоит по умолчанию и мог повлиять на результат.
Попробовать на одной задаче
Все три промпта выше можно прогнать самому. Обе версии, Nano Banana 2 и Nano Banana 2.1, есть в SYNTX.AI [3] наравне с остальной линейкой, и одно и то же задание уходит им подряд, без переписывания под каждую. Для читателей Хабра работает промокод CTRLAI: скидка 20% на любой тариф.
Автор: syntxaiofficial
Источник [4]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36690
URLs in this post:
[1] памяти: http://www.braintools.ru/article/4140
[2] случайности: http://www.braintools.ru/article/6560
[3] SYNTX.AI: https://syntx.ai/ru/
[4] Источник: https://habr.com/ru/companies/syntx_ai/articles/1091964/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1091964
Нажмите здесь для печати.