Локальный запуск Qwen-Image-2.1 без safety checker: тест на MacBook Air с 16 ГБ памяти
Команда Qwen из Alibaba выпустила Qwen-Image-2.1 — модель для генерации и редактирования изображений на базе diffusion transformer с 7 млрд параметров, поддержкой нативного вывода до 2K и лицензией Qwen Research License.
Она умеет генерировать изображения по текстовому описанию, редактировать их с использованием до десяти референсов и заметно лучше многих открытых альтернатив работает с китайским текстом. В сообществе доступны сборки без встроенного content filter: промпты, веса модели и результаты генерации при локальном запуске остаются на компьютере пользователя.
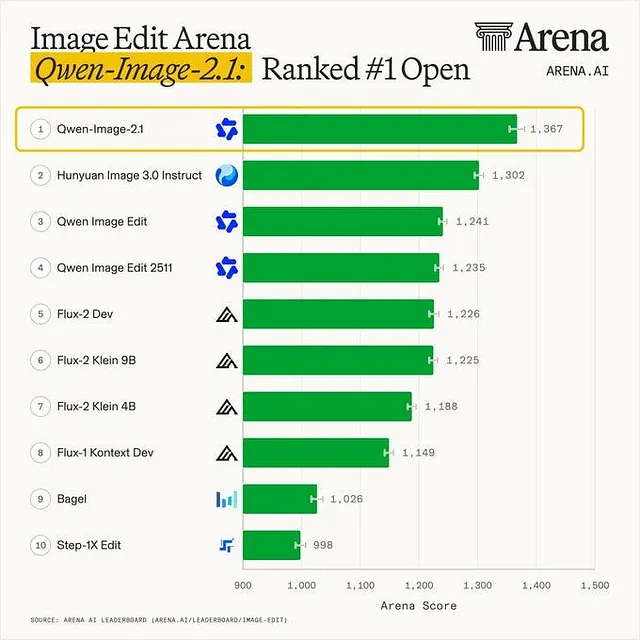
Я развернул Qwen-Image-2.1 на MacBook Air с Apple M4 и 16 ГБ unified memory. Ниже три варианта запуска, требования к памяти [1] и результаты тестов на машине, которую сложно назвать специализированной рабочей станцией для генеративных моделей.
Зачем вообще запускать модель локально
Три основные причины: приватность, стоимость и контроль над окружением.
При работе с облачными API промпты отправляются на внешнюю инфраструктуру. Для клиентских материалов, еще не выпущенных продуктов и внутренних концептов это может быть нежелательно. Локальный inference оставляет весь pipeline на собственном устройстве.
Вариант abenzerps/Qwen-Image-2.1-Uncensored-GGUF [2] поставляется без safety checker (цензуры), поэтому итог зависит от промпта и самой модели, а генерация не требует отправки данных во внешний сервис.
Вторая причина — стоимость. На Apple Silicon генерация одного изображения 1024 × 1024 требует лишь электроэнергии. Если за проект нужно получить сотни изображений, количество запусков само по себе не создает отдельного API-счета.
Третья причина — воспроизводимость. Можно зафиксировать seed, версию модели и окружение и не зависеть от того, что облачный провайдер изменит API или модель во время работы над проектом.
Лицензия. Для Qwen-Image-2.1 используется Qwen Research License [3], которая ограничивает коммерческое использование и ориентирована на исследования и оценку модели. Если нужны коммерческие права, предыдущая Qwen-Image-2512 [4] остается под Apache 2.0. Ещё один вариант — отдельно получить коммерческую лицензию у Alibaba.
Три способа запуска
Вариант 1. GGUF и ComfyUI
Формат GGUF можно использовать на Windows, Linux и macOS через ComfyUI [5] вместе с плагином ComfyUI-GGUF [6].
Готовая сборка abenzerps/Qwen-Image-2.1-Uncensored-GGUF [2] содержит необходимые компоненты модели.
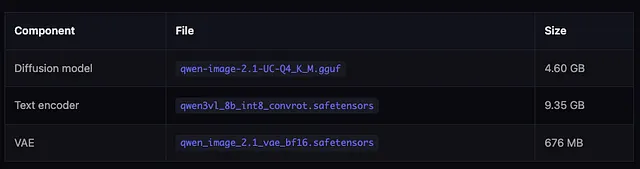
Файлы нужно распределить по соответствующим каталогам ComfyUI:
models/diffusion_models
models/text_encoders
models/vae
Для diffusion model используется узел
Unet Loader (GGUF)Для текстового энкодера — стандартный CLIPLoader с типом qwen_image
Для VAE — VAELoader.
Официальные workflow templates от Comfy-Org [7] можно использовать практически без изменений, заменив соответствующий узел загрузки модели. Для систем с ограниченным объемом VRAM имеет смысл держать GGUF diffusion model в памяти GPU, а text encoder выгружать в системную RAM.
Text encoder используется один раз на каждый prompt, поэтому такое разделение позволяет освободить примерно 9–17 ГБ VRAM без потери скорости непосредственно во время diffusion-итераций.
Если на GPU с 16 ГБ все равно возникает дефицит памяти, ComfyUI можно запускать с:
--lowvramВариант 2. MLX для Apple Silicon
У Apple Silicon другая архитектура памяти: CPU и GPU используют общий пул unified memory. Для Mac поэтому интереснее нативный MLX-вариант.
JoyFusionAI/Qwen-Image-2.1-MLX-4bit [8] содержит Qwen-Image-2.1, преобразованную в формат MLX и квантизованную до 4 бит.
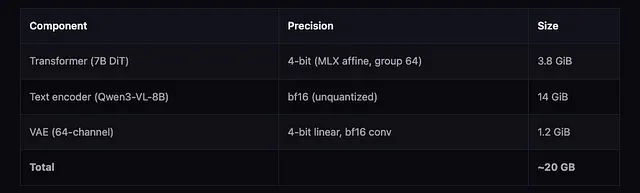
Для запуска требуется MFLUX [9] версии 0.20.0 или новее с поддержкой Qwen-Image-2.1, начиная с commit 8c00dab2.
Обновить MFLUX можно командой:
uv tool install --upgrade mfluxИ запустить
mflux-generate-qwen-2.1
  --model JoyFusionAI/Qwen-Image-2.1-MLX-4bit
  --base-model qwen-image-2.1
  --prompt "A red fox in a snowy forest holding a wooden sign that says 'Hello'"
  --steps 40 --low-ram
Для машин с небольшим объемом памяти нужен режим:
--low-ramОн освобождает text encoder после завершения кодирования prompt и использует tiled VAE decode.
Разница получается существенной. На M1 Max при генерации 768 × 768 обычный режим достигает примерно 33–36 ГБ пиковой памяти. С --low-ram значение снижается примерно до 7 ГБ.
На Mac с 16 ГБ памяти этот флаг фактически обязателен.
Вариант 3. Distilled-модели для ускорения
Если стандартные 40 steps слишком медленные, есть distilled-варианты, которым достаточно 4-8 шагов:
Viggle/Qwen-Image-2.1-viggle-turbo
Qwen-Image-2.1-viggle-turbo [10] генерирует изображение за 4 шага и использует Distribution Matching Distillation.
Доступны два варианта:
-
полный transformer размером около 14,2 ГБ;
-
LoRA-адаптер размером около 340 МБ.
Для работы требуется CFG = 1.0 и специальный scheduler.
Цена ускорения — снижение качества в более сложных задачах, особенно при редактировании и композиции с несколькими референсами.
Tongyi-MAI/Z-Image-Turbo
Z-Image-Turbo [11] — 6B-модель от Tongyi Lab, рассчитанная на генерацию примерно за 8 шагов.
Для нее заявляется работа на потребительских видеокартах с 16 ГБ VRAM. Модель распространяется под Apache 2.0. Согласно Elo-рейтингу Layer, ее результаты в blind tests сопоставимы с FLUX.2 Dev или превосходят его.
Тест на MacBook Air с 16 ГБ
Конфигурация тестовой машины: MacBook Air, Apple M4, 10-core CPU, 16GB unified memory, macOS 26.6.2.
Для запуска использовались: MFLUX 0.20.0 и Python 3.13.15.
Загрузка модели через huggingface-cli потребовала примерно 16 ГБ.
Полный репозиторий вместе с Git LFS cache занял около 38 ГБ. При этом LFS cache содержит локальную резервную копию загруженных объектов, поэтому реальный рабочий объем ближе к 20 ГБ.
Первый тест был минимальным:
512 × 512, 4 steps
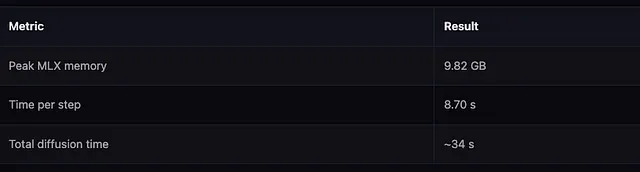
Модель загрузилась, MLX задействовал Apple GPU, изображение было успешно сгенерировано. То есть сам факт запуска на 16-гигабайтной машине подтвердился.
Следующим тестом стала генерация:
1024 × 1024, 20 steps, детализированный промпт
An orange cat sitting beside a traditional Chinese wooden window, with a rainy Jiangnan water town visible outside. Warm lantern light reflects on the wet stone pavement. Realistic fur texture, natural lighting, shallow depth of field, photographic style.
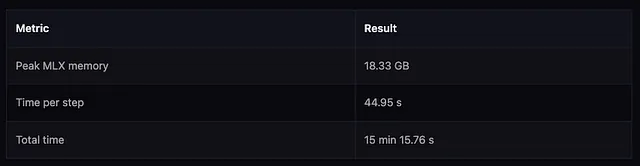
Как 16-гигабайтная машина показала peak memory 18,33 ГБ
Самое интересное значение в тесте — 18,33 ГБ peak MLX memory.
Физически в MacBook при этом установлено только 16 ГБ unified memory. Противоречия здесь нет. MLX показывает максимальный объем памяти, выделенный во время генерации, а не только объем физической RAM, которую в конкретный момент эксклюзивно занимает GPU.
В процессе задействованы:
-
unified memory;
-
virtual memory macOS;
-
compressed memory;
-
swap на SSD.
На традиционной системе с дискретной видеокартой RAM и VRAM физически разделены. Если модель перестает помещаться в видеопамять, приходится перемещать данные между памятью CPU и GPU либо использовать CPU fallback.
Apple Silicon использует общий пул памяти. GPU может обращаться к unified memory без передачи данных через PCIe между двумя отдельными физическими пулами. Когда давление на память становится слишком высоким, macOS может сжимать страницы и выгружать часть из них на SSD.
Работает это не бесплатно.
При пике в 18,33 ГБ система уже находилась под существенным memory pressure и активно использовала paging. На тесте 1024 × 1024 один шаг занимал примерно 44,95 секунды.
Интерактивным такой режим назвать сложно. Это скорее batch-сценарий: поставить несколько задач в очередь, оставить компьютер работать и вернуться позже.
Разница с --low-ram хорошо показывает, почему режим так важен.
На M1 Max при 768 × 768:
-
обычный режим: 33-36 ГБ
-
–low-ram: около 7 ГБ
Снижение достигается за счет выгрузки text encoder после обработки prompt и tiled VAE decode. Для Mac с 16 ГБ это разница между постоянным swap и значительно более комфортной работой.
Что получилось сгенерировать
Китайский промпт дал ожидаемую композицию: рыжий кот у деревянного окна, за ним дождливый водный город Цзяннань, мокрая каменная мостовая и отражающийся свет фонарей.
Модель отработала и визуальные требования:
-
реалистичную шерсть;
-
деревянную фактуру;
-
отражения на мокрой поверхности;
-
естественное освещение;
-
небольшую глубину резкости.
При внимательном рассмотрении появились ограничения.
Локально повторялись участки текстуры шерсти. Архитектура на заднем плане при увеличении выглядела менее структурно точной. Текст на дальних вывесках не получился читаемым. Для 4-битной локальной версии такой результат ожидаем, но при задачах, где типографика имеет большое значение, это нужно учитывать.
Для иллюстраций к статьям, концептов и черновиков качество уже можно использовать непосредственно. Если речь идет о production-типографике или коммерческих product shots, результат лучше предварительно проверять на конкретных задачах.
Редактирование с использованием до десяти reference images на 16-гигабайтном Mac я не тестировал.
По сообщениям пользователей с RTX 4060 Ti 16GB, редактирование с INT8-квантизацией запускается примерно при 15 ГБ VRAM, хотя генерация одного изображения может занимать несколько минут.
Скорость против качества
Базовый режим ориентирован примерно на 40 steps.
Distilled-модели уменьшают их количество до 4-8, но за это приходится платить качеством.
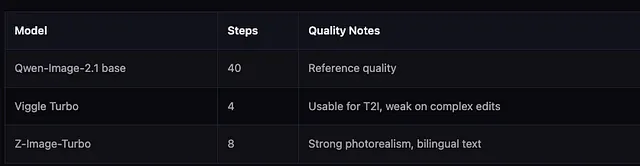
Документация Viggle/Qwen-Image-2.1-viggle-turbo [10] прямо указывает, что preview-версия v0.1 уступает основной модели в:
-
multi-reference composition;
-
face swap;
-
identity-preserving editing.
Для обычного text-to-image четыре шага уже дают пригодный результат. Для более серьезного редактирования разумнее оставаться на базовых 40 steps либо отдельно тестировать 8-step Z-Image-Turbo.
Для Z-Image-Turbo [11] заявляются Elo-результаты, конкурентоспособные с закрытыми моделями. Отдельный плюс — лицензия Apache 2.0, в отличие от research-license Qwen-Image-2.1.
Какую конфигурацию выбирать
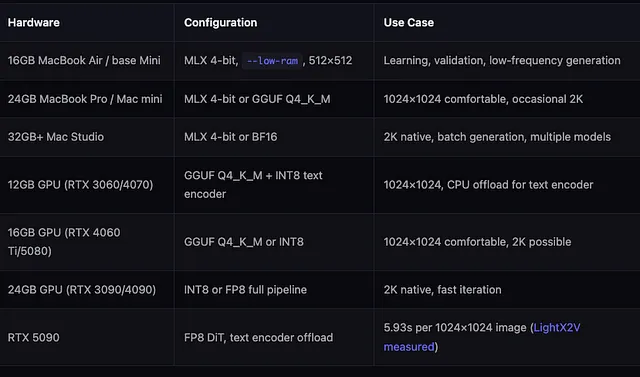
MacBook Air с 16 ГБ показывает прежде всего нижнюю границу входа: модель можно запустить на такой машине, однако это не означает, что именно такая конфигурация оптимальна.
Если задача — проверить пайплайн, получить несколько изображений, поэкспериментировать с промптом или настроить локальную генерацию без облака, Apple Silicon с 16 ГБ уже пригоден.
Если же важны высокая скорость, большие разрешения, серия из сотен изображений или сложное редактирование с несколькими референсами, ограничения становятся заметны очень быстро.
GGUF + ComfyUI удобнее для Windows/Linux и дискретных GPU.
MLX — естественный выбор для Apple Silicon.
Turbo-сборки подходят, если количество steps важнее максимально возможного качества.
Если не хотите или не можете запустить модель локально, попробуйте Qwen [12] прямо у себя в браузере за пару кликов.
Автор: Qwertcoser
Источник [13]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36896
URLs in this post:
[1] памяти: http://www.braintools.ru/article/4140
[2] abenzerps/Qwen-Image-2.1-Uncensored-GGUF: https://huggingface.co/abenzerps/Qwen-Image-2.1-Uncensored-GGUF
[3] Qwen Research License: https://huggingface.co/Qwen/Qwen-Image-2.1
[4] Qwen-Image-2512: https://huggingface.co/Qwen/Qwen-Image-2512
[5] ComfyUI: https://github.com/comfyanonymous/ComfyUI
[6] ComfyUI-GGUF: https://github.com/leejet/ComfyUI-GGUF
[7] workflow templates от Comfy-Org: https://comfy.org/workflows/5fbe136ba6f9-5fbe136ba6f9/
[8] JoyFusionAI/Qwen-Image-2.1-MLX-4bit: https://huggingface.co/JoyFusionAI/Qwen-Image-2.1-MLX-4bit
[9] MFLUX: https://github.com/mflux-community/mflux
[10] Qwen-Image-2.1-viggle-turbo: https://huggingface.co/Viggle/Qwen-Image-2.1-viggle-turbo
[11] Z-Image-Turbo: https://huggingface.co/Tongyi-MAI/Z-Image-Turbo
[12] Qwen: https://umaai.site/image
[13] Источник: https://habr.com/ru/articles/1093810/?utm_campaign=1093810&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.