Как писать текст для нейросети, чтобы она сослалась на сайт: в 60 ответах она чаще брала абзацы от 30 слов
Допустим, вы ведёте документацию или блог и хотите, чтобы куски текста попадали в ответы ChatGPT, Perplexity или Алисы AI. Я проверил на ответах Perplexity простой совет — не начинать абзац с «это», «он» или «поэтому». Такие начала одинаково редки у абзацев, которые нейросеть взяла, и у тех, что пропустила.
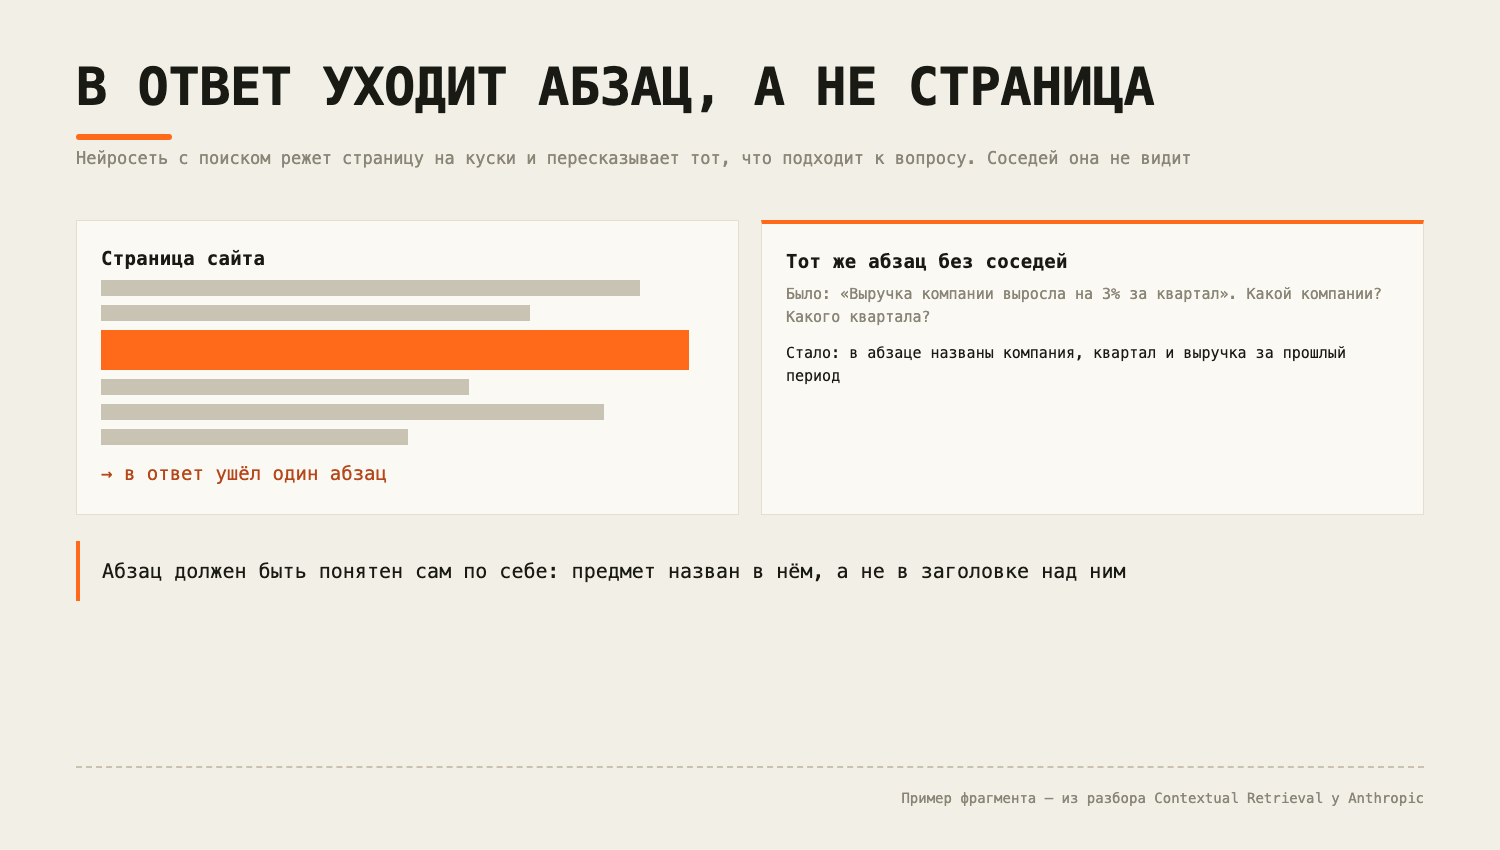
Заметно отличается другое: взятые абзацы длиннее. Совет появился потому, что нейросеть с поиском берёт со страницы не всю статью, а один-два абзаца, и они должны быть понятны без соседей. Но если чистить только «это», можно потратить вечер на правку и не изменить ничего.
Как нейросеть, которая ищет ответ в интернете, выбирает абзац со страницы сайта
Ahrefs [1] пишет, что поисковые ИИ могут резать страницу на фрагменты, доставать самые подходящие к запросу и цитировать только те, что подтверждают ответ. Отсюда совет: главные факты должны оставаться понятными, если их вырвать из текста, а каждый раздел должен вводить и закрывать одну мысль. Bing [2] говорит почти то же: ассистент не читает страницу сверху вниз, он режет её на небольшие куски и ранжирует их, поэтому стены текста мешают.
Как выглядит кусок без контекста, хорошо видно у Anthropic [3]. Фраза «Выручка компании выросла на 3% за квартал» сама по себе не говорит, о какой компании и каком квартале речь. В исправленной версии в тот же фрагмент дописаны название компании, квартал и выручка за прошлый период.
Из этих советов я вывел четыре признака, которые проверяются кодом. Первый — абзац начинается со слова-отсылки к предыдущему тексту: «это», «он», «поэтому», «при этом». Второй — в абзаце есть число. Третий — предмет назван словом в самом абзаце, а не только в заголовке над ним. Четвёртый — длина от 30 до 80 слов. Это окно я выбрал сам: Ahrefs конкретной длины не называет, Bing просит только не писать стен текста. Я читал руководства по GEO-оптимизации (generative engine optimization, подготовке сайта к ответам нейросетей): советов там много, а сравнения со страницами, которые нейросеть реально цитирует, нет.
Чем абзацы, которые поисковая нейросеть Perplexity пересказала в ответах, отличаются от пропущенных
Я взял 60 ответов Perplexity с включённым поиском и скачал страницы, на которые они ссылаются. Каждую страницу разрезал на абзацы по тегам, заголовки и куски короче 10 слов выбросил. Взятым считал абзац, в котором нашлось не меньше половины слов из предложения ответа со ссылкой на эту страницу (из таких — самый похожий). Получилось 113 взятых абзацев на 79 страницах, остальные 4390 абзацев тех же страниц пошли в группу невзятых. Для масштаба: в моём прошлом разборе медианная страница отдавала в ответ 2 абзаца из 85.
|
Признак |
Взятые, все |
Невзятые, все |
Взятые, 30–80 слов |
Невзятые, 30–80 слов |
|
Начало со слова-отсылки |
2,7% (3 из 113) |
3,6% (157 из 4390) |
4,1% |
4,5% |
|
Есть число |
36% |
27% |
36% |
33% |
|
Предмет назван внутри |
80% |
58% |
85% |
76% |
|
Длина 30–80 слов |
65% |
34% |
— |
— |
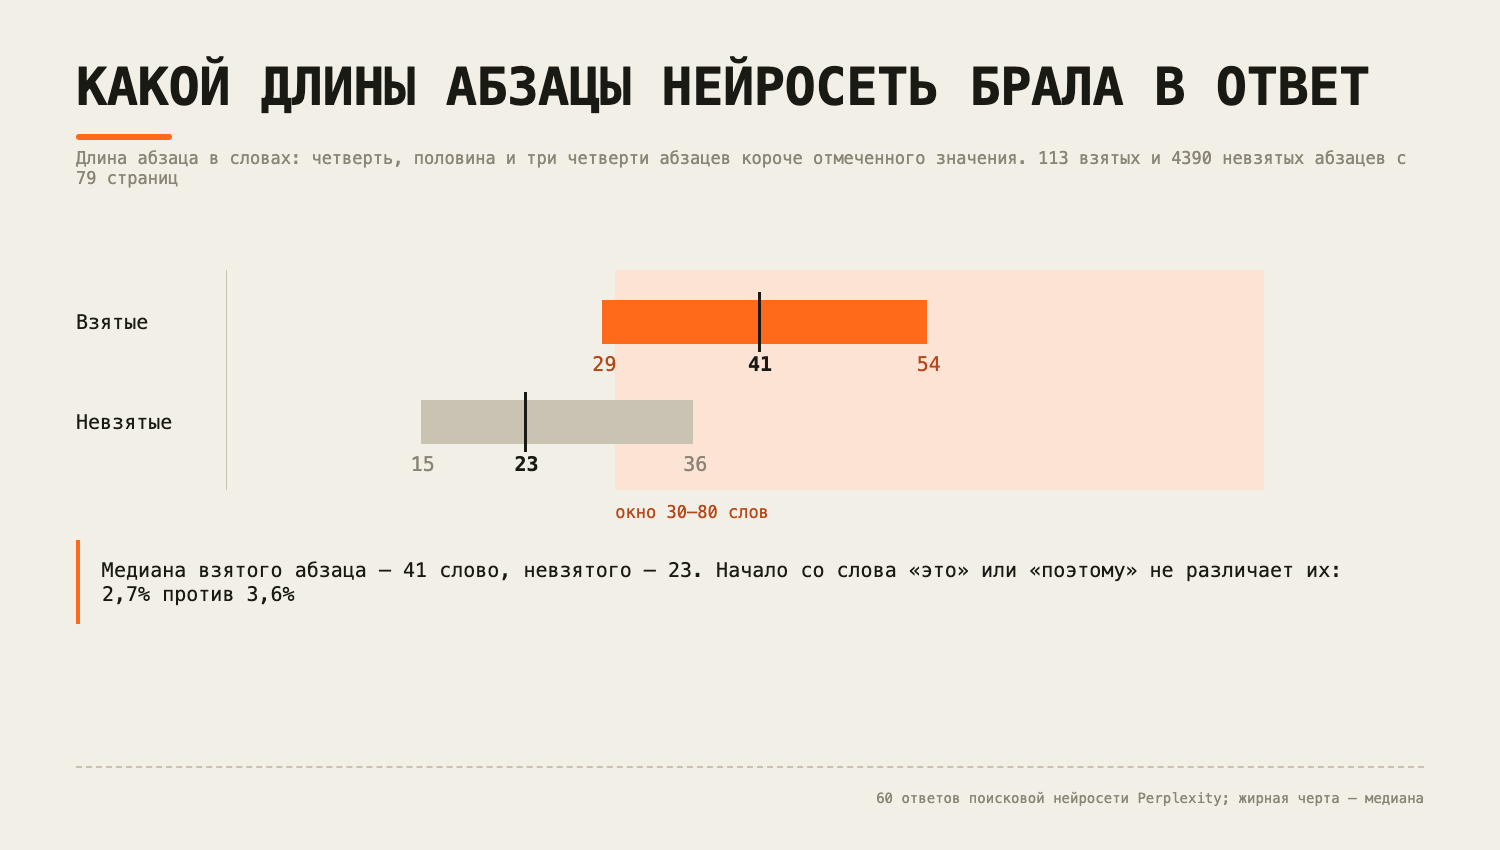
Слово-отсылка в начале ничего не различает. Три взятых абзаца даже начинались с «Поэтому», «При этом» и «Однако», и Perplexity это не помешало.
Длина различает. Медиана взятого абзаца — 41 слово, невзятого — 23. Три четверти взятых абзацев длиннее 29 слов, а три четверти невзятых короче 36.
Число и предмет в первых двух столбцах тоже выглядят полезными, но там их раздувает длина. В длинном абзаце больше слов, и в нём просто чаще встречаются цифра и слово из заголовка. Поэтому я отдельно сравнил только абзацы от 30 до 80 слов: 73 взятых против 1481 невзятого. Разрыв по числу сжался до 3 процентных пунктов, по предмету — до 9. На такой выборке это не доказано, хотя предмет внутри абзаца у взятых всё же встречается чаще.
Как проверить скриптом на Python, готов ли абзац попасть в ответы нейросетей
Если вы решаете, как попасть в ответы нейросетей, по этим данным выходит такой порядок. Первым делом найти короткие абзацы-обрывки на 10–20 слов и склеить их с соседями в законченную мысль. Предмет называть словом, а не местоимением: среди абзацев на 30–80 слов у взятых он встречается чаще, хотя на такой выборке разница не доказана. Слова «это» и «поэтому» в начале абзаца из-за совета чистить не нужно.
Проверять свою страницу удобнее скриптом. Он читает Markdown, пропускает заголовки, таблицы и код и ставит каждому абзацу четыре метки:
import re, sys

LINK = re.compile(r"^(?:этоw*|эт(?:от|а|и|им|ого|ой|их|ому|у|ими)|он|она|они|оно|"
    r"так(?:ой|ая|ое|ие)?|также|при этом|поэтому|однако|кроме того|здесь|там|тогда)b", re.I)

def marks(par, subject):
    t = re.sub(r'^[s"«“(-–—•d.)]+', "", par.lower().replace("ё", "е"))
    stem = subject.lower().replace("ё", "е")[:max(4, len(subject) - 2)]
    return {"длина": 30 <= len(par.split()) <= 80,
            "отсылка": bool(LINK.match(t)),
            "число": bool(re.search(r"d", par)),
            "предмет": stem in t}

text = re.sub(r"`{3}.*?`{3}", "", open(sys.argv[1], encoding="utf-8").read(), flags=re.S)
for par in text.split("nn"):
    par = re.sub(r"[([^]]*)]([^)]*)", r"1", par.strip())
    if not par or par.startswith(("#", "!", "*", "|")):
        continue
    m = marks(par, sys.argv[2])
    print(" ".join(k[:3] + ("+" if v else "-") for k, v in m.items()), "|", par[:50])
Запуск: python3 marks.py [4] статья.md [5] нейросеть, второй аргумент — главное слово страницы. Скрипт отрезает от него две последние буквы и так ловит падежи: по слову нейросеть он найдёт и нейросети, и нейросетью. На выходе строка на каждый абзац, например:
дли- отс- чис+ пре- | Длина различает. Медиана взятого абзаца — 41 словоПервым смотрю на метку длины с минусом. Такой абзац либо обрывок, и его стоит склеить с соседом, либо стена текста, и её стоит разрезать.
Вывод, что взятые абзацы длиннее, держится на 60 ответах одной нейросети
Ответы только от Perplexity, на одном наборе вопросов, и несколько абзацев приходят с одной страницы. Взятым абзац я признавал по совпадению слов, а в длинном совпасть проще, так что часть разницы дал мой способ. Но и внутри одних и тех же страниц взятые чаще попадают в окно 30–80 слов: +29 п.п., от +20 до +38. Это наблюдение, а не эксперимент: если переписать абзац под метки, попадание никто не обещает.
Автор: sburyi
Источник [6]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36978
URLs in this post:
[1] Ahrefs: https://ahrefs.com/blog/how-to-optimize-for-ai-search/
[2] Bing: https://about.ads.microsoft.com/en/blog/post/october-2025/optimizing-your-content-for-inclusion-in-ai-search-answers
[3] Anthropic: https://www.anthropic.com/news/contextual-retrieval
[4] marks.py: http://marks.py
[5] статья.md: http://%D1%81%D1%82%D0%B0%D1%82%D1%8C%D1%8F.md
[6] Источник: https://habr.com/ru/articles/1094484/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1094484
Нажмите здесь для печати.