От толмачей до локальных нейросетей: как я собрал приложение для перевода книг
На днях хотел прочитать книгу, но она была только на английском языке.
Всё бы ничего, только я не совсем дружу с английским.
Я человек простой, если вижу проблему, то стараюсь решить её, а не игнорировать. Так что решил прочитать книгу именно на русском языке.
За время изучения проблемы я нашёл два готовых пути, и оба мне не совсем подходят:
|
1. Живой переводчик |
Да, он переведёт нужную мне книгу, но на это уйдёт много времени и денег. |
|
2. Онлайн-переводчик |
Всё бы ничего, но файлы уходят на чужие серверы, назад приходит машинный перевод, сверху лимит на символы или на запросы, и текст приходится самому копировать, вставлять и переписывать. А что делать с чувствительными файлами, которые нельзя публиковать в сеть? |
Лучшим решением для меня стало создание собственного приложения для локального перевода файлов. За перевод отвечает нейросеть, специально обученная для этой задачи, а обработка текста происходит непосредственно на моём компьютере — без отправки содержимого документов на сторонние серверы. Это особенно удобно при работе с конфиденциальными материалами, хотя само по себе использование локальной модели не отменяет требований информационной безопасности и условий NDA.
В этой статье мы разберём, как книги переводили раньше, как их переводят сейчас и как я перевожу свою книгу у себя. Покажу и само приложение.
❯ Когда перевод был ручной работой
До появления компьютеров переводом полностью занимался человек. Переводчик читал оригинал, разбирался в значении слов и выражений, подбирал подходящие формулировки на другом языке, а затем кропотливо всё перепроверял до тех пор, пока не получит удовлетворительный результат.
Знать значения отдельных слов было недостаточно. Нужно учитывать грамматику, контекст, культурные отсылки и стиль автора. Одно и то же слово в разных местах могло иметь разные значения, а переведённая шутка или метафора часто теряла смысл.
В Средневековье работа осложнялась тем, что книги не только переводили, но и переписывали вручную. Сначала нужно было подготовить перевод, затем перенести его в новую рукопись. Этим занимались писцы, работавшие при церквях, соборах и монастырях.
В XI веке при Ярославе Мудром уже существовала организованная работа с книгами. Летопись рассказывает, что князь собрал писцов, которые переводили произведения с греческого на славянский язык и создавали новые рукописные экземпляры.
Иногда над одной книгой работала целая группа. Один человек переводил текст с греческого на латынь, другие передавали его на русский язык, а писцы готовили рукопись.
Получался небольшой производственный процесс:
|
1. Один человек разбирал оригинал. |
|
2. Другой переводил промежуточную версию. |
|
3. Писец переносил результат в рукопись. |
|
4. Текст проверяли и исправляли. |
К XVI-XVII векам переводчики были нужны уже не только церкви. В Посольском приказе они работали с дипломатическими письмами, договорами и другими государственными документами. Письменным переводом обычно занимались переводчики, а устным — толмачи.
Разбирать я начал не с карточек моделей, а с вопроса, который от них не зависит. Кто держит предыдущую страницу и куда девается файл. Ответ на него менялся, скорость тоже, а дыра посередине книги долго оставалась той же.
Как книгопечатание изменило перевод
Печатный станок не научился переводить текст, но сильно ускорил распространение готовых переводов. Рукописная книга существовала в нескольких экземплярах, каждый из которых приходилось создавать вручную. Печатное издание можно было выпустить значительно большим тиражом.
Одновременно развивались словари и глоссарии. Они помогали искать значения слов, сравнивать варианты перевода и сохранять одинаковую терминологию на протяжении всей книги.
Работа всё ещё оставалась ручной, но у переводчика появлялось больше инструментов. Ему уже не требовалось каждый раз искать значение редкого слова в других рукописях или обращаться к человеку, который знал нужный язык.
В последующие века общий процесс почти не менялся. Переводчик работал с оригиналом, словарями и справочниками, редактор проверял текст, а издательство готовило книгу к печати. Главным инструментом оставались знания человека.
❯ Первые идеи машинного перевода
Попытки механизировать перевод появились ещё до электронных компьютеров.
В 1933 году советский изобретатель Пётр Троянский предложил устройство [1] для автоматизированного поиска переводов. Предполагалось, что машина будет находить слова в многоязычном словаре и использовать специальные грамматические обозначения.
Полностью автоматическим такой процесс не был. Один специалист должен был подготовить исходный текст, машина находила соответствия, другой человек восстанавливал правильные формы слов, а редактор приводил результат в читаемый вид.
Настоящая компьютерная история машинного перевода началась после Второй мировой войны. В 1949 году американский математик Уоррен Уивер предложил использовать [2] для перевода электронные вычислительные машины. Он рассматривал язык как систему, закономерности которой можно анализировать математическими методами.
В 1954 году состоялся Джорджтаунский эксперимент. Компьютер IBM 701 перевёл с русского на английский несколько десятков заранее подготовленных предложений. Его словарь содержал около 250 слов, а обработка строилась на шести грамматических правилах.
Это был не универсальный переводчик, а демонстрация идеи. Система хорошо работала только с теми предложениями, словарём и правилами, которые для неё заранее подготовили.
Первые переводы на советских ЭВМ
В СССР исследования начались почти сразу после Джорджтаунского эксперимента. В конце 1955 года на машине БЭСМ провели первый эксперимент [3] по автоматическому переводу с английского языка на русский.
Для системы вручную подготовили словарь, правила анализа английского предложения и программу. Компьютер находил слова, определял их возможные формы и собирал русский вариант.
Параллельно другие группы разрабатывали алгоритмы перевода с французского, немецкого, китайского и ряда других языков. Уже тогда исследователи разделяли процесс на две части:
|
Первое: Анализ исходного предложения. |
|
Второе: Синтез предложения на русском языке. |
Первые результаты вызвали большой оптимизм. Казалось, что достаточно расширить словарь и добавить больше правил, после чего компьютер сможет переводить любые тексты.
Проблема оказалась сложнее. Естественный язык состоит не только из слов и грамматики. Значение зависит от контекста, темы, стиля и даже от информации, которая появилась несколькими абзацами ранее. Количество возможных исключений быстро росло, а ручная разработка правил требовала всё больше времени.
В 1966 году американский комитет ALPAC опубликовал критический отчёт о машинном переводе. Его авторы пришли к выводу, что качественный полностью автоматический перевод в ближайшее время маловероятен. После этого финансирование подобных исследований в США заметно сократилось.
Работы не прекратились, но ожидания стали реалистичнее. Исследователи начали думать не только о замене переводчика, но и о программах, которые могли бы ему помогать.
Компьютер как помощник переводчика
В 1980-х годах начали появляться [4] первые CAT-системы. Их название происходит от английского Computer-Assisted Translation, то есть «перевод с помощью компьютера».
Такие программы не переводили текст полностью самостоятельно. Они помогали переводчику работать со словарями, терминологическими базами и уже готовыми переводами.
Одним из главных инструментов стала память [5] переводов. В ней сохраняются пары из исходного предложения и подтверждённого перевода. Если похожий фрагмент встречается снова, программа предлагает готовый вариант.
Это хорошо работает с документацией, договорами, интерфейсами и инструкциями, где формулировки часто повторяются. В художественной литературе повторов меньше, а контекст важнее, поэтому роль человека остаётся значительной.
❯ Перевод по правилам
Первые полноценные программы машинного перевода строились на словарях и правилах. Такой подход называют Rule-Based Machine Translation, или RBMT.
|
|
|
– Части речи. |
|
– Формы слов. |
|
– Порядок слов в предложении. |
|
– Правила согласования. |
|
– Возможные значения слов. |
|
– Преобразования между языками. |
Программа разбирала предложение по этим правилам, искала слова в словаре и собирала перевод.
Преимуществом была управляемость. Если разработчик добавлял нужное правило или термин, система начинала применять его предсказуемым образом. Недостаток тоже понятен: естественный язык слишком велик и неоднозначен, чтобы полностью описать его вручную.
Одним из известных российских проектов стал PROMT. Компания появилась в 1991 году и разрабатывала системы машинного перевода для персональных компьютеров. В 1998 году был запущен Translate.ru, один из первых массовых российских онлайн-переводчиков.
❯ Статистика вместо правил
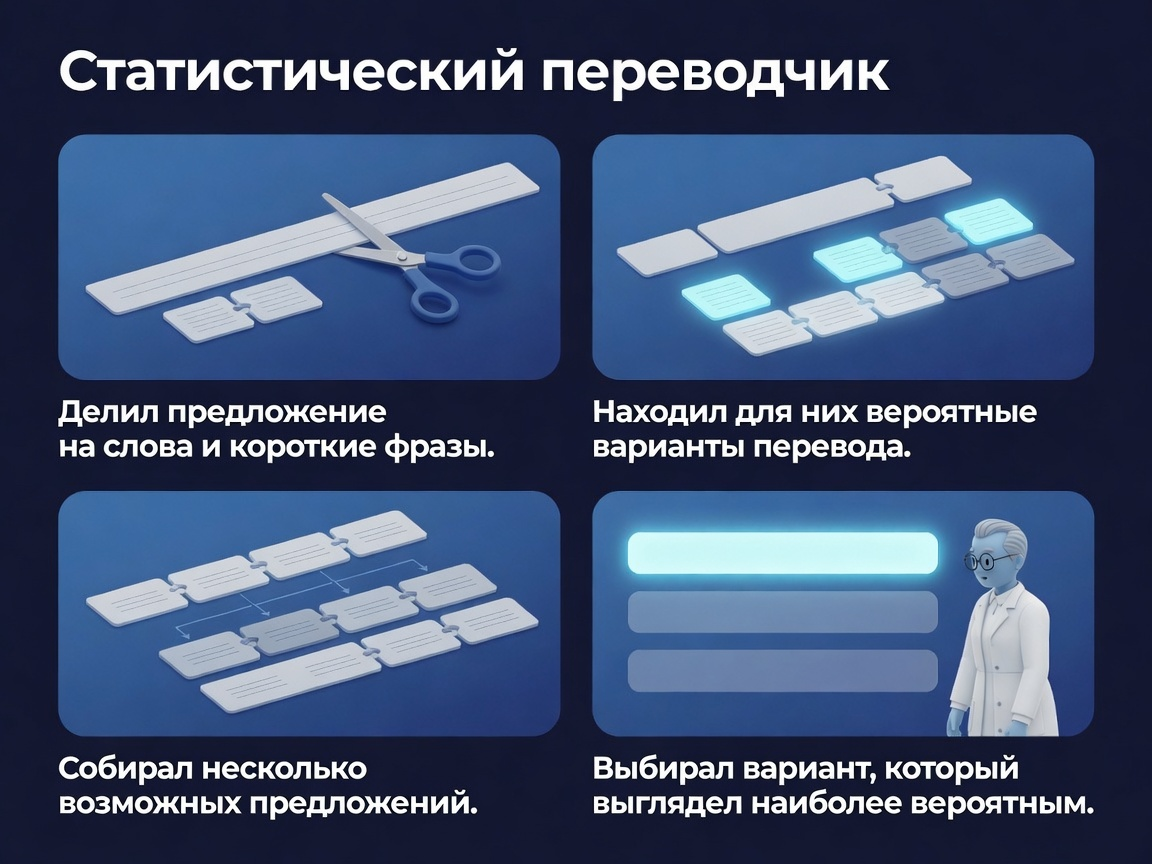
В статистическом машинном переводе систему обучали на параллельных корпусах. Такой корпус содержит оригинальные предложения и их человеческие переводы.
Алгоритм оценивал, какие слова и фразы соответствуют друг другу, а затем искал наиболее вероятный вариант перевода нового предложения. В развитых фразовых системах учитывались не только отдельные слова, но и короткие последовательности, порядок частей предложения и вероятность текста на целевом языке.
Разработчику больше не требовалось вручную описывать каждое окончание. Качество всё сильнее зависело от объёма и чистоты данных.
Статистический перевод мог звучать естественнее старых систем, но часто оставался фрагментарным. Отдельные части предложения выглядели правильно, а общий смысл или связь между ними терялись.
В 2000-х онлайн-переводчики сделали эту технологию массовой. Пользователь получал ответ за секунды, не устанавливая словари и языковые пакеты.
Вместе с удобством появился новый компромисс. Текст нужно было отправить на сервер владельца сервиса. Для открытой веб-страницы это обычно несущественно. Для закрытого документа место обработки становится частью архитектуры.
❯ Что изменили нейросети
Следующий большой скачок произошёл в 2010-х годах. Вместо отдельных словарей, правил и таблиц вероятностей исследователи начали обучать единую нейронную сеть преобразовывать текст с одного языка на другой.
Ранние нейросетевые переводчики использовали архитектуру encoder-decoder. Первая часть сети читала исходное предложение и строила его числовое представление. Вторая часть на основе этого представления создавала перевод.
В 2014 году механизм attention позволил модели при генерации каждого слова обращаться к нужным частям исходного предложения. Благодаря этому сеть лучше работала с длинными фразами и сложными связями между словами.
В 2017 году появилась архитектура Transformer. Она эффективнее работала с контекстом и лучше подходила для параллельных вычислений. Transformer стал основой большинства современных систем машинного перевода и больших языковых моделей.
Современная модель разбивает текст на токены, превращает их в числовые представления и определяет связи между частями исходного текста. Затем она последовательно генерирует перевод. Каждый новый токен выбирается с учётом оригинала и уже созданной части ответа.
В отличие от старых систем, разработчик не задаёт вручную правило для каждого окончания или порядка слов. Нейросеть извлекает языковые закономерности из обучающих данных.
Это не делает результат гарантированно правильным. Модель может выбрать неподходящее значение, пропустить часть предложения, изменить имя, добавить пояснение или слишком свободно пересказать исходник. Хорошо переведённая отдельная строка ещё не означает, что система сможет последовательно обработать книгу.
На этой общей архитектуре сегодня строятся разные классы моделей. Универсальные LLM обучаются решать широкий круг задач. Они отвечают на вопросы, пишут код, пересказывают, анализируют и переводят текст. Такая гибкость полезна при ручной работе. Модель можно попросить объяснить неоднозначную фразу, предложить несколько вариантов или изменить стиль перевода.
Но внутри автоматического конвейера универсальность может мешать. Перевод для такой модели остаётся одной задачей из многих, поэтому просьба «верни только перевод» не становится строгим контрактом. Иногда LLM добавляет комментарий, вступление, собственное форматирование или повторяет часть инструкции. При переводе одного абзаца это легко исправить. При обработке сотен фрагментов такие отклонения приходится обнаруживать программно.
Специализированные переводные модели решают более узкую задачу. Их обучают прежде всего преобразовывать текст между языками, соблюдать терминологию и сохранять структуру исходника. Они не обязаны уметь писать программу или поддерживать разговор, зато их поведение [6] в переводческом конвейере может быть более предсказуемым. Кроме того, среди таких моделей есть относительно компактные варианты, которые проще запускать локально.
Это не означает, что специализированная модель всегда переводит лучше универсальной LLM. Результат зависит от языковой пары, жанра, обучающих данных, размера модели, квантования и конкретного фрагмента. Универсальная модель может точнее передать литературный образ, а переводная — аккуратнее сохранить терминологию или структуру документа. Сравнивать нужно не классы моделей в целом, а конкретные версии в одинаковых условиях.
❯ Как появился DotLingo
Мне нужна была не новая нейросеть и не ещё один облачный сервис. Я просто хотел взять существующую модель, запустить её на своём компьютере и перевести книгу без лишних хлопот.
Для моей задачи были важны не только литературные способности. Модель должна была запускаться без внешнего API, помещаться в доступные RAM и VRAM, иметь готовый GGUF-файл для llama.cpp и принимать дополнительный контекст вместе с терминологией. Ещё мне нужен был достаточно предсказуемый ответ, который можно автоматически сохранить как очередной фрагмент перевода.
По этим причинам я начал искать не самую универсальную, а специализированную переводную модель. Так основным кандидатом стала Hy-MT2 [9] от Tencent Hunyuan.
Но выбор подходящей модели решал только часть задачи. Даже если она хорошо переводит отдельный абзац, она не умеет открыть EPUB, разделить книгу на фрагменты, сохранить очередь, вспомнить исправление пользователя и собрать новый документ. Эти операции должны выполняться вокруг модели.
Именно так, из простой задачи перевести книгу, появился DotLingo [8].
❯ Немного про сам проект
DotLingo — настольное приложение для перевода документов с помощью локальных GGUF-моделей. Новую нейросеть я не обучал. Программа использует существующие модели и организует их работу с целым документом.
Пользователь загружает книгу, выбирает языки и модель, после чего запускает перевод. Программа извлекает текст, делит его на фрагменты и по очереди передаёт их модели. Каждый готовый результат сразу сохраняется, поэтому обработку можно поставить на паузу и продолжить после перезапуска приложения.
Во время работы программа передаёт модели недавний контекст, чтобы соседние абзацы не выглядели изолированными. Исправления пользователя могут использоваться как примеры для следующих фрагментов, а глоссарий помогает сохранять выбранные варианты имён и терминов.
После завершения все переведённые части собираются в отдельный документ, а исходный файл остаётся без изменений.
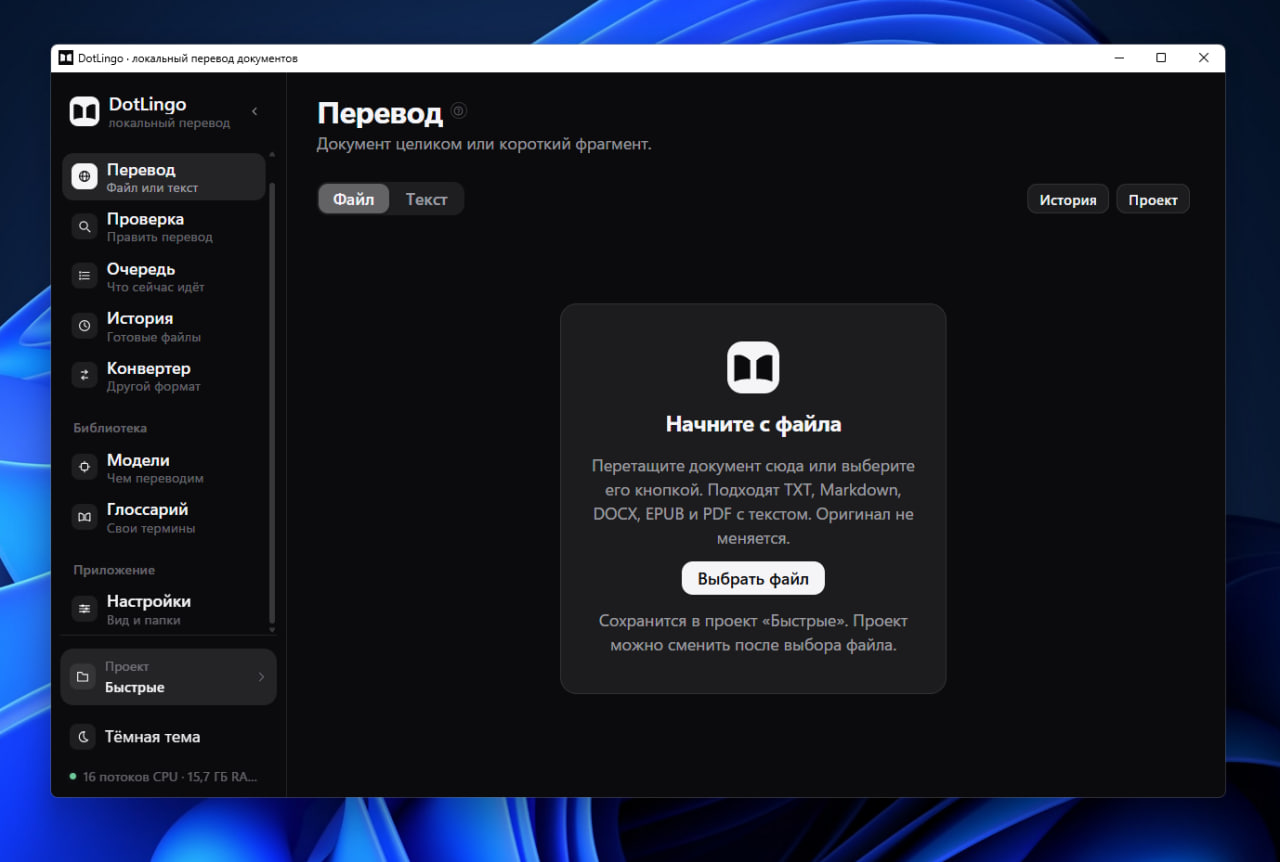
Сейчас приложение работает с TXT, Markdown, DOCX, EPUB и PDF. Для сканированных страниц используется локальное распознавание текста через Windows OCR.
❯ Как перевести книгу
Перевод максимально простой, достаточно просто выбрать файл и переместить его в приложение, после откроется окно перевода.
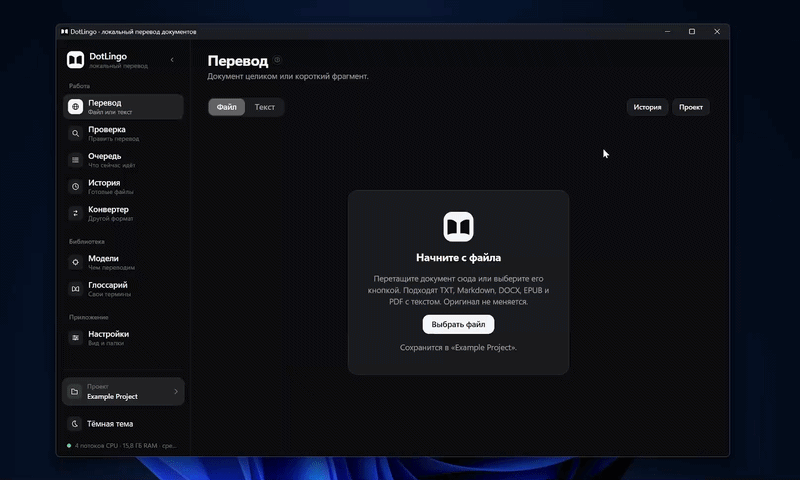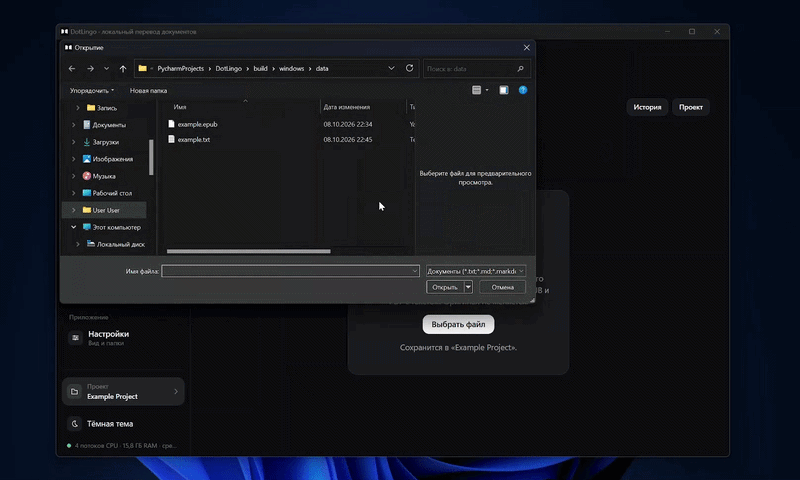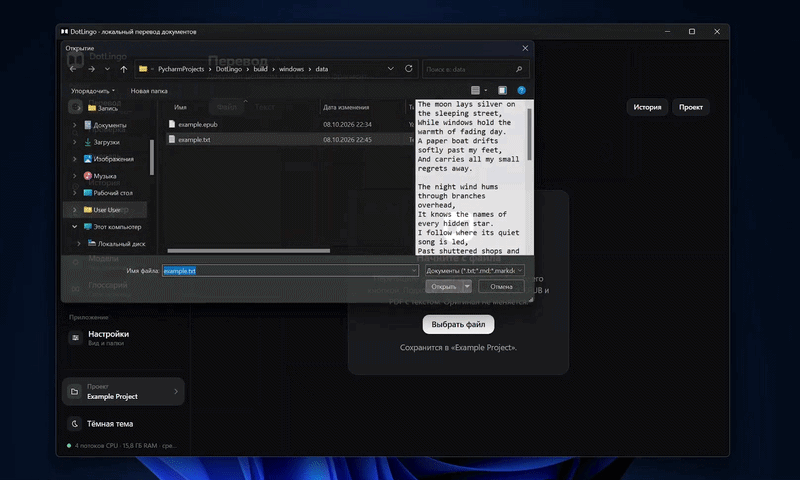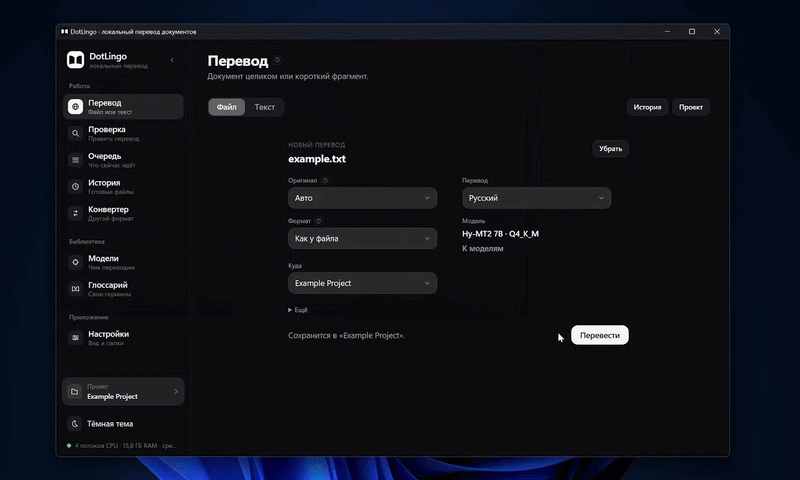
В этом окне настраивается перевод. Указываю язык оригинала, формат файла на выходе, путь, куда сохранить результат, язык перевода и модель. Если нужно, дописываю тон: предмет, имена, как к тексту обращаться.
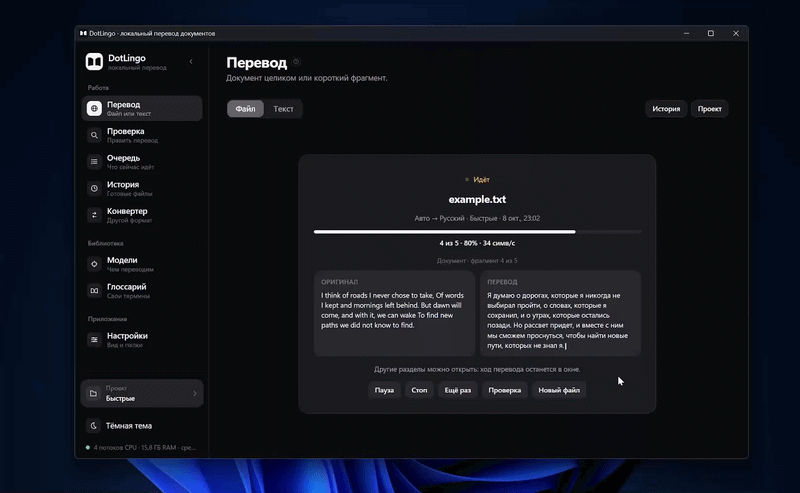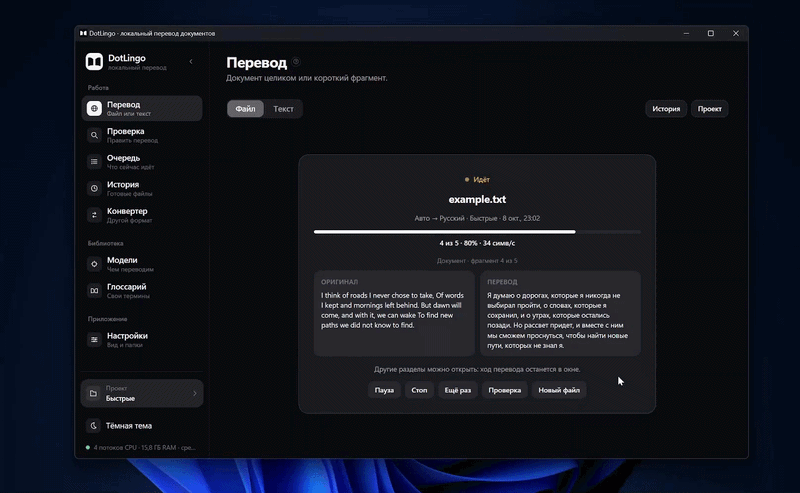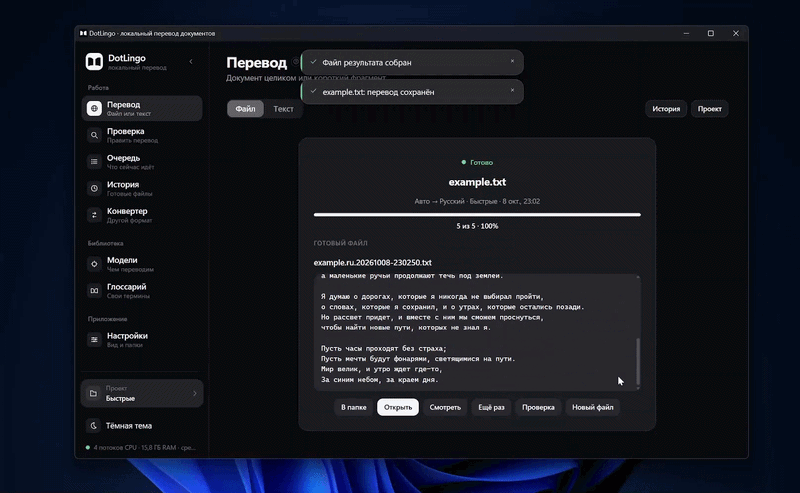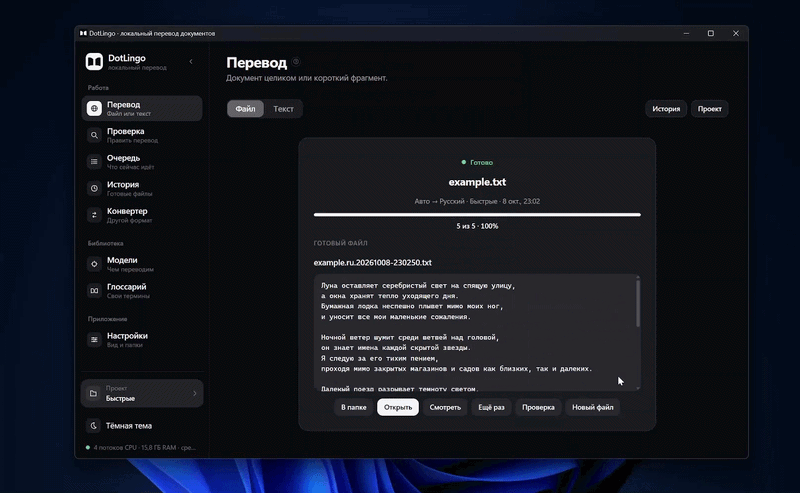
Дальше нажимаю «Перевести». Пока идёт работа, видны прогресс и уже переведённые фрагменты. Когда всё закончится, файл можно открыть и проверить.
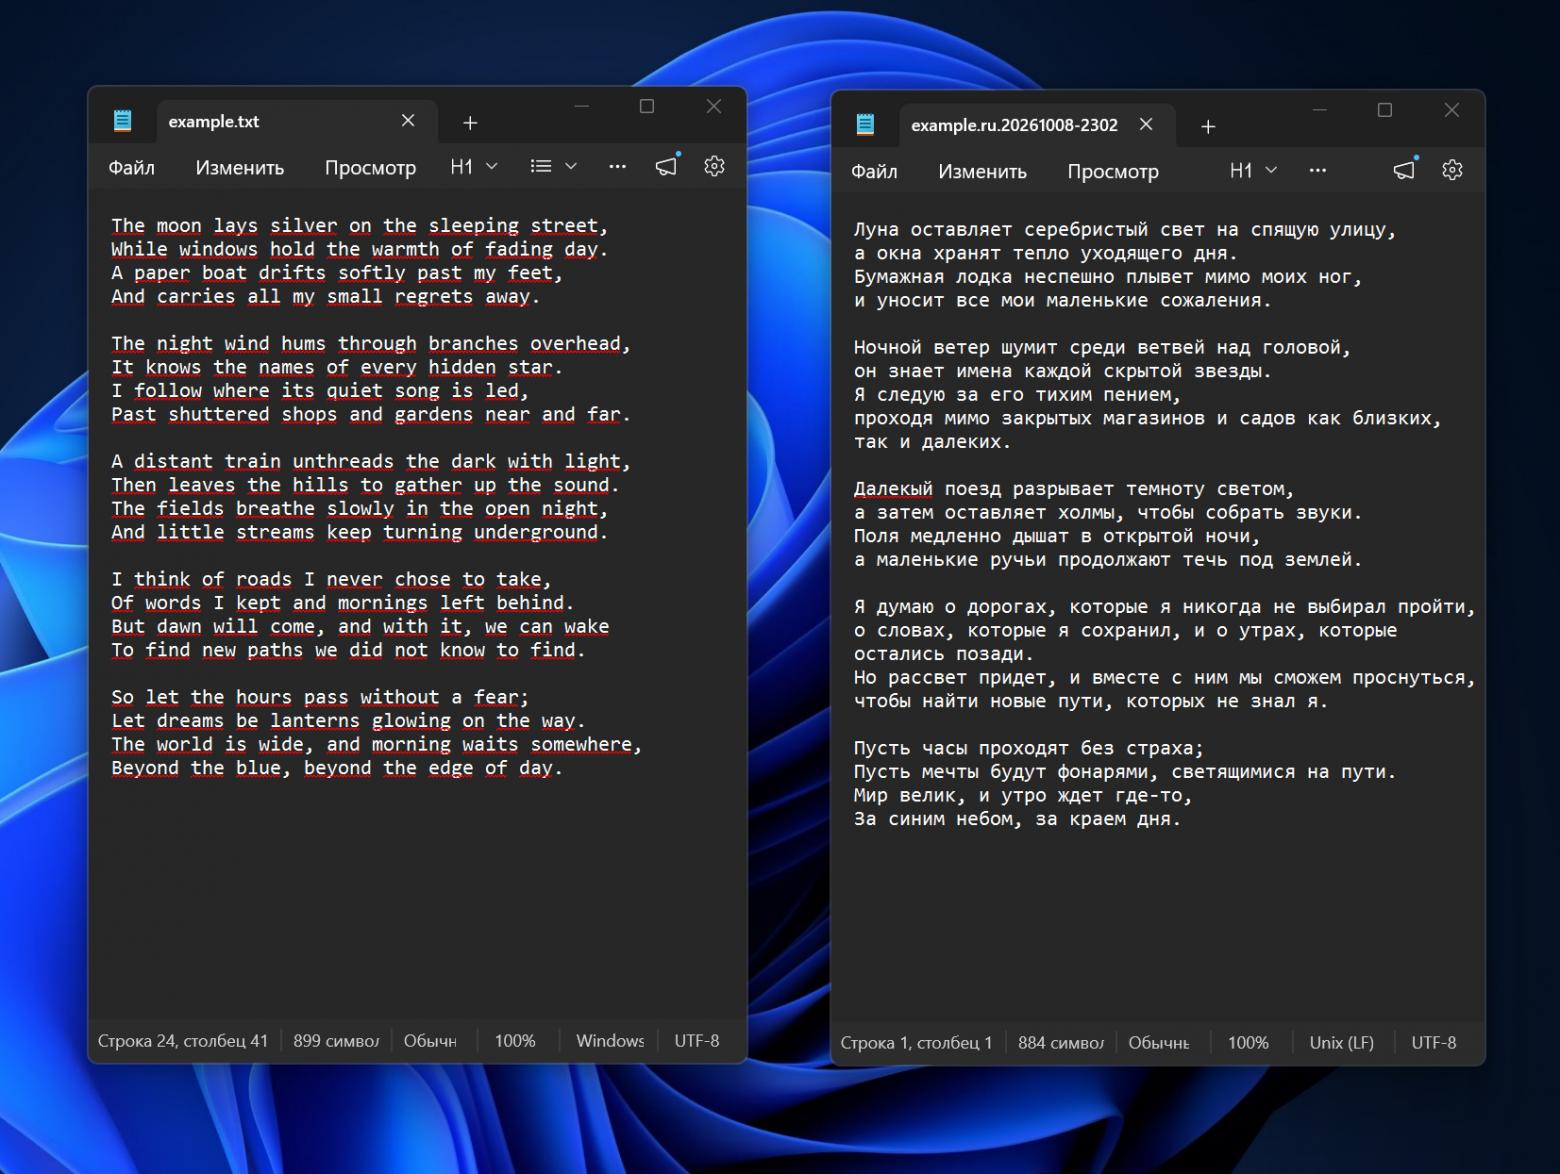
На фото оригинал и результат перевода из примера.
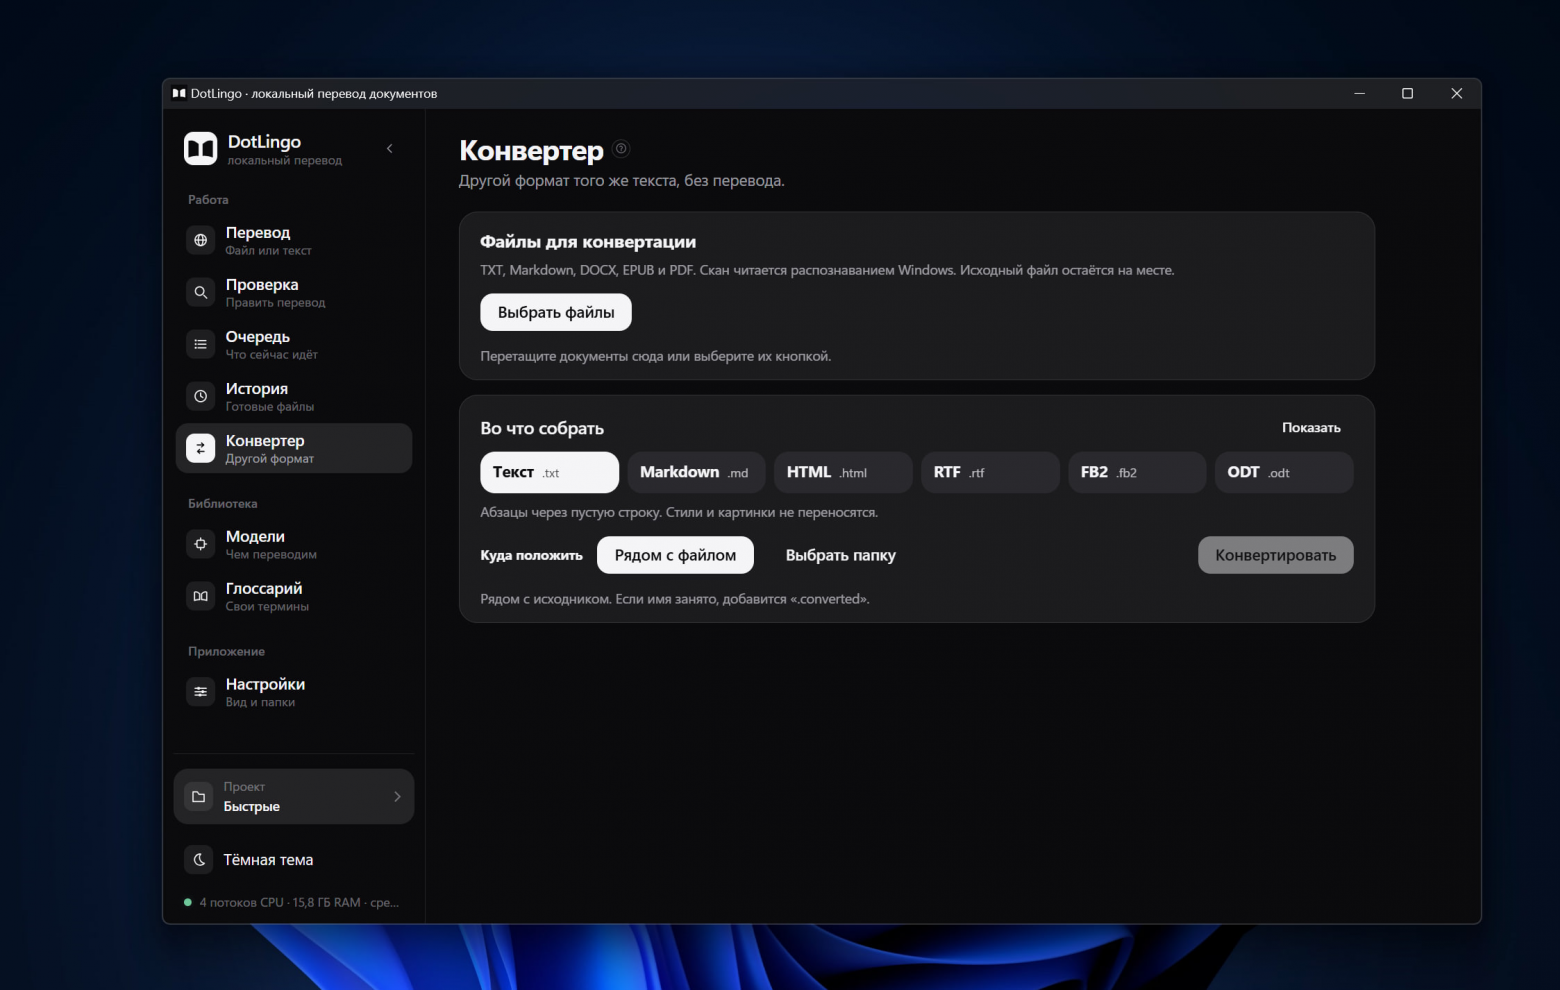
Кроме перевода есть конвертер. Он собирает тот же файл в другой формат, без модели.
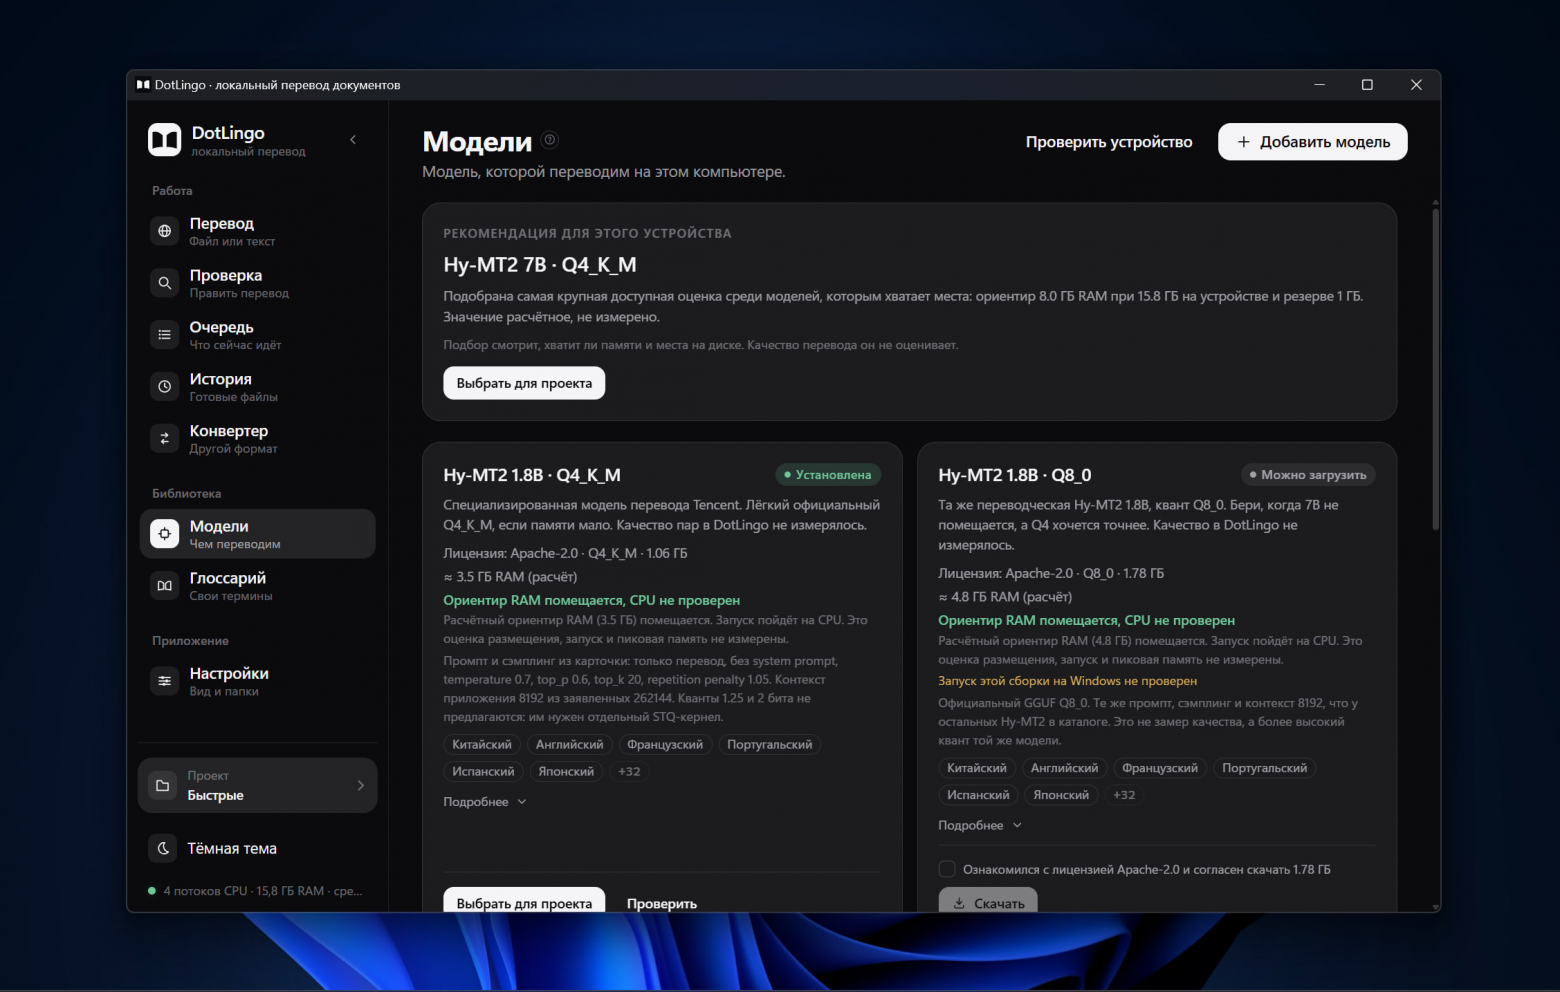
На вкладке «Модели» можно скачать готовую модель или добавить свою.
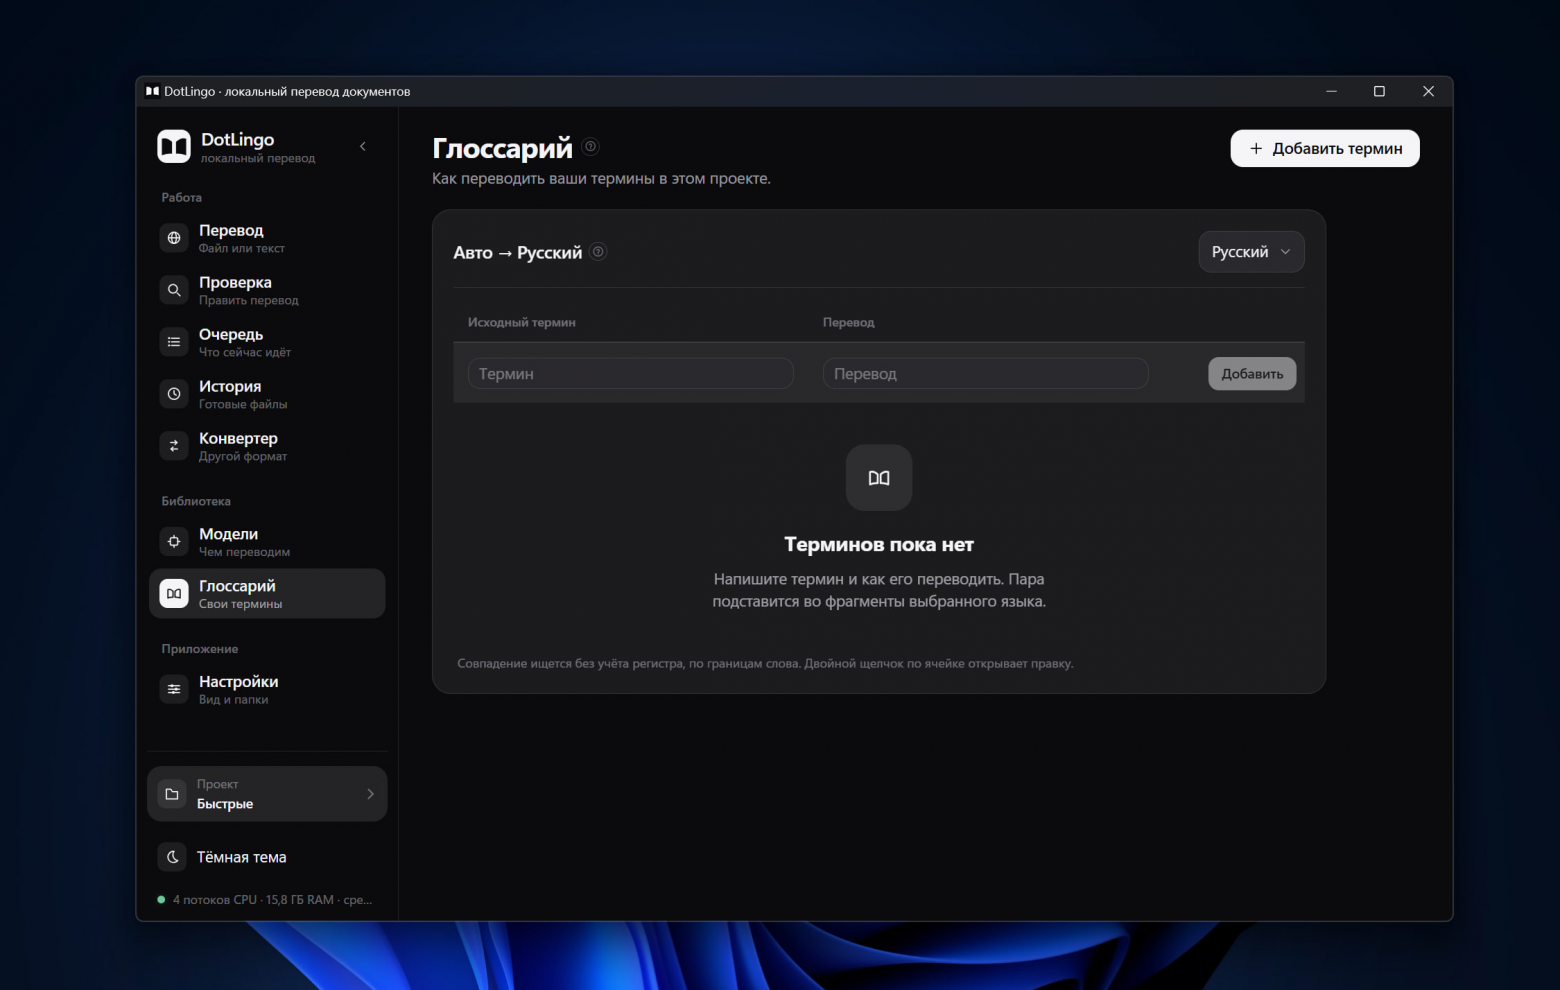
Глоссарий закрывает простую проблему: одно имя или термин по книге не должен переводиться по-разному. В списке пишу, как слово стоит в оригинале и каким оно должно быть в переводе.
❯ Работа на практике
Чтобы проверить практическую полезность проекта, нужно провести соответствующие заголовку статьи тесты. Перевести книгу через созданную мною программу.
В качестве книги для перевода я взял короткий рассказ Шарлотты Перкинс Гилман «The Yellow Wallpaper», 1892 год. Он в общественном достоянии.
Запускал всё на ноутбуке, со средними параметрами:
|
Процессор |
Intel Core i7-1185G7 |
|
Оперативная память |
16 ГБ (было свободно 7,6 ГБ) |
|
Видеокарта |
Отдельной видеокарты нет, вся обработка велась на CPU |
|
Модель |
Hy-MT2 1.8B Q4_K_M (лёгкая и быстрая) |
Весь рассказ был разделён на 269 фрагментов и 31 263 знака. Каждый фрагмент содержал разное количество знаков. От 16 до 535, в среднем было около 116 знаков на один фрагмент. Модель поднялась за 3,3 секунды и сразу приступила к работе.
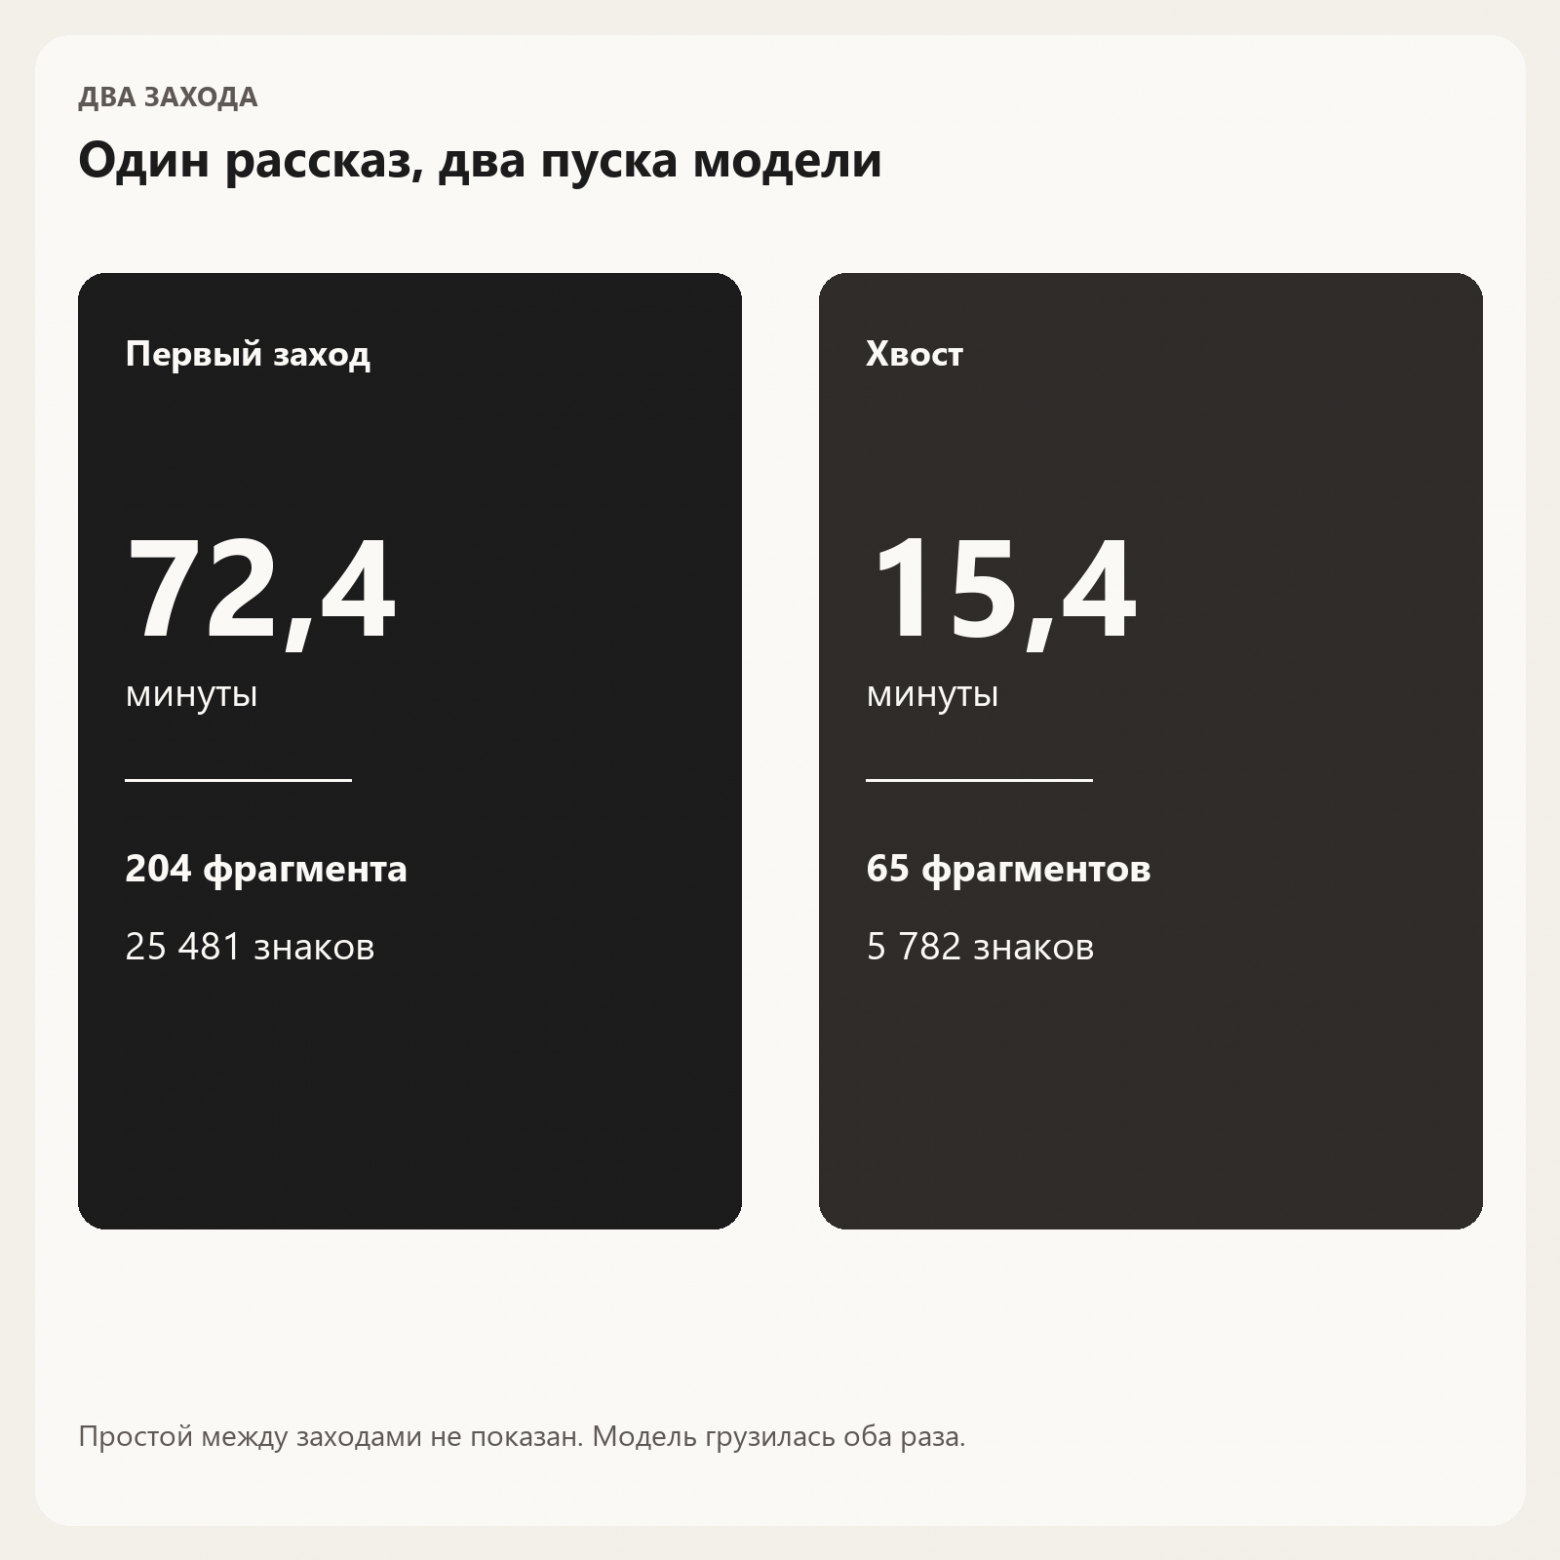
Всего было 2 захода. Первый добрался до 204-го фрагмента (25 481 знак) и занял 72,4 минуты. Дальше задача оборвалась.
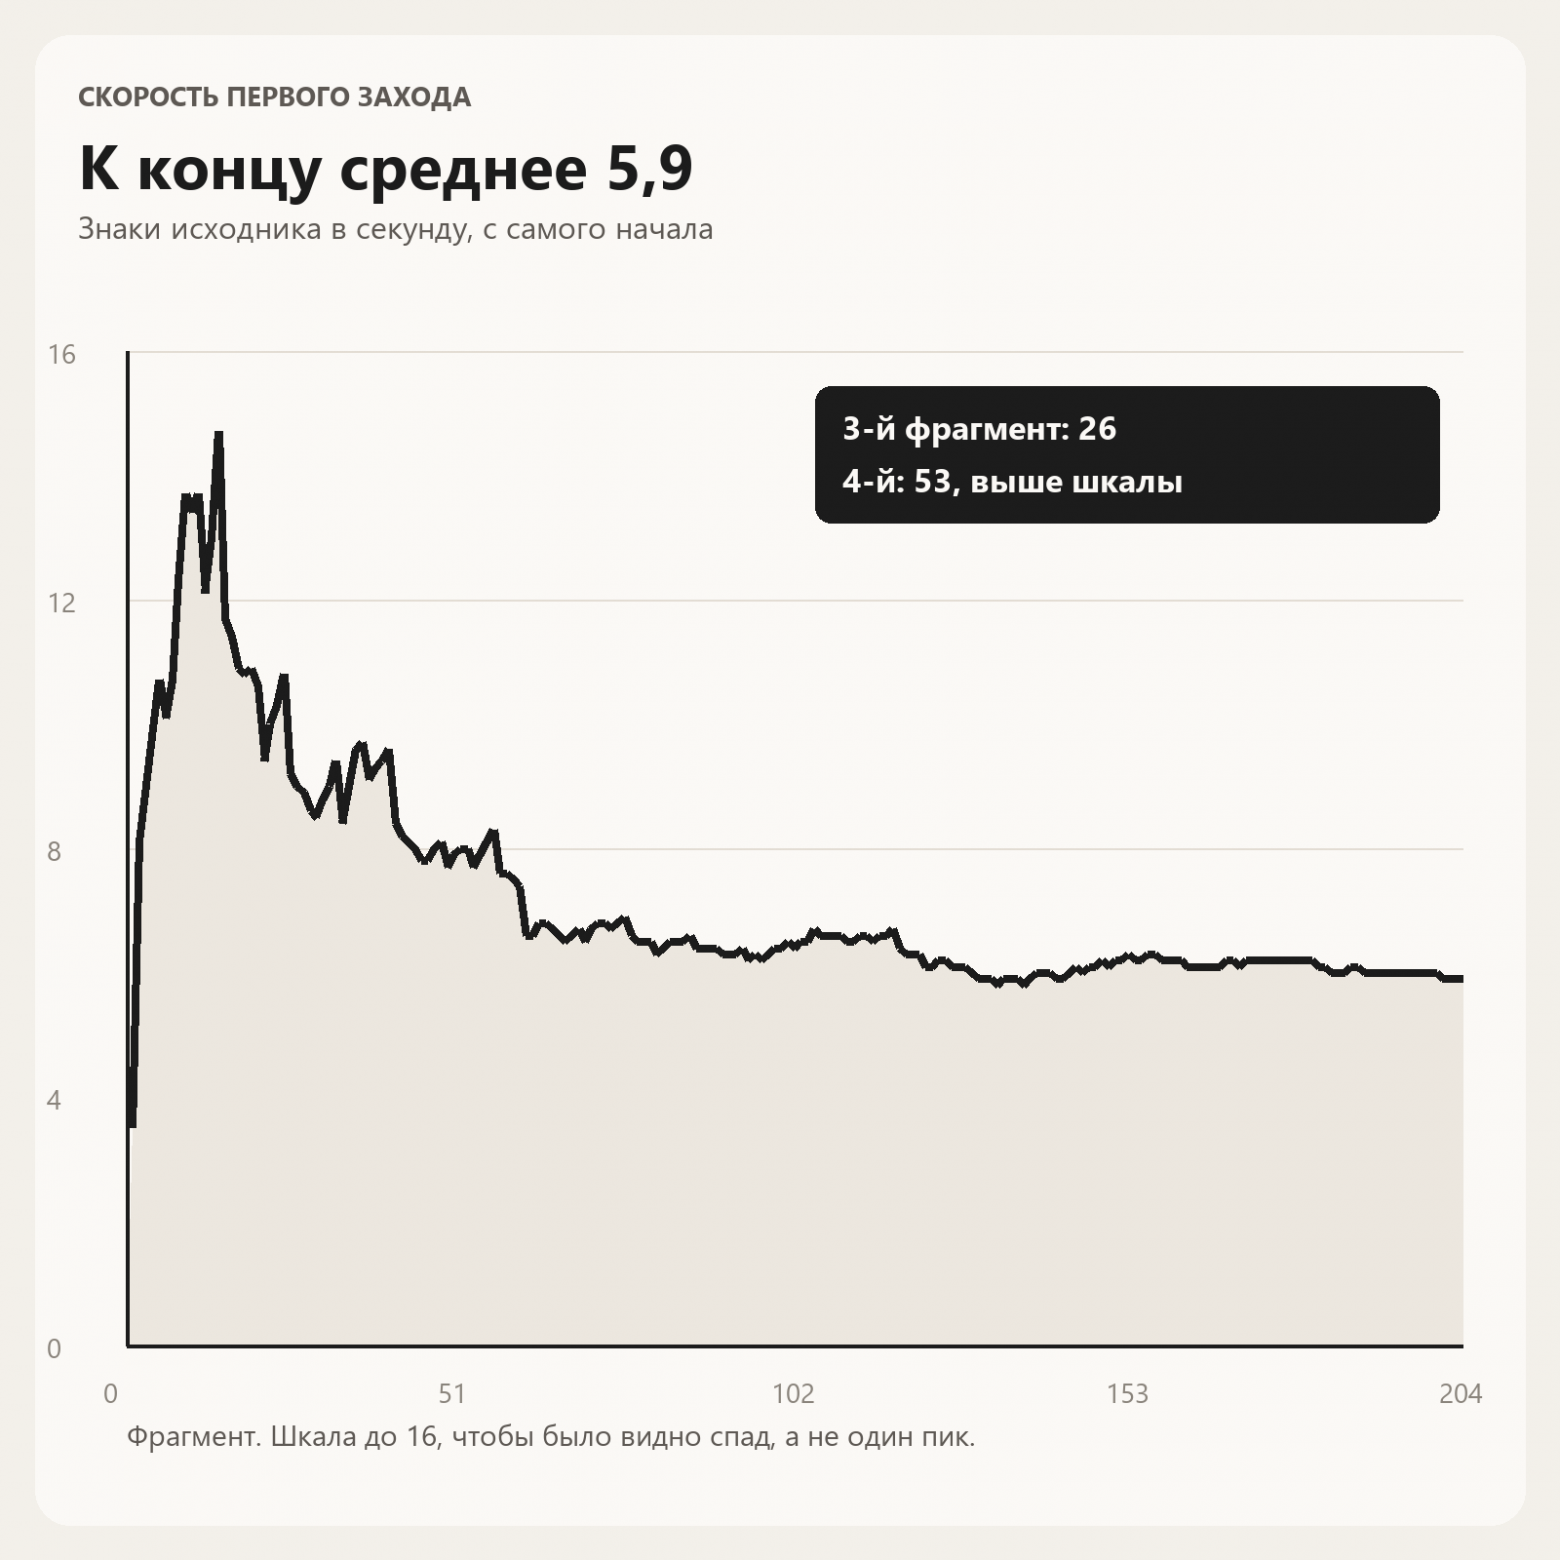
Готового файла ещё не было, но переведённые куски сохранились, и оставшуюся часть я добил отдельно. 65 фрагментов (5 782 знака) работа завершилась за 15,4 минуты. Всего вышло 87,8 минут на всю книгу. Это примерно 5,9 знака в секунду.
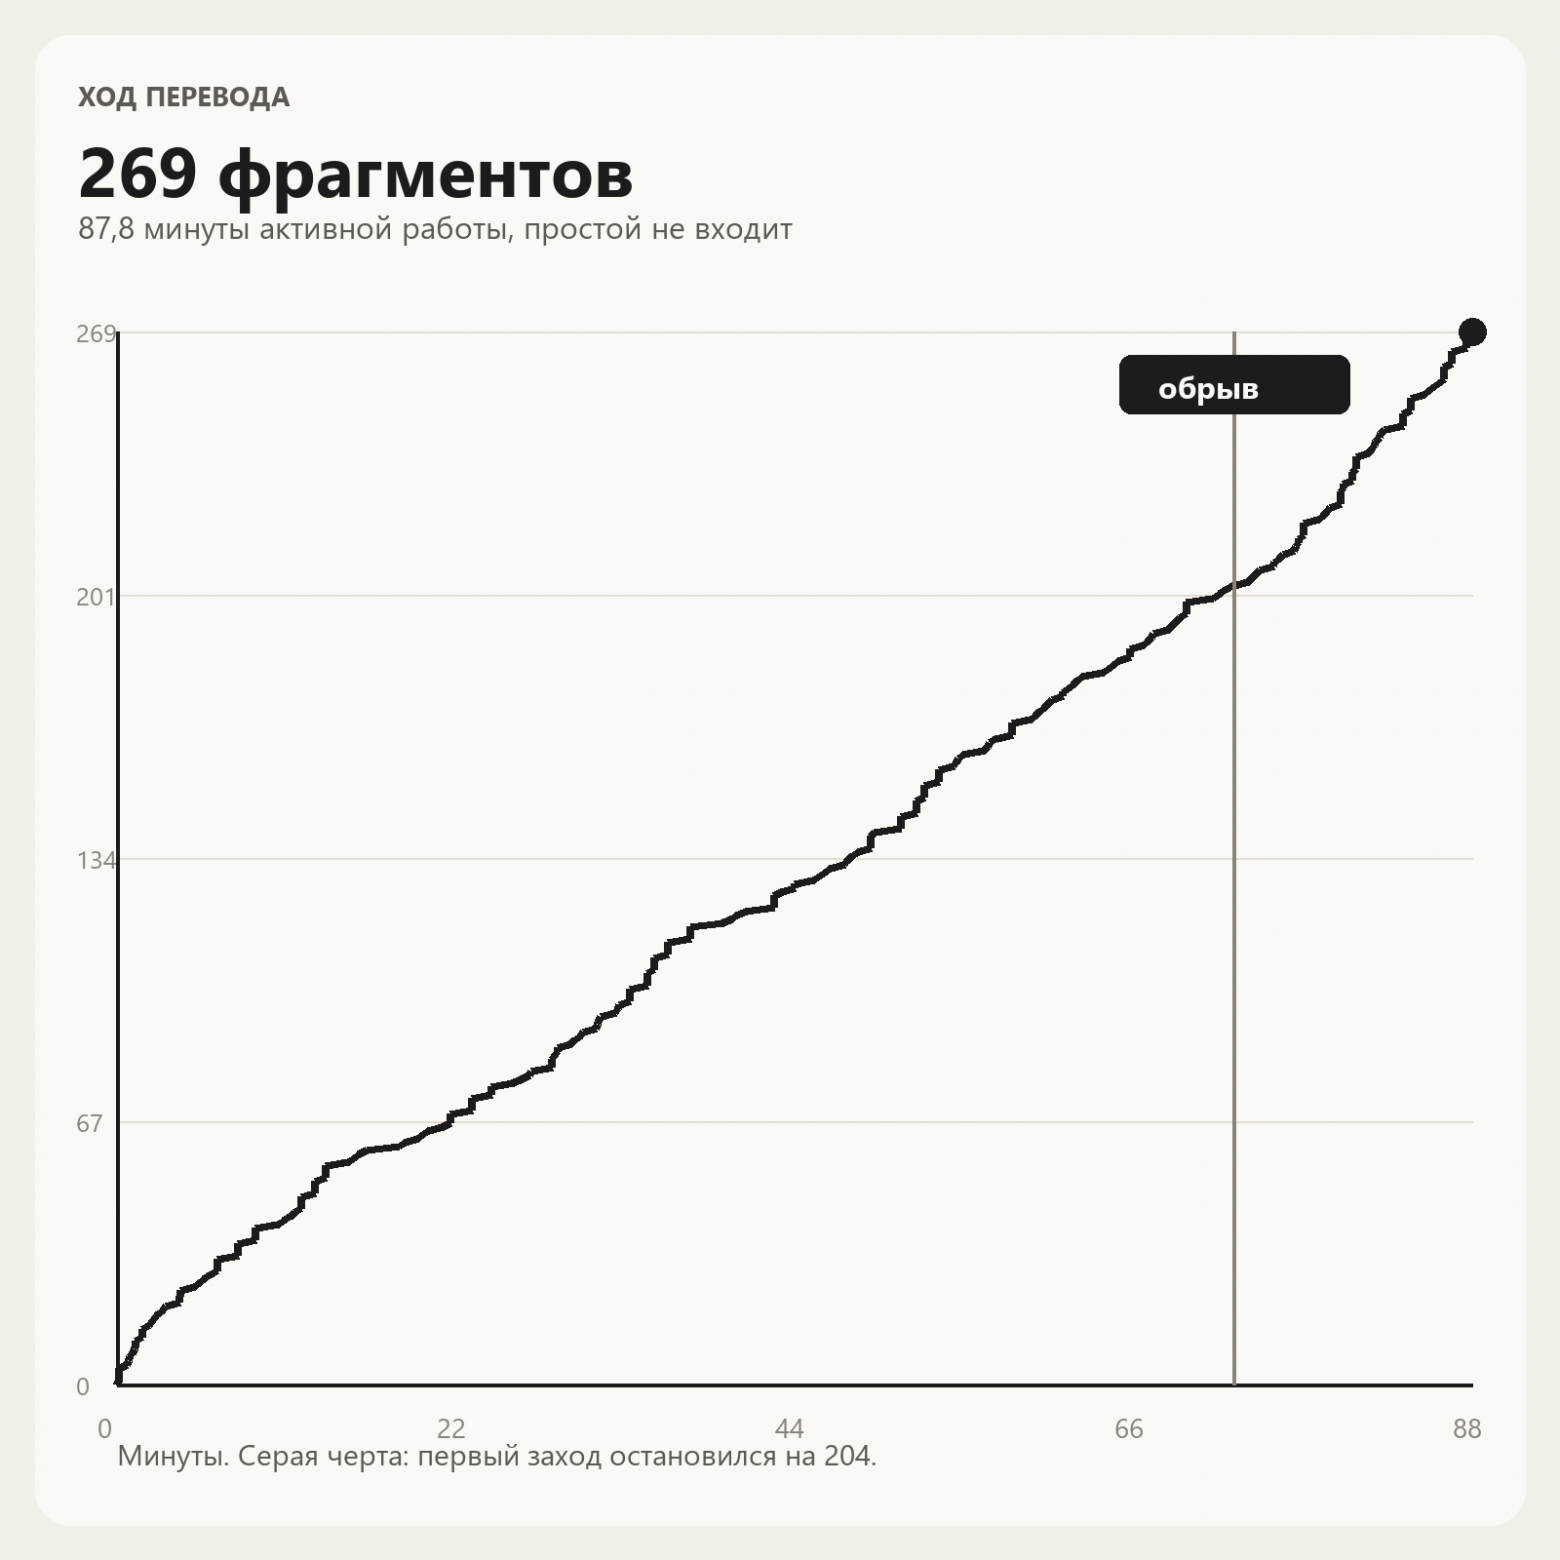
В процессе перевода темп скорости перевода гулял. В первые секунды средним было показание до 26 знаков в секунду, а на четвёртом фрагменте до 53. После нагрузка и скорость стабилизировались и держалось около 5,9.
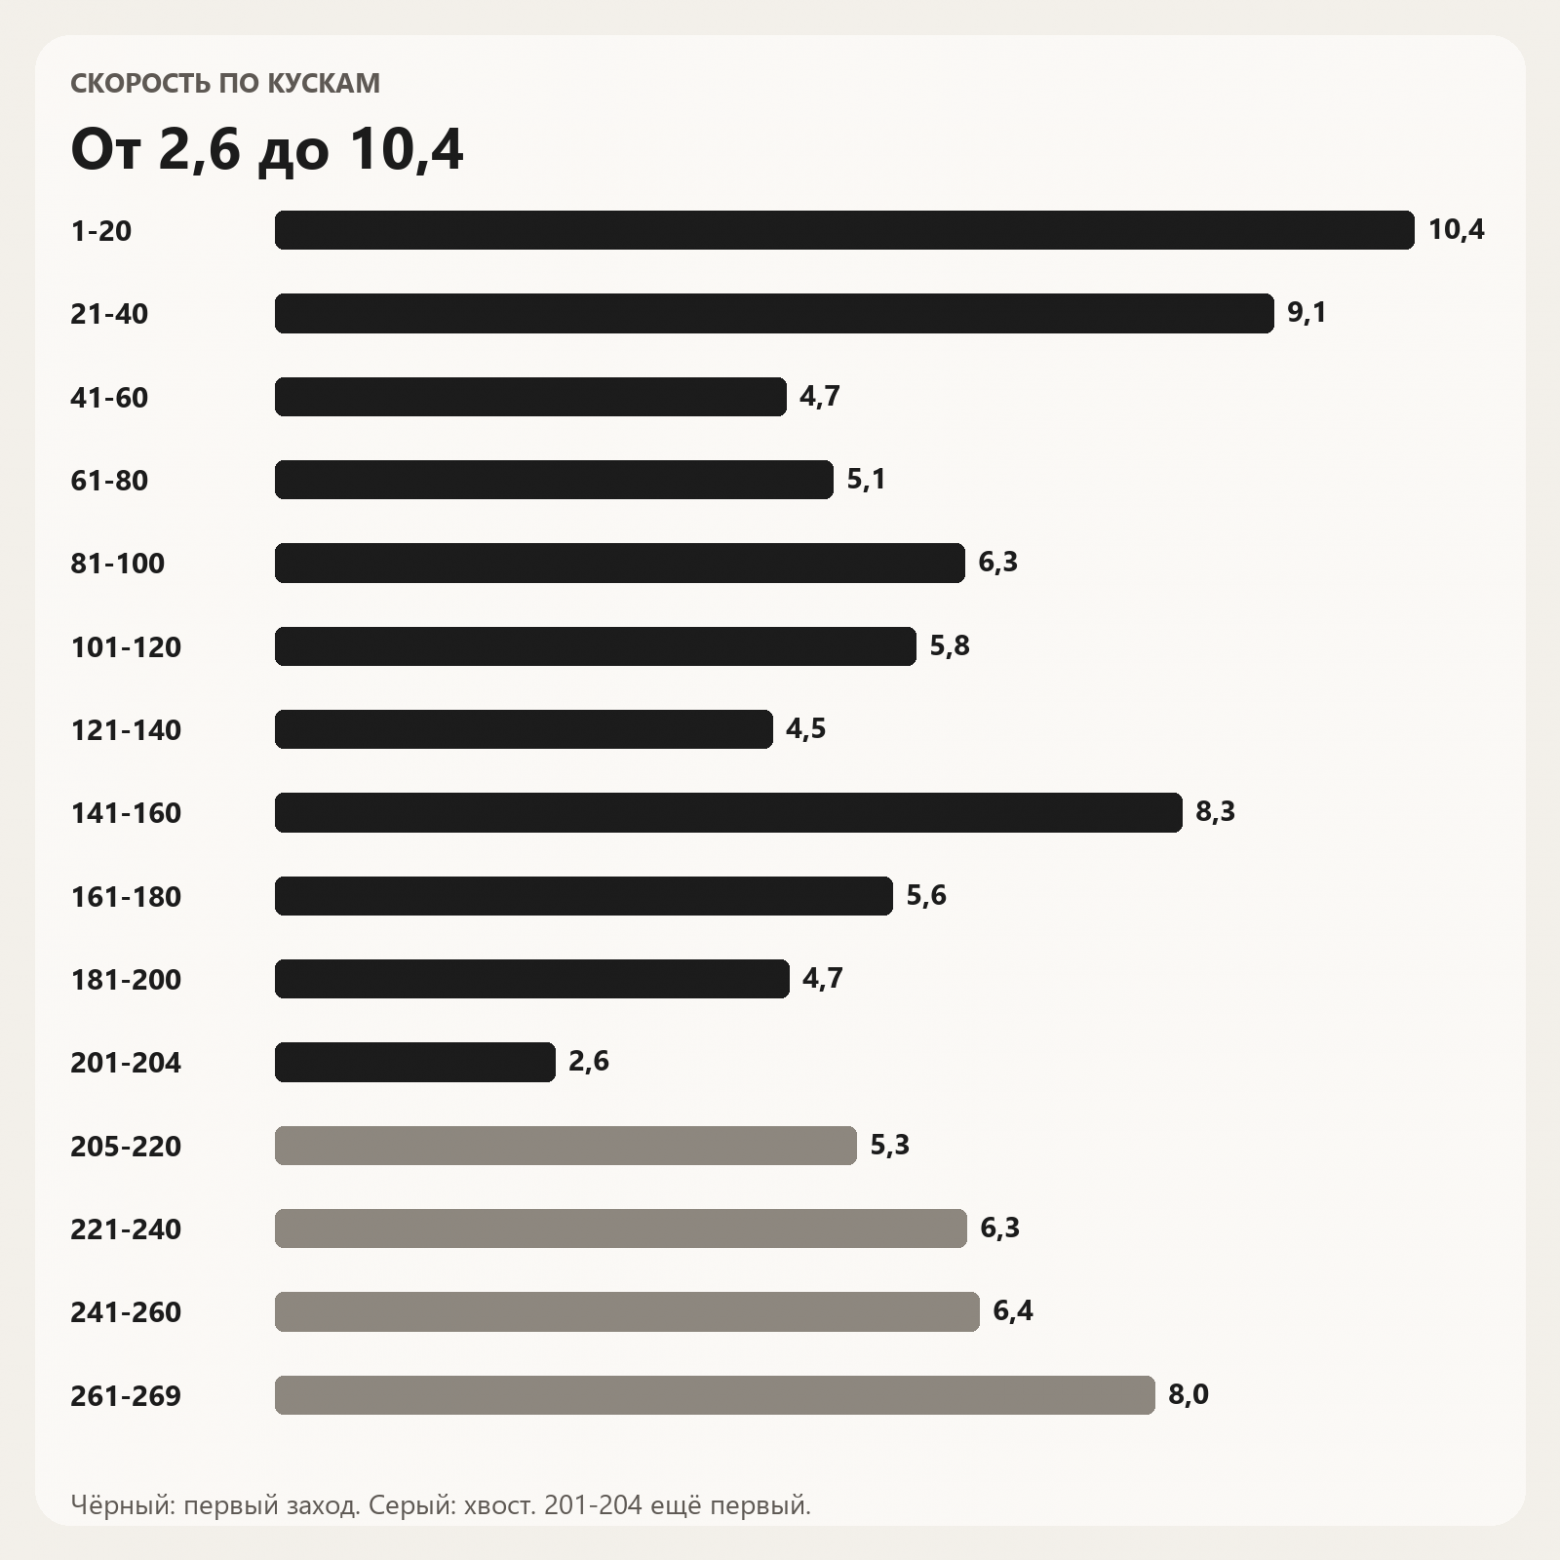
Качество перевода оставляет желать лучшего, но это было ожидаемо. Модель простая, лёгкая и не претендует на точные результаты. Если хочется серьёзных результатов, то нужно запускать соответствующие модели на соответствующем железе.
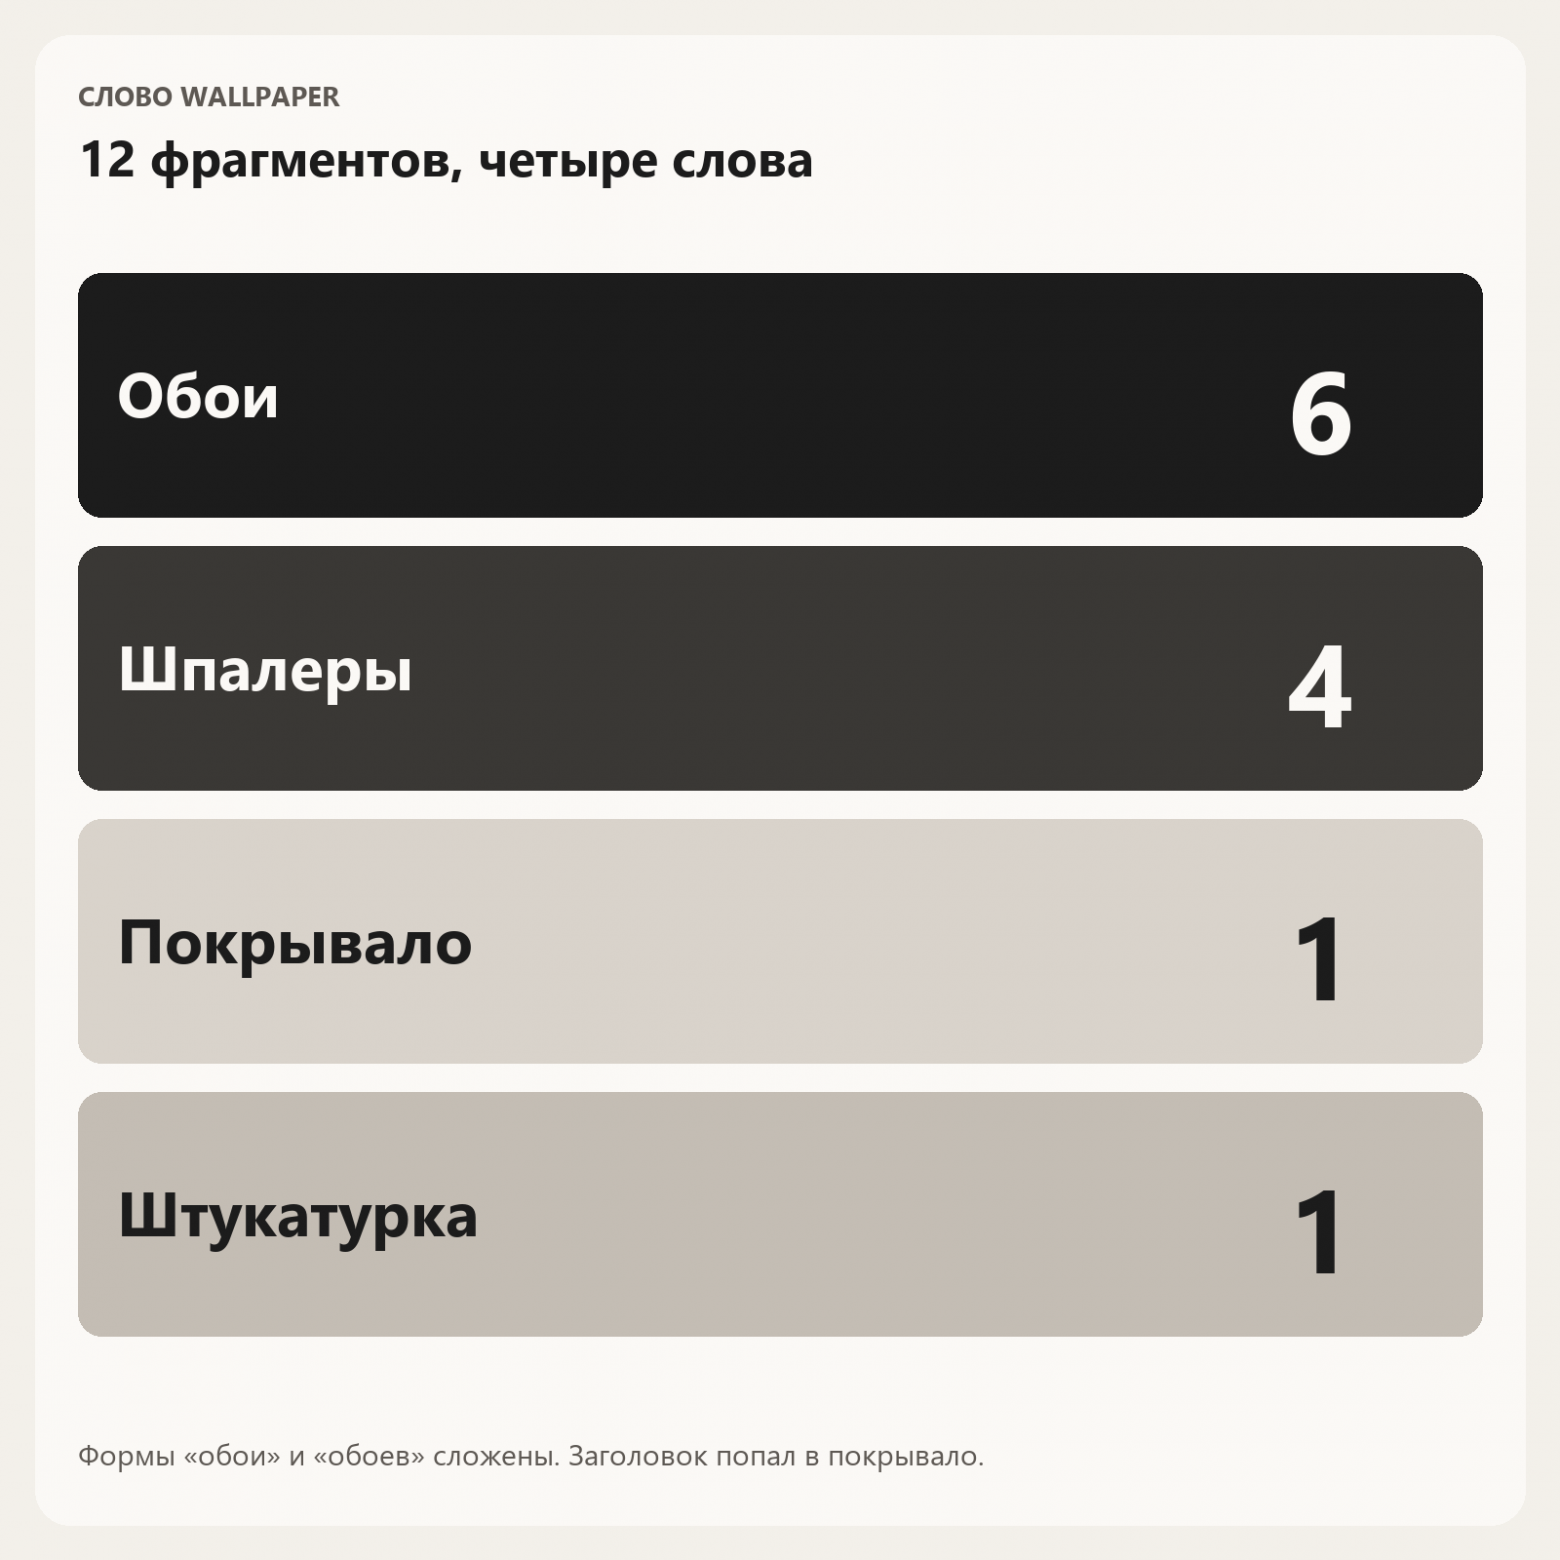
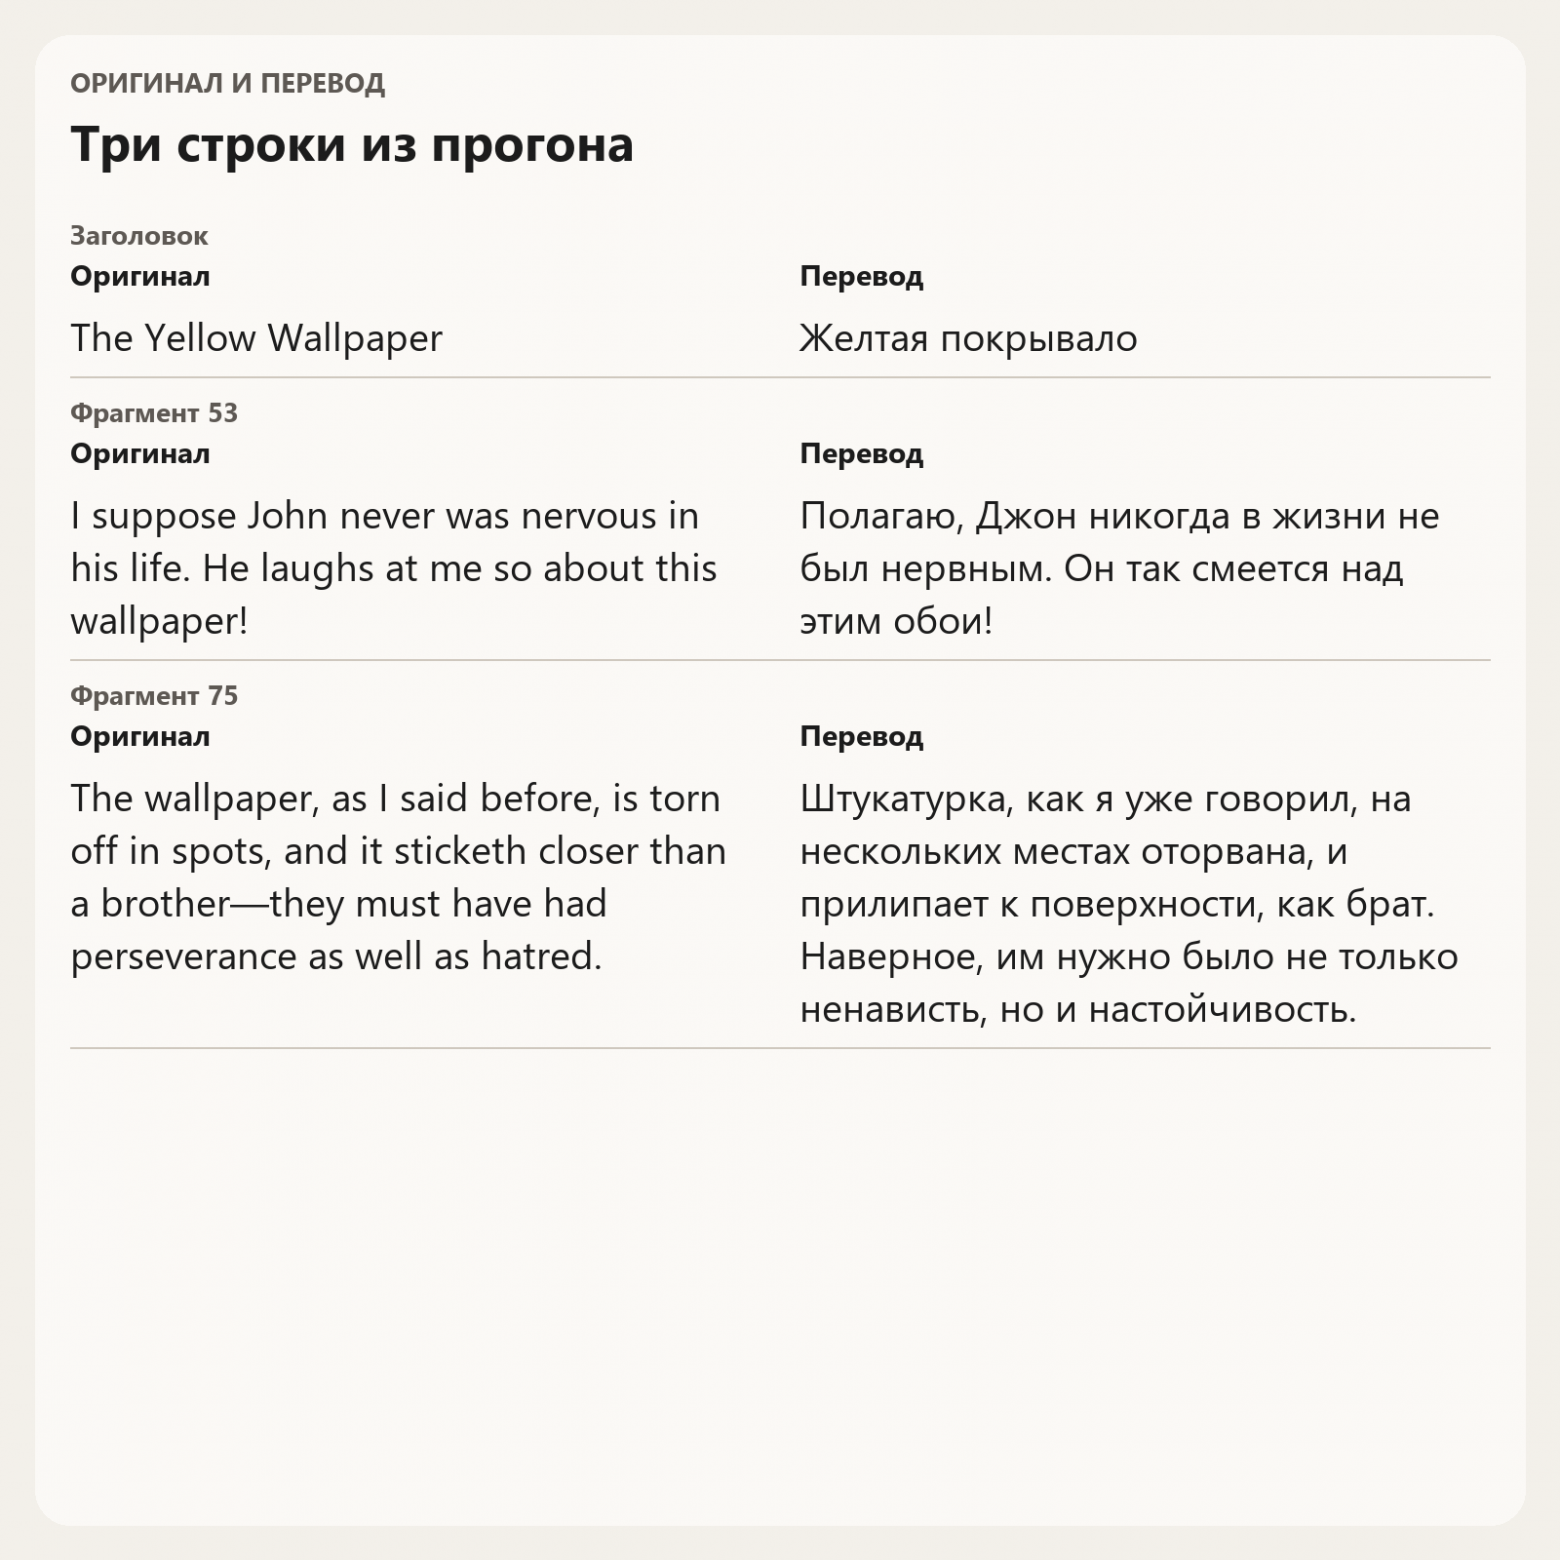
К примеру, cлово wallpaper в рассказе попадается в 12 фрагментах, и модель так и не выбрала одно русское: шесть раз обои, четыре раза шпалеры, один раз покрывало и один раз штукатурка. Заголовок «The Yellow Wallpaper» вышел «Желтая покрывало».
Тут и смысл уехал, и род не сошёлся. В одном месте героиня говорит о себе «как я уже говорил», хотя рассказ ведётся от женщины. Имена при этом удержались без всякого глоссария. John все 46 раз остался Джоном, Jennie 12 раз стала Дженни.
Черновик, в общем, честный. Программа действительно перевела короткий рассказ и сохранила результаты. Все вычисления производились на моём процессоре, без интернета.
Текст читать можно, но с оговорками. Как писал выше, если вам нужен качественный перевод, нужно использовать модели получше.
❯ Итоги
История перевода показывает, что новые технологии постепенно забирали у человека отдельные этапы работы: сначала появились словари и печатные машины, затем компьютерные системы, статистические алгоритмы и нейросети.
Современная модель уже может быстро подготовить перевод большого объёма текста, но пока не всегда понимает контекст, удерживает стиль, корректно передаёт игру слов и принимает редакторские решения.
Поэтому нейросеть ещё не заменяет живого переводчика, а скорее становится его инструментом и ускоряет подготовку черновика.
При этом переход уже начался. Модели становятся доступнее, специализированные системы лучше работают с терминологией, а локальный запуск позволяет обрабатывать книги без передачи текста стороннему сервису.
В ближайшие годы качество и удобство таких инструментов могут заметно измениться, и граница между машинным и человеческим переводом продолжит смещаться. Пока же для личного чтения достаточно связки «локальная модель + приложение», а для публикации нужен человек, который отвечает за смысл, стиль и окончательный текст.
Ссылки:
GitHub: https://github.com/network-user/DotLingo [8]
Обо мне: https://info.dotcore.lol/ [10]
Новости | AI: https://t.me/nesw_ai [11]
Может быть интересно:
Новости, обзоры продуктов и конкурсы от команды [16]Timeweb.Cloud [17] — в нашем Telegram‑канале [16] ↩
Автор: bububebe
Источник [18]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37155
URLs in this post:
[1] предложил устройство: https://www.iis.nsk.su/news/2022-03-17
[2] предложил использовать: https://en.wikipedia.org/wiki/History_of_machine_translation
[3] провели первый эксперимент: https://www.computer-museum.ru/histsoft/histmt.htm
[4] начали появляться: https://aclanthology.org/www.mt-archive.info/90/T%26T-1990-Hutchins.pdf
[5] память: http://www.braintools.ru/article/4140
[6] поведение: http://www.braintools.ru/article/9372
[7] https://github.com/network-user/DotL: https://github.com/network-user/DotL
[8] ingo: https://github.com/network-user/DotLingo
[9] Hy-MT2: https://github.com/Tencent-Hunyuan/Hy-MT2
[10] https://info.dotcore.lol/: https://info.dotcore.lol/
[11] https://t.me/nesw_ai: https://t.me/nesw_ai
[12] Раньше были основой, а потом пропали без следа. Какие мобильные ОС мы потеряли: https://habr.com/ru/companies/timeweb/articles/1093928/
[13] Путь IT‑шника в английский: приложения и инструменты на личном опыте: https://habr.com/ru/companies/timeweb/articles/1090138/
[14] От медной шахты до Луны: путь Маргарет Гамильтон: https://habr.com/ru/companies/timeweb/articles/1093044/
[15] Перейти: https://timeweb.cloud/?utm_source=habr&utm_medium=banner&utm_campaign=promo
[16] Новости, обзоры продуктов и конкурсы от команды : https://t.me/timewebru
[17] Timeweb.Cloud: http://Timeweb.Cloud
[18] Источник: https://habr.com/ru/companies/timeweb/articles/1091210/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1091210
Нажмите здесь для печати.