Как теперь устроена наша PIM-система и что необратимо изменилось
Для начала немного контекста: мы с командой делаем сервис для бизнеса, и я иногда пишу тут, на Хабре, о каких-то успехах, провалах или просто своем опыте [1]. Несколько лет назад писал про то, как наша PIM устроена внутри [2].
Она всё ещё устроена так же, но что-то необратимо изменилось. Мы активно развивали продукт, а он устаревал быстрее, чем мы его развивали. Это по моим ощущениям. Что с этим делать, я не понимал. А потом как понял. За несколько месяцев мы поменяли способ работы пользователей с системой — и это пошло на пользу и нам, и клиентам. Но не волнуйтесь, я по-прежнему не понимаю множество вещей.
Мы встроили ИИ-агента в нашу платформу и научили его работать самостоятельно. Например, он реально сам ищет информацию в интернете и создаёт карточки товаров на маркетплейсах.
Но мы-то знаем, что под капотом это вызовы API, запуск Python-скриптов (которые вызывают C-библиотеки) и так далее. Об этом и пойдёт речь.
Заодно порассуждаем, почему получилось «внедрить ИИ» только с четвёртого раза.
PIM — это довольно нишевая тема, не каждый разработчик сталкивался, по сути это система для управления данными о товарах, и её задача — данные собрать, обработать и отдать дальше. Вот, например, карточка пылесоса на маркетплейсе — по-хорошему, результат выгрузки из PIM (а не заполнения руками в личном кабинете), список моторных масел в наличии с допуском RN17 — тоже вопрос к PIM. Как CRM относится к процессам, в которые вовлечены клиенты, так и PIM относится к процессам, в которые вовлечены товары.
Искусственным интеллектом [3] мы будем называть предсказатель токенов. Оказалось, что на базе этого механизма можно построить сложные и весьма полезные вещи. Например, программировать он уже может лучше меня, хоть у меня 20 лет опыта. Вообще, это тема для отдельной статьи, в каких-то вопросах я всё ещё лучше.
История с внедрением каких-то отдельных ИИ-функций в продукт началась давно, лет 5 назад. Тогда из всего разнообразия вещей, которые мы хотели бы сделать, модели справлялись только с генерацией описаний товаров по известным характеристикам.
Остальное получалось плохо: например, у моделей не хватало интеллекта, чтобы понять, что если в спецификации товара указана версия блютуза, то это означает возможность беспроводного подключения. Потом это научились понимать дорогие модели, а в этом году — относительно дешёвые, GPT-6 Luna неплохо справляется с этой задачей.
Третьей отдельной задачей, которую мы переложили на плечи ИИ, стало распределение новых товаров по дереву категорий каталога.
Но всё это — решение отдельных точечных задач без какой-то долгосрочной стратегии и видения.
Исходная точка
Итак, у нас есть PIM-система. Может многое, начиная от сбора прайсов поставщиков в разных форматах и заканчивая интеграциями со всеми крупными маркетплейсами. Нормально справляется с каталогами в несколько миллионов товаров, даёт клиентам доступ к библиотеке на 100 миллионов карточек и алгоритмы для работы с ними.
То есть, если клиент хочет продавать пылесос Керхер на Озоне — ему не надо искать фотографии и скачивать спецификацию, данные с официального сайта в системе есть, и карточку можно создать почти автоматически.
И с Озоном интеграции реализованы, и с Вайлдберрис, и с другими маркетплейсами. Модуль для Битрикса есть. API есть. Но всё же тут настрой, тут разберись, тут формулу придумай и напиши. Руками всё равно нужно что-то делать, а глазами — за чем-то присматривать.
С другой стороны, существуют большие языковые модели, которые умеют писать код, отвечать на вопросы, имеют широкий кругозор и понимают контекст.
С третьей стороны, мы пользуемся Claude Code, Codex и OpenCode, которые умеют эффективно пользоваться моделями и имеют доступ к локальным инструментам для работы с кодом и не только. Например, добавляют новые функции в проект, и хорошо с этим справляются. Это уже не окошко чата, куда копируешь содержимое файла и просишь поправить баг или добавить кнопку, это реально новый уровень работы с кодом и проектом.
Тот же Claude Code даже без документации может разобраться в коде и добавить новый функционал или починить баг в старом. С документацией справляется ещё лучше. Кстати, мы стараемся документировать не детали реализации, а задачи, которые мы решаем той или иной функцией, и объясняем, зачем это нужно нашим пользователям. Раз уж Claude Code может такое, то с настройками разобраться тоже сможет.
И ещё в мире существует MCP — протокол, построенный поверх JSON-RPC. Это вообще простая штука, сервер должен просто принимать и отдавать JSON определенной структуры. Его хорошо понимают агенты типа того же Claude Code. В принципе, они и другие API понимают, но оптимизированы именно для работы с MCP.
План
Claude Code появился в общем доступе в мае 2025 года. Активно им пользоваться я начал в декабре. А потом ещё полгода потребовалось, чтобы прийти от автоматизации рутины (пишем код с помощью Claude Code) до чего-то принципиально нового (Claude Code или другой агент сам работает над задачами клиентов). Вот вроде бы очевидная мысль, но в мою голову она долго шла.
Мы поняли, что из этого можно собрать что-то стоящее, когда сделанный за вечер прототип присвоил коды ТНВЭД сотне тысяч товаров за час работы. Проверили (а у нас несколько тысяч товаров для проверки было, для них ранее специалист вручную коды подбирал) — и оказалось, что расхождений мало, десятые доли процента, а те, что есть — в пользу Claude Code (под капотом был он).
Кстати, если Claude Code просто дать список товаров и поставить эту задачу без инструментов, он не справится. Прототип как раз давал ему эффективные методы по поиску данных о товарах и по фильтрации кодов ТНВЭД. Инструменты — половина успеха.
Когда мы это увидели, приступили к разработке настоящего агента.
План был такой: для пользователя это выглядит как чат внутри системы, куда можно написать «создай карточки на Озоне для товаров из файла», загрузить файл, в котором только названия — и ожидать, что карточки реально появятся на Озоне. А наша задача — сделать так, чтобы они там реально появились.
Но это только первый шаг, реакция [4] на запрос пользователя. Второй шаг — автономная работа. Технически реализовать автономную работу не так сложно, когда есть база. Но прежде чем начать доверять агенту делать что-то самостоятельно, клиенты тестируют его возможности и адекватность в режиме чата.
Как это работает
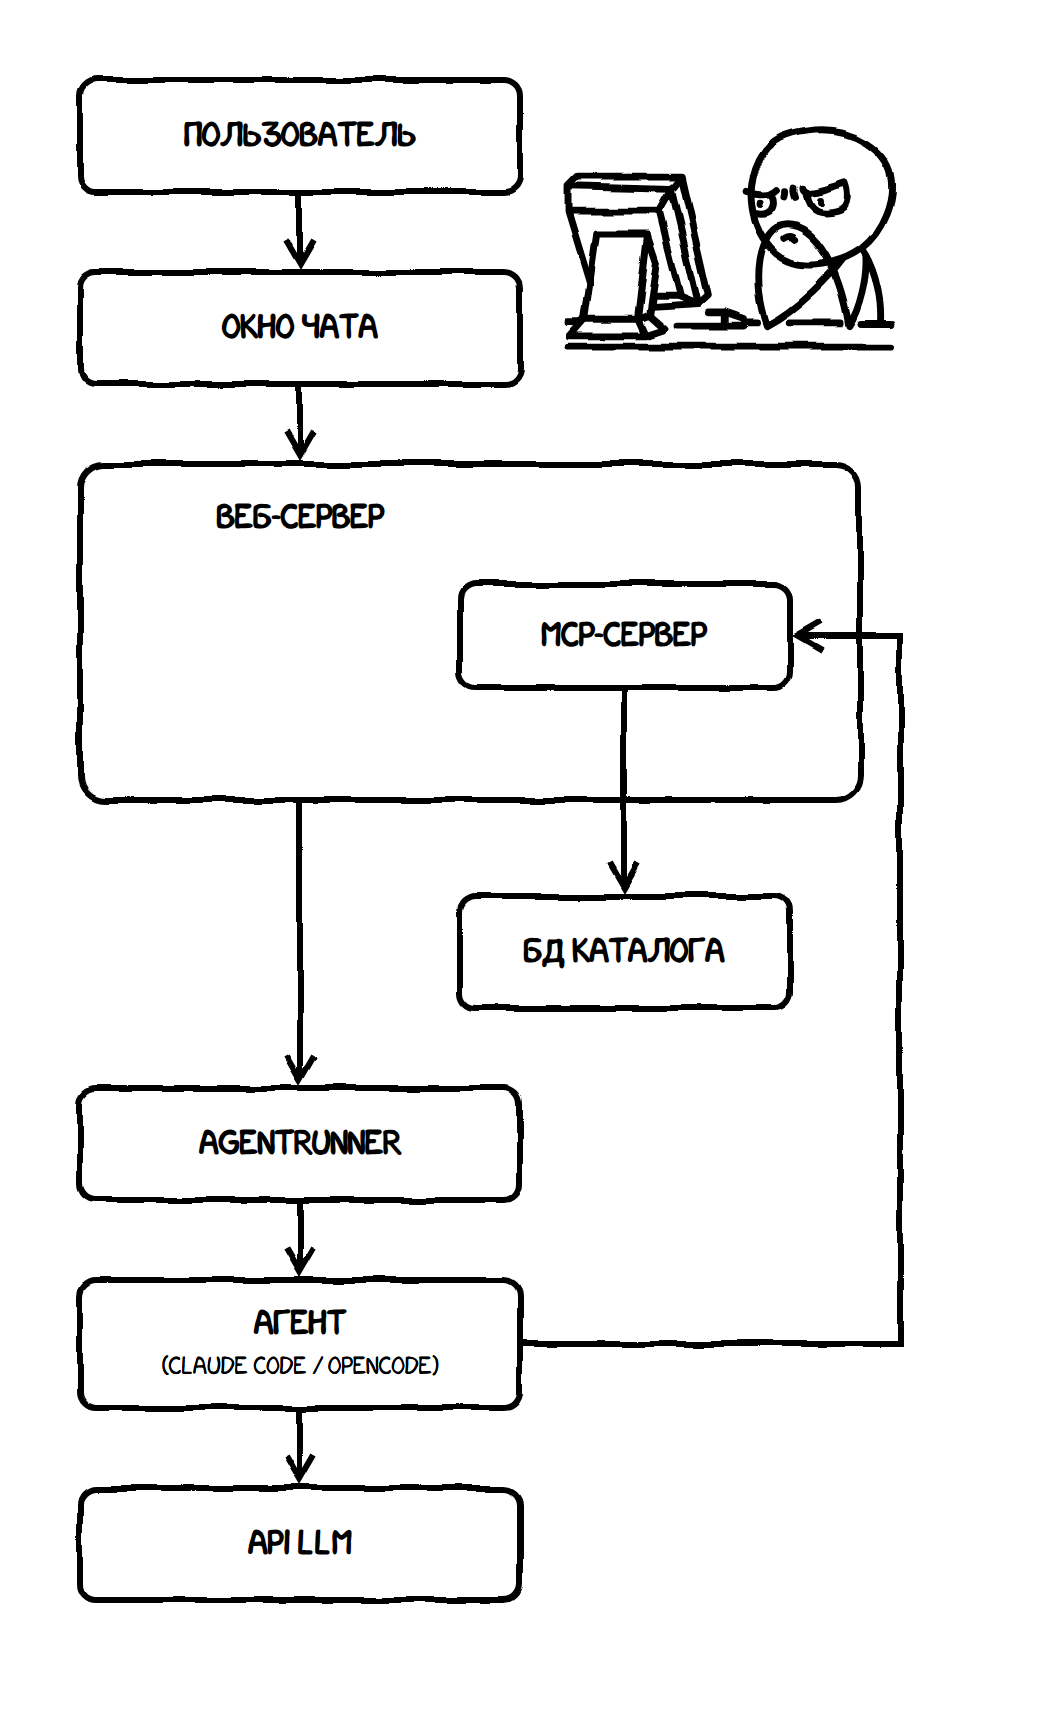
Магия для пользователя происходит где-то в окне чата. Магия для разработчика происходит ровно в одном месте — где-то на удаленных серверах провайдера LLM. Всё остальное — вполне детерминированное и предсказуемое.
Предлагаю посмотреть на каждый блок подробно.
Пользователь
Агентом пользуются разные люди с разными навыками, разными полномочиями и разной ответственностью. Кто-то пишет «Заполни эту карточку товара», а потом проверяет глазами, а кто-то настраивает сценарий «Массовое создание карточек на Озоне по новым товарам с Мерлиона» и доверяет агенту работать в фоне с десятками тысяч товаров прямо в активном кабинете Озона. Для справки, Мерлион — это крупный дистрибьютор электроники. Читателям скорее известен по брендам «Ситилинк» и «Позитроника».
Окно чата
Тут, с одной стороны, всё просто: javascript, который добавляет чат на все страницы. Общение с сервером — обычные http запросы (на вебсокеты перейдём когда-нибудь попозже).
С другой стороны — не так просто: чтобы агент не выглядел глупо, у него должен быть контекст пользователя. По сути, чат должен собирать информацию, что видит пользователь на странице, какие страницы он смотрел раньше, какие товары или бренды отмечены галочками, в каком месте и на какой странице расположена определенная кнопка или надпись. И часть этой комплексной работы по погружению агента в контекст пользователя реализуется скриптом чата.
Обращаю на это внимание [5], потому что был период, когда топовые модели не ориентировались в своем же интерфейсе.
— Как включить голосовой ввод?
— Не знаю, у меня данные до февраля 2025 года, тогда этой функции не было, а искать в интернете я не умею.
Веб-сервер
Запросы обрабатывает веб-сервер на ASP.NET [6] MVC. Ему уже много лет, он существует с самого начала проекта. В него просто добавили методы для работы с чатом, и встроили MCP-сервер. С точки зрения [7] организации кода, MCP-сервер — это отдельный проект и просто подключается через инъекцию зависимостей.
Agent runner
Это отдельный процесс на отдельном сервере. За обработку HTTP запросов отвечает Kestrel — встроенный сервер ASP.NET [6] Core. Его задача — запустить агента с нужными настройками и в нужном окружении. Настройки, ключи, запрос, идентификатор сессии — всё приходит внутри запроса от веб-сервера, задача раннера — подготовить окружение и запустить нужного агента, передать ему запрос на выполнение, а потом прочитать результат. Пишем в stdin и читаем из stdout.
Если пользователь загрузил файл — нужно положить его в папку, где живёт нужная сессия. Если агент сгенерировал файл для передачи пользователю — нужно уметь его прочитать и передать его пользователю, когда тот будет его скачивать. (Запрос из браузера пойдёт на веб-сервер, а оттуда — к раннеру, напрямую пользователи с раннером не взаимодействуют).
Раннер ничего не решает сам, он получает команду от Web-приложения. Это позволяет прямо в админке указать, какую модель и какого агента использовать для конкретного клиента, какие данные использовать для доступа к API LLM.
Ещё одна задача раннера — обеспечить единый интерфейс для работы с любым агентом. Независимо от того, кто будет делать реальную работу — Claude Code, Cursor, OpenCode, Qwen Code — интерфейс взаимодействия с раннером остаётся неизменным.
Агент
Сам агент — это даже не наш код. Смысл существования агента заключается в том, чтобы эффективно работать с LLM API во-первых, и иметь доступ к компьютеру и инструментам, во-вторых. На данный момент поддерживаются Claude Code и OpenCode, но архитектурно можно легко добавить и других исполнителей.
Агент получает от пользователя команду и собирает из неё запрос к LLM API: системный промпт (ОС, что установлено, правила и ограничения), историю переписки и запрос пользователя. Префикс запроса он помечает как кешируемый, при повторной отправке обработка того же префикса будет стоить раз в 10 дешевле, потому что модель их не пересчитывает.
Например, пользователь пишет “который час?”. Агент собирает запрос, и отправляет в LLM API. В ответ приходит не текст ответа, а запрос на вызов инструмента: «выполни date +%s». Агент запускает команду, получает 1783874849, дописывает результат к переписке и шлёт весь контекст заново. Теперь модель отвечает текстом — «без пяти минут пять», — и агент печатает его пользователю.
Но на пустой операционной системе возможности агента ограничены. Для эффективной работы нужны готовые программы для часто возникающих задач.
Первое — работа с кодом. Мы используем Python с набором предустановленных библиотек. Если нужно обработать большие массивы данных, делается это не через контекст и LLM, а через генерацию кода по их обработке. Так экономнее, точнее, быстрее.
Второе — работа с файлами. Пользователь просит сделать Excel-таблицу или вытащить характеристики товара из PDF — и агент это делает. Если задача простая — достаточно встроенных grep, sed или cat. Если сложнее — то используется тот же Python и подходящие библиотеки. Например, pandas и openpyxl. Если их не дать агенту, то он сам пишет xml файлы и собирает из них xlsx файл. Для меня удивительно то, что у него это получается.
Третье — работа с сетью. Так-то, PDF с характеристиками ещё найти нужно.
И четвёртое — MCP-методы платформы. Агент вызывает их точно так же, как date, просто запрос идёт к нашей платформе.
В итоге агент не просто общается, а может реально делать работу.
MCP — сервер
Это способ обеспечить агенту доступ к возможностям платформы. А уже платформа умеет всё остальное: и обработку прайс-листов, и пересчёт цен, и обмены данными с маркетплейсами или другими системами типа Битрикса или 1С, и поиск товаров по фильтрам и многое другое (счёт инструментов идёт на сотни).
Ещё через MCP агент получает всю документацию о проекте, и, кроме того, имеет возможность посмотреть любую страницу глазами пользователя. Например, пользователь пишет «Я не могу найти красный стул с уточкой», а агент отвечает «На открытой странице представлен список товаров, и красный стул с уточкой в этом списке на пятом месте. На главном фото уточки не видно, она на третьем по счёту фото». Для этого нам пришлось сделать свой ViewEngine — чтобы давать не голый html, а более компактную версию данных о странице.
С документацией пользовательского интерфейса тоже есть нюансы. Если ее отдавать всю сразу, то контекст растет до сотен тысяч токенов. Во-первых, дорого, во-вторых, большой контекст с данными, которые к задаче не относятся, могут сбивать агента с толку. Поэтому пришлось строить что-то похожее на Вики, но через MCP. На верхнем уровне — описание сервиса в целом: какие задачи решает, как устроен интерфейс пользователя на уровне разделов, какие интеграции реализованы. На этом же уровне — инструкция, как посмотреть документацию по определенному разделу.
На втором уровне – тот же принцип, только для раздела. А на третьем-четвертом уровне уже документация о конкретной странице или функции. Они ссылаются друг на друга, если функции связаны. Кроме того, агент может сам посмотреть любую страницу, если документации оказалось недостаточно.
Это позволяет агенту экономить контекст, но адекватно отвечать на любые вопросы об интерфейсе системы.
При разработке каждый инструмент проверялся на быстродействие на разных масштабах, в том числе исследовались планы всех запросов в базу данных, которые инструмент может генерировать. Измеряли количество чтений и записей на тестовой базе с 10 миллионами товаров. Это важно, агенты могут создать значительную нагрузку на базу, если какой-то из методов MCP API будет неэффективным (например, будет выполнять сканирование всего индекса таблицы).
LLM API
— Это твоя система машинного обучения [8]?
— Да! Ты засыпаешь данные в эту большую кучу линейной алгебры, а потом собираешь ответы с другой стороны.
— А если ответы неверные?
— Просто перемешивай кучу, пока они не начнут выглядеть правильно.
Клянусь, как-то так это и работает внутри. А для нас это выглядит просто как обращение к API на удаленном сервере.
А без платформы нельзя?
Решить ограниченную задачу можно и без платформы и MCP. Но вот полноценный процесс управления данными — нет, не построить.
Те же обмены с маркетплейсами — это десятки тысяч строк кода. Нюанс в том, что API маркетплейсов документировано далеко не так хорошо, как хотелось бы. Вот, например, документация приводит 20 возможных значений для перечисления типа расходов продавца. На деле мы встречаем 50. Не всё сразу, и у разных клиентов — разные. И эти данные можно только накопить в процессе реального использования и преобразовать полученный опыт в код.
И так со всеми интеграциями. Код, разработанный в соответствии с документацией, либо не работает, либо ломается в какое-то время на неожиданных данных.
Но даже без учёта интеграций платформа даёт то, что агенту без платформы придётся изобретать самому — эффективные алгоритмы, часто используемые функции, редко используемые функции, плюс десятки терабайт собранных и структурированных данных.
А ещё — сотни страниц, которые дают картину того, что происходит. То есть, состояние системы не скрыто, всё можно сделать руками, если не доверяешь агенту.
Я месяц активно читал чаты пользователей с агентом и искал неправильные ответы, ошибочные действия, неоптимальные пути решения задач. Иногда не хватало инструмента — тогда добавлял его, иногда находились пробелы в документации, обновлял документацию. Только исправлений и доработок за этот месяц получилось несколько сотен. Сейчас я продолжаю это делать, но не так активно.
Автономная работа
Платформа и без агента предоставляла возможность запускать задачи по расписанию. Например, каждый рабочий день в 10:00 нужно забирать данные о новых ценах поставщика, а каждые 15 минут — актуальные данные об остатках товаров на складе выгружать на маркетплейс. Автономная работа построена на базе этого механизма.
Для повторяющихся действий клиент создает сценарий для агента, и может ссылаться на него в чате, или настроить расписание, и тогда платформа будет запускать его в нужное время.
Работает?
С технической частью разобрались, и всё действительно работает как задумано. А что с точки зрения пользы для бизнеса?
Тут сделаем шаг назад и вернемся к временам нашего прототипа. Тогда в команде было две точки зрения: выкатить функционал агента как можно раньше и отдать пользователям, или отточить до состояния, когда он сможет выполнять почти все пользовательские сценарии, самостоятельно ориентироваться в интерфейсе и понимать текущий контекст пользователя — видеть то, что видит пользователь. Мы пошли вторым путём, и это отложило релиз на месяц-другой.
Но оно того стоило, как мне кажется. Пользователи не сразу стали доверять агенту. Сначала были запросы, которые были как бы проверкой на адекватность и возможности. Думаю, если бы им отвечала сырая версия, агент бы эту проверку не прошёл и не получил кредит доверия. А упросить попробовать версию после доработок было бы очень сложно.
Зачем упрашивать? Цель сервиса — решать задачи клиентов, и с агентом это получается проще и быстрее. А если сервис не приносит ожидаемую пользу, от него проще отказаться.
А если агент сделает что-то не так? Для многих операций возможно откатиться. Пишешь агенту «верни как было», и он возвращает. Данные сессии хранятся несколько недель.
Рискованная операция — это управление ценами на маркетплейсах. Их тоже можно откатить, но получить невыгодные заказы можно и за короткое время. Но, во-первых, права на это можно не давать платформе в целом. Во-вторых, даже если права у платформы есть, у агента нет возможности управлять ценами напрямую, только через настройки алгоритма формирования цен. Безусловно, стоит проверить алгоритм перед запуском в работу в живом кабинете, для этого есть возможность делать тестовые запуски без отправки данных в маркетплейсы.
Ещё один значимый эффект заключается в том, что мы стали получать гораздо меньше запросов в техподдержку, приблизительно раза в три. Но, изучая чаты, я понимаю, что самих вопросов стало больше. Люди спрашивают у агента то, о чем в поддержку писать не стали бы.
Три предыдущие попытки внедрить ИИ в продукт провалились. Ну как провалились, с технической точки зрения они работали как задумано и выполняли заявленные задачи. Клиенты этими функциями пользовались (описаниями — редко, а заполнением карточек и поиском нужных категорий для новых товаров — чаще).
Но концептуально это были просто полезные функции, а не смена парадигмы. Они не были определяющей характеристикой продукта. Я ожидал от этих попыток большего и видел в них полноценное внедрение ИИ в продукт — хотя на деле они им не стали.
А четвёртая попытка, насколько я вижу, стала именно той определяющей характеристикой продукта, за которую его можно хотеть внедрить, и побыстрее. Это не я выдумал — с момента релиза я уже более 50 раз встречался с клиентами для его обсуждения. Все находят его полезным, но и списки того, над чем ещё стоит поработать, получаю регулярно. Например, явно нужно что-то делать с доступом агента к страницам, закрытым капчей. Думаем.
Я продолжаю наблюдать за работой агента, сейчас счёт идёт на тысячи диалогов в неделю. Сколько создаётся или редактируется карточек — я не знаю, не считал, важнее было другое — справляется ли агент с заявленными задачами. С точки зрения метрик бизнеса клиентов я тоже не могу оценить эффект, у меня нет доступа к этим метрикам. Есть только отзывы с встреч и доступ к диалогам.
Выводы
Я стал пользоваться ИИ регулярно и замечать эффект для своей работы, когда на смену чату с вопросами и ответами пришёл чат с командами и отчётами.
Пользователи нашей платформы — когда на смену отдельным функциям пришла цельная концепция, в которой у ИИ агента есть возможность сделать всё, что может сделать пользователь (и даже больше, пользователи не особо часто пишут скрипты на Python).
Ко времени четвёртой попытки появились готовые агенты, а модели поумнели и стали дешевле.
Без готовых агентов мы бы не реализовали все возможности своими силами. Глупые модели не смогли бы решать сложные задачи, дорогие — не имели бы экономического смысла.
Получается, попытка номер четыре стала удачной, потому что мир поменялся. Наша заслуга в том, что мы это заметили и поменяли парадигму продукта в соответствии с новыми возможностями.
Наверное, это и есть самое сложное — в ситуации, когда продукту уже много лет, когда он работает и на самом деле закрывает задачи — посмотреть на него с другой точки зрения, посмотреть на мир вокруг и признать, что он был хорош пять лет назад, а сейчас — устарел, хоть все пять лет развивался.
Похоже, агент с нами уже навсегда, отключить его мы уже не сможем — он оказался полезным, пользователи к нему привыкли, и если его отключить, продукт станет объективно хуже.
Автор: Razoomnick
Источник [9]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37473
URLs in this post:
[1] опыте: http://www.braintools.ru/article/6952
[2] PIM устроена внутри: https://habr.com/ru/articles/802465/
[3] интеллектом: http://www.braintools.ru/article/7605
[4] реакция: http://www.braintools.ru/article/1549
[5] внимание: http://www.braintools.ru/article/7595
[6] ASP.NET: http://ASP.NET
[7] зрения: http://www.braintools.ru/article/6238
[8] обучения: http://www.braintools.ru/article/5125
[9] Источник: https://habr.com/ru/articles/1098978/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1098978
Нажмите здесь для печати.