Периодические функции как функции активации в нейросетях
Вступление
Современные LLM-модели демонстрируют огромный прирост качества за счет развития математики [1], разработки новых алгоритмов и способов обучения [2]. За последний год вышло множество моделей, которые подтверждают сказанное мною выше. Но, особенно меня удивила модель от OpenAI, а именно — GPT-6 Astra [3].
После её выхода я был несколько удивлён архитектурой Looped Transformer; для меня это стало открытием. Я начал читать про данную разновидность архитектуры Transformer, и мне пришла в голову следующая мысль: «Если архитектура Looped Transformer даёт цикличность [4], благодаря которой у модели появляется шанс „пересмотреть“ своё решение, почему бы не использовать периодические функции — они тоже цикличны и тоже дают шанс „пересмотреть“ решение, но немного в другом смысле?» Давайте разберём эту мысль подробнее.
Итак, план на сегодня:
-
Рассмотрим мысль поближе.
-
Рассмотрим разновидности периодических функций: какая подойдет, а какая — нет.
-
Проведем сравнение двух легких сетей.
-
Обсудим периодические функции в глубоких сетях
-
Проведем сравнение двух глубоких сетей.
-
Разберем, где периодические функции можно использовать, а где нет.
-
Подведем итоги.
Рассмотрим мысль поближе
Как я говорил ранее, архитектура Looped Transformer циклична. А что, если по аналогии с данной архитектурой заменить любую нелинейную функцию на периодическую — ведь она тоже циклична? Важное отличие: Looped Transformer циклична с точки зрения [5] итеративности, а периодические функции — с точки зрения повторяемости значений через период. Но между этими понятиями есть определённая связь. Далее сосредоточимся на основном предмете статьи, а не на устройстве Looped Transformer.
Сразу хочу сказать, что при использовании периодических функций в нейросетях есть как свои плюсы, так и свои минусы. Ниже я разобрал плюсы и минусы и подвёл краткий итог.
Плюсы:
-
Первое, что я хочу сказать в пользу периодических функций – их градиент. В отличие от гиперболического тангенса, они не затухают с возрастанием входных значений, всегда давая модели возможность учиться.
-
Второй, не менее важный плюс – их периодичность, которая позволяет удерживать выходные значения в норме (например, [-1; 1] для sin или cos), при этом не насыщаться на огромных входных значениях. Также, периодические функции заставляют модель «прорисовывать» активацию буквально точка за точкой по периоду — ей приходится точно настраивать веса, чтобы попасть в нужные значения. В отличие от tanh, у неё нет лазейки: tanh при больших входах насыщается, градиент падает почти до нуля, и модель может «спрятаться» в этой мёртвой зоне. Периодическая функция такой возможности не даёт — она продолжает реагировать [6] на изменения весов. Это дает возможность учить более сложные зависимости.
Минусы:
-
Если ваша сеть является глубокой, использование периодической функции создает дополнительную задачу — убедиться в том, что входные в нее значения стабильные и не будут взрываться или “скакать”. Рассмотрим немного позже, в модуле “Периодические функции в глубоких сетях”.
Итог:
Давайте посмотрим на вектор a⃗ = (-6;0;1;8). Если мы подадим его как вход в гиперболический тангенс, то мы получим следующую картину:
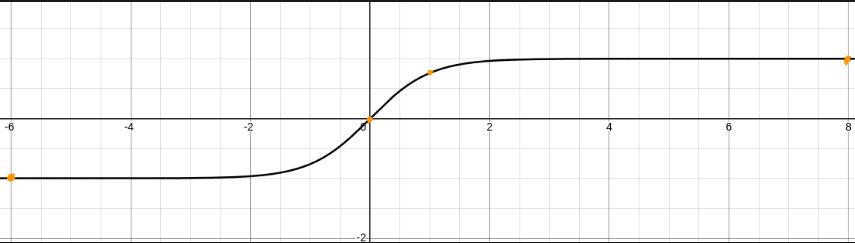
Мы видим, что он насытился в точках -6 и 8. Градиент по ним будет мелкий, и с высокой вероятностью они утратят возможность обучаться. Но, если мы подадим вектор a⃗ как вход в синус, то мы увидим более лучшую картину:
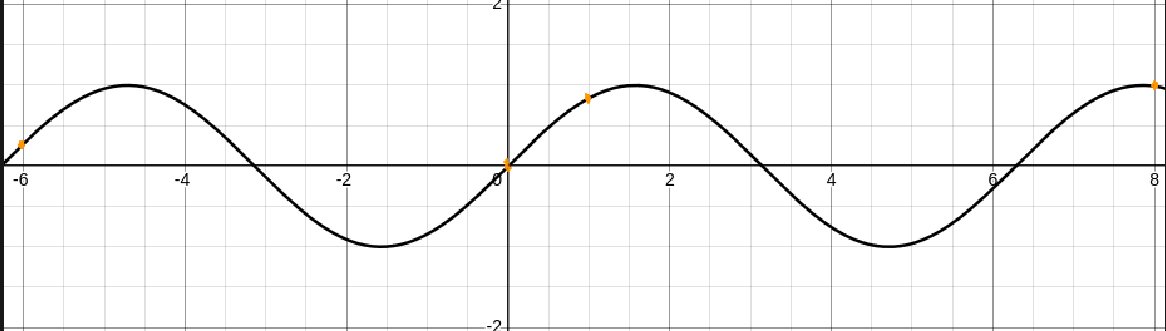
Тут градиенты ненулевые, способность обучаться остается. Выходы также находятся в стабильном диапазоне [-1;1], что является плюсом.
Итак, периодические функции дают модели более богатую выразительную способность и не затухающий градиент, но в очень глубоких сетях их спектр и градиенты трудно контролировать, что ведёт к шуму и проблемам оптимизации.
Разновидности периодических функций: что берем, а что — нет
Периодических функций немало: есть и cos (косинус), и sin (синус), и tan (тангенс), cot (котангенс), sec (секанс) и csc (косеканс) — и это ещё не все! Вы просто представьте, как их много!
Но в нейросетях нельзя просто взять «левую» функцию из этого огромного списка. Важно учитывать диапазон выходных значений, плавность функции, её производную и многое другое. Например, про tan (тангенс) и cot (котангенс) мы сразу можем сказать, что для нейросетей — это плохая идея. Во-первых, посмотрите на их график:
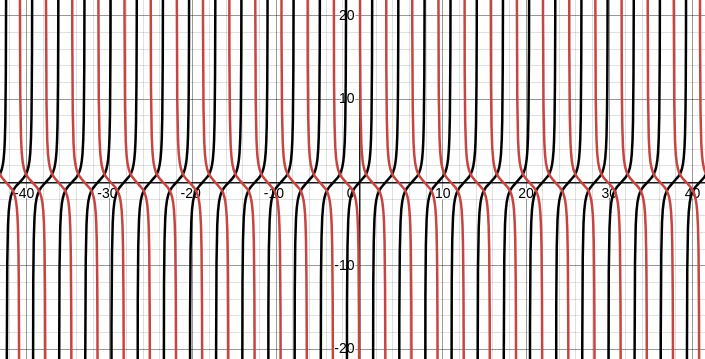
Сразу заметим, что выходные значения стремятся к ± бесконечности при некоторых значениях x и быстро улетают вверх. В нейросетях такая функция убийственно опасна для градиентов: может появиться NaN, тем самым убив обучение. То же самое с sec (секанс) и csc (косеканс):
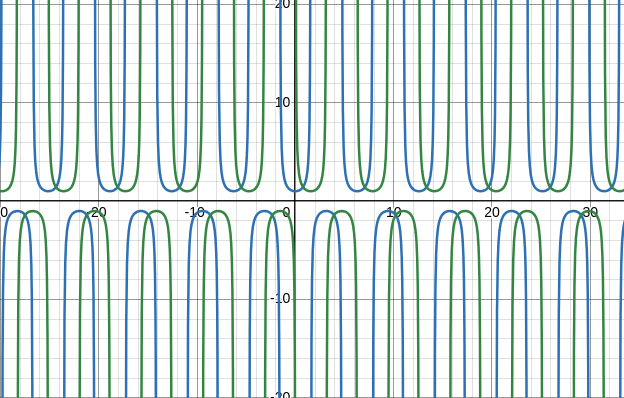
Тут ситуация даже немного хуже, чем с тангенсом и котангенсом. Мы наблюдаем, что выходные значения растут так же быстро, достигая при некоторых значениях x ± бесконечности. Это, как мы говорили выше, убьёт обучение. Но ситуация с синусом и косинусом — другая:
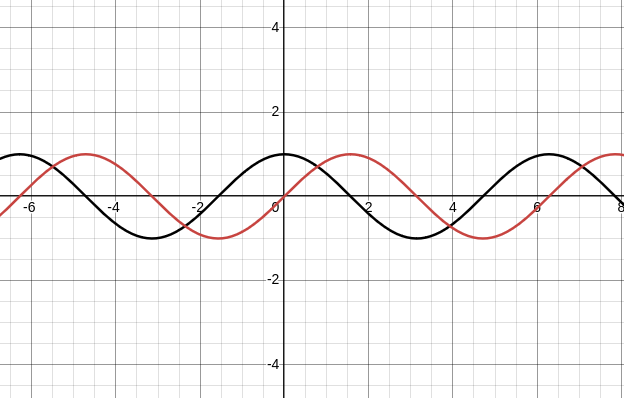
Идеально. Как мы и хотели: функция периодическая, выходные значения в стабильном для нейросетей диапазоне — [−1; 1], градиенты не уходят в NaN. Отличия для нейросетей между этими функциями в основном в том, что косинус более симметричен относительно нуля, чем синус (это можно увидеть на графике).
Давайте сделаем вывод. Периодические функции, хоть и обладают очень весомыми плюсами, некоторые из них могут быть опасными для обучения. Нельзя сказать однозначно, что все периодические функции подходят. Перед обучением я лично советую вам зайти в графический онлайн-калькулятор и посмотреть на график периодической функции, которую вы собираетесь использовать.
Сравнение двух простых сетей
Давайте сравним две простые сети:
-
Attention-подобная сеть с гиперболическим тангенсом
-
Attention-подобная сеть с синусом
Написал код на Python для сравнения двух моделей (прошу прощения, если он не грамотно оформлен):
import torch
import torch.nn as nn
import random
from torch.utils.data import DataLoader, Dataset

class NNT(nn.Module):
    def __init__(self):
        super().__init__()
        self.embeding = nn.Embedding(10, 16)
        self.Linear = nn.Linear(16, 32)
        self.Linear2 = nn.Linear(16,32)
        self.Linear3 = nn.Linear(16, 16)
        self.linear_out = nn.Linear(16, 4)
        self.func = nn.Tanh()
    def forward(self,x):
        x = self.embeding(x)
        x1 = self.Linear(x)
        x2 = self.Linear2(x).transpose(-1,-2)
        x3 = self.Linear3(x)
        x = self.func(x1@x2)
        x = x@x3
        x = self.linear_out(x)
        return x[:,-1,:]
class NN(nn.Module):
    def __init__(self):
        super().__init__()
        self.embeding = nn.Embedding(10, 16)
        self.Linear = nn.Linear(16, 32)
        self.Linear2 = nn.Linear(16,32)
        self.Linear3 = nn.Linear(16, 16)
        self.linear_out = nn.Linear(16, 4)
    def forward(self,x):
        x = self.embeding(x)
        x1 = self.Linear(x)
        x2 = self.Linear2(x).transpose(-1,-2)
        x3 = self.Linear3(x)
        x = torch.sin(x1@x2)
        x = x@x3
        x = self.linear_out(x)
        return x[:,-1,:]

class dataset(Dataset):
    def __len__(self):
        return 10000
    def __getitem__(self, index):
        inpts = []
        out = 0
        for _ in range(5):
            inpts.append(random.randint(0,9))
        nout = 1
        for i in inpts:
            nout = nout*i
        if nout > 100:
            out = 0
        elif 100 > nout < 50:
            out = 1
        elif 0 < nout < 50:
            out = 2
        elif nout == 0:
            out = 3
        return torch.tensor(inpts), torch.tensor(out)
class accset(Dataset):
    def __len__(self):
        return 1
    def __getitem__(self, index):
        inpts = []
        out = 0
        for _ in range(5):
            inpts.append(random.randint(0,9))
        nout = 1
        for i in inpts:
            nout = nout*i
        if nout > 100:
            out = 0
        elif 100 > nout < 50:
            out = 1
        elif 0 < nout < 50:
            out = 2
        elif nout == 0:
            out = 3
        return torch.tensor(inpts), torch.tensor(out)
dataset = dataset()
dataset = DataLoader(dataset, batch_size=64)
accset = accset()
accset = DataLoader(accset, batch_size=64)
model = NN()
model2 = NNT()
trnr = torch.optim.SGD(model.parameters(), lr=0.001)
trnr2 = torch.optim.SGD(model2.parameters(), lr=0.001)
ce = nn.CrossEntropyLoss()
for i in range(100):
    itr = 0
    errf = 0
    acc = 0
    errf2 = 0
    acc2 = 0
    for ix,xi in dataset:
        otv = model(ix)
        err = ce(otv, xi)
        trnr.zero_grad()
        err.backward()
        trnr.step()
        errf += err.item()
        itr += 1
        otv = model2(ix)
        err = ce(otv, xi)
        trnr2.zero_grad()
        err.backward()
        trnr2.step()
        errf2 += err.item()
        itr += 1
        with torch.no_grad():
            model.eval()
            for ix, xi in accset:
                otv = model(ix)
                err = ce(otv, xi)
                acc += err.item()
            model.train()
            model2.eval()
            for ix, xi in accset:
                otv = model2(ix)
                err = ce(otv, xi)
                acc2 += err.item()
            model2.train()
        if itr % 100 == 0:
            print(f'EPOCH: {i} n [SIN]| LOSS: {errf/100} | VAL_LOSS: {acc/100}n[TANH] | LOSS: {errf2/100} | VAL_LOSS: {acc2/100}')
            acc = 0
            errf = 0
            acc2 = 0
            errf2 = 0
Так как вывод получился большим, я покажу его отрезками (также, немного почистил вывод для аккуратности):
EPOCH: 0
  [SIN]  LOSS: 0.625153545141220  VAL_LOSS: 0.6692562925815583
  [TANH] LOSS: 0.570297715663910  VAL_LOSS: 0.5202550455927849
EPOCH: 2
  [SIN]  LOSS: 0.425748145580291  VAL_LOSS: 0.3828628628700972
  [TANH] LOSS: 0.318564990758895  VAL_LOSS: 0.3276974935084581
EPOCH: 4
  [SIN]  LOSS: 0.268293462693691  VAL_LOSS: 0.3105708013474941
  [TANH] LOSS: 0.217715777158737  VAL_LOSS: 0.1801781963557004
EPOCH: 6
  [SIN]  LOSS: 0.150961394459009  VAL_LOSS: 0.1292178003303706
  [TANH] LOSS: 0.163014921247959  VAL_LOSS: 0.1515910577028990
EPOCH: 8
  [SIN]  LOSS: 0.110841303020715  VAL_LOSS: 0.0904882042435929
  [TANH] LOSS: 0.134534047693014  VAL_LOSS: 0.1465282635961193
EPOCH: 10
  [SIN]  LOSS: 0.077621582895517  VAL_LOSS: 0.0822396780119743
  [TANH] LOSS: 0.101415519118309  VAL_LOSS: 0.0865053286845795
EPOCH: 20
  [SIN]  LOSS: 0.034723242036998  VAL_LOSS: 0.0460810497711645
  [TANH] LOSS: 0.045202526673674  VAL_LOSS: 0.0228022014122689
EPOCH: 30
  [SIN]  LOSS: 0.025092132408171  VAL_LOSS: 0.0248953375596102
  [TANH] LOSS: 0.032410152349621  VAL_LOSS: 0.0237012546163532
EPOCH: 40
  [SIN]  LOSS: 0.018362972959876  VAL_LOSS: 0.0118060966429038
  [TANH] LOSS: 0.023608845956623  VAL_LOSS: 0.0325171568638143
EPOCH: 100
  [SIN]  LOSS: 0.019116567075252  VAL_LOSS: 0.0081796115541874
  [TANH] LOSS: 0.027363810557872  VAL_LOSS: 0.0257659442291776
Наблюдаем следующую картину: сеть с гиперболическим тангенсом в качестве функции активации поначалу лидирует, затем она уступает место сети с синусом. Скорее всего, это связано с тем, что градиент начал где-то затухать. У гиперболического тангенса, как мы говорили ранее, это более выражено, так как формула производной у него:

И она затухает при всё больших значениях x агрессивно. Давайте лучше посмотрим её график:
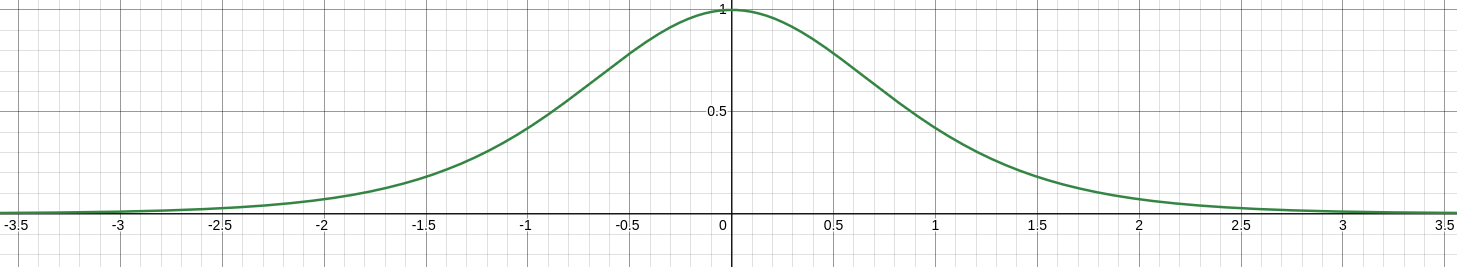
У синуса же все наоборот. У него производная периодическая, и она не затухает “навсегда”. Просто давайте посмотрим на формулу производной синуса:

И заодно на ее график:
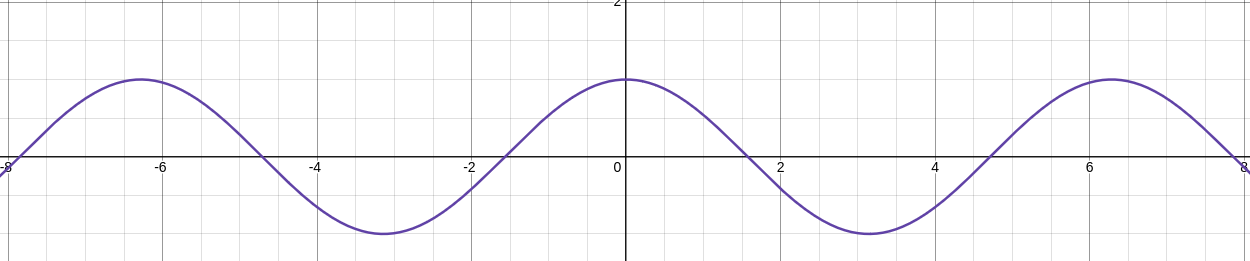
Видно, что производная не тухнет “навсегда”. Если честно, очень жирный плюс.
Это преимущество, скорее всего, является одной из причин, почему сеть с синусом в качестве функции активации на последних эпохах лидирует: веса, возможно, стали большими, матричное умножение начало насыщать входные значения гиперболического тангенса — и всё остановилось.
Периодические функции в глубоких сетях.
Сейчас мы затронем очень важную тему, а именно — поведение [7] периодических функций в глубоких сетях. Думаю, рассматривать мы будем это долго, ибо глубокие сети – это не простые, где можно разобрать маленькую сеть в голове.
Давайте возьмем сеть, аналогичную нашей простой, но более глубокую:
import torch
import torch.nn as nn
class Func(nn.Module):
    def forward(self, x):
        # return torch.sin(x)
        # Или
        # return nn.Tanh()(x)
        # Буду подставлять в ходе действий
class NN(nn.Module):
    def __init__(self):
        super().__init__()
        self.embeding = nn.Embedding(10, 16)
        self.Linear = nn.Sequential(
            nn.Linear(16, 32),
            Func(),
            nn.Linear(32, 64),
            Func(),
            nn.Linear(64, 32),
            Func()
        )
        self.Linear2 = nn.Sequential(
            nn.Linear(16, 32),
            Func(),
            nn.Linear(32, 64),
            Func(),
            nn.Linear(64, 32),
            Func()
        )
        self.Linear3 = nn.Sequential(
            nn.Linear(16, 32),
            Func(),
            nn.Linear(32, 64),
            Func(),
            nn.Linear(64, 32),
            Func(),
            nn.Linear(32, 16),
            Func()
        )
        self.linear_out = nn.Sequential(
            nn.Linear(16, 32),
            Func(),
            nn.Linear(32, 64),
            Func(),
            nn.Linear(64, 32),
            Func(),
            nn.Linear(32, 16),
            Func(),
            nn.Linear(16, 4)
        )
    def forward(self,x):
        x = self.embeding(x)
        x1 = self.Linear(x)
        x2 = self.Linear2(x).transpose(-1,-2)
        x3 = self.Linear3(x)
        x = torch.sin(x1@x2)
        x = x@x3
        x = self.linear_out(x)
        return x[:,-1,:]
Довольно глубокая сеть у нас получилась. Тут я уже буду обсуждать и делать больший упор внимания [8] на градиенты, т.к. в глубоких сетях с ними проблемы. Но и про другое забывать [9] не буду, например — После теории также сравним две модели — глубокую с синусом и глубокую с гиперболическим тангенсом.
Даже не знаю, с чего начать. Ну, давайте начнем с градиентов.
Мы знаем, что в глубоких сетях есть распространенная проблема — затухание или взрыв градиентов, в общем — нестабильность градиента. Эта нестабильность появляется из-за, допустим, больших значений RMS в активациях, что вызывает затухание. Или, например, маленький RMS перед RMS Norm может создать проблему взрыва градиента (из-за множителя 1/RMS). А эти значения, как правило, сложнее контролировать и удерживать нормальными с увеличением глубины сети (без насыщений в функциях активации, со стабильными значениями).
Например, гиперболический тангенс может насытиться, затушив градиент. Или наоборот — выдавать максимальный градиент и мелкие выходные значения, что в некоторых случаях (например, из-за RMS Norm перед следующим слоем) может усугубить ситуацию и привести к взрыву градиентов.
Но когда входные и выходные значения стабильны и имеют RMS около единицы — это в большинстве случаев спасает сеть от взрыва или затухания градиентов. Однако, как я говорил выше, чем глубже сеть, тем сложнее удержать стабильность значений. Если, допустим, мы поставим гиперболический тангенс (он же сжимает значения в [−1;1], что дает RMS около единицы), то он может легко создать затухание градиента при, скажем, большом сдвиге весов сети или, например, единичном выбросе огромного значения в наш вектор, который пойдет в этот гиперболический тангенс.
В случае, когда мы заменяем любую нелинейную функцию активации на периодическую (например, косинус или синус), мы получаем более стабильную сеть (т.к. значения находятся в ограниченном диапазоне, а производная не «насыщается», в отличие от гиперболического тангенса).
Это происходит благодаря самой периодичности, которая дает, во-первых, стабильность выходных значений, независимо от того, какое значение по модулю подано на вход. Имею в виду, что гиперболический тангенс очень чувствителен к этому и насыщается, а периодическая функция — нет. Во-вторых, производная у периодической функции тоже периодическая. И здесь не важно, является ли функция гладкой; любая периодическая функция, которая не имеет «насыщаемого» конца, а зеркалит себя и имеет периодическую производную. Например, у гиперболического тангенса производная быстро становится нулем, а у косинуса производная не имеет “жесткого” конца в ноль. Мягко говоря, производная периодической функции никогда не фиксируется в одно значение навсегда, например, как у гиперболического тангенса или у сигмоиды (кроме случаев, когда функция является константой, что тоже можно считать вырожденным случаем периодичности).
Благодаря этому сеть получает шанс учиться дальше. Разумеется, это зависит от конкретной функции; в данном случае мы говорим про синус и косинус.
У меня есть такая гипотеза, что градиент от периодической функции не имеет шум больше, чем от гиперболического тангенса. Я так начал думать только тогда, когда увидел график синуса, наложенный на график гиперболического тангенса:
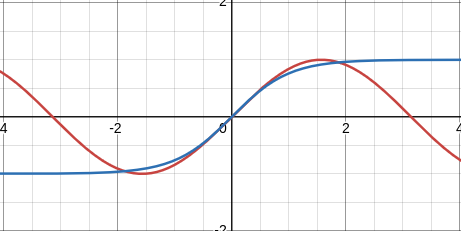
Для стабильных значений (когда входные данные не огромны) синус (или косинус, но в основном мы рассматриваем синус) не ведёт себя хаотично. У него плавная производная и плавные переходы — прямо как у гиперболического тангенса на графике, за исключением его «хвостов». Вспомним, что синус периодичен, и его график будет совпадать с графиком гиперболического тангенса через раз (раз — график tanh, два — график −tanh, три — снова tanh и так далее).
Самое главное и ключевое: при стабильных весах, когда нет взрывов и резко меняющихся значений, градиент синуса не такой шумный, каким он был бы при резких скачках входных данных. Из-за периодичности синус при резком скачке может сильно «дёрнуться» и резко сменить выходное значение, создав шумный градиент. А гиперболический тангенс в такой ситуации, скорее всего, просто насытился бы.
Не менее важное дополнение: есть шанс (хоть и маленький), что при таком скачке входного значения синуса его выходное значение окажется именно таким, какое нужно для правильного, не шумного градиента.
Делаем вывод: если мы хотим использовать периодическую функцию в глубоких сетях, очень важно убедиться в стабильности поступающих в неё входных значениях, также в стабильности предыдущих слоев и активаций. Иначе, как говорилось выше, она просто «перескачет».
Вроде-бы мы разобрались с периодическими функциями в глубоких сетях. Сейчас мы сравним лоб-в-лоб две глубокие сети – одна с гиперболическим тангенсом, вторая с синусом.
Сравнение двух глубоких сетей.
Код для сравнения был взят из модуля “Сравнение двух простых сетей”, но с архитектурой глубокой сети из модуля “Периодические функции в глубоких сетях”.
Запустив его, я получил результаты. Можете на них взглянуть:
EPOCH: 0
  [SIN]  LOSS: 0.624842579364776  VAL_LOSS: 0.6247314512729645
  [TANH] LOSS: 0.668855265378952  VAL_LOSS: 0.6763675808906555
EPOCH: 2
  [SIN]  LOSS: 0.5840543174743652 VAL_LOSS: 0.5763820600509644
  [TANH] LOSS: 0.6401820981502533 VAL_LOSS: 0.6300999116897583
EPOCH: 6
  [SIN]  LOSS: 0.5178782904148101 VAL_LOSS: 0.5313001906871796
  [TANH] LOSS: 0.5893145608901977 VAL_LOSS: 0.5990010929107666
EPOCH: 8
  [SIN]  LOSS: 0.4919031250476837 VAL_LOSS: 0.4819188302755355
  [TANH] LOSS: 0.5670799422264099 VAL_LOSS: 0.5509801584482193
EPOCH: 10
  [SIN]  LOSS: 0.4704611134529113 VAL_LOSS: 0.4747267186641690
  [TANH] LOSS: 0.5468785238265991 VAL_LOSS: 0.5404656243324280
EPOCH: 20
  [SIN]  LOSS: 0.4047175270318985 VAL_LOSS: 0.4057970201969140
  [TANH] LOSS: 0.4653988617658615 VAL_LOSS: 0.4666895228624340
EPOCH: 30
  [SIN]  LOSS: 0.3800671291351318 VAL_LOSS: 0.3783280897140503
  [TANH] LOSS: 0.4177939587831497 VAL_LOSS: 0.4284683382511139
EPOCH: 40
  [SIN]  LOSS: 0.3661166733503341 VAL_LOSS: 0.3720418882369995
  [TANH] LOSS: 0.3880735290050506 VAL_LOSS: 0.3800842720270156
EPOCH: 99
  [SIN]  LOSS: 0.3458011263608933 VAL_LOSS: 0.3593702882528305
  [TANH] LOSS: 0.3483378905057907 VAL_LOSS: 0.3554814624786377
Мы наблюдаем, что сеть с синусом значительно лучше обучалась в начале, а к концу, как и сеть с гиперболическим тангенсом, вышла на плато. Это также может быть связано с затуханием градиента в этой глубокой сети. Если посмотреть на результаты в конце модуля «Сравнение двух простых сетей», можно увидеть, что там всё прошло гладко. Здесь, скорее всего, проблема с градиентами усилилась из-за глубины сети. Если честно — я был несколько расстроен, увидев такие результаты..
И да, я был прав. Некоторые слои получали градиент меньше, чем 6.8345e-05 (без учёта умножения на lr). А так как это голый SGD, то эффективный шаг у него grad*lr. Я запустил обучение, увеличив lr с 0.001 до 0.1, и получил прекрасную картину:
EPOCH: 0
  [SIN]  LOSS: 0.4282208263874054 VAL_LOSS: 0.4279021078348159
  [TANH] LOSS: 0.4485434007644653 VAL_LOSS: 0.4383033233880997
EPOCH: 2
  [SIN]  LOSS: 0.1039599910750985 VAL_LOSS: 0.0516232780925929
  [TANH] LOSS: 0.1009371670149266 VAL_LOSS: 0.0528345651179552
EPOCH: 4
  [SIN]  LOSS: 0.0255658515729010 VAL_LOSS: 0.0323567000590264
  [TANH] LOSS: 0.0175351749313995 VAL_LOSS: 0.0381937821139581
EPOCH: 19
  [SIN]  LOSS: 0.0078047137591056 VAL_LOSS: 0.0031145263195503
  [TANH] LOSS: 0.008290578291052  VAL_LOSS: 0.0109428699011914
Видим картину, сопоставимую с результатом обучения и сравнения двух простых сетей. Объяснять, почему сеть с синусом в конце достигает результатов лучше, чем с гиперболическим тангенсом я не буду, так как я описывал это ранее, в конце модуля “Сравнение двух простых сетей”.
Это как раз подтверждает то, что в глубоких сетях проблема с градиентом более выражена, чем в простых. Заметим, что глубокая сеть обучилась только с lr=0.1, когда простая — с lr=0.001 без проблем.
Пойдем дальше — и определим, в каких задачах периодические функкции активации выигрывают другие, а в каких – наоборот.
Периодические функции – где можно, где нельзя?
Ответ будет хоть и резкий, но это действительно скорее всего так:
Периодические функции можно использовать везде — хоть в задаче генерации текста, хоть в глубокой сети, хоть в компьютерном зрении (CV). Единственное их фундаментальное ограничение — входные данные должны быть стабильными и не «скакать» туда-сюда. При соблюдении этого условия они не хуже классических активаций.
Они нужны там, где:
-
Есть проблема с градиентами.
-
Нужен больший шанс на корректное обучение.
При условии, что:
-
Все входные значения нормированы и не скачут туда-сюда.
Они помешают там, где:
-
Нестабильные входные значения.
-
Не нужна периодичность.
Итоги
Сегодня в этой статье мы рассмотрели кандидатуру периодических функций в качестве активаций в нейросетях. Статья получилась довольно содержательной: мы провели два полноценных сравнения (на простых и на глубоких сетях), проанализировали поведение [10] градиентов и вывели несколько важных условий, при которых периодические функции можно использовать без риска для обучения.
Главный вывод: периодические активации — это не просто математическая экзотика, а перспективный инструмент. Они дают модели более богатый градиент и спасают от затухания в глубоких слоях, но требуют к себе бережного отношения (стабилизации входов).
Автор: radmirryan
Источник [11]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37672
URLs in this post:
[1] математики: http://www.braintools.ru/article/7620
[2] обучения: http://www.braintools.ru/article/5125
[3] GPT-6 Astra: https://habr.com/ru/companies/gptunnel/articles/1078774/
[4] цикличность: http://www.braintools.ru/article/7590
[5] зрения: http://www.braintools.ru/article/6238
[6] реагировать: http://www.braintools.ru/article/1549
[7] поведение: http://www.braintools.ru/article/9372
[8] внимания: http://www.braintools.ru/article/7595
[9] забывать: http://www.braintools.ru/article/333
[10] поведение: http://www.braintools.ru/article/5593
[11] Источник: https://habr.com/ru/articles/1100598/?utm_campaign=1100598&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.