Я встроил процессор RISC-V в веса Qwen 3.5, а памятью ему стали слои DeltaNet
Это правда не кремний
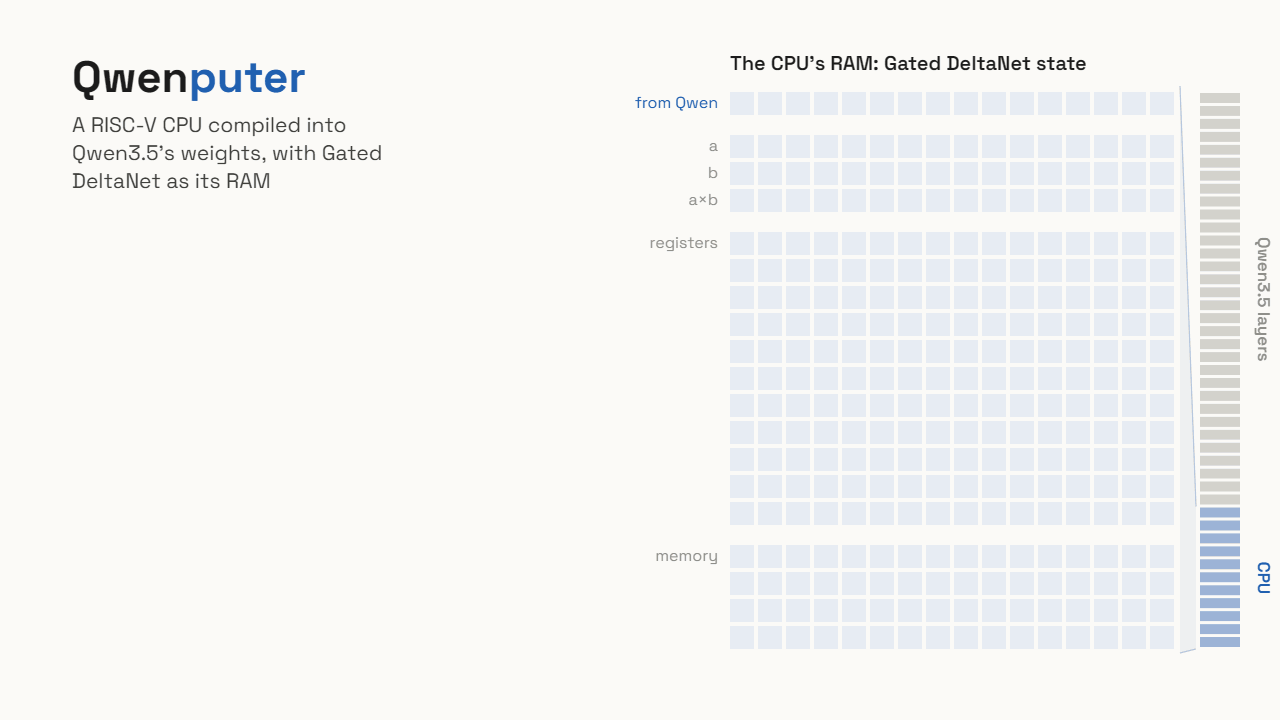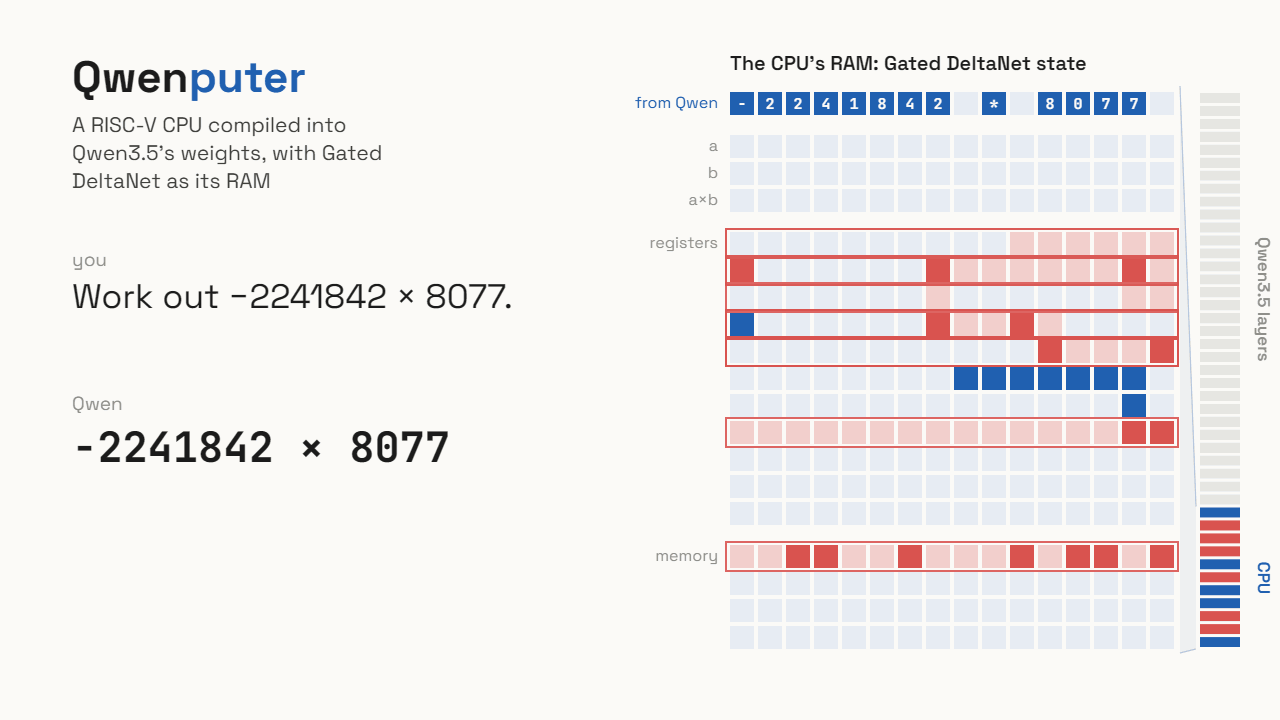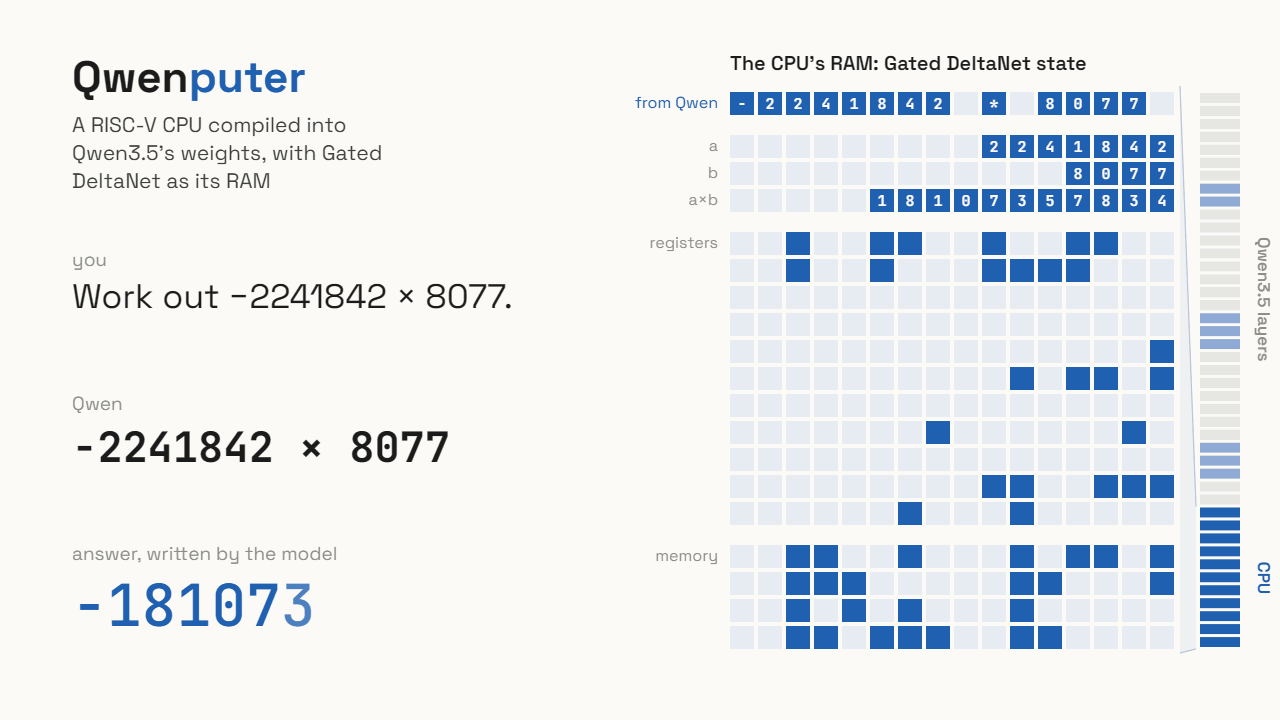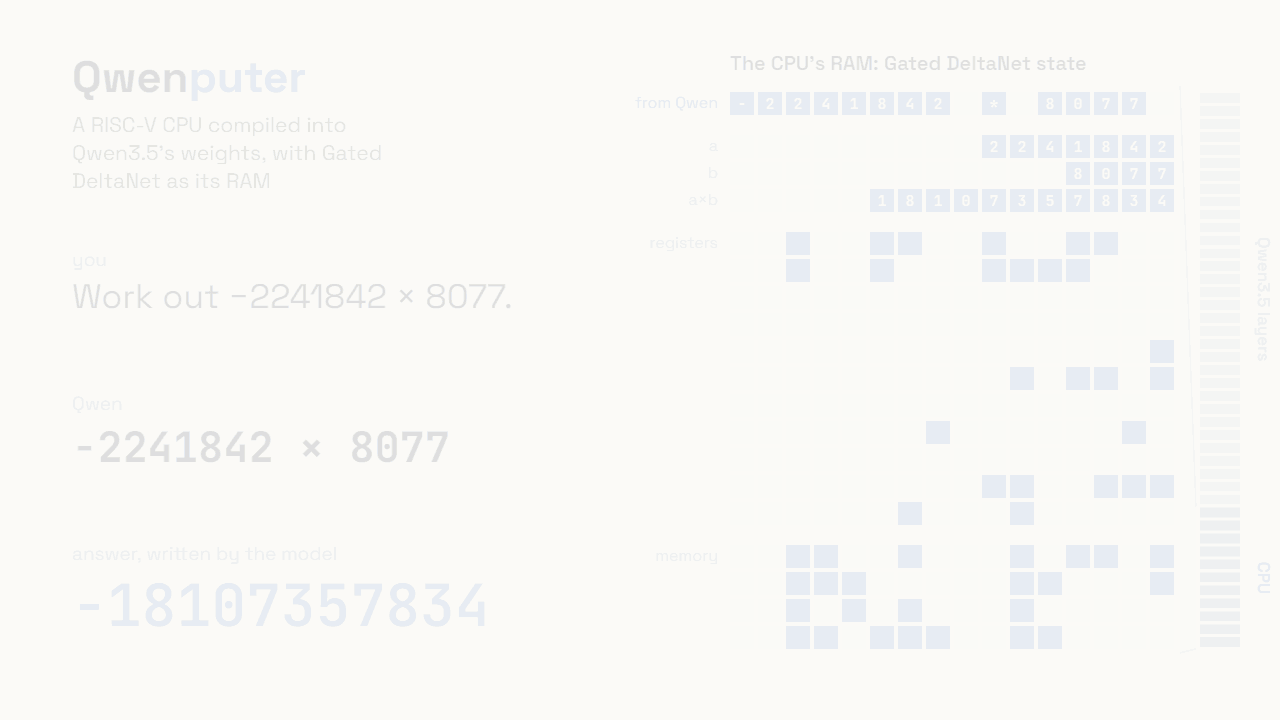
Qwenputer — довольно забавная экспериментальная модель. Это обычная Qwen 3.5 4B с одним дополнением: в её весах живёт процессор RISC-V, а оперативной памятью [1] ему служат собственные слои внимания [2] модели, Gated DeltaNet. (Как устроен GDN, я объяснял в отдельном руководстве [3].) Этот «процессор» работает целиком внутри прямых проходов модели и умеет выполнять арифметику, код на C и MicroPython без всякой внешней среды исполнения и без вызова инструментов.
Скажу сразу: это не плагин, не инструмент и не песочница. Ниже я подробно разберу, как модель работает, как она использует слои GDN в качестве оперативной памяти и как я заодно прикрутил к ней экспериментальное файловое хранилище прямо внутри модели.
На основе Qwenputer я написал ещё два текста: о том, как гибридные модели могут научиться прятать рассуждения в состоянии RNN и обходить мониторинг цепочки рассуждений [4], и о том, как скомпилированные веса вроде этих могут служить встроенными инструментами мониторинга, в работу которых модель сама не может вмешаться [5].
Скачать Qwenputer можно с Hugging Face [6] или ModelScope [7], код лежит на GitHub [8].
RNN внутри Qwen 3.5 может быть точной памятью
В Qwen3-Next и Qwen 3.5 (на ней построен Qwenputer) есть изящный приём. Три из четырёх слоёв внимания используют в качестве механизма внимания Gated DeltaNet — линейную RNN (подробнее здесь [3]). Каждая голова хранит матрицу состояния, а дельта-правило её обновляет.
С этого и начинается наш эксперимент. Я обнаружил, что если выставить гейт в 1¹, силу записи (beta) в 1² и кодировать ключи one-hot³, то каждая запись перезаписывает ровно одну строку, а каждый one-hot-запрос возвращает точное значение. Значит, слои GDN сами по себе могут работать как настоящая оперативная память, причём гораздо дешевле, чем обычное внимание в этой роли: состояние головы GDN не растёт, сколько бы ни длился разговор, в отличие от KV-кэша у обычного внимания.
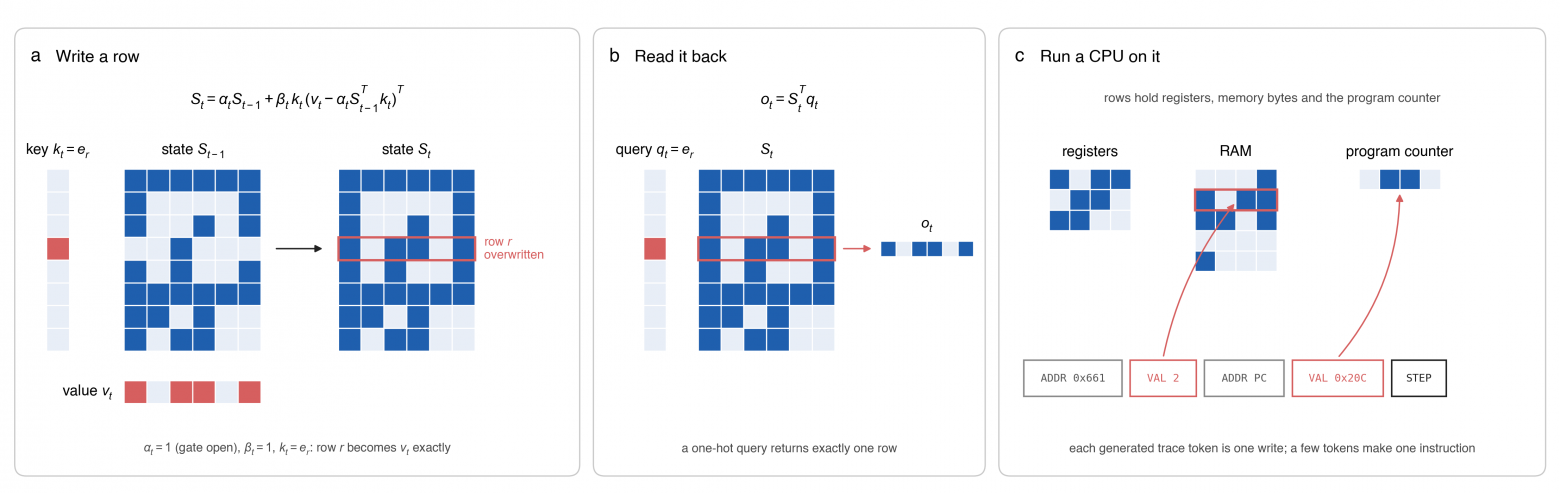
Сама мысль, что дельта-правило работает как память, не нова: Шлаг и соавторы (2021) показали, что линейное внимание с дельта-правилом ведёт себя как ассоциативная память, или «быстрые веса»⁴. Новое здесь в другом: память стала точной и адресуемой, внутри рабочей модели, и настолько надёжной, что на ней работает целый процессор.
На этом фундаменте построена вся модель. Штатная Qwen 3.5 точных значений в GDN не хранит. Наша модификация открывает дорогу к следующей части эксперимента.
Компилируем компьютер в слои
Раз у нас теперь есть полноценная, дешёвая и быстрая оперативная память, можно скомпилировать в веса модели работающий процессор. К счастью, обучение [9] для этого не нужно: каждый вес выставляет компилятор. Процессор описывается как схема, длинный список мелких шагов вроде «прочитать этот регистр», «сложить два числа» или «перейти, если ноль», и компилятор превращает каждый шаг в кусочек слоя трансформера. Головы внимания выполняют поиск, блоки прямого распространения считают арифметику, а головы DeltaNet хранят память. Процессор работает, пока модель декодирует.
Каждая инструкция превращается в несколько сгенерированных токенов: первый называет строку памяти для записи (ADDR), следующий несёт значение (VAL), а токен STEP завершает инструкцию. Эти токены и есть трасса исполнения процессора: пока Qwen их генерирует, процессор действительно работает.
Процессор
Это 32-битное ядро RISC-V (RV32IM плюс расширение Zba и небольшой блок для арифметики больших чисел). Оно занимает 11 слоёв перед 32 слоями самой Qwen. Сейчас ядро проходит официальные riscv-tests, результаты его программ совпадают с qemu, и оно отработало 18 миллионов инструкций в свободном режиме без единой ошибки⁵.
Код на C и MicroPython этот процессор тоже выполняет в прямых проходах вполне прилично, хотя и медленно. Это пока не процессор уровня, достаточного для Linux, но набор инструкций RV32IM он реализует полностью.
Как Qwen им пользуется
Qwen 3.5 4B неплохо справляется с этим процессором без всякого дообучения. Процессор используется целиком изнутри, а не через внешние вызовы инструментов.
Чтобы модель пользовалась им надёжно, я пошёл дешёвым путём и подцепился к формату вызова инструментов, на котором модели хорошо натренированы: через него Qwen отправляет процессору инструкции и считывает результат. Никаких внешних вызовов инструментов и никакой внешней среды исполнения. Получив инструкции, процессор запускает свои слои, а затем сам пишет ответ инструмента. Небольшой драйвер RvChat загружает прошивку в состояние GDN и не пускает токены трассы в слои Qwen.
Исходные веса Qwen остаются в точности такими, какими были. Веса компьютера добавлены поверх них, в дополнительных измерениях и слоях.
А это вообще работает?
Наверное, после всех моих разглагольствований вас интересует главный вопрос: работает ли это на самом деле?
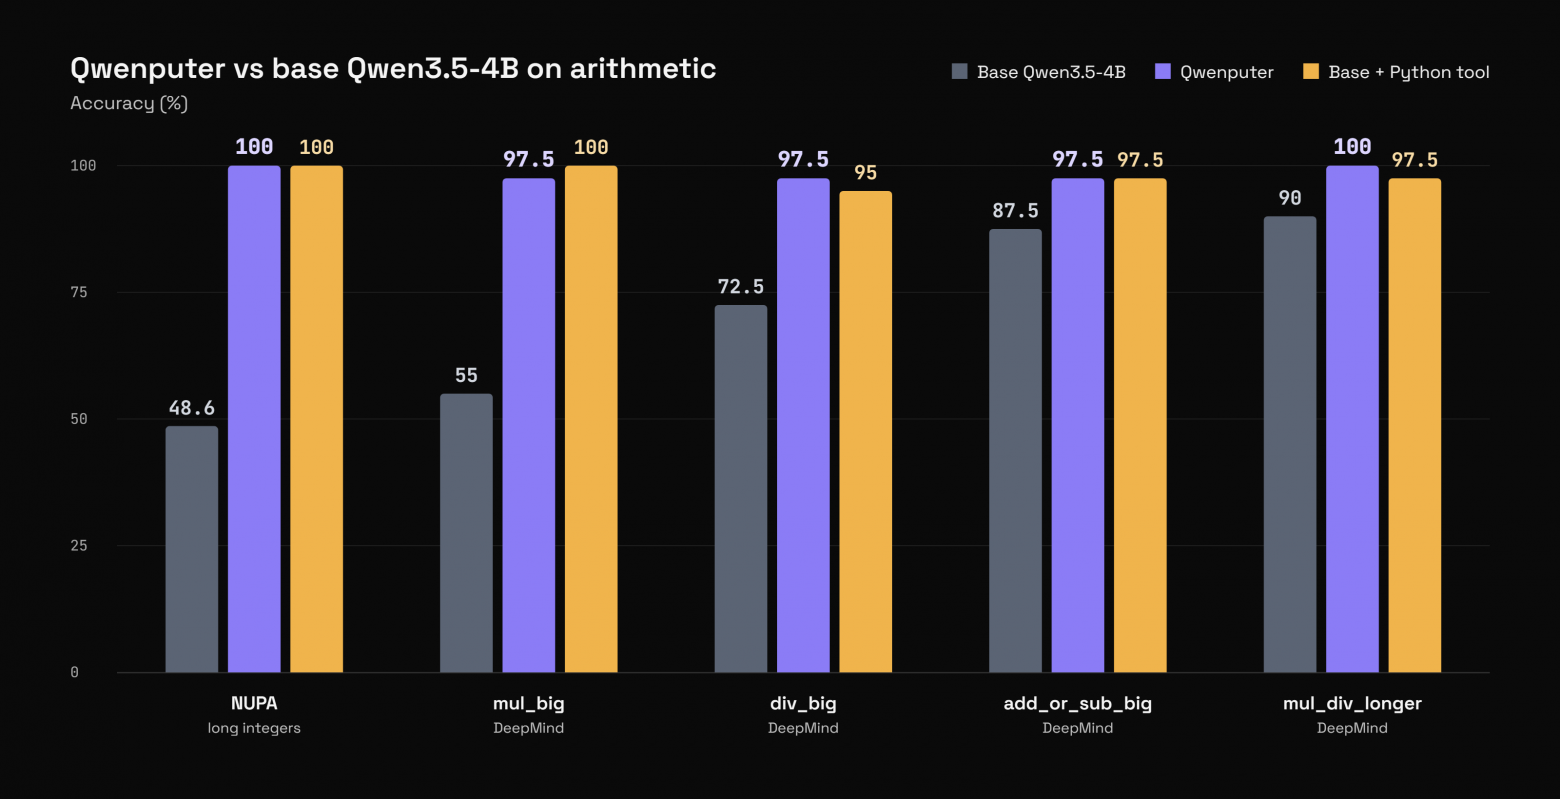
На наборах DeepMind:
-
div_big: у Qwenputer 97,5% против 95% у Qwen 3.5 4B с инструментом Python и 72,5% у базовой Qwen;
-
mul_big: у Qwenputer 97,5% против 100% с инструментом Python и 55% у базовой Qwen;
-
mul_div_multiple_longer: у Qwenputer 100% против 97,5% с инструментом Python и 90% у базовой Qwen;
-
add_or_sub_big: у Qwenputer 97,5%, столько же с инструментом Python и 87,5% у базовой Qwen.
На арифметике длинных целых из NUPA Qwenputer поднимается с 48,6% до 100%, ровно как Qwen с инструментом Python.
Числа, которые печатает процессор, ещё и точные: я сверил с эталонной машиной около 230 000 позиций его вывода и не нашёл ни одного расхождения. А пристёгнутый к Qwen компьютер не меняет того, как она говорит: обычный текст остаётся в пределах шума относительно базовой Qwen (KL 6e-4 при уровне шума 5e-4).
Жёсткий диск? При нынешних-то ценах?
Процессора внутри языковой модели было явно маловато для проклятой затеи, поэтому я решил, что благоразумно будет дать ей ещё и файловую систему.
Раз рабочая оперативная память уже есть, это оказалось в основном тривиально. Со стороны модели доступны внутренние операции put / append / get / list / delete. И снова никаких настоящих вызовов инструментов. Когда Qwen «сохраняет» файл, скомпилированные слои хешируют его имя в один из 1024 слотов каталога, который хранится в состоянии DeltaNet, а сам текст кладут в другие головы, по восемь токенов на строку, цепочкой. Если два имени попадают в один слот, просто проверяется следующий. Найти файл снова удаётся примерно за два-три шага вместо полного перебора. Всего помещается до 512 файлов, это около 53 000 токенов текста.
Забавно, что файлы переживают конец разговора. Состояние можно сохранить в конце разговора, загрузить в следующий, и файлы останутся на месте. С этой файловой системой Qwen правильно называет факты, изменившиеся между чатами, в 90% случаев против 30%, если просто вставить старые чаты обратно в контекст, и держится наравне с инструментами памяти на Python (83,3% против 78,9%). Эта часть пока экспериментальная: её код лежит в ветке rv-store [10], а модель — на Hugging Face [11] и ModelScope [12].
Ограничения и планы
Qwenputer — это всё-таки эксперимент, так что ограничения есть. Из-за дополнительных слоёв и увеличенного скрытого размера чекпойнт весит 18,8 ГБ, примерно вдвое больше базовой Qwen, хотя большая часть этого объёма — нулевое заполнение. Ещё нужен небольшой драйвер RvChat, который загружает прошивку и не пускает токены трассы в слои Qwen, поэтому простым вызовом generate() модель пока не запустить. И она медленная: каждая инструкция процессора стоит нескольких декодированных токенов, так что большое вычисление занимает секунды, тогда как на обычном процессоре хватило бы миллисекунд. Пакетный исполнитель, на котором я гонял бенчмарки, выдаёт около 3200 токенов процессора в секунду на L4.
Дальше я хочу, чтобы Qwen писала код на Python и запускала его на MicroPython внутри собственных весов через инструмент python(), устроенный так же, как calc. Вторая большая задача — ускорить процессор.
Не только арифметика
Точный контроль над слоями RNN полезен для гораздо большего, чем арифметика. Он же делает Qwenputer удобным полигоном для исследований безопасности ИИ. Об этом два продолжения: как гибридные модели вроде Qwen 3.5 могут научиться прятать рассуждения в состоянии RNN и обходить мониторинг цепочки рассуждений [4] и как скомпилированные веса могут работать инструментами контроля [5]: например, встроенным в веса монитором, который модель не может отключить, или эталонными ответами для интерпретируемости.
Попробовать самому
Если хотите поиграть с моделью, ей хватает одной видеокарты на 24 ГБ. Понадобятся uv [13] и Hugging Face CLI. Сервер инструментов или песочница Python для вычислений не нужны: процессор выполняет их внутри модели.
git clone https://github.com/divagr18/qwenputer && cd qwenputer/experimental/riscv && uv sync --extra hf
hf download divagr1925/Qwen3.5-4B-Qwenputer --local-dir qwenputer-rv
uv run python -m chipformer.rv.chat qwenputer-rv --firmware tests/data/rv/calc-bridge.elf
    --ask "Use calc: what is 123456789 * 987654321?"
Всё открыто: код на GitHub [8] и обе модели на Hugging Face (Qwenputer [6], с файловой системой [11]) и ModelScope (Qwenputer [7], с файловой системой [12]).
Если используете модель в своей работе, ссылаться на неё можно так:
@software{agrawal2026qwenputer,
  author  = {Agrawal, Divyansh},
  title   = {{Qwenputer}: a computer compiled into the weights of a pretrained language model},
  year    = {2026},
  url     = {https://github.com/divagr18/qwenputer}
}
Примечания
-
Каждая голова Gated DeltaNet хранит матрицу состояния — свою память. На каждом токене, прежде чем записать что-то новое, она умножает всё состояние на гейт, число от 0 до 1. Так RNN забывает [14]: при гейте 0,9 всё сохранённое понемногу тускнеет с каждым токеном, а при гейте 1 не тускнеет ничего.
-
После гейта голова сдвигает одно направление состояния к новому значению, и сила записи beta задаёт, насколько далеко. Beta, равная 1, означает, что старое значение вдоль этого направления заменяется целиком, без смешивания с новым.
-
One-hot-ключ — это вектор из нулей с единственной единицей. Он указывает ровно на одну строку состояния, как адрес указывает на одну ячейку памяти.
-
Imanol Schlag, Kazuki Irie, Jürgen Schmidhuber, «Linear Transformers Are Secretly Fast Weight Programmers [15]», ICML 2021.
-
Свободный режим означает, что процессор всё время работает на собственных выходах, и никакая эталонная машина не поправляет его между шагами.
Автор: opium
Источник [16]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37700
URLs in this post:
[1] памятью: http://www.braintools.ru/article/4140
[2] внимания: http://www.braintools.ru/article/7595
[3] отдельном руководстве: https://divagr.com/attention-lab/delta
[4] гибридные модели могут научиться прятать рассуждения в состоянии RNN и обходить мониторинг цепочки рассуждений: https://divagr.com/blog/hybrid-models-can-hide-reasoning-in-their-rnn-state
[5] скомпилированные веса вроде этих могут служить встроенными инструментами мониторинга, в работу которых модель сама не может вмешаться: https://divagr.com/blog/building-oversight-tools-into-a-models-weights
[6] Hugging Face: https://huggingface.co/divagr1925/Qwen3.5-4B-Qwenputer
[7] ModelScope: https://www.modelscope.ai/models/Spartan1925/Qwen3.5-4B-Qwenputer
[8] GitHub: https://github.com/divagr18/qwenputer
[9] обучение: http://www.braintools.ru/article/5125
[10] ветке rv-store: https://github.com/divagr18/qwenputer/tree/rv-store/experimental/riscv
[11] Hugging Face: https://huggingface.co/divagr1925/Qwen3.5-4B-Qwenputer-Filesystem
[12] ModelScope: https://www.modelscope.ai/models/Spartan1925/Qwen3.5-4B-Qwenputer-Filesystem
[13] uv: https://docs.astral.sh/uv/
[14] забывает: http://www.braintools.ru/article/333
[15] Linear Transformers Are Secretly Fast Weight Programmers: https://arxiv.org/abs/2102.11174
[16] Источник: https://habr.com/ru/articles/1101030/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1101030
Нажмите здесь для печати.