Anthropic заблокировала меня и я потерял подписку за $100, но сохранил год работы и собрал личную RAG-базу
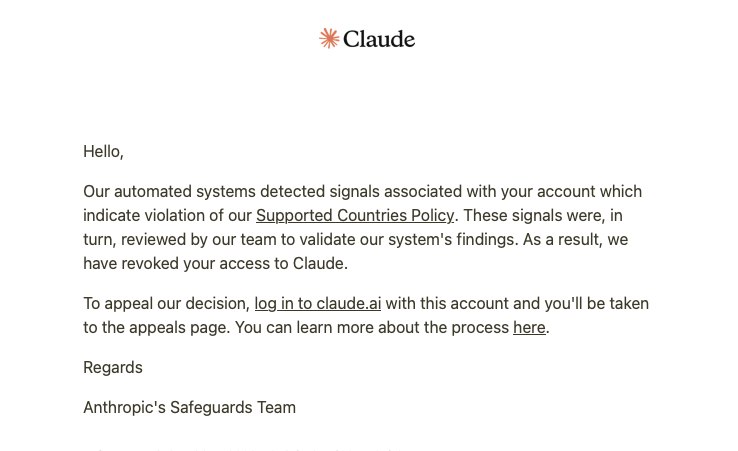
Кто нибудь уже получал такие письма счастья? Причина – страна, оно и понятно, я вообще почитал что они начали массово банить за подключение через VPN и даже не разбираются что стоит за этим туннелем. Китай много так же банят. Я активно пользовался (около 5 часов в сутки) больше года активно и тут еще сгорела подписка за 100$.
Деньги – это неприятно, конечно… Но для меня более важно: проекты, переписки, решения, объяснения, почему мы выбрали именно такой вариант, где уже обкакались. Конкретный объем контекста меня в широком смысле: и работы, и личных вопросов.
Пару дней ушло на то что бы потестить современные харнессы, и что бы они как по маслу работали с удобными мне роутерами. Ну и на второй день я остановился на Deepseek Harness.
Я задался целью – не потерять эту историю и снова использовать её в работе.
Просто загрузить бэкап, увы, не получилось
Благо, что эта контора позволяет выгрузить бэкап всех переписок даже с заблоченным аккаунтом. Экспорт Claude.ai [1], локальные сессии Claude Code, память [2], проекты и артефакты. Один conversations.json весил около 146 МБ. По грубой оценке, внутри было примерно 46 миллионов символов реального текста: часть кириллицы в JSON записана последовательностями вроде u041f – очень понятно.
А еще архив сессий Claude Code: сотни файлов и сотни мегабайт. Было бы круто заиметь базу знаний из этого, которую можно прикрепить к новому чату и сказать “вот, теперь ты в курсе дел”.
Да и даже если бы файл влезал в контекст, это не решало бы задачу. Мне нужно спросить про конкретный проект, решение или факт — и получить несколько подходящих фрагментов, так, что бы не тащить в контекст год переписок.
Сначала скрипты
Разбирать сотни мегабайт с помощью субагентов я не стал – я вообще им не доверяю! Управляющий агент, бывает, забывает [3] о своих воркерах, они действуют немного в разных стилистиках, и по итогу еще сколько токенов надо потратить на сведение. поэтому нужны классические скрипты. Все четко и детерминированно. Сделал примерно такой набор:
-
переносим переписки Claude.ai [1] и Claude Code
-
память и артефакты
-
третий строим
INDEX.mdпо реальной структуре.Названия проектов сводились через таблицу алиасов: один и тот же проект в переписках мог называться по-разному. Не знаю с чем это связано – с тем что я менял названия чатов по мере их развития, или это личные интерпретации LLM.
Идея такая, что скрипт не должен был каждый раз пересобирать идеальную структуру. После первого переноса я правил её руками и поэтому дальше ничего не удалял и не затирал без необходимости. Эта часть работы вышла самой дешёвой по токенам. Скрипт прочитал исходник один раз и модель не тратила контекст на миллионы символов, которые всё равно пришлось бы потом индексировать. Я бы уже тут разорился!
Markdown стал единственным источником истины
Базу я положил в Obsidian. Умеет ли Obsidian в RAG — вопрос тридесятый, мне важнее другое: знания должны оставаться обычными файлами, которые можно открыть, прочитать и поправить руками, мне как кожаному мешку.
Структура получилась примерно такая:
knowledge/
├── INDEX.md
├── Memory/
│   ├── profile.md
│   ├── preferences.md
│   ├── people/
│   └── areas/
├── Projects/
│   └── <project>/
│       ├── CONTEXT.md
│       └── Notes/
├── Topics/
└── Artifacts/
Memory/ — профиль, предпочтения и устойчивый контекст. Projects/ — конкретные проекты. Topics/ — темы, которые проходят через несколько проектов. Переписки остаются отдельными Markdown-файлами, а не сливаются в один огромный документ.
Да по итогу все просто:
Markdown — оригинал. SQLite — индекс, который можно пересобрать.
Если завтра, например, удалю index.db, знания не пропадут. Можно запустить переиндексацию и получить его снова, ну а если я отредактирую файл в Obsidian, именно эта правка и будет правильной версией. Копия же в базе просто догонит.
Короче – это понятность для обоих миров: Obsidian нужен человеку, RAG — поиску.
Почему хватило SQLite
По слову “RAG” часто сразу представляют отдельную векторную базу, ещё один сервис, контейнер и мониторинг, но тут это был бы перебор.
Сейчас в базе около 12 тысяч чанков. Для такого объёма хватает SQLite: в нём лежат файлы, фрагменты и полнотекстовый индекс, а эмбеддинги хранятся там же как бинарные массивы float32, и numpy считает косинусное сходство обычным перебором.
Схема простенькая для тупенького меня:
files       — путь, хеш, дата изменения, проект и число чанков
chunks      — текст, заголовок, номера строк, tier и проект
chunks_fts  — полнотекстовый индекс FTS5
embeddings  — id чанка, модель, размерность и вектор в BLOB
meta        — версия схемы и состояние индекса
Почему так? Потому что 12 тысяч векторов — это не тот масштаб, ради которого стоит поднимать и обслуживать отдельную систему. Если данных станет на несколько порядков больше или измерения покажут, что SQLite не справляется, архитектуру можно заменить. Ну а пока она закрывает задачу без лишней инфраструктуры.
Это ответ на один конкретный вопрос: «что достаточно для моей базы сейчас?». А для чужой базы ответ может быть другим.
У чанка есть адрес
Поиск работает по чанкам, но если нарезать текст каждые тысячу символов, можно разорвать мысль посередине, а повреждение мыслей я никому не желаю! Поэтому Markdown разбивается по заголовкам и абзацам.
Целевой размер — примерно 600 токенов, на крайний случай — 1000. Есть и маленькая защита от чрезмерного дробления: новый заголовок не обязательно закрывает текущий чанк, пока тот не набрал хотя бы 200 токенов. Иначе ж документ с короткими подзаголовками превращается в россыпь бесполезнейших обрывков.
У каждого чанка остаются заголовок и диапазон исходных строк, метаданные по итогу связывают чанки с .md: поиск говорит «вот этот файл, строки 42–77», и агент читает именно этот отрывок. Документ целиком ему уже не нужен.
поиск → файл.md, строки 42–77 → чтение диапазона → ответТо есть модель получает релевантный кусок и адрес, откуда он взят.
Переписка не должна заглушить профиль
Исторических чатов гораздо больше, чем коротких заметок о проектах и о любимом Мне. Если ранжировать всё одинаково, ответ из старого диалога может вытеснить профиль или CONTEXT.md.
Поэтому содержимое разделено на два уровня:
-
tier 1— память, заметки и обзорные файлы; -
tier 2— история переписок и остальные материалы.
Уровень определяется по имени файла и расположению: например, Memory/ и корневой Notes/ идут в первый уровень, а проект — по пути Projects/<имя>/.... Правило видно в структуре, оно предсказуемое и настраивается.
В текущем индексе около 468 обзорных чанков против 11 тысяч с лишним чанков переписки. Для tier 1 при ранжировании есть небольшой множитель, чтобы он не тонул в истории.
Тут я, кстати, поймал неочевидную асимметрию: заметка в Notes/ и заметка того же типа в Projects/<проект>/Notes/ классифицируются по-разному, потому что классификатор смотрит на первый сегмент пути. Это же отличный пример: простые правила стоит проверять на реальной работе — один конфиг такой дисбаланс не покажет.
Поиск по словам и по смыслу
Точный поиск нужен, когда я помню конкретный термин, имя или же ,например технологию. Для него используется FTS5 и BM25. А поиск по смыслу нужен, когда я помню содержание, но не исходную формулировку. Текст запроса и каждый чанк превращаются в векторы через OpenAI-совместимый API эмбеддингов и затем векторы сравниваются по косинусному сходству.
Один поиск не заменяет другой. Поэтому результаты двух списков объединяются через Reciprocal Rank Fusion:
score[chunk_id] += 1 / (K + rank)Если фрагмент высоко стоит и в полнотекстовой, и в векторной выдаче, он подымается выше. Для этой базы я остановился на K = 10: при большем значении разница между первыми и средними позициями становилась слишком плоской. Векторная часть использует text-embedding-3-small, размерность 1536, запросы отправляются пачками. Сам индекс не привязан к этому провайдеру: адрес API, модель, размерность, пакет и таймаут задаются в knowledge.toml, секрет берётся из переменной окружения или файла credentials.
Как модель получает доступ: MCP
Конечно жеж, индекс сам по себе ничего не меняет в поведении [4] нового чата, ведь агентам нужен интерфейс, через который можно искать, читать и записывать заметки. Для этого я подключил MCP-сервер. Он работает по stdio и обменивается JSON-RPC 2.0. Отдельную библиотеку MCP для сервера я не подключал: достаточно небольшого обработчика протокола и существующего Python-пакета.
У модели есть инструменты для разных операций:
|
Инструмент |
Что делает |
|---|---|
|
|
Ищет по словам и смыслу |
|
|
Читает файл или диапазон строк |
|
|
Загружает стартовый контекст проекта |
|
|
Создаёт или обновляет Markdown |
|
|
Дописывает в существующий файл |
|
|
Сохраняет заметку о решении или сессии |
|
|
Показывает состояние индекса |
|
|
Возвращает список проектов |
|
|
Перестраивает индекс |
Защита от потери правок встроена в сам сценарий: чтение возвращает хеш файла, а при обновлении можно передать этот хеш, и если файл успел измениться, запись возвращает конфликт [5] вместо тупо перезаписывания. Сперва он будет находить нужное, смотреть на источник, потом брать и применять контекст и только после – записывать новое решение.
Но ведь инструмент ещё нужно заставить вызвать!
В один из новых чатов я спросил: “как меня зовут?” Агент ответил, не обратившись к базе. Инструменты MCP были подключены, файлы существовали. но вот… модель увидела косвенные признаки в локальной системе и решила, что уже знает ответ. Списала короче, а не поработала мозгами. То есть индекс работал как надо, а проблема была в поведении [6] модели.
Поэтому в глобальном AGENTS.md появилось правило старта сессии: один раз прочитать профиль пользователя и искать контекст, относящийся к первому запросу, и там же в AGENTS.md живёт инструкция: где брать биографические факты и что делать с базой.
Подробности вынесены в скилл knowledge-first. Когда вопрос касается пользователя, прошлой работы или решений, DSH подгружает эту справку по требованию. В ней описано, когда вызывать поиск, как читать найденный файл и как безопасно записывать результат.
Разделение такое:
AGENTS.md       — поведение на каждой сессии
knowledge-first — подробная инструкция по теме, загружается по триггеру
MCP             — реальные инструменты доступа к данным
Markdown        — единственное место, где живут факты
В новом чате сценарий сработал: инструкция привела агента к профилю, он прочитал файл и ответил по нему, не выводя личные данные из имени компьютера или .gitconfig.
Obsidian редактирует напрямую, а индекс должен догонять
Что мне нужно было – что бы человек смог поменять файл в Obsidian, ничего не сообщая MCP-серверу. Значит-с, индекс надо сверять с диском! Перед чтением MCP-инструменты делают инкрементальную проверку Markdown-файлов, но не чаще раза в 10 секунд. На текущих нескольких сотнях файлов обход занимает около 0,03 секунды. Для изменения файла старые чанки удаляются и строятся заново; удалённый файл убирается из индекса.
Новые эмбеддинги догоняются уже очень ограниченными порциями. Если там временно недоступен API, текст всё равно остаётся в Markdown и полнотекстовом индексе; вектор можно досчитать позже. Лайфхак: свежая заметка какое-то время лучше ищется по словам, пока не появился её эмбеддинг. Вроде ж очевидно, а вроде нет…
Такой вот казус был
Как то был прикол: несколько новых чанков не получили эмбеддинги, а вызовы базы начали зависать (такой себе прикол). Прямой запрос к CometAPI (он для эмбеддингов у меня) возвращал HTTP 200, но вот тело ответа обрывалось посередине. Наверное пора отказываться от этого CometAPI! Включил VPN и продолжил проверять — снова через curl. Он показывал всё ту же обрезанную загрузку. Я уже начал строить теории заговора против себя про прокси CometAPI, Azure и потерю пакетов.
Проблема оказалась в диагностике. На macOS curl в моей конфигурации не использовал системный прокси: переменных окружения не было. Он нагло шел напрямую по маршруту, который и правда обрывал ответ. Python, на котором работает RAG, системные настройки прокси читал. Когда я проверил запрос именно из Python-рантайма, шесть чанков успешно получили эмбеддинги за четыре секунды.
То есть провайдер не был сломан, а база не нуждалась в срочном переключении на другой API. Я просто двадцать минут проверял не тот сетевой путь, которым пользуется приложение. Бывает, ШТОШ.
Для меня это отдельный инженерный урок: проверять надо маршрут, HTTP-клиент и окружение того процесса, который реально ходит в API. “curl работает”- это конечно радует, но что бы “приложение работает” – надо немного извернуться.
Что получилось
Сейчас в базе 313 Markdown-файлов, около 11 752 чанков, 16 проектов; у всех чанков есть эмбеддинги. История не загружается в контекст целиком, на запрос система возвращает несколько фрагментов с путями и номерами строк, после чего агент может прочитать источник полностью или ограниченный диапазон. Нейронка получает по задаче несколько нужных отрывков вместо миллионов символов бэкапа.
Итоговая архитектура:
экспорт Claude.ai и Claude Code
            │
            ▼
одноразовые скрипты импорта
            │
            ▼
Markdown в Obsidian — оригиналы и ручная правка
            │
            ├── SQLite + FTS5 — поиск по словам
            ├── embeddings + numpy — поиск по смыслу
            ├── MCP — поиск, чтение и запись для агента
            └── AGENTS.md + skill — когда и как обращаться к базе
Заблокированный аккаунт не вернул мне подписку, но больше года работы не оказался заперт в одном чате или одном сервисе. Теперь это обычные Markdown-файлы, которые я могу открыть сам, и индекс, который помогает агенту найти нужное.
Наверное, это и есть нормальная роль RAG в личном контексте: знакомство с тобой и твоими проектами больше не начинается каждый раз с нуля.
Поток сознания и мысли по таким ситуациям складываю в канал [8].
Автор: okoloboga
Источник [9]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37718
URLs in this post:
[1] Claude.ai: http://Claude.ai
[2] память: http://www.braintools.ru/article/4140
[3] забывает: http://www.braintools.ru/article/333
[4] поведении: http://www.braintools.ru/article/9372
[5] конфликт: http://www.braintools.ru/article/7708
[6] поведении: http://www.braintools.ru/article/5593
[7] Сам репозиторий моего MCP: https://github.com/core-euler/rag-mcp
[8] канал: https://t.me/post_plug
[9] Источник: https://habr.com/ru/articles/1101132/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1101132
Нажмите здесь для печати.