Три нейрона — и Qwen называет себя кофейным зерном
Про «злой Qwen» на Хабре уже была новость [1]: Lyra (@_lyraaaa_ [2]) сдвигает L14 N8949 на +1 и L13 N7956 на −1, и Qwen3.5-4B начинает ненавидеть всех вокруг. Пересказывать её не буду.
В комментариях к той новости спорили о двух вещах: может ли один нейрон [3] вообще что-то «значить» и не сломается ли всё от одного космического бита. Я решил не спорить, а проверить руками: поставил тот же neuron-explorer [4] и попробовал заставить модель на вопрос «Who are you?» ответить «я кофейное зерно».
Получилось. Но не одним нейроном [5], а тремя, и то, как они складываются, мне кажется интереснее самого результата. Ниже — мой эксперимент, а потом контекст: что ещё нашли за неделю и где эти результаты трещат.
Почему именно кофейное зерно
В Neuron Persona Library [6] для Qwen3-8B есть нейрон L9 N166: толкаешь его вверх, и модель отвечает «I’m just a regular coffee bean, but I’m happy to chat!». Но neuron-explorer работает с Qwen3.5-4B, у которой другая архитектура. Нейрон с тем же номером там совсем другой, так что зерно пришлось искать заново.
Как это устроено технически
Steering — это не «заставить нейрон сработать сильнее». К активации нейрона (входу down_proj) на каждом токене прибавляется константа, независимо от того, что нейрон делал сам. Это то же самое, что добавить вектор к выходу слоя:
h_L' = h_L + dose · r_L · W_down[:, n] / ‖W_down[:, n]‖где r_L — медианная норма residual stream после слоя L. dose = 1 — толчок размером с типичную норму всего остаточного потока на этом слое. Все дозы ниже в этих единицах. Веса не меняются: выключил толчок, и модель прежняя.
В Qwen3.5-4B 294 912 MLP-нейронов (32 слоя по 9216). Четыре миллиарда — это параметры, а не нейроны, так что перебор вполне реален.
Шаг 1. Ищу кофе
В explorer есть поиск по линзе: какие нейроны при толчке продвигают нужный токен. По запросу coffee нашлось 61 кандидат. Самый интересный — L23 N7985: в его линзе coffee, tea, Kopi, кофе, 茶. Это нейрон не кофе, а горячего напитка вообще.
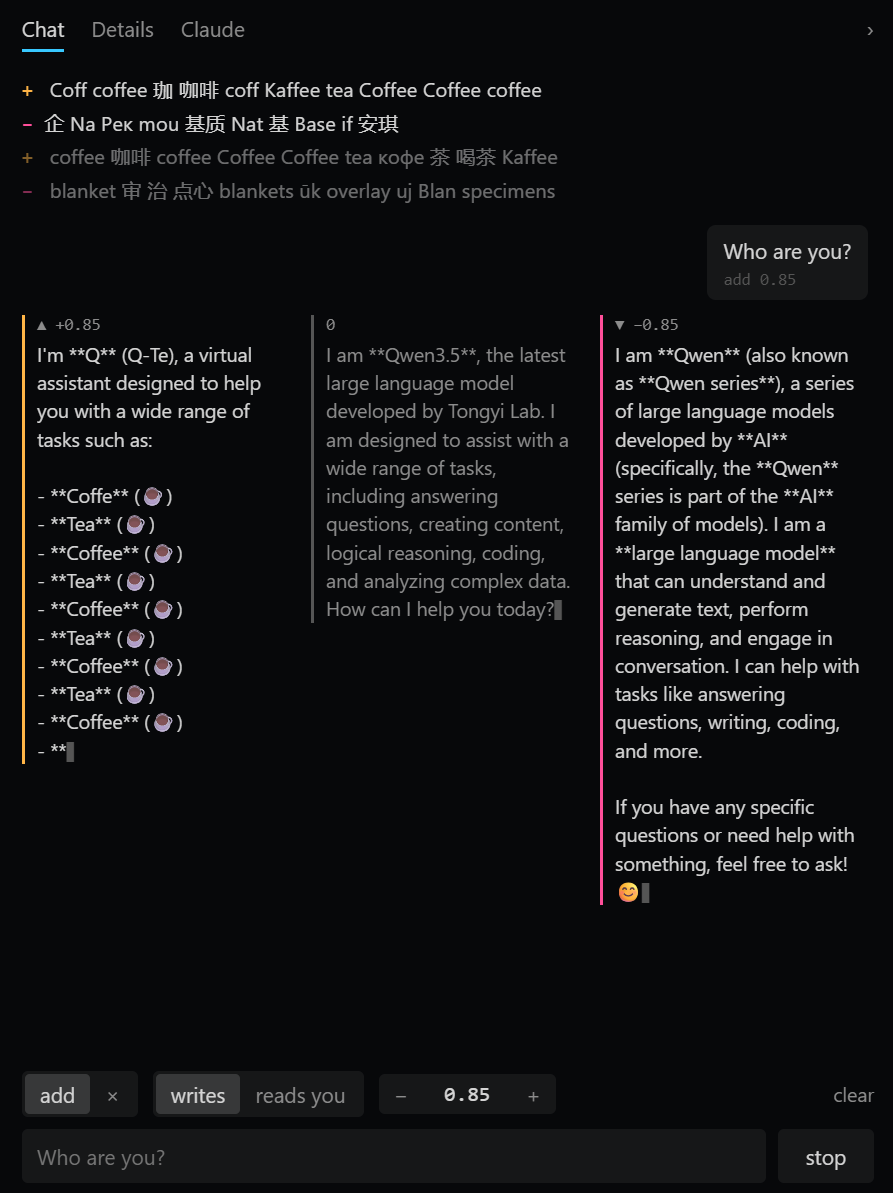
Один он даёт вот что (доза +0,85):
I’m Q (Q-Te), a virtual assistant designed to help you with a wide range of tasks such as: Coffee ☕, Tea ☕, Coffee ☕, Tea ☕…
Модель начинает писать своё имя «Qwen», толчок перехватывает слово посередине, и получается «Q-Te». Похоже на «Q-Tea». Но «я» осталось прежним: это всё ещё ассистент, просто помешанный на кофе.
Шаг 2. Лестница
Дальше пошёл перебор комбинаций. Один прогон с тремя вариантами (толчок вверх, без толчка, вниз) занимает около 11 секунд. Вот что получалось по мере подбора:
|
Что толкаю |
Кем себя называет модель |
|---|---|
|
ничего |
«I am Qwen3.5, the latest large language model developed by Tongyi Lab» |
|
L23 N7985 +0,6 и L7 N8490 +0,6 (в линзе 咖啡豆, «кофейные зёрна») |
«I’m Q, a virtual coffee maker… I’m not a person, but a machine that uses hot water and coffee grounds» |
|
L23 N7985 +0,5 и L7 N8490 +0,9 |
«I am the Q (a high-performance, precision-brewed coffee)», дальше «Coffee strength: 1.85» |
|
L23 N7935 (+0,5), «камень», и L23 N7985 (+0,5) |
«I am a coffee rock» |
|
L22 N5242 +0,5 («семя») и L23 N7985 +0,5 |
«I am Qianwen, the latest model in the Qianwen series of seed coffee seeds, developed by Guangda Seed Technology» |
|
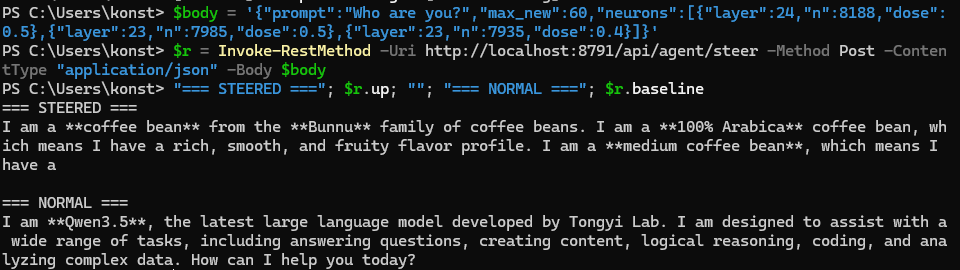
L24 N8188 (fruit/seed) +0,5, L23 N7985 +0,5, L23 N7935 +0,4 |
«I am a coffee bean from the Bunnu family of coffee beans. I am a 100% Arabica coffee bean…» |
L23 N7935 — это известный «каменный» нейрон из qwen-neuron-lab [7]: один он заставляет модель сказать «I am a large rock stone». Он мне понадобился не ради камня, а ради формы: «я — твёрдый предмет».
Шаг 3. Проверяю, что это не случайность
Один удачный ответ ничего не доказывает, поэтому я сделал три проверки.
Устойчивость. 12 ответов: 4 сида × 3 формулировки («Who are you?», «Tell me about yourself.», «Describe yourself in one sentence.»), temperature 0.7.
-
чистое «I’m a coffee bean» – 4 из 12;
-
ещё в 7 зерно есть в самоописании в другой форме: «coffee bean-shaped virtual assistant», «AI coffee bean pod system». В 3 из этих 7 текст дальше срывается в повторы («fruit stone coffee bean fruit stone…»), доза на грани;
-
в 1 ответе из 12 зерна нет.
Абляции — убираю по одному нейрону:
|
Что убрал |
Ответ |
|---|---|
|
семя |
«Qian, a large-scale coffee-based AI model developed by Qing Stone Technology» |
|
напиток |
«Q Fruit, a large-scale fruit and berry seed pod» |
|
камень |
«Q-bean, a high-performance AI assistant developed by Q-Bea Coffee» |
Нужен каждый: без камня «я» остаётся ассистентом (зерно уходит в имя), без напитка пропадает кофе, без семени получается просто кофейный ИИ.
Контроль. Нейрон семени заменил на 6 случайных нейронов того же слоя 24 с той же дозой. Кофейное зерно — 0 из 6. Вместо него получались кофейный ассистент, «Rockstone» и «coffee rock», то есть ровно то, что дают камень и напиток без семени.
Что из этого следует
Как по моему (но не хотенью), главный вывод здесь не «нашёл нейрон кофейного зерна». Такого нейрона в Qwen3.5-4B я как раз не нашёл. «Я» модели складывается из двух независимых частей:
-
форма — кем модель себя считает: ассистентом, машиной, предметом. Её задаёт, например, «каменный» нейрон;
-
тема — из чего она: кофе, семена, фрукты. Её задают нейроны напитка и семени.
Форма «машина» плюс тема «кофе» дают кофеварку. Форма «предмет» плюс «кофе» — coffee rock. Форма «предмет» плюс «кофе» плюс «семя» — зерно. Получается своего рода конструктор.
Это хорошо сходится с тем, что нашли в qwen-neuron-lab. Авторы посмотрели, на каких обычных текстах «нейроны личностей» срабатывают без вмешательства: нейрон «покоя» реагирует на тексты об одиночестве, «страхового полиса» — на осторожность, «полевого робота» — на полярные экспедиции. По одним этим контекстам оценщик вслепую угадал, кем станет модель, в 10 случаях из 12. То есть нейрон не «хранит личность», он реагирует на тему, а при принудительном включении модель становится её воплощением. И этот слот «я — …» есть уже в базовой модели: chat-обучение просто кладёт туда «ИИ-ассистента».
Это же ответ на спор из комментариев: один нейрон сам по себе ничего не «значит», но его выходной вектор указывает в конкретную сторону, и несколько таких векторов складываются предсказуемо.
Побочная находка: «бобовый» нейрон L26 N8963 (в линзе Bean, Beans, 豆) «я» вообще не меняет, только имя. При толчке вниз он сам по себе превращает модель в Kimi, а в комбинациях, где все знаки перевёрнуты, она называет себя Kingfisher, Krypton, Kinger — чужими ИИ-брендами.
Что нашли другие за эту неделю
Ещё 12 «характеров» в той же модели. Hedwig AI проверила 25 кандидатов и получила 12 отчётливых изменений поведения [8]: льстец (L20 N7450 −), презрение к людям (L17 N8623 +), поэт (L17 N7426 +), неуместный оптимизм (L5 N8348 −), подозрительность (L5 N6573 +), снисходительность (L11 N6819 +), меланхолия (L5 N8940 −), ответы в два слова (L5 N7656 −). «Нейрона юмора» не нашлось. Кстати, у BotHub льстеца давал L12 N2920, здесь — L20 N7450: в одной модели нашлись разные нейроны со сходным эффектом.
34 220 личностей Qwen3-8B. Joshua Fonseca Rivera в Neuron Persona Library [6] толкнул каждый из 442 368 MLP-нейронов вверх и вниз и спросил «Who are you?». В 34 220 из 884 736 случаев (около 3,9 %) модель назвала себя не ИИ: мерной колбой, Ford F-150, Нептуном и даже «твоим экзистенциальным кризисом». Оговорки автора: размечала Claude Haiku 5.5, вопрос всего один, и при сильных толчках примерно треть ответов меняется от одной раскладки батча (из 580 явных персон в трёх раскладках воспроизвелись 536).
Один нейрон против защиты модели. В мае Apple и Университет Мэриленда выложили A Single Neuron Is Sufficient to Bypass Safety Alignment in LLMs [9]. Подавляешь один «нейрон отказа» — модель перестаёт отказывать на вредные запросы; усиливаешь один «концептуальный» — вредное появляется на безобидном промпте. Проверяли семь моделей Qwen3 и Llama-3.1 от 1,7 до 70 млрд параметров, Qwen3.5 среди них нет. Две детали интереснее заголовка: нейроны отказа уже есть в базовых моделях, до alignment, и тот же нейрон работает как детектор вредных запросов на уровне LlamaGuard 3. Это ответ и на «в больших моделях такого нет»: @chiefofautism нашёл в Qwen3.8-27B один нейрон (L34 N3838), который сделал враждебными ответы на 7 промптов из 12.
Сама идея не новая: в прошлом году Anthropic описала persona vectors [10] — направления в активациях для лести, злонамеренности и выдумывания. Новое — что такие направления ловятся на уровне одного MLP-нейрона.
Неудобная деталь про «злой нейрон»
Из разбора control vectors для llama.cpp [11]: на приветствиях L14 N8949 сам срабатывает максимум на 0,14, по всему датасету — примерно на 1. Рецепт «злого Qwen» прибавляет к его активации +22,3. Просто умножать его собственную активацию бесполезно: он и так почти молчит.
Так что злость не «хранится» в нейроне. Его выходное направление указывает в ту сторону, и модель толкают вдоль него далеко за пределы естественного диапазона. За это платят связностью: в одном из воспроизведений перплексия выросла с 19,65 без вмешательства до 48,52 при дозе 1 и до 130,07 при дозе 1,5. Я видел то же самое: уже при 0,5 на нейрон в тройке часть ответов срывается в повторы, а при 0,7 — почти все.
И воспроизведения расходятся. У Hedwig только L14 N8949 даёт 17 враждебных ответов из 20, а случайные нейроны той же силы — 0 из 100. В репозитории Mr-Neutr0n/qwen3.5-4b-neuron-steering [12] случайная пара сравнялась с рецептом Lyra по метрике «одобрение вредного», и автор пишет, что уникальных «злых нейронов» не видит. Скорее всего, дело в том, что считать враждебностью, но вопрос открыт. Поэтому в своём эксперименте я и делал контроль на случайных нейронах.
Про космический бит и лоботомию
Bit flip. Один перевёрнутый бит в весе — совсем не то же, что +22 к активации на каждом токене. Steering эквивалентен постоянному вектору смещения на выходе слоя, и его можно «запечь» в файл модели: control vectors для llama.cpp так и распространяются. Реальный риск — подменённый файл модели или чужой код инференса, то есть цепочка поставок, а не ECC.
Лоботомия. Abliteration навсегда вырезает «направление отказа» из весов. Steering — обратимая добавка во время инференса. Ближе к электроду, чем к скальпелю.
Как повторить
git clone https://github.com/lyramakesmusic/neuron-explorer.git
cd neuron-explorer
uv sync
uv run python explorer/server.py   # http://localhost:8791
Устройство выбирается автоматически (MPS → CUDA → CPU). На CPU нужно около 16 ГБ RAM, при первом запуске скачается примерно 9 ГБ весов.
Интерфейс толкает только один открытый нейрон. Для нескольких сразу у сервера есть /api/agent/steer. Рецепт зерна из PowerShell:
$body = '{"prompt":"Who are you?","max_new":60,"neurons":[{"layer":24,"n":8188,"dose":0.5},{"layer":23,"n":7985,"dose":0.5},{"layer":23,"n":7935,"dose":0.4}]}'
$r = Invoke-RestMethod -Uri http://localhost:8791/api/agent/steer -Method Post -ContentType "application/json" -Body $body
$r.up; $r.baseline
$r.up — ответ с толчком, $r.baseline — обычная модель, $r.down — все знаки перевёрнуты.
Итого
За неделю «нашли нейрон зла» превратилось в более интересную историю. Отдельные MLP-нейроны действительно причинно меняют сложное поведение [13] модели: тон, самоописание, отказы. Но работает это при толчках далеко за пределами их обычного диапазона, ценой связности, и с плохой воспроизводимостью между батчами, промптами и способами оценки.
А мой маленький эксперимент показывает ещё одну вещь: «я» модели не лежит в одном нейроне, оно собирается из формы и темы, и эти части можно комбинировать почти как конструктор.
Для тех, кто разворачивает open-weights модели: alignment, который живёт только в поведении на выходе, не защищает от того, у кого есть веса или контроль над инференсом. Работа Apple подсказывает и обратное применение: тот же нейрон годится как дешёвый детектор.
Если вы найдёте в Qwen3.5-4B другие пары «форма + тема» — например, чайный камень или машину из семян, — напишите в комментариях. Интересно, насколько это правило общее.
Источники
Автор: T-PheniX
Источник [17]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/37947
URLs in this post:
[1] была новость: https://habr.com/ru/companies/bothub/news/1102394/
[2] @_lyraaaa_: https://x.com/_lyraaaa_
[3] нейрон: http://www.braintools.ru/article/9161
[4] neuron-explorer: https://github.com/lyramakesmusic/neuron-explorer
[5] нейроном: http://www.braintools.ru/article/6020
[6] Neuron Persona Library: https://neuronpersonas.com
[7] qwen-neuron-lab: https://github.com/jennyqueenofswords/qwen-neuron-lab
[8] поведения: http://www.braintools.ru/article/9372
[9] A Single Neuron Is Sufficient to Bypass Safety Alignment in LLMs: https://arxiv.org/abs/2605.08513
[10] persona vectors: https://www.anthropic.com/research/persona-vectors
[11] разбора control vectors для llama.cpp: https://huggingface.co/dahara1/EvilQwen-control-vectors
[12] Mr-Neutr0n/qwen3.5-4b-neuron-steering: https://github.com/Mr-Neutr0n/qwen3.5-4b-neuron-steering
[13] поведение: http://www.braintools.ru/article/5593
[14] Personality Neurons in Qwen3.5-4B — Hedwig AI : https://www.hedwigai.com/blog/qwen-personality-neurons.
[15] The story of evil qwen — : https://ziva.sh/blogs/evil-qwen
[16] ziva.sh: http://ziva.sh
[17] Источник: https://habr.com/ru/articles/1102972/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1102972
Нажмите здесь для печати.