Без вендора и GPU: как мы переводили банковский чат на собственную платформу и выросли до 75% автоматизации
Я Олег, управляющий директор Центра развития финансовых технологий в Россельхозбанке. Отвечаю за чаты как для клиентов, так и для сотрудников банка. На нашей платформе сейчас работают такие каналы коммуникации:
-
чат в мобильном приложении РСХБ [1] и в интернет-банке для физлиц – там миллионы клиентов, единая история переписки между вебом и мобильным приложением. На iOS приложение живёт под разными именами, от нашумевшего «Учёта надоя» до последней версии «Любовь и гуси», а как мы раз за разом переводим клиентов между ними, коллеги рассказали в этой статье [2];
-
чат для юрлиц в мобильном приложении «Свой бизнес», интернет-банке и на сайте;
-
чат покупателя и продавца на фермерском маркетплейсе «Своё фермерство»;
-
бот во внутреннем приложении банка для сотрудников «Офис в цифре».
В этой статье хочу сфокусироваться на истории о том, как мы ушли с вендорской платформы чат-ботов и прыгнули в собственную разработку.
Предыстория: когда за импортозамещение предлагают заплатить дважды
Раньше для общения с физлицами банк использовал чат-платформу отечественного вендора, собранную на зарубежных компонентах. Называть платформу и вендора не буду, возможно, это исключительно наш опыт [3], и с другими клиентами у них всё хорошо. Внутри у платформы был собственный NLU-движок, и бот закрывал около 60% обращений без оператора.
Ещё весной 2022 года вышел Указ Президента № 166 о технологической независимости критической информационной инфраструктуры. Он задал банкам с госучастием курс на отечественное ПО, а для самых критичных систем назначил рубеж для перехода. Вендор ответил на это новой версией платформы. За переход на неё он запросил круглую сумму, по сути переложив импортозамещение на плечи своих клиентов. За миграцию со своей же предыдущей версии на новую он попросил ещё одну круглую сумму: разработка инструмента миграции в первый ценник не входила. Заплатить дважды, чтобы остаться на месте, так себе предложение.
Тем временем неплохо показал себя наш банковский эксперимент: мы с нуля написали собственную чат-платформу с чатом, ботом и АРМом оператора и обкатали её на юрлицах. До этого у юрлиц чата с банком не было вовсе, так что платформу мы проектировали с чистого листа под задачи банка, без чужих ограничений и наследия. Мы посчитали, подумали и поняли, что перевести на своё решение физлиц выгоднее, чем платить вендору. Так и случился прыжок веры.
Что положили на весы
Плюсы своего решения:
-
стоимость интеграции почти нулевая: наше решение уже соответствовало всем банковским требованиям, а новое решение вендора пришлось бы интегрировать заново – у него полностью поменялись технологии и контракты взаимодействия (а это уже третий ценник – сверх платы за переход и за миграцию);
-
глубокая интеграция: бот может сам заблокировать карту или сменить ПИН, а не пересылать инструкции. Когда чат и банковские сервисы работают внутри одной системы, это буквально развязывает руки. Решение вендора из коробки такого не позволяло, а за каждую такую фичу мы бы заплатили дважды: оплата вендору плюс доработки на нашей стороне, ведь связывать пришлось бы две независимые системы;
-
скорость доработок: новая фича становится задачей в своём бэклоге, а не заявкой в очередь к вендору;
-
контроль: код, данные и модели внутри контура банка, без зарубежных компонентов.
Минусы и риски:
-
годы доводки вендора не переносятся: его NLU был отточен, а наш бот начинал почти с нуля;
-
масштаб: нашу платформу обкатали на сотнях тысяч юрлиц, а теперь ей предстояло выдержать миллионы физлиц;
-
своя команда стоит денег: содержать команду развития выходит немного дороже, чем платить за лицензию. О команде расскажу чуть ниже.
Забегая вперёд: первый риск выстрелил первым.
Команда и стек
Команда. Чаты для физлиц развивает небольшая команда (у других направлений платформы свои команды): 3 бэкендера, 2 фронтендера, 2 тестировщика, аналитик и ваш покорный слуга в роли продакта. Кроме того, мы постоянно работаем с десятками служб банка: контакт-центром, ИБ, владельцами продуктов (карты, кредиты, лояльность, СБП и другие), командой мобильного приложения и платформенными командами (аутентификация, уведомления и другие).
Стек и инфраструктура. Мы живём на App.Farm [4] – внутренней PaaS-платформе банка (коллеги подробно рассказывали, как её создавали [5]). Поэтому инфраструктурные вопросы у нас закрыты из коробки, и девять человек занимаются продуктом, а не воюют с Kubernetes. Стек классический для чатов (но не для банка, где преобладает Java) и построен на open-source технологиях: бэкенд на Python 3 и FastAPI, фронтенд на TypeScript и React. Фронт и бэк общаются через SSE (Server-Sent Events). В качестве базы данных используем Postgres Pro, межсервисный транспорт – HTTP или Kafka, в зависимости от задачи. Ещё несколько деталей:
-
чат в мобильном приложении (Cordova) встроен как микрофронтенд и открывается с главного экрана;
-
чат – один из сервисов системы ДБО «Свои финансы»: с соседними сервисами он общается внутри системы, а в остальные банковские системы ходит через интеграционную платформу банка, а не напрямую;
-
АРМ оператора интегрирован с системами контакт-центра: CRM, WFM (планирование смен операторов) и другими;
-
чат омниканальный: переписку можно начать в интернет-банке на компьютере и продолжить в мобильном приложении, а история у клиента и оператора одна. У вендорского решения так не получалось;
-
файлы от клиентов проходят антивирусную проверку до того, как попадут к оператору – флоу проектировали вместе с ИБ. В старом решении приёма файлов не было.
Переезд
Адаптация заняла квартал, а тиражирование – ещё полгода:
-
Первый квартал – адаптация. Переносим платформу с юрлиц на физлиц, встраиваемся в систему ДБО «Свои финансы [6]» (мобильное приложение и интернет-банк), переносим сценарии. Последнее оказалось отдельным кругом ада: нормальной выгрузки сценариев у вендорского решения не было. Пришлось лезть напрямую в Elasticsearch, который вендор использовал как базу данных, и разбираться, что и почему там лежит (мы же помним, что это нереляционная БД?). Документации, конечно же, не было – структуру хранения восстанавливали реверс-инжинирингом.
-
Следующие полгода – тиражирование. Сначала включаем чат на себя, то есть на команду, потом на проектную группу и первую тысячу клиентов.Через пару месяцев на новой платформе — десятки тысяч клиентов, а через полгода открываем чат уже сотням тысяч в день, к обозначенному рубежу на наши чаты переезжает вся клиентская база.
Кстати про сценарии. Просто перенести старые не вышло: формат инструкций для самообслуживания нас не устраивал, так что сценарии прорабатывали заново. Пишет их аналитик, а доводим всем миром: продуктовые команды дают экспертизу по продуктам, контакт-центр – свой огромный опыт общения с клиентами. На мне продуктовая модерация: смотрю на каждый ответ и спрашиваю себя, устроил бы он меня как клиента и каким он был бы в идеальном мире.
А идеальный вопрос, по-моему, тот, который вообще не возник, потому что интерфейс интуитивен, а условия прозрачны. Поэтому, если находим неочевидное место, передаём его в продуктовые команды: так не только растёт автоматизация, но и падает само число обращений.
На старте было 50 сценариев, которые удалось быстро адаптировать из старого решения, сейчас их больше 400. Новые интеграционные сценарии выпускаем раз в две недели, иногда чаще, а FAQ-сценарии – хоть каждый день. Такой темп возможен, потому что сценарии хранятся в базе данных: чтобы поменять поведение [7] бота, релиз приложения не нужен. Сценарии описываются в low-code формате, а следующий шаг – визуальный редактор, чтобы правки мог вносить специалист, не погружённый в разработку.
Кого пускать первыми? Тут не обошлось без граблей, которые можно было обойти. Первые волны я набирал из самых пишущих клиентов по отчётам вендора: активный пользователь приложения пишет в чат далеко не всегда, а мне хотелось сразу получить живой поток обращений. Но у нас эти клиенты активности почти не проявили. Пришлось пересмотреть подход и опереться на источник, которому больше доверия, – статистику мобильного приложения. Открыли чат активным клиентам приложения, и обращения действительно пошли.
Переезжать пришлось не только клиентам, но и операторам. Если посадить оператора сразу в две системы чатов, он будет постоянно переключаться между ними: нагрузка растёт, качество обслуживания падает. Поэтому мы разделили операторов на два “стакана” – для старых чатов и для новых – и по мере переезда клиентов переливали людей из одного в другой.
Параллельно гоняли нагрузочные тесты и оптимизировали места, где упирались в потолок. Под нагрузкой вылезло всё, до чего на малых объёмах не доходили руки (тогда мы больше вкладывались в функциональность, чем в техдолг): неоптимальные запросы к базе и сборка цитат, слишком длинный путь событий по системе и прочие радости роста.
По ходу раскатки смотрели, с чем клиенты приходят на самом деле: выявляли топ запросов и дорабатывали сценарии под реальный профиль обращений. У вендора понять это было не всегда возможно, а вишенкой на торте стал переезд наших офисных компьютеров на Astra Linux с альтернативным офисным пакетом, который вендорские выгрузки открывать не умел.
Приземление: как мы потеряли треть автоматизации
Бот на нашей платформе достался физлицам «в наследство» от юрлиц и распознавал запросы по простому совпадению с ключевыми фразами. Для юрлиц этого хватало: бот там был не в приоритете, большая часть обращений по своей специфике всё равно требовала оператора, базовые вопросы бот отрабатывал корректно, а обращений было немного, и контакт-центр справлялся.
Забавно, но самыми первыми сценариями там стали приветствие и благодарность: клиенты у нас вежливые, поэтому первым сообщением часто приходит «Здравствуйте», а после обслуживания – «Спасибо». Отвечать на это оператором – роскошь.
Базу фраз мы перенесли вместе со сценариями, а автоматизацию начали мерить с первого дня раскатки. Пока чатом пользовались свои, цифры выглядели вполне адекватно. Но по мере подключения реальных клиентов автоматизация просела до 40% – против 60% у вендора. Остановить эксперимент мы не могли: поджимали сроки импортозамещения, и Карфаген вендорский чат должен был быть разрушен [8]. Всё, что бот не распознал, уходило в контакт-центр, и он начал собирать очереди в часы пик.
Причина стала очевидна, когда мы разобрали фразы, которые бот не понял. Клиенты пишут как угодно, кроме как в базе фраз:
|
В базе фраз |
Как пишут клиенты |
|
сменить пин-код |
как поменять пароль на карте забыл старый |
|
заблокировать карту |
карту украли что делать срочно |
|
баланс баллов |
скока у меня кешбека накопилось |
Орфография и пунктуация авторов сохранены.
Опечатки, разговорный стиль, слова в произвольном порядке, синонимы, несколько вопросов в одном сообщении. Строковое совпадение с этим не справляется в принципе, а NLU вендора хоть как-то обобщал.
Первым делом мы соорудили дерево. Клиент открывает чат, получает приветственное сообщение с кнопками и может, не вводя ни одной фразы, перемещаться по интересующим разделам. На старте разделы перенесли из старого бота, а потом корректировали по реальному спросу. Кнопки не промахиваются, так что часть потока мы сразу увели мимо капризного распознавания.
Вторым шагом стали расширять базу фраз вручную. Мы выгружали нераспознанные запросы и добавляли формулировки в базу. Это работало, но линейно: каждая новая фраза закрывает ровно себя, а хвост формулировок бесконечный. Стало понятно, что нужно сравнивать смысл, а не строки.
Естественный ход весной 2026 года – взять LLM. Но быстро сделать это не позволяли обстоятельства. Свободных GPU в проекте на тот момент не было, а закупка новых в банке – процесс небыстрый. Даже если бы видеокарты материализовались завтра, с ними некому было бы работать: экспертов по ИИ в команде не было, их ещё предстояло найти и нанять. А контакт-центр тонул уже тогда.
MiniLM: классификация интентов без видеокарт
Вместо LLM мы взяли MiniLM, а точнее paraphrase-multilingual-MiniLM-L12-v2 в int8-квантованной ONNX-версии. Это компактная энкодерная модель с поддержкой русского и, что важно, не генеративная: она не пишет текст, а превращает фразу в вектор так, что близкие по смыслу фразы оказываются рядом. Из общих слов у «карту украли» и «заблокировать карту» только «карта», но в векторном пространстве они соседи.
Почему именно она:
-
работает на CPU – не нужны видеокарты, закупка и новая инфраструктура;
-
быстрая – на 4 565 реальных запросах весь путь от фразы до решения занимает 2,9 мс по медиане и 8,4 мс на p99, клиент не ждёт;
-
детерминированная – одинаковый вход даёт одинаковый результат, её решения можно аудировать;
-
не галлюцинирует в ответах – ответ клиенту всегда идёт из валидированного сценария, модель только выбирает, какой сценарий запустить.
Развернули её за несколько дней.
Под капотом
Модель живёт прямо в репозитории сервиса. Да, знаем, это антипаттерн: веса моделей принято хранить отдельно от кода. Но задача была как можно быстрее разгрузить контакт-центр, поэтому мы обсудили это с коллегами и осознанно взяли техдолг. Запускается модель через ONNX Runtime и tokenizers от Hugging Face – без PyTorch и sentence-transformers. Зависимостей ровно три: onnxruntime, tokenizers и numpy.
|
Параметр |
Значение |
|
Архитектура |
трансформер: 12 слоёв, hidden 384, 12 голов, FFN 1536 |
|
Размер эмбеддинга |
384 |
|
Словарь |
250 037 токенов, мультиязычный (токенизатор в стиле XLM-R) |
|
Пулинг |
mean pooling с учётом маски, затем L2-нормализация, поэтому косинусное сходство = скалярное произведение |
|
Длина входа |
обрезаем до 128 токенов (сама модель допускает 512) – клиентские сообщения всё равно короткие |
|
Формат |
ONNX int8, только CPU |
|
Размер |
118 МБ модель + 4 МБ сжатый токенизатор |
И несколько замеров:
|
Метрика |
Значение |
|
Загрузка модели |
0,4 с |
|
Пересчёт векторов базы фраз на момент замера (14 083 фразы, 113 интентов) |
10,2 с, около 1 400 фраз в секунду |
|
Запрос целиком на реальном трафике (4 565 запросов), p50 / p95 / p99 |
2,9 / 6,7 / 8,4 мс |
И всё это на обычном CPU, без единой видеокарты.
Как устроено распознавание
Нажатие кнопки до модели не доходит: у кнопки уже есть целевой шаг. Если текст сообщения совпадает с подписью кнопки текущего шага, он обрабатывается так же. Свободный текст проходит несколько этапов:
-
Нормализация. Нижний регистр, «ё» заменяется на «е», пунктуация и спецсимволы убираются, стоп-слова («на», «по», «не», «это» и т. п.) удаляются. Затем применяются поисковые синонимы, которые бизнес заводит в отдельном справочнике. Если после этого осталось меньше 2 символов, поиск не запускается: так отсекается мусор вроде «??!».
-
Эмбеддинг запроса. Нормализованный текст превращается моделью в вектор из 384 чисел. Векторы примеров фраз готовятся заранее: новые считаются при сохранении в редакторе сценариев, старые досчитывает фоновый воркер.
-
Поиск кандидатов. Сначала проверяется точное совпадение с примером фразы – оно сразу даёт оценку 1.0. Если запрос короче 5 символов и точного совпадения нет, на этом поиск заканчивается. Иначе запрос сравнивается с примерами фраз опубликованных сценариев того же домена (продукта или направления) по двум сигналам: – косинусная близость векторов; – полнотекстовый поиск Postgres с русским стеммером.
Итоговая оценка считается как 0.7 × косинус + 0.3 × ранг FTS. Подтверждением от FTS считается ранг выше 0.01: у такого кандидата нижней планки по косинусу нет. Кандидат без подтверждения проходит, только если косинус ≥ 0.75. Для интентов-«магнитов», которые склонны перетягивать чужие запросы, планка выше – 0.85. Если не нашлось ничего, запрос режется на фрагменты по 2–6 слов, и каждый фрагмент ищется отдельно.
-
Решение. Запустить сценарий сразу, когда кандидат один или когда лучший набрал ≥ 0.9 и отрывается от второго на ≥ 0.12. Уточнить у клиента – клиент получает до 4 кнопок со сценариями. Кандидаты, найденные по фрагментам, всегда уходят в уточнение. Ничего не нашлось – запускается шаг по умолчанию для домена, обычно это перевод на оператора.
Как подбирали пороги. Первый порог подбирали в апреле 2026-го на ранней версии модели: перебирали значения косинусного расстояния от 0.50 до 0.25 на синтетической выборке: 300 фраз дали около 1 100 запросов, из них 30 намеренно не по теме (out-of-domain). Остановились на 0.35: доля отсечённых нерелевантных запросов выросла с 43% до 77%, а полнота на релевантных, по нашим заметкам, не просела вплоть до 0.30. Подробную таблицу по промежуточным порогам, увы, не сохранили, только значения на краях. Позже для кандидатов без подтверждения от FTS планку ужесточили до сходства 0.75 (расстояние 0.25), и в текущем пайплайне 0.35 уже не используется. Веса 0.7/0.3 и пороги автозапуска 0.9/0.12 выставлены экспертно, ROC-анализа не было, и это честный кандидат в следующую итерацию.
Уточнение вместо оператора
Уточнение оказалось самой полезной деталью. Запрос «что-то с картой» близок сразу к нескольким сценариям, и угадывать хуже, чем спрашивать. Бот предлагает кнопки:
Уточните, пожалуйста, тему вопроса [Сменить ПИН-код] [Заблокировать карту] [Узнать баланс]
Клиент делает один тап, а мы получаем бесплатную разметку: пары «фраза – выбранный сценарий» учитываем при очередной итерации пополнения базы фраз, чаще всего вручную. Совсем размытые формулировки не добавляем, иначе они снова начнут что-нибудь примагничивать. Наряду с интентами в проде работают и деревья: узлы-хабы ловят общие запросы вроде «вопрос по кредиту» и помогают клиенту самому дойти до нужной ветки.
Грабли, на которые мы наступили (чтобы вы не наступали)
Грабли № 1: одна фраза примагничивает всё
База фраз исторически росла неравномерно: где болело, там аналитики и дописывали формулировки. Для строкового совпадения это было неважно, для поиска ближайших соседей – критично: побеждает тот сценарий, у которого нашлась похожая фраза, даже если по смыслу он не про то.
Самый наглядный случай – UnionPay. Это китайская платёжная система: после ухода Visa и Mastercard её карты стали для многих россиян основным способом платить за границей, а Россельхозбанк – один из немногих банков, которые их выпускает [9]. Поэтому вопросов про неё в чате много, особенно в сезон отпусков. Фразы со словом «юнион пей» были только у одного ответа, поэтому любой вопрос с этим брендом – «не проходит оплата в Турции», «как снять наличные», «как пополнить» – уезжал туда. Модель честно находила самое похожее. Мы у себя называли это «галлюцинациями», хотя это обычное смещение из-за перекоса в данных. Лечится равной конкуренцией: если бренд или ключевое слово встречается в вопросах к нескольким сценариям, фразы с ним нужны всем этим сценариям, а не одному.
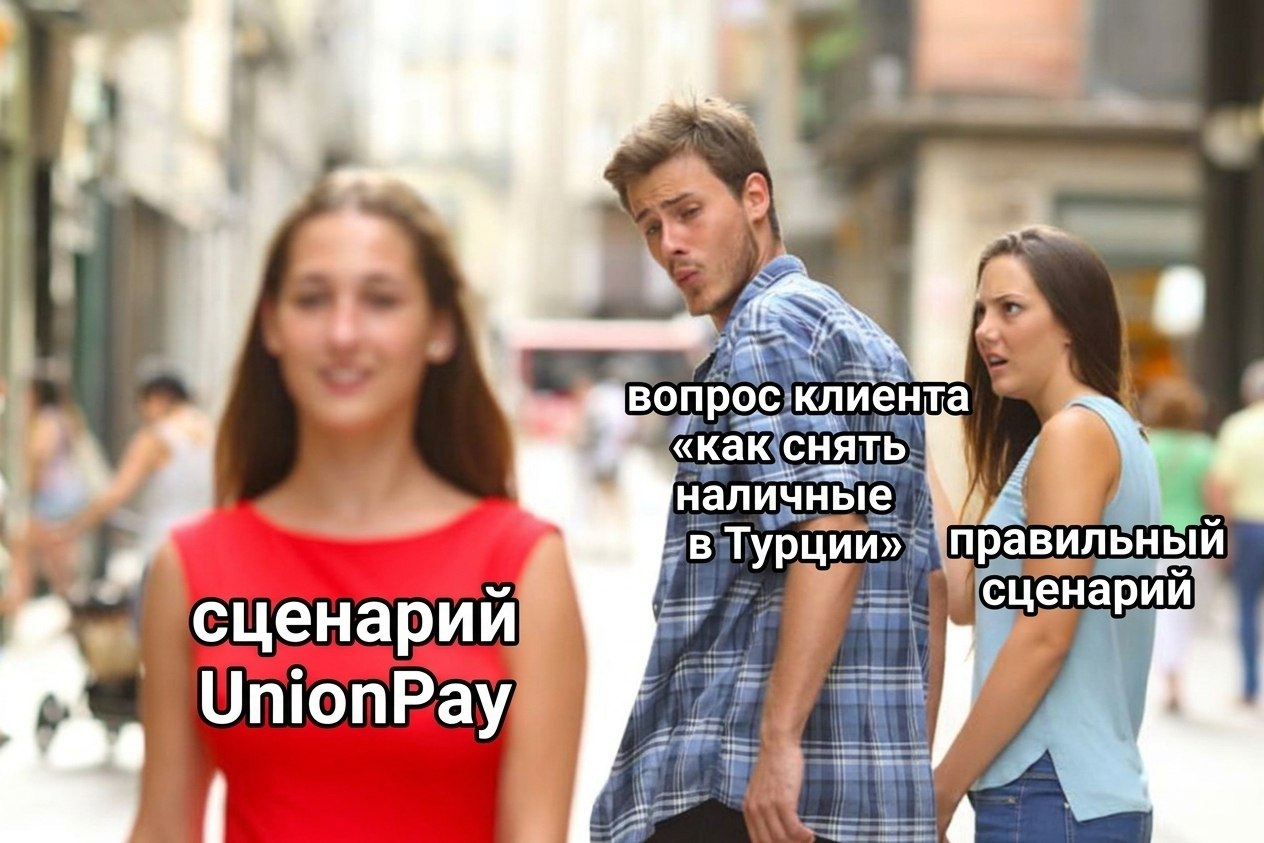
Грабли № 2: бот, который не умеет сказать «не знаю»
В первой версии был один порог: выше – отвечаем, ниже – оператор. Поставишь порог низко – бот бодро отвечает не на тот вопрос. Поставишь высоко – половина трафика снова в контакт-центре. Помогли две вещи: три зоны вместо двух (запуск / уточнение / оператор) и проверка разрыва между первым и вторым кандидатом. Если два сценария идут нос в нос, модель не угадывает, а бот спрашивает.
Грабли № 3: ИБ и «а что это у вас за нейросеть?»
Слово «модель» в банке вызывает у безопасников предсказуемую реакцию [10]. Поэтому мы сразу зафиксировали правила:
-
никаких обновлений из интернета и никаких внешних API – всё внутри контура банка;
-
модель не ходит в банковские системы, она только возвращает идентификатор сценария, а действия выполняет детерминированный код.
Отдельно про персональные данные. Самой модели маскирование не нужно: она просто считает вектор внутри контура. А вот в выгрузках, которые мы изучаем, персональные данные подменяем сопоставимыми значениями: имена на имена, телефоны на телефоны, счета на счета (благо Faker [11] с локалью ru_RU отлично сочиняет правдоподобную тестовую персуху). От текста остаётся сам вопрос клиента, но без единого настоящего персонального значения, поэтому выгрузками с прода можно спокойно обмениваться с коллегами, не опасаясь утечки.
Забавно, но именно «тупость» модели (она только классифицирует и ничего не генерирует) сильно упростила согласования.
И ещё по мелочи
-
«Мошенники» не всегда мошенники. Из 759 сообщений со словами «мошенник», «украли», «списали» настоящих случаев оказалось 9, шум к сигналу примерно 84 к 1. Чаще клиент просто не видит операцию в выписке. Поэтому сценарий не регистрирует обращение сразу, а сначала спрашивает: «С вами кто-то связывался?»
-
Хвост бесконечен. Из 13 тысяч первых сообщений за неделю уникальных формулировок больше 10 тысяч, а топ-20 покрывают меньше 10%. Точными фразами такое не закрыть в принципе. А вежливость клиентов, кстати, никуда не делась: «Здравствуйте» и «Добрый день» в этом топе по-прежнему на почётных местах.
-
Падение метрики не всегда деградация. Однажды автоматизация просела за ночь на 5 п.п. Оказалось, бот ни при чём: пришёл новый канал трафика без сценариев. Смотрите на структуру, а не на среднее.
От справочника к помощнику: «клиент просит – бот делает»
Понять клиента – это половина дела. Вендорский бот понимал неплохо, но дальше вёл себя как справочное бюро:
Чтобы сменить ПИН-код, сверните чат, откройте главный экран, выберите карту, нажмите «Настройки», затем «Безопасность»..
К третьему шагу клиент забывает [12] первый, к пятому – зачем вообще пришёл, и пишет оператору. Круг замкнулся.
Мы разделили сценарии на два типа:
-
информационные – бот объясняет (условия продукта, тарифы, сроки);
-
интеграционные – бот сам ходит в банковские системы и выполняет действие прямо в чате или открывает нужный экран приложения с уже заполненными данными.
Между ними есть промежуточный, но очень полезный шаг – навигация. Чем больше и функциональнее приложение, тем чаще клиенты ленятся что-то в нём искать (и правильно делают): в бот прилетает куча вопросов, которые на самом деле про конкретный раздел. Поэтому сразу после дерева мы собрали у коллег-продуктовиков ссылки на все их модули и добавили в чат особый тип кнопки – internal url. В неё кладём название микрофронтенда в приложении, а по нажатию вызываем у хоста специальный метод, и он переключает «браузер» приложения на нужный модуль. Так бот за один тап отправляет клиента в любую точку приложения – без долгих рассказов, куда нажать.
Тут мы наступили на ещё одни грабли: когда бот выдавал клиенту несколько кнопок-ссылок, было непонятно, куда в итоге он ушёл. В истории чата этого не было видно ни оператору, ни контролю качества, а чтобы считать переходы, пришлось бы вводить отдельные метки. Мы решили изящнее: по нажатию клиент уходит в нужный модуль, а мы фоном публикуем в чат от его имени сообщение с названием нажатой кнопки. Точные параметры перехода кладём в метаданные этого сообщения. Одним выстрелом двух зайцев: клиент, оператор и контроль качества видят в чате сквозную историю перемещений, а у нас остаётся разметка для учёта переходов.
Как теперь выглядит смена ПИНа:
Клиент: хочу поменять пин бот запрашивает список карт клиента Бот: Для какой карты? [Мир ••4821] [Мир ••0937] клиент тапает – открывается экран смены ПИНа именно этой карты
Было пять шагов инструкции, стало два тапа. Так же устроены блокировка карты (бот блокирует сам, пока человек нервничает), закрытие счёта дебетовой карты, баланс баллов лояльности и курс их обмена – бот показывает его по тарифу конкретного клиента, а не отправляет читать условия программы.
Технически интеграционные сценарии устроены довольно просто. У нас есть набор tool’ов на Python: каждый вызывается по имени, иногда с аргументами, полученными на предыдущих шагах, а результат сохраняется в контекст диалога и может использоваться дальше. Например, чтобы показать клиенту подключённые категории лояльности, шаг вызывает условный get_categories, а тот идёт в продуктовый микросервис и возвращает данные именно по этому клиенту. Если дальше нужен экран приложения, в ход идёт та же кнопка internal url. Модель в этой цепочке только на входе – она решает, какой сценарий запустить, и больше ни в чём не участвует.
Оператор по первому требованию
Отдельно про то, что лично меня очень сильно бесит в чужих ботах. Задаёшь вопрос, бот отвечает мимо, просишь позвать оператора, а бот продолжает настаивать, что сам прекрасно справится. Уверен, я такой не один, и такие методы не поддерживаю, поэтому у нас логика [13] более дружелюбная:
-
клиент просит оператора, ещё не задав вопрос – бот уточняет: «Что передать оператору?» Пока клиент формулирует вопрос, оператор помогает другим, а потом получает диалог уже с сутью и всей предыдущей перепиской, без «Здравствуйте» и паузы;
-
вопрос уже задан – переводим на оператора безоговорочно, без попыток удержать клиента в боте.
Что получилось
|
Метрика |
Вендор |
После переезда |
Сейчас |
|
Автоматизация (доля обращений без оператора) |
~60% |
~40% |
~75% |
|
Точность ответа бота |
не мерили |
не мерили |
93,3% |
|
Новый сценарий в проде |
заявка вендору |
– |
интеграционный – раз в 2 недели, FAQ – хоть каждый день |
|
Инфраструктура для модели |
у вендора |
– |
CPU, без GPU |
Как считаем автоматизацию. Обращение открывается с первым сообщением клиента и закрывается одним из двух исходов: клиент замолчал на 3 минуты или ушёл к оператору. К оператору диалог уходит в двух случаях: бот не понял вопрос и ему нечего уточнить, либо клиент сам попросил живого человека. Автоматизация – доля обращений, закрытых по молчанию. Честно признаем: молчание – это прокси для «бот помог», а не гарантия. Клиент мог замолчать и потому, что махнул рукой.
Именно поэтому точность ответа мы считаем отдельно: автоматизация её не видит, диалог может завершиться «успешно», а ответ при этом быть не по теме. Для этого периодически берём обращения, где ответил бот, и проверяем, соответствует ли ответ вопросу клиента. Проверяем двумя способами: вручную и прогоном маскированных выгрузок через мощную LLM (в проде её у нас нет, а вот в роли придирчивого проверяющего она пригодилась). В последнем срезе (7 014 обращений за 26–30 июня) по теме оказались 93,3% ответов, ложноположительных – 6,7%.
Главный бизнес-эффект: рост клиентской базы больше не означает автоматический рост штата операторов – бот забирает типовые вопросы на себя. Операторы занимаются нестандартными ситуациями, а не в сотый раз за день рассказывают, где в приложении кнопка смены ПИНа.
Что бы я сказал себе до переезда и что дальше?
1. Своя команда – плохая выборка. Пока чатом пользуется команда, автоматизация выглядит прилично: свои пишут аккуратнее и примерно знают, как устроен бот. Реальные клиенты пишут совсем иначе, и цифры поедут вниз. Пускайте реальных клиентов как можно раньше, пусть на маленькую долю, и закладывайте просадку в план: первый релиз почти наверняка будет хуже вендора, у которого за плечами годы доводки. И отбирайте эту долю по статистике, которую формируете сами: какую логику вендор закладывает в свои отчёты, известно одному ему.
2. Для классификации интентов не нужна LLM. Компактный энкодер на CPU разворачивается за дни, отвечает за миллисекунды и не придумывает текст от имени банка. А качество упирается не в размер модели, а в данные. : история с UnionPay показала, что перекос в базе фраз ломает распознавание сильнее, чем любая архитектура. И не стоит выбрасывать старый добрый полнотекстовый поиск: у нас эмбеддинги работают в паре с FTS Postgres, и он страхует модель от уверенных, но ложных совпадений. Начинайте с простого, LLM оставьте для задач, где она действительно нужна.
3. Автоматизация – значит сделано. Если бот идеально понял вопрос, но ответил инструкцией из пяти шагов, диалог всё равно часто заканчивается оператором. Интеграционные сценарии и уточняющие кнопки дают не меньше, чем модель. И именно они в итоге оправдывают своё решение вместо коробки: у вендора каждая такая интеграция была бы отдельным счётом и заявкой в его очередь. А ещё отдельной проработкой со стороны банка: данные клиентов выходили бы за границы системы, и архитекторам, безопасникам, юристам и другим участникам процесса пришлось бы поломать голову и извести немало бумаги.
Параллельно у нас работает R&D-команда, которая экспериментирует с генеративными моделями в закрытом контуре. Принцип тот же: факты и условия продуктов берутся из валидированных шаблонов, а модель отвечает за живость диалога. Но это уже тема для отдельной статьи. Если интересно, пишите в комментариях. А если вы сейчас стоите перед тем же выбором «платить вендору или писать своё», расскажите, что в итоге решили.
Автор: t0rr
Источник [14]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38054
URLs in this post:
[1] РСХБ: https://play.google.com/store/apps/details?id=ru.rshb.dbo&hl=ru
[2] статье: https://habr.com/ru/companies/rshb/articles/1039012/
[3] опыт: http://www.braintools.ru/article/6952
[4] App.Farm: http://App.Farm
[5] как её создавали: https://habr.com/ru/companies/rshb/articles/825816/
[6] систему ДБО «Свои финансы: https://habr.com/ru/companies/rshb/articles/990094/
[7] поведение: http://www.braintools.ru/article/9372
[8] Карфаген вендорский чат должен был быть разрушен: https://ru.wikipedia.org/wiki/%D0%9A%D0%B0%D1%80%D1%84%D0%B0%D0%B3%D0%B5%D0%BD_%D0%B4%D0%BE%D0%BB%D0%B6%D0%B5%D0%BD_%D0%B1%D1%8B%D1%82%D1%8C_%D1%80%D0%B0%D0%B7%D1%80%D1%83%D1%88%D0%B5%D0%BD
[9] выпускает: https://www.rshb.ru/natural/debetcards/unionpay-apply
[10] реакцию: http://www.braintools.ru/article/1549
[11] Faker: https://faker.readthedocs.io/
[12] забывает: http://www.braintools.ru/article/333
[13] логика: http://www.braintools.ru/article/7640
[14] Источник: https://habr.com/ru/companies/rshb/articles/1103790/?utm_campaign=1103790&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.