Как я скрестил RAG, LLM и RandomForest: архитектура торгового сигнала с доказательствами
Вступление
В первой части [1] я рассказывал, как собрал RAG-систему с LangGraph-агентом на локальных LLM. Она умела искать новости, отвечать на вопросы и извлекать сущности. Но для трейдинга этого мало — нужно не просто читать, а предсказывать.
В этой статье я расскажу, как превратил новостной скрапер в ML-пайплайн, который генерирует торговые сигналы (BUY/SELL/NEUTRAL) с доказательствами. Мы пройдём путь от привязки новостей к тикерам до Explainable UI, разберём грабли на малых данных и заглянем в архитектурное будущее проекта.
Стек: Scikit-learn, Plotly, FastAPI, Streamlit, PostgreSQL, Ollama.
0. Что изменилось с момента выхода первой статьи
В первой части мы остановились на том, что у нас есть RAG-система и агент. Но когда база выросла с 12 000 до 37 000 статей, выяснилось, что «в лоб» обрабатывать всё подряд — слишком дорого.
Раньше у нас было три независимые фоновые задачи (Classify, NER, Enrich), которые работали параллельно и мешали друг другу, опрашивая Ollama. Каждая задача пыталась загрузить свою модель в VRAM, вызывая «пинг-понг» (о котором я писал в первой статье). Плюс мы тратили GPU на новости, которые не влияют на рынок (спорт, культура, происшествия).
Что мы сделали:
-
Перешли к единому конвейеру (Unified Pipeline). Теперь статья проходит цепочку:
Классификация → Фильтр мусора → Market Impact → NER → Summary → Embed. Если статья не проходит фильтр, она помечается какskipped, и мы не тратим на неё ресурсы. -
Изменили настройки Ollama (увеличили параллелизм и разрешили держать две модели в памяти [2]), чтобы этот конвейер работал максимально быстро. Подробности — в разделе 3.
Именно этот архитектурный сдвиг (от «обрабатываем всё» к «обрабатываем только важное») позволил нам перейти к ML-сигналам без взрыва нагрузки на GPU.
1. От текста к тикерам: Entity Linking
Чтобы модель могла предсказывать доходность акции, нужно знать, о какой компании написана новость. NER (извлечение сущностей) находит «Сбер» или «Лукойл», но не знает, что это тикеры SBER и LKOH.
Решение: словарь синонимов (tickers.yaml), который автоматически пополняется из API Мосбиржи. Для каждой новости мы сопоставляем извлечённые NER-сущности с тикерами.
Особый случай: Альфа-банк.
Сначала мы столкнулись с ложным срабатыванием: «Альфа-банк» матчился наSVCB(Совкомбанк). Но при детальном разборе выяснилось, что NER корректно извлёк и «Альфа-банк», и «Совкомбанк» из текста — просто в словаре не было Альфа-банка.Мы добавили фиктивный тикер
ALFAMOCK. Это не костыль, а заглушка на будущее: собираем новости сейчас, а когда банк выйдет на биржу — просто заменим тикер на реальный.
На текущий момент в базе 37 268 статей из 24 источников. Entity Linking работает в фоне, привязывая новости к 50+ ликвидным акциям Мосбиржи.
2. Feature Engineering: из чего состоит сигнал
Каждая новость имеет market_impact (bullish, bearish, neutral). Для каждого дня и тикера мы считаем фичи:
-
market_pressure— сумма направлений (+1 за bullish, -1 за bearish). -
news_count— количество новостей. -
has_summary— была ли сделана суммаризация (признак важности). -
vol_5d,vol_20d— волатильность (стандартное отклонение доходностей). -
adv_20d— средний объём торгов (ликвидность).
Новая фича: Volume Anomaly.
Мы добавили отслеживание аномальных объёмов торгов. Если объём за день превышает средний (ADV) в 3 и более раз, это часто предшествует движению цены (вход или выход крупного игрока). Фича volume_ratio = volume / adv_20d уже заложена в архитектуру и будет тестироваться на исторических данных.
Грабли: Time Decay.
Мы попытались внедрить временное затухание (свежие новости весят больше). Ноmarket_pressureстал дробным (0.85 вместо 1), и RandomForest «сломался» — Accuracy упала с 0.52 до 0.36. На 55 записях это добавило шум, а не сигнал. Отложили до накопления 200+ записей (ADR-023), чтобы не заниматься преждевременной оптимизацией.
3. Настройка Ollama на одной Tesla P100
В первой статье я упоминал, что поднял OLLAMA_NUM_PARALLEL с 1 до 2, и это дало ускорение в 1.5 раза. С ростом базы до 37 000 статей этого стало мало. У нас есть сервер с двумя Tesla P100 (по 16 ГБ), но мы сознательно решили оптимизировать пайплайн так, чтобы всё работало на одной карте.
Почему не на двух?
Когда модели не хватает 16 ГБ, Ollama начинает «размазывать» слои между GPU. Это вызывает передачу данных по PCIe и падение скорости в 3–5 раз, а также повышает нестабильность при параллельных запросах. Для наших задач (несколько моделей + параллельные запуски) стабильность одной карты оказалась важнее, чем гипотетическая возможность загрузить модель побольше.
Проблема: VRAM Ping-Pong.
Даже на одной карте Ollama пыталась выгружать модели, если ей не хватало места. Это вызывало задержки: пока модель грузится в память, запросы висят в очереди.
Решение 1: OLLAMA_MAX_LOADED_MODELS=2.
Мы разрешили Ollama держать обе нужные модели (Qwen 14B и BGE-M3) в памяти одновременно. Это убрало эффект «холостого хода».
Решение 2: OLLAMA_NUM_PARALLEL=6 (подобрано опытным путём).
Мы включили параллельную обработку запросов. Параметр подбирался эмпирически:
-
Подняли до 6, замерили время обработки батча (логи Ollama +
nvidia-smi). -
При 8 начали замечать, что GPU упирается в потолок по памяти, и запросы начинают таймаутиться.
-
Остановились на 6 параллельных запросах — это дало 1.5–2х ускорение по сравнению с дефолтным значением, при этом оставив запас по VRAM (свободно около 6.3 ГБ).
Опасения: «размазывание» моделей по картам.
Мы сознательно не стали поднимать NUM_PARALLEL выше 6 и не используем вторую GPU. Если суммарный объём двух моделей перестанет влезать в 16 ГБ одной карты, Ollama начнёт распределять слои между GPU №0 и GPU №1. Это чревато падением скорости в 3–5 раз (из-за передачи данных по PCIe) и нестабильностью. Сейчас у нас запас по памяти, но мы мониторим этот момент через логи, чтобы вовремя остановиться.
Итог: После настройки (MAX_LOADED_MODELS=2, NUM_PARALLEL=6, KEEP_ALIVE=-1 и CUDA_VISIBLE_DEVICES=0) пайплайн обработки статей ускорился в 1.5–2 раза, при этом вся система работает стабильно на одной карте, а вторая остаётся в резерве или для других задач.
4. ML-модель и Walk-Forward Validation
Мы используем RandomForest с калибровкой (Platt scaling). Это даёт не просто предсказание, а откалиброванную вероятность (если модель говорит 0.65, значит, она права в 65% случаев).
Почему обычный train/test split не подходит?
Финансовые ряды нестационарны. Если мы обучим модель на первых 80% данных, а протестируем на последних 20%, мы можем случайно попасть на «удачный» период. Поэтому мы используем Walk-Forward Validation.
Честное ограничение: Наша целевая архитектура (ADR-020) — это окно обучения [3] 30 дней, тест 7 дней. Но на текущем объёме данных (59 записей с новостями) мы используем 14/3/3 (обучение 14 дней, тест 3, сдвиг 3), чтобы получить хоть какое-то окно валидации. При накоплении 200+ записей мы перейдём на целевые 30/7/1.
Результат: На 59 записях с новостями мы получили среднюю Accuracy 0.62 (медиана 0.67). Однако размер тестовой выборки составил всего 45 примеров. Это предварительная оценка. Мы честно ждём накопления данных (в очереди ещё 30 457 статей), чтобы модель нашла стабильный сигнал, а не выучила шум.
5. API и Explainable UI
Мы сделали два эндпоинта:
-
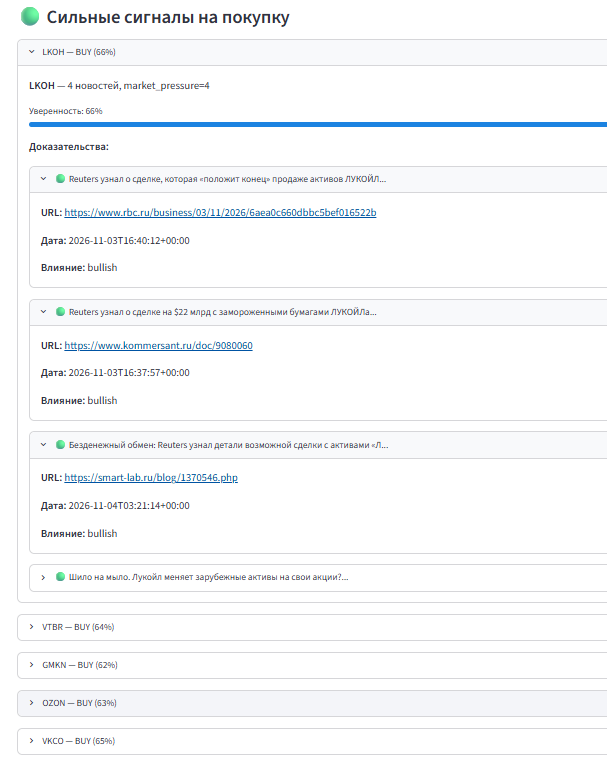
GET /signal/{ticker}— возвращает сигнал (BUY/SELL/NEUTRAL), уверенность и доказательства (список новостей, повлиявших на решение). -
GET /candles/{ticker}— исторические свечи для графиков.
В Streamlit мы нарисовали терминал трейдера:
-
График свечей (Plotly Candlestick).
-
Прогресс-бары уверенности.
-
Раскрывающиеся новости с ссылками и направлением влияния.
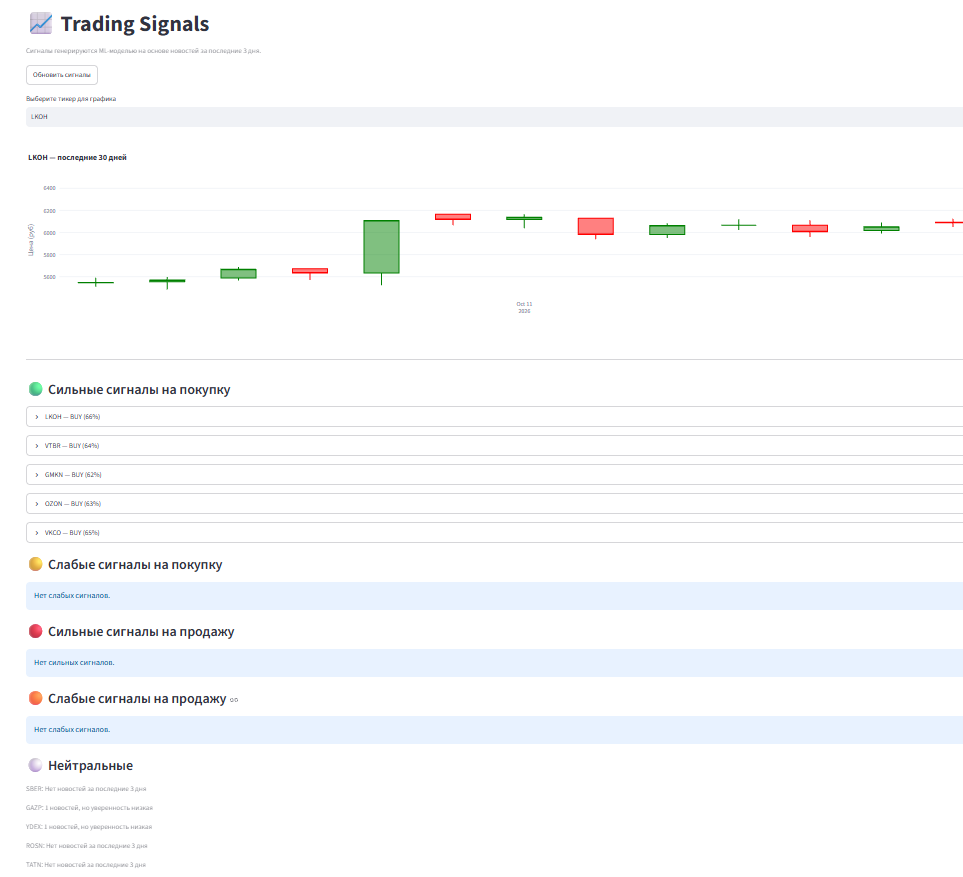
Главная фишка: Explainable AI. Трейдер видит не просто «BUY», а почему модель так решила. Это снижает недоверие и позволяет быстро проверить контекст.
6. Проблема смешанных сигналов (и почему мы не стали костылять)
При тестировании мы заметили, что VKCO получил сигнал BUY (64%), хотя его новости были нейтральными (market_pressure=0). Модель просто выучила, что рынок растёт в 55% случаев.
Мы рассмотрели два варианта:
-
А: Жёсткий фильтр в API (если
market_pressure == 0, ставим NEUTRAL). -
Б: Добавить в модель фичи доминирования (
bullish_count,bearish_count,dominance).
Отвергли А, потому что это маскировка симптома. Если у тикера 2 позитивные новости и 1 негативная (market_pressure=1), API всё равно выдаст BUY, хотя фон смешанный.
Выбрали Б, но отложили реализацию до накопления 200+ записей. Сейчас API выдаёт «грязные» сигналы, но мы честно документируем причину и не прячем проблему за заглушками. Это осознанный техдолг.
6. Vision 2.0: Куда мы движемся
Проект не стоит на месте. Мы зафиксировали концепцию развития (ADR-025), разделив фичи на три трека:
-
Quick Wins: Аномалии объёма (
volume_ratio), извлечение корпоративных событий (buyback/SPO через LLM), ожидаемая доходностьE[return]для расчёта Risk/Reward. -
Core R&D: Event Horizons — прогноз горизонта выхода (Take Profit) в зависимости от типа события (геополитика, макро, корпоративные). Global Risk Factor — учёт влияния мирового фона (VIX, S&P 500, Brent).
-
Moonshot: Fragility Score — детекция «хрупкости» рынка (по мотивам работ Нассима Талеба). Мы не обещаем предсказать «чёрного лебедя», но можем сигнализировать о расхождении между новостным фоном и реакцией [4] цены.
Вывод
Построить end-to-end ML-пайплайн на локальных новостях — реально. Главное — честно признавать ограничения данных и не костылять там, где нужно подождать. Мы показали, что даже на малых данных (59 записей) можно получить работающий пайплайн и UI с доказательствами, а архитектура (ADR, Vision 2.0) готова к масштабированию.
Архитектурная схема пайплайна (Mermaid) доступна в документации проекта. Исходный код публичной части открыт.
Ссылка на GitHub: https://github.com/tzar26/news_scrapper [5]
Автор: Knez
Источник [6]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38135
URLs in this post:
[1] первой части: https://habr.com/ru/articles/1101266/
[2] памяти: http://www.braintools.ru/article/4140
[3] обучения: http://www.braintools.ru/article/5125
[4] реакцией: http://www.braintools.ru/article/1549
[5] https://github.com/tzar26/news_scrapper: https://github.com/tzar26/news_scrapper
[6] Источник: https://habr.com/ru/articles/1104642/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1104642
Нажмите здесь для печати.