От скрипта к трансформеру: как behavior cloning привёл нас к серебру Kaggriculture
В детстве мы играли в «Весёлую ферму», а летом 2026 года увидели на Kaggle соревнование Kaggriculture [1]. Здесь два агента ведут соседние фермы: выращивают урожай, держат скот и продают продукцию на общий рынок. Через 30 игровых дней побеждает тот, у кого больше денег.
Мы из команды трайба «Цифровой ассистент В2С». За два месяца проверили шесть подходов — от скрипта с правилами до трансформера на 20 млн параметров. Заняли 436-е место из 10 148 команд и получили серебро.
Коротко
-
Случайный набор лавок сильно меняет доход фермы. Чтобы отличать удачный розыгрыш от улучшения агента, мы переигрывали одни и те же партии.
-
По записям сильного игрока собрали k-NN-агента без обучения [2]. Нейросеть тоже учили повторять [3] готовые решения — методом behavior cloning (BC).
-
Лучшей моделью стал BC-трансформер. Настроенный PPO добавил небольшой прирост, хотя в ранних запусках агент мог разучиться торговать.
Содержание
-
Что получилось с PPO [10]
-
Результат и выводы [11]
-
Ссылки [12]
Ферма с общим рынком
У каждого игрока поле 10 × 10, разделённое на четыре квартала. Один доступен сразу, остальные нужно купить. На грядках растут овощи, в постройках живут коровы, овцы и гуси. Урожай надо вовремя собрать, животных — покормить. Партия длится 720 тактов: 30 дней по 24 часа.
Работают фермер и наёмные рабочие. Их нанимают на один день; цена каждого следующего найма растёт по ряду Фибоначчи. Десять рабочих обходятся в 143 доллара, двенадцать — уже в 376. Купить землю и стадо недостаточно: нужно ещё успеть их обслужить.
Весь урожай поступает на один рынок. У каждого товара есть городской запас; равновесный уровень — 10 000 единиц. Ниже него цена растёт, выше — падает. Пшеницы и яиц можно продать тысячи, а шерсти достаточно добавить 59 единиц сверх равновесия, чтобы цена упала до доллара. У клубники этот порог — 62 единицы, у молока — 76.
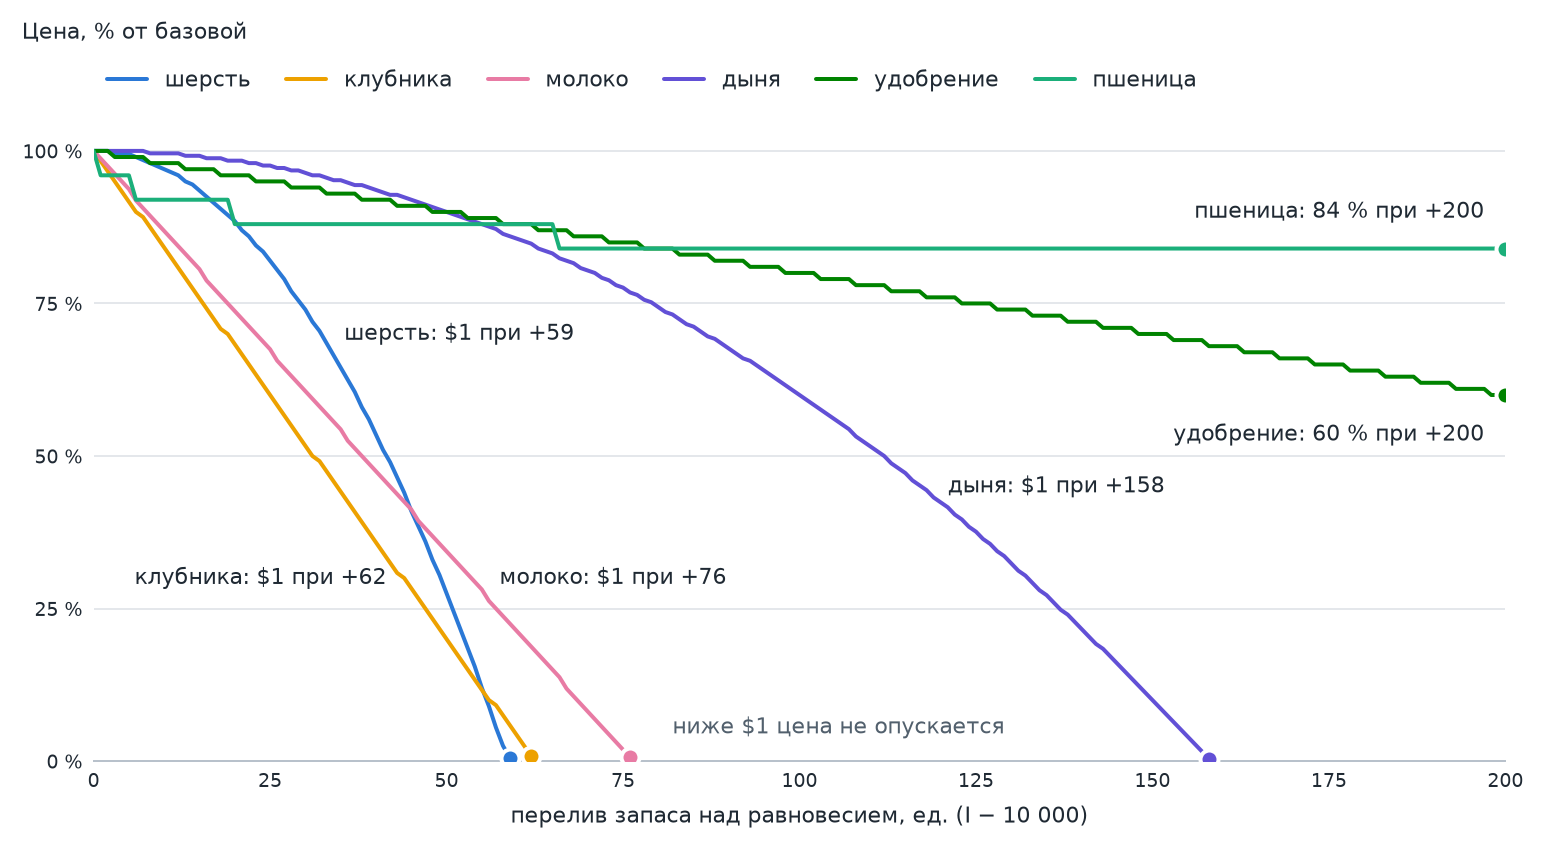
Продажи обоих игроков пополняют один запас. Заявки обрабатываются поштучно: i-я заявка встречается с i-й заявкой соперника, оба получают одну цену, затем она пересчитывается. Поэтому имеет значение и объём, и порядок продаж. В 541 партии команд из золотой зоны к последнему такту молоко стоило в среднем около 9 долларов при базовой цене 160.
По нашей оценке на этих партиях, в среднем на двоих 38 987 долларов оставались несобранными на пустых рынках, ещё 37 407 терялись на переполненных. Пока игроки сбивали друг другу цену одного товара, спрос на другой оставался неудовлетворённым. Поэтому агенту приходилось выбирать, что производить, и следить, сколько рынок ещё готов купить.
Товары с рынка забирают городские лавки. С 3-го по 24-й день каждые трое суток открывается новая; её тип выбирается случайно из восьми. Лавка снимает свой набор товаров раз в четыре такта. Магазин пряжи, например, создаёт спрос на шерсть. У дыни и удобрения спроса от лавок нет.
В 3 000 партиях зеркального бота первая лавка меняла суммарный доход игроков примерно в полтора раза. Со смузи-баром они вместе зарабатывали в среднем 207 630 долларов, с кафе для питомцев — 134 517. Агенты те же, экономика партии другая.
Какой разброс приходится на игру
Мы разложили дисперсию итоговой кассы по 2 266 результатам игроков из 34 команд методом REML. На саму партию пришлось 88,8 % разброса, в основном из-за набора лавок. На свою команду — 1,9 %, на соперника — 2,3 %. Эти проценты описывают дисперсию итоговой кассы, а не долю побед, обусловленных случайностью [13].
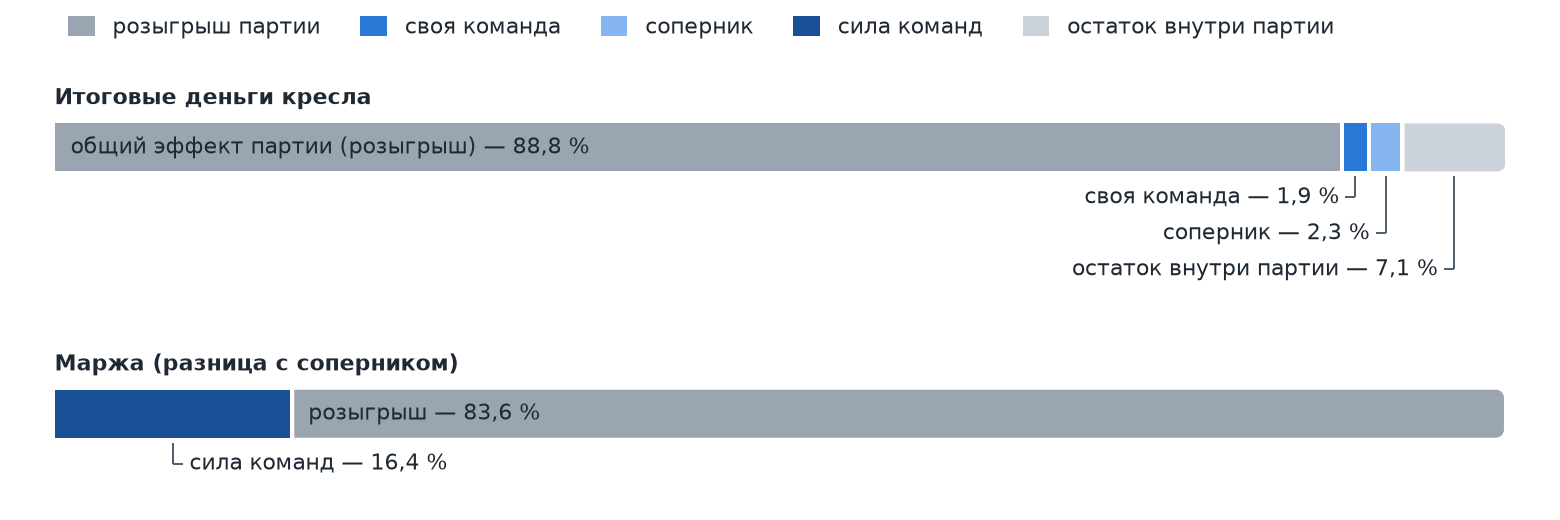
В разнице касс игроков вклад силы команд был выше, но всё ещё составлял только 16,4 % разброса. Судить о новой версии по нескольким случайным партиям было ненадёжно: хороший доход мог объясняться удачным спросом. Дальше все изменения мы сравнивали на одинаковых сидах.
Как мы проверяли изменения
Эталоном служил официальный движок kaggle-environments 1.32.7. Для обучения мы написали среду на JAX, которая обрабатывала батчи партий на GPU. На проверке совпали все 2 157 переходов, которые мы сравнили с эталоном.
Для реальных партий собрали стенд-«призрак». В реплее Kaggle есть info.seed. Запускаем среду с тем же сидом, ставим кандидата на наше место, а соперник повторяет записанные ходы. Наш исходный агент воспроизвёл так 465 из 466 партий до доллара.
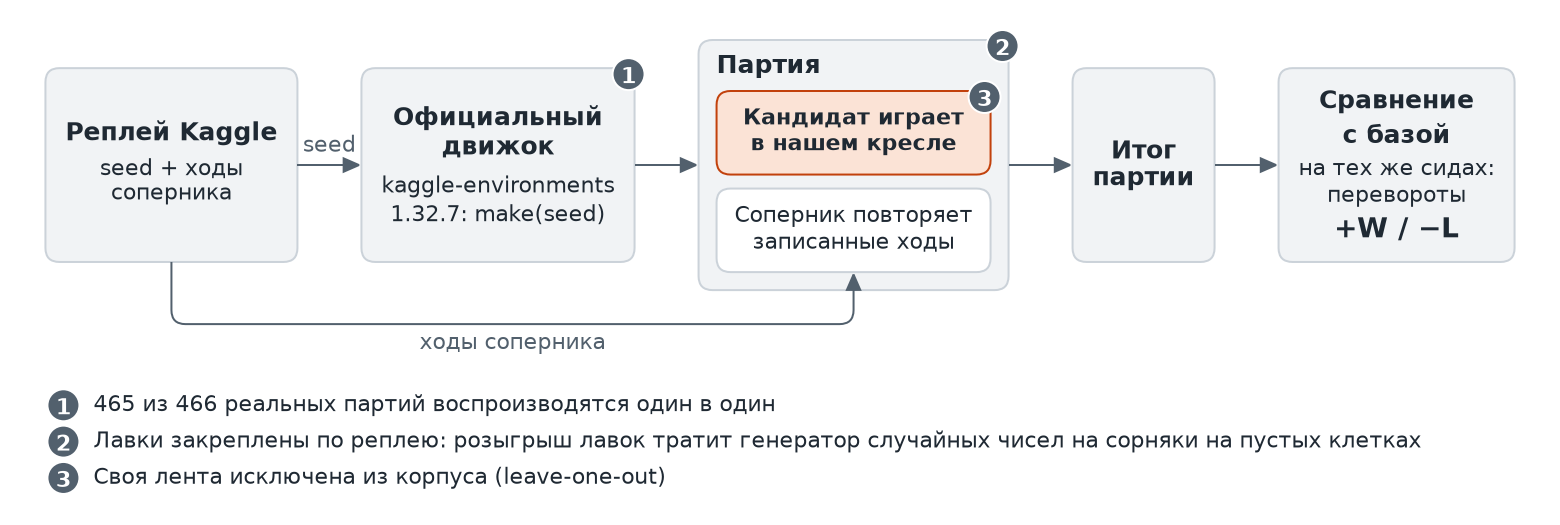
Основной метрикой стали «перевороты». Запись «+23/−12» означает: кандидат выиграл 23 партии, проигранные базовой версией, и проиграл 12, которые она выигрывала. Остальные исходы совпали. Так мы сравнивали изменения на одном наборе партий, не подменяя качество агента доходностью случайного розыгрыша.
Для проверки использовали знаковый тест. При равной силе каждый переворот равновероятен в обе стороны: «+6/−0» даёт p ≈ 0,031, а «+15/−13» не позволяет отличить улучшение от шума. В лиге гипотез на 15 тысяч партий из 17 идей подтвердилась одна.
У такого теста есть граница: соперник воспроизводит запись и не отвечает на новые действия кандидата. «Призрак» удобен для парного сравнения версий, но его результаты нужно отделять от игр на Kaggle.
Первый бот: правила и продажи
В августе мы разобрали 260 реплеев лидеров. Многие начинали похоже: почти всю кассу тратили на рабочих, посевы и животных. К 12-му дню у фермы было около 60 грядок, 13–14 животных и три купленных квартала. Мы записали этот шаблон в скрипт с двумя ветками под разные наборы лавок.
Для продаж сделали отдельный симулятор цен. Он совпал с движком бит в бит на 1,68 млн значений. Выручку считали поштучно: каждая проданная единица пополняет запас и меняет цену следующей. По этому симулятору динамическое программирование выбирало день продажи каждого товара, учитывая, как лавки освобождают рынок.
Бот получил live-рейтинг 2 056 в конце августа, версия со второй веткой — 2 579 в начале сентября. Но в реплеях 16,7 % заявленного объёма продавалось не дороже 5 долларов и приносило лишь 0,33 % выручки. Запас шерсти доходил до 10 059–10 060 единиц, а бот всё равно подавал ещё пять заявок по доллару.
Разница была заметна и при одинаковой корзине товаров: победители получали на 3,4 доллара больше за единицу. Сам по себе объём производства не объяснял их преимущество. В исходном шаблоне 57 % урожая продавали в первый час суток; повторять это расписание независимо от ситуации на рынке было недостаточно.
Правила было удобно проверять: меняем одну константу, переигрываем те же партии. Однако скрипт следовал усреднённому шаблону, а соперника замечал только по ценам. К сентябрю похожие программы использовали сотни команд. Нам понадобился способ точнее воспроизводить решения сильного игрока.
k-NN: продолжить чужую партию
В записях обнаружилась повторяемость: у многих сильных команд последовательности из первых 51 хода совпадали на разных сидах байт в байт, а дебют мог повторяться до 10-го дня. Не у всех — лидер таблицы к 7-му дню уже заметно подстраивался под партию. Но для копирования детерминированной программы данных хватало.
Мы собрали 782 «ленты» одного топ-игрока. В каждой записаны действия по тактам, цены девяти товаров, открытые лавки, раскладка фермы и итоговая касса. Агент искал подходящую ленту и повторял её ход. Это имитация через поиск ближайшего примера [2] [14]: обучение весов не требуется.
Как выбирали ленту
-
Отбирали записи, где фермер и рабочие стоят на тех же клетках, лавки открылись в том же порядке, а раскладка отличается не больше чем на 6 клеток. Пару «у нас пусто, в записи сорняк» различием не считали.
-
Если записей с нашими лавками не было, снимали это условие. Сначала оставляли минимальное расхождение раскладки, затем — наиболее близкий спрос на товары от открытых лавок.
-
Среди оставшихся выбирали ближайшую по ценам за последние сутки. При равенстве расстояний брали запись с большей итоговой кассой.
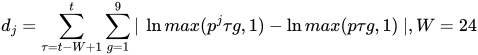
Здесь  — лента,
 — товар,
 — текущий такт. Цены отражают сразу наш сбыт, продажи соперника и спрос лавок. Логарифм позволяет сравнивать относительные изменения у товаров по 25 и по 250 долларов.
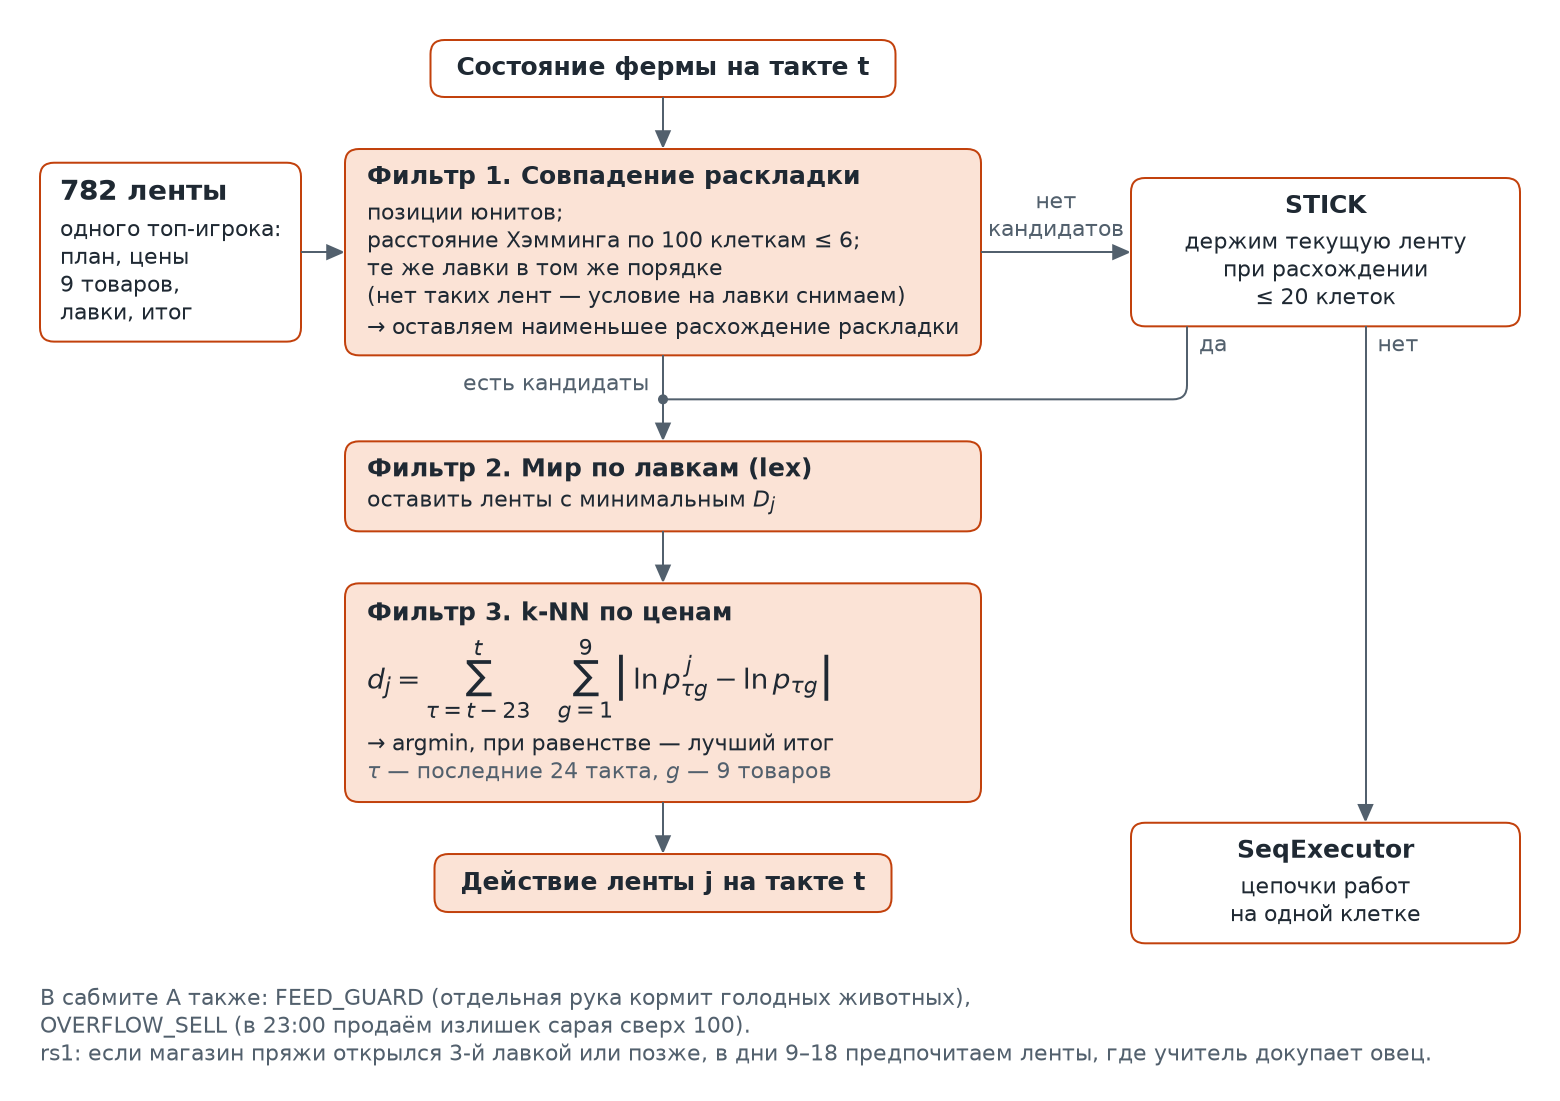
Ленту выбирали заново на каждом такте. Если подходящих записей не было, продолжали текущую, пока раскладка расходилась не больше чем на 20 клеток. После этого управление получал SeqExecutor: он назначал фермеру и рабочим задания с учётом расстояния, ценности работы и срочности полива и кормления к вечеру.
Переход на собственный исполнитель не всегда помогал. Когда подходящих лент не было, продолжение текущей записи вместо переключения на исполнителя дало +11/−0 переворотов. Отдельная страховка от голода — рабочий докармливает животных, пропустивших второй день кормления, — дала +4/−0. А перед полуночью мы продавали излишек сверх ёмкости сарая в 100 единиц: иначе он сгорал.
Отдельно разобрали партии с поздним магазином пряжи: наша копия выигрывала в них лишь 37%. Топ-игроки после его открытия докупали овец. Если магазин появлялся третьей лавкой или позже, с 9-го по 18-й день мы предпочитали совместимые ленты, где учитель покупал овец в ближайшие трое суток. Ради такой записи разрешали ещё одну клетку расхождения раскладки.
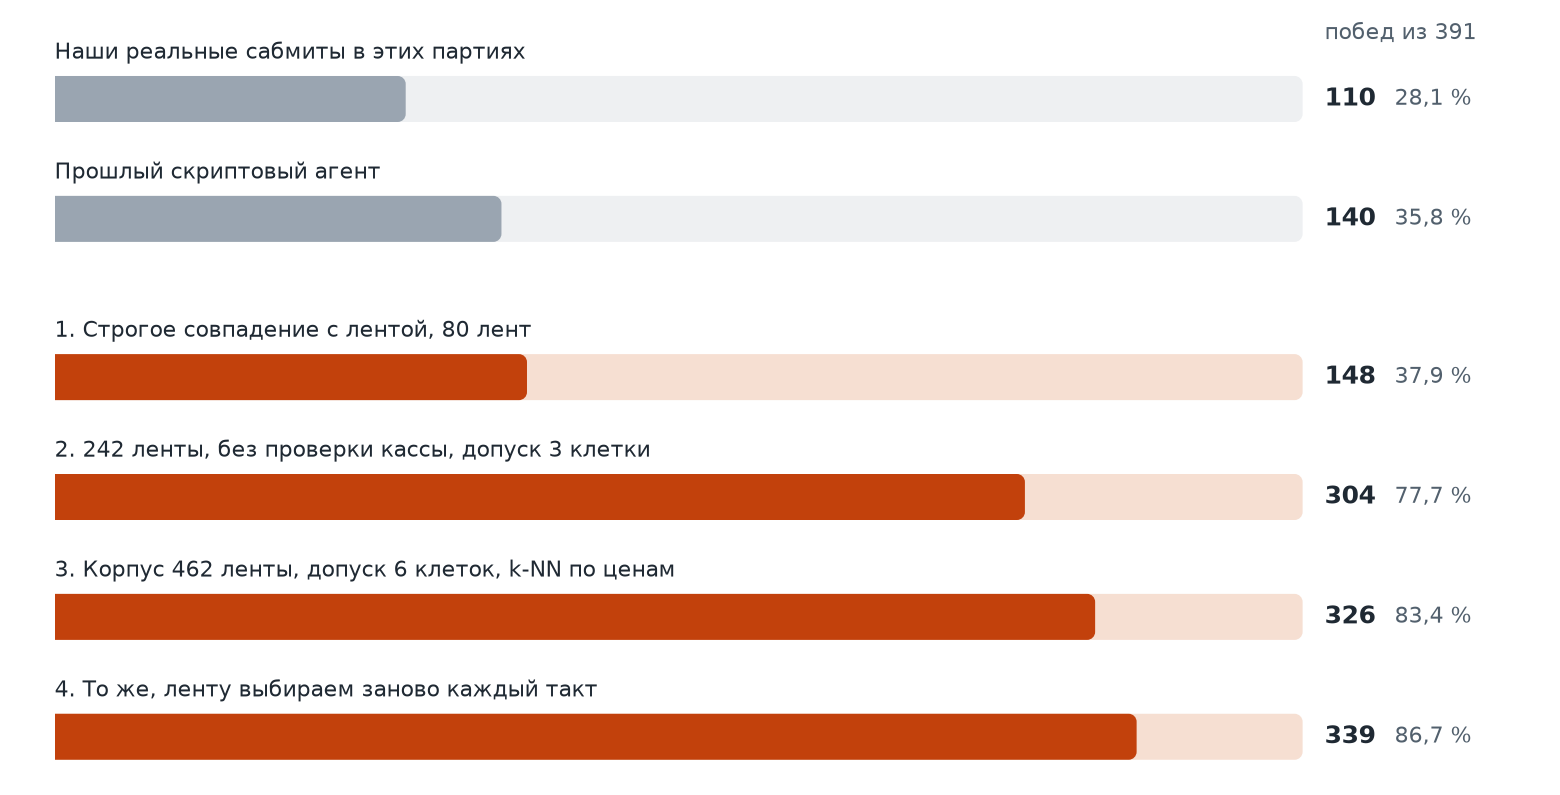
На наборе из 391 реальной партии нашей команды строгая ранняя версия выиграла 148 раз, финальная — 339. Последний скриптовый кандидат на том же стенде выиграл 140. Выбор по близости цен вместо итоговой кассы ленты дал +23/−12; допуск в 6 клеток вместо 3 — +7/−2. Это результаты переигровок против записанного соперника, а не доля побед в живом турнире.
Где копия переставала быть похожей
Мы поставили копию в точные состояния оригинала и сравнили действия. В дни 0–5 она повторяла его ход всегда, в дни 6–14 — в 85 % случаев, с 15-го дня — лишь в 2,5 %. К этому времени в корпусе почти не оставалось подходящих продолжений: k-NN выбирал похожую запись, но причины решений учителя ему были недоступны.
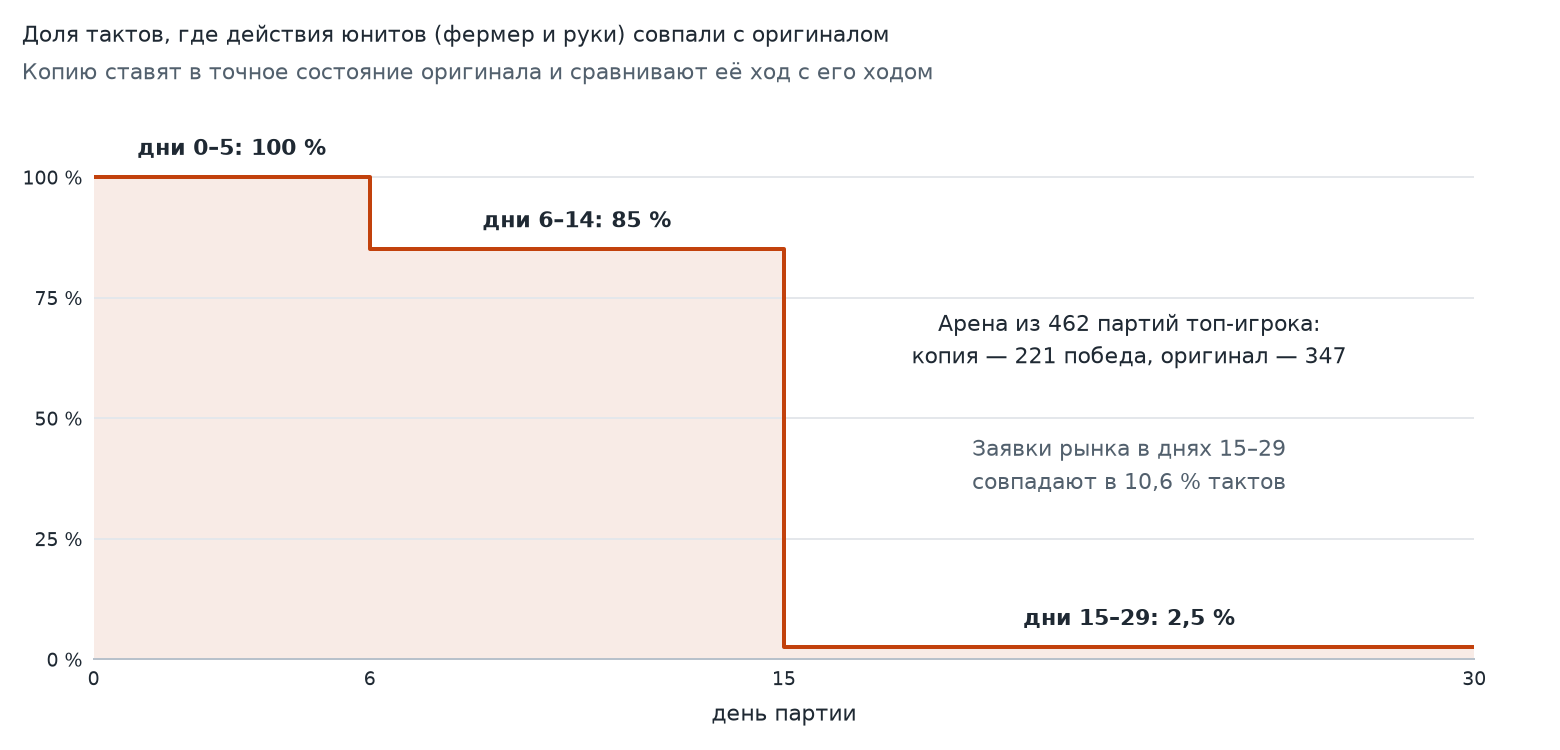
В отдельной проверке на 462 записанных партиях копия выиграла 221 раз; исходный бот победил в 347 из этих партий. Касса копии была в среднем ниже на 6,9 тыс. долларов, почти весь разрыв возникал после 17-го дня. Повторяемый дебют мы освоили, а в поздней игре всё сильнее отставали. Кроме того, весь подход зависел от доступности партий одного сильного игрока.
Два подхода, которые остались на стенде
Мы пробовали дополнять ленту собственной логикой [15]. Реактивный агент прогнозировал кассу и склад и вмешивался, когда план грозил нехваткой денег. Но модель не учитывала часть правил производства и ошибочно предсказывала дефицит примерно в трети тактов. Простая перестановка продаж тоже меняла их спаривание с заявками соперника.
Локальные вмешательства с окном в 12 тактов помогали, окно в 24 уже вредило. Полная замена управления юнитами дала 33 тыс. долларов против 113 тыс. у опорной ленты: агент потратился на уход за животными и не накопил на второй квартал. До отправки на Kaggle он не дошёл.
Другой вариант — план сезона на CP-SAT из OR-Tools [3] [16] с отдельной LP-задачей сбыта. В модель вошли посадки, животные, земля, рабочие, корм и склад: 2 170 переменных и 11 тысяч ограничений. На старте решатель находил план с расчётным доходом 141 тыс. долларов за 10 секунд, 184 тыс. — за 20. Это оценки модели, не заработок агента в партии.
Верхняя граница при этом оставалась около 260 тыс. долларов: оптимальность найденного плана не была доказана.Модель предлагала покупать землю сразу, а стадо — позже, но так, чтобы успеть получить первую продукцию. Такие планы помогали разбирать экономику, но ещё не давали готовый агент.
План быстро устаревал, а даже с подсказками первый допустимый вариант искался около секунды. Пересчитывать его каждый такт было слишком дорого. LP сбыта работал за 7 мс, но проблему пересчёта всего сезона не решал. Этот подход тоже остался на стенде.
BC: учимся повторять решения
Затем мы перешли к нейросети. За основу взяли решение победителя другого симуляционного соревнования Kaggle — Orbit Wars. Там каждой сущности игры соответствовал отдельный токен; модель обучали через PPO в self-play и дистиллировали лучший чекпойнт. Мы перенесли эту архитектуру и почти все основные гиперпараметры.
Как ферма попала в трансформер
Состояние заняло 197 токенов: глобальные признаки, игроки, клетки, юниты, товары, рыночные слоты и память [17]. В токене клетки лежат признаки обеих ферм, а среди юнитов есть и свои, и чужие. Так модель получает состояние соседа вместе со своим.
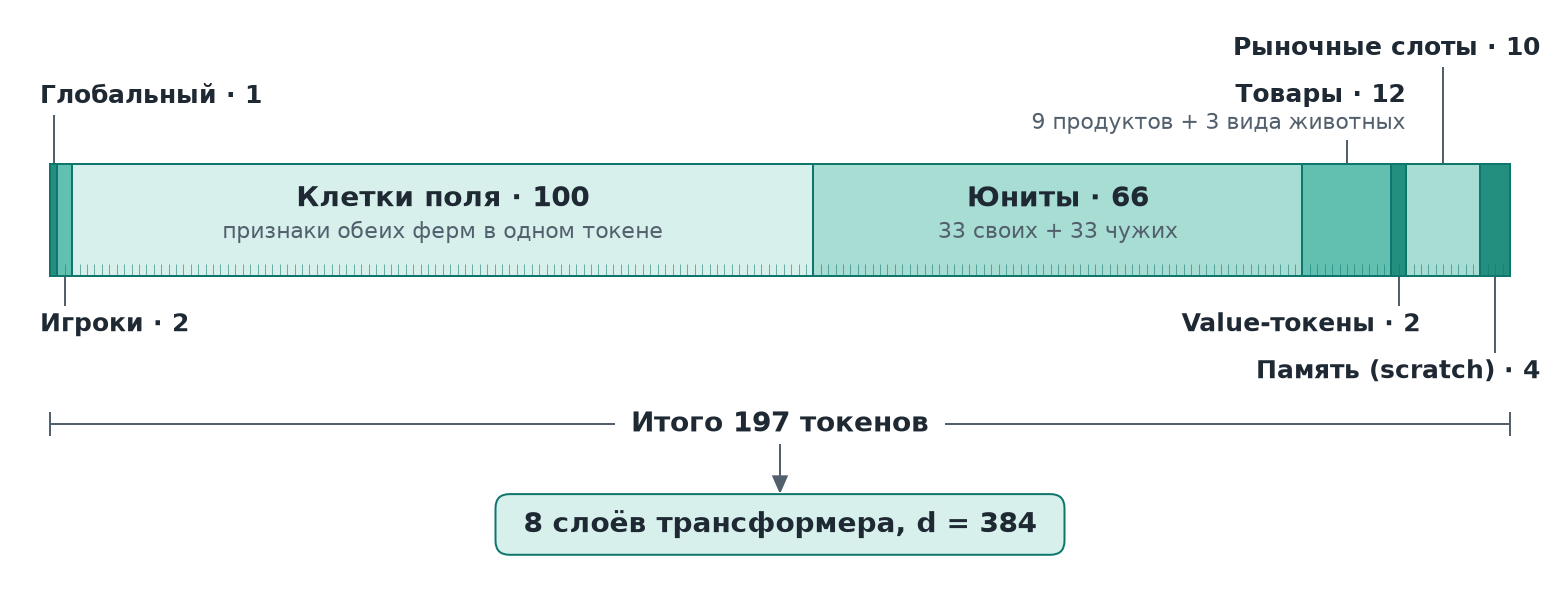
Восемь блоков EntityBlock шириной 384 дают около 20,2 млн параметров. Внутри — pre-LN, attention с восемью головами и QK-нормировкой, FFN с SiLU-гейтом. Между ходами состояние хранит GRU: после действия она записывает пару «наблюдение, действие», на следующем такте её читают четыре токена памяти.
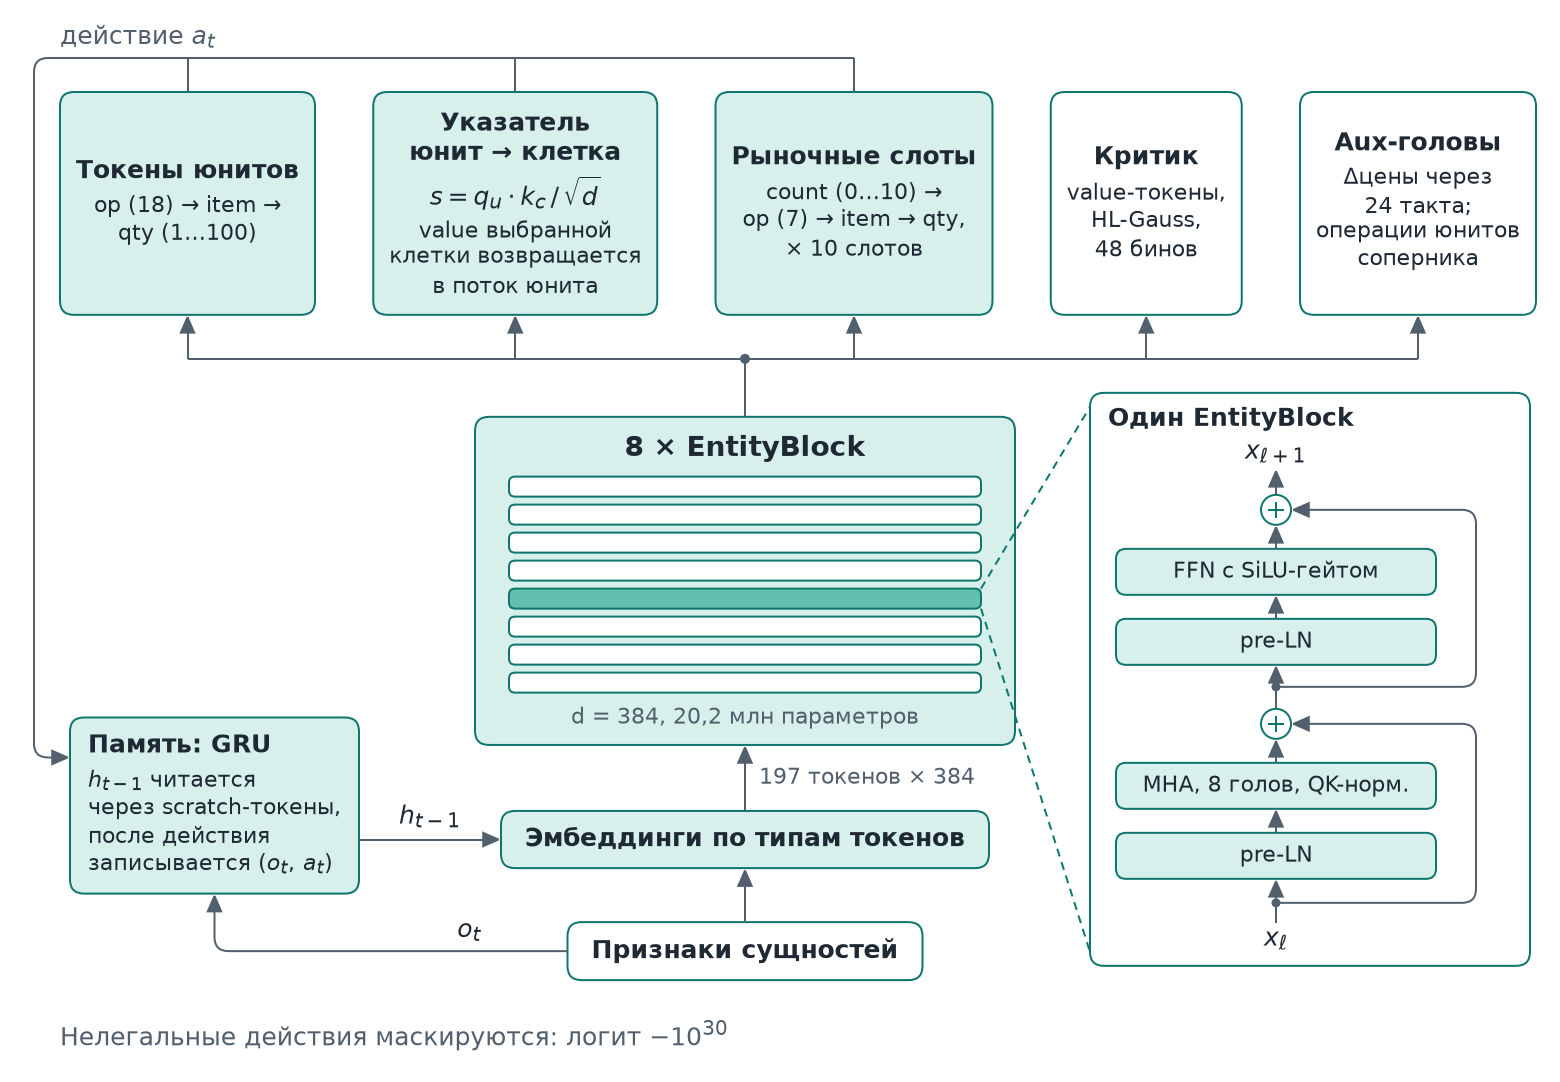
Для юнита модель выбирает клетку указателем — через attention к клеткам поля. Представление выбранной клетки возвращается в поток юнита и участвует в выборе операции, предмета и количества. Маска исключает недопустимые по правилам цели. Рыночная голова отдельно задаёт число заявок от 0 до 10, затем для каждой выбирает операцию, товар и объём.
В последней версии добавили макродействия: политика выбирает пару «клетка, операция», а исполнитель ведёт юнит сначала по  , потом по
 и выполняет работу на месте. Модели больше не нужно заново выбирать каждый шаг пути. Маски запрещали нелегальные действия, но не защищали от стратегических ошибок.
Чему учить по реплеям
Начали с behavior cloning: восстанавливали полное состояние каждого такта из реплея и учили модель выбирать записанные действия. С перемещениями возникла неоднозначность. До одной клетки можно дойти несколькими кратчайшими путями, а в записи указан только один.
Мы переразметили 25,6 % перемещений по правилу «сначала  , потом
 ». В loss для перемещений суммировали вероятность всех кратчайших шагов к записанной цели. За выбор другого равноценного шага модель не штрафовали:
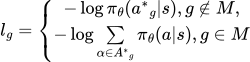
Здесь  — группа решений,
 — группы перемещений,
 — записанное действие,
 — все кратчайшие шаги к цели. Общий BC-loss усредняли по группам с допустимыми вариантами.
Результат зависел от учителя. В отдельном эксперименте клон открытой программы одного из топов — сеть 640 × 10 — совпал с ней в 99,9 % решений. При обучении на смеси топ-игроков сеть усредняла разные стратегии. В ранних версиях количество товара в заявке она угадывала лишь в 29–33 % случаев.
В ранних live-снимках клон смеси получил рейтинг 1 009, клон одной элитной программы — 1 842, скрипт в те же дни — 2 056. Это результаты первых BC-моделей, а не финального трансформера. Они показали проблему смеси: хороший ход из одной стратегии мог не подходить к вложениям, сделанным по другой.
Финальный BC-трансформер стал нашей сильнейшей моделью. Проверять изменения теперь приходилось на GPU: с 20 млн весов уже не получалось за минуты перебрать правки, как в скрипте. А следующая попытка — улучшить имитацию через обучение с подкреплением [18] — потребовала ещё и лиги соперников.
Что получилось с PPO
Мы дообучали BC-модель через PPO [4] [19]. Вероятности считали по смысловым решениям: отдельно для каждого юнита и каждой рыночной заявки, с общим advantage, как в MAPPO [5] [20]. Поля одного решения объединяли, чтобы оптимизировать выбор действия целиком:
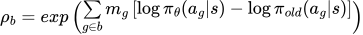
Здесь  — решение юнита или заявка,
 — его поле,
 — маска учитываемых полей. Это отношение вероятностей подставляли в clipped PPO-loss. KL-штраф удерживал политику рядом с текущим чемпионом лиги.
Критик обучался классификацией на 48 бинов по HL-Gauss [6] [21]. Две вспомогательные головы предсказывали изменение цены через сутки и операции юнитов соперника. Вторую добавили после аудита: политика почти не учитывала его действия.
В награде исход партии имел вес 0,75, добавка за размер разницы касс — 0,25. Добавку считали через ограниченный логарифм: разница в деньгах влияла на сигнал, но победа оставалась главным критерием. Чтобы не ждать сигнала до 720-го такта, добавили потенциальный шейпинг [7] [22]: промежуточная награда зависела от изменения оценки позиции. Потенциал учитывал разницу богатства игроков и оставшееся время, в терминальном состоянии обнулялся.
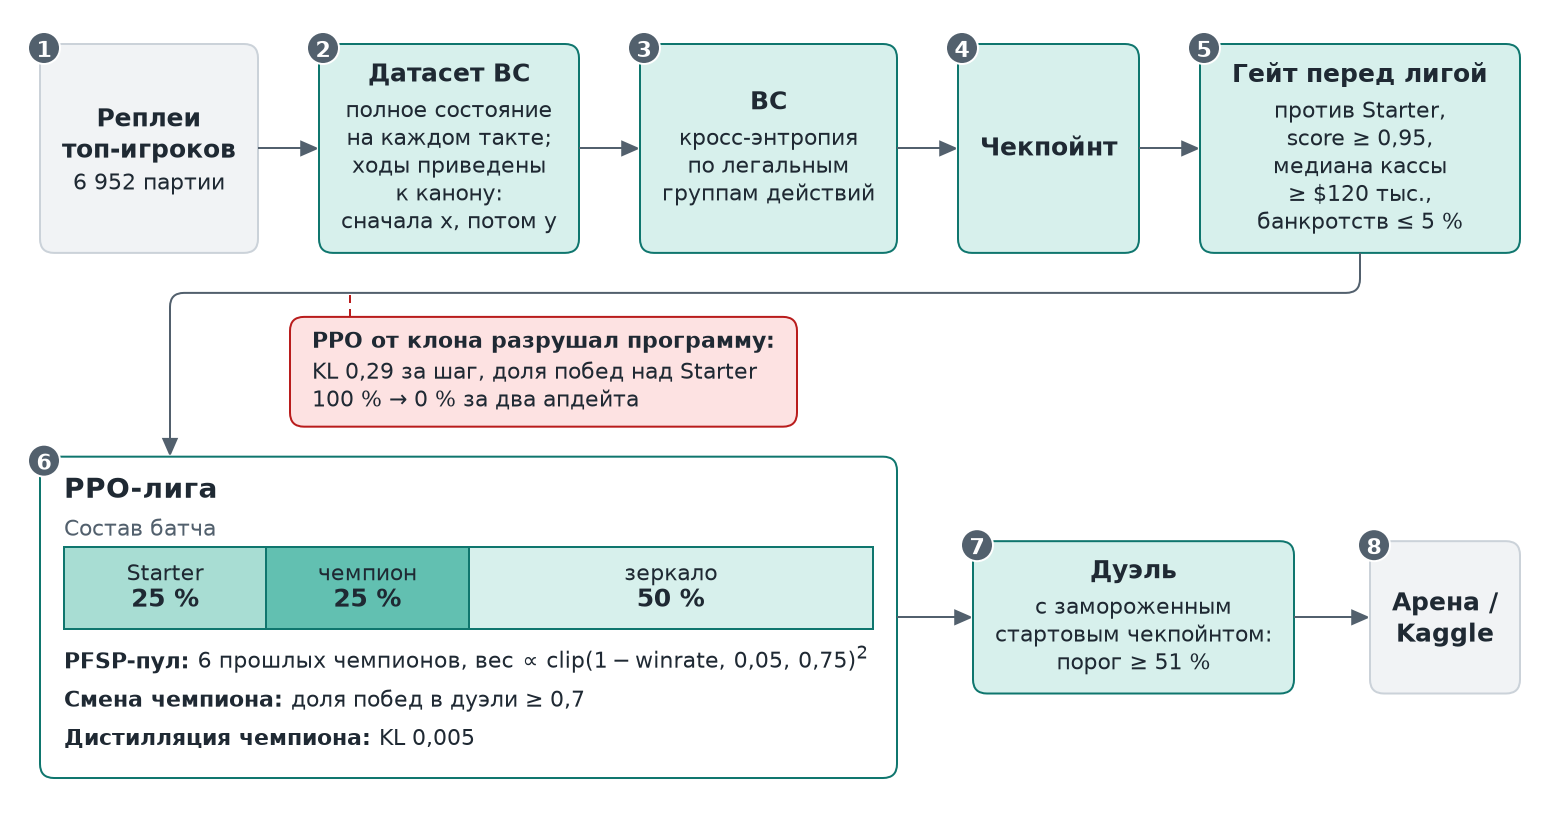
Лигу построили по примеру AlphaStar [8] [23]. Батч из 64 партий делился на игры со Starter (25 %), чемпионом (25 %) и зеркальные (50 %). Ученик становился чемпионом после побед как минимум в 70 % дуэлей с предыдущим. Прошлых чемпионов сохраняли в пуле из шести; PFSP чаще выбирал тех, кого текущая модель обыгрывала хуже.
Как агент разучивался торговать
В первом запуске было много статичных соперников, и обучение не давало результата. Другие ранние ветки тоже не показывали устойчивого улучшения: против замороженного стартового чекпойнта доля побед колебалась от 41 до 51 %.
В одном прогоне за два апдейта KL вырос до 0,29, а доля побед над Starter упала со 100 % до нуля. Поэтому проверка против стартового чекпойнта была отдельным этапом: успехи внутри меняющейся лиги ещё не означали, что модель сохранила то, чему научилась при BC.
В прогоне sp_g145b примерно после 125-го апдейта агент почти перестал продавать. Медианное число заявок упало с 228 до двух за партию, касса оставалась на стартовых 3 000 долларах. В одной из проверок семь партий из десяти закончились ничьёй.
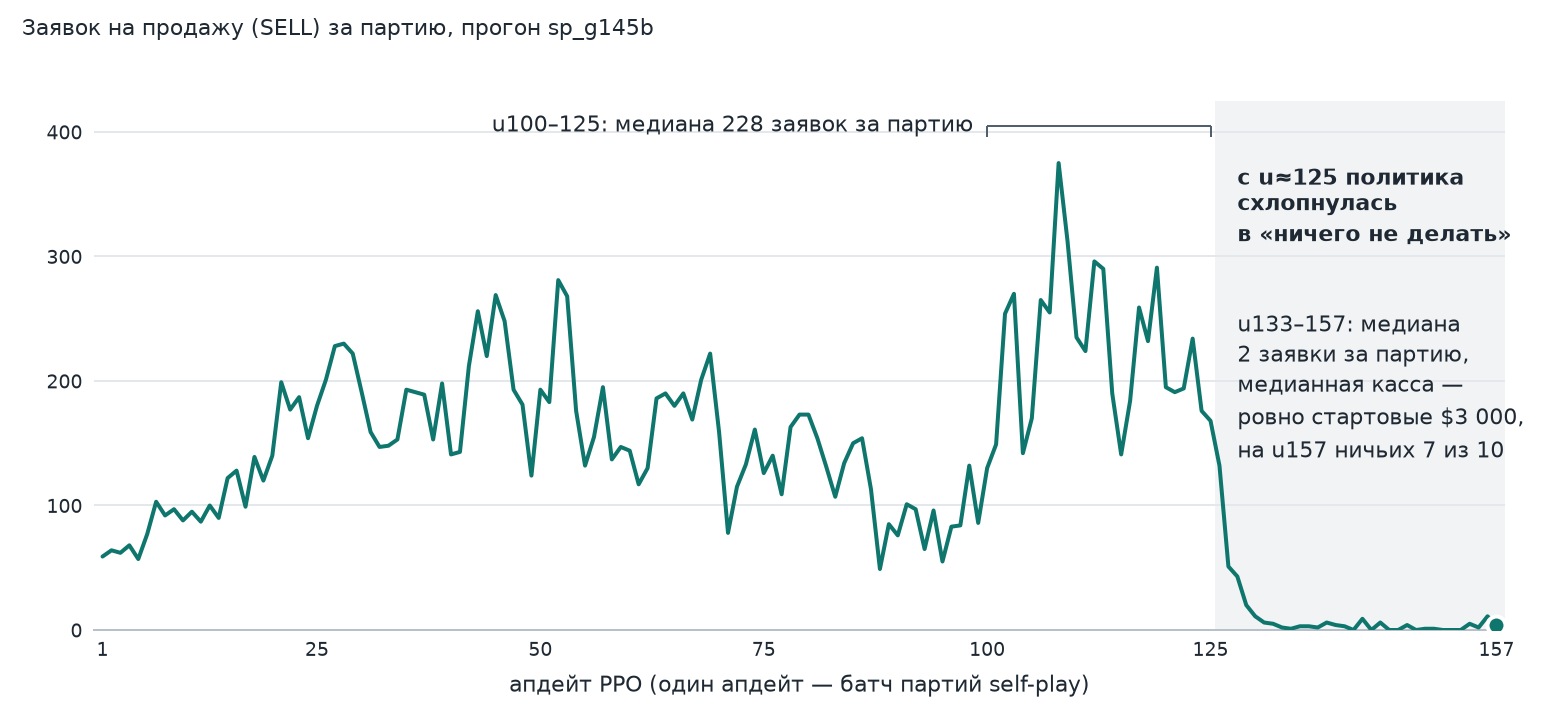
Мы связываем это с инвестициями. Земля, стадо и рабочие требуют денег сейчас, а окупаются через 10–20 дней. Пока политика плохо выполняет продолжение такого плана, покупка выглядит убыточной. Бездействие со стартовыми 3 000 долларами оказывается выгоднее неумелой работы; Starter, например, заканчивал примерно с 3 486 долларами.
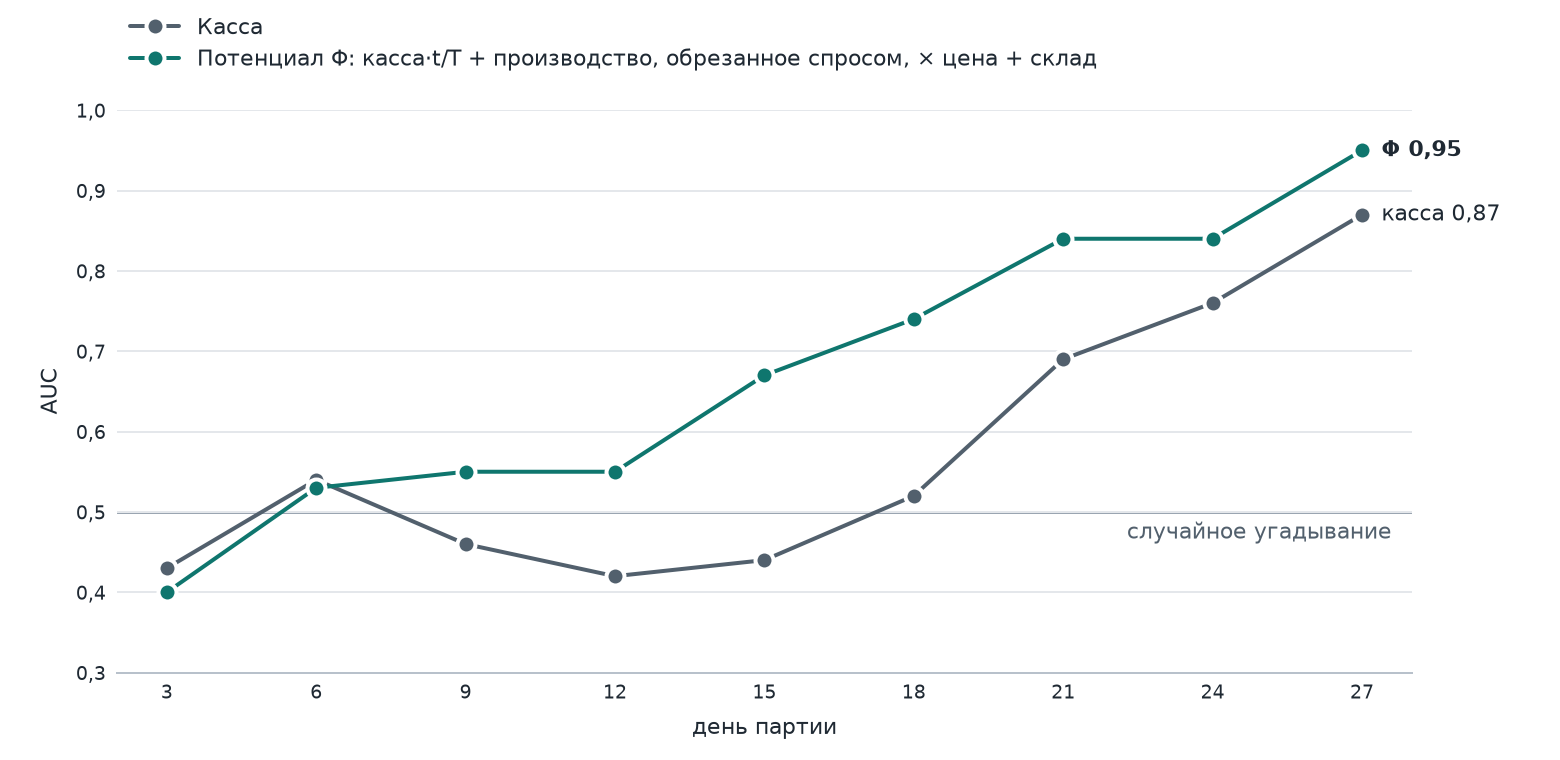
Ранний сигнал был слабым даже в партиях топ против топа: касса до 18-го дня предсказывала победу с AUC 0,42–0,54. Потенциал из разбора реплеев выходил выше случайного уровня с 6-го дня, но AUC 0,84 достигал только к 21-му. Добавить промежуточную награду оказалось недостаточно — она ещё должна была вовремя различать хорошие и плохие вложения.
В следующем запуске мы изменили состав лиги и ограничили макродействия. Настроенный PPO дал небольшой прирост поверх BC. Но переносить этот результат на все конфигурации нельзя: ранние прогоны показывали, что дообучение способно быстро испортить уже работающую политику.
Результат и выводы
Наш итог на Kaggle — серебро, 436-е место из 10 148. Команду ранжировали по лучшему сабмиту с помощью модели Брэдли–Терри [9] [24]. Live-рейтинг менялся вместе с составом соперников, поэтому его значения за август и сентябрь нельзя читать как единую шкалу прогресса.
|
Подход |
Что получили |
|---|---|
|
BC-трансформер |
Лучшая модель команды; k-NN остался вторым по силе. |
|
k-NN |
339 побед из 391 переигровки против записанных соперников. |
|
Скрипт с DP-продажами |
140 побед на том же наборе из 391 партии. |
|
Реактивный агент и CP-SAT |
Остались на стенде, на Kaggle их не отправляли. |
Числа 339 и 140 сравнивают две версии на внутреннем стенде. В этом тесте нет BC-трансформера, поэтому таблица не задаёт количественного разрыва между ним и k-NN.
Из соревнования мы забрали три рабочих приёма. Сравнивать кандидатов на одних партиях. Проверять, совместимы ли стратегии учителей, прежде чем смешивать их записи. И после каждого этапа RL снова играть против исходного чекпойнта: увеличение числа апдейтов само по себе не означает, что агент стал сильнее.
Спасибо игроку, чьи партии мы использовали для обучения, и организаторам Kaggle за Kaggriculture.
Ссылки
-
Kaggriculture на Kaggle [25].
-
The Surprising Effectiveness of Representation Learning for Visual Imitation (VINN). arXiv:2112.01511 [26], 2021.
-
Proximal Policy Optimization Algorithms. arXiv:1707.06347 [28], 2017.
-
The Surprising Effectiveness of PPO in Cooperative Multi-Agent Games (MAPPO). arXiv:2103.01955 [29], 2022.
-
Stop Regressing: Training Value Functions via Classification for Scalable Deep RL. arXiv:2403.03950 [30], 2024.
-
Policy Invariance Under Reward Transformations: Theory and Application to Reward Shaping. ICML, 1999.
-
Grandmaster level in StarCraft II using multi-agent reinforcement learning. Nature, 2019.
-
Rank Analysis of Incomplete Block Designs. Biometrika, 1952.
Автор: Sber
Источник [31]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38228
URLs in this post:
[1] Kaggriculture: #ref-1
[2] обучения: http://www.braintools.ru/article/5125
[3] повторять: http://www.braintools.ru/article/4012
[4] Ферма с общим рынком: #economy
[5] Как мы проверяли изменения: #evaluation
[6] Первый бот: правила и продажи: #script
[7] k-NN: продолжить чужую партию: #knn
[8] Два подхода, которые остались на стенде: #planning
[9] BC: учимся повторять решения: #bc
[10] Что получилось с PPO: #ppo
[11] Результат и выводы: #results
[12] Ссылки: #references
[13] случайностью: http://www.braintools.ru/article/6560
[14] [2]: #ref-2
[15] логикой: http://www.braintools.ru/article/7640
[16] [3]: #ref-3
[17] память: http://www.braintools.ru/article/4140
[18] подкреплением: http://www.braintools.ru/article/5528
[19] [4]: #ref-4
[20] [5]: #ref-5
[21] [6]: #ref-6
[22] [7]: #ref-7
[23] [8]: #ref-8
[24] [9]: #ref-9
[25] Kaggriculture на Kaggle: https://www.kaggle.com/competitions/kaggriculture
[26] arXiv:2112.01511: https://arxiv.org/abs/2112.01511
[27] CP-SAT Solver, Google OR-Tools: https://developers.google.com/optimization/cp/cp_solver
[28] arXiv:1707.06347: https://arxiv.org/abs/1707.06347
[29] arXiv:2103.01955: https://arxiv.org/abs/2103.01955
[30] arXiv:2403.03950: https://arxiv.org/abs/2403.03950
[31] Источник: https://habr.com/ru/companies/sberbank/articles/1104646/?utm_campaign=1104646&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.