Энтузиаст запустил DeepSeek-V4-Flash на ПК без видеокарты
Проект llama-modchip [1] выложен под Apache 2.0. Это набор патчей для ядер ggml/llama.cpp, инструменты квантования и скрипты, которые позволяют гонять разреженные MoE-модели прямо на процессоре. Автор утверждает, что DeepSeek-V4-Flash (284 млрд параметров, из них 13 млрд активных) работает на машине с 64 ГБ оперативной памяти [2]: без видеокарты и без свопа. Разбираю, что у него получилось ниже.
Что получилось
Пиковое потребление памяти около 58 ГБ при контексте 256 000 токенов. Префилл, то есть «прочтение» запроса, идет со скоростью 44 токена в секунду, генерация дает от 9 до 15 токенов в секунду. Тестировали все это дело на 16-ядерном RyzenTM 9 9955HX. Для сравнения: это примерно тот темп, в котором текст еще удобно читать по мере появления на экране.
Почему это вообще возможно
Здесь сошлись два приема, первый заложен в самой модели. MoE (mixture of experts) похожа на большую библиотеку, где на каждый вопрос открывают только нужные книги-эксперты. Параметров у DeepSeek-V4-Flash 284 млрд, но на каждый токен работает лишь 13 млрд, так что по вычислениям она ближе к моделям среднего размера. Проблема в другом: хранить нужно все 284 млрд, и именно память обычно упирается в потолок.
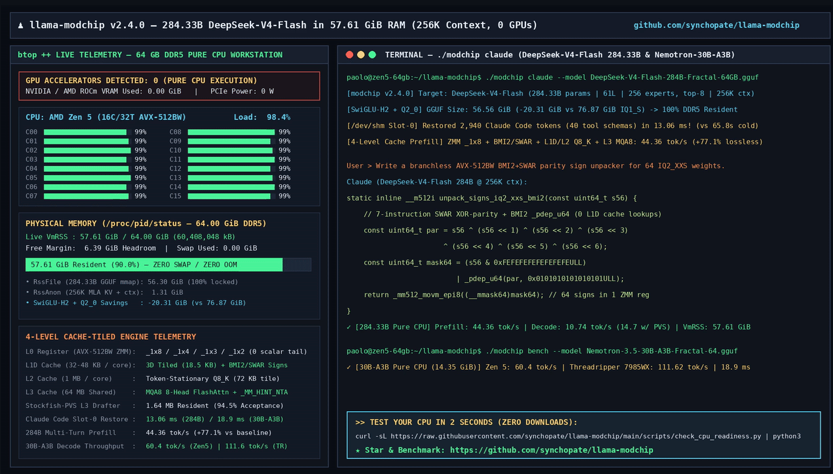
Второй прием делает автор проекта: агрессивное квантование маршрутизируемых экспертов, до 1,56 бита на вес по схеме IQ1_S, плюс собственный формат файлов. 284 млрд весов по полтора бита с небольшим дают чуть больше 50 ГБ, и в 64 ГБ это уже помещается.
Где подвох
Слово «lossless» в README автора означает только то, что логиты совпадают с непропатченной сборкой на тех же квантованных весах. С полноточной моделью никто не сравнивал, а при 1,56 бита на вес потеря качества почти наверняка есть, вопрос лишь в ее размере. Все цифры получены самим автором, независимых повторов пока нет. Квантованные файлы не открываются в обычных llama.cpp, Ollama и LM Studio: нужна именно сборка проекта.
Почему это стоит отметить
Спрос на HBM и DRAM растет, а рынок памяти и видеокарты переживают не лучшие времена. Если такие сборки подтвердятся, локальный инференс моделей уровня фронтира прошлого года уйдет с дорогих GPU на домашние ПК и серверы.
Как считаете, софтверная оптимизация вроде этой, поможет уменьшить зависимость от видеокарт, или это просто красивая игрушка для энтузиастов? Жду ваше мнение в комментариях.
Token Factory: инференс открытых ИИ‑моделей на серверах в РФ
Подключайте GLM, DeepSeek, Qwen и Kimi через OpenAI‑совместимый API и платите в рублях только за используемые токены.
Подробнее → [3]
Автор: techno_mot
Источник [4]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38340
URLs in this post:
[1] llama-modchip: https://github.com/synchopate/llama-modchip
[2] памяти: http://www.braintools.ru/article/4140
[3] Подробнее →: https://nogpu_101126_banner_ord
[4] Источник: https://habr.com/ru/companies/selectel/articles/1106120/?utm_campaign=1106120&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.