Ускоряем AI модель на процессоре Qwen3.8-Flash-Next Gyro
Существует много различных проектов и вариантов по ускорению генерации AI. Но в большинстве случаев они используют тюнинг модели, а так же использование внешней видео карты. Но можно ли ускорить генерацию модели, если у нас есть только процессор и ОЗУ?
Для тестирования использовалась модель Qwen3.8-Flash-Next Gyro GGUF [1]
В данной оптимизации помог Opus, который несколько суток гонял тесты на моём железе и пытался оптимизировать код llama. К сожалению мою учётную запись заблокировали, и после верификации и апеляции, окончательно. Возможно ли такой же тюнинг и отладка с другими моделями AI?
|
Версия патча Opus |
Промпт t/s |
Генерация t/s |
Сравнение с оригиналом |
|---|---|---|---|
|
fix23 |
10.98 / 10.05 |
2.41 / 2.38 |
×1.23 |
|
fix37 |
11.21 / 14.49 |
2.72 / 2.73 |
×1.40 |
|
original |
4.12 / 3.75 |
1.97 / 1.92 |
— |
График снижения скорости генерации в зависимости от контекста.
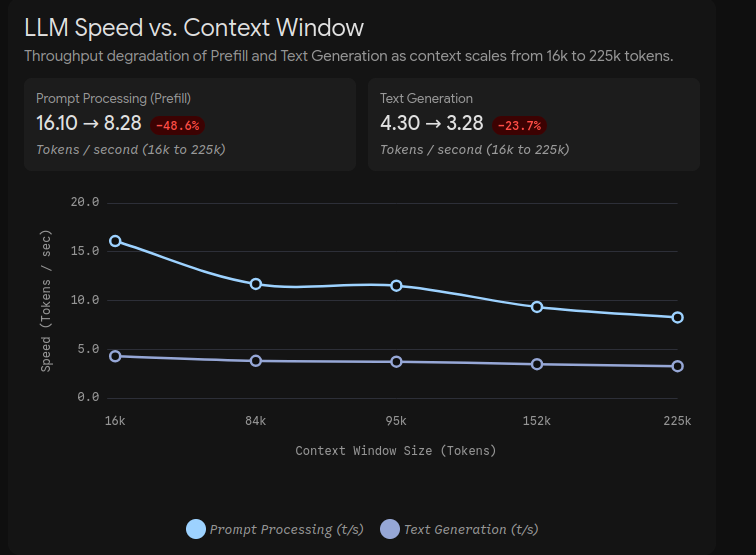
Патчи и наработки здесь. Пишите в комментариях железо и насколько увеличивается у вас скорость генерации после применения патчей.
https://gitlab.com/agentionai-group/llama.cpp/-/merge_requests/1 [2]
Так же напишите, какая модель и из какого harness может так же долго работать как cloud code -заниматься такой сложной и низко-уровненовой работой на твоём личном железе.
Автор: Renatk
Источник [3]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38585
URLs in this post:
[1] Qwen3.8-Flash-Next Gyro GGUF: https://huggingface.co/agentionai/Qwen3.8-Flash-Next-Gyro-GGUF
[2] https://gitlab.com/agentionai-group/llama.cpp/-/merge_requests/1: https://gitlab.com/agentionai-group/llama.cpp/-/merge_requests/1
[3] Источник: https://habr.com/ru/articles/1108016/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1108016
Нажмите здесь для печати.