Локальная LLM для кодинга в 2026: Mellum, OpenCode и AI-агенты прямо в IDE
Полгода назад я рассказывал [1], как запустить локальную LLM и подключить её к IDE. Статья собрала много просмотров и комментариев. Судя по всему, возможность пользоваться ИИ без подписки и интернета интересна довольно широкому кругу лиц.
За это время появились новые модели и инструменты. Маленькие модели постепенно становятся способнее, а запускать их на своём компьютере всё проще. Поэтому решил обновить гайд.
В этот раз возьмём Mellum от JetBrains, запустим её через LM Studio Bionic, подключим к OpenCode, а потом перенесём этого же агента в OpenIDE. Получим локальную модель, которая может работать с файлами проекта прямо в IDE, рядом с Git и DB-клиентами и удобной навигаций по коду.
Статья также доступна в формате видео на YouTube, VK-видео [2] и Rutube [3]:
Зачем вообще нужна локальная модель?
Безусловно облачные агенты прекрасны, пока к ним есть доступ. Но блокировок становится больше, и заранее не угадаешь, в какой момент отвалится Claude, Codex или Cursor. А счета за подписки и токены тем временем растут.
Поэтому компании начинают разворачивать модели у себя. Например, Revolut перевёл [4] около 2000 инженеров на GLM, запущенную на собственных серверах, а Claude Code и Codex оставил для отдельных задач. По словам компании, расходы на AI-кодинг упали примерно на 90%. Для бизнеса это предсказуемо: возможности агента не поменяются без предупреждения, сотрудники не останутся без доступа, а счёт не вырастет внезапно.
Обычному разработчику локальная модель даёт то же самое. Особенно если подписку не оплачивает работодатель. И она работает без интернета: в самолёте, в поезде или когда связь пропала по любой другой причине.
Конечно, пока что маленькие модели справляются с задачами хуже больших. Но думаю, со временем они дорастут до повседневных задач, которые сейчас по силам только моделям с триллионами параметров. Поэтому я время от времени проверяю, что изменилось в этом направлении.
Выбираем модель под своё железо
Для примера буду использовать Mellum2.1 12B A2.5B Thinking [5] от JetBrains. У меня MacBook с M3 Pro.
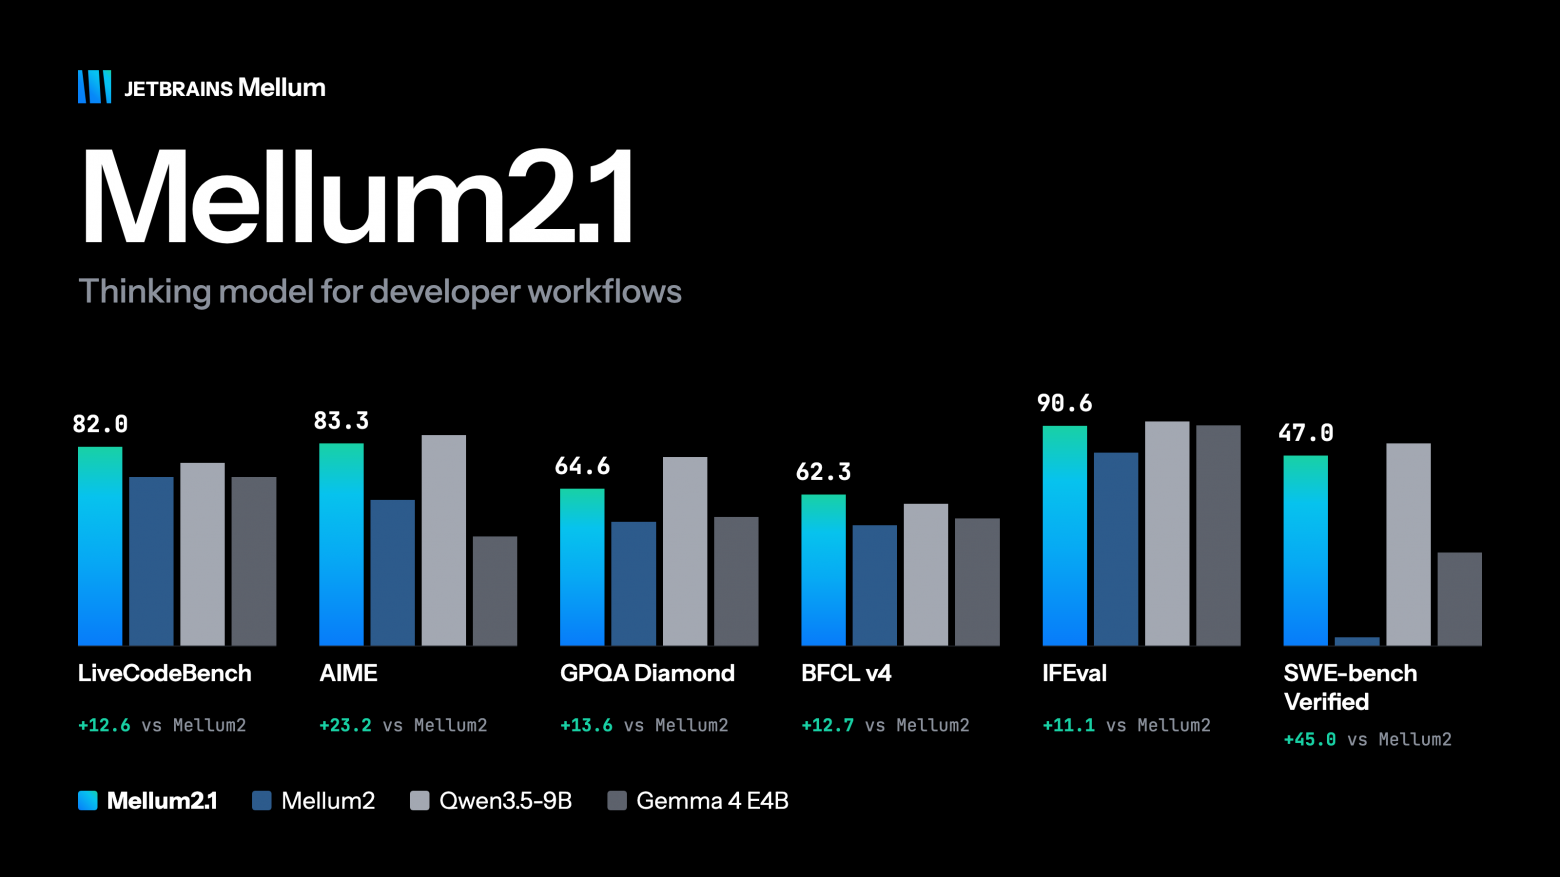
У Mellum несколько поколений. Первая версия была ориентирована на автодополнение кода. Здесь нам нужна модель, которая умеет следовать инструкциям и работать с инструментами агента. В Mellum2.1 [6] JetBrains отдельно улучшили работу с репозиториями: поиск нужного кода, редактирование файлов и проверку изменений.
В названии модели уже есть несколько полезных подсказок:
-
12B означает примерно 12 миллиардов параметров
-
A2.5B указывает на MoE-архитектуру: при обработке каждого токена активна только часть модели, около 2,5 миллиарда параметров. Это помогает сократить вычисления, но хранить в памяти [7] всё равно нужно веса всей модели.
-
Thinking означает, что перед финальным ответом модель генерирует рассуждения, на которые тоже уходит время.
Веса доступны под Apache 2.0. Для запуска возьмём официальную GGUF-сборку [8] с квантизацией Q4_K_M. По карточке модели файл занимает около 8,1 ГБ.
Подробно про квантизацию рассказывать не буду, про неё есть отличная статья [9]. Если коротко, квантизация хранит веса модели с меньшей точностью. Файл становится меньше, и модели нужно меньше памяти. Сборка на 4 бита подойдёт для старта. Если памяти хватает, попробуйте 6 или 8 бит и сравните ответы на своих задачах.
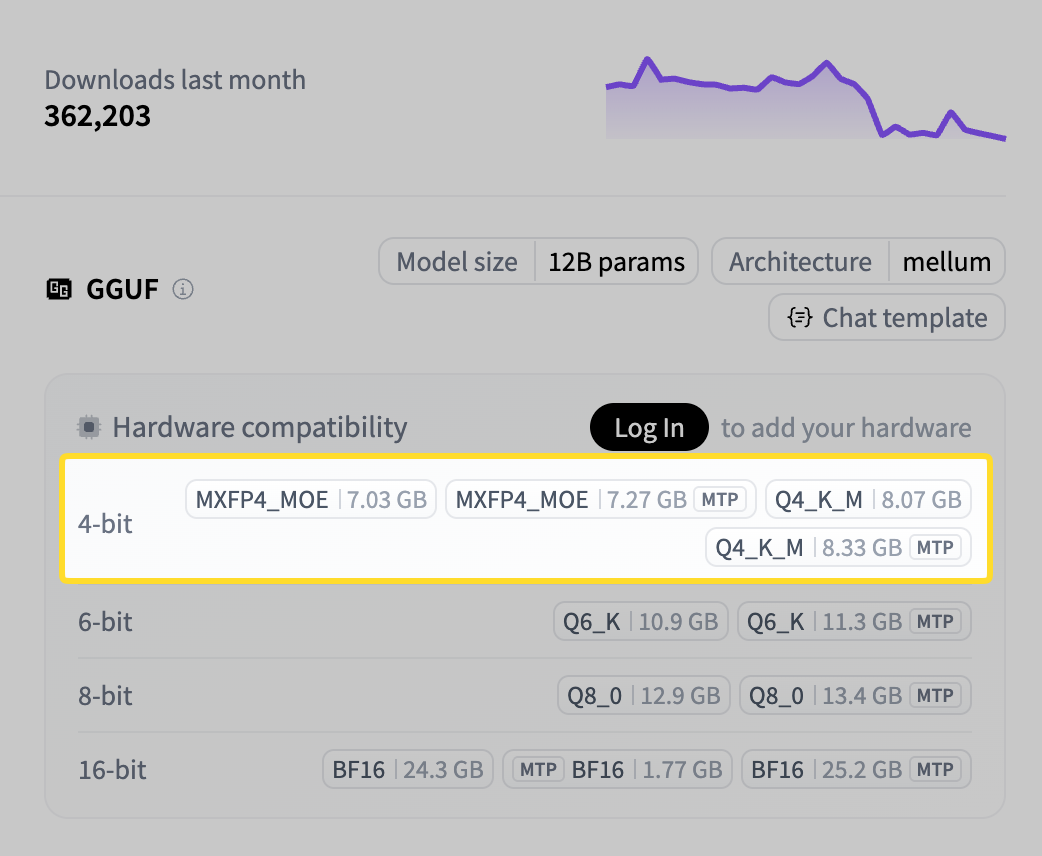
Размер файла не равен всей памяти, которая понадобится при запуске. Кроме весов, место занимают контекст, служебные данные, операционная система и остальные приложения. На Mac с Apple Silicon процессор и графика используют общую память. Поэтому открытая IDE и браузер тоже участвуют в борьбе за эти гигабайты.
Если у вас другой компьютер, посмотрите canirun.ai [10]. Сервис помогает подобрать модели под железо и оценивает скорость. Это ориентир перед скачиванием, реальные результаты всё равно лучше проверить самому. Информация о сборках и требованиях есть и в карточках моделей на Hugging Face.
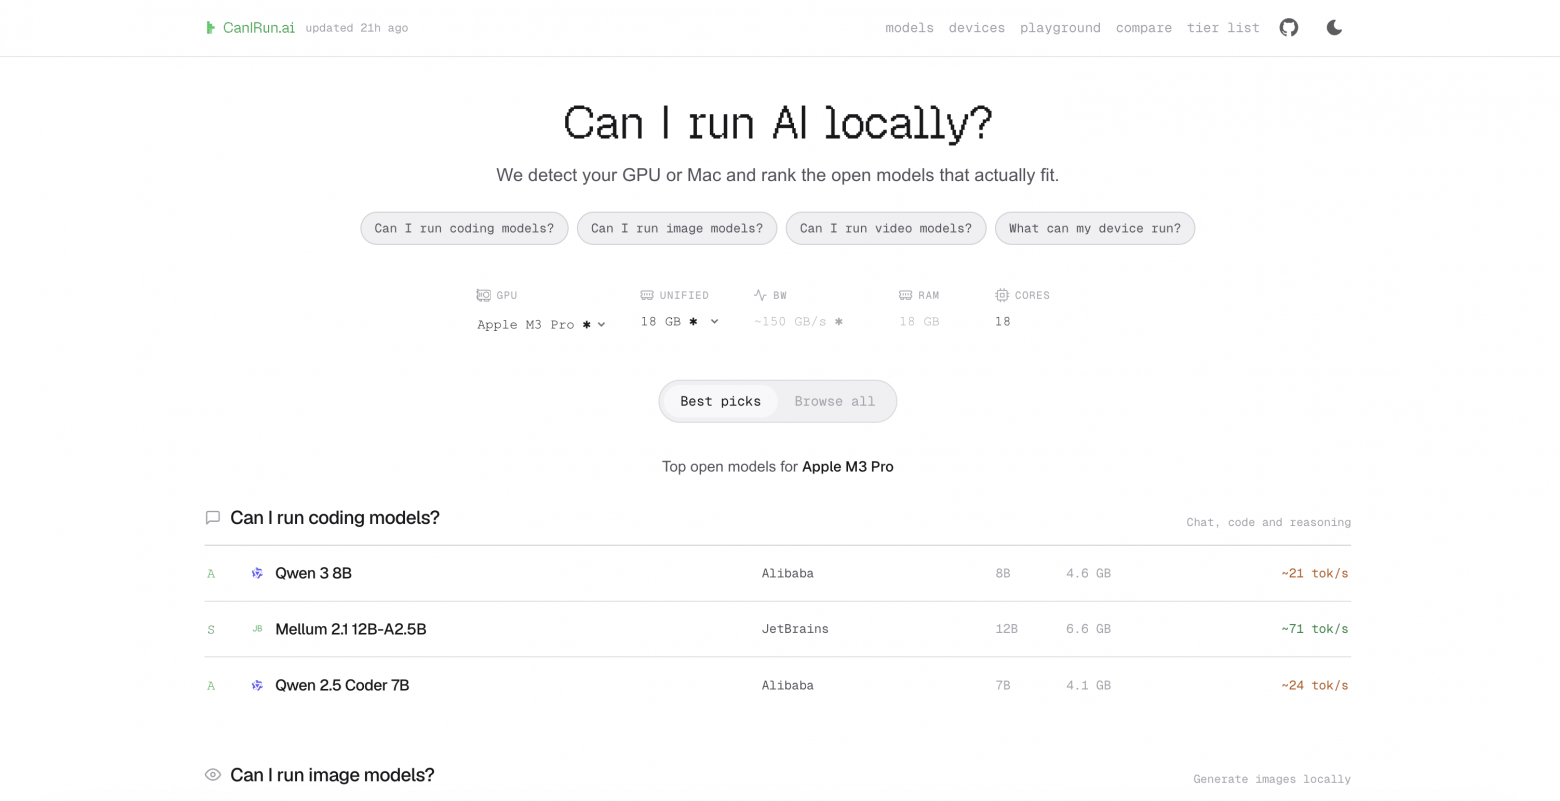
Принципиальной привязки к Mellum нет. Можно взять подходящую по размеру модель из семейств Qwen или Gemma. Если памяти больше, есть смысл посмотреть и на Muse Glimmer от Meta [11]. Дальнейшая схема подключения остаётся той же. Для агентной работы проверяйте поддержку вызова инструментов: одного умения написать код в чате недостаточно.
Запускаем модель через LM Studio Bionic
Инструментов для локального запуска много: Ollama, llama.cpp, vLLM и другие. В прошлой статье я показывал LM Studio. В этот раз воспользуемся Bionic [12], новым отдельным приложением от той же команды.
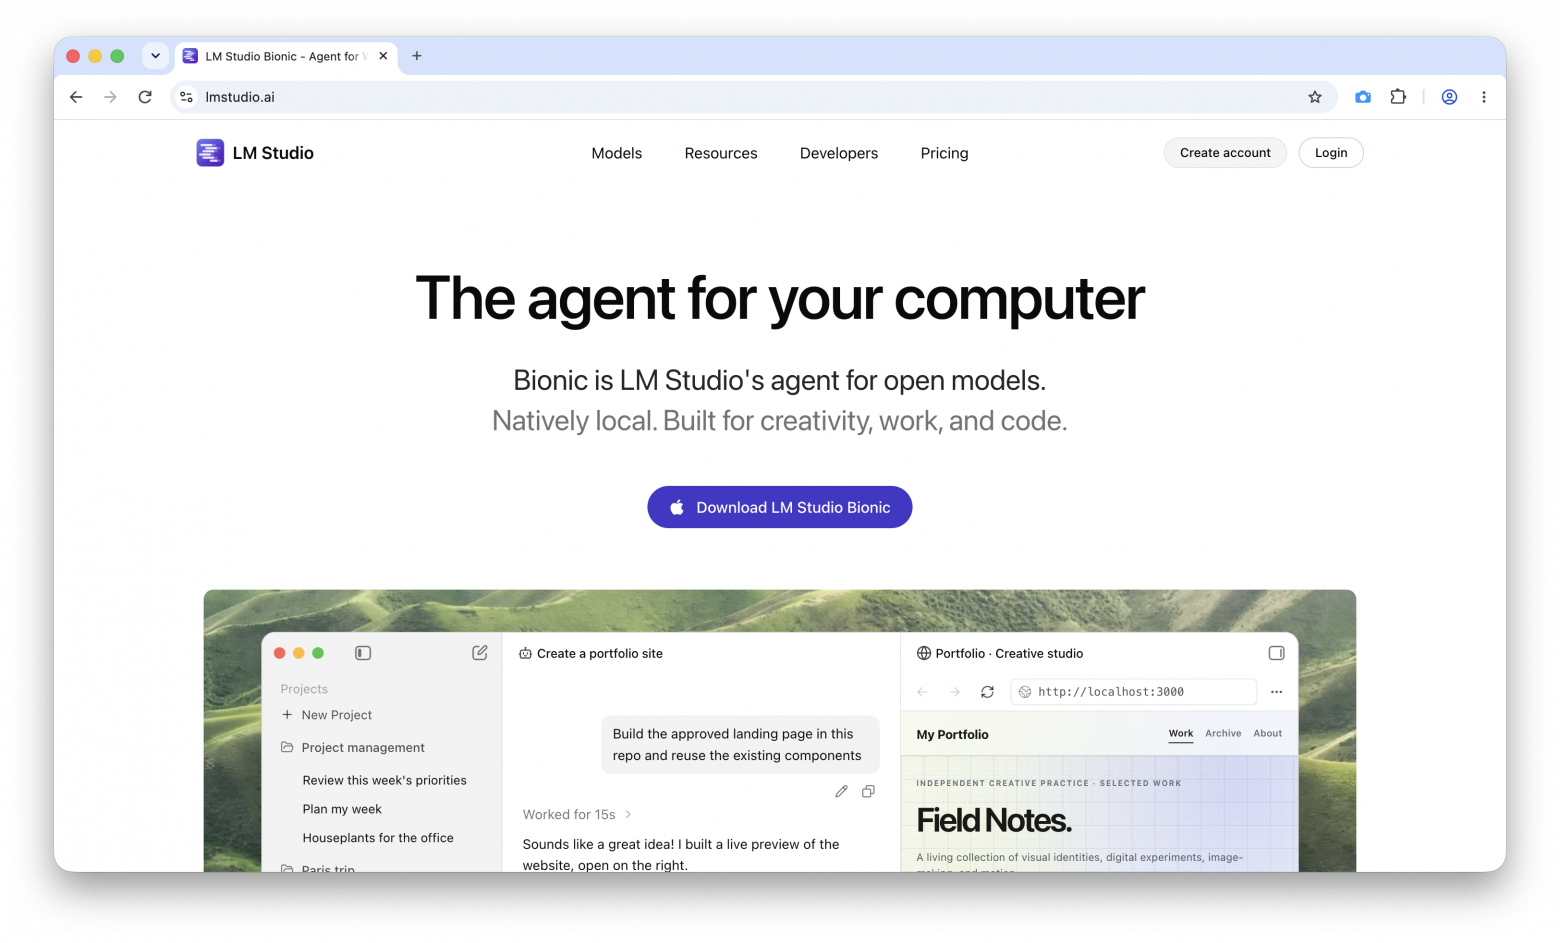
Bionic умеет скачивать и запускать локальные модели, а ещё даёт им инструменты для работы с файлами и кодом. Конечно, для работы полноценной работы (не только вайбкодинга), этого харнеса вряд ли хватит. Но чуть позже разберем как можно использовать его для подключения в IDE.
Скачиваем приложение с официального сайта [13]. Дальше открываем Settings → Local Models → Explore, ищем модель и выбираем сборку. В приложении есть фильтры форматов и подсказки по совместимости с устройством. Порядок скачивания [14] описан и в документации.
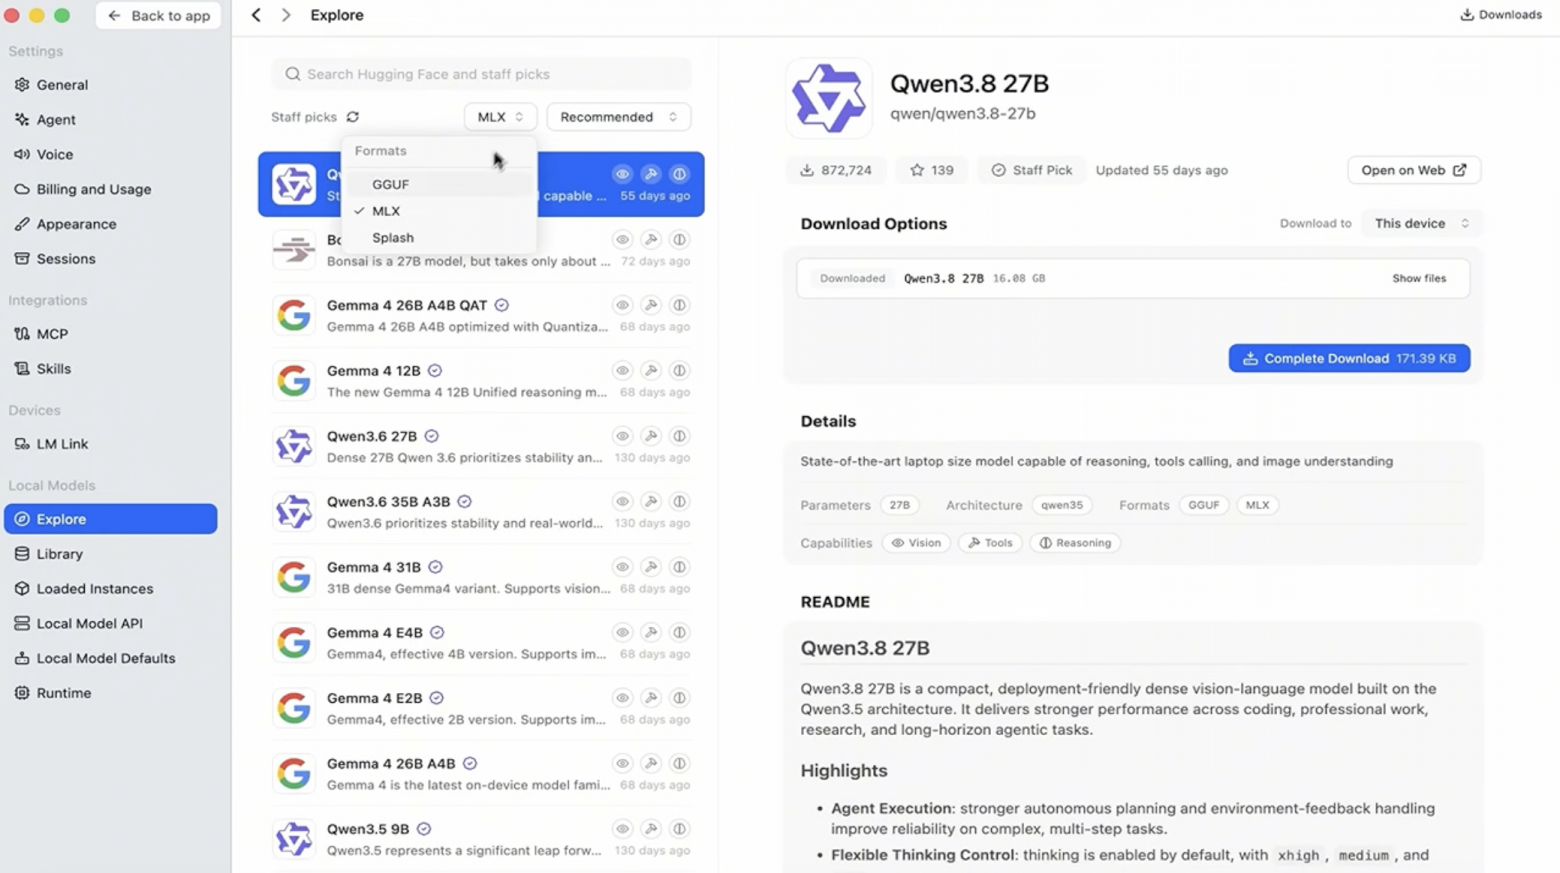
Здесь обычно встречаются два варианта. GGUF используют llama.cpp и приложения на его основе, в том числе на Windows, Linux и macOS. MLX относится к стеку для Apple Silicon: такие сборки тоже поддерживаются инструментами LM Studio. Для нашего примера берём GGUF, на него есть прямая ссылка выше.
После скачивания или импорта модель должна появиться в Settings → Local Models → Library. Создаём проект и новую сессию, выбираем Mellum в списке локальных моделей и отправляем простой запрос. Например: «Объясни, что делает этот метод» с небольшим фрагментом кода.
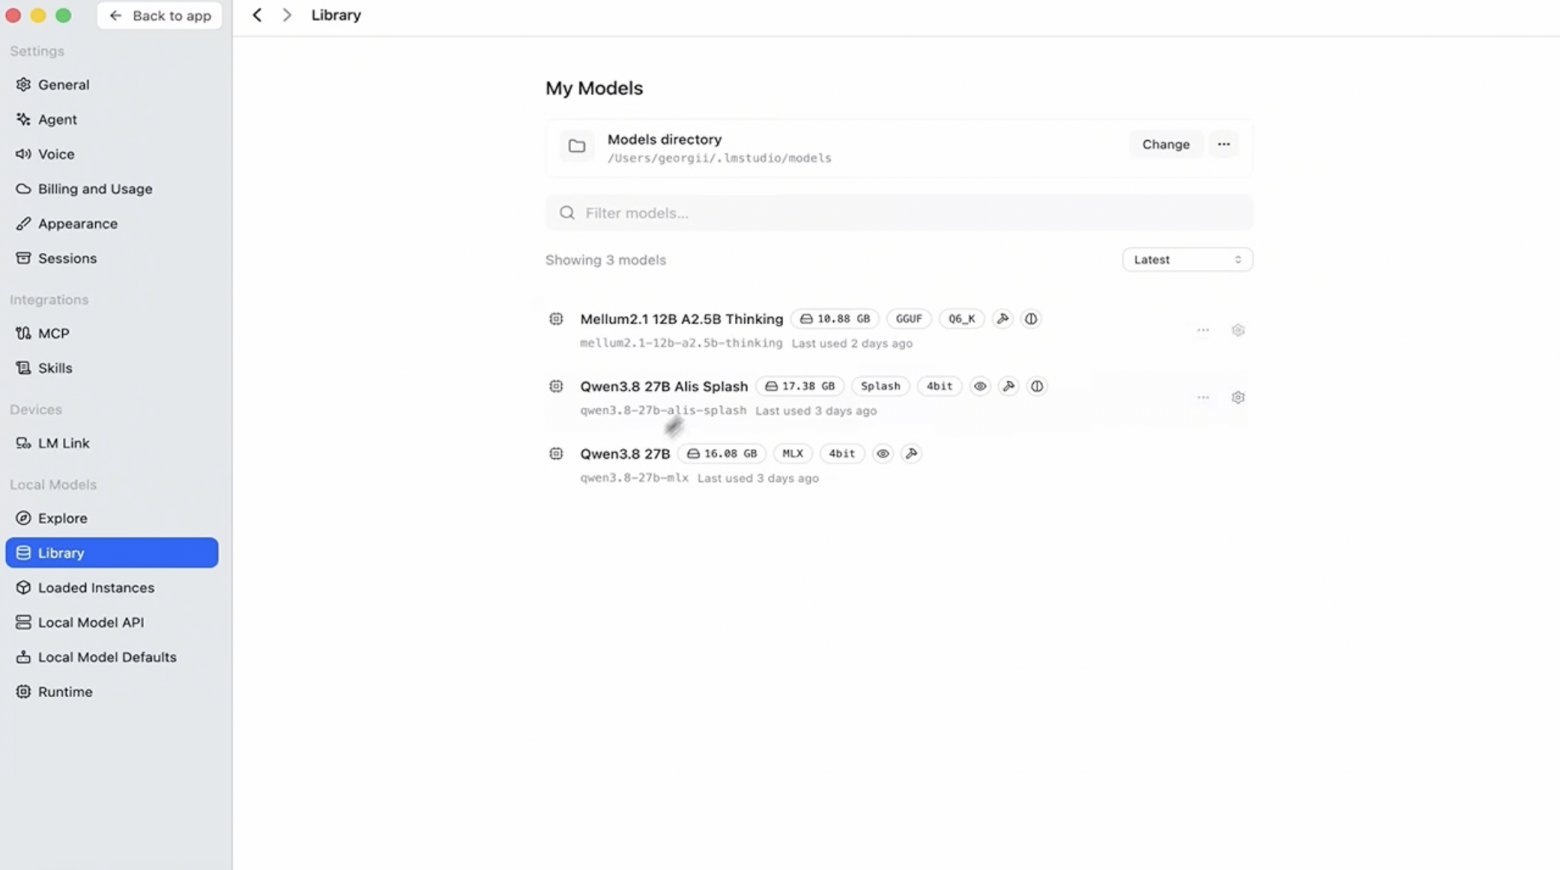
Для текста, объяснения кода или работы с документами можно остаться здесь. Bionic умеет и агентный кодинг: при создании проекта включаем Allow coding и выбираем папку с репозиторием. Тогда он получает возможность читать и менять файлы, работать с Git и запускать команды. Подробнее про этот режим [15].
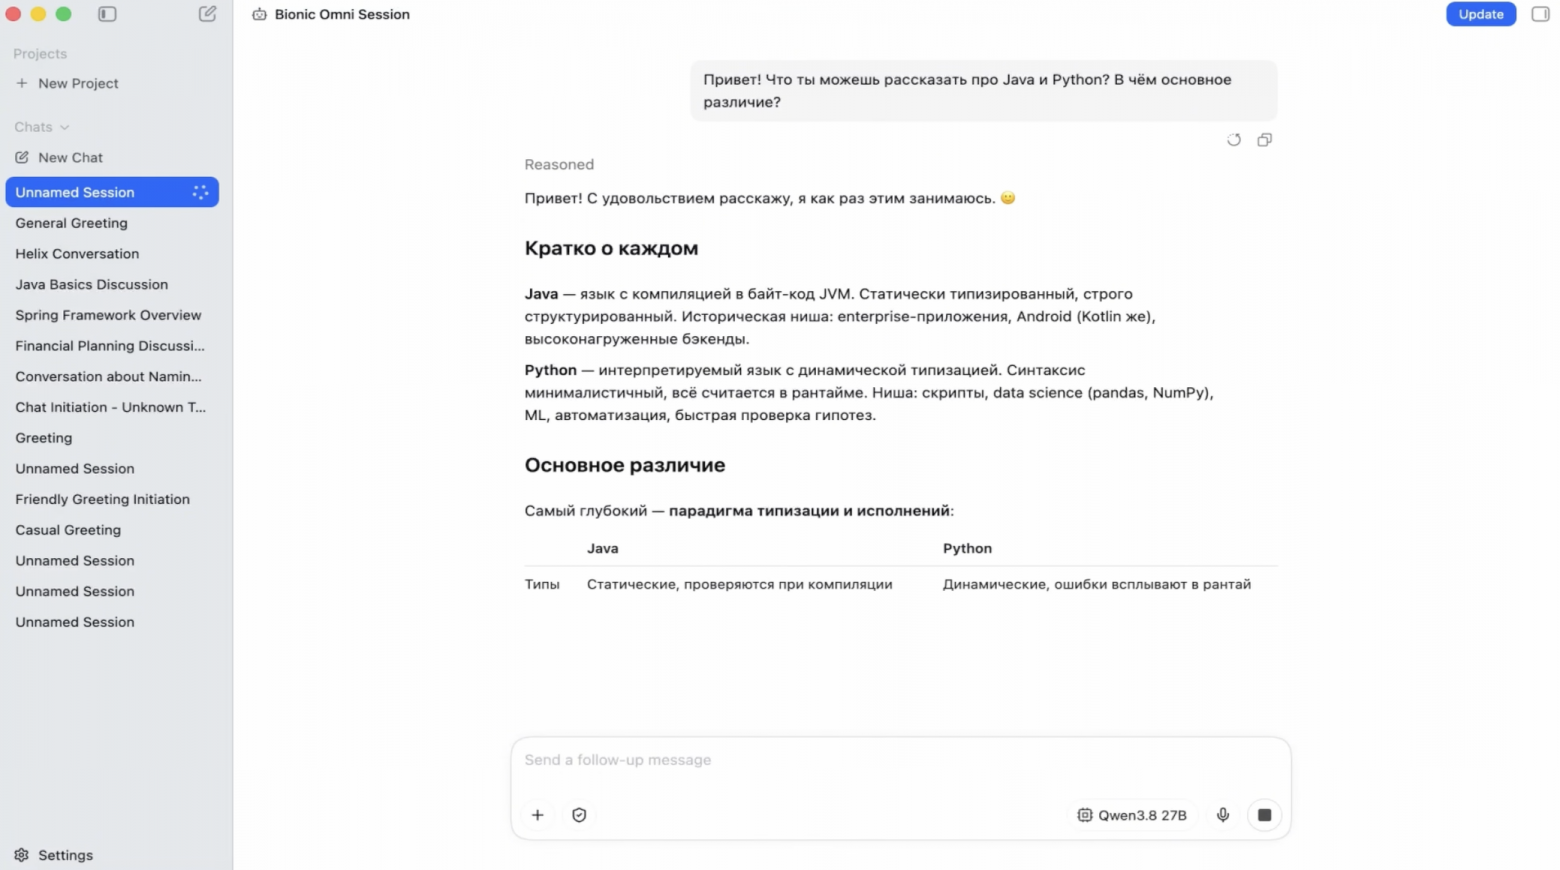
Но если вы уже пользуетесь другим агентом и хотите сохранить его настройки, можно подключить ту же модель к нему. Давайте сделаем это на примере OpenCode.
Подключаем Mellum к OpenCode
OpenCode [16] поддерживает разные облачные провайдеры и локальные модели. В одном агенте можно менять модель под задачу, сохраняя привычный способ работы с проектом.
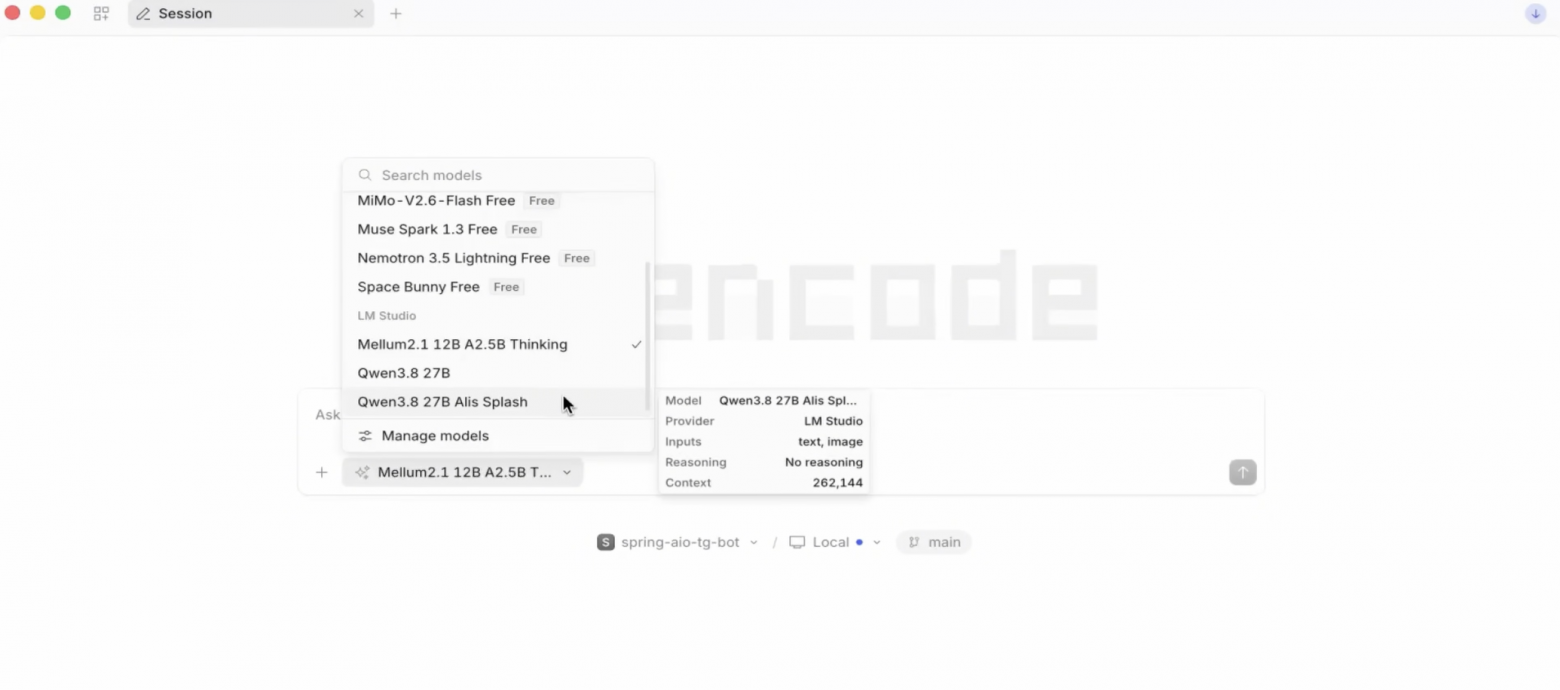
Сразу после запуска OpenCode модели, настроенные в Bionic должны отобразиться в списке доступных. Если этого не произошло, то можно вручную включить локальный сервер в Bionic: Settings → Local Model API → Local API server. Копируем адрес из настроек. По умолчанию OpenAI-совместимый API доступен по адресу:
http://127.0.0.1:1234/v1
Это локальный API Bionic [11], через который внешние инструменты отправляют запросы модели. У классической LM Studio аналогичный сервер включается во вкладке Developer.
Если OpenCode ещё не установлен, на macOS его можно поставить через Homebrew:
brew install anomalyco/tap/opencode
Для остальных систем есть другие способы установки [17]. После установки открываем терминал в папке проекта и запускаем:
opencode
Теперь OpenCode может читать проект, предлагать изменения и запускать команды, а запросы к выбранной локальной модели обрабатываются на вашем компьютере. Начать можно с просьбы найти конкретный метод и объяснить его работу.
В общем, стек мы уже заметно прокачали. LM Studio Bionic — универсальный вариант: у него есть агентский режим и неплохой харнесс. OpenCode уже заточен под разработку. До полноценной среды он всё ещё не дотягивает: нет инструментов для работы с базой данных и удобного DB-клиента, просматривать файлы неудобно, а диффы местами отображаются неплохо, но не идеально. Тем не менее это уже вполне рабочий вариант.
Давайте закончим настройку наших локальных агентов и подключим получившуюся связку прямо в OpenIDE.
Переносим агента в OpenIDE
С большей частью задач агенты сейчас справляются отлично. Но работать с кодом руками всё ещё приходится. Реже, чем раньше, но приходится.
Поэтому дальше воспользуемся OpenIDE [18] – мультиязычной IDE с интегрированной поддержкой AI-агентов (Claude, Codex, Cursor, Opencode, и т.д.). В ней есть инструменты для работы с кодом, отладкой, Git, базами данных и Docker.
После установки надо выбрать того агента, которым сейчас пользуетесь. Можно несколько. В нашем случае это OpenCode:
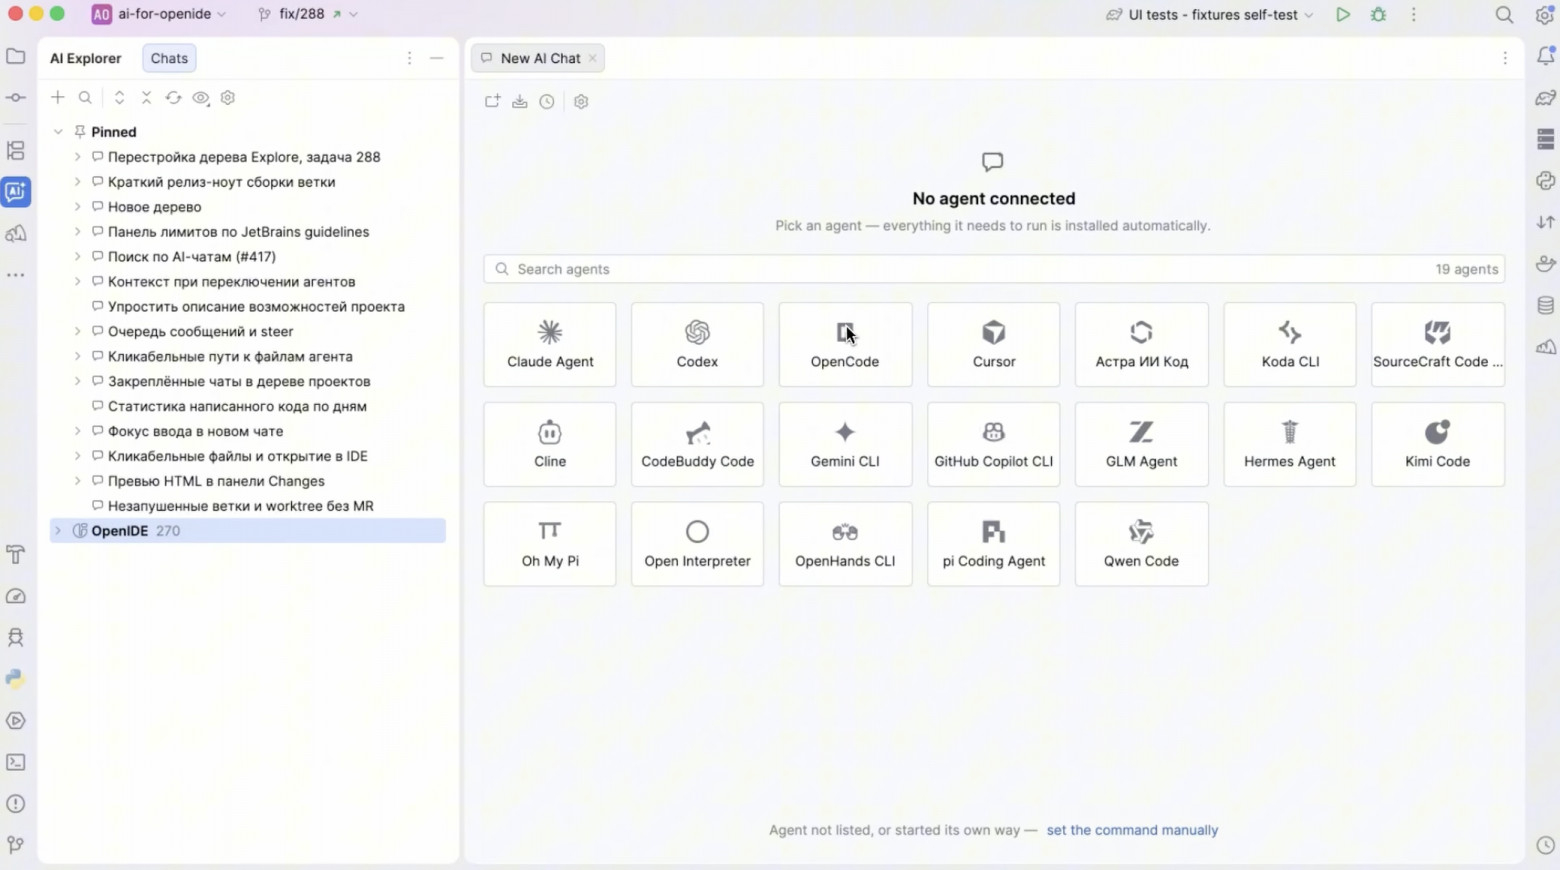
В пройдем нам сценарии мы используем того же самого агента, которого ранее уже настроили. Если настроили ему правила проекта, MCP-серверы или другие инструменты, они доступны и при работе в IDE. Не нужно собирать отдельного агента специально для IDE.
Так же можно подключать другие поддерживаемые агенты, в том числе Claude Code или Codex, и пользоваться доступом к моделям через них. Переключаться между ними в рамках одного чата, тегать именованных агентов [19] и т.д., но сейчас нам достаточно одной локальной Mellum.
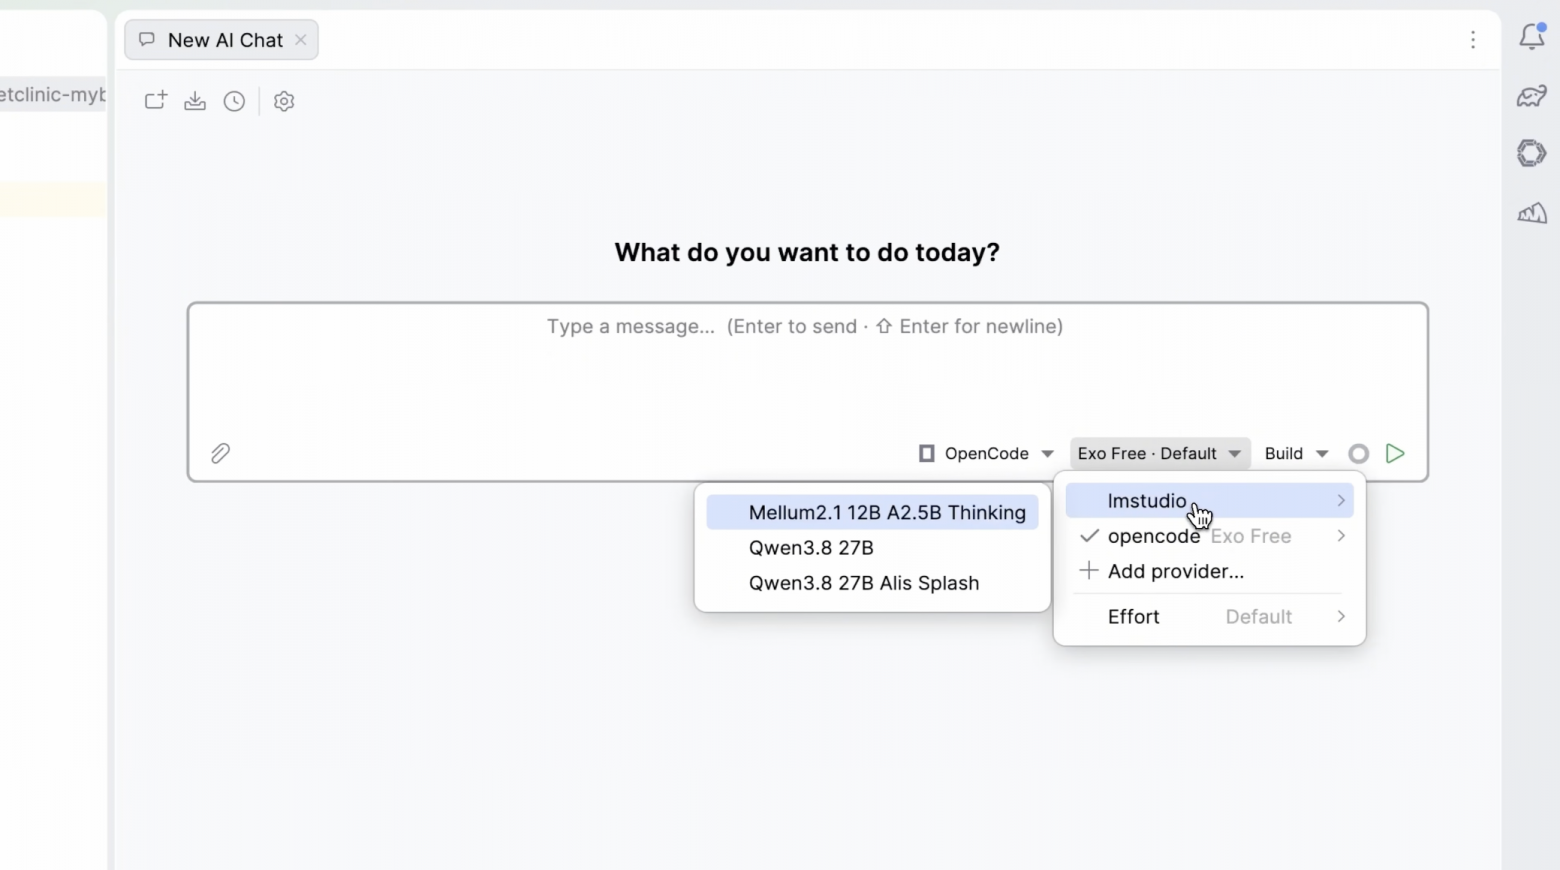
Насколько этим можно пользоваться?
На моём M3 Pro я бы оценил такую работу примерно на 5 из 10. Хотелось бы быстрее, особенно когда агенту нужно несколько раз обратиться к модели, чтобы прочитать файлы, внести изменение и проверить его. В целом, если у вас более мощное железо, то результат будет сильно лучше.
Для повседневной работы с большими задачами я пока переехать на локальные модели не смогу.
В следующей статье планирую разобрать бесплатные облачные варианты: что сейчас доступно, какие там лимиты и как подключить эти инструменты к IDE. За полгода в этой части тоже многое поменялось.
Если используете локальные модели для разработки, расскажите в комментариях, на каком железе, с каким агентом и для каких задач.
Автор: honest_niceman
Источник [20]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38634
URLs in this post:
[1] рассказывал: https://habr.com/ru/companies/haulmont/articles/1012626/
[2] VK-видео: https://vkvideo.ru/video-230816739_456239066?list=ln-PfHghXndrdWXJFFLBY
[3] Rutube: https://rutube.ru/video/9c579264c2a85243ada8d73521725a97/
[4] перевёл: https://www.computing.co.uk/news/2026/ai/revolut-turns-to-self-hosted-ai-to-cut-coding-costs-tenfold-over-claude
[5] Mellum2.1 12B A2.5B Thinking: https://huggingface.co/JetBrains/Mellum2.1-12B-A2.5B-Thinking
[6] Mellum2.1: https://blog.jetbrains.com/ai/2026/10/mellum2-1-gets-to-work-a-fast-open-model-for-coding-agents/
[7] памяти: http://www.braintools.ru/article/4140
[8] официальную GGUF-сборку: https://huggingface.co/JetBrains/Mellum2.1-12B-A2.5B-Thinking-GGUF
[9] отличная статья: https://habr.com/ru/articles/1015510/
[10] canirun.ai: http://canirun.ai
[11] Muse Glimmer от Meta: https://lmstudio.ai/blog/muse-glimmer
[12] Bionic: https://lmstudio.ai/docs/bionic
[13] официального сайта: https://lmstudio.ai/
[14] Порядок скачивания: https://lmstudio.ai/docs/bionic/models/download-local-models
[15] Подробнее про этот режим: https://lmstudio.ai/docs/bionic/quick-start
[16] OpenCode: https://opencode.ai/
[17] другие способы установки: https://opencode.ai/docs/#install
[18] OpenIDE: https://openide.ru/?utm_source=habr&utm_medium=article&utm_campaign=local-llm-v2-2026
[19] тегать именованных агентов: https://habr.com/ru/companies/haulmont/articles/1102934/
[20] Источник: https://habr.com/ru/companies/haulmont/articles/1108400/?utm_campaign=1108400&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.