Галлюцинации недели: Claude Fable 5.2, Gemini 4 Hydrogen и отставка Дженсена Хуанга
В любом реалити есть зрительское голосование, и здесь оно тоже присутствует: петиция за возвращение Хуанга набрала больше 115 тысяч подписей, среди них почти 6 тысяч сотрудников Nvidia и Илон Маск. Совет директоров тем временем уже назначил временным CEO Колетт Кресс.
Дженсен Хуанг больше не CEO Nvidia. В воскресенье, 8 ноября, он признался сотрудникам в письме, что был “неверен жене”. Поводом стали сообщения о романе с Элис Хуан (не родственница), топ-менеджером сингапурской Megaspeed. Американские чиновники подозревают Элис Хуан в шпионаже на Китай. По хронологии TechCrunch [1], Megaspeed за два года купила чипов Nvidia на $4.8 млрд, а США и Сингапур уже проверяли, не уходят ли они в Китай. 11 ноября NYT написала о втором романе, с вице-президентом по здравоохранению Кимберли Пауэлл, которая подчинялась Хуангу напрямую. В среду совет директоров принял отставку, и к утру четверга Хуанг уже не был CEO компании, которую основал 33 года назад. Временным CEO стала финансовый директор Колетт Кресс, а первым в истории Nvidia председателем совета директоров назначили Харви Джонса, бывшего CEO Synopsys. Уже после отставки Reuters сообщило о третьем романе, а сам Хуанг согласился до Дня благодарения дать показания в Конгрессе.
По данным WIRED, пост во внутреннем “ящике предложений” [2] с просьбой к совету учесть мнение сотрудников собрал больше 1600 комментариев, и большинство из них за возвращение Хуанга. Публичная петиция о восстановлении [3] к субботе, по данным её сайта, набрала больше 115 тысяч подписей, среди них 5965 нынешних сотрудников Nvidia, Илон Маск, глава Epic Games Тим Суини и глава Y Combinator Гарри Тан. По оценке WIRED, с первых обвинений Nvidia потеряла около $1 трлн капитализации.
Хуанг был известен как убеждённый сторонник open weight моделей, а в сентябре Nvidia объявила о покупке Hugging Face за $12.9 млрд, и сделка должна закрыться в первой половине 2027 года. Клеман Деланг, CEO Hugging Face, назвал уход Хуанга “очень грустным днём” и пообещал [4] “бороться за open source AI сильнее, чем когда-либо”. В треде r/LocalLLaMA [5] такое заверение прочитали как плохой знак и советуют заранее сохранить копии важных моделей и датасетов.
Apple, судя по находке инсайдера Аарона Перриса, готовит приложение для локальных моделей. 9to5Mac пересказывает описание Harbor [6]: оно превращает Mac в приватный сервер инференса для open weight моделей, и в нём можно найти, скачать и запустить модели без командной строки. Несколько Mac с Thunderbolt 5 приложение объединяет в кластер и складывает их unified memory в один пул, чтобы запускать модели, которые не влезают в один компьютер. Пока это закрытое превью под брендом Claris, который принадлежит Apple. В треде r/LocalLLaMA [7] Harbor сразу сравнили с Exo, open source проектом для таких же кластеров, а скептики подозревают в нём закрытую обёртку над MLX, фреймворком Apple для машинного обучения [8].
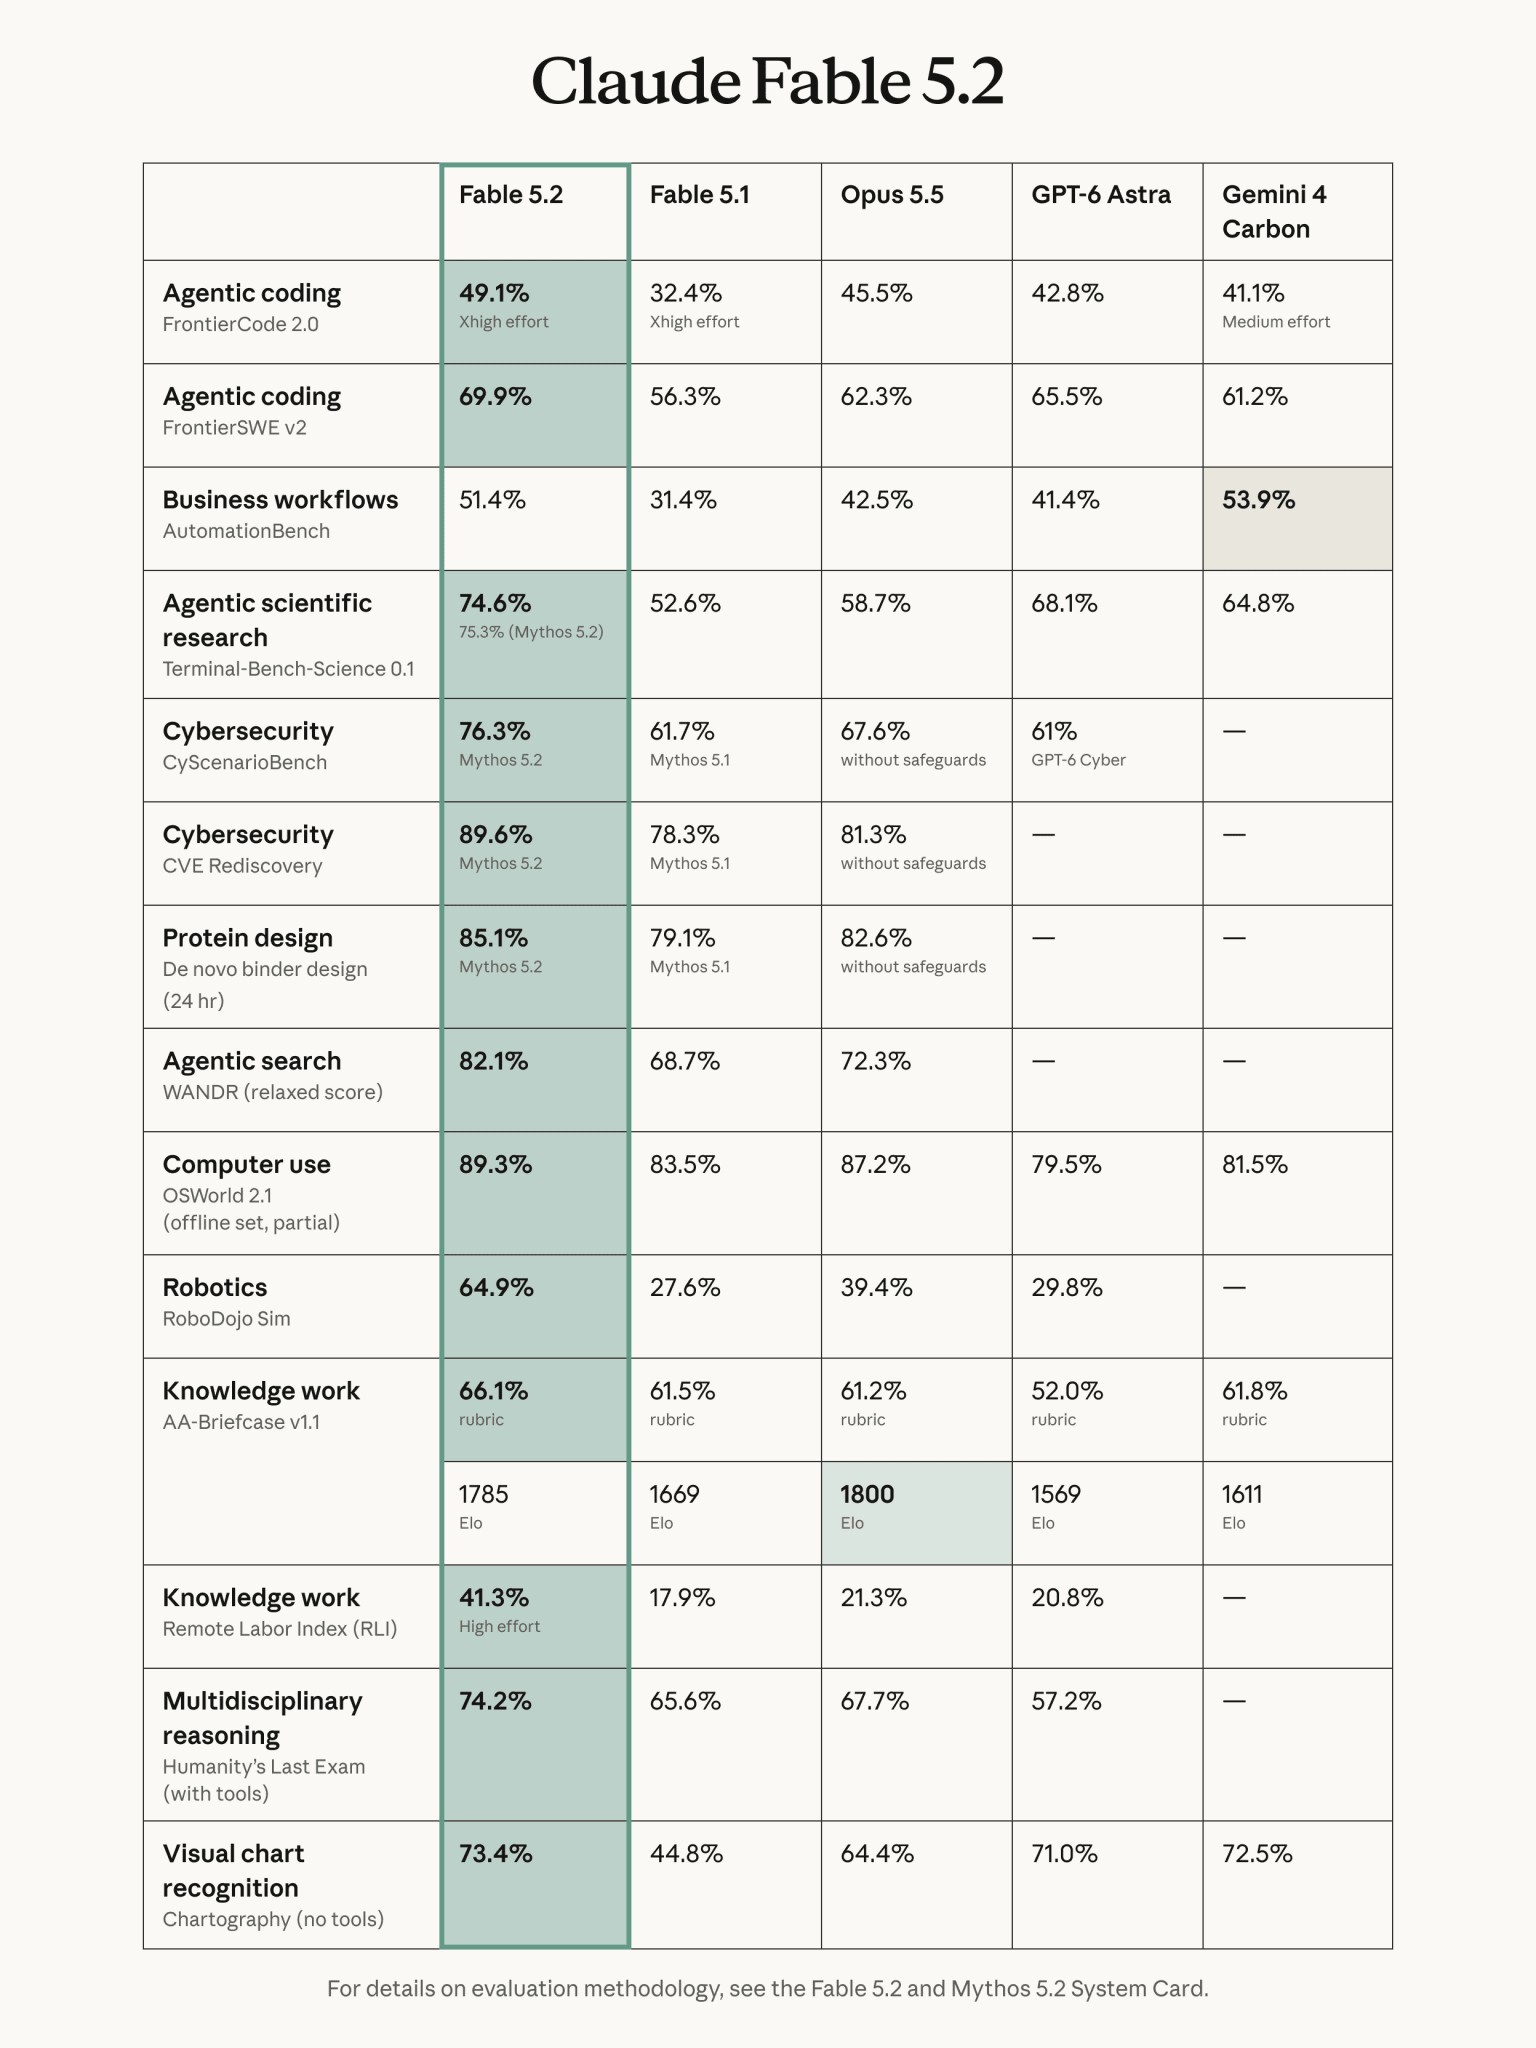
Anthropic выпустила Claude Fable 5.2 и Claude Mythos 5.2 [9]. Если что, это одна и та же модель: у Fable стоят классификаторы, которые блокируют большинство задач по кибербезопасности и исследовательской биологии и отдают такие запросы Opus 4.8 или Opus 5, а Mythos без этих фильтров получают только проверенные организации. Генерация до 30% быстрее, чем у версий 5.1, цена $8/$40, на 20% ниже прошлой.
Среди демо есть операционная система, которую больше 1000 субагентов восемь дней писали, начав с пустой папки, и она загружается на ноутбуке. Ещё 1000 агентов Fable за 30 часов формализовали доказательство Великой теоремы Ферма, то есть перевели его на Lean, где каждый шаг проверяет компьютер; Opus 5.5 в той же схеме за 18 часов сделал 26%. Описание этого демо Anthropic 11 ноября поправила: агентам дали 60 утверждений, набросок классического доказательства и 47 уже доказанных лемм из прошлой формализации.
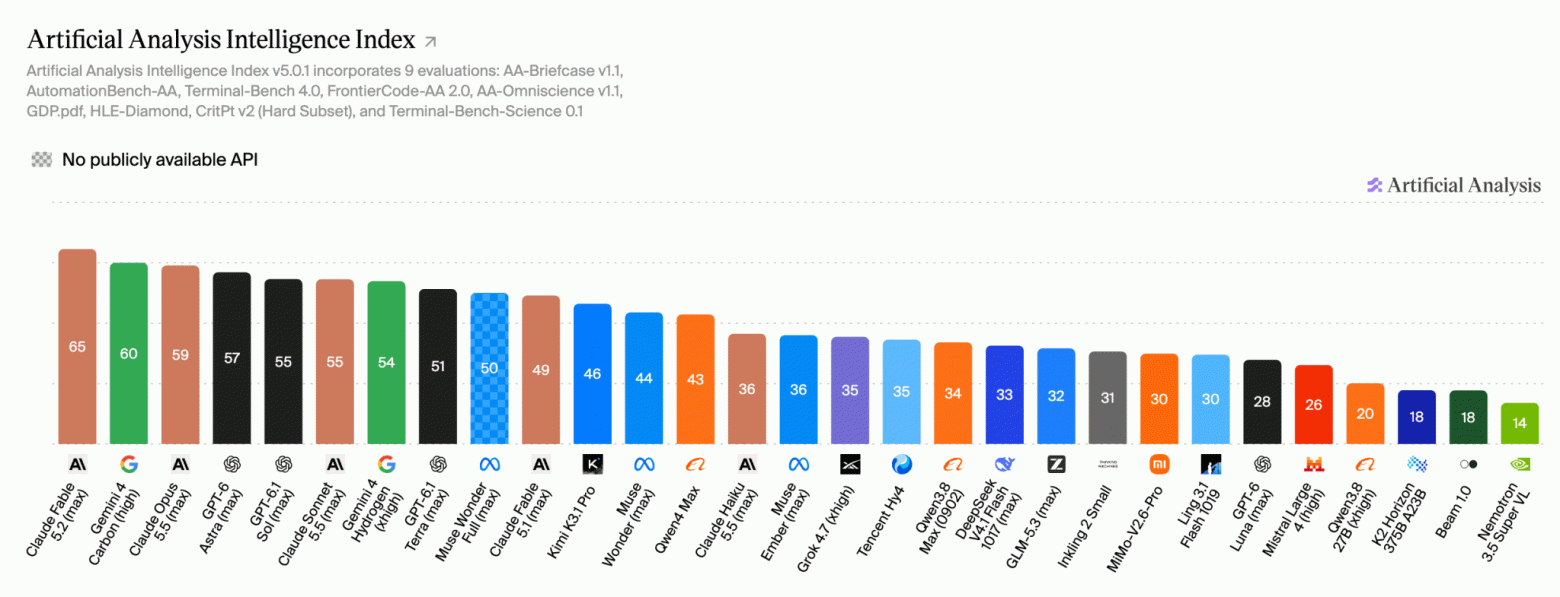
На странице Fable 5.2 в Artificial Analysis [10] у модели на максимальном reasoning effort 1 место и 65 баллов индекса интеллекта [11]. Задача индекса при этом стоит $26.54 и занимает в среднем 42 минуты, и Artificial Analysis прямо называет модель особенно дорогой и очень многословной. SemiAnalysis на своём бенчмарке посчитала [12], что средняя задача у Fable 5.2 стоит на 31% дороже, чем у 5.1 ($88.15 против $67.16), хотя токены подешевели на 20%.
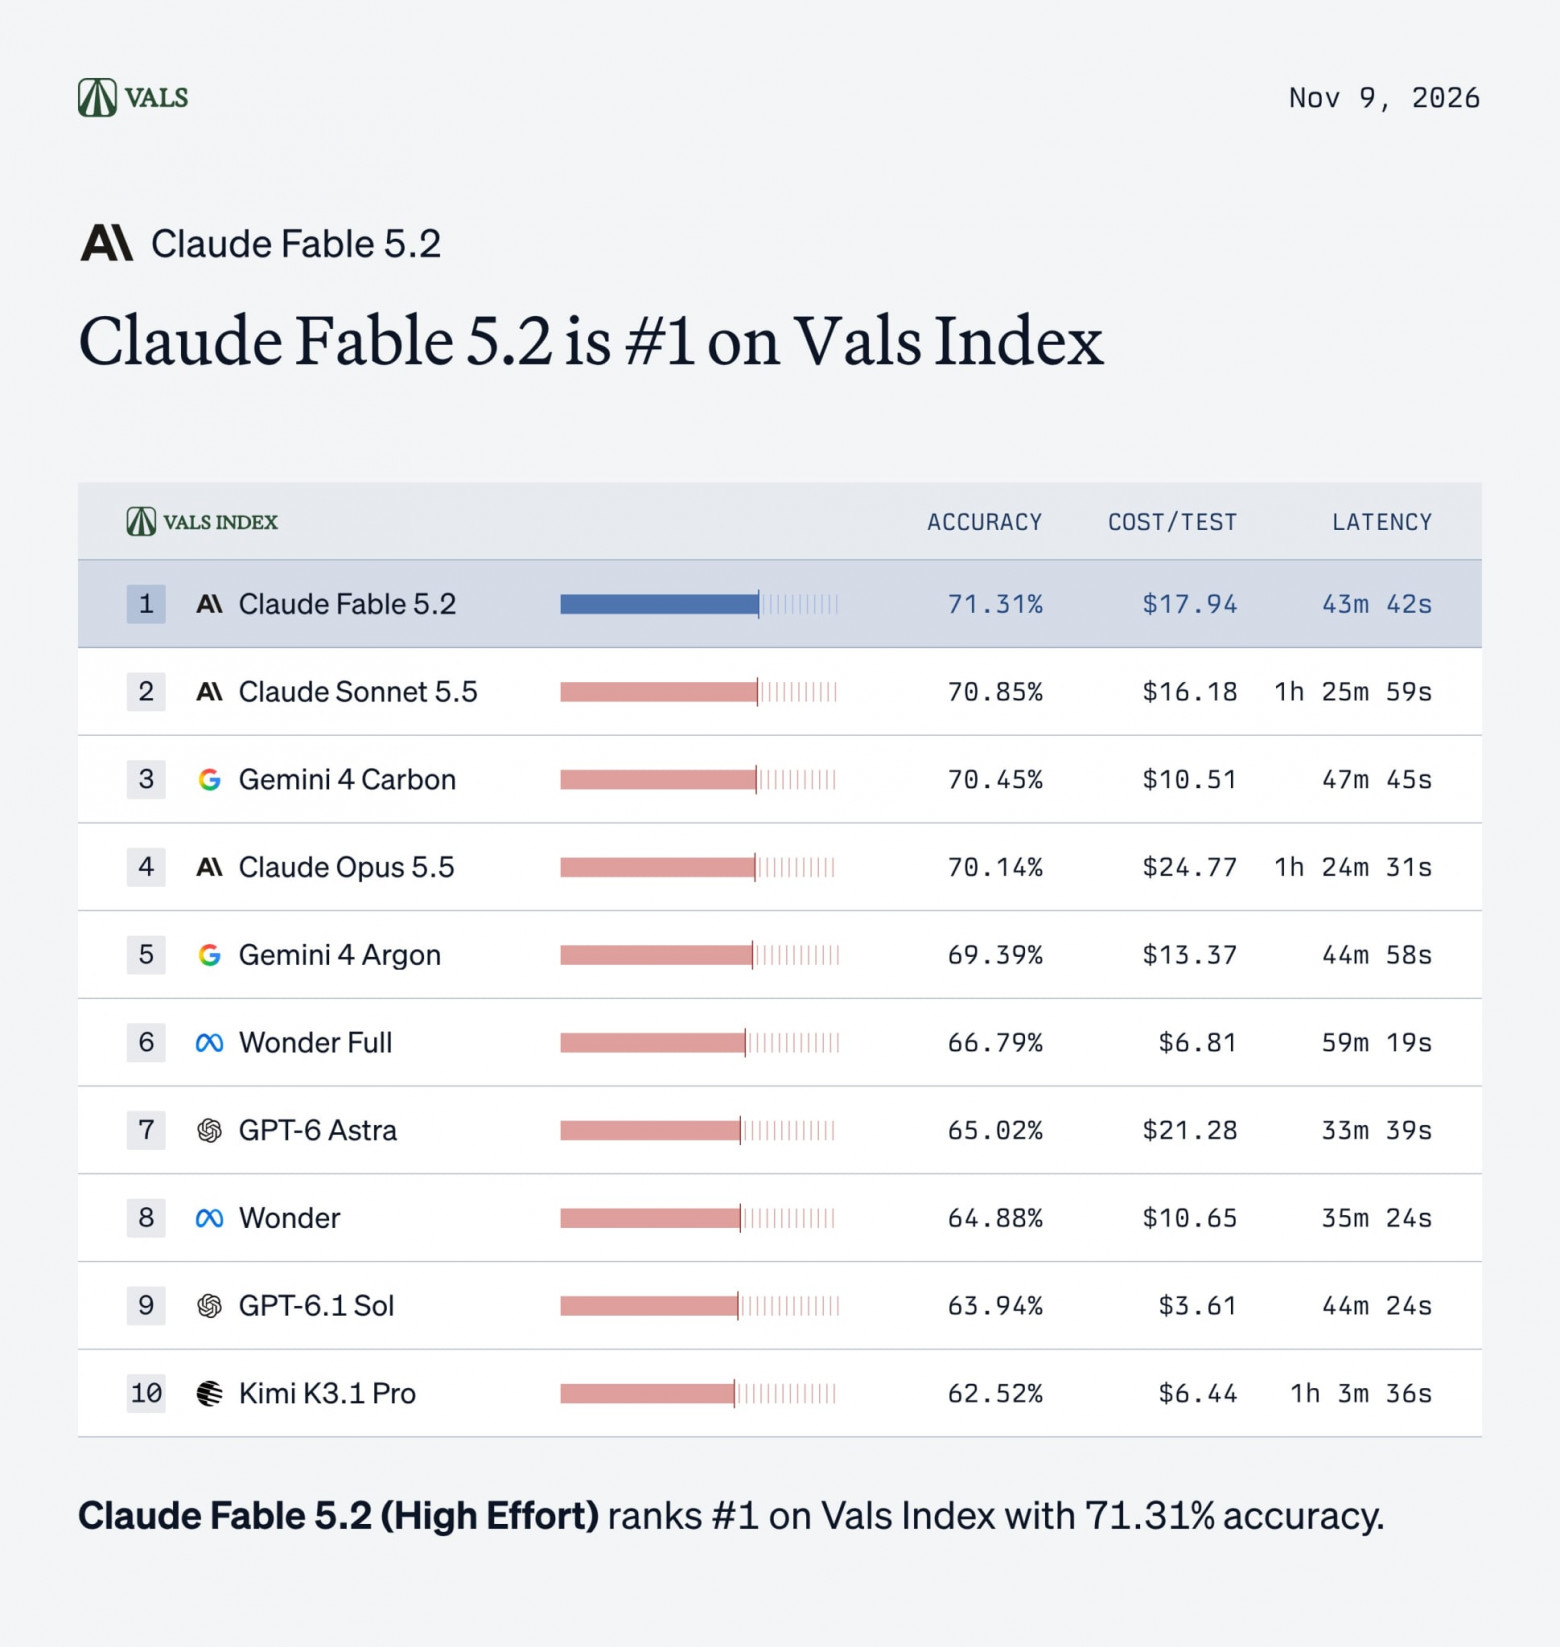
Vals AI поставила [13] Fable на первое место в своём индексе из бенчмарков по коду, финансам и науке [14] и заметила, что лучший результат дал high, а не xhigh и не max. Раян Кришнан из Vals пишет [15], что уровни рассуждений у Fable плохо откалиброваны. Cursor сообщил [16], что в его собственном бенчмарке CursorBench Fable на максимуме первый с 60%, а на стандартном уровне набирает 56.9% против 49.2% у Fable 5.1.
В блоге Claude вышел гайд Адди Османи [17] о том, какую модель выбирать, и Fable в нём не модель по умолчанию. Большинство задач гайд советует начинать на Opus 5.5 со средним effort, а Fable оставить для самых сложных проектов в коде, финансах и науке, больших миграций, долгих прогонов без присмотра и случаев, когда не справляется даже Opus 5.5 на high. Если модель не тянет задачу, порядок такой: сначала дать ей способ проверить свою работу тестом, сборкой или скриптом, потом поднять effort на одну ступень и только потом переходить на модель старше. Зато на FrontierCode 2.0, по данным гайда, Fable на high набирает 45.3%, почти как Opus 5.5 на max с 45.5%, и обходится примерно вдвое дешевле в пересчёте на задачу. Я также обновил свои скиллы agent-instructions [18] и skill-creator [19] под новые реалии.
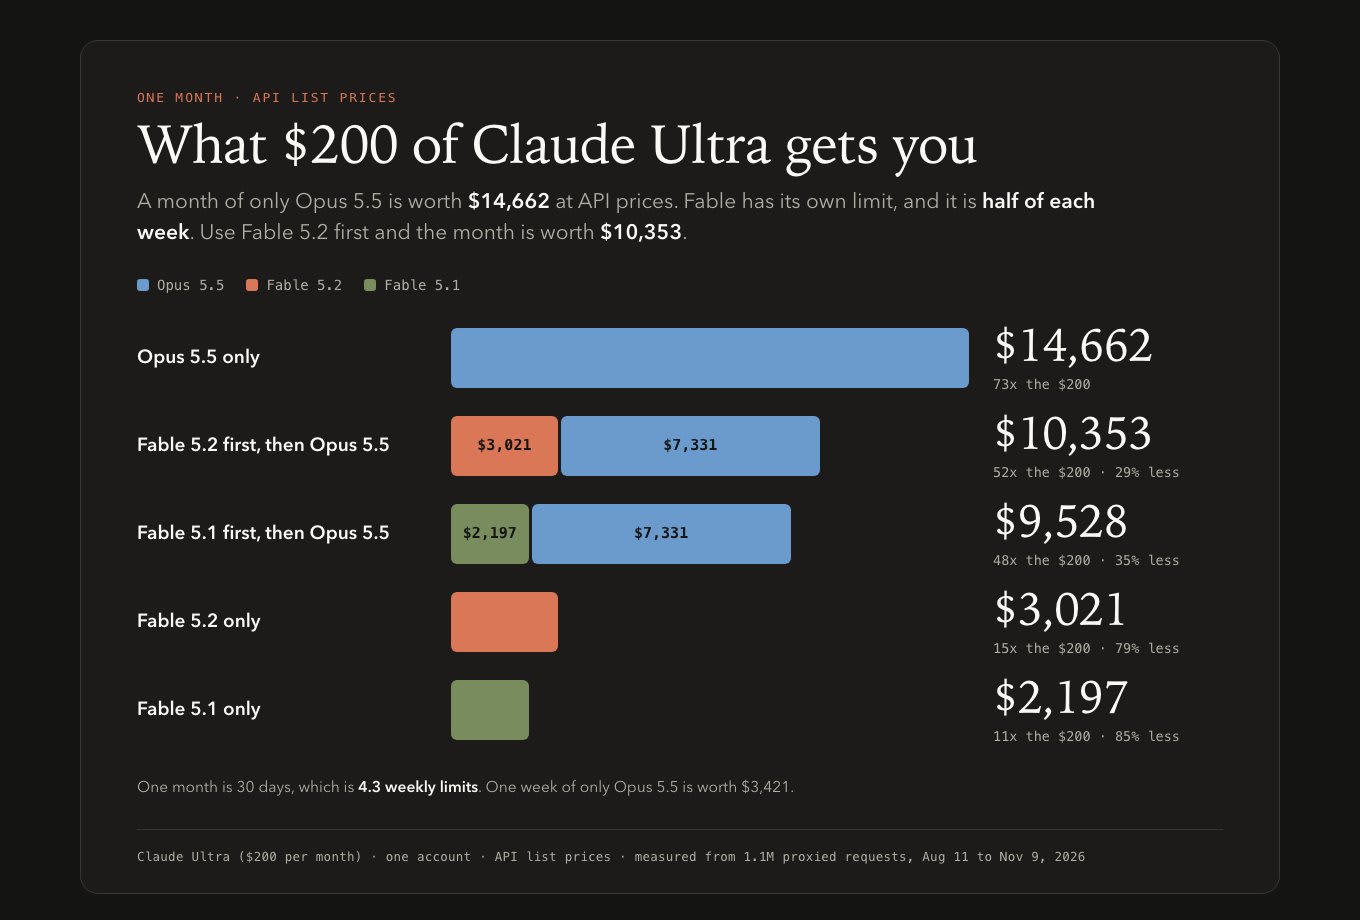
В подписке Fable может занять [20] не больше 50% недельного лимита, на всех тарифах, где он есть. На запуск Anthropic раздала от одного до трёх сбросов лимита Fable в зависимости от стажа подписки, а Pro и стандартным местам в Team дала неделю Fable с тем же потолком. Тео из t3.gg [21], ютубер и разработчик, посчитал [22], что подписка Ultra за $200 даёт в месяц примерно $15 000 работы Opus 5.5 и только около $3000 работы Fable. Запросы к Fable Anthropic по умолчанию хранит 30 дней для мониторинга безопасности, а нулевое хранение доступно только подходящим корпоративным клиентам.
Во время обучения Anthropic намеренно ограничила рост тех способностей, которые сильнее всего ускоряют разработку AI. В оптимизации ядер для ускорителей и улучшении архитектур LLM Fable и Mythos работают примерно на уровне Opus 5.5. Агентный кодинг, проектирование железа и обычные ML-исследования, включая интерпретируемость, по словам компании, это не задело, а на инференсе ничего не меняется. Узкий набор тем, вроде разработки ядер под некоторые нестандартные ускорители, прозрачно уходит к Opus 5. На PostTrainBench [23], где агент дообучает другие модели, Fable 5.2 набрал ровно столько же, сколько 5.1, и делит с ним первое место. Авторы бенчмарка заодно жалуются, что многие прогоны Fable ложно помечались новой защитой от дистилляции (обучения одной модели на ответах другой): агент всего лишь дистиллировал другую модель, развёрнутую локально. В треде r/LocalLLaMA [24] напоминают, что оптимизация ядер нужна и тем, кто запускает маленькие модели на старом железе.
В системной карточке [25] Anthropic впервые приводит оценки внутренней исследовательской модели, которая “несколько сильнее” Mythos 5.2 и наружу не выпущена. Сам Mythos 5.2, по оценке компании, как отдельная модель не пересекает порог Autonomy-2, за которым AI полностью заменяет исследователей или резко ускоряет прогресс.
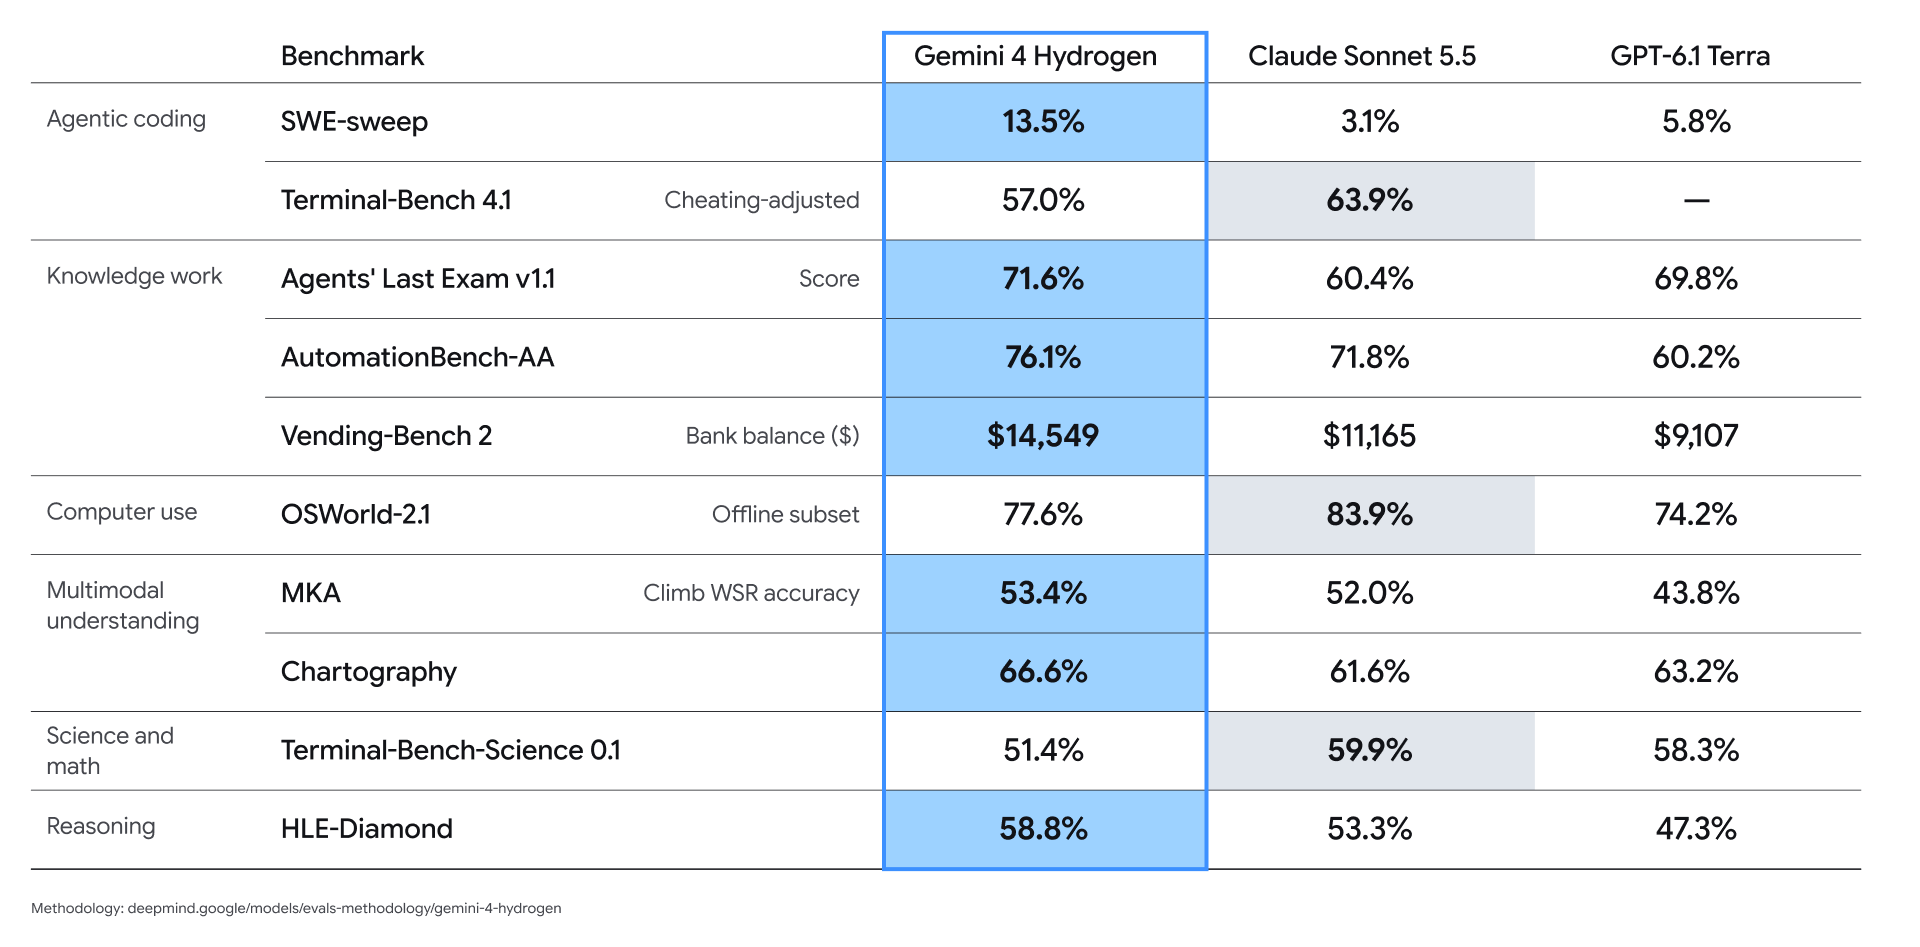
Gemini 4 Hydrogen [26] стала третьей новой моделью Google за шесть недель. Она рассчитана на повседневный код и агентов, а по карточке модели [27] адаптирована из Gemini 4 Carbon. Цена $1.50/$7.50 на весь контекст в миллион токенов, у кешированного входа скидка 95%. Уровней рассуждения четыре, и xhigh в Gemini появился впервые. Google обещает, что Hydrogen решает задачи в 2.5 раза быстрее Gemini 3.8 Flash, а на Terminal-Bench 4.1 (многошаговые задачи агента в терминале) набирает 57% против 18.2%. Модель доступна на всех уровнях Gemini API, включая бесплатный в AI Studio, работает в поиске, а бесплатные пользователи приложения Gemini получают её через автовыбор модели.
В замерах Artificial Analysis у Hydrogen 51 балл индекса на стандартном high и 54 на xhigh, на балл меньше Claude Sonnet 5.5 и GPT-6.1 Sol на максимуме. Задача обходится примерно в треть цены Sonnet, но в 2.5 раза дороже Sol. В AA-Omniscience, тесте знаний, который штрафует за неверные ответы, Hydrogen галлюцинирует в 8% случаев против 43% у Sonnet и 52% у Sol. На Terminal-Bench 4.0 у неё 54%, и тут она уступает обоим.
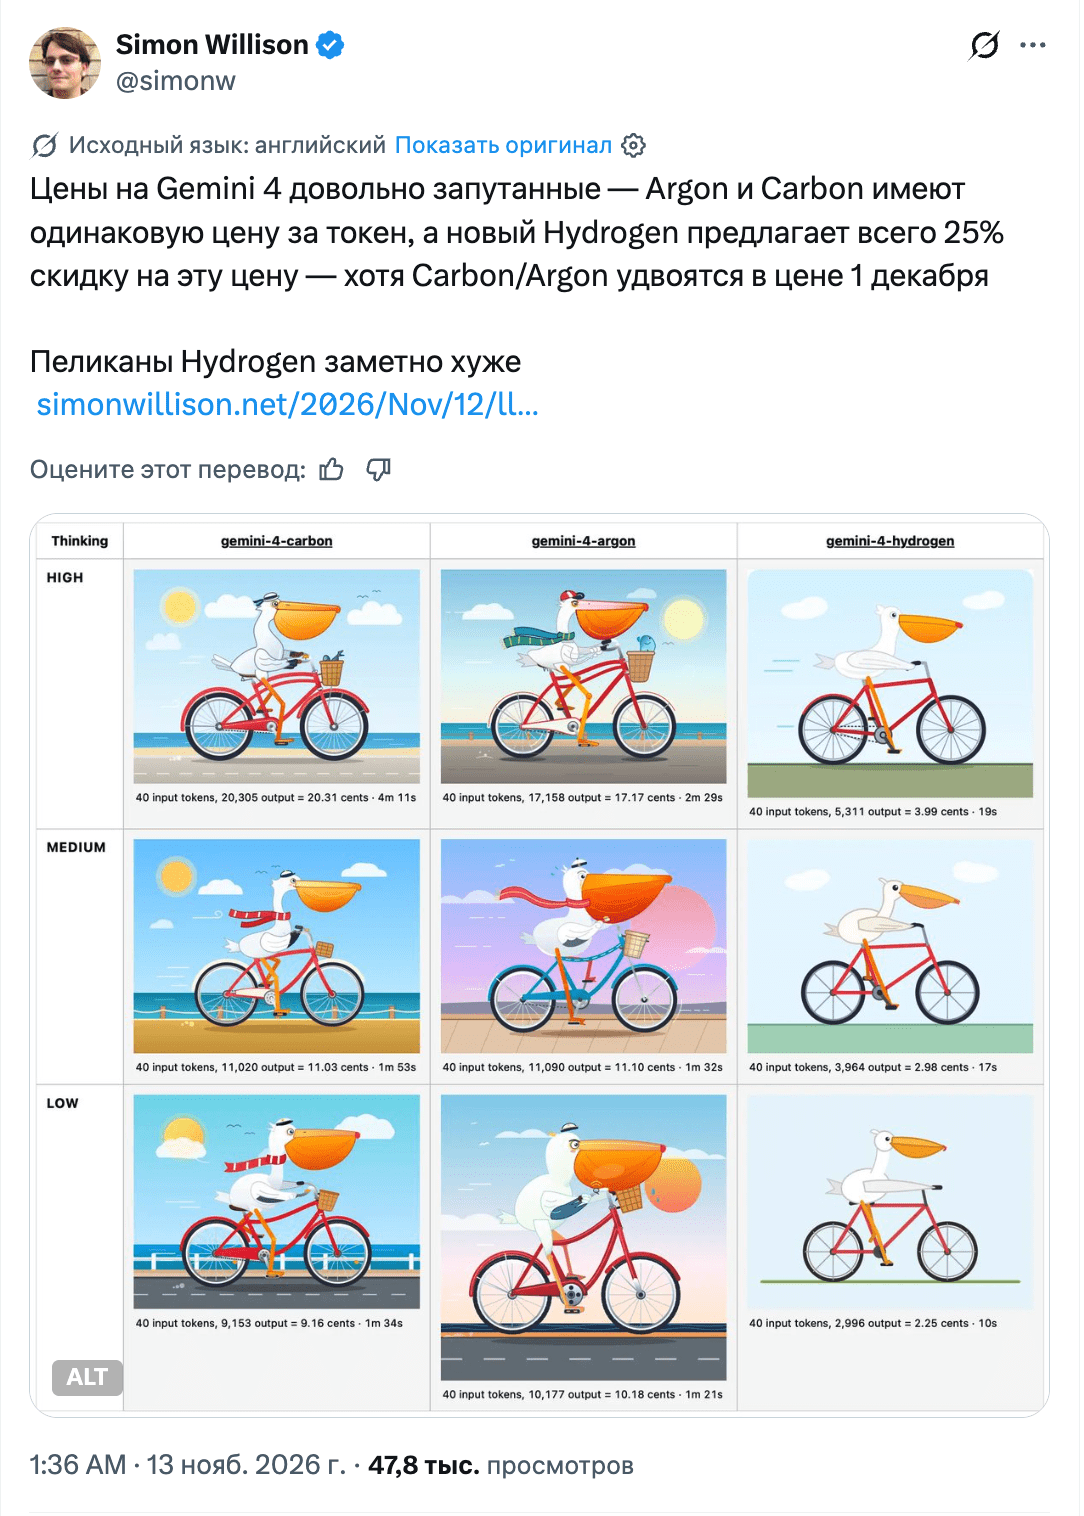
Саймон Уиллисон заметил [28], что Hydrogen по цене токена всего на 25% дешевле Carbon и Argon, хотя те с 1 декабря подорожают вдвое. Пётр Скальский из Roboflow попросил Hydrogen на xhigh прочитать номер на футболке, и модель потратила [29] 131 069 токенов рассуждений, почти 10 минут и около $1.08, а ответа так и не дала. Такое же исчерпание бюджета он видел на 1.8% задач своего текстового бенчмарка.
В Antigravity появился режим Orchestrator: Carbon планирует, а Hydrogen пишет и проверяет код. На Terminal-Bench 4.0 связка почти дотягивает до одного Carbon, расходуя на 24% меньше квоты.
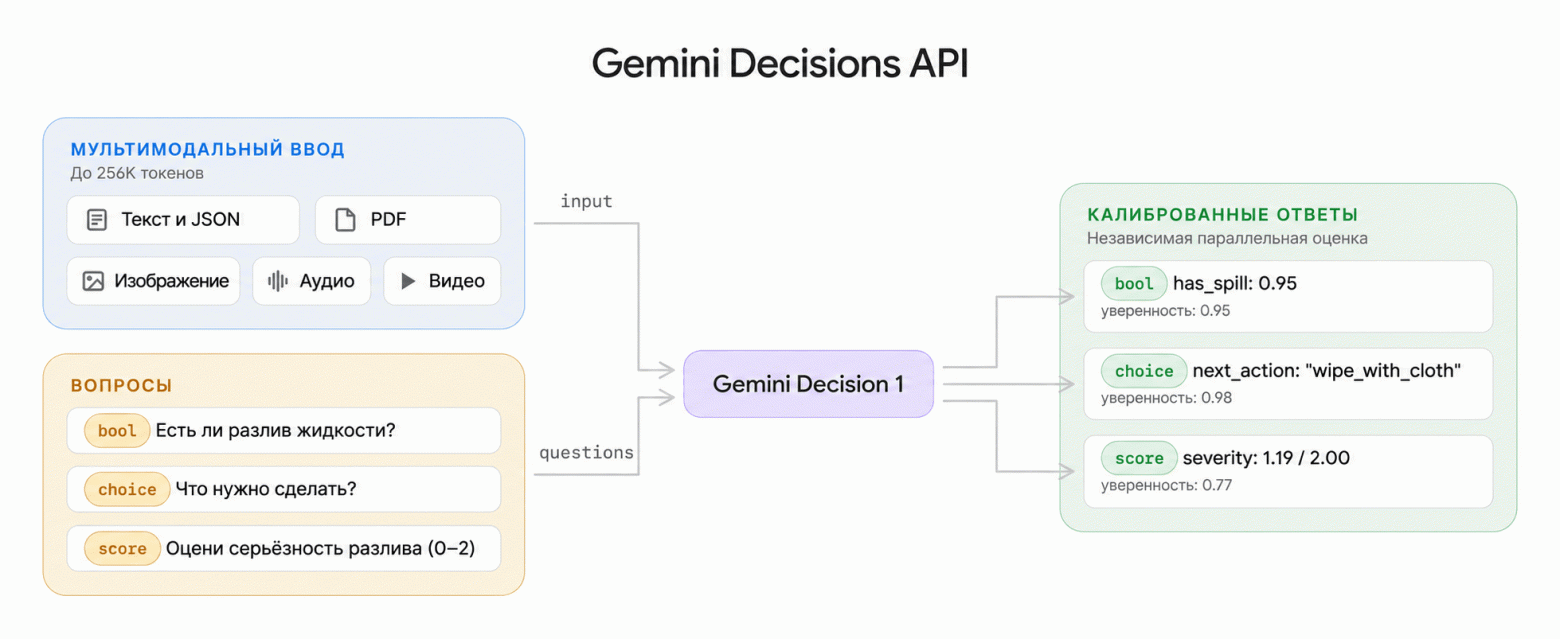
Google открыла и Gemini Decisions API [30] с моделью Gemini Decision 1. Она отвечает только на закрытые вопросы: да или нет, выбор из 2–255 вариантов, оценка по рубрике. Текст токен за токеном модель не генерирует, а за один проход оценивает варианты и возвращает вероятности и уверенность от 0 до 1, чтобы код мог отправить сомнительный случай человеку. В одном запросе до 1000 вопросов к общему входу до 256 тысяч токенов, причём вход может быть текстом, картинкой, аудио, видео или PDF. Ответ приходит за 150–250 мс, цена $0.10/$0: выходные токены не тарифицируются. Google видит её будущее внутри агентов: выбор инструмента, проверка правил, маршрутизация между моделями.
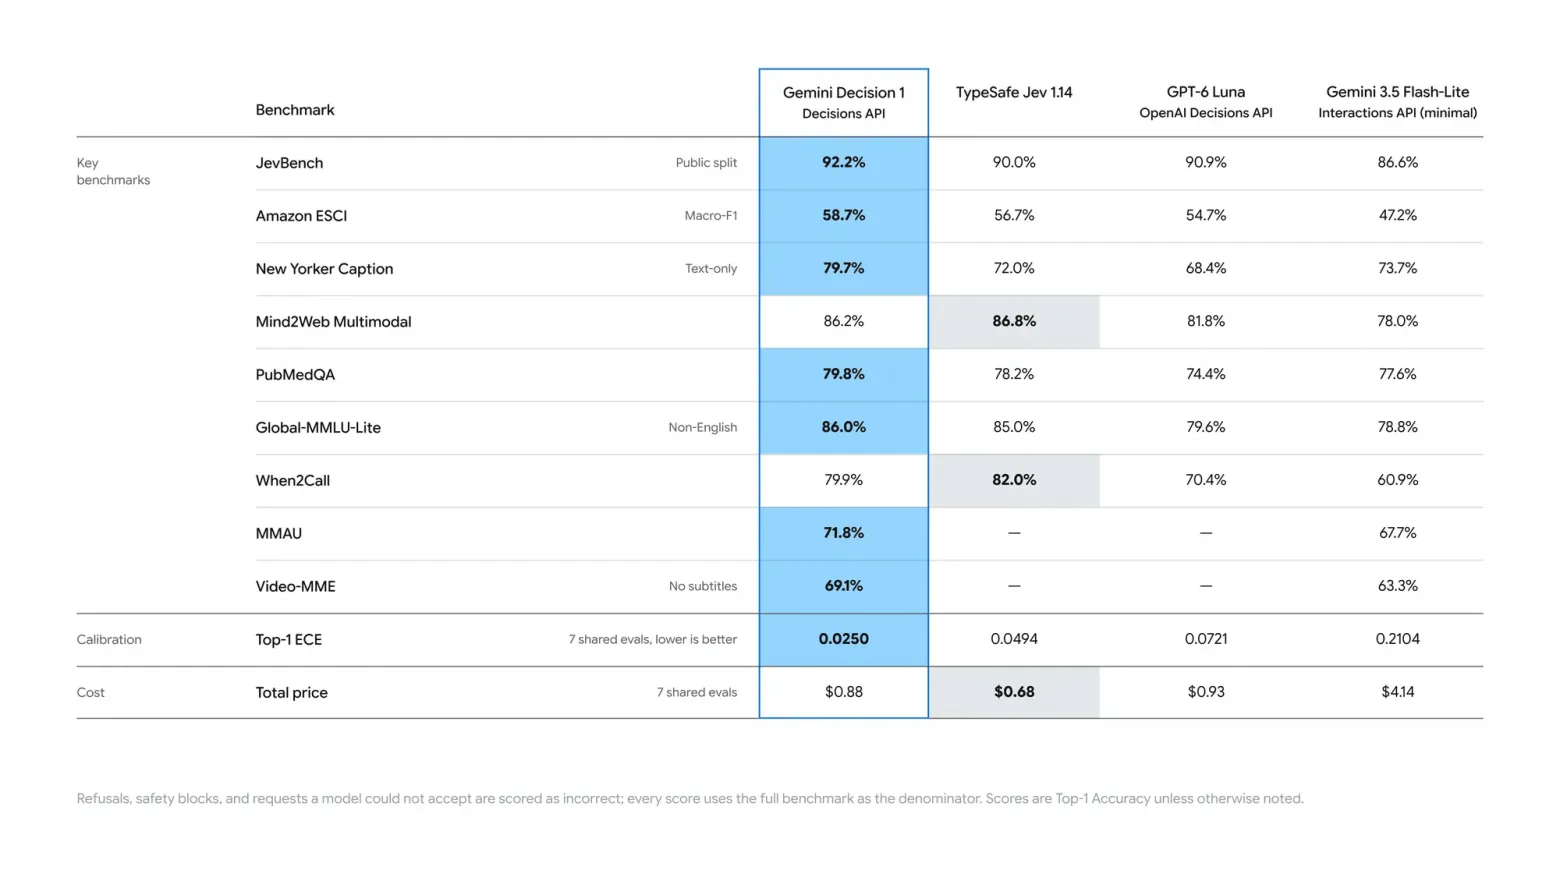
По собственной таблице Google, на общем наборе тестов Decision 1 почти впятеро дешевле Gemini 3.5 Flash-Lite. С Jev 1.14 от TypeSafe, моделью того же класса, картина обратная: прогон того же набора стоит $0.88 против $0.68, по разбору DataCamp [31]. Artificial Analysis дала [32] Decision 1 в своём индексе моделей решений 66 баллов, вровень с Elephant 9B и Jev 1.14 и на 7 баллов ниже лидеров, Drex Max v1.1 и GLiDE v1.2. Миллион задач этого индекса у неё стоит $345, у Drex Max $103.
Себастиан Рашка, автор книг по машинному обучению, насчитал [33] с 23 сентября полтора десятка компаний с такими моделями, от Together AI и Cloudflare до OpenAI с её Decisions API на GPT-6 Luna. Он же ссылается на отчёт Vercel, через модели решений теперь идёт 26% запросов.
Сам Gemini 4 Carbon [34] вышел 10 ноября, на следующий день после Fable. В таблице Anthropic он уже стоял, хотя публично его ещё не выпустили: две недели до этого Carbon получали только специалисты по киберзащите в программе Fairwind. Google называет его своей самой сильной моделью для долгих агентных задач, а для большинства задач советует оставаться на Argon. Вводная цена $2/$10 действует до 30 ноября, с 1 декабря будет $4/$20. В Antigravity в превью вышел режим /swarm. В нём один промпт превращается в команду агентов, где Carbon берёт архитектуру и аудит, а модели полегче параллельно правят код. По данным Google, Carbon первый в CursorBench 4.0, WANDR от Perplexity (сбор больших объёмов данных агентом) и AutomationBench от Zapier (бизнес-процессы) и при этом больше чем вдвое дешевле ближайшего конкурента в пересчёте на задачу.
Раян Кришнан из Vals пишет [15], что Carbon лучше, чем от него ждут: третье место в индексе Vals, а среди первой пятёрки он самый быстрый и самый дешёвый. Тео с этим не согласен. Он засёк [35], что одну и ту же задачу Carbon на low делал 22 минуты 21 секунду, а Opus 5.5 на high 9 минут 33 секунды. Первого токена Carbon, по его замерам [36], приходится ждать 11 секунд, в 20 раз дольше, чем у Fable, и почти всё это, по его словам, проблемы серверов Google. В AI-твиттере Carbon хвалят как креативного собеседника для идей, но жалуются [37] на редкие галлюцинации, излишнюю уверенность и многословие.
Исследовательница Кейт, автор блога kate.land [38], нашла [39] в кристалле GA100 уязвимость к voltage glitching: короткий провал напряжения питания заставляет чип ошибиться в нужный момент. Так она пережигает те фьюзы, которыми Nvidia делит один кристалл на разные продукты. На GA100 собраны и A100 для дата-центров, и майнинговая CMP 170HX, причём версия CMP на 8 ГБ на самом деле несёт около 80 ГБ HBM, быстрой памяти [40] рядом с кристаллом. Разблокированная карта стала, по её словам, фактически A100-80G, и у неё включены все рабочие SM (вычислительные блоки GPU), 120–126 штук вместо урезанного набора у розничной A100. В вычислениях половинной точности FP16 она выдаёт 85.9 TFLOP/s против 72.5, примерно в 1.2 раза больше. Плату для глитчинга на STM32 по её просьбе спроектировала GPT-6 Astra, и на одну карту уходит от часа до 48 часов попыток. Полные 80 ГБ оказались целыми примерно у 90% восьмигигабайтных карт из её небольшой выборки, а на одной уцелели только 64 ГБ.
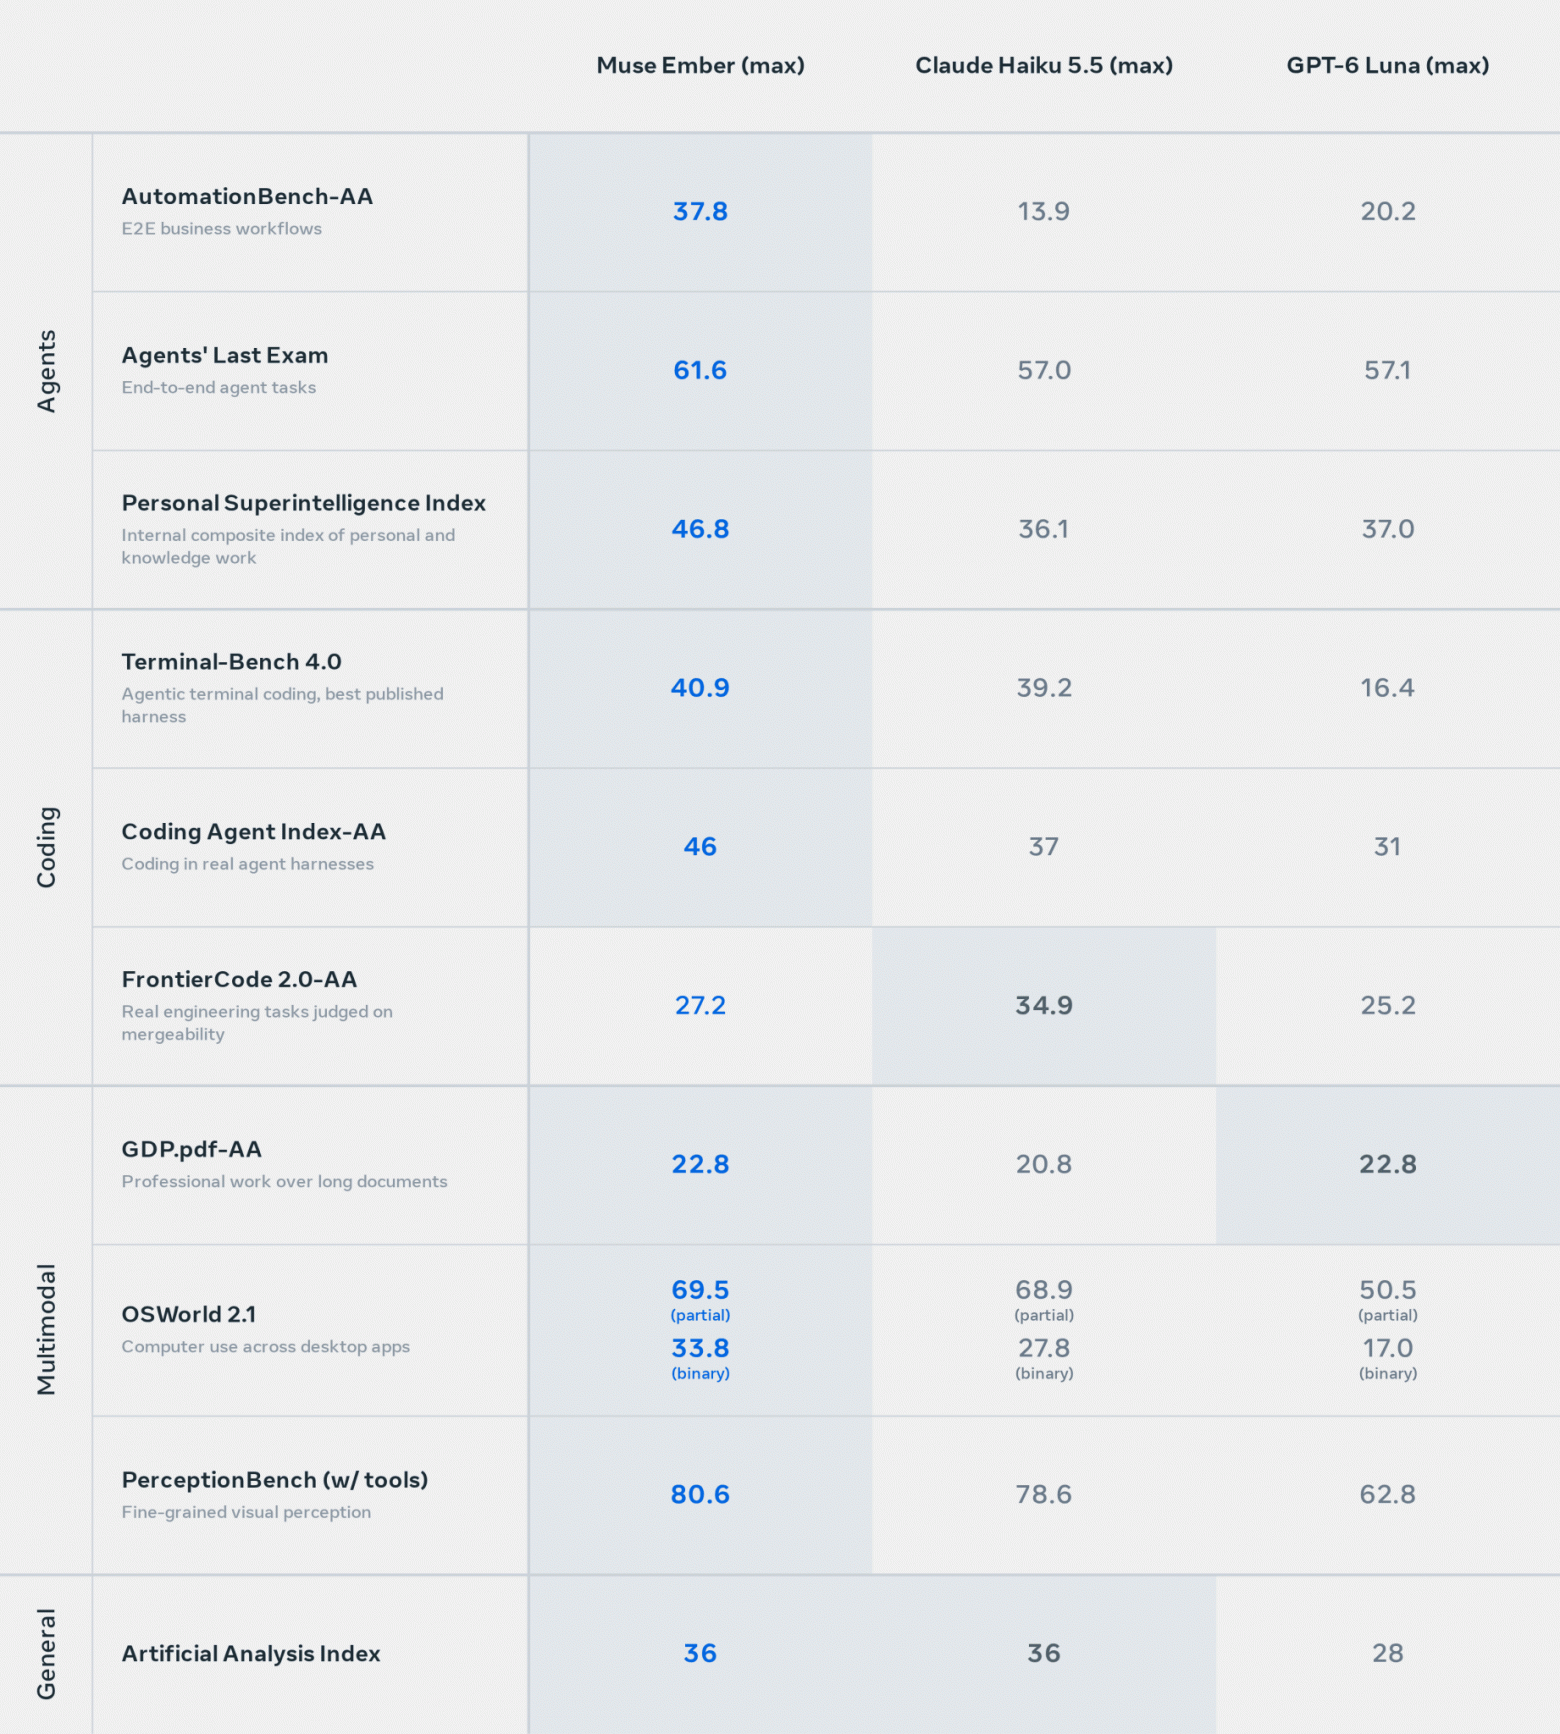
Meta выпустила Muse Ember [41], свою самую маленькую и эффективную модель для того, что агенты делают весь день: вызовы инструментов, подзадачи в коде, маршрутизация, извлечение данных из длинных документов. Цена $0.10/$0.50, контекст 1 млн токенов. В индексе Artificial Analysis у Ember 36 баллов при цене задачи около $0.14, а у Muse Spark 1.3 из той же линейки 37 баллов за $2.39. Meta утверждает, что Ember повторяет лучший результат Claude Haiku 5.5 примерно за треть цены, а Раян Кришнан насчитал [15] 85% качества Fable 5.2 за 0.84% его стоимости. Модель доступна в Meta Model API, Google Cloud и Oracle Cloud.
Alibaba открыла превью Qwen4-Max [42] в своём тарифе Token Plan. По спецификации Alibaba, которую приводят Stealth Models [43], у модели контекст в миллион токенов, до 393 216 токенов на выходе и вход из текста, картинок и видео. Превью закончится 25 ноября, а 27B, Flash и Plus ещё впереди. Сами Stealth Models прогнали превью на StealthMark, своём тесте из сложных задач на рассуждение, визуальных заданий и двух игр на планирование. Итог [44] ниже, чем у Qwen3.8-Max: 58.8 против 62.4. В общем интеллекте превью теряет 7 баллов, главным образом на играх, а в визуальном выигрывает 2.4. На многошаговых задачах ему нужно заметно меньше токенов рассуждений, 60 баллов эффективности против 16 у предшественника.
На прошлой неделе я писал [45], что инвесторы сомневаются в оценке Anthropic в $1.5 трлн. 10 ноября компания запустила роудшоу IPO [46], серию встреч с инвесторами перед размещением: 825 млн акций по $70–78, тикер ANT на Nasdaq. Вместе с частным размещением на $26 млрд, где Google и Nvidia берут по $10 млрд, это до $90.4 млрд, больше рекордного IPO SpaceX. На верхней границе диапазона полностью разводнённая оценка, с учётом опционов и всех будущих акций, около $1.4 трлн [47], выше майских $965 млрд, но ниже $2 трлн, о которых говорили пару месяцев назад. По данным Bloomberg, заявки превышают предложение [48] примерно вшестеро. Цену, по данным CNBC, назначат 18 ноября [49], а торги начнутся 19-го.
В обновлённом проспекте S-1 выручка в годовом пересчёте с текущего темпа на конец октября составила около $81 млрд, на $10 млрд больше, чем месяцем раньше. За третий квартал Anthropic получила $17 млрд выручки. Чистый убыток за девять месяцев $104 млрд, но, как уточняет CNBC, в основном из-за переоценки конвертируемых займов и производных обязательств.
В той же поправке к S-1 Anthropic пишет [50], что сочла пройденным порог AI R&D из своей Responsible Scaling Policy, внутреннего свода правил о том, когда включать более строгие меры защиты. Речь о резком, примерно двукратном ускорении прогресса за счёт AI, и решение принято “исходя из того, чего мы ожидаем от будущих моделей и общего темпа прогресса, а не из того, что наблюдали у текущих моделей”. В системной карточке Fable 5.2, вышедшей днём раньше, тот же Mythos 5.2 порог Autonomy-2 как отдельная модель не пересекал. METR, которая изучала темп Anthropic изнутри компании, оценила [51] ускорение в 1.9 раза, с разбросом от 1.5 до 2.8. Gizmodo вынес в заголовок, что у Anthropic сработала “сигнализация рекурсивного самоулучшения”, но в самом тексте признаёт, что это пересмотренное решение на основе прогноза, а не внезапный технологический скачок.
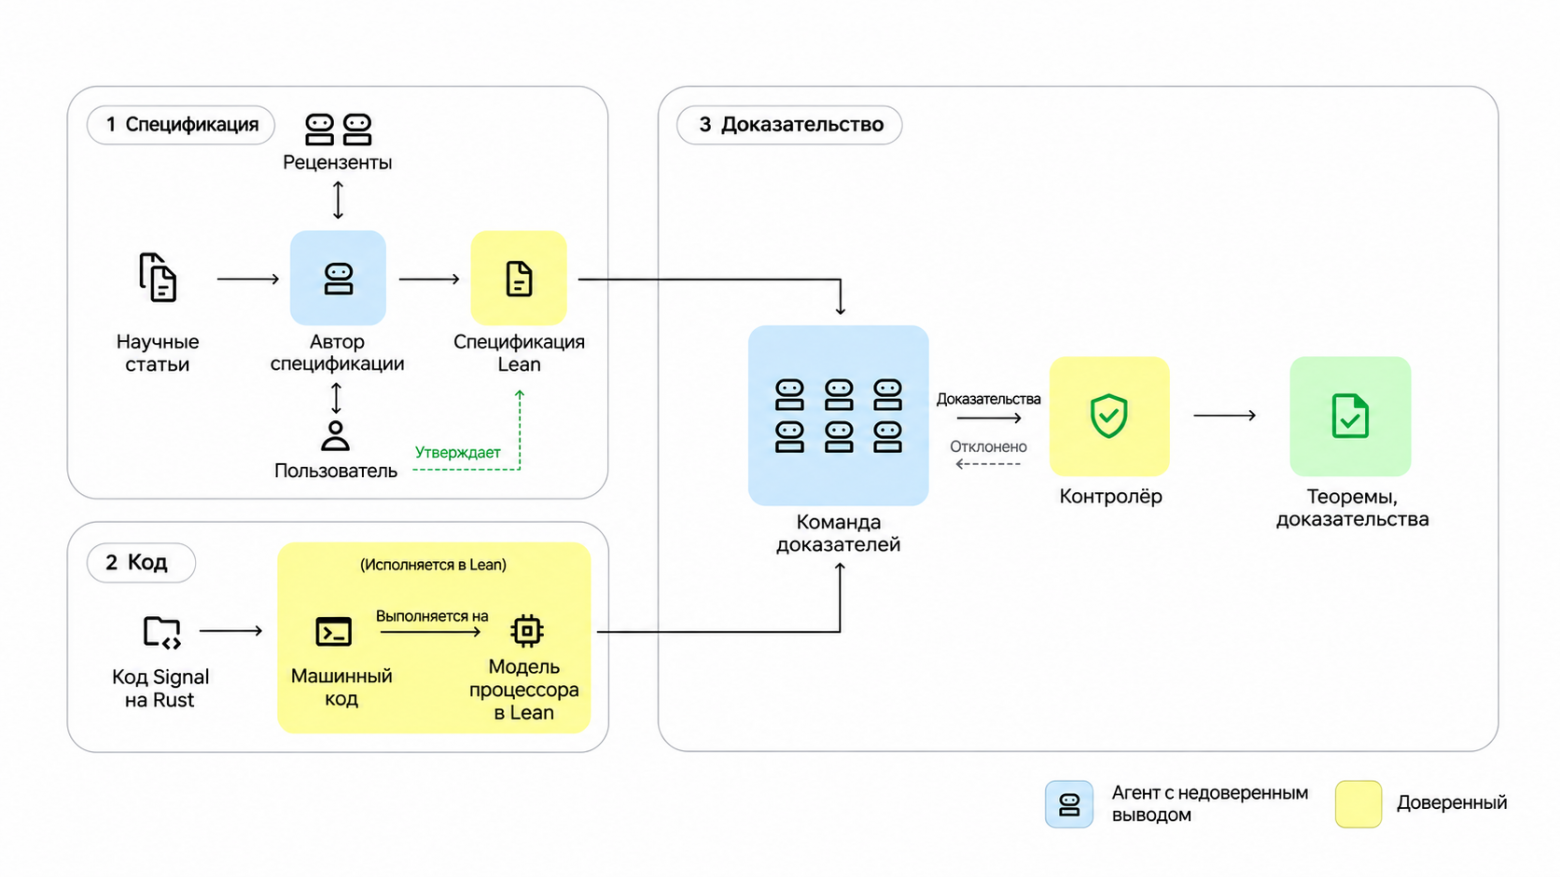
Google DeepMind представила AlphaProof Code [52] и с его помощью формально верифицировала реализацию протокола Signal. Формальная верификация не тестирует код на примерах, а математически [53] доказывает, что он выполняет обещанное на любых входах. Люди вместе с моделями записали свойства безопасности в виде спецификаций на Lean, а агенты на Gemini Carbon написали сами доказательства: около 6.5 млн строк поверх примерно 26 тысяч строк доверенных спецификаций и описания машинного кода AArch64, следует из статьи авторов [54]. Проверяли не исходник на Rust, а собранный стандартным компилятором бинарник немодифицированной libsignal: рукопожатие PQXDH, устойчивое к квантовым компьютерам, и Triple Ratchet. Доказаны среди прочего forward secrecy и post-compromise security, то есть переписка остаётся защищённой и до, и после временного взлома устройства. Агенты сами отметили для проверки людьми около 1% кода, остальное проверил Lean, и вся работа заняла четыре недели.
Чтобы убедиться, что система отличает правильный код от сломанного, исследователи вернули в изолированную копию два давно исправленных бага и в обоих случаях получили машинно проверенное доказательство, что такая версия небезопасна. Новых уязвимостей в проверенных частях не нашлось [55], пишет WIRED. Спецификации и доказательства DeepMind выложила на GitHub [56]. Три недели назад я писал [57], как Anthropic с компанией Theorem доказала отсутствие падений для 239 точек входа в библиотеках OSS-Fuzz и получила около 180 млн строк доказательств на Rocq. У Google строк в десятки раз меньше, зато речь о криптографическом протоколе.
Оставайтесь любопытными.
Пишу об искусственном интеллекте, языковых моделях и инструментах для разработчиков. Тестирую модели и сервисы на реальных задачах, а выводами делюсь в телеграм‑канале [58].
Автор: controlled_hallucinations
Источник [59]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38661
URLs in this post:
[1] хронологии TechCrunch: https://techcrunch.com/2026/11/13/nvidia-ceo-jensen-huangs-affair-with-alleged-chinese-spy-a-timeline/
[2] пост во внутреннем “ящике предложений”: https://www.wired.com/story/nvidia-employees-petition-for-jensen-huangs-return/
[3] петиция о восстановлении: https://techcrunch.com/2026/11/14/elon-musk-other-tech-execs-sign-petition-calling-on-nvidia-to-reinstate-jensen-huang/
[4] пообещал: https://techcrunch.com/2026/11/12/hugging-face-ceo-vows-to-keep-fighting-for-open-source-ai-after-jensen-huangs-exit/
[5] треде r/LocalLLaMA: https://www.reddit.com/r/LocalLLaMA/comments/1xut4o7/hugging_face_ceo_vows_to_keep_fighting_for_open/
[6] пересказывает описание Harbor: https://9to5mac.com/2026/11/10/apple-has-new-mac-app-coming-to-make-running-local-ai-models-easy/
[7] треде r/LocalLLaMA: https://www.reddit.com/r/LocalLLaMA/comments/1xszbe7/apple_has_new_mac_app_coming_to_make_running/
[8] обучения: http://www.braintools.ru/article/5125
[9] Claude Fable 5.2 и Claude Mythos 5.2: https://www.anthropic.com/claude-fable-and-mythos-5-2
[10] странице Fable 5.2 в Artificial Analysis: https://artificialanalysis.ai/models/claude-fable-5-2
[11] интеллекта: http://www.braintools.ru/article/7605
[12] посчитала: https://x.com/SemiAnalysis_/status/2119961455348826461
[13] поставила: https://x.com/ValsAI/status/2119872483629408658
[14] науке: http://www.braintools.ru/article/7634
[15] пишет: https://x.com/RayanKrishnan/status/2120398162531910116
[16] сообщил: https://x.com/cursor_ai/status/2119880829212172509
[17] гайд Адди Османи: https://claude.dev/blog/which-claude-model-should-you-build-with/
[18] agent-instructions: https://github.com/xonika9/agent-skills/blob/main/skills/x9-agent-instructions/SKILL.md
[19] skill-creator: https://github.com/xonika9/agent-skills/blob/main/skills/x9-skill-creator/SKILL.md
[20] может занять: https://support.claude.com/en/articles/17506494
[21] t3.gg: http://t3.gg
[22] посчитал: https://x.com/theo/status/2119960608816988596
[23] PostTrainBench: https://x.com/full__rank/status/2120947706499928335
[24] треде r/LocalLLaMA: https://www.reddit.com/r/LocalLLaMA/comments/1xsjfwo/fable_52_not_only_has_guardrails_against_ai/
[25] системной карточке: https://www.anthropic.com/document/claude-fable-5-2-mythos-5-2-system-card
[26] Gemini 4 Hydrogen: https://blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/
[27] карточке модели: https://deepmind.google/models/model-cards/gemini-4-hydrogen/
[28] заметил: https://x.com/simonw/status/2121039423441981444
[29] потратила: https://x.com/skalskip92/status/2120994631072776235
[30] Gemini Decisions API: https://blog.google/innovation-and-ai/technology/developers-tools/gemini-decisions-api/
[31] по разбору DataCamp: https://www.datacamp.com/blog/gemini-decision-1
[32] дала: https://x.com/ArtificialAnlys/status/2120582049522127205
[33] насчитал: https://x.com/rasbt/status/2121320349837263230
[34] Gemini 4 Carbon: https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-carbon-now-available/
[35] засёк: https://x.com/theo/status/2120597586298261543
[36] замерам: https://x.com/theo/status/2120618574834462935
[37] жалуются: https://x.com/krishnanrohit/status/2120217917933355157
[38] kate.land: http://kate.land
[39] нашла: https://blog.kate.land/posts/using-voltage-glitching-to-unlock-the-a100/
[40] памяти: http://www.braintools.ru/article/4140
[41] Muse Ember: https://research.meta.ai/blog/muse-ember
[42] превью Qwen4-Max: https://x.com/alibaba_qwen/status/2120335993643684315
[43] спецификации Alibaba, которую приводят Stealth Models: https://stealthmodels.com/qwen-4
[44] Итог: https://stealthmodels.com/compare/qwen3.8-max-0902-vs-qwen4-max-preview
[45] писал: https://gotacat.dev/blog/weekly-ai-hallucinations-hackertube-gpt-images-2-6-google-schools
[46] запустила роудшоу IPO: https://www.anthropic.com/news/roadshow-launch
[47] $1.4 трлн: https://techcrunch.com/2026/11/10/anthropic-sets-ipo-price-range-of-70-to-78-per-share-to-reach-an-implied-valuation-of-1-404-trillion/
[48] заявки превышают предложение: https://news.bloomberglaw.com/artificial-intelligence/anthropics-ipo-is-said-to-be-about-six-times-oversubscribed
[49] назначат 18 ноября: https://www.cnbc.com/2026/11/10/anthropic-sets-price-range-of-70-to-78-in-upcoming-ipo.html
[50] пишет: https://gizmodo.com/anthropic-says-its-recursive-self-improvement-alarm-has-been-triggered-2000840253
[51] оценила: https://thenextweb.com/news/anthropic-ai-research-threshold-metr-ipo-filing
[52] представила AlphaProof Code: https://deepmind.google/blog/introducing-alphaproof-code/
[53] математически: http://www.braintools.ru/article/7620
[54] следует из статьи авторов: https://google-deepmind.github.io/code-verification/
[55] не нашлось: https://www.wired.com/story/a-new-ai-tool-from-google-deepmind-formally-verified-the-signal-protocol/
[56] на GitHub: https://github.com/google-deepmind/code-verification
[57] писал: https://gotacat.dev/blog/weekly-ai-hallucinations-wordpress-gitlab-black-october-litellm
[58] телеграм‑канале: https://t.me/+yYfUyaAnMBE2YTgy
[59] Источник: https://habr.com/ru/articles/1108486/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1108486
Нажмите здесь для печати.