GTA 6 сгенерировала нейросеть?
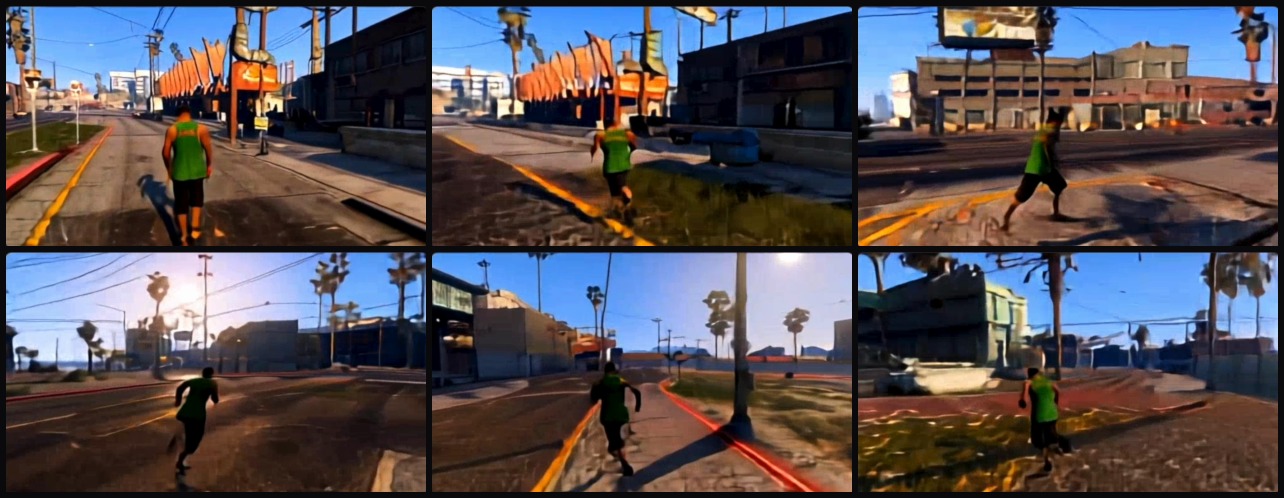
Разработчик Абхишек Сеншарма, публикующий проекты под именем lucidml, представил интерактивную модель мира, обученную на записях GTA V. Пользователь задаёт стартовое изображение и управляет происходящим с клавиатуры, а нейросеть последовательно генерирует новые кадры. Под изображением нет работающего игрового движка GTA: продолжение сцены создаётся моделью с учётом действий игрока.
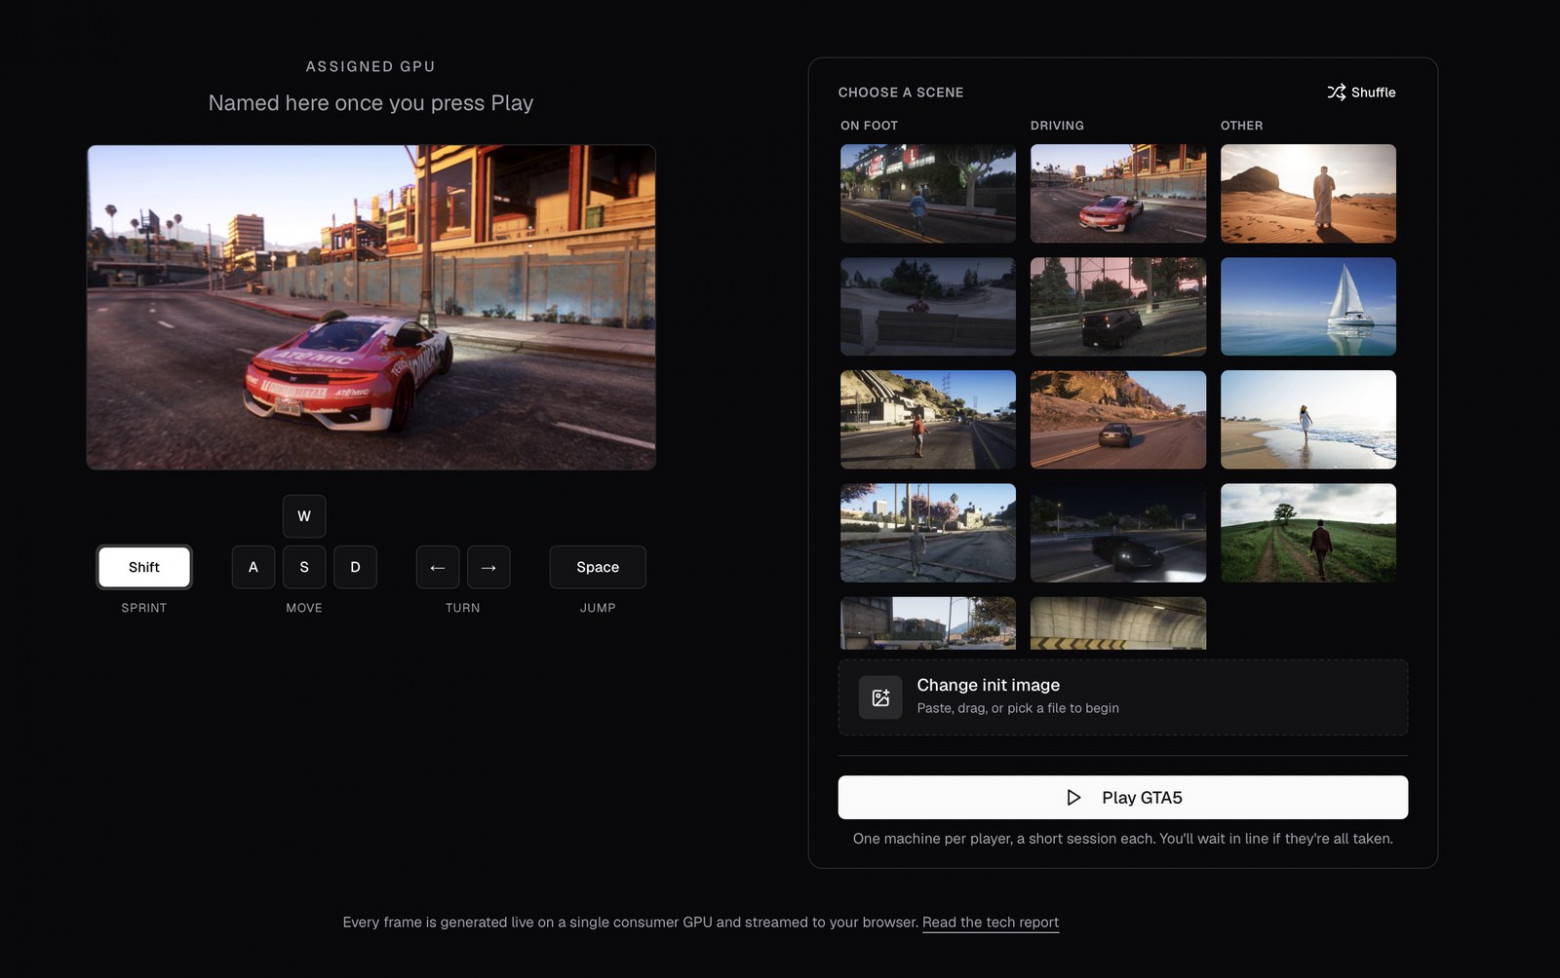
В основе проекта — трансформер Summaryformer на 630 млн параметров. Автор обучил его с нуля и опубликовал веса вместе с кодом инференса под лицензией Apache-2.0. На странице проекта также доступна ссылка на браузерную демонстрацию. Вычисления выполняются на сервере с GPU, а браузер получает видеопоток и передаёт команды управления.
Главная техническая особенность разработки — устройство памяти [1]. Summaryformer сохраняет недавние кадры подробно, а более старые — в виде компактных представлений, которые создаёт сама нейросеть. Такой подход уменьшает объём данных, к которым обращается механизм внимания [2] при генерации.
Как устроена нейросетевая версия GTA V
Для начала сессии достаточно одного изображения [3] — например, скриншота GTA V. До запуска пользователь видит исходную картинку. После нажатия Play модель начинает генерировать продолжение, реагируя на клавиши управления, в том числе WASD.
В отличие от заранее подготовленного видео, последовательность зависит от действий пользователя. Однако это исследовательская демонстрация генерации игрового мира, а не полноценное воспроизведение GTA V со всеми её механиками. К G
TA VI проект отношения не имеет, а автор отдельно отмечает, что не связан с Rockstar Games или Take-Two Interactive.
Чтобы следующий кадр продолжал предыдущий, нейросети нужна история происходящего. Именно здесь возникает основная вычислительная проблема: подробное хранение прошлого быстро увеличивает стоимость генерации.
Почему модели нужна особая память
Summaryformer работает каузально: при создании очередного кадра использует текущие входные данные и доступную историю. Предыдущие кадры представлены в KV-кэше — сохранённых ключах и значениях механизма внимания.
При разрешении 384 × 672 изображение преобразуется в латентную сетку размером 24 × 42, то есть в 1 008 токенов. Если сохранять весь рассматриваемый отрезок истории с такой детализацией, каждому новому токену приходится учитывать 26 208 ключей. Эта работа повторяется в 28 блоках трансформера на каждом проходе шумоподавления.
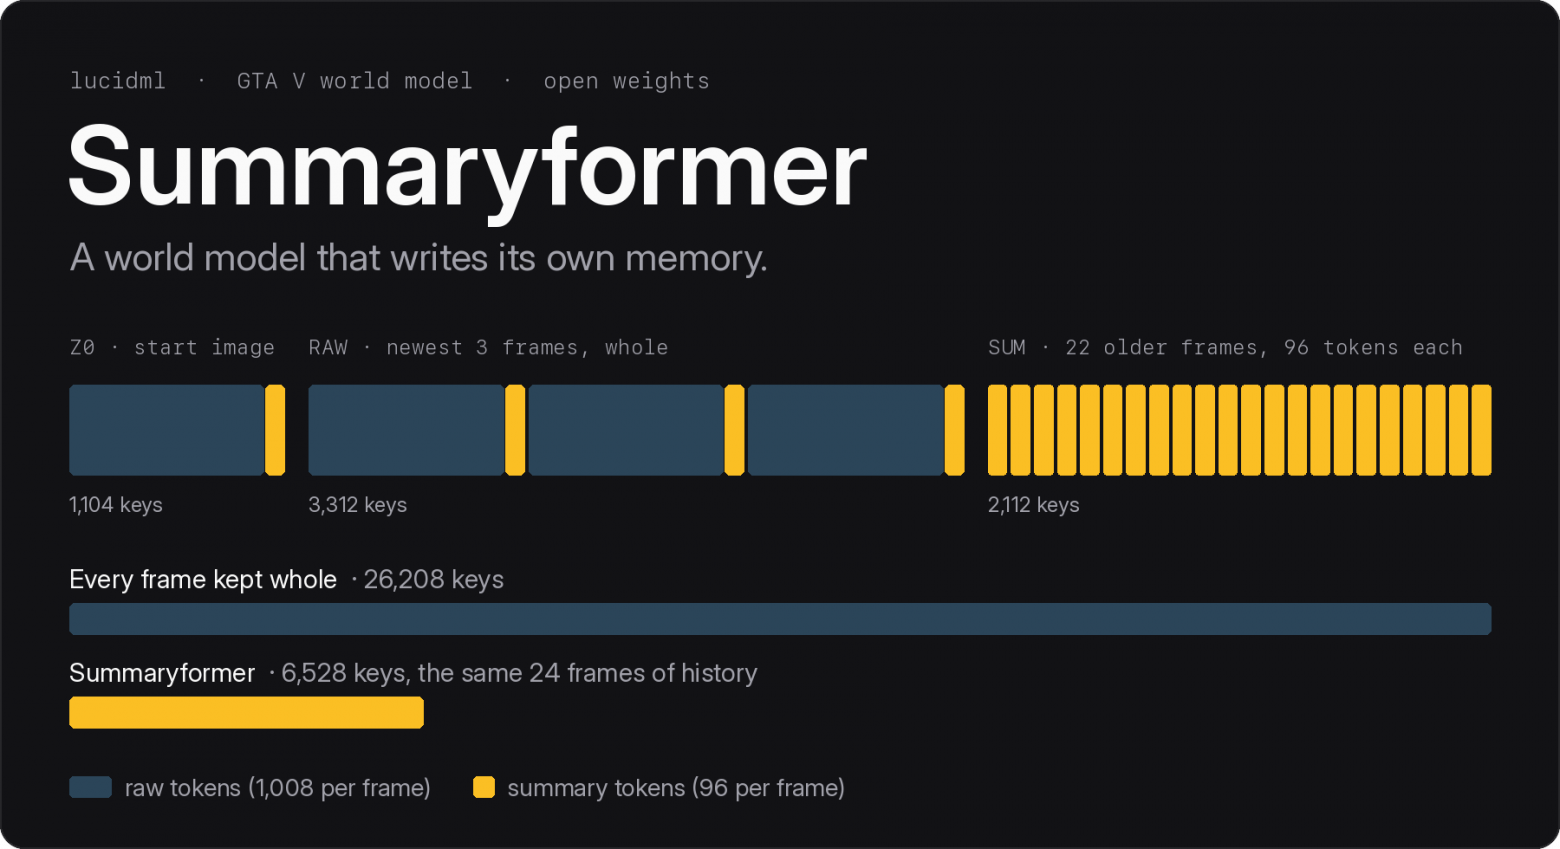
Сократить историю до нескольких кадров проще, но тогда модель быстро теряет сведения о том, что происходило раньше. Автор предложил компромисс: сохранять разную степень детализации для недавнего и более далёкого прошлого.
Последние кадры нужны для непрерывного движения и сохранения локальных деталей. От старых кадров важнее получить общее представление о сцене: какие объекты там находились и как они располагались.
Каждый кадр создаёт собственное краткое представление
В Summaryformer запись кадра состоит из двух частей:
record(t) = raw(t): 1008 токенов + sum(t): 96 токенов
Первая часть содержит подробное латентное представление изображения. Вторая — 96 обучаемых summary-токенов, предназначенных для компактного сохранения информации о кадре.
«Краткое описание» здесь не означает текстовую подпись. Это внутреннее числовое представление, которое модель учится формировать во время обучения [4].
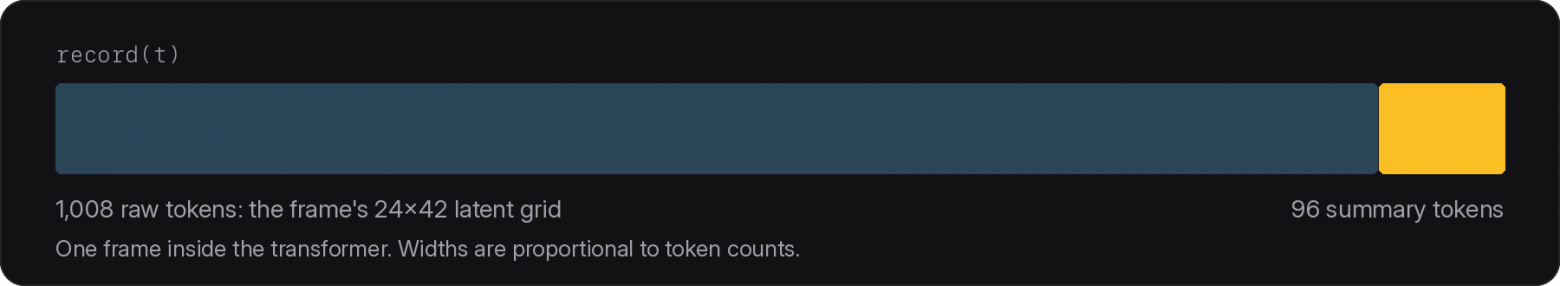
Summary-токены проходят через те же 28 блоков и в рамках того же прямого прохода, что и основные токены изображения. Отдельной сети для сжатия и дополнительного запуска генератора не требуется. Поскольку со временем от старого кадра в памяти остаётся только эта компактная часть, обучение должно побуждать модель сохранять в ней полезные сведения.
При генерации очередного кадра механизм внимания получает доступ к четырём источникам:
-
токенам текущего кадра, включая его summary-токены;
-
полным записям двух предыдущих кадров;
-
компактным представлениям более старых кадров в пределах окна памяти;
-
полной записи стартового изображения, которая не вытесняется.
Таким образом, недавняя история помогает продолжать движение, сжатая история сохраняет контекст, а исходное изображение служит постоянной опорой для сцены.
Как работает вытеснение кадров
Для каждого блока трансформера заранее выделяется единый KV-буфер с тремя областями. В первой хранится стартовое изображение. Во второй — текущий кадр и два предыдущих. Третья содержит компактные представления более старых кадров.
Когда кадр перестаёт входить в число последних, его 96 summary-токенов копируются в область сжатой истории. Подробная часть освобождает место для нового кадра. Обе области обновляются по кругу.
Механизм внимания считывает заполненную часть буфера за одну операцию. В описанном автором режиме инференса не требуется собирать историю конкатенацией или накладывать отдельную маску внимания: доступный контекст определяется самим содержимым буфера.
При окне, использованном в обучении, система хранит 6 528 ключей вместо 26 208. Это примерно четырёхкратное сокращение числа ключей для внимания, но не заявление о четырёхкратном ускорении всей модели.
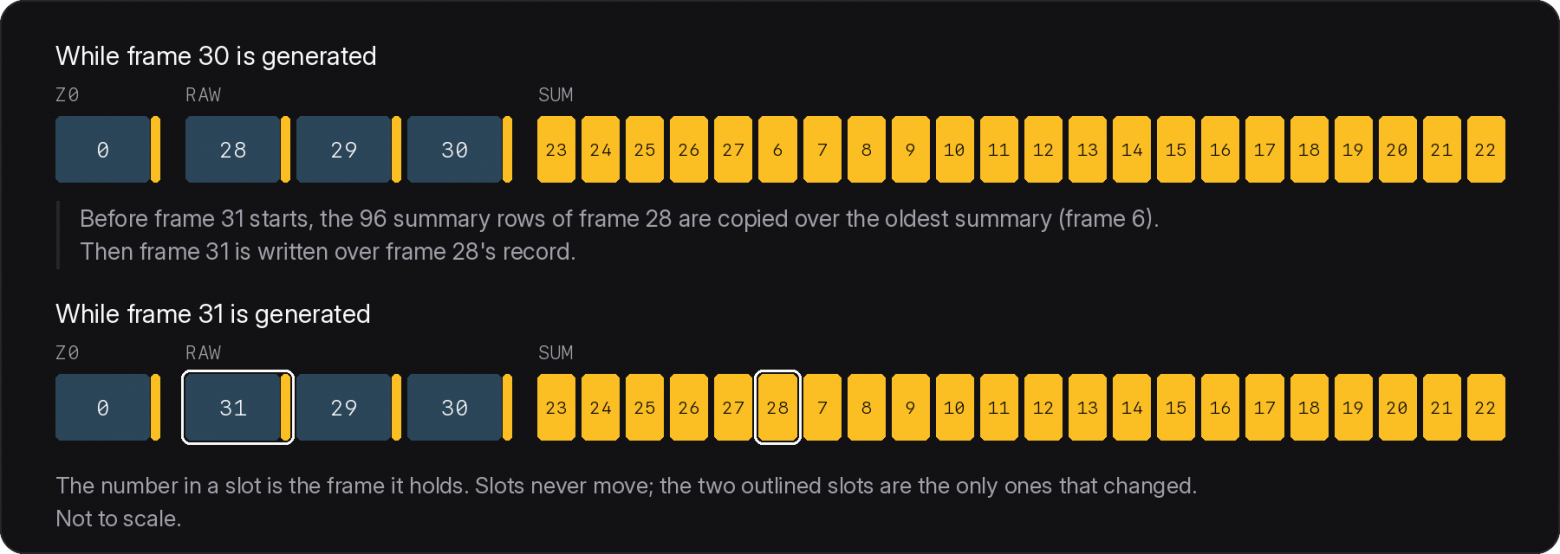
Есть и различие между обучением и демонстрацией: модель обучалась с окном из 24 латентных кадров, тогда как серверная конфигурация по умолчанию использует 16. Один последующий латентный кадр декодируется в четыре RGB-кадра, поэтому окно из 24 охватывает 96 кадров видео.
Две доработки позиционного кодирования
Чтобы подробные и сжатые представления могли сосуществовать, модель должна различать их даже при одинаковой временной позиции.
Для этого автор использовал ротационные позиционные представления RoPE. В каждой голове внимания есть 12 плоскостей, отвечающих за время. Две самые низкочастотные почти не меняются на расстояниях внутри рабочего окна. Для summary-токенов в этих плоскостях добавляется поворот на четверть оборота. Он позволяет механизму внимания по-разному учитывать подробные и сжатые токены одного кадра без отдельного эмбеддинга типа токена.
Вторая доработка касается стартового изображения. Оно остаётся в памяти всю сессию, но его временная позиция постепенно отдаляется от текущих кадров. Чтобы сохранить удобное для модели расстояние, автор периодически сдвигает позицию исходного кадра дополнительным поворотом уже сохранённых ключей RoPE. Значения в кэше при этом не меняются, а пересчитывать само изображение не нужно.
Что происходит после нажатия клавиши
Команда пользователя преобразуется в действие, представленное пятью числами. Если область подробной истории заполнена, самый старый кадр вытесняется и от него остаётся компактное представление.
Далее модель выполняет три прохода шумоподавления для нового латентного кадра. После этого проводится ещё один проход по очищенному результату, который обновляет запись в KV-кэше. Благодаря этому последующие кадры опираются на очищенные представления.
Автоэнкодер преобразует полученный латентный кадр в четыре RGB-кадра. Они кодируются в H.264 и передаются в браузер. Цикл повторяется с учётом новых действий игрока.
Текстовых запросов в этой версии нет: автор убрал перекрёстное внимание к тексту. Генерация обусловлена изображением, действиями пользователя и техническими параметрами, включая частоту кадров.
На каких данных обучали модель
По словам Сеншармы, он обучил с нуля и трансформер, и автоэнкодер. Для предобучения использовались 100 млн изображений, 4 млн видео и 200 тыс. особенно длинных видео. Затем модель обучалась на собственном датасете GG800: примерно 800 часов игрового процесса GTA V, разбитых на 100 тыс. видеозаписей с действиями игрока.
Трансформер содержит 630 205 008 параметров, 28 блоков и 20 голов внимания. Автор использовал известные компоненты и методы: KV-кэширование из подходов к авторегрессионной генерации видео, позиционное кодирование на основе Wan2.1, SwiGLU и диффузионную генерацию с v-prediction.
Новизну он связывает с сочетанием этих решений: модель сама формирует сжатую память, сохраняет её после вытеснения подробных кадров и использует единый буфер для обращения ко всей доступной истории.
Какие ограничения остаются
Сам автор подчёркивает, что проблема долговременной памяти [5] пока не решена. Из-за ограниченного бюджета обучение этой версии не довели до сходимости, поэтому неизвестно, насколько полно модель научилась использовать доступное окно контекста. В текущем состоянии она не удерживает сцену устойчиво на длинных отрезках.
Продолжительность сессий также ограничена. Таблица позиций рассчитана на 4 096 идентификаторов кадров, а сервер по умолчанию завершает сессию через 180 секунд. Для самостоятельного запуска требуется GPU с поддержкой CUDA; один процесс на видеокарте обслуживает одного игрока одновременно.
В репозитории lucidml/gta [6] доступны веса, автоэнкодер и серверный код инференса. Кода обучения и браузерного клиента в опубликованном наборе нет.
Проект показывает, как управляемая генерация видео может работать с ограниченной памятью. Следующий вопрос — сможет ли такое сжатие истории сохранять устойчивый мир при более длительной игре. У текущей версии Summaryformer убедительного ответа на него пока нет.
Автор: molniya_ai
Источник [7]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38690
URLs in this post:
[1] памяти: http://www.braintools.ru/article/4140
[2] внимания: http://www.braintools.ru/article/7595
[3] достаточно одного изображения: https://speshu.ai/?utm_source=media&utm_medium=habrcorp&utm_campaign=GTA-6-sgenerirovala-neyroset?!
[4] обучения: http://www.braintools.ru/article/5125
[5] долговременной памяти: http://www.braintools.ru/article/9500
[6] репозитории lucidml/gta: https://huggingface.co/lucidml/gta
[7] Источник: https://habr.com/ru/companies/speshu_ai/articles/1108842/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1108842
Нажмите здесь для печати.