Как обезопасить данные в системах ИИ, если вы дварф из D&D
Системы с искусственным интеллектом [1] внедряются повсеместно. Поэтому появляются специфические угрозы, направленные непосредственно на ИИ инфраструктуру и информационную безопасность систем, которые его используют. Обеспечение конфиденциальности, целостности и доступности данных становится первостепенной задачей как для программистов, так и для пользователей таких систем.
Компаниям важно безопасно интегрировать ИИ. Поэтому перед внедрением ML-моделей необходимо понимать, как обезопасить данные, на которых модель будет обучаться и с которыми в дальнейшем будет работать.
Помимо прочего ИИ атака может быть нацелена на модель, данные обучения [2] и дообучения, а также механизмы взаимодействия с ней — промпты. Это открывает дорогу новым угрозам безопасности ИИ, например:
-
Prompt injection (промпт-инъекции) — внедрение вредоносных инструкций в промпт, которые приводят к недекларированному поведению [3] LLM.
-
Jailbreaking (джейлбрейк) — обход встроенных ограничений модели и эксплуатация «серых зон» поведения [4].
В этой статье мы упоминаем не все способы для безопасной работы с информацией при обучении систем ИИ, и статья не является руководством по внедрению ИИ. Основная цель — познакомить читателя с базовыми методами обеспечения конфиденциальности, используя простой язык и шуточную аналогию с D&D для ценителей.
Безопасность данных в системах ИИ
Рассмотрим основные подходы к обеспечению конфиденциальности данных для обучения моделей и интеграции с ними.
Шифрование данных при их хранении и передаче
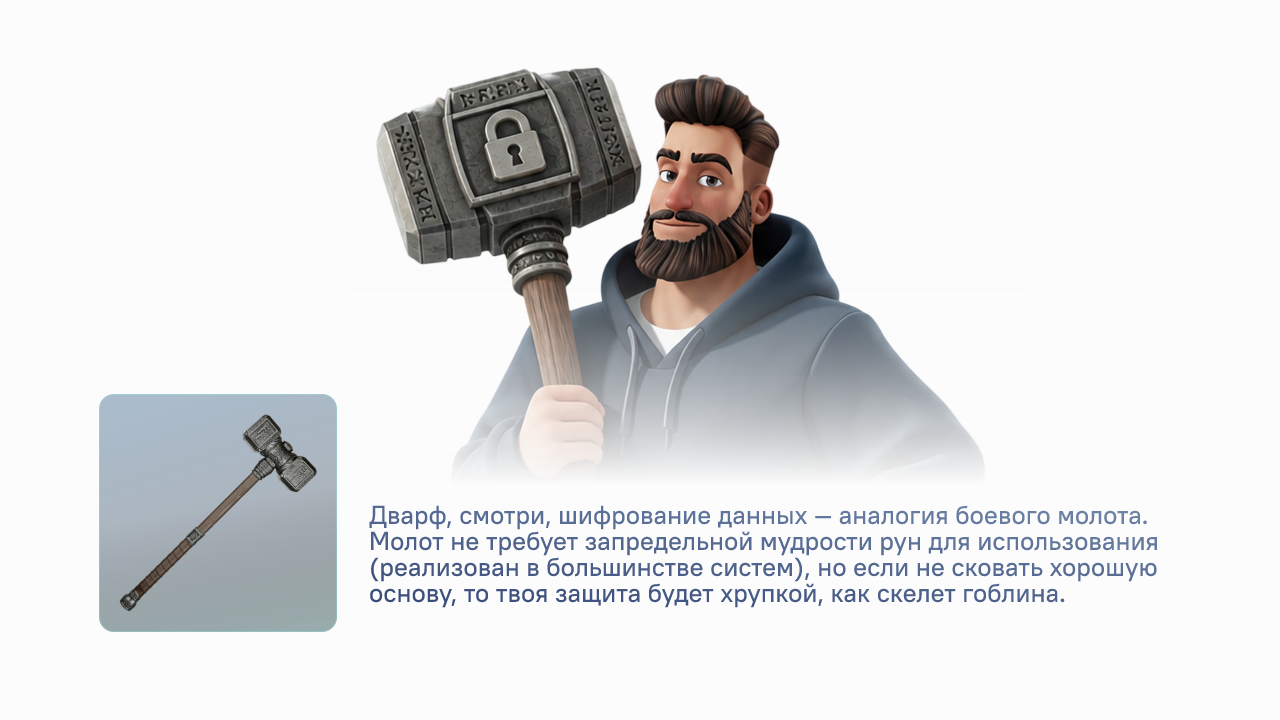
Базовый шаг — хранить наборы данных (например, базы с персональной информацией, большие данные пользователей) в зашифрованном виде. Применяются стандартные алгоритмы симметричного шифрования (AES [5], ГОСТ – «Магма», «Кузнечик») [6] для файлов или СУБД. При передаче наборов данных между узлами (например, между клиентом и сервером, или между распределёнными компонентами ML-системы) используется защита каналов связи (TLS, VPN) – это защищает данные от перехвата.
Обезличивание данных
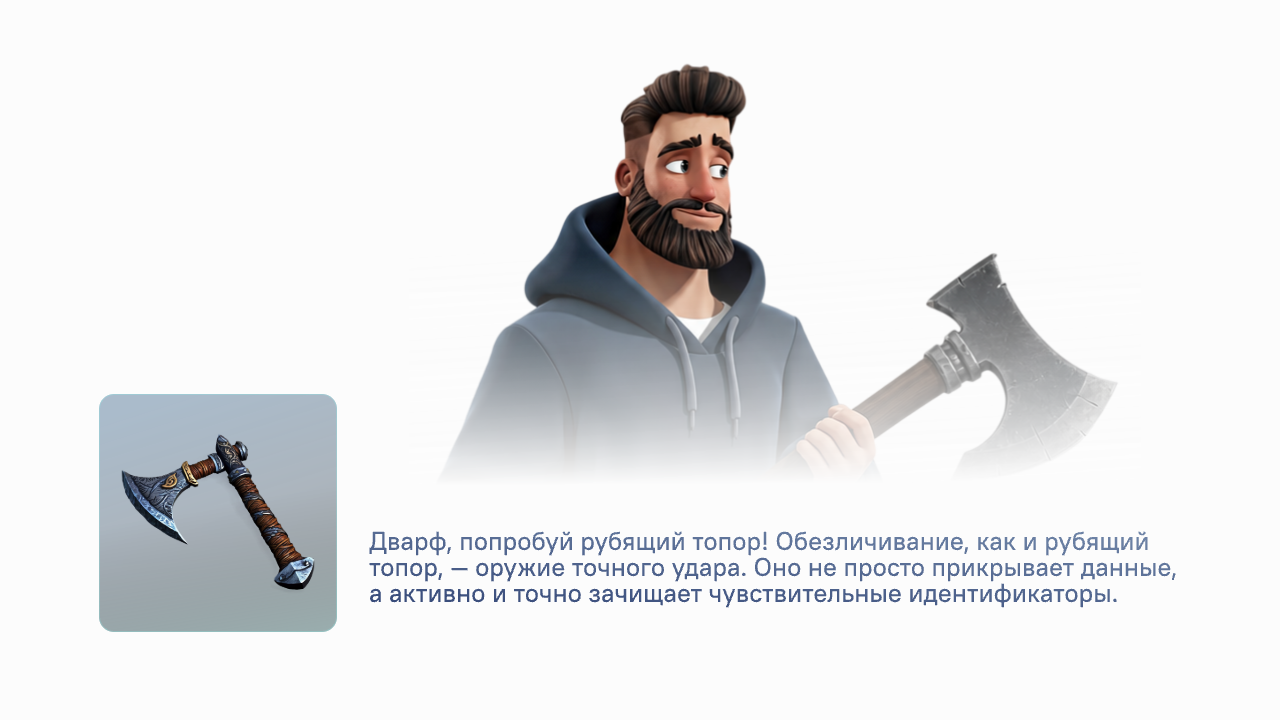
Работа с персональными данными физических лиц или с данными чувствительными к разглашению третьим лицам сопряжена с необходимостью анонимизации для снижения негативных последствий утечки таких данных. Основные подходы:
-
Удаление или маскировка идентификаторов — имён, номеров, адресов.
-
Псевдонимизация — замена реальных идентификаторов на искусственные. Например, вместо имени используется случайный ID, при этом существует отдельный словарь сопоставления, который хранится безопасно.
-
Обобщение данных — например, вместо точной даты рождения указывается год рождения или возрастной диапазон.
-
Удаление редких характеристик — признаков, по которым можно вычислить личность.
Анонимизация позволяет использовать данные в исследованиях, не раскрывая персоналий. Подход особенно полезен, когда модель работает с общекорпоративной информацией с разным уровнем доступа: обезличивание не даст сотрудникам увидеть то, к чему у них нет прав.
При псевдонимизации используют согласованную замену (связность), если нужно сохранить связи между записями. Так, один и тот же исходный идентификатор получает одинаковое обозначение во всех связанных данных. Например, одинаковая замена IP-адреса в сетевых журналах позволяет сопоставлять события одного узла и анализировать его взаимодействия с другими, не раскрывая исходный адрес. Однако с таким подходом лучше работать аккуратно: чем больше связей сохранено, тем полезнее данные для анализа — и тем больше информации остаётся у человека, который попытается восстановить исходные объекты. Похожую роль играет и криптографическая маскировка средствами хеширования. Такой подход сохраняет важные связи — соотношение разных записей одному объекту и отличие разных объектов в соответствующих записях.
При этом важно помнить о регуляторных требованиях: GDPR в Европе, HIPAA в США и 152-ФЗ в России предъявляют строгие нормы к обработке персональных данных. Например, 152 ФЗ требует обязательного обезличивания в конкретных случаях (по достижении цели обработки, для исследовательских целей, по запросу Минцифры).
Дифференциальная приватность
Позволяет публиковать агрегированные данные или обучать модель так, чтобы добавление или удаление одной записи не влияло на итоговый результат (почти). Математически [7] дифференциальная приватность добавляет контролируемый шум к результатам запросов или к градиентам при обучении, благодаря этому нельзя с высокой уверенностью восстановить исходные данные. Существует два основных подхода:
-
Добавление шума к результату работы модели. Не позволяет злоумышленнику определить, использовались ли данные конкретного экземпляра в обучении модели (Membership Inference Attacks). Например, вместо точного числа 34.2 алгоритм ДП может вернуть ответ 34.7 или 33.8, при этом влияние шума на общую статистику остаётся минимальным.
-
Встраивание шума в сам процесс обучения. Помогает защитить систему не только от Membership Inference Attacks, но и от Model Inversion Attacks — атак, направленных на извлечение исходных данных путём обратного анализа модели (например, восстановление изображения лица по предсказаниям модели). В этом подходе модель становится «слепой» к отдельным записям и учится только на общих, устойчивых закономерностях.
Федеративное обучение и гомоморфное шифрование
Когда набор данных распределён между несколькими участниками, они могут совместно обучать модель, не раскрывая друг другу свои данные. Алгоритмы, основанные на протоколах обмена зашифрованной информацией, позволяют вычислить общий результат (например, веса модели) без раскрытия исходных данных каждой стороне. Это значит, что с данными можно работать, не зная их содержимого.
В некоторых случаях применяется гомоморфное шифрование, которое позволяет выполнять вычисления над зашифрованными данными (например, искать по зашифрованной базе, не раскрывая ни запрос, ни найденное значение). Правда, у гомоморфного шифрования очень высокая вычислительная сложность, и оно требует мощного железа.
Для агрегации обновлений модели в федеративном обучении используют Secure Aggregation — протокол, при котором сервер получает только сумму обновлений, но не видит вклад каждого клиента по отдельности. Это дешевле по вычислениям, чем гомоморфное шифрование, и не снижает точность модели.
Защита целостности данных: очистка и проверка на отравление
Данные могут не только украсть, но и отравить с целью искажения результата работы модели — это называется Data Poisoning. Для профилактики таких ситуаций проводят очистку данных (data cleansing): удаляют шум и аномалии, а также проводят регулярное регрессионное тестирование и симуляцию атак, чтобы выявить уязвимости до того, как они повлияют на продуктивную среду.
Если всё-таки отравление обнаружено, быстро откатиться поможет версионирование датасетов (DVC — Data Version Control). Храните историю изменений наборов данных и контролируйте версии — это позволит восстановить «чистую» версию и продолжить работу без потерь.
Безопасность инфраструктуры
Мы рассмотрели прямые орудия для защиты данных в системах ИИ. Но они могут быть бесполезны, если сама корпоративная инфраструктура недостаточно подготовлена для этого. Если злоумышленник получит доступ к серверу обучения, даже самая продвинутая модель, обученная на идеально обезличенных данных, будет скомпрометирована.
Ниже — не менее важные принципы обеспечения базовой безопасности для внедрения ИИ.
Принцип наименьших привилегий
Сотрудникам и системам предоставляется доступ только к тем данным, которые минимально необходимы для выполнения конкретной задачи. Это снижает поверхность атаки и ущерб от потенциальной компрометации одной учётной записи.
Изоляция инфраструктуры
Обучение моделей на чувствительных данных не должно происходить в общем корпоративном кластере, где крутятся тестовые среды и почта маркетологов. Инфраструктура для обучения моделей должна быть строго изолирована — это подразумевает сегментацию сетей, выделенные кластеры, ограничение доступа извне и полный контроль над всеми компонентами.
Мониторинг инфраструктуры
Системы обнаружения вторжений (IDS) следят за сетевыми атаками, а отслеживание аномалий в потреблении ресурсов помогает выявить скрытую активность злоумышленников. Внезапная аномальная нагрузка на CPU/GPU, подозрительная активность дисков или сетевых интерфейсов могут быть признаком работы вредоносного скрипта или попытки кражи модели. Такие решения комбинируются для обеспечения защиты на всех уровнях системы.
Кроме того, стоит организовать мониторинг массовых запросов к API модели и необычных паттернов использования — это поможет вовремя заметить попытки эксплуатации или утечки данных через внешние интерфейсы.
DLP-системы и контроль запросов к ИИ
Системы защиты от утечек (DLP) позволяют отлавливать попытки передачи конфиденциальных данных в запросах к внешним ИИ-сервисам (например, к облачным LLM). Это особенно актуально при использовании B2B-решений, где данные покидают контур компании.
Физическая безопасность
Не стоит забывать [8] и о физическом уровне: серверные помещения, где хранятся обучающие данные и веса моделей, должны находиться в контролируемой зоне с ограниченным доступом, системами видеонаблюдения и контроля климата. Если злоумышленник получит физический доступ к оборудованию — все программные защиты могут оказаться бесполезны.
Обфускация кода
Отдельного внимания [9] заслуживает защита самой модели после обучения. Здесь речь идёт не о шифровании данных, а об обфускации (запутывании) кода модели и использовании методов защиты весов нейросетей. Это позволяет усложнить анализ и воспроизведение модели даже в случае компрометации инфраструктуры, но не является шифрованием в классическом смысле.
Заключение
Конечно, при внедрении ИИ могут возникнуть множество других проблем, но очень важно обратить внимание на безопасность данных, особенно если вы обучаете модель на корпоративной информации.
Выстраивайте свою оборону, как дварф выстраивает крепость: слой за слоем, инструмент за инструментом. Ни один метод не идеален, но вместе они создают неприступную башню для ваших данных.
А вы, уважаемые дварфы, какие артефакты используете для защиты своих данных в ИИ-проектах? Доверяете ли боевому молоту (шифрованию) или уже доросли до рунических доспехов (гомоморфному шифрованию)? Может, сталкивались с гоблинами, которые пытались отравить вашу руду? Делитесь в комментариях — обсудим, как мы укрепляем свои крепости!
Автор: InfotecsTech
Источник [10]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38717
URLs in this post:
[1] интеллектом: http://www.braintools.ru/article/7605
[2] обучения: http://www.braintools.ru/article/5125
[3] поведению: http://www.braintools.ru/article/9372
[4] поведения: http://www.braintools.ru/article/5593
[5] AES: https://ru.wikipedia.org/wiki/AES_(%D1%81%D1%82%D0%B0%D0%BD%D0%B4%D0%B0%D1%80%D1%82_%D1%88%D0%B8%D1%84%D1%80%D0%BE%D0%B2%D0%B0%D0%BD%D0%B8%D1%8F)
[6] ГОСТ – «Магма», «Кузнечик»): https://tc26.ru/standard/gost/GOST_R_3412-2015.pdf?ysclid=metygn607i867628580
[7] Математически: http://www.braintools.ru/article/7620
[8] забывать: http://www.braintools.ru/article/333
[9] внимания: http://www.braintools.ru/article/7595
[10] Источник: https://habr.com/ru/companies/infotecs_tech/articles/1108514/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1108514
Нажмите здесь для печати.