LLM впервые запустили на фотонном чипе: как Q.ANT и AMD скрестили оптику с GPU
Частая боль [1] при работе современных языковых моделей — механизм внимания [2] или self-attention. С ростом контекста он требует квадратично больше вычислений и раздувает KV-кэш в памяти [3] видеокарты. Чтобы обойти это ограничение, немецкая компания Q.ANT привезла на конференцию SC26 в Чикаго демонстрацию гибридного инференса: часть слоев языковой модели перенесли с видеокарты AMD на фотонный сопроцессор NPU Gen 2+, который считает дискретное преобразование Фурье светом за один проход.
Правда, в пресс-релизе [4] компания поторопилась назвать свой запуск «первым в мире». Еще в апреле 2026 года полноценную LLM с помощью оптики запустил британский стартап Lumai на своем сервером Iris. Если Q.ANT использует плоские кремниевые волноводы, то британцы сделали акцент на трехмерную оптику — линзы и пучки света в свободном пространстве. На такой архитектуре они запустили модели уровня Llama 70B в реальном времени, экономя 90% энергии. Давайте разберемся, что за этим стоит.
Что именно поменяли в нейросети и о чем умолчали
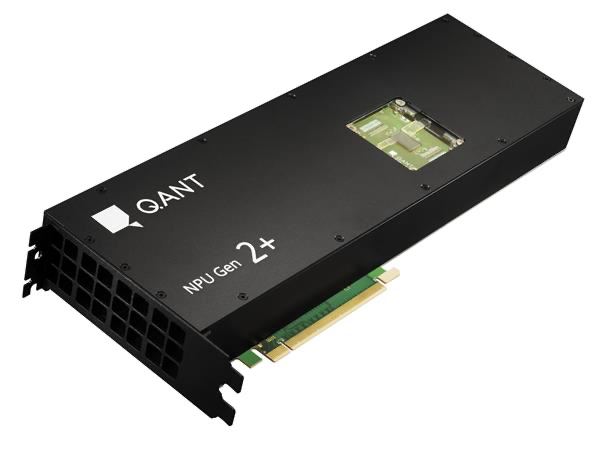
В техническом отчете Q.ANT и AMD говорят, что в эксперименте работала языковая модель объемом около 1 млрд параметров на ускорителе AMD Instinct MI210 в паре с фотонным чипом. Вице-президент Q.ANT по программному обеспечению Ютц Бахер называет подход «Фурье-слоями внимания в языковых моделях» и ранним прототипом. По задумке, замена self-attention на оптическое преобразование Фурье ускоряет инференс и позволяет сильно сжать KV-кэш.
Хотя ключевые метрики самой модели в анонсе остались за кадром:
-
Архитектура и разбиение графа. Конкретная модель не названа. Неясно, как именно решается проблема каузального маскирования (запрета для модели «подглядывать» в будущие слова при пошаговой генерации текста) и какие именно слои остались на GPU.
-
Качество генерации. Компания не привела ни перплексию, ни результаты на стандартных LLM-бенчмарках. Ждем тестов на Artificial Analysis.
-
Скорость и выигрыш по памяти. Реальный прирост токенов в секунду и итоговое сжатие KV-кэша в демонстрации не раскрыты, а снижение энергозатрат описано лишь как «потенциально значительное».
Как Q.ANT шла к языковым моделям
До этого компания обкатывала фотонные вычисления на куда более компактных нейросетях. В июне 2026 года на конференции ISC в Гамбурге Q.ANT показывала на чипе прошлого поколения генерацию изображений через диффузионную модель на 59 млн параметров и работу архитектуры TiRex на базе xLSTM. Тогда разработчики заявляли о 30-кратной энергоэффективности на уровне самой оптической схемы, но это тоже были расчетные цифры.
Ноябрьский запуск — это первая попытка перенести подход на полноценную языковую модель масштаба 1B. Причем фотонному ускорителю отдали только математику [5] преобразования Фурье, оставив все остальные слои трансформера классической видеокарте AMD.
Когда это можно будет протестировать в своих пайплайнах
Серийные системы с поддержкой таких вычислений Q.ANT планирует вывести на рынок во второй половине 2027 года. Покрутить саму идею в коде можно уже сейчас: в сентябре 2026-го компания выложила открытый SDK с API на C и Python и эмуляцией на CPU, который сейчас обновляют под Фурье-слои Gen 2+.
Доступ к ускорителям предыдущего поколения открыли 9 ноября — в виде закрытой беты на выделенных серверах IONOS в Германии. Еще раньше чипы уехали в немецкие суперкомпьютерные центры LRZ и JSC, но публичных независимых отчетов оттуда до сих пор нет.
Что станет с качеством
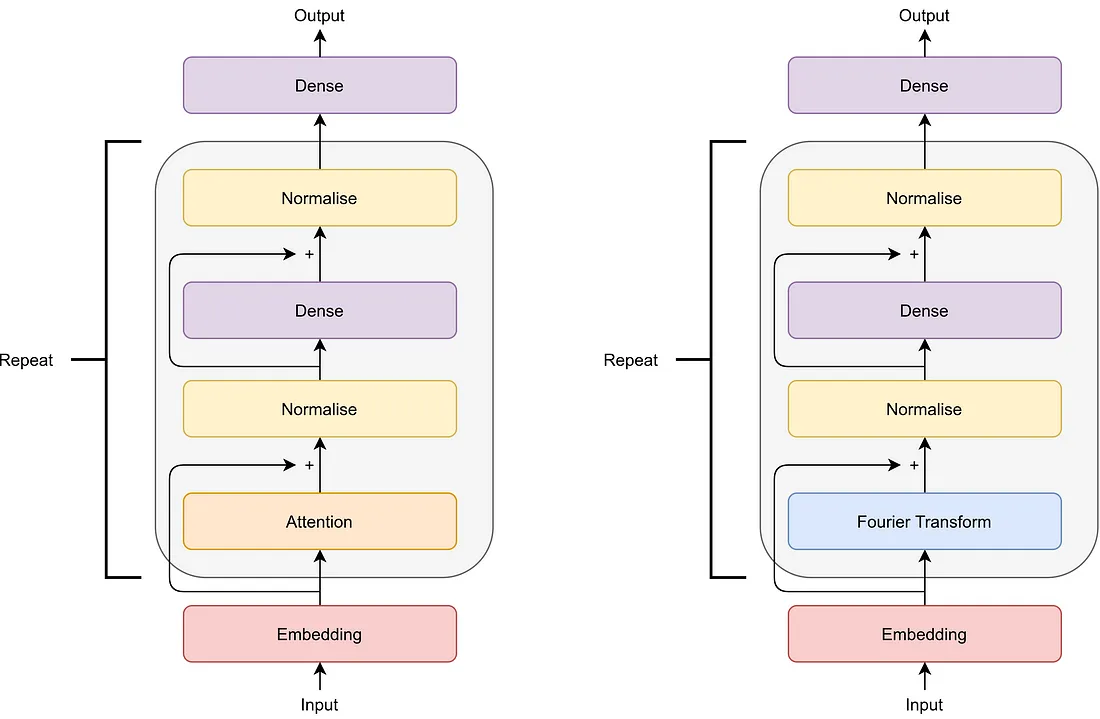
Заменить механизм внимания слоем Фурье придумали еще до фотоники — в 2021 году это сделала Google в архитектуре FNet. Подход ускорял обучение [7] на 70–80%, но резал качество: FNet сохраняла 92–97% точности BERT на тесте GLUE, да и была энкодером, а не авторегрессионной генеративной моделью.
Перенос этой математики на свет упирается в ту же архитектурную проблему, только теперь к ней добавляются накладные расходы на конвертацию тензоров из цифры в свет и обратно на каждом слое, а также их пересылку между GPU и сопроцессором.
Жизнеспособность гибрида покажут только две цифры: перплексия в сравнении с такой же 1B-моделью на классическом внимании и честный прирост токенов в секунду на реальном инференсе. Без бенчмарков говорить о замене attention рано.
Остается только гадать, что окажется сложнее: довести оптическое железо до серии или убедить разработчиков переписать под него свои модели. Делитесь мнением в комментариях.
Token Factory: инференс открытых ИИ‑моделей на серверах в РФ
Подключайте GLM, DeepSeek, Qwen и Kimi через OpenAI‑совместимый API и платите в рублях только за используемые токены.
Подробнее → [8]
Автор: NastolniyShar
Источник [9]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/38759
URLs in this post:
[1] боль: http://www.braintools.ru/article/9901
[2] внимания: http://www.braintools.ru/article/7595
[3] памяти: http://www.braintools.ru/article/4140
[4] в пресс-релизе: https://www.globenewswire.com/news-release/2026/11/17/3404482/0/en/q-ant-unveils-npu-gen-2-photonic-fourier-transforms-power-large-language-model.html
[5] математику: http://www.braintools.ru/article/7620
[6] Источник: https://optalysys.com/resource/attention-fourier-transforms/
[7] обучение: http://www.braintools.ru/article/5125
[8] Подробнее → : https://selectel.ru/services/cloud/token-factory/?utm_source=habr.com&utm_medium=referral&utm_campaign=tokenfactory_news_ai-qant_081126_banner_ord
[9] Источник: https://habr.com/ru/companies/selectel/articles/1109180/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1109180
Нажмите здесь для печати.