Как утки с СДВГ довели меня до опенсорса: зачем я собрал утилиту для перевода коротких видео на домашней видеокарте
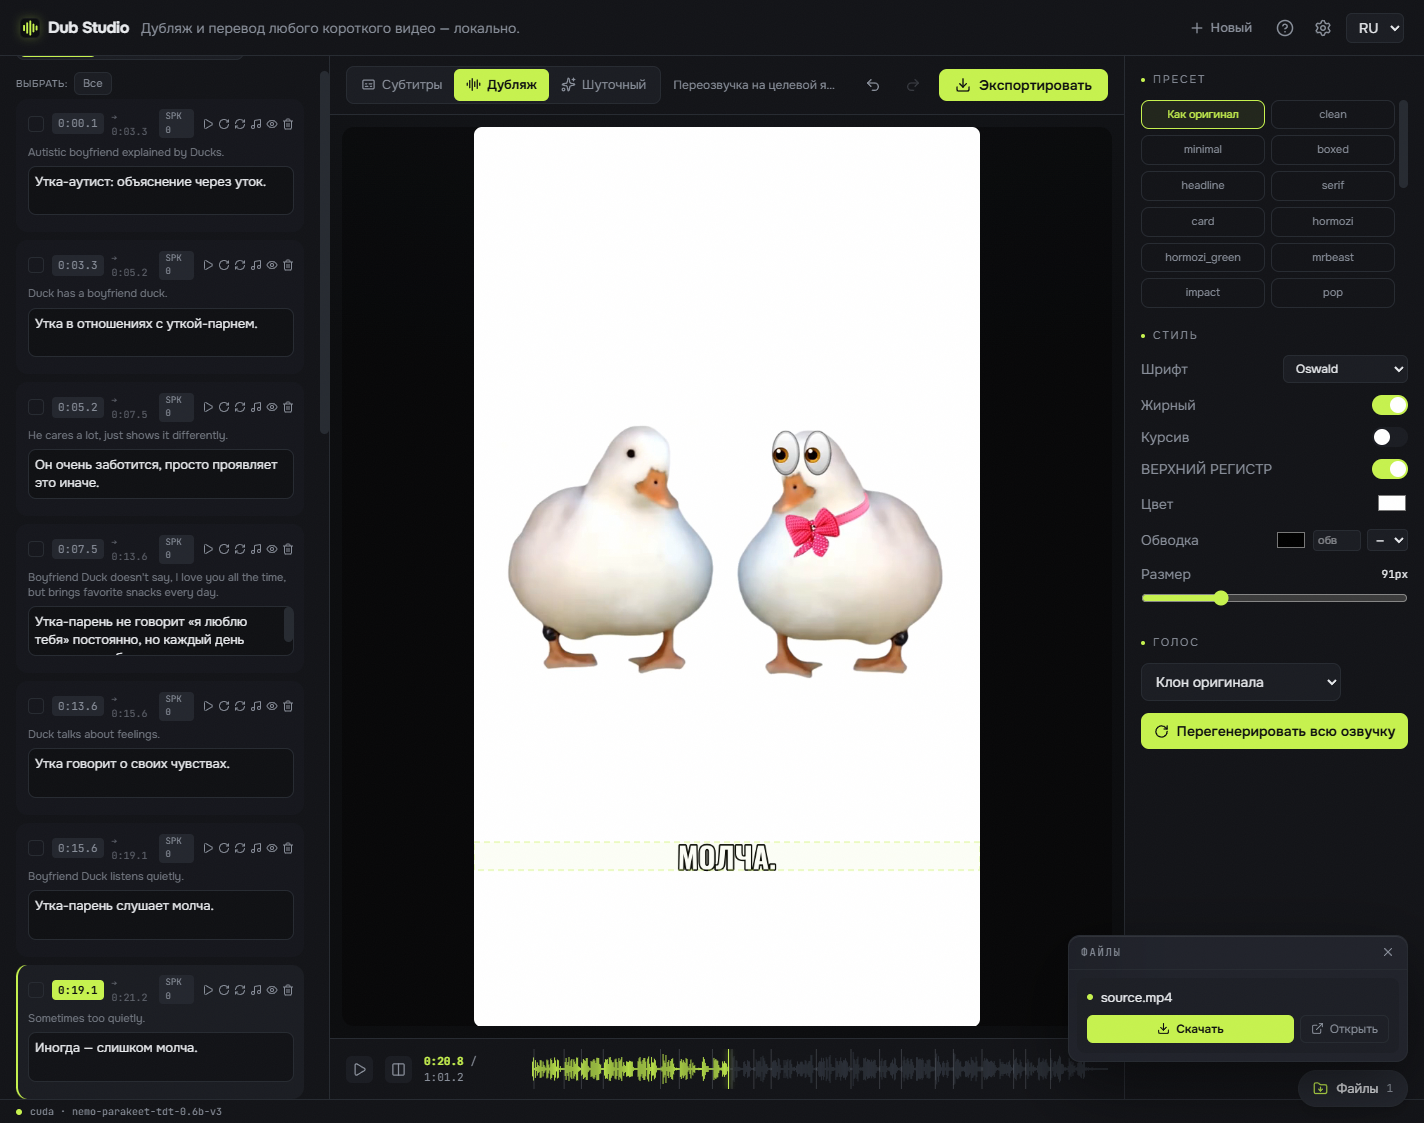
Всем привет! Листал ленту тиктока и попался американский ролик про СДВГ, где всё объясняют на утках. Понравилось. И я подумал: классно было бы сделать такой же канал, только на русском.
Но я ленивый. Снимать, писать сценарии, делать всё с нуля – это скучно. А вот взять готовый ролик и перевести-переозвучить его на русский – вот это уже интересно, подумал я, а потом задумался, о том, как это автоматизировать. Это оказалось интересной инженерной задачей, которая увлекла меня на неделю времени, и привела к созданию ИИ утилиты с открытым исходным кодом. А тикток с утками я так и не создал…
Меня зовут Илья, я блогер, основатель сервиса для генерации ArtGeneration.me и просто фанат нейросетей. Я не разработчик в классическом смысле – скорее продакт с двадцатилетним стажем, который вайбкодит с нейросетями всё, что давно хотелось воплотить в жизнь.
Портативок [1]я насобирал уже кучу, потому что для меня это самый быстрый способ протестировать технологию. Отдельно под озвучку, отдельно под распознавание речи. Но чтобы собрать всё это в один инструмент, где работает сразу из коробки – такого ещё не было. Заодно захотелось наконец слезть с Gradio, на котором я обычно делаю свои портативки.
Так появился Dub Studio [2] – утилита, которая локально переводит и переозвучивает короткие ролики. Офлайн, бесплатно, без подписок и без цензуры. А та самая утка стала главным тестовым роликом проекта.
Дальше расскажу, как всё это собиралось и покажу примеры сделанные в этой же утилите.
❯ Почему шесть нейросетей, а не одна
Сначала я хотел обойтись одной моделью. Омнимодальной. Чтобы один мозг [3] сразу и слушал звук, и смотрел картинку, и читал-переводил надписи на экране. Один файл, один прогон, никакой возни со склейкой.
Но была рамка. Дома у меня RTX 4090 на 24 гига, в неё влезает многое. А вот у большинства моих подписчиков 12 гигов и меньше. Пихать в инструмент жирные модели, которые у них просто не запустятся, мне не хотелось. Так что планку я поставил сразу под аудиторию: всё должно жить в 12 гигах VRAM. Иначе смысла нет.
Поресёрчил омни-модели. Вывод вышел неприятный: ни одна модель, которая влезает в 12 гигов, не умеет нормально размечать речь по времени и по говорящим за один проход. Это не я поленился покопаться, это просто потолок таких моделей, даже лучших. Кто где говорит и в какую секунду – они на этом плывут.
Реальный кандидат был один, MiniCPM-o, он по размеру проходил. Но до его тестов я даже не дошёл. Ещё на ресёрче стало понятно, что омни в принципе не вывозит аудио-тайминг, и запускать её смысла уже не было.
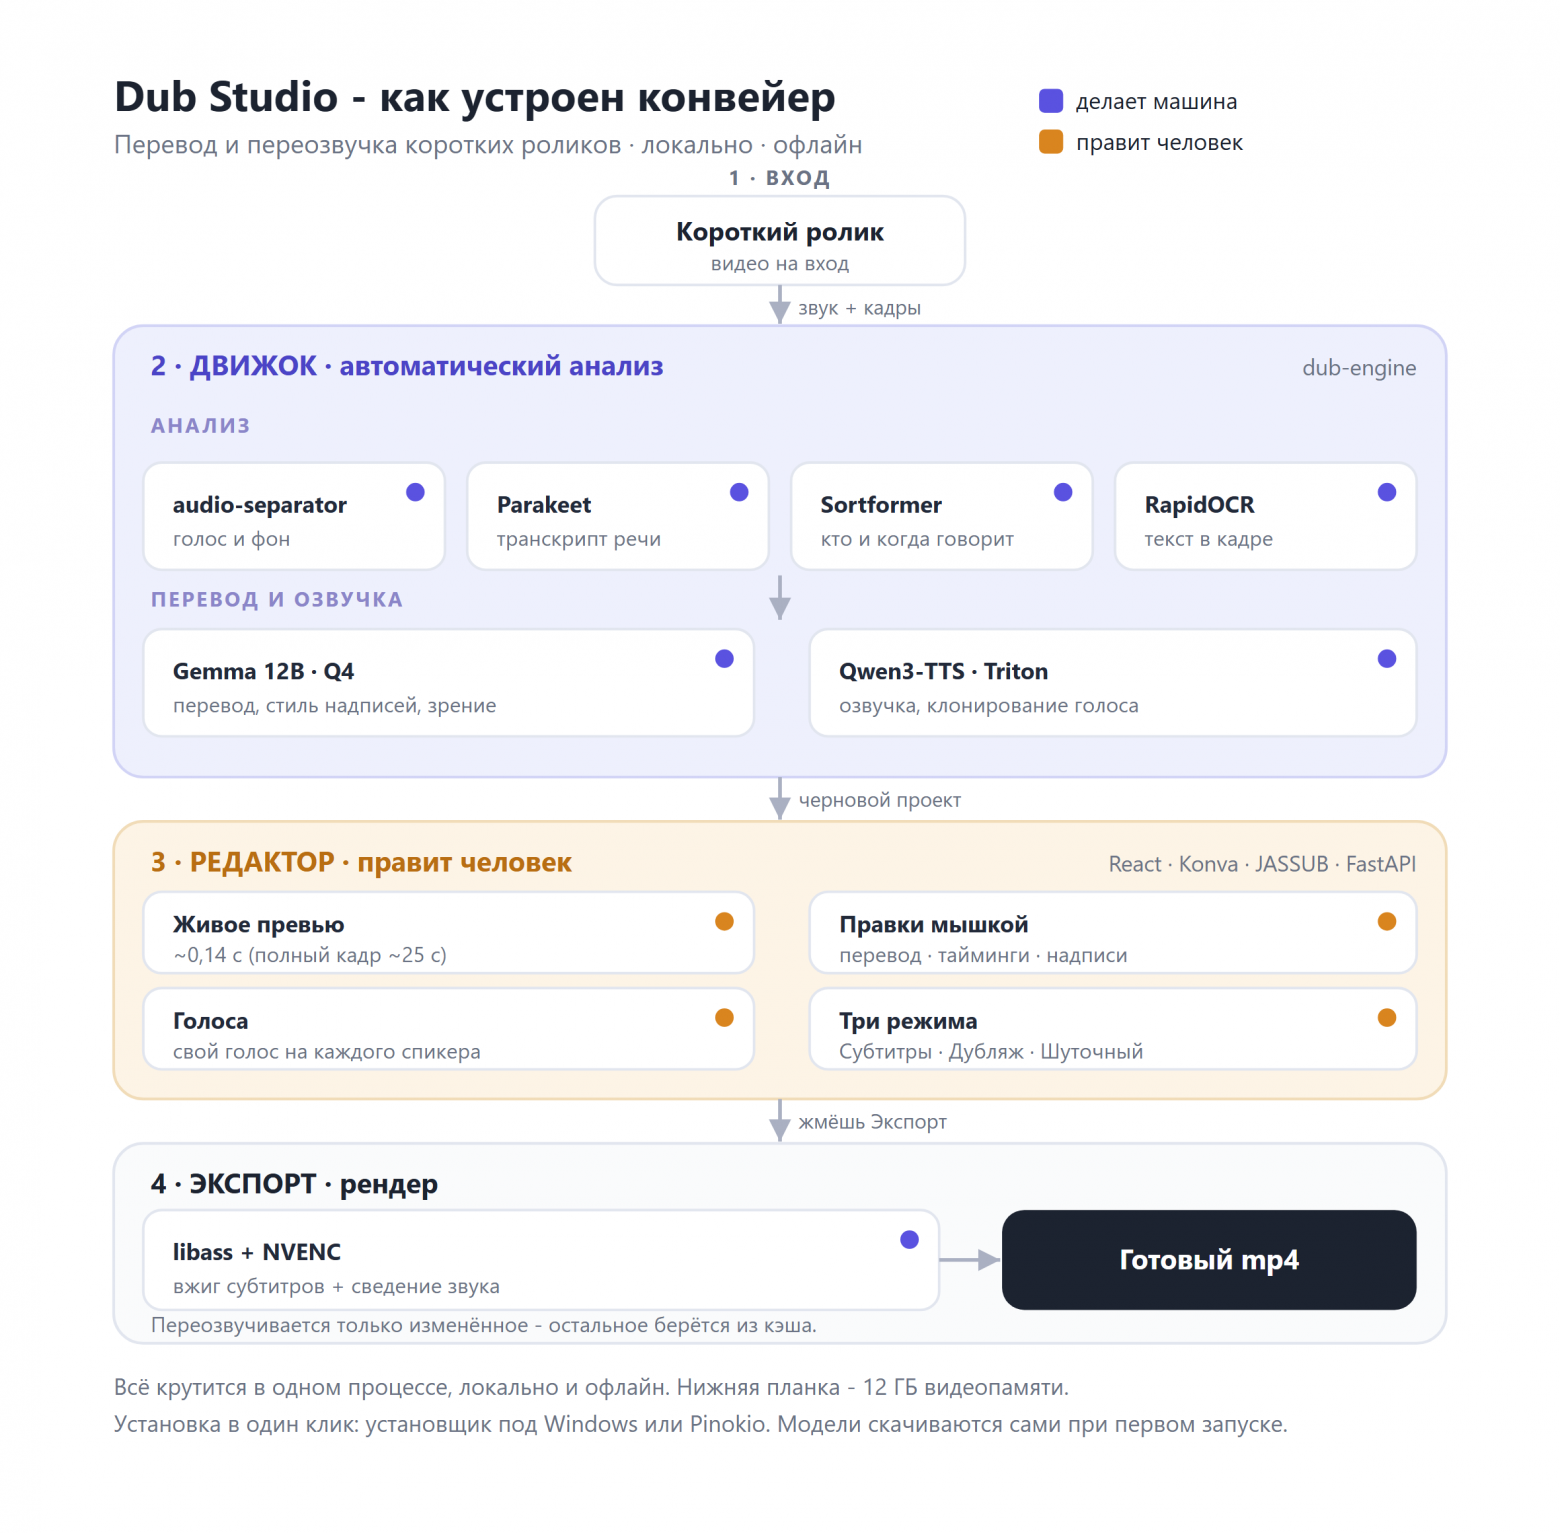
Поэтому в итоге не одна модель, а гибрид из шести специализированных. Каждая делает свой кусок и делает его хорошо:
-
распознавание речи берёт на себя Parakeet [4];
-
кто и когда говорит размечает Sortformer [5];
-
голос от музыки отделяет audio-separator [6] (UVR);
-
надписи на кадре читает и переводит квантованная Gemma [7];
-
озвучивает и клонирует голос Qwen3-TTS [8];
-
экранный текст вытаскивает RapidOCR [9], а вжигает субтитры libass [10].
Да, шесть штук вместо одной звучит как перебор. Но каждая тут весит немного, все вместе укладываются в бюджет по памяти [11], и на своём участке работают лучше, чем одна большая модель на всём сразу.
❯ TTS: лучший из худших
Озвучка – это сердце дубляжа. Поэтому к выбору движка я подошёл серьёзнее всего.
TTS, который мне нужен, должен уметь клонировать голос. Не просто прочитать текст роботом, а звучать похоже на оригинал, в моём случае ещё и по-русски. Таких движков несколько, и я прогнал большое исследование: погонял кандидатов по метрикам.
Вывод [12]вышел невесёлый. Идеального движка нет. Вообще. У каждого свой набор косяков.
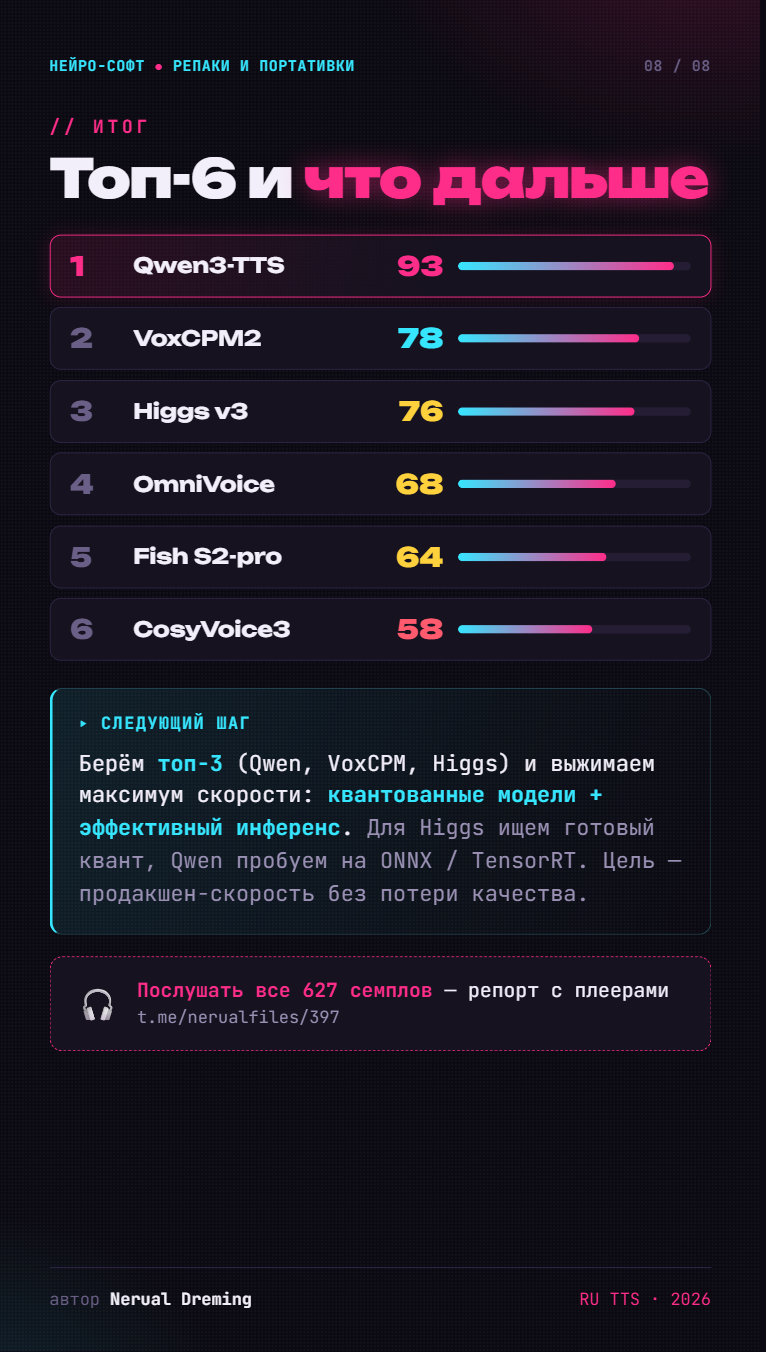
Победил Qwen3-TTS [13], в сборке на Triton. Победил не потому, что не косячит. Косячит. Хуже всего у него с ударениями: периодически ставит их не туда, и тогда слово звучит не по-русски. Но из всех вариантов это самый адекватный компромисс. Он быстрый, лёгкий и работает быстрее реалтайма. Лучший из худших, если совсем честно.
И вот тут я хочу сказать вещь, которая тянется через весь проект. Он целиком собран на компромиссах. Gemma у меня квантованная, не полная. Сам процесс полу-автоматический, а не нажал кнопку и пошёл пить кофе. Везде, где можно было выбрать между идеально и просто работает, я выбирал второе. Иначе инструмента просто не было бы.
Выбор TTS, да, спорный. Я знаю, что многие со мной не согласятся. И это не просто так. Но про это позже.
❯ Прощай, Gradio
Сначала я хотел сделать совсем просто. Лёгкий CLI, полностью автоматический. Кидаешь ролик, получаешь готовый дубляж. Без рук, без редактора, без меня.
Не вышло. У каждого ролика своя верстка: надписи лезут не туда, разметка везде разная. Модели ошибаются. Универсального кинул и готово не существует. Чем дольше я это ковырял, тем понятнее становилось, что полностью без человека тут не выехать.
Так я пришёл к полу-автоматике. Движок берёт на себя тяжёлую часть: анализирует ролик, раскладывает умные дефолты. А человек правит остальное. Но правит не вслепую, а с живым превью, где сразу видно что получится.
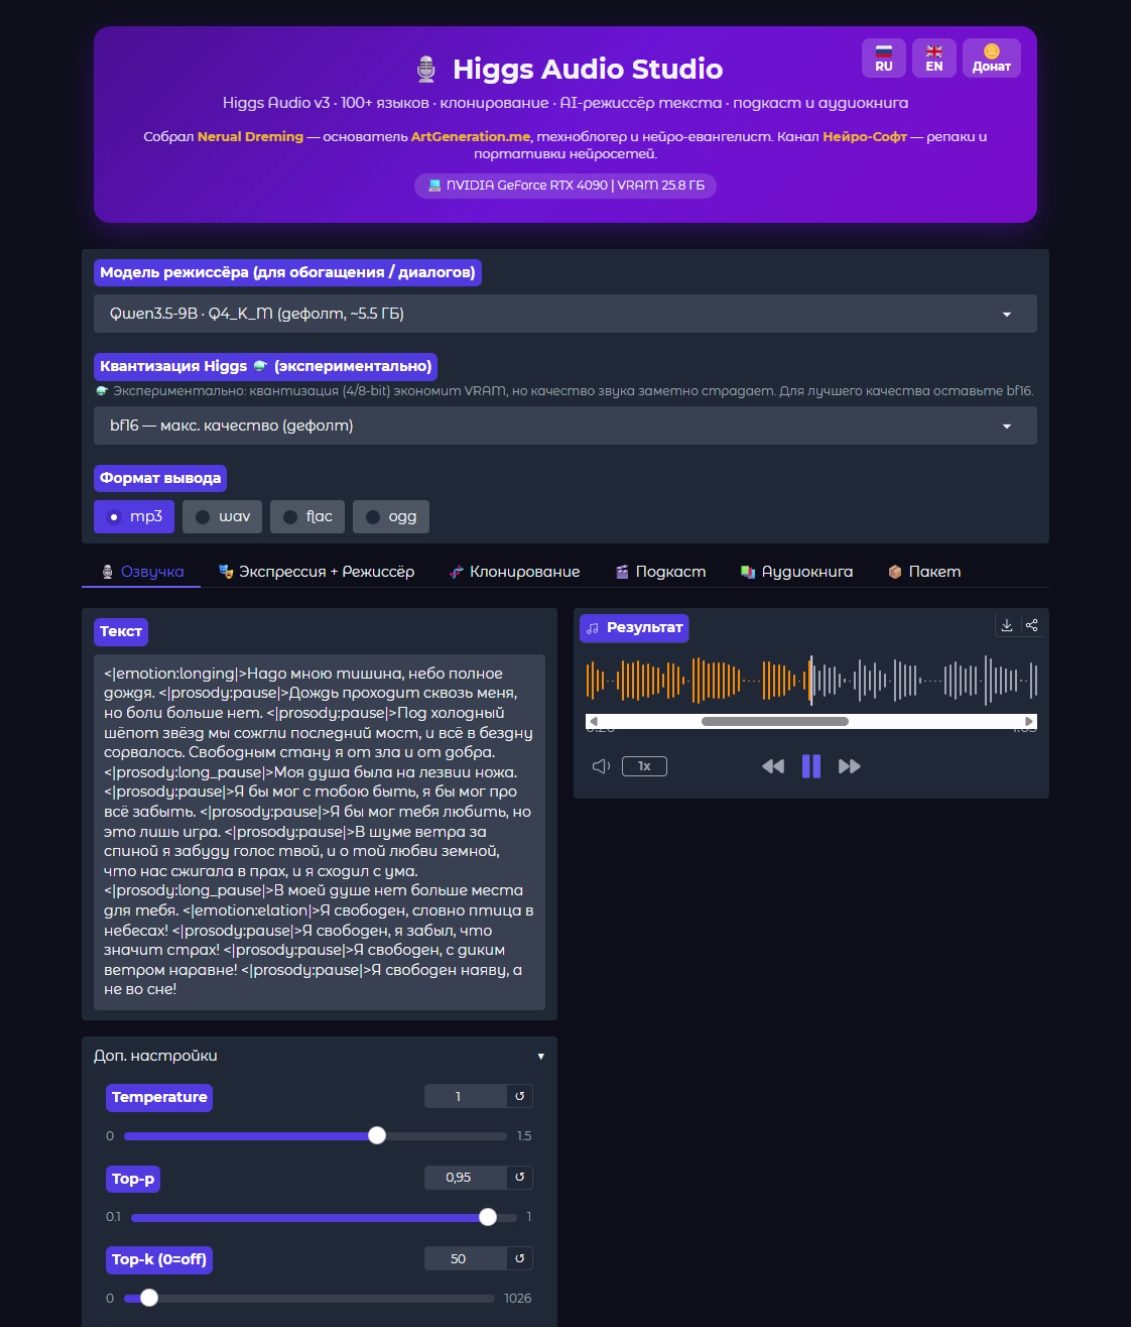
Тут стоит пояснить, что вообще такое Gradio [14] – вдруг кто не сталкивался. Это питоновская библиотека для быстрых интерфейсов к нейросетям: парой строк кода оборачиваешь модель в простенькую веб-морду – поле ввода, кнопка, окошко с результатом, и всё, модель можно тыкать в браузере, а не гонять из консоли. Бутстрап для нейронок.
Принадлежит он Hugging Face [15] – по сути это гитхаб для нейросетей, главный репозиторий ИИ-моделей. Поэтому с моделями оттуда Gradio дружит бесшовно: взял с хаба, обернул, выложил – всё заводится из коробки. Идеальная штука, чтобы по-быстрому собрать MVP, на нём собраны почти все мои портативки.
И вот тут стало ясно, что Gradio мне больше не помощник. Для демки он отличный. Но нормальный редактор на нём не собрать. Gradio – это один столбик, пара полей и готовых элементов и кнопка. А мне нужен холст, превью, субтитры поверх видео, перетаскивание.
Поэтому я взял нормальный фронт. React + Konva [16] для холста, на нём всё рисуется и двигается. Субтитры кладутся сверху через JASSUB [17], прямо поверх видео. Бэкенд на FastAPI [18]. А голый CLI к тому же грузил весь стек заново на каждый ролик, что радости тоже не добавляло.
❯ Редактор
Теперь как это работает в деле. Кидаешь ролик, движок прогоняет анализ и раскладывает умные дефолты: транскрипт, кто где говорит, какие надписи нашёл в кадре, готовый план субтитров. Дальше начинается пользовательская часть.
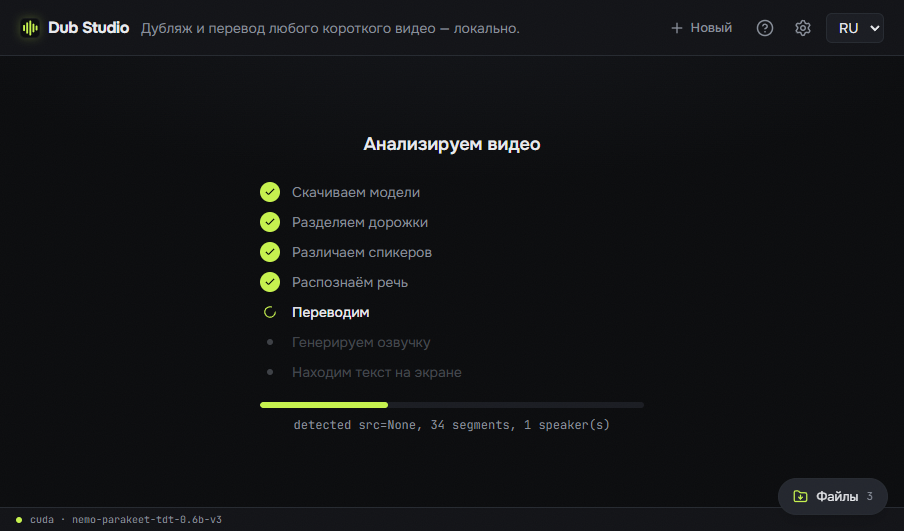
Дольше всего я бился над превью. Оно и сейчас по сути покадровое слайд шоу с аудио дорожкой, это так и задумано. Но поначалу оно тормозило так, что работать было невозможно. Полный рендер одного кадра шел около 25 секунд. Двадцать пять. Сидеть и ждать столько после каждого чиха в редакторе невозможно. Пришлось делать отдельный быстрый предпросмотр, тоже один кадр, но уже около 0.14 секунды. Вот после этого редактор и ожил.
Каждый ролик можно гонять в одном из трёх режимов: Субтитры, Дубляж или Шуточный. Первые два понятны. С Шуточным интереснее: говоришь Gemma тему, она переписывает скрипт под неё, и кусок переозвучивается заново уже с новым текстом, мем сделанный в этом режиме ждет вас в конце статьи.
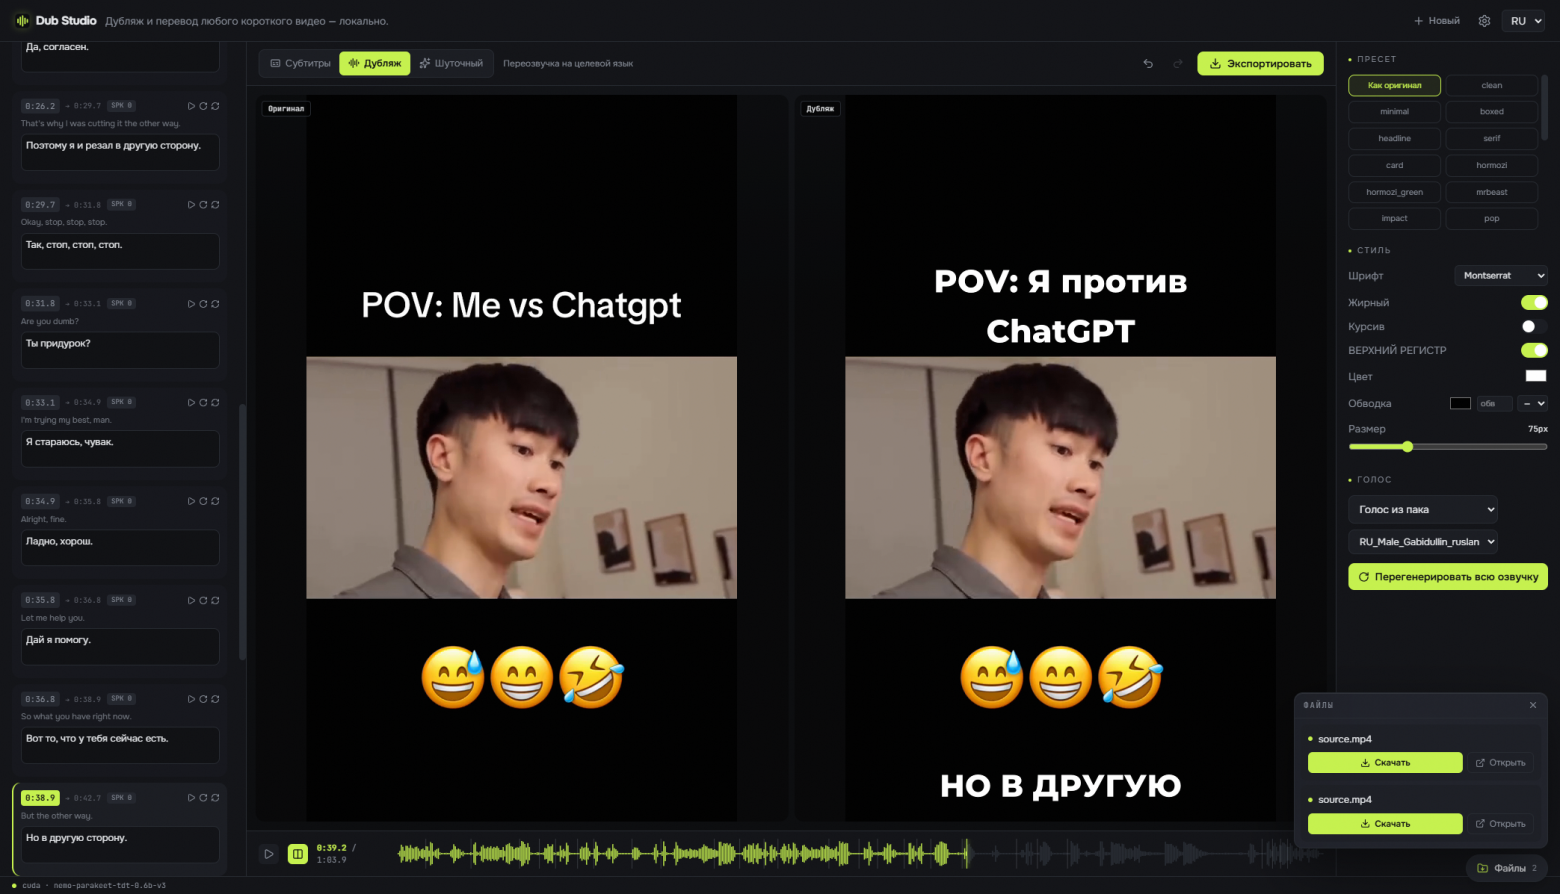
Голоса вешаются на каждого говорящего по отдельности. Один спикер – один голос из пака, другой – другой. Голосов в паке много и никто не мешает добавлять еще просто закидывая файлы в папку.
С субтитрами тоже всё руками. Не нравится, где стоит полоса – берёшь её мышкой и таскаешь прямо по кадру, куда надо.
Теперь переведённые надписи в самом видео. Хочется, чтобы они смотрелись как родные. Поэтому оригинал я не блюрю. Блюр мылит картинку и сразу выдаёт, что тут что-то подменили. Вместо этого оригинальная надпись кроется непрозрачной плашкой под цвет сцены. Где её положить, подсказывает OCR, а как оформить текст поверх, подсматривает зрение [19] Gemma. Получается аккуратно.
И ещё про громкость. Реплики приходят разные по уровню. Поэтому все фразы приводятся к одному уровню.
❯ Честно про вайбкодинг
Раз уж пошёл такой разговор, расскажу честно про обратную сторону.
Этот проект тоже собран в паре с ИИ-агентом. Штука мощная, но есть одна боль [20], которая выматывала сильнее всего. Агент уверенно пишет тебе “готово, баг исправлен”. А на деле ничего не исправлено. И ловишь ты это только сам, глазами.
Простой пример. Поправили субтитр в превью, всё хорошо. Запускаешь экспорт – а там та же самая ошибка [21] на месте. Агент починил один путь и честно отчитался за оба.
Но больнее всего была не сама модельная часть. Больнее всего оказалась упаковка в один клик, через Pinokio [22]. Агент взял обязательную зависимость и пометил её как необязательную. Вроде мелочь. А без неё весь дубляж просто падал. И отдельная радость – полдня ушло на одну ошибку с ffmpeg. Просто полдня на одну ошибку, подробности опущу.
Вывод для меня простой. Верить агенту на слово нельзя. Совсем. Поэтому всё, что он делает, проверяешь сам. Каждый раз.
❯ Стек и как это работает
Если убрать всю кухню, алгоритм простой.
Кидаешь видео в окно. Дальше движок сам прогоняет весь конвейер: снимает транскрипт, режет на сегменты по спикерам, вытаскивает надписи с экрана, собирает план субтитров с разумными дефолтами. На выходе готовый проект, который можно открыть и крутить.
Дальше правишь руками. Меняешь перевод, двигаешь тайминги, перебираешь надписи – и всё это с живым превью, видно сразу. Когда всё нравится, жмёшь экспорт. Тут важный момент: переозвучивается только то, что ты трогал. Остальное берётся из кэша, заново гонять весь ролик не нужно. На выходе готовый mp4.
❯ Это бета, и ей нужны вы
Я доволен тем, что получилось. Сам этим пользуюсь, и это уже не игрушка. Но давайте честно: это бета. Работы ещё хватает.
Поэтому про ограничения прямо. Заточено всё в основном под короткие ролики. Выбор TTS спорный, и я это прекрасно понимаю – многие со мной не согласятся по поводу того, какой голос лучше. Языков можно тащить больше, чем сейчас доступно. Технически и ттс и ллм их поддерживает больше, но каждый язык надо тестить руками, а это время.
В планах сделать все модули сменными. Раз уж столько споров вокруг TTS, логичный ход – дать каждому собрать пайплайн под себя. Не нравится распознавалка – воткни свою. Не нравится речь – поставь другой. Хочется, чтобы это был конструктор, а не приговор.
Кстати, стек так удачно лёг, что я потащил его и в другие свои проекты, например в днд игру где нейросеть выступает гейм-мастером. Но это уже отдельная история, под новую статью, так что как-нибудь в другой раз.
Теперь самое важное. Репозиторий открыт, лицензия MIT, код тут [2] – берите и делайте. Форкайте, шлите PR и заводите issue. Если что-то сломалось или работает не так – расскажите. А ещё лучше – прогоните свой ролик и киньте результат в комменты, очень интересно посмотреть, что у вас выйдет. И если проект вам зашёл, поставьте звезду на гитхабе, мне будет приятно, а ему полезно.
Найти меня можно в YouTube [23], в Телеграме [24]и на Бусти [25]. Залетайте, там тоже интересно, каждую пятницу смотрим новинки нейросетей и генерируем вместе. Всех обнял и удачных дубляжей.
Автор: timonin
Источник [26]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/32210
URLs in this post:
[1] Портативок : https://habr.com/ru/articles/1025996/
[2] Dub Studio: https://github.com/timoncool/dub-studio
[3] мозг: http://www.braintools.ru/parts-of-the-brain
[4] Parakeet: https://huggingface.co/nvidia/parakeet-tdt-0.6b-v3
[5] Sortformer: https://huggingface.co/nvidia/diar_sortformer_4spk-v1
[6] audio-separator: https://github.com/nomadkaraoke/python-audio-separator
[7] Gemma: https://huggingface.co/google/gemma-4-12B
[8] Qwen3-TTS: https://huggingface.co/Qwen/Qwen3-TTS-12Hz-1.7B-Base
[9] RapidOCR: https://github.com/RapidAI/RapidOCR
[10] libass: https://github.com/libass/libass
[11] памяти: http://www.braintools.ru/article/4140
[12] Вывод : https://t.me/neuroport/702
[13] Qwen3-TTS: https://github.com/newgrit1004/qwen3-tts-triton
[14] Gradio: https://www.gradio.app/
[15] Hugging Face: https://huggingface.co/
[16] React + Konva: https://github.com/konvajs/react-konva
[17] JASSUB: https://github.com/ThaUnknown/jassub
[18] FastAPI: https://github.com/fastapi/fastapi
[19] зрение: http://www.braintools.ru/article/6238
[20] боль: http://www.braintools.ru/article/9901
[21] ошибка: http://www.braintools.ru/article/4192
[22] Pinokio: https://pinokio.computer/
[23] YouTube: https://www.youtube.com/@nerual_dreming
[24] Телеграме : https://t.me/nerual_dreming
[25] Бусти: https://boosty.to/neuro_art
[26] Источник: https://habr.com/ru/articles/1051580/?utm_campaign=1051580&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.