Когда ИИ не знает – но делает вид, что знает: ударим энтропией по LLM
Представьте: вы спрашиваете умного коллегу о дедлайне проекта, а он отвечает уверенно и детально – но на самом деле придумывает всё на ходу. Именно это постоянно делают большие языковые модели. Они не «знают», что не знают. И это не баг конкретной реализации – это фундаментальное свойство архитектуры.
Эта статья – про то, как с этим бороться инженерными методами. Без философии, с цифрами. Спойлер: Масштабирование модели не поможет. Даже GPT-175B врёт в 42% случаев. Но есть кое-что получше.
Проблема: модель умеет врать убедительно
Чтобы понять масштаб беды, достаточно взглянуть на бенчмарк TruthfulQA – 817 вопросов из 38 категорий, специально подобранных так, чтобы провоцировать типичные заблуждения. Результаты обескураживают: Лучший результат среди всех протестированных языковых моделей – 58% правдивых ответов. Люди справляются на 94%.
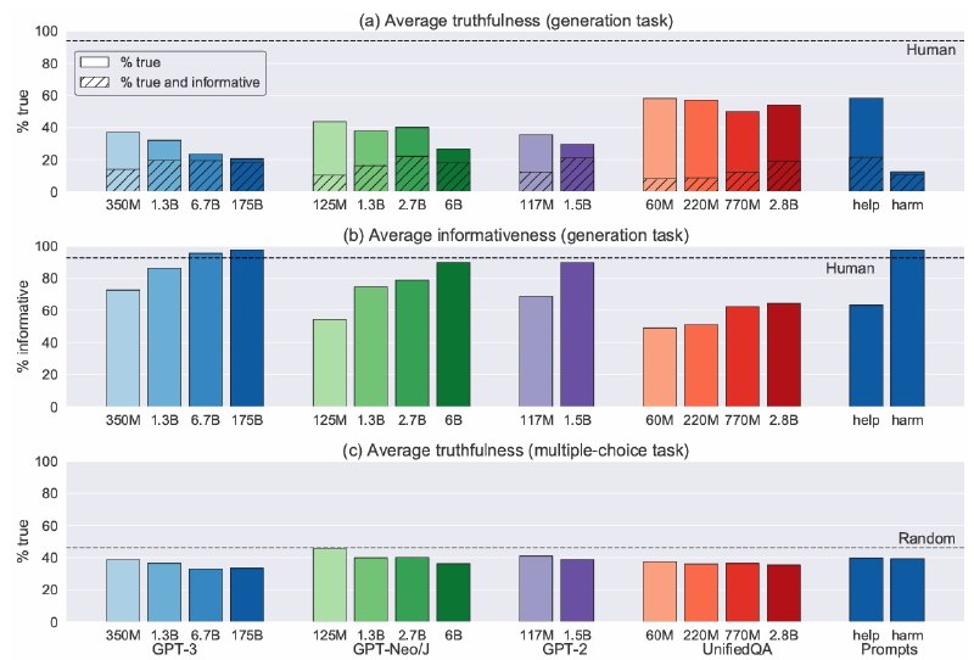
Впрочем модели совершенствуются и скоро видимо просто выучат данный фреймворк – ничего, люди придумают новый. Самое неприятное открытие из анализа данной работы: бо́льшая модель ≠ более правдивая модель. GPT-3 на 175 миллиардах параметров не точнее, чем на 6 миллиардах – она просто увереннее воспроизводит популярные заблуждения из обучающей выборки. Масштабирование здесь не лечит, а иногда усугубляет.
Современные топовые модели (такие как MAI-Thinking-1 или Phi-4) показывают лучшие результаты на данном фреймворке, достигая точности 75-88%, однако тестирование всё еще выявляет склонность моделей к галлюцинациям в сложных или узкоспециализированных областях.
Откуда берётся неопределённость
Неопределенность вещь неопределенная, давайте её определим. В теории машинного обучения [2] различают два принципиально разных типа неопределённости (взято отсюда [3]):
-
Алеаторическая (или неопределённость данных) – это когда сам вопрос неоднозначен. «Когда основан Рим?» – историки спорят. Никакой объём обучения не уберёт эту неопределённость, она встроена в задачу.
-
Эпистемическая (или неопределённость знаний) – это когда модель просто не знает, потому что не видела нужных данных. Устаревшие факты, узкоспециализированные области, события после даты обучения – всё это источники эпистемической неопределённости.
Если с первым типом неопределенности ничего не сделать – разве что выбрать наиболее приятное для нас решение задачи, то с эпистемической неопределенностью можно бороться.
Для LLM эпистемическая неопределённость особенно коварна: знания модели «заморожены» в параметрах на момент обучения, никакого механизма верификации нет, а уверенность при генерации слабо коррелирует с правильностью ответа.
Решение первого уровня: дать модели доступ к знаниям
Самый логичный ответ на проблему устаревших и неполных знаний – не пытаться «запомнить» всё во время обучения, а дать модели возможность искать нужное в момент ответа. Именно такое решение появилось практически сразу после достижения LLM высокого уровня – это подход RAG (Retrieval-Augmented Generation) или генерация с привлечением внешних данных.
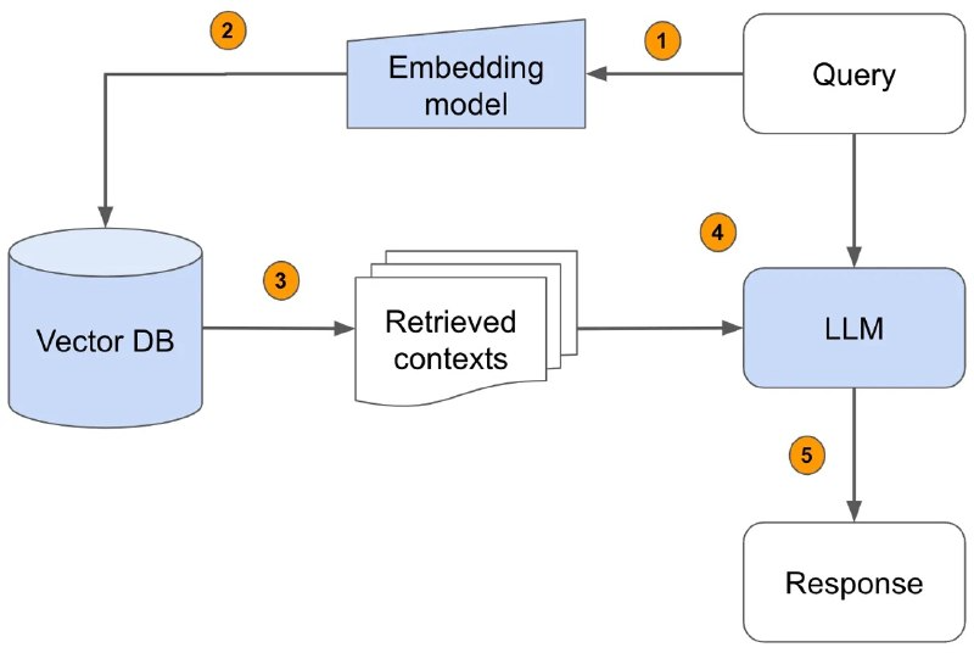
Логика [5] работы RAG довольно понятна – когда пользователь задаёт вопрос, система сначала ищет релевантные документы в базе знаний (через векторный поиск), а потом подаёт их вместе с вопросом в LLM. Модель отвечает, опираясь на конкретные факты из документов, а не только на статистику языковых паттернов из обучения.
Что это даёт на практике? Вот сравнение точности на стандартных бенчмарках открытых вопросов:
|
Датасет |
Базовая модель |
Без RAG |
С RAG |
Прирост |
|
DPR |
41,5% |
44,5% |
+3,0% |
|
|
WebQuestions [7] |
DPR |
41,1% |
45,2% |
+4,1% |
|
CuratedTrec [8] |
DPR |
50,6% |
52,2% |
+1,6% |
|
TriviaQA-Wiki [9] |
T5-11B + SSM |
60,5% |
68,0% |
+7,5% |
Но цифры Exact Match не передают всей картины. Показательнее другой тест: на задаче генерации вопросов в стиле Jeopardy человеческие оценщики признали BART (без RAG) «более фактичным» лишь в 7% случаев, а RAG-систему – в 43% (данные Lewis P., Perez E., Piktus A. et al. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks [10]). Это разница в восприятии качества, а не просто метрика.
RAG не всесилен – семантическая энтропия нам поможет
Добавление базы знаний улучшает ситуацию, но не решает её полностью. Модель по-прежнему может:
-
выбрать нерелевантный фрагмент из найденных документов;
-
неверно синтезировать несколько противоречивых источников;
-
сформулировать спорный вывод с избыточной уверенностью.
Вопрос остаётся: когда системе можно доверять? Для ответа на него нужен способ измерить «уверенность» модели – не ту, что она декларирует в тексте, а реальную. И здесь на помощь приходит семантическая энтропия.
Решение второго уровня: измерить, насколько модель «не знает». Идея семантической энтропии элегантна. Классическая формула Шеннона:
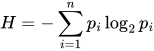
где: H – энтропия, n – число возможных состояний, pi – вероятность появления i-го состояния. Основание логарифма определяет единицу измерения энтропии. Чаще всего основание логарифма выбирается равным 2. В таком случае энтропия измеряется в битах на символ/токен.
Стандартная энтропия считается на уровне токенов – но это не то, что нас интересует. Если на вопрос «Кто написал Гамлета?» модель генерирует ответы «Шекспир», «Уильям Шекспир» и «Shakespeare» – формально это три разных ответа, но смысл один. Высокая токенная энтропия, нулевая семантическая.
Семантическая энтропия работает иначе: генерируется несколько ответов, затем они кластеризуются по смыслу, и энтропия считается по кластерам. Если модель стабильно говорит одно и то же разными словами – она уверена. Если генерирует семантически разные ответы – она сама не знает.
Исследования на моделях OPT (от 125M до 30B параметров) подтвердили (Kuhn L., Gal Y., Farquhar S. Semantic Uncertainty: Linguistic Invariances for Uncertainty Estimation in Natural Language Generation [11]): неправильные ответы сопровождаются значительно большим числом семантически различных вариантов, чем правильные. Семантическая энтропия реально предсказывает ошибки [12].
Практический вопрос: сколько сэмплов нужно?
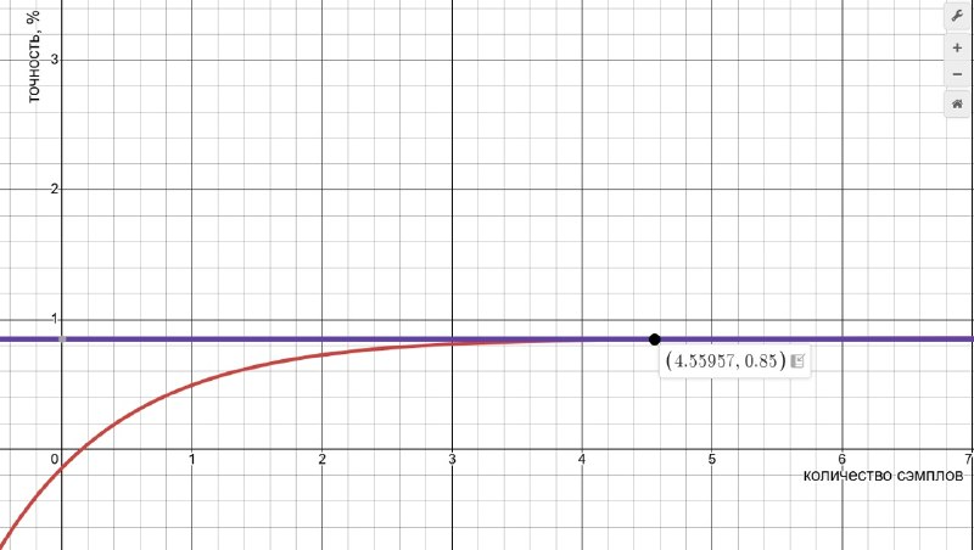
Вопрос в количестве ответов (сэмплов) которое даст максимальный эффект при незначительном снижении времени на получение ответа – ведь каждый семпл нужно сгенерировать. Мы простроили график прироста точности от числа сэмплов. Видно, что значение точности быстро насыщается. После 5 сэмплов каждый дополнительный даёт менее 1% улучшения.
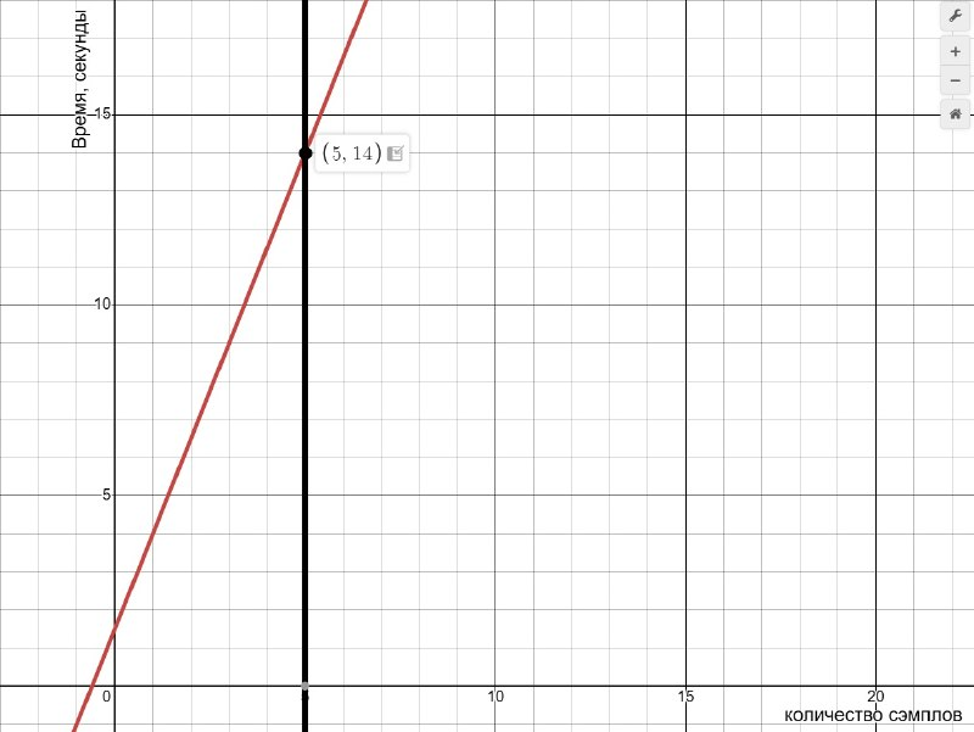
При этом время ответа модели растёт линейно. На нашем оборудовании (парочка Tesla A100) 5 сэмплов укладываются примерно в 14 секунд – граница приемлемого ожидания. Таким образом найдена золотая середина: 5 сэмплов.
На основании этого мы разработали интегрированную систему для получения ответов по технической документации.
Интегрированная система: RAG + энтропия + отказ от ответа
Всё вместе складывается в следующую архитектуру. Мы реализовали её на мощностях МАИ – развернули модель Qwen3.5-122b (в целом можно заменить и на другую, но эта показала лучшие результаты из доступных моделей для локального инференса) и дописали обвязку для снижения неопределенности на основе классического RAG и вычисления энтропии. Вот что получилось в итоге:
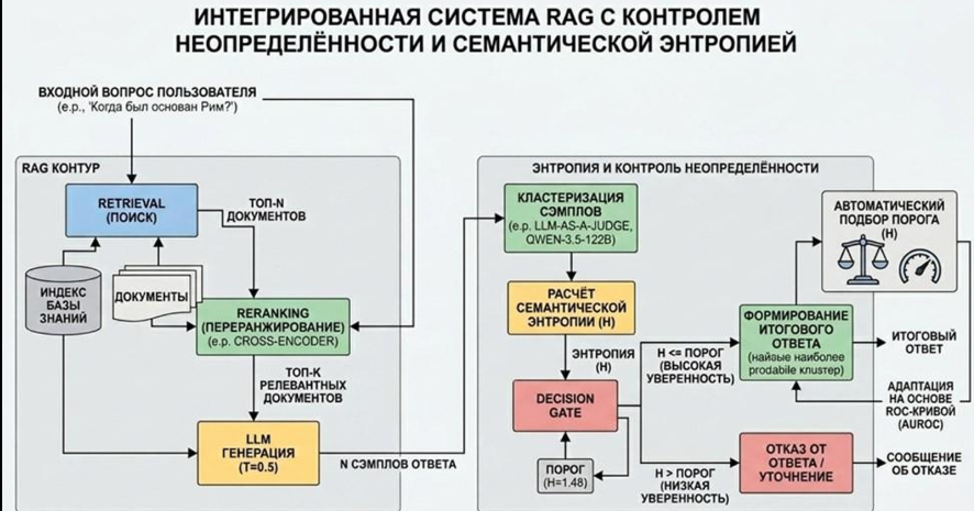
Логика принятия решения проста и жёсткая. Система отвечает пользователю только если одновременно выполнены два условия: найдены надёжные релевантные источники и семантическая энтропия ответов ниже порога (H ≤ 1,48). В противном случае – запрос на уточнение или явное признание неопределённости.
Результаты: что даёт двухуровневая фильтрация. Эксперимент проводился на тех же датасетах, но с метрикой Accuracy (фактическая корректность смысла, а не строгое совпадение строк). В роли судьи – модель QWEN-3.5-122B, точность автоматической оценки составила 0,96 для TriviaQA и 0,89 для CoQA.
|
Датасет |
RAG-Seq |
RAG + reranking |
RAG + reranking + decision |
Итоговый прирост |
|
Natural Questions |
54,1% |
58,6% |
59,8% |
+5,7% |
|
WebQuestions |
55,4% |
59,0% |
61,3% |
+5,9% |
|
CuratedTrec |
62,2% |
70,9% |
73,9% |
+11,7% |
|
TriviaQA-Wiki |
73,2% |
79,2% |
82,1% |
+8,9% |
Наибольший эффект (почти +12%) – на CuratedTrec, где вопросы сложные и однозначные источники особенно важны. Механизм отказа дополнительно «чистит» выборку – система просто не отвечает на случаи, где ошиблась бы.
Честное предупреждение: введение порога отказа означает, что на часть вопросов система не даст ответа вообще. Это компромисс между покрытием и точностью, и в разных приложениях оптимальный баланс будет разным.
Выводы: три принципа надёжной LLM-системы
После всего представленного в статье можно сформулировать несколько конкретных тезисов:
-
Масштабирование не лечит галлюцинации. TruthfulQA показывает это недвусмысленно. Чем крупнее модель – тем убедительнее она воспроизводит распространённые заблуждения;
-
RAG то что нужно для технической документации, он переводит знания из скрытого параметрического пространства в наблюдаемое документальное. Это не просто улучшение точности – это принципиальный сдвиг в том, как система обосновывает свои ответы. Можно указать источник. Можно проверить;
-
Хорошая система должна знать, когда не отвечать. Семантическая энтропия – практичный способ реализовать это без сложной дообучения или специальных классификаторов. Порог настраивается эмпирически под конкретный продукт.
Это не серебряная пуля – каждый компонент добавляет задержку и сложность. Но для приложений, где цена ошибки высока (авиация, космос, медицина, критическая инфраструктура), это единственный честный путь.
Статья основана на исследовании студента первого курса ТОП ИТ – Романа Эль-Тахира «Эффективное построение систем больших языковых моделей с использованием баз знаний и оценки неопределённости» (МАИ, ТОП-ИТ, 2026).
Автор: itmai
Источник [13]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/32399
URLs in this post:
[1] посмотреть тут: https://arxiv.org/abs/2109.07958
[2] обучения: http://www.braintools.ru/article/5125
[3] взято отсюда: https://arxiv.org/pdf/2305.16703
[4] утащено тут: https://habr.com/ru/articles/871226/
[5] Логика: http://www.braintools.ru/article/7640
[6] Natural Questions: https://github.com/google-research-datasets/natural-questions
[7] WebQuestions: https://github.com/brmson/dataset-factoid-webquestions
[8] CuratedTrec: https://huggingface.co/datasets/RUC-NLPIR/FlashRAG_datasets/blob/refs%2Fpr%2F2/curatedtrec/train.jsonl
[9] TriviaQA-Wiki: https://nlp.cs.washington.edu/triviaqa/
[10] данные Lewis P., Perez E., Piktus A. et al. Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks: https://arxiv.org/html/2005.11401v4
[11] Kuhn L., Gal Y., Farquhar S. Semantic Uncertainty: Linguistic Invariances for Uncertainty Estimation in Natural Language Generation: https://openreview.net/forum?id=VD-AYtP0dve
[12] ошибки: http://www.braintools.ru/article/4192
[13] Источник: https://habr.com/ru/companies/itmai/articles/1053446/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1053446
Нажмите здесь для печати.