Синтетическая речь разборчивее живой. Или нет? Разбираем Qwen-Audio-3.0-TTS и что происходит в метриках
Меня зовут Саша, я пишу курс «Аудиоанализ, распознавание и генерация речи» [1] в Яндекс Практикуме, работаю ML-инженером в аудиодомене и вообще послеживаю за индустрией.
Пару месяцев назад (а именно 27 июля 2026 года) вышла статья по генерации речи от Alibaba — Qwen-Audio-3.0-TTS [2]. И вот что примечательно: в таблице результатов на SEED-TTS-Eval есть строка Human, и это не какая-то модель-гуманоид, а настоящая живая человеческая речь, прогнанная через тот же бенчмарк, что и все системы в сравнении. Так сказать, контрольная точка отсчёта.
Так вот, у человека там ошибка [3] 1,26, а у модели, про которую эта статья, — 0,84. На этой строчке я застрял и сел делать разбор, потому что за ней, возможно, стоит проблема поинтереснее самой модели. Вечная проблема метрик.
Попробуем разобраться, что у них там происходит.
4 способа сделать TTS в 2026-м
Сперва неплохо было бы разобраться, как вообще нынче делают TTS и о чём, собственно, статья. Можно выделить четыре основных подхода к задаче генерации речи.
-
Авторегрессия на дискретных токенах (VALL-E, Spark-TTS, Qwen3-TTS). Классика. Языковая модель предсказывает токены речи по тексту. Это естественно стыкуется с LLM-стеком и даёт низкую задержку при стриминге. Однако квантование отбрасывает часть акустики, а стоимость декодирования растёт вместе с числом токенов в секунду.
-
Неавторегрессионные подходы на непрерывных представлениях (Voicebox, E2 TTS, F5-TTS). Акустика синтезируется параллельно, диффузией или flow matching. Итеративный сэмплинг позволяет достичь высокой точности, но на уровне целого высказывания плохо дружит со стримингом.
-
Гибриды (Seed-TTS, CosyVoice). Авторегрессионная модель генерирует дискретные семантические токены, а отдельный непрерывный блок дорисовывает по ним акустику. Разделение удобно, но между двумя блоками остаётся дискретный стык, и всё, что в него не пролезло, до акустики не доедет — это узкое место.
-
Непрерывно-авторегрессионные (DiTAR, Dots.TTS, VoxCPM2). Со стороны похожи на гибриды, но на самом деле здесь существует принципиальная разница: авторегрессия идёт не по дискретным токенам, а сразу по непрерывным латентам, патч за патчем. Дискретного стыка нигде нет, поэтому и речевой квантователь не нужен: акустическое представление остаётся непрерывным вектором внутри модели, а не индексом из отдельно обученного словаря. Потерь на квантовании нет, но зато генерация в высокой размерности и накопление ошибки бьют по устойчивости на длинных фрагментах.
Увы, универсального рецепта здесь нет, есть лишь четыре компромисса.
Qwen-Audio-3.0-TTS растёт из третьей (гибридной) ветки: прямой наследник CosyVoice, у которого попытались заклеить главную дыру гибридного подхода. Кстати, обратите внимание [4], что Qwen3-TTS в свою очередь произрастает из первой ветки. То есть у Alibaba в работе сразу два соседних подхода: чистая авторегрессия на дискретных токенах и вот этот гибрид.
Прямого родства авторы нигде не проговаривают, Qwen3-TTS фигурирует в таблицах на правах бейзлайна, однако частота токенов у обоих в районе 12 Гц. Qwen-Audio-3.0-TTS вышел спустя полгода, и в каком-то смысле его можно назвать преемником. Для тех, кто учил TTS по классике (Tacotron, FastSpeech, HiFi-GAN и вот это вот всё), — это предыдущий слой той же самой идеологии. Это лишний раз показывает нам, что знать классику по-прежнему необходимо, просто раньше на ней обучение [5] заканчивалось, а теперь с неё всё только начинается, так как здесь всё чуточку хитрее.
Кстати, модель выпущена в двух вариантах: Flash — под real-time, первый пакет за ~300 мс, и Plus — под качество. Веса закрыты, доступ только через API. Посмотрим, что внутри.
Речь как 12,5 токенов в секунду
Начнём с самого приземлённого — с токенизатора. Эту часть обычно опускают, а зря, ведь на самом деле она определяет почти всё остальное. Вообще говоря, именно токенизатор задаёт потолок качества генераций.
Зачем вообще дискретизировать речь
Чтобы языковая модель могла работать с речью, необходим конечный алфавит. Соответственно, тяжеловесный непрерывный сигнал надо сжать и квантовать. Здесь начинается компромисс. Камень преткновения — число токенов в секунду, ведь авторегрессионный декодер делает один шаг на токен. Хотите вдвое меньшую задержку — делайте последовательность вдвое короче.
Предыдущее поколение (CosyVoice3) работало на 25 Гц. Здесь — 12,5 Гц, в два раза меньше. Получается один токен на 80 миллисекунд. Для грубого сравнения: средний слог в русском языке может длиться ~200 мс. Соответственно, на слог приходится около двух с половиной токенов. На этом бюджете надо уместить и то, что сказано, и то, как. Звучит как челлендж, и это действительно так.
В отчёте есть ablation, где сравниваются варианты токенизаторов. SEED-TTS-Eval бенчмарк, где CER — это ошибка по символам на китайском языке, SIM — похожесть на голос-референс:
|
Токенизатор |
Кодбук |
Частота |
CER, test-zh ↓ |
SIM, test-zh ↑ |
WER, test-en ↓ |
SIM, test-en ↑ |
|
CosyVoice3 |
6 561 |
25 Гц |
1,45 |
80,60 |
2,57 |
73,60 |
|
Qwen-Audio-3.0-TTS |
6 561 |
12,5 Гц |
2,59 |
72,44 |
3,21 |
61,64 |
|
Qwen-Audio-3.0-TTS |
19 683 |
12,5 Гц |
1,48 |
83,25 |
2,56 |
77,58 |
|
Qwen-Audio-3.0-TTS |
59 049 |
12,5 Гц |
1,23 |
83,09 |
2,37 |
77,49 |
Читать эту таблицу можно следующим образом. Просто уполовинить частоту при том же словаре — катастрофа: похожесть голоса на английском обваливается, ошибка растёт почти в полтора раза. Информация, которая жила в лишних кадрах, теряется. Оказывается, может и не лишними они были.
Однако же если при этом одновременно раздуть словарь, потери не только компенсируются, но и перекрываются: при 19 683 кодах модель уже лучше исходной 25-герцевой по обоим критериям, при 59 049 — ещё точнее. По сути, это трейдофф «частота против алфавита»: сэкономленное по времени доплачивается размером словаря. Похожую картину можно увидеть и на чистом ASR-прогоне токенизатора: на Common Voice ошибка уменьшается по мере роста размера кодовой книги, обгоняя 25-герцевого предшественника.
Кодбук в 59 049 записей получается не случайно. Это 310: используется Finite Scalar Quantization — десятимерный bottleneck, каждое измерение которого квантуется на три уровня. Никакого обучаемого кодбука с его вечной проблемой мёртвых кодов здесь нет, просто округление по сетке. Удобно.
Оговорочка: численные значения в этой таблице — из ablation, где сравниваются только варианты кодирования на одинаковой в остальном системе. Финальная модель на том же тесте показывает 0,84.
Что ещё умеет токенизатор
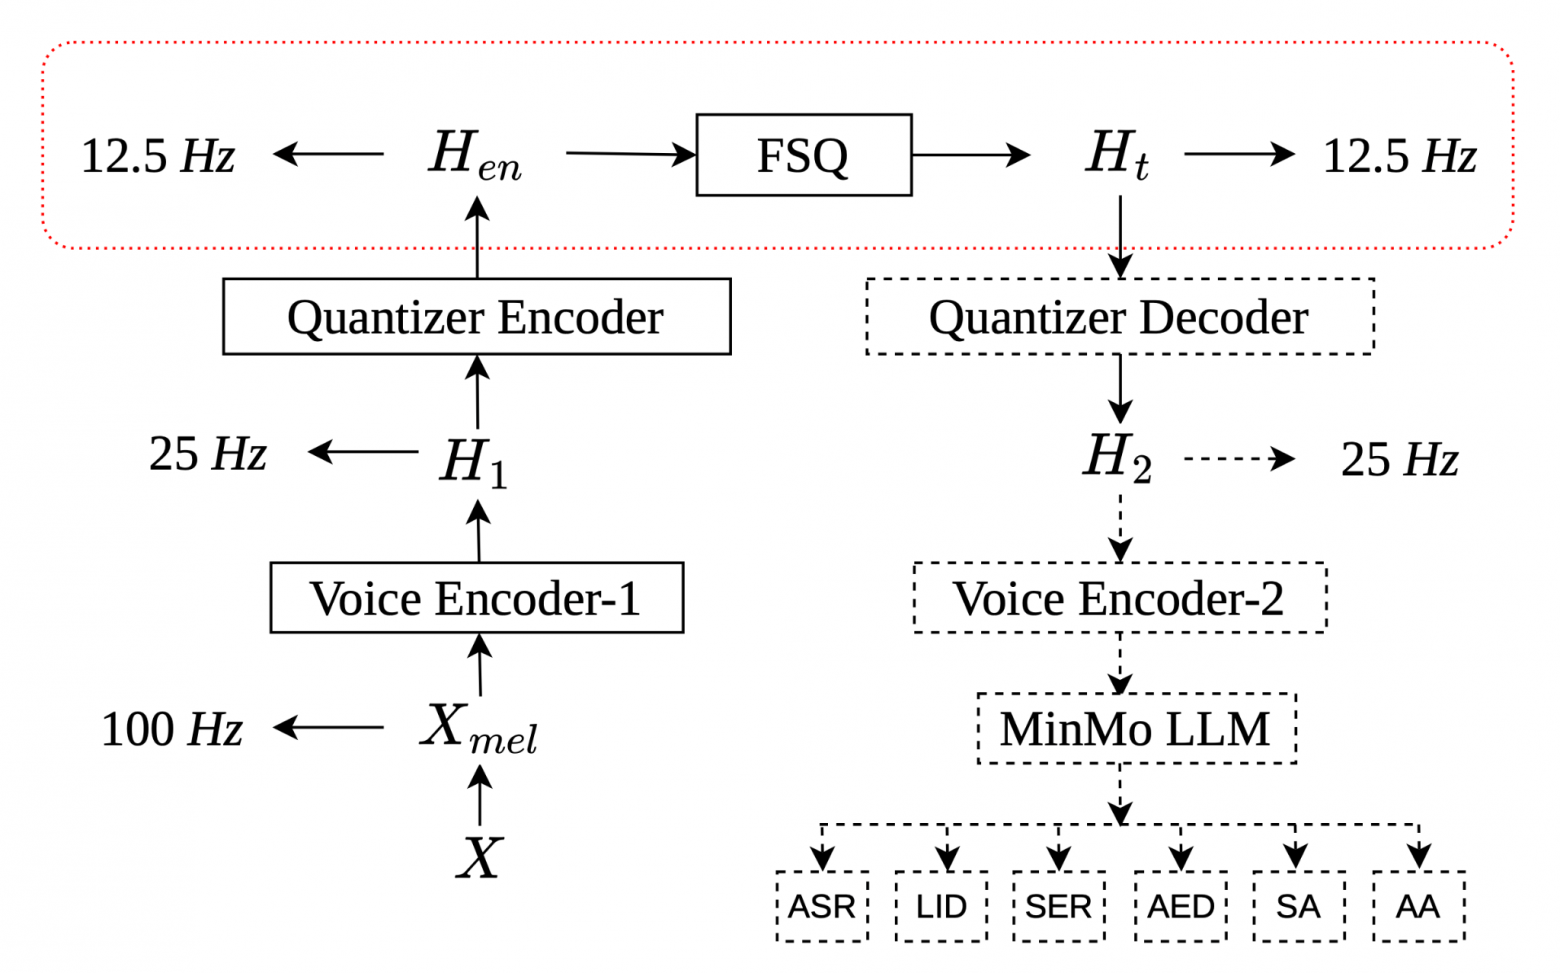
Обучается токенизатор не только на ASR: мультизадачный таргет включает как распознавание речи и определение языка, так и распознавание эмоций [6], детекцию аудиособытий, анализ говорящего. Логика [7] такая: если токены должны нести не только «какие слова», но и «каким голосом», «с какой эмоцией», «в какой обстановке» и так далее, то надо явно попросить об этом на этапе обучения представлений. Само обучение идёт по схеме «сначала непрерывное, потом квантованное», то есть сначала стабильное непрерывное представление, и только затем включается FSQ.
Внимательный читатель спросит, а что вообще, собственно, токенизируем? Хороший вопрос. На вход идут 128-полосные мел-спектрограммы с частотой 100 Гц от wideband (16 кГц) аудио, а-ля Whisper. Опять же, мел-спектрограмма — это первое, что показывают в любом введении в аудиоанализ, и она по-прежнему никуда не делась. Она остаётся первым слоем в современном стеке за миллиард параметров. Разумеется, сегодня существуют и подходы к сырым аудио-вэйв-формам, но вот здесь не так, однако.
Пять стадий обучения
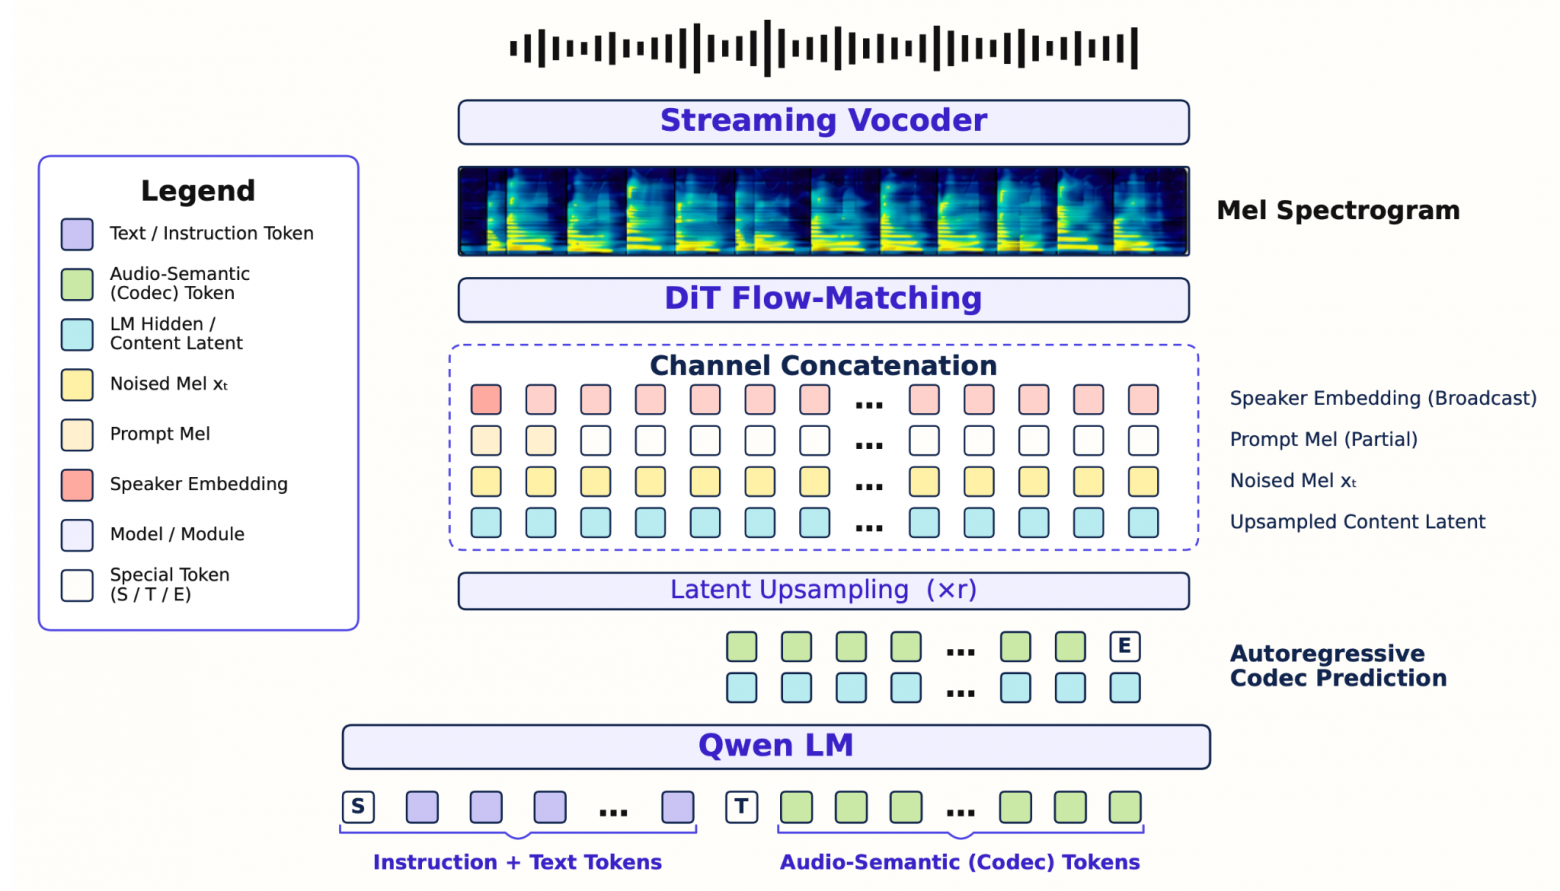
Сама модель представляет собой три компонента: языковая модель предсказывает семантические токены, flow-matching модель восстанавливает акустические признаки (те самые мел-спектрограммы), а каузальный BigVGAN превращает их в волну. Классическая каскадная схема с известной болячкой: дискретный токен на стыке — узкое место. Всё, что не влезло в 12,5 токенов в секунду, до акустического рендерера не доезжает.
Что сделали здесь: flow-matching модель обусловили не на эмбеддинги дискретных токенов, а на непрерывные латенты LM, и стали обучать оба блока совместно. Предсказание токенов осталось стабильным обучающим сигналом, но теперь ошибка реконструкции акустики протекает обратно в языковую модель через общий непрерывный путь.
Дальше — то, что авторы называют прогрессивной парадигмой из пяти стадий:
-
Раздельный претрейн LM и FM на большом разнородном корпусе — многоязычном, диалектном, с инструкциями.
-
Совместное обучение с отжигом на качественных данных. Сначала широкое покрытие, потом сужение выборки до чистой и выразительной речи. Порядок принципиален: если сузить выборку сразу, покрытие уже не вернётся.
-
RL для языковой модели — GRPO с составной наградой.
-
Обучение робастности с замороженной LM: FM учат вытаскивать чистую речь из грязного референса.
-
RL для flow-matching модели — FlowTTS-GRPO.
Два момента отсюда, пожалуй, заслуживают отдельного разговора.
Награда за разнообразие
Награда на третьей стадии складывается из четырёх слагаемых: содержание (проверяется распознаванием прямо в токенном домене), длительность, просодия и разнообразие. Последнее буквально штрафует «механическое схлопывание». То есть авторы заранее знают: если оптимизировать только точность произнесения, модель начнёт говорить как голос, объявляющий, что двери закрываются: идеально разборчиво и абсолютно мёртво.
Ещё инженерная деталь: все награды третьей стадии считаются до запуска FM и вокодера. Роллаут — это последовательность токенов, а не отрендеренная волна, и разница в стоимости RL-цикла тут в разы. Любопытен и двухфазный учебный план внутри RL: сначала общая оптимизация, из которой намеренно исключены инструкции, тонкое управление и диалекты (чтобы не оптимизировать то, что базовая награда не умеет измерять), и только потом фаза с наградой за правильность диалекта.
Список аугментаций
Четвёртая стадия — про то, что реальный референс вряд ли записывается в студии. Кто-то честно сел и выписал все способы испортить пятисекундную запись своего голоса: шум и реверберация, характеристики телефонного, блютус- и ноутбучного микрофонов, дальнее поле, перекрытие микрофона рукой или маской, артефакты кодеков и ЦАП, потеря пакетов, эхо и даже комбинации типа «шумная переговорка с дальним полем». Принципиальный момент: шумоподавление здесь встроено в путь клонирования, а не вынесено в отдельный денойзер. Срез по реверберированным референсам:
|
Система |
WER ↓ |
SIM ↑ |
DNSMOS ↑ |
|
ElevenLabs-v3 + денойз |
0,58 |
44,39 |
4,025 |
|
MiniMax-Speech-2.8-HD + денойз |
0,87 |
56,53 |
3,343 |
|
Qwen-Audio-3.0-TTS |
0,69 |
74,12 |
3,925 |
Смотрите, что происходит у конкурентов при включении денойза: разборчивость и чистота звука отличные, ElevenLabs здесь даже впереди Qwen и по WER, и по DNSMOS. Вот только голос при этом уже чужой: 44 по похожести против 74. Отдельный шумодав не знает, где кончается шум и начинается тембр, и на всякий случай подрезает лишнее. Для тех, кто строит какой-то продукт с клонированием голоса по записи с телефона, разница между 44 и 74 может быть критической, даже если по двум другим колонкам есть какая-то просадка.
Управление: 86 тегов и свободный текст
Теперь про то, что видится главным изменением именно с точки зрения [8] продукта. Как управляли синтезом раньше? Speaker embedding для тембра, ручки для темпа и высоты, иногда категориальная метка эмоции [9] из фиксированного списка. Всё это по-прежнему рабочая база, но здесь интерфейс иной.
Свободные инструкции на естественном языке: роль, эмоция, стиль, темп, тембр, акцент описываются текстом. Из релизного блога: «прочитай это медленно, как сказку на ночь». Прямо режиссёрская ремарка. Плюс 86 встроенных тегов для локального управления на уровне фразы или слова: [whisper], [angry], [breaths], [laughs], кашель, вздохи, переходы между состояниями. Скрипт для синтеза начинает выглядеть как пьеса.
Насколько хорошо это работает? Здесь тоже есть чиселки. Бенчмарк на 440 кейсов, поровну китайский и английский, три типа инструкций: одноатрибутные (SA), многоатрибутные на естественном языке (NL) и структурированные «ключ-значение» (ST).
|
Система |
zh SA |
zh NL |
zh ST |
zh итог |
en SA |
en NL |
en ST |
en итог |
|
IndexTTS2 |
65,00 |
42,67 |
40,67 |
54,39 |
67,50 |
37,33 |
62,00 |
59,39 |
|
CosyVoice3-1.5B |
82,50 |
67,33 |
68,67 |
75,91 |
63,33 |
56,00 |
74,00 |
64,09 |
|
Qwen-Audio-3.0-TTS |
87,50 |
72,00 |
65,33 |
78,94 |
83,33 |
76,00 |
78,00 |
80,45 |
Интересно смотреть не на итоговые колонки, а внутрь. На английском прирост ровный и существенный, как на одноатрибутных инструкциях, так и на свободной форме. Забавно, что именно на китайском картина другая: по свободной форме выигрыш небольшой, а по структурированным «ключ-значение» модель предшественнику и вовсе проигрывает.
Есть и цена. По похожести голоса на этом же бенчмарке Qwen-Audio-3.0-TTS уступает CosyVoice3, что, в общем-то, логично: чем сильнее вы просите модель изменить манеру, тем дальше она уезжает от исходного тембра. Управляемость и верность голосу тянут в разные стороны. Соответственно, не баг, а фича.
Языки и акценты
Модель заявляет 16 языков, 7 из которых добавлены в этом поколении: малайский, тагальский, арабский, португальский, индонезийский, тайский и вьетнамский. Плюс 20 китайских диалектных регионов. Нас же интересует русский.
Русский
На мультиязычном бенчмарке клонирования голоса CV3-Eval на русском получается лучший результат среди сравниваемых систем:
|
Система |
Ошибка на русском ↓ |
|
Qwen-Audio-3.0-TTS |
4,68 |
|
ElevenLabs-v3 |
5,38 |
|
MiniMax-Speech-2.8-HD |
5,39 |
|
VoxCPM2 |
5,97 |
|
CosyVoice3-1.5B |
6,64 |
|
CosyVoice3-0.5B |
6,77 |
|
Qwen3-TTS-12Hz-1.7B-Base |
7,40 |
|
Dots.TTS-2B |
14,0 |
Наверное, это не панацея, так как бенчмарк один, домен узкий, и по своим данным всё равно надо перепроверять, но всё равно приятно.
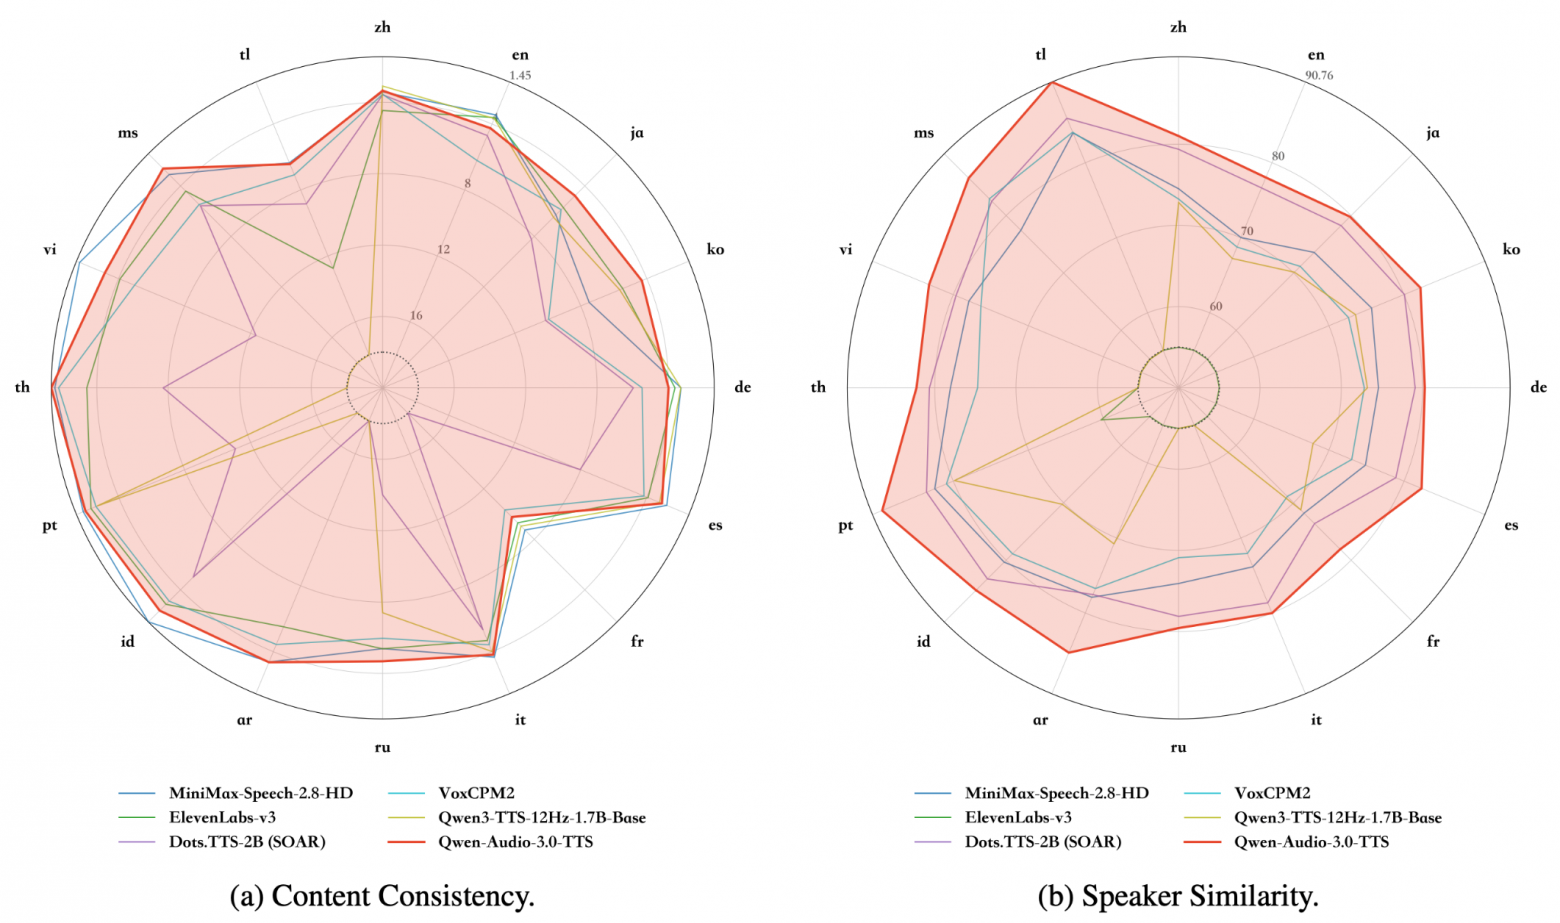
Забавная деталь: французский тяжело даётся вообще всем. Связь написания и произношения во французском — отдельный вид спорта, и медалистов среди моделей не наблюдается. Так что про поддержку 16 языков — сильное заявление. Проверять я его, конечно, не буду. Однако разброс внутри одной модели доходит почти до семикратного и как бы намекает.
Чужой язык чужим голосом
Отдельный сюжет — кросс-языковое клонирование: взять референс на одном языке и заставить этот голос говорить на другом. Занятно. На 12 направлениях переноса между китайским, английским, японским и корейским Qwen-Audio-3.0-TTS лучший в 8 и второй в остальных 4, причём лучше в каждом направлении без исключений.
Неудобный вопрос про метрики
На мой взгляд, весьма нетривиальная тема, из-за которой я, собственно, здесь и оказался. Так что происходит?
Как вообще оценивают качество синтеза речи
Основные метрики качества TTS — это традиционные WER и CER. Берём сгенерированное аудио, прогоняем через систему распознавания речи, сравниваем расшифровку с исходным текстом. Меньше ошибок — лучше синтез.
Нетрудно заметить, что на самом деле это метрики именно распознавания, применённые задом наперёд: в ASR они измеряют, насколько хорошо модель услышала, а здесь ими измеряют, насколько внятно модель сказала. Инструмент один, направление обратное. Но есть один нюанс.
Работает это ровно настолько, насколько ASR-модель нейтральна. А она не нейтральна: у неё свой словарь, свои привычки нормализации, свои слабые места. Например, Whisper-large-v3, по которой оценивают английский, — это не эталон из международного бюро мер и весов, а лишь ещё одна сетка со своим характером, и она здесь невольно становится частью измерительного прибора.
Число, на котором хочется остановиться
Возвращаемся к строке Human. На китайском тесте у живой человеческой речи CER 1,26. У Qwen-Audio-3.0-TTS — 0,84. Синтез разборчивее человека. Заметно разборчивее. И это не единственная строка, где человек проигрывает. Например, по похожести на голос-референс у настоящей записи того же диктора 0,755 и 0,775 по двум разным энкодерам, у синтеза — 0,792 и 0,847. Живой человек оказывается менее похож на собственный референс, чем модель, которая его имитирует. Чудеса в решете.
Если у вас возникло ощущение, что что-то здесь не так, — оно правильное. По крайней мере, мне тоже так кажется. Живая речь не хуже, она сложнее устроена. В ней есть хезитации, редукция, нестандартные ударения, темп, который скачет по смыслу. Всё то, что делает речь живой, распознаватель считает за ошибки. А чистая, канонично артикулированная синтетика ему нравится. Кажется, дело в этом.
То есть метрика уже давно измеряет не качество речи, а степень её приглаженности, и оптимизировать её дальше — значит целенаправленно уезжать от человека. И авторы это прямо пишут. В том же разделе есть тезис, который, увы, в анонсы не попадает. Дословно: «дожимание CER/WER более агрессивной оптимизацией стабильно достигается ценой естественности и выразительности речи». Поэтому модель целится в общий баланс, а не в минимальную ошибку.
И это видно по таблице: на китайском тесте у Qwen-Audio-3.0-TTS второе место по CER, в то время как первое у того самого Qwen3-TTS из первой ветки. Впрочем, на английском ровно та же расстановка. Одна компания, две соседние ветки, и по метрике впереди оказывается та, что целиком живёт на дискретных токенах. Любопытно. Они могли додавить, но не стали, причём на обоих языках.
Также интересно посмотреть, чего стоит эта корона. Тот же самый Qwen3-TTS, который выигрывает по китайскому CER, в русской таблице выше стоит предпоследним, а, например, на тайском его вообще не оценивали. Первое место по одной метрике на одном языке не переносится даже на соседнюю строку бенчмарка.
Вот именно здесь я и залип, ибо выходит эдакое тихое, но радикальное заявление о состоянии области: метрика, на которой вырос современный TTS, теперь мешает ему становиться лучше. И индустрия это уже понимает, просто пока не придумала, чем WER заменить. В такие моменты возникает некий экзистенциальный кризис, ведь мы привыкли обращаться к численным оценкам и тратить множество усилий на их оптимизацию, иной раз забывая валидировать, имеет ли это какой-то реальный смысл.
Дальше — больше. По похожести голоса авторы отмечают, что WavLM и ERes2Net в качестве эмбеддеров часто дают разные ранжирования систем. Сами они объясняют это тем, что модели схватывают взаимодополняющие стороны похожести. Объяснение мягче, чем следствие: на вопрос «чей голос ближе к оригиналу» два стандартных энкодера отвечают по-разному, и «SOTA по speaker similarity» зависит от того, кого вы спросили.
Судья, который сам себе не доверяет
Ещё интереснее с оценкой выполнения инструкций, ведь здесь объективной метрики нет вовсе. Поэтому судьёй ставят Gemini-2.5-Pro, и вот за это действительно отдельное уважение, потому что ребята калибруют судью по людям и публикуют результаты:
-
на простых одноатрибутных инструкциях согласие с людьми 70%, точность 92,3%, но полнота 64,9%;
-
на сложных многоатрибутных согласие по отдельным критериям падает до 56,7%;
-
при этом средние баллы почти совпадают: 1,46 у людей против 1,48 у модели;
-
и, наконец: слепой разбор спорных случаев показал, что 35,4% таких критериев в принципе неоднозначны, то есть обе оценки защитимы.
Последнее число кажется интересным. Получается, треть критериев качества выразительной речи не имеет определённого ответа — сам вопрос так поставлен. Всё равно что если бы у каждого третьего вопроса на экзамене не было единственного верного варианта, а оценку бы всё равно ставили.
Получается, что существует интерфейс управления голосом, но его успешность или неуспешность мы на самом деле не умеем надёжно оценивать. И это, кажется, выглядит гораздо более интересной инженерной проблемой, нежели очередная десятая доля процента WER.
Первое место на арене
Финальный штрих. В отчёте есть скриншот лидерборда Artificial Analysis от 16 июля: Elo 1237 на 1427 сравнениях, первое место. Тут же уточнение: отображаемый диапазон ранга 1–2, а 95-процентный доверительный интервал пересекается с интервалом Simba 3.2. Авторы формулируют аккуратно: первое место по точечной оценке, внутри статистически лидирующей группы.
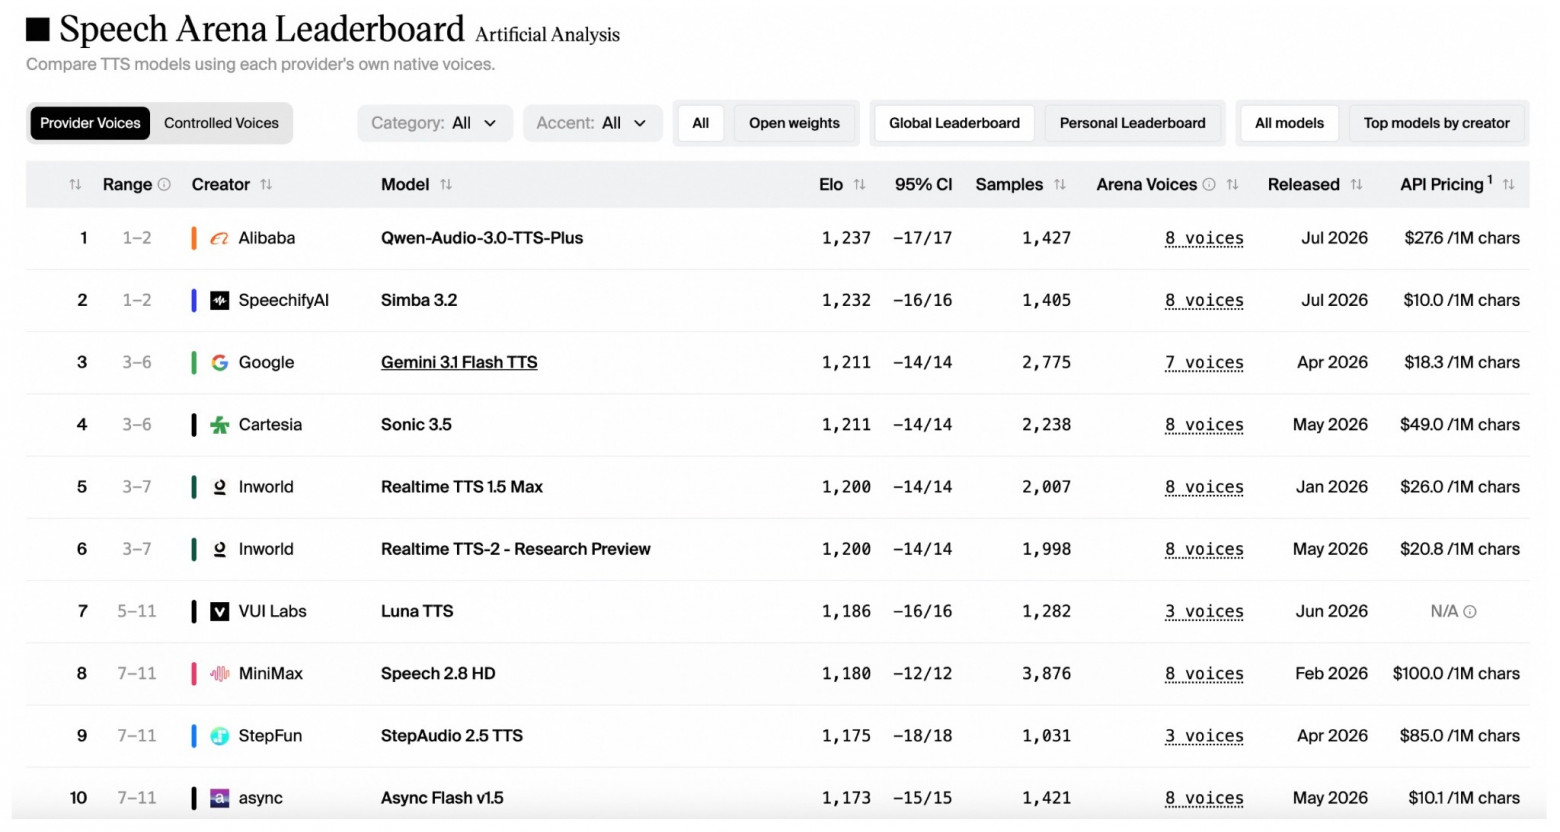
Между тем, пока я готовил эту статью, лидерборд ответил лучше любого комментария. Например, уже в конце августа наверху успела оказаться модель Sonic 3.6 с Elo 1283, а Qwen-Audio-3.0-TTS-Plus с 1238 разделил второе место с той самой Simba 3.2. 45 пунктов отрыва, и вот теперь интервалы уже не пересекаются.
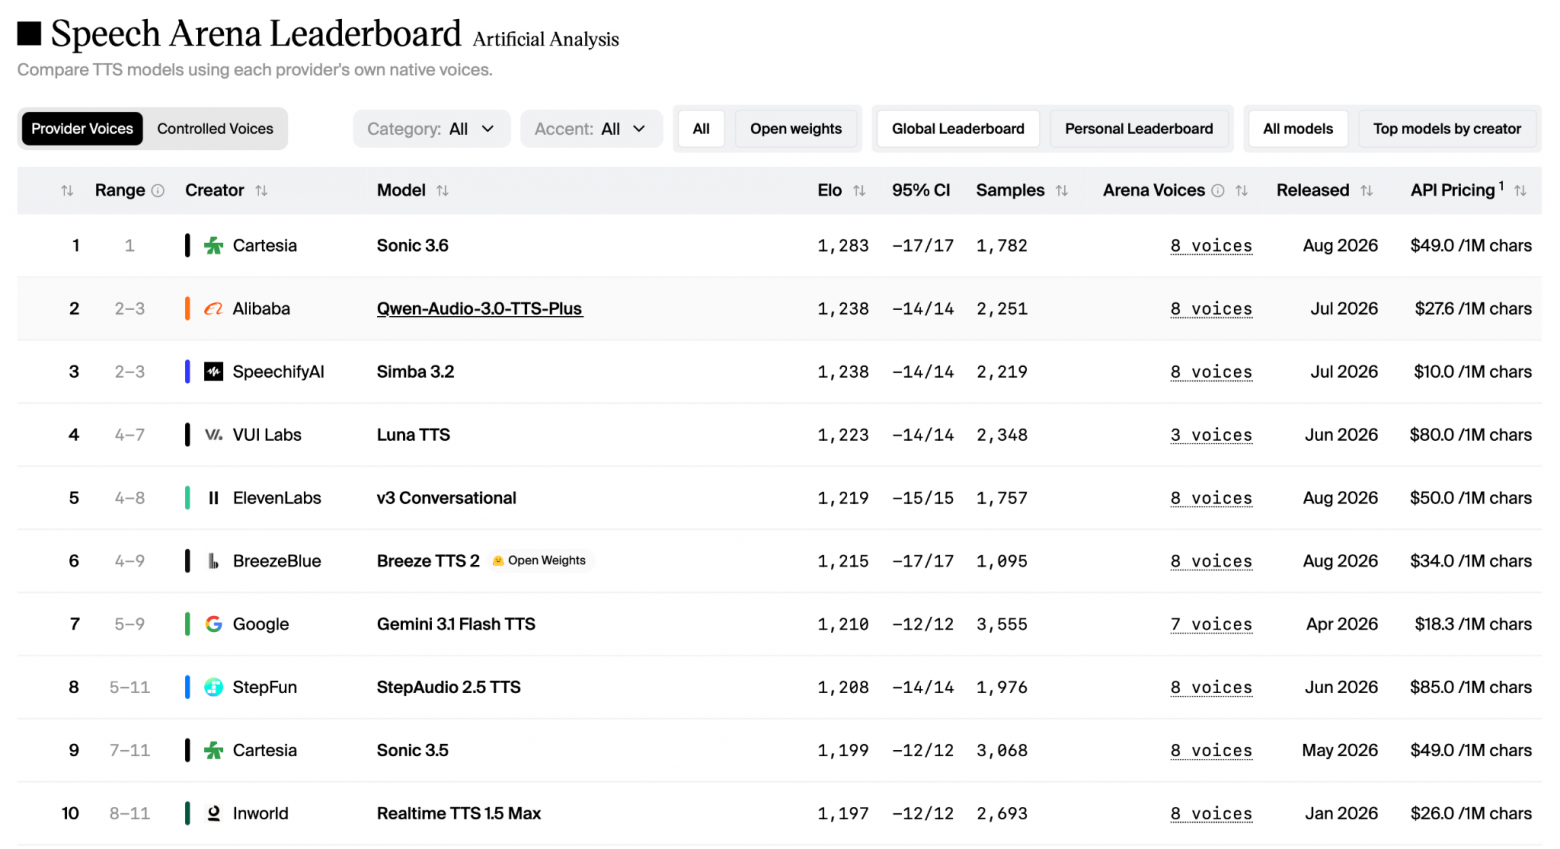
Короче говоря, маркетинг говорит «#1 на лидерборде», но дьявол в деталях, и это тоже стоит иметь в виду. Надо сказать, это ни в коем случае не умаляет подвиг коллег из Alibaba. Однако выходит так, что всем нам всегда есть к чему стремиться.
Если собираетесь строить на этом продукт
Положим, вы делаете свой гениальный AI B2B SaaS с речевыми технологиями, и вам срочно нужен TTS. На что стоит обратить внимание? Вот четыре места, где, судя по отчёту, что-то может поломаться в первую очередь.
Нормализация текста
Наверное, нормализация — это самый недооценённый источник production-багов в TTS. У авторов под это отдельный бенчмарк на 1 375 случаев, разбитый по категориям: числа и даты, финансовые выражения, аббревиатуры, коды и адреса, формулы с единицами и символами.
Общий результат Qwen-Audio-3.0-TTS — лучший среди сравниваемых: 68,7% на китайском и 65,7% на английском. По категориям картина неровная:
|
Категория |
zh |
en |
|
Числа, даты, время |
84,2 |
78,2 |
|
Коды, серийники, адреса |
89,7 |
61,5 |
|
Финансовые выражения |
43,7 |
82,8 |
|
Аббревиатуры и акронимы |
50,6 |
59,4 |
|
Формулы, единицы, символы |
43,8 |
45,1 |
Формулы и единицы — не очень у всех, аббревиатуры немногим лучше. А финансовые выражения расходятся между языками почти вдвое, что намекает: дело не в модели, а в том, сколько таких данных было по каждому языку. Практически: ваши артикулы, суммы, даты, аббревиатуры и адреса надо прогнать отдельным тестом до того, как вы озвучите их.
Длинные генерации
Синтез до трёх минут речи за один проход без внешней нарезки — вот это серьёзная заявка. Тестируют на 200 абзацах, разбитых на короткие, средние и длинные, и тут полезно смотреть не на итог, а на разбивку.
У Qwen-Audio-3.0-TTS на китайском: 0,30 на коротких, 0,31 на средних и 5,62 на длинных. В сумме 2,22, что отлично на фоне остальных, но внутри деградация почти в 19 раз к концу диапазона.
Для сравнения: на длинных сегментах CosyVoice3-1.5B уходит к 33,29, а Dots.TTS к 47,31: это уже не деградация, а развал. Зато VoxCPM2 держит ровные ~0,5, но при этом у него похожесть на референс 61,73 против 78,85 у Qwen. То есть он стабильно читает текст не тем голосом. Стабильность — это, конечно, признак мастерства, но это не точно.
Мораль сей басни такова: длительность в спецификации не гарантирует стабильность на всём диапазоне, и почти всегда есть цена. Лучше слушать целиком, а не первые десять секунд.
Формат аудио: каналы и килогерцы
Момент, который в отчёте в явном виде не проговаривается толком вообще, а в проде всплывает чуть ли не первым же вопросом.
Каналы. Здесь всё довольно очевидно, генерируется моно-аудио.
Частота дискретизации. А вот тут занятно. Мы уже выяснили, что на входе токенизатора — wideband, 16 кГц. А вот то, с какой частотой отдаёт аудио финальный вокодер, в отчёте не сказано. Единственное конкретное число дальше по тексту — это super-resolution вокодер на fullband (48 кГц), который обучают отдельно, и, судя по всему, это опция.
API 48 кГц отдаёт: в параметрах есть sample_rate со значениями 8 000, 16 000, 22 050, 24 000, 44 100 и 48 000, по умолчанию 24 000, плюс можно выбрать контейнер: mp3, wav, pcm или opus. Казалось бы, вопрос закрыт.
Но не тут-то было. Возможность попросить 48 кГц и наличие в сигнале реального верха — это, вообще говоря, две разные вещи. Super-resolution вокодер в отчёте описан, а вот в релизном блоге 48 кГц на момент анонса стоял с пометкой coming soon, при том, что параметр sample_rate со значением 48 000 API принимал уже тогда. Так что на самом деле вопрос открытый: то ли там честный суперрез, то ли обычный ресемплинг вверх, который даст лишь файл потяжелее и ровно ноль новых гармоник.
При этом базовую частоту (имеется в виду без суперреза) также угадать несложно: прямым текстом её не называют, но всё сходится на 24 кГц: у CosyVoice2, чей дизайн здесь наследуется, вокодер на 24 кГц, да и дефолт API тоже. Если вам важны ВЧ-детали, проверяется всё это дело за пять минут: возьмите синтез на 48 кГц и постройте спектрограмму. Если выше 12 кГц пустота, то, увы, вам просто заапсемплили сигнал с частотой 24 кГц.
Ещё момент: по умолчанию отдаётся mp3 на 32 кбит/с. Для голосового ассистента, наверное, терпимо, но для всего остального лучше сразу просить wav или pcm, чтобы не смешивать артефакты синтеза с артефактами кодека.
Доступ
Модели доступны только по API, веса закрыты. Если у вас есть требования к on-premise, то на сегодня это блокер. Заодно это значит, что перепроверить численные значения из отчёта не получится в принципе: вы можете померить сервис, но не модель.
Выводы
Три вещи, которые я забираю себе из этих 15 страниц текста.
-
Интерфейсом к голосу стал язык. Не пресет из выпадающего списка, а прямо инструкции и ремарки на естественном языке, практически «словами через рот». Это приятно. Управление синтезом переехало в ту же плоскость, где живут промпты к LLM. Согласитесь, это удобнее.
-
Узкое место сместилось с генерации на оценку. Отчёт на самом деле посвящен тому, что модель стала лучше, и он же подолгу объясняет, почему числам нельзя слепо верить: WER специально не дожимают, синтез по этой метрике обгоняет живого человека, два энкодера похожести расходятся в ранжировании, треть критериев выразительности неоднозначна в принципе, а первое место в арене оказалось внутри доверительного интервала и за пять недель успело смениться. Может, нам, инженерам, стоит поработать в направлении метрик и бенчмарков для TTS. Выглядит как интересная и нужная прикладная задача.
-
База не устарела, она стала несущей. Действительно, чтобы прочитать этот отчёт не как список аббревиатур, а осознанно, нужно понимать, что такое мел-спектрограмма, почему мелов 128 на 100 Гц и кто такие эти ваши мелы вообще; что делает квантование и чем FSQ отличается от, скажем, RVQ; почему частота кадров напрямую превращается в задержку; что именно считает WER и какие ошибки он не различает; зачем в конце стека вообще нужен вокодер; чем flow matching отличается от авторегрессии и почему поверх него не так просто приделать обучение с подкреплением [10]. В общем-то, ни один из этих моментов не новый, всё это из первых глав любого нормального введения в обработку звука, просто теперь без них фронтир нечитаем.
Всё, что я разбирал выше, стоит на определённом фундаменте: спектрограммы, кодировщики, квантование, генераторы, вокодеры, метрики. Если вдруг после прочтения статьи вам захотелось глубже погрузиться в тему аудиоанализа, а не выцеплять смысл из аббревиатур, — добро пожаловать на курс «Аудиоанализ, распознавание и генерация речи» [1].
Спасибо за внимание!
Первоисточник: Qwen-Audio-3.0-TTS: Freely Controllable and Highly Robust Speech Synthesis with Multi-Stage Training Paradigm, arXiv:2607.23938 [2]
Автор: ivnvalex
Источник [11]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/35505
URLs in this post:
[1] «Аудиоанализ, распознавание и генерация речи»: https://practicum.yandex.ru/audio-analysis/?utm_source=content&utm_medium=media&utm_campaign=habr_media_RF_Data_audiAn_b2c_Article_None_synthetic-speech&utm_content=15-09-26
[2] Qwen-Audio-3.0-TTS: https://arxiv.org/abs/2607.23938
[3] ошибка: http://www.braintools.ru/article/4192
[4] внимание: http://www.braintools.ru/article/7595
[5] обучение: http://www.braintools.ru/article/5125
[6] эмоций: http://www.braintools.ru/article/9540
[7] Логика: http://www.braintools.ru/article/7640
[8] зрения: http://www.braintools.ru/article/6238
[9] эмоции: http://www.braintools.ru/article/9387
[10] подкреплением: http://www.braintools.ru/article/5528
[11] Источник: https://habr.com/ru/companies/yandex_praktikum/articles/1080414/?utm_campaign=1080414&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.