Система экстренных оповещений на 15 тысяч пользователей: LLM, PostGIS, Qdrant и Telegram
В нашем телеграм-боте — системе экстренных оповещений «Мигалка» — нужно в реальном времени обрабатывать сообщения примерно из тысячи телеграм-каналов и доставлять релевантные события пользователям в конкретных локациях.
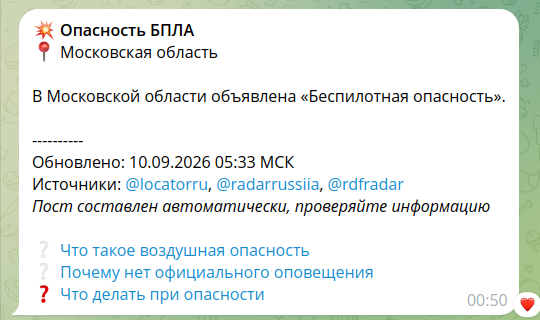
Официальные предупреждения о прилетах дронов и ракетных ударах часто приходят [1] с опозданием на часы, а нередко не приходят вовсе. Сотни телеграм-каналов сообщают об опасности раньше официальных служб. Читать их напрямую сложно: в одном канале смешиваются события из разных регионов, а одно происшествие могут одновременно описывать десятки источников. К тому же, пользователям интересно следить и за другими рисками — облавами и рейдами.
Главная инженерная задача здесь — превратить поток неструктурированного текста из сотен телеграм-каналов в события, с которыми может работать остальная система: определить тип события, место, краткое описание, убрать дубли и понять, кому именно его нужно отправить.
Мы изначально строили систему без постоянной ручной модерации. События появляются круглосуточно и их происходит по несколько сотен в день, поэтому ручная проверка плохо масштабируется. Часть работы выполняет LLM-конвейер, часть — пользователи, которые могут сами сообщать о событиях и проверять сообщения друг друга.
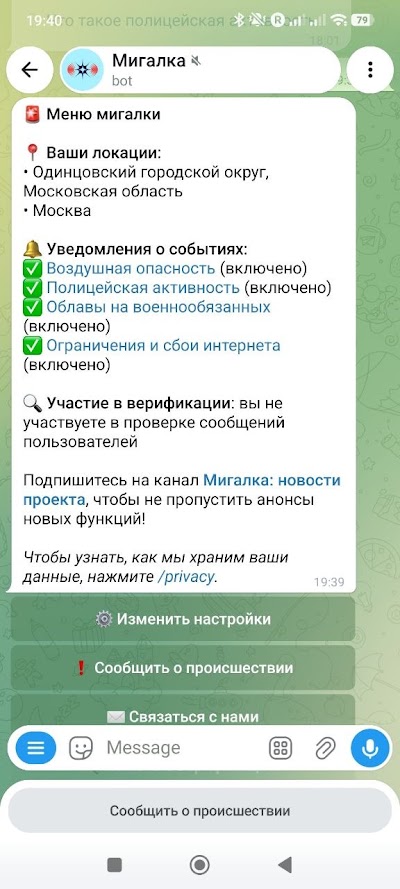
Пользователь вводит в бота локацию — она может быть любой степени детальности, от целого региона до района в городе, а также интересные ему категории опасности. Эти фильры используются в боте, чтобы присылать релевантные оповещения, а значит из каждого поста надо выделить категорию события и локацию.
Как это устроено в целом
Каналы читает отдельный Telegram-скрейпер, который складывает новые посты во входящую очередь. Дальше сообщение проходит несколько этапов:
-
тематическую фильтрацию;
-
извлечение события;
-
определение и проверку локации;
-
дедупликацию;
-
подбор получателей;
-
постановку в очередь доставки.
В системе используется несколько хранилищ. Postgres содержит основные данные — события и настройки пользователей — и используется для надёжной очереди доставки. Qdrant хранит векторы для поиска потенциальных дублей. Redis используется для входящей очереди и управления скоростью отправки для соблюдения лимитов телеграма.
Превращаем текст в структурированное событие
Центральная задача системы — преобразовать публикацию в набор структурированных событий: определить тему, регион и более точную локацию, а затем составить короткое описание.
Это делает LLM. Всё, что происходит дальше — географическая привязка, дедупликация и доставка, — работает уже с результатом этого преобразования.
Один пост может породить несколько событий в разных местах или не породить ни одного. Поэтому после этого этапа основным объектом системы становится событие, а не исходная публикация.
При обработке одного сообщения модель выполняет несколько задач:
-
Проверяет релевантность публикации выбранной теме.
-
Извлекает пары «регион + локация». Одна публикация может описывать события сразу в нескольких городах.
-
Формулирует краткое описание, которое увидит пользователь.
-
Проверяет локацию: действительно ли событие произошло в указанном месте или оно лишь упомянуто в тексте.
-
Выступает арбитром в неоднозначных случаях дедупликации.
Промпты настраиваются отдельно для каждой категории и хранятся в Postgres. Их можно менять без правки кода приложения, поэтому добавление новой категории опасности в основном сводится к настройке инструкций и схемы результата.
При этом значительная часть сложности оказалась вокруг самих вызовов LLM. Для них предусмотрены тайм-ауты, резервная модель и повторные попытки с экспоненциальной задержкой. Это нужно потому, что внешний API может отвечать медленно, временно быть недоступным или вернуть результат, не соответствующий ожидаемой схеме.
Дедупликация
Одно событие за короткое время могут описать десятки каналов. Если каждую публикацию превратить в отдельное оповещение, пользователь получит десятки сообщений об одном и том же.
Сравнивать исходные тексты напрямую недостаточно. Один источник может написать о «взрывах в районе промзоны», другой — о «работе ПВО над городом». Формулировки сильно различаются, хотя речь может идти об одном событии.
Поэтому дедупликация состоит из двух уровней. Сначала эмбеддинги быстро отбирают потенциально похожие события. Сравнение идёт по семантической близости текста, поэтому дословное совпадение не требуется.
Затем мы сравниваем локации событий — подробнее об этом в следующей главе. Проверять географию отдельно необходимо: семантически практически одинаковые сообщения из разных городов нельзя объединять.
Найденный дубль не удаляется, а добавляется к существующему событию как дополнительный источник. Если новая публикация уточняет информацию, уже созданное оповещение может быть обновлено.
Геокодирование: OSM, PostGIS и ltree
После извлечения LLM может вернуть строку вроде «Шебекино». Географический модуль должен превратить её в структуру, позволяющую решить две задачи: определить, каким пользователям относится событие, и сравнивать географию событий при дедупликации.
Сравнивать названия как строки неудобно. «Шебекино» и «Шебекинский городской округ» могут относиться к одной территории, а одинаковые названия населённых пунктов встречаются в разных регионах.
Поэтому и место события, и выбранная пользователем территория приводятся к единому представлению — пути в дереве административных границ.
Россия
└── Краснодарский край
    ├── Туапсе
    └── Сочи
        └── Центральный район
Путь строится в два этапа. Сначала название проходит через Google Maps. Геокодер нормализует его и возвращает дополнительную информацию: официальное название, регион, город и координаты. Это помогает в случаях, если в посте было указано конкретное место в городе без адреса: например, если будет локация «ТЦ Европейский», Google Maps поймет, что это находится в Москве и определит точный адрес.
После этого по нормализованным данным ищется соответствующая территория среди административных границ OpenStreetMap. Полигоны хранятся в PostGIS, а получившаяся цепочка административных уровней — в Postgres как ltree.
Подбор получателей после этого сводится к сравнению путей. Например, подписчик на Краснодарский край должен получать события из Туапсе. Пользователь, выбравший Туапсе, должен получать и события, релевантные для территории всего края.
Та же структура используется при дедупликации. Если два текста очень похожи, но соответствуют разным ветвям географического дерева, система оставит их отдельными событиями.
Здесь есть важное исключение. Путь города лежит внутри пути региона, то есть формально они на одной ветви дерева — но событие «во всём регионе» и событие «в конкретном городе» этого региона мы намеренно не считаем одним. Некоторые пользователи могут обращать мало внимания [2] на объявление беспилотной опасности во всем регионе, т.к. вероятность попадания дрона в их конкретный населенный пункт мала. Поэтому если появляется информация про конкретный населенный пункт пользователя, ему нужно прислать оповещение еще раз.
Если к существующему событию добавляется дубль, локация которая более широкая, система дополнительно находит пользователей новой территории и отправляет оповещение им. У тех, кто уже получил событие, обновляется существующее сообщение; остальным оно отправляется впервые.
Как лимит Telegram стал частью архитектуры
Telegram Bot API ограничивает скорость отправки 30 сообщениями в секунду на одного бота. При нескольких тысячах получателей одного оповещения (а сейчас в боте 15 тысяч пользователей) это быстро становится узким местом, задержка может достигать нескольких минут.
Наше основное решение проблемы — использовать несколько ботов. Поскольку ограничение применяется к каждому отдельно, суммарная пропускная способность увеличивается вместе с их количеством. Новые пользователи Мигалки распределяются между ними автоматически: основной бот, которого пользователь запустил впервые, дает ссылку на другого бота. По сути, горизонтально масштабируется сам слой доставки.
Кроме этого, конечно, мы используем общую очередь исходящих сообщений. Она поддерживает приоритеты: вовремя отправить новое оповещение важнее, чем добавить источник к существующему. Основная задача такого планировщика — централизованно учитывать rate limits. Делать это независимо в каждом worker неудобно: воркеры не знают, сколько сообщений остальные процессы уже отправили через конкретного бота. Для очереди мы используем Redis, а часть информации записываем в Postgres.
В текущей конфигурации средняя задержка между появлением исходной публикации и доставкой составляет около минуты. За это время система успевает выполнить несколько вызовов модели, геокодирование, дедупликацию, подбор пользователей и собственно доставку.
Пользовательские сообщения и распределённая верификация
До сих пор речь шла о постах из каналов. Но у Мигалки есть и второй источник — сами пользователи: иногда человек слышит работу ПВО или замечает облаву раньше, чем об этом напишет любой канал. Для этого в боте и есть кнопка «Сообщить о происшествии». Такие сообщения обязательно проходят верификацию другими пользователями.
Пользователь нажимает «Сообщить о происшествии» и кратко описывает ситуацию. Сообщение проходит тот же конвейер, что и публикации из каналов: тематическую фильтрацию, извлечение события и проверку локации. Если система обнаруживает дубль, репорт становится дополнительным источником уже известного события. Для нового события запускается проверка другими пользователями.
Проверяют репорты верификаторы — обычные пользователи, согласившиеся оценивать чужие сообщения. Когда человек уже какое-то время пользуется ботом, бот спрашивает, готов ли пользователь помогать проверять сообщения других, — с кнопками «Да» и «Нет». Ответивший «Да» попадает в пул проверяющих; передумать и изменить ответ можно в любой момент в настройках.
В проверке участвуют несколько верификаторов из того же региона. Они видят текст сообщения, но не знают автора, и голосуют одной из трёх кнопок: ✅, ❌ или «не знаю». Вариант «не знаю» нужен, чтобы следить, кто из верификаторов остаётся активным. Система со временем отключает тех, кто часто игнорирует запросы на верификацию.
Если через пять минут сообщение получило хотя бы одно подтверждение и ни одного возражения, оно считается проверенным и уходит в рассылку. В остальных случаях раунд продолжается до 15 минут.
Такая проверка отсеивает бессмысленные и заведомо неправдоподобные сообщения, но не гарантирует истинность каждого репорта. Для Мигалки этот баланс оправдан: цена пропущенного или запоздавшего верного оповещения выше, чем ложного срабатывания.
То же сообщество ловит ошибки
Проверка продолжается и после отправки события. Пользователь может сообщить об ошибке [3] в любом полученном оповещении. Для этого нужно не только нажать кнопку, но и написать пояснение.
Пояснение автоматически проверяется на осмысленность через LLM. Если число сообщений об ошибке недостаточно для принятия решения, событие отправляется на дополнительное голосование верификаторам.
Это позволяет использовать распределённую аудиторию как дополнительный слой контроля качества автоматического конвейера. Как и с верификацией пользовательских происшетсвий, мы делегируем проверку качества сообществу, без модератора в этом пайплайне. Тем более, ошибку быстрее обнаружит человек, находящийся непосредственно в соответствующей местности, чем это сделал бы модератор из другого города.
Приватность
Идентификаторы пользователей относятся к чувствительным данным. Поэтому они защищены не только TLS и правами доступа к базе, но и шифрованием на уровне приложения.
Обычное вероятностное шифрование затрудняет поиск по базе: одно и то же значение при каждом шифровании даёт новый шифротекст. В «Мигалке» используется детерминированное шифрование, при котором одинаковым исходным значениям соответствует одинаковый результат. Благодаря этому сохраняются поиск по равенству и уникальные индексы.
Мы шифруем идентификаторы пользователей Telegram и токены ботов. Внутренние идентификаторы, связывающие таблицы, остаются открытыми: сами по себе они не раскрывают личность.
Пользователь может удалить все свои данные из бота по специальной команде. В этом случае данные полностью анонимизируются: зашифрованные идентификаторы удаляются из базы, переписка с командой (если она была) удаляется из внутреннего чата команды.
Что получилось
За время работы системы через конвейер Мигалки [4] прошло около 150 тысяч событий, а слой доставки отправил больше 12 миллионов сообщений. При таком объёме наиболее важными оказались несколько решений.
Во-первых, LLM удобно использовать как один из этапов ETL, но вокруг неё всё равно приходится строить обычную отказоустойчивую инфраструктуру: ретраи, тайм-ауты и контроль параллелизма.
Во-вторых, дедупликацию текста нельзя рассматривать отдельно от географии. Высокая семантическая близость ничего не говорит о том, произошло ли событие в том же месте.
В-третьих, ограничения внешнего API могут определить архитектуру целого слоя системы. В нашем случае лимиты телеграма привели к нескольким ботам, общей очереди и централизованному планировщику.
Наконец, для распределённой системы пользовательская верификация оказалась полезным дополнением к автоматической обработке. Она применяется и к сообщениям пользователей, и как механизм обратной связи для уже опубликованных событий. Сообщество справляется с ролью, которую в обычном медиапродукте выполняет редакция. Пользователи сообщают о происшествиях, проверяют репорты друг друга и находят ошибки системы. Для этого не нужен штат модераторов, а публикация не задерживается в ожидании ручного согласования.
Главный результат — 15 тысяч пользователей, которые получают оповещения бота Мигалки [5]. Больше 30% из них продолжают регулярно заходить в бота через 2 недели после регистрации (удержание пользователей мы измеряем с помощью фидбек-опроса). К сожалению, потребность [6] в таком продукте у людей сейчас есть.
Автор: AlesyaSokol
Источник [7]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/35551
URLs in this post:
[1] приходят: https://t.me/migalka_project/37
[2] внимания: http://www.braintools.ru/article/7595
[3] ошибке: http://www.braintools.ru/article/4192
[4] Мигалки: https://t.me/migalka_project
[5] бота Мигалки: https://t.me/migalka_alerts_bot
[6] потребность: http://www.braintools.ru/article/9534
[7] Источник: https://habr.com/ru/articles/1082204/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1082204
Нажмите здесь для печати.