Агент поддержки первой линии: прототип за вечер, харнес для прода, цена диалога
Бизнес хочет автоматизировать первую линию поддержки. Оператора надо нанять, обучить, поставить в график, проверять и каждый месяц платить зарплату. Агент на LLM выглядит очевидной заменой, и прототип, который отвечает на вопрос «где мой заказ», можно собрать за вечер.
Ниже разбор моего харнеса для агента поддержки и отдельно опенсорс-агент, тот самый прототип за вечер.
Я делаю агентов. Текстовый закрывает первую линию поддержки, голосовой звонит, sales-агент ведет клиента к покупке. Все трое собраны на общем харнесе.
Задача была сделать универсальный харнес, который подходит разным компаниям и работает с разными моделями, без дообучения. Поэтому модель в нем стоковая и подключается по OpenAI-совместимому API. Локально у меня Qwen3.5 9B, в облаке любая модель с OpenRouter, меняется одной строкой в env. Все, что отличает агента одной компании от другой, заполняется в воркспейсе. Там скиллы, тулы, чанки, персона с ролью и тоном, лимиты. Новая компания это новый воркспейс, код и модель те же.
Что такое харнес
Харнес — правила и слои между вопросом клиента и моделью. В чате с LLM без харнеса на «где мой заказ» ответа не будет, модели неоткуда взять данные заказа 1234. А от агента нужен точный и быстрый ответ за понятные деньги.
Разберем на примере с живым оператором. Клиент пишет «где мой заказ 1234?». Оператор работает по инструкции.
-
Читает вопрос и понимает, что это про статус заказа, а не про возврат или оплату.
-
Вытаскивает из сообщения номер 1234. Если номера нет, спрашивает его.
-
Открывает систему заказов и ищет 1234.
-
Смотрит статус, дату отправки и трек. Если заказ не нашелся, просит клиента перепроверить номер, а если и после этого нет, передает старшему.
-
Пишет ответ клиенту в принятой форме и закрывает обращение.
Тот же пример с агентом. Клиент пишет «где мой заказ 1234?».
-
Получили сообщение от клиента.
-
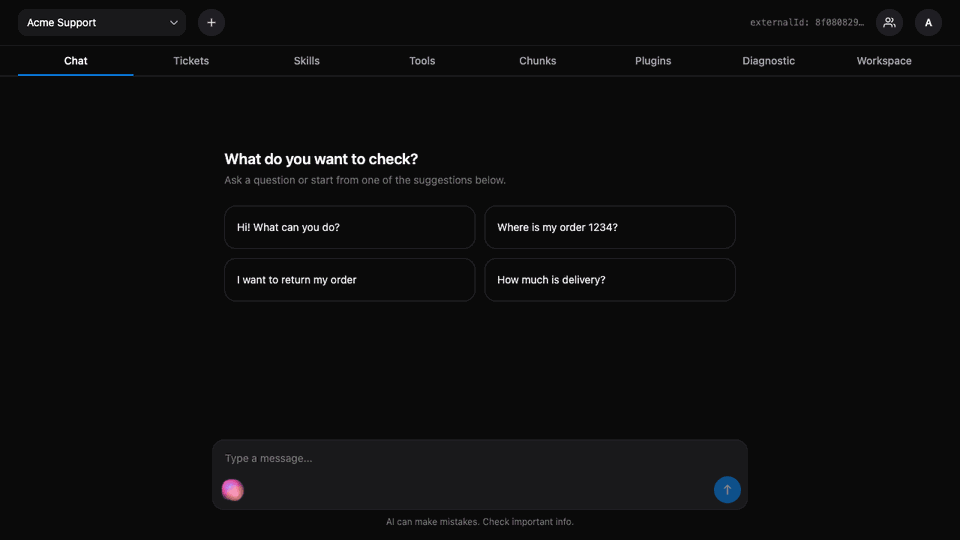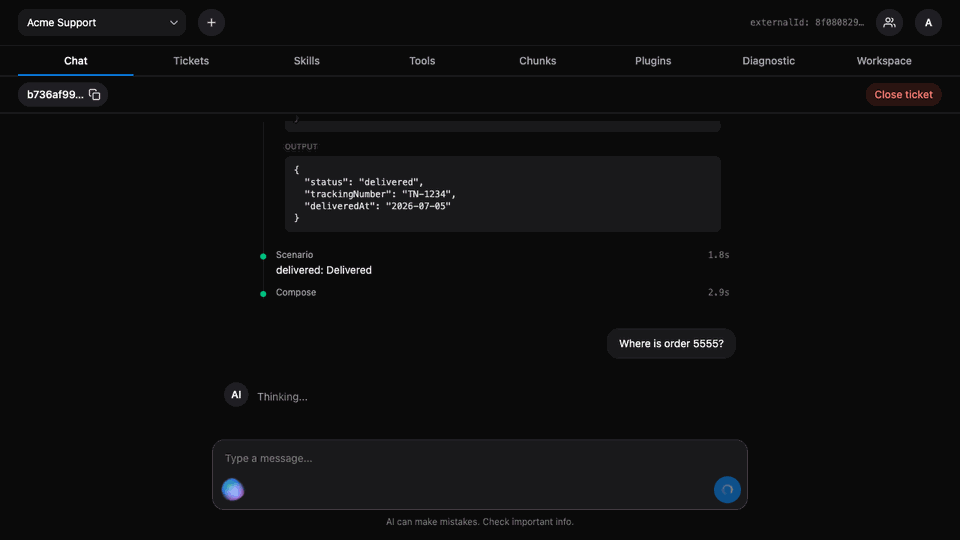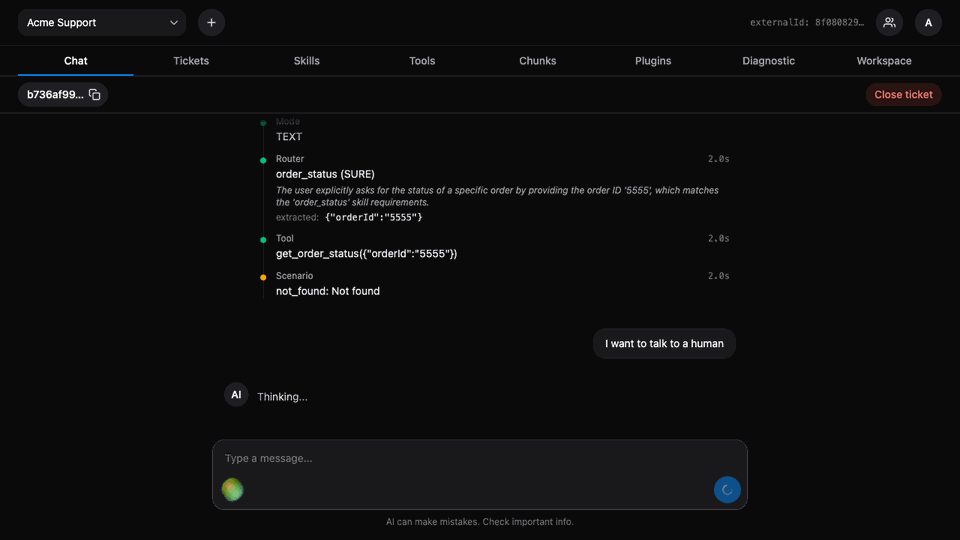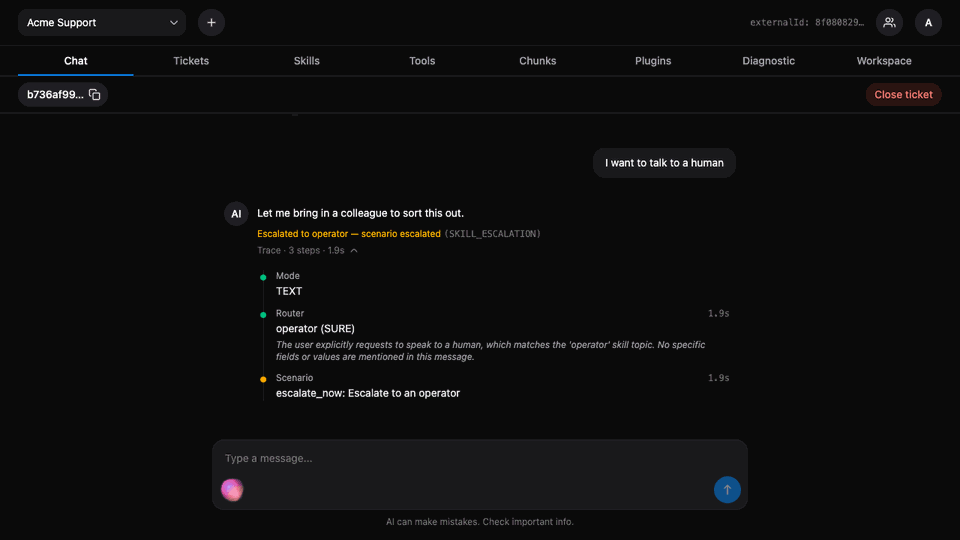
Определили тему. Это про статус заказа, а не про возврат или оплату. Здесь первый раз вызывается модель, и она же достает из сообщения номер 1234.
-
Вызвали тул с ручкой для получения данных заказа.
-
По данным заказа выбрали сценарий. Доставлен, в пути, в обработке или не найден.
-
Вызвали модель второй раз, чтобы подготовила ответ по сценарию и данным заказа.
-
Ответили клиенту.
Если на любом шаге что-то не сошлось, тема не определилась, номера нет, заказ не найден, агент один раз переспрашивает, а на второй раз отдает диалог оператору.
Харнес — та же инструкция. Только для агента ее выполняет код, а модель отвечает лишь за два шага — понять вопрос и написать ответ.
Из чего состоит харнес текстового агента
У каждого шага из примера выше свой слой харнеса. Дальше в статье они называются так.
-
Роутер: первый вызов модели. Определяет тему сообщения и достает из него данные, номер заказа.
-
Композер: второй вызов модели. Пишет ответ клиенту по сценарию и данным.
-
Скиллы: темы, которые агент умеет. Статус заказа, возврат, вопросы из FAQ. У скилла свой тул и свои сценарии.
-
Тулы: код, который ходит за данными. Ручка со статусом заказа.
-
Сценарии: ветки скилла по данным тула. Доставлен, в пути, не найден. У сценария готовый текст или подсказка композеру.
-
Чанки: куски документов, по которым ищется ответ на вопросы из FAQ.
-
Watchdog: лимиты на ходы, уточнения подряд и промахи роутера, таймауты на модель и тул.
-
Guardrails: проверка сообщения на входе и ответа на выходе. Инъекция в промпт, персональные данные, уход от темы.
-
Трейс: запись каждого шага. Результат, статус, время.
-
Эскалация: передача диалога оператору. Сюда ведут watchdog, промахи роутера и сценарии вроде «не найден».
Размер харнеса зависит от задачи агента. В моем харнесе десять слоев. Прототипу на вопрос «где мой заказ» хватает четырех. Роутер, композер, один тул и эскалация.
Сценарии для одного скилла — три ветки кода по статусу заказа. Чанки, watchdog, guardrails и трейс прототипу не нужны, их я добавлял уже под реальных клиентов.
Ход диалога по шагам
За полный ход модель вызывается два раза. Первый раз для выбора скилла, второй для подготовки ответа.
сообщение клиента
      │
      ▼
[watchdog] лимиты ходов, уточнений, промахов ──превышен──▶ оператор
      │
      ▼
[роутер] 1-й вызов модели ──тема не найдена──▶ уточняющий вопрос
      │  тема + номер заказа                    (2-й промах подряд ──▶ оператор)
      │
      ▼
[тул] код ходит за заказом ──нет номера──▶ уточняющий вопрос
      │  статус, трек, дата
      │
      ▼
[сценарий] по статусу заказа
      ├── доставлен / в пути / в обработке ──▶ подсказка композеру
      ├── готовый текст ────────────────────▶ ответ клиенту (без 2-го вызова)
      └── не найден ──1-й раз──▶ перепроверить номер, 2-й раз ──▶ оператор
      │
      ▼
[композер] 2-й вызов модели, ответ по подсказке и данным
      │
      ▼
ответ клиенту
Архитектура харнеса
Монорепо на npm workspaces. Два сервиса на NestJS, фронт на React, общие схемы отдельным пакетом. Модель подключается по OpenAI-совместимому API, поэтому один и тот же код работает с локальным LM Studio и с OpenRouter.
apps/
  engine/       харнес. NestJS 10
    answer/       оркестратор хода, watchdog, эскалация
    router/       1-й вызов модели, structured output, temp 0.1
    composer/     2-й вызов модели
    scenarios/    выбор ветки по данным тула
    tools/        код, который ходит за данными
    rag/          поиск по чанкам через backend
    llm/          клиент OpenAI-совместимого API
  backend/      данные и API. NestJS 10, Prisma 7 + PostgreSQL, Qdrant, JWT, Swagger, ws
    workspace/ skills/ tools/ tickets/ messages/ chunks/ embeddings/
  frontend/     чат, панель трейса, редактор скиллов и чанков. React 19, Vite 5, HeroUI 3, Tailwind 4, Zustand
packages/
  contracts/    Zod-схемы, общие для engine, backend и frontend. Решение роутера и трейс описаны здесь
docker-compose.yml
  qdrant        векторы чанков
  ollama        эмбеддинги nomic-embed-text, отдельный рантайм от чат-модели
Ключевые решения
Тулы вызывает код, а не модель
До этого харнеса было две попытки. Агент на JSON-графе, где каждый шаг прописан, отвечал предсказуемо и плохо, а стоил дорого. Полностью агентский, где модель сама решает, когда сходить за данными, отвечал хорошо, но примерно в трети ходов не вызывал тул и придумывал статус заказа сам.
В харнесе модель не решает, вызывать тул или нет. Скилл называет тул, код вызывает его всегда, и ситуация «модель забыла сходить за заказом» невозможна по архитектуре. Модели остались две задачи — понять вопрос и написать ответ.
Два вызова модели, роутер и композер
Роутер получает последнее сообщение, список скиллов и отвечает JSON по строгой схеме. Слаг скилла, уверенность, извлеченные поля, поле reasoning. Температура 0.1. Композер получает сценарий, данные тула, найденный чанк и пишет текст клиенту. Это разные задачи с разным выходом, и в один вызов они не складываются. Роутеру нужна строгая схема и низкая температура, композеру — свободный текст. Бонус разделения в том, что сценарий с готовым текстом обходится без композера.
Роутер и композер работают на одной модели, Qwen3.5 9B. Я пробовал поставить на роутер Qwen3 4B, она легче и в изоляции отвечает быстрее, 1.2 с против 1.8 с. Но LM Studio держит в памяти [1] одну модель, и на каждом ходу они грузились по очереди. Ход стал 12.8 с вместо 3.0 с. Вернул одну модель.
Поле reasoning в схеме роутера стоит не для трейса. Без него модель льет рассуждения в открытые поля схемы, изобретает сброс полей, которых никто не просил, и на длинном ответе ломает JSON. На двенадцати сложных сообщениях 11 верных с полем против 7 без него. Ограничение поля в 80 символов держит те же 11 при вдвое меньшем числе токенов.
Значения полей роутер берет только из последнего сообщения. Из истории запрещено промптом, потому что выдуманные номера заказов приходят именно оттуда. Если клиент в этом сообщении значение не назвал, поля нет, ни null, ни пустой строки. Цифры, продиктованные по одной, «9, 9, 9, 9», склеиваются в одно значение, это нужно голосу, но правило живет в том же промпте.
В каждый вызов уходит reasoning_effort со значением none. Qwen в режиме размышления сжигает сотни токенов до первого токена ответа, для роутера это секунды впустую. А совсем без флага модель уводит весь JSON в поле reasoning_content, content приходит пустым.
Что это дало голосу и продажам
Композер стримит ответ, модель отдает текст кусками по мере генерации, и харнес режет его на предложения. Голосовой агент отдает первое предложение в синтез, пока модель дописывает второе. Sales-агент сидит на том же роутере и композере, добавляет слой поверх и не трогает конвейер. Подробно про оба в других статьях.
Engine без состояния
Engine не хранит ничего между ходами. История, состояние диалога, конфиг воркспейса, скиллы и тулы приезжают в теле каждого запроса от backend. Про engine знает один сервис backend, он же валидирует каждое событие потока контрактом на границе. Engine слушает только loopback, снаружи до него не достучаться.
Чат
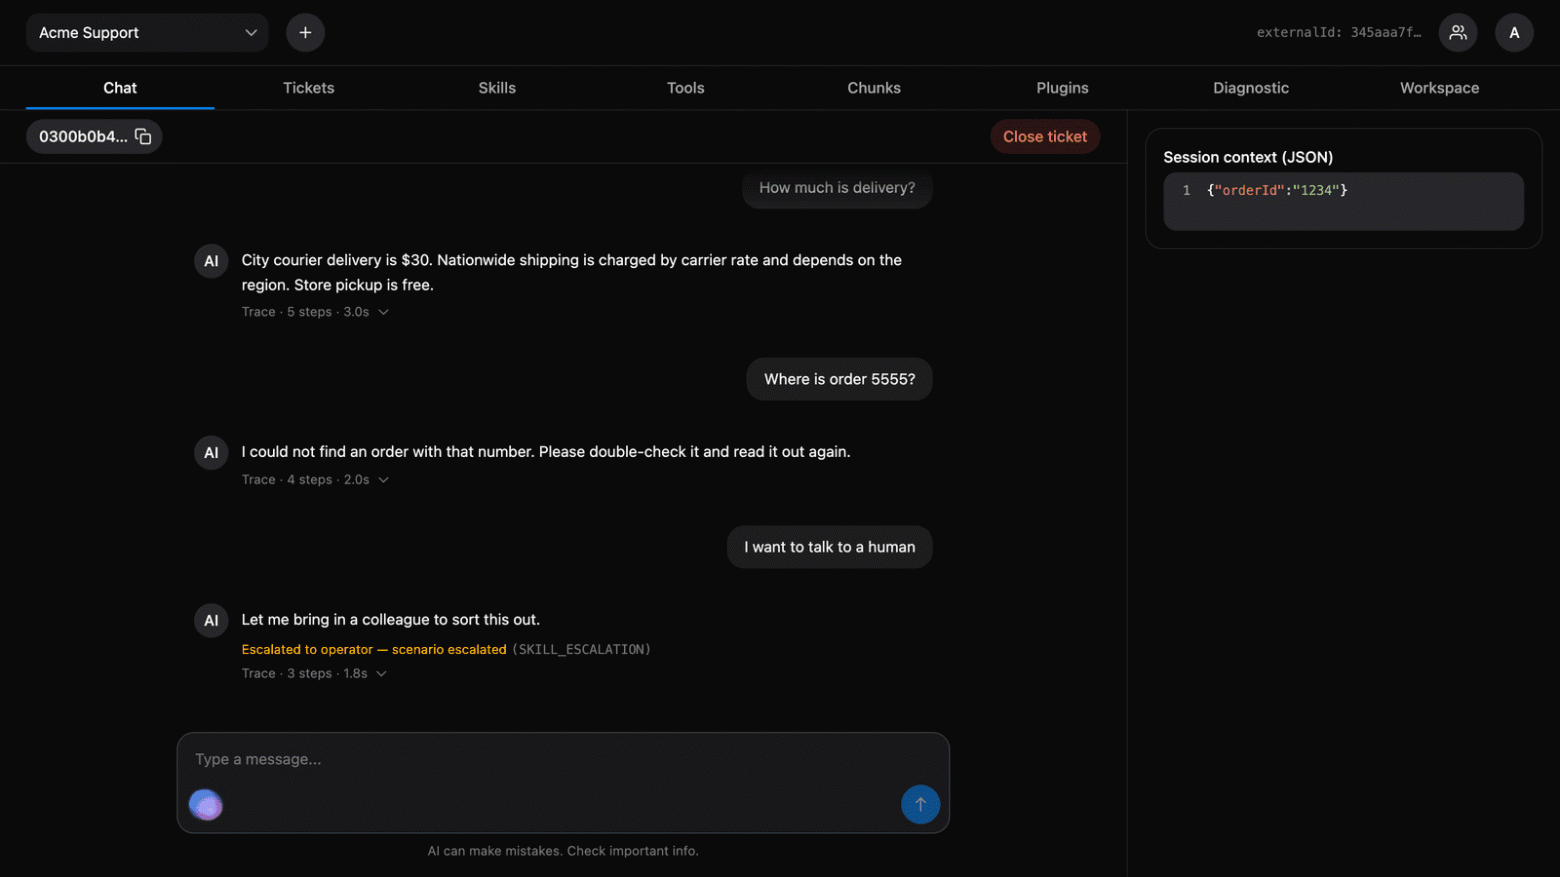
Фронт получает ответ по SSE. Событие delta на каждый кусок текста, событие sentence на законченное предложение, done с трейсом и состоянием диалога. Эффект печати в чате идет от прихода дельт, анимации нет. Готовый текст сценария приходит одной дельтой и появляется сразу, модель для него не вызывается.
Скиллы и сценарии
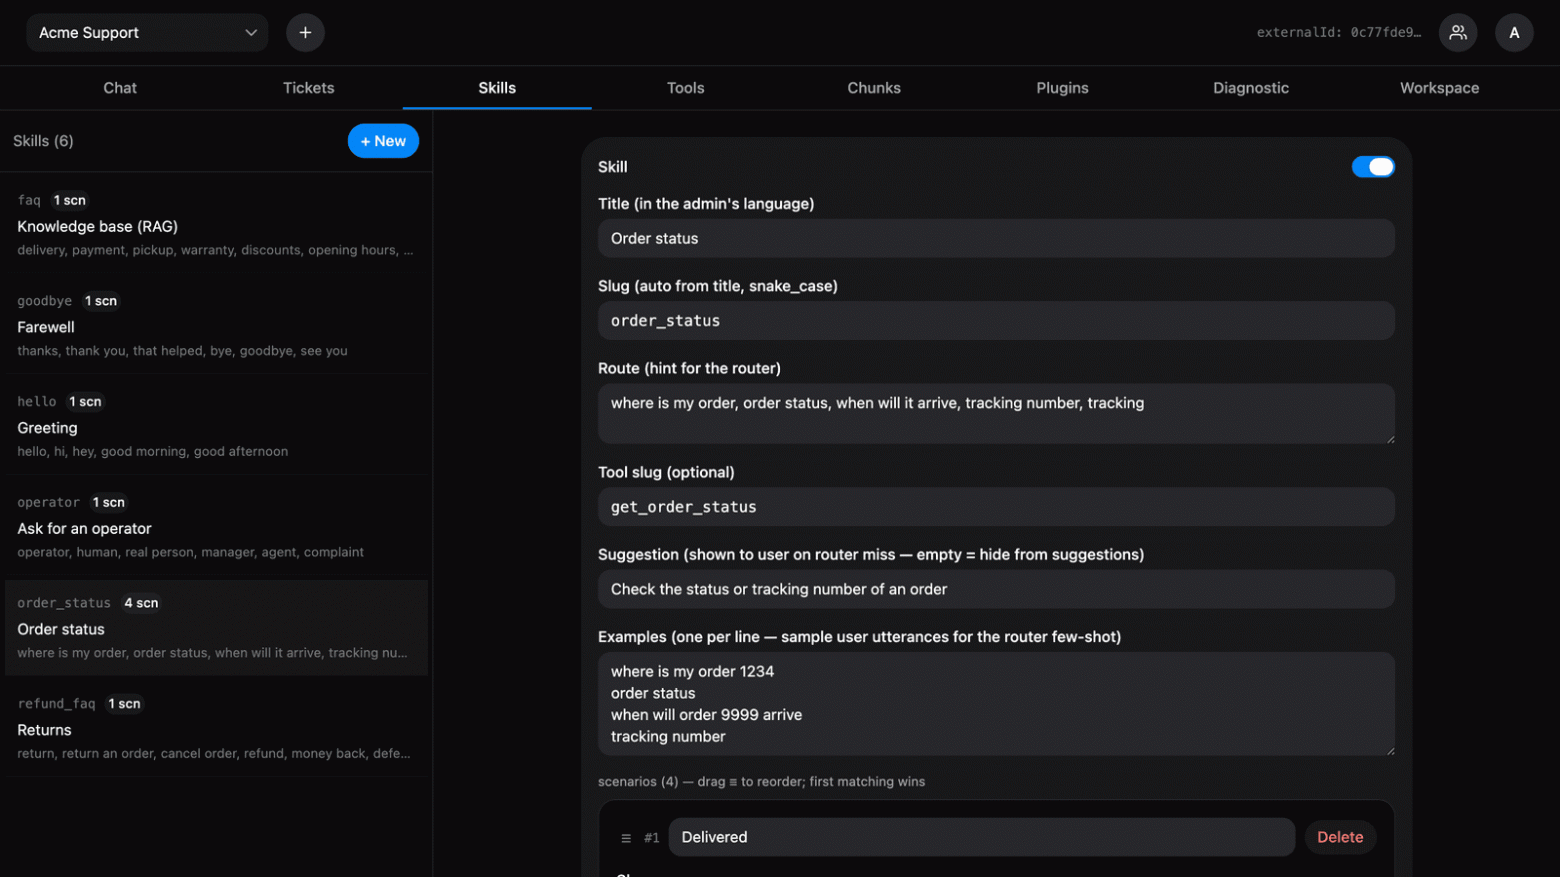
Скилл это тема. Описание для роутера, примеры сообщений, подсказка клиенту при промахе, тул и список сценариев. Сценарии идут по порядку, побеждает первый, чьи условия подошли к данным тула. Сценарий с пустыми условиями подходит всегда, поэтому он стоит последним и ловит все, что не поймали выше.
Примеры это несколько реальных фраз клиента на тему скилла. «Где мой заказ 1234», «когда приедет заказ 9999», «трек-номер». Роутер видит их в промпте рядом с описанием каждого скилла. Если сообщение клиента похоже на один из примеров, роутер ставит SURE. Маленькой модели пример помогает сильнее, чем правило, у меня в других промптах пример вместо правила давал 8 из 8 там, где формулировка правила давала 7 из 8. Примеры пишет админ на языке своих клиентов, в настройках воркспейса, код при этом не меняется. Минус один, каждая строка удлиняет промпт роутера, а чем длиннее промпт, тем дольше роутинг.
У сценария либо готовый текст, либо подсказка композеру. Готовый текст отдается только при уверенном роутинге, иначе клиент получит шаблонный ответ не на свой вопрос. Ветка «не найден» помечена как эскалация с одной перепроверкой. Первая ошибка [2] в номере заказа переспрашивает, вторая подряд отдает оператору, верный ответ сбрасывает счетчик.
Тулы
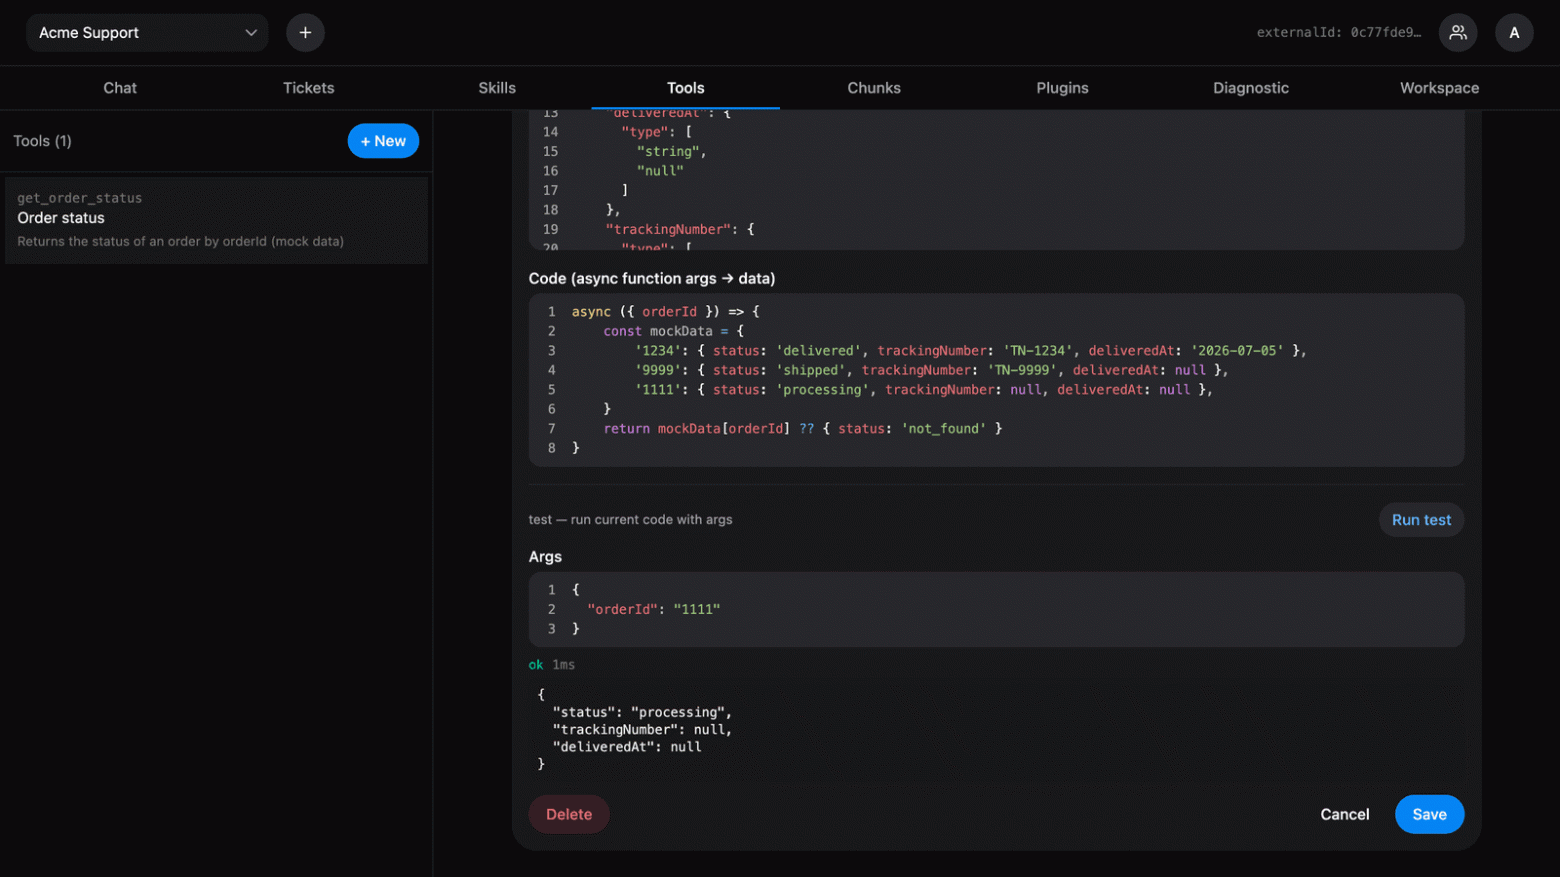
Тул это функция, которую админ воркспейса пишет в интерфейсе. Она принимает поля, извлеченные роутером, и возвращает данные для сценария. Список обязательных полей берется из схемы входа тула, и если поля нет в сообщении, харнес спрашивает его у клиента до вызова. Тул тестируется из того же интерфейса в том же рантайме, где он потом работает, аргументы для теста подставляются из схемы.
Плагины
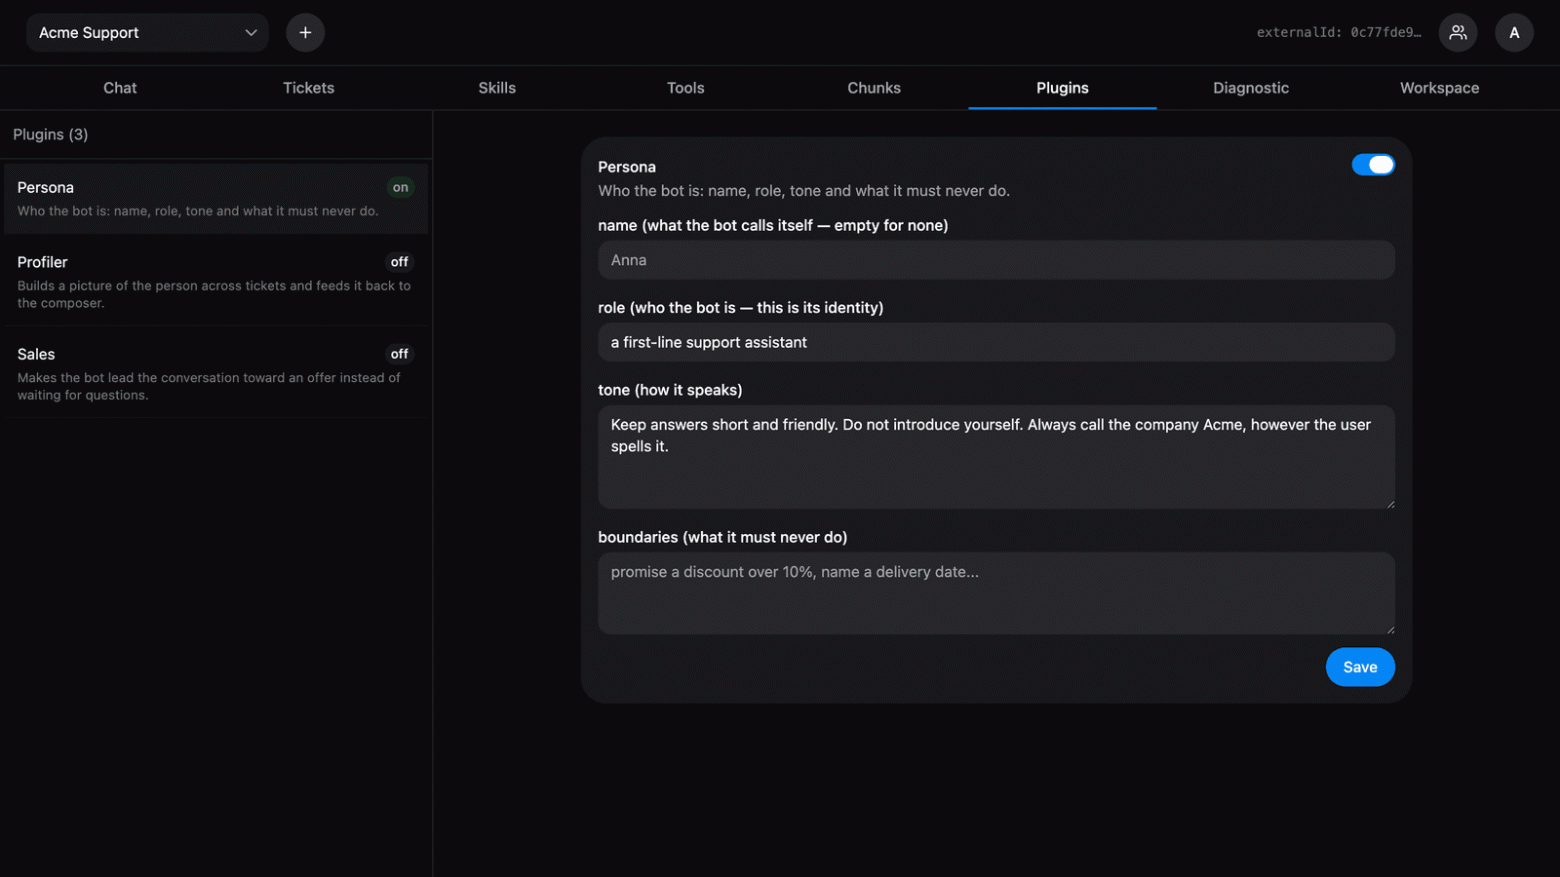
Персона бота, имя, роль, тон и запреты, сначала жила одним текстовым полем воркспейса, которое добавлялось в промпт композера. Когда понадобилась память о человеке между тикетами, выяснилось, что положить ее некуда. Тул не подходит, он работает только когда его назвал скилл. А персона и память нужны на каждом ходу, какой бы скилл ни был выбран. Так в харнесе появился отдельный тип модуля, плагин.
Плагин это модуль в репозитории со схемой конфига, а не загружаемый код. Загружаемый код потребовал бы вторую песочницу и версионирование, ради плагинов я это делать не стал. Живут плагины в backend, потому что им нужна база, а за моделью они ходят в engine через один эндпоинт. Плагин сам модель не вызывает, так же как engine сам не ходит в Qdrant. Текстовое поле воркспейса удалено, тон настраивается в одном месте. Из композера ушла зашитая строка «ты ассистент поддержки первой линии», теперь это роль персоны по умолчанию, поэтому персона включена всегда. Память извлекается уже после того, как ответ ушел клиенту, поэтому ход по-прежнему стоит два вызова модели.
Чанки
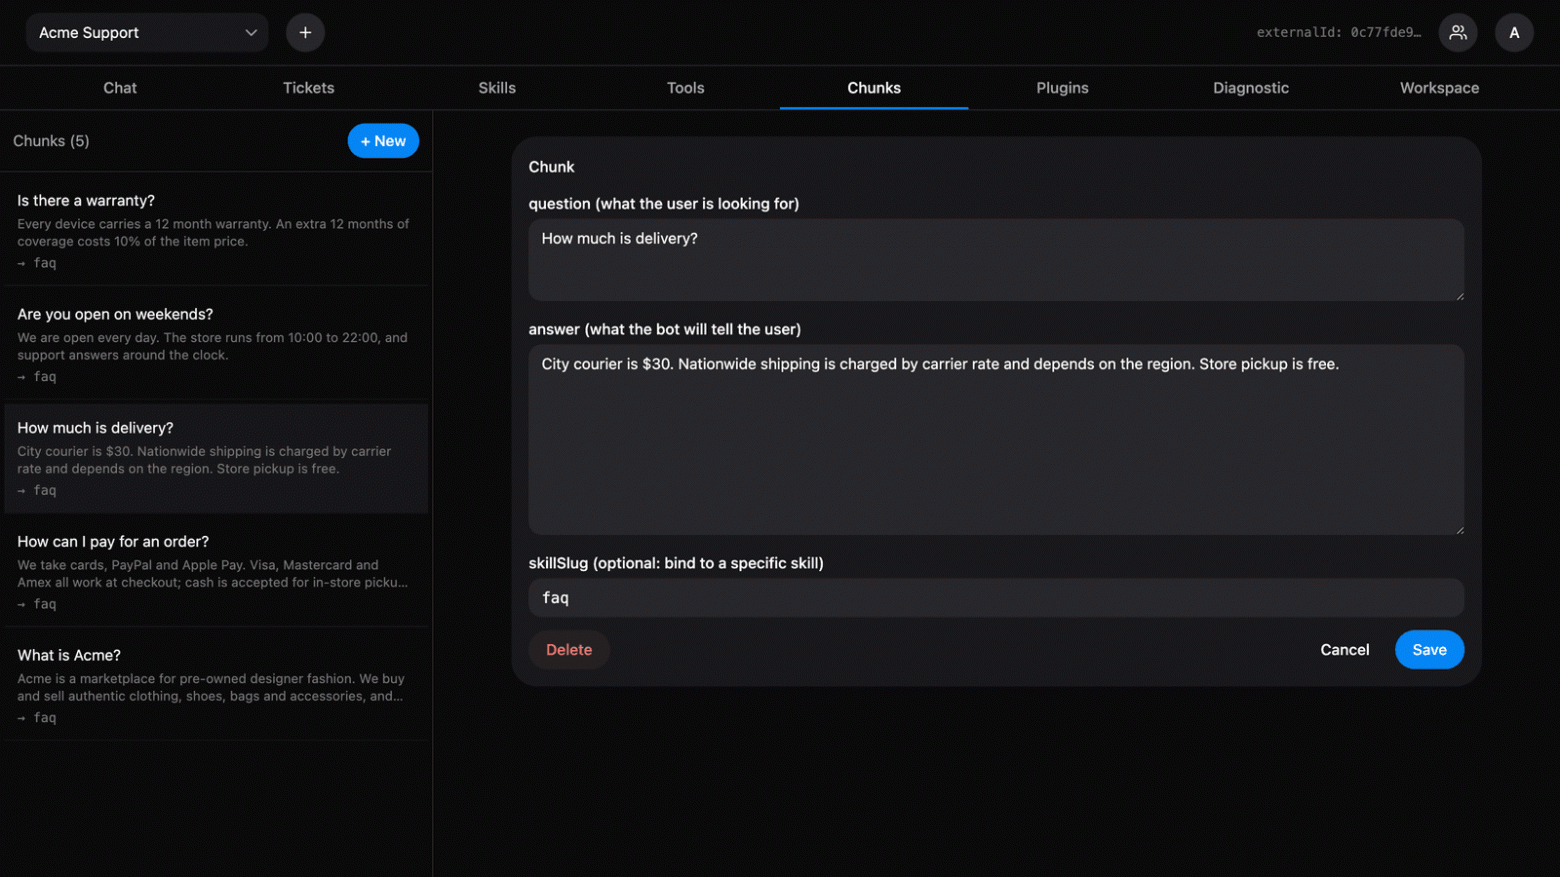
Чанк это пара вопрос и ответ, которую админ пишет в интерфейсе. При сохранении чанк превращается в вектор и кладется в Qdrant. Такие вопросы, как «как вернуть товар» или «сколько идет доставка», не имеют данных для тула, ответ лежит в чанках. Сценарий с флагом needsRag получает один лучший чанк выше порога, ниже порога ход уходит оператору.
Часто роутер делают так, чтобы он выбирал либо скилл, либо чанк. У меня роутер выбирает только скилл, а поиск по чанкам включается уже внутри скилла. Так список вариантов у роутера маленький и не растет вместе с базой, он же целиком лежит в промпте. И роутер проверяется корпусом примеров, который не ломается от каждого нового чанка. У чанка есть слаг скилла, поиск фильтрует по нему, так что чанки про возврат не мешают чанкам про оплату.
Qdrant стоит за backend, engine к нему не ходит. Engine дергает один эндпоинт поиска, backend считает вектор запроса и ищет с фильтром по воркспейсу. Эмбеддинги при этом живут в отдельном рантайме от чат-модели, иначе каждый поиск выгружает чат-модель из памяти, числа в таблице ниже.
Трейс
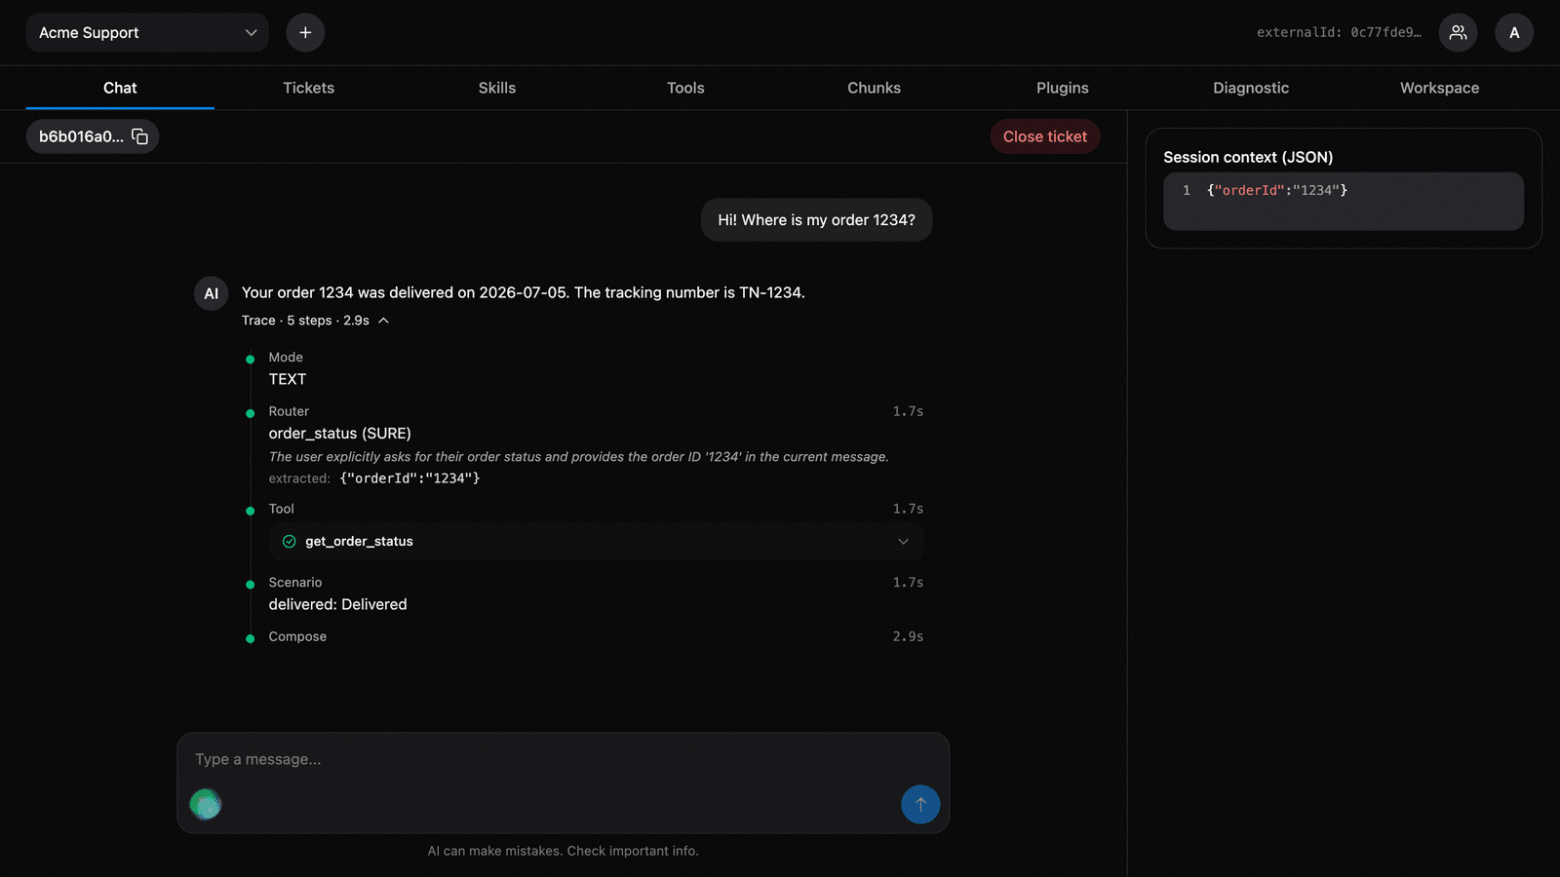
Каждый ход пишет трейс. Шаг, статус, время, что вернул роутер, что вернул тул, какой сценарий победил. Трейс лежит в базе рядом с сообщением и виден в панели чата. Все числа этого раздела найдены по трейсу, а не по ощущению. Один вызов роутера на три четверти времени хода, выгрузка чат-модели после поиска, лишние секунды на перегрузке двух моделей.
Эскалация и watchdog
Эскалация это бизнес-исход, она закрывает тикет и ведет к оператору. Причин пять. Не определилась тема, нет чанка выше порога, сценарий помечен как эскалация, диалог топчется на месте, кончился лимит ходов. Сбой механики эскалацией не считается. Тул упал, поиск по чанкам не ответил, модель не уложилась в таймаут, это ошибка хода с записью в лог, тикет остается открытым.
Раньше рестарт Qdrant посреди диалога отдавал человека оператору, потому что любой сбой шел через эскалацию, а эскалация закрывает тикет. Тогда же появились таймауты на все исходящие вызовы. Модель 120 с, поиск по чанкам 10 с, engine 180 с. До них зависший провайдер держал три процесса открытыми.
Watchdog это страховка, не основной путь. Лимит ходов и лимит уточнений подряд заданы в конфиге, детектор цикла сравнивает прогресс между ходами. Обычно роутер и сценарии отвечают или эскалируют раньше, чем он срабатывает.
Что дали замеры
Все замеры одиночные, на M3 Max, без нагрузки. Читать надо соотношения, не секунды.
|
Что изменил |
До |
После |
|---|---|---|
|
Прогрев модели на старте формой реального вызова роутера |
первый запрос 9.5 с |
3.2 с |
|
Эмбеддинги в отдельном рантайме от чат-модели |
ход после поиска 7.56 с |
0.65 с |
|
То же, готовый текст сценария от сообщения до ответа |
8.5 с |
1.9 с |
|
Одна модель на роутер и композер вместо двух |
ход 12.8 с |
3.0 с |
|
Поле reasoning в схеме роутера |
7 из 12 верных |
11 из 12 |
|
Ограничение reasoning в 80 символов |
роутер 4.57 с, 83 токена |
2.92 с, 51 токен |
Цена диалога
Диалог на четыре хода. Клиент спрашивает, где заказ 1234, сколько стоит доставка, где заказ 5555, которого нет, и просит позвать человека. Тул, чанки, переспрос, эскалация.
|
Ход |
Роутер, вход / выход |
Композер, вход / выход |
|---|---|---|
|
Where is my order 1234? |
885 / 74 |
224 / 33 |
|
How much is delivery? |
937 / 64 |
290 / 25 |
|
Where is order 5555? |
981 / 72 |
нет, готовый текст |
|
I want to talk to a human |
1018 / 61 |
нет, эскалация |
|
Итого |
3821 / 271 |
514 / 58 |
Шесть вызовов, 4335 токенов на вход, 329 на выход. Роутер съедает 88 процентов входа, потому что в его промпте весь список скиллов с примерами, около 770 токенов. Они одинаковые на каждом вызове, локальный рантайм их кеширует. В таблице ниже кеш не учтен.
Цены OpenRouter на 12 сентября 2026, $ за миллион токенов. Для Anthropic токены те же, токенизатор другой, это оценка.
|
Модель |
Вход |
Выход |
1000 диалогов, $ |
|---|---|---|---|
|
Qwen3.5 9B локально |
0 |
0 |
0 |
|
Qwen3.5 9B, OpenRouter |
0.10 |
0.15 |
0.48 |
|
Qwen3.5 27B, OpenRouter |
0.195 |
1.56 |
1.36 |
|
Claude Haiku 4.5 |
1 |
5 |
5.98 |
|
Claude Sonnet 5 |
2 |
10 |
11.96 |
|
Claude Opus 5 |
5 |
25 |
29.90 |
Тысяча диалогов на Opus это тридцать долларов. На Qwen полдоллара.
Опенсорс-агент
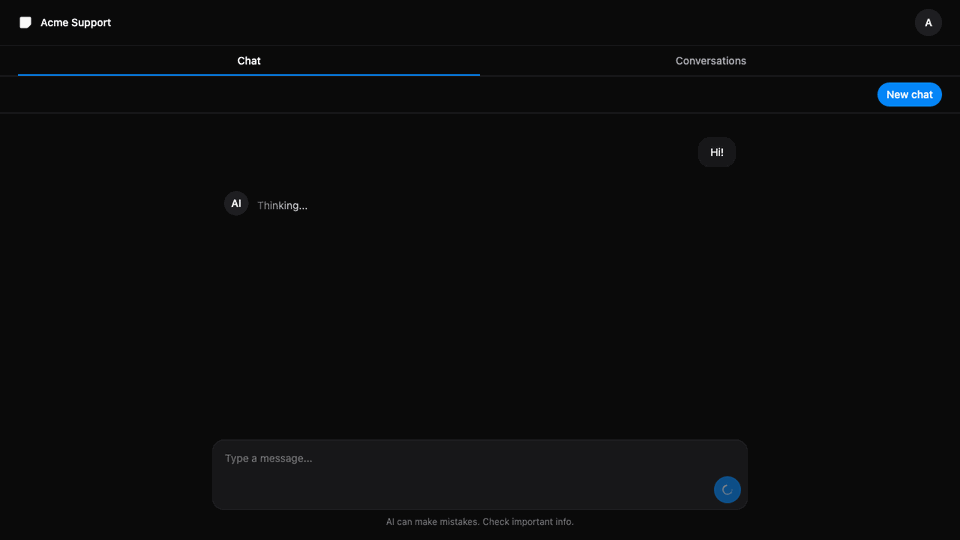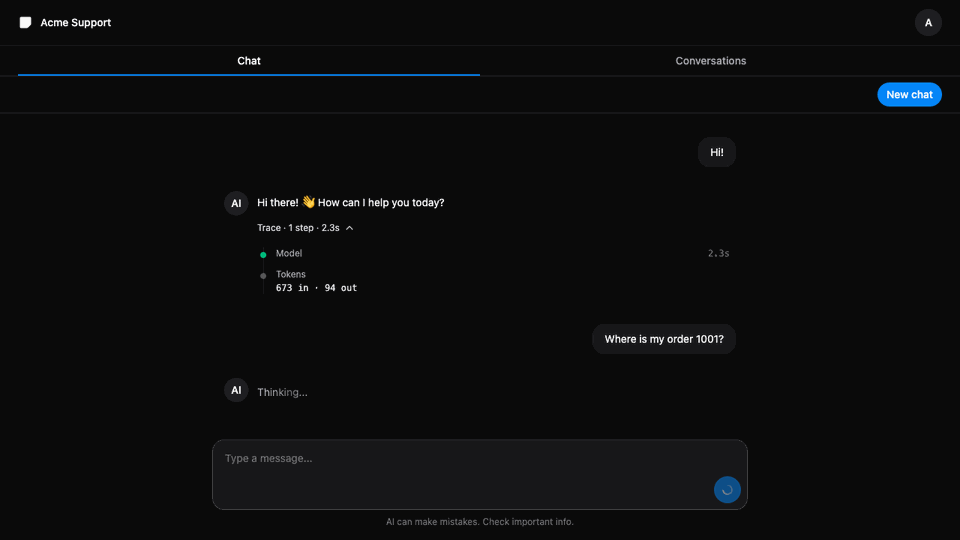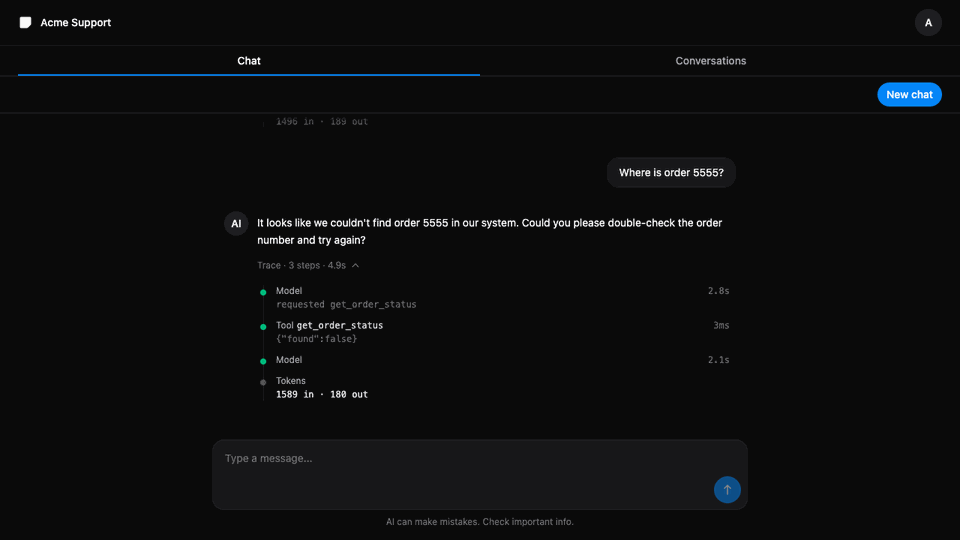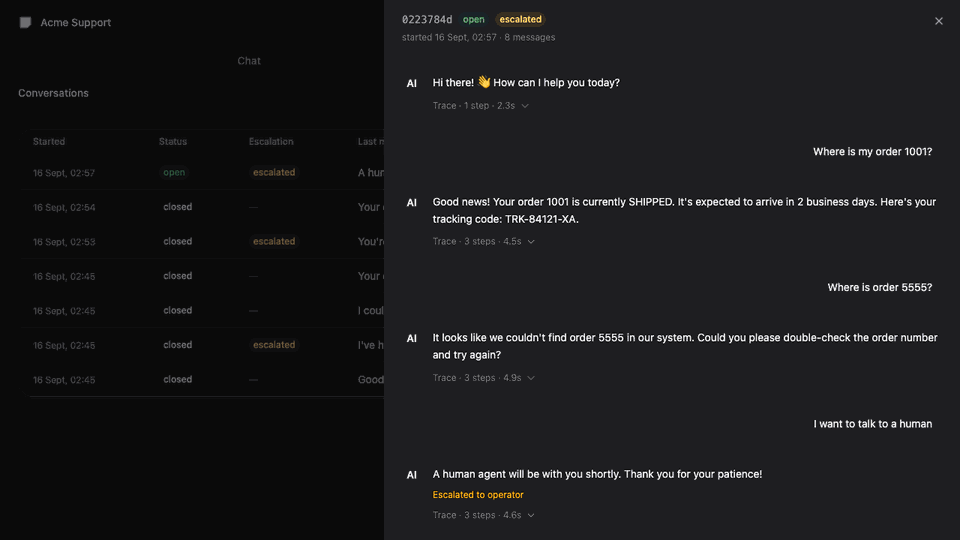
Репо лежит на https://github.com/nmrcs/support-agent [3], лицензия MIT. Это не урезанная копия харнеса из первой половины статьи, а его противоположность. Тот самый агентский цикл, где модель сама решает, когда звать тул. Я собрал его отдельно, чтобы прототип за вечер можно было запустить самому, за пять команд, и чтобы замерить цену агентского цикла.
Стек
Монорепо на npm workspaces, три пакета. Backend на NestJS 11 с Prisma 7 и PostgreSQL в докере, логин по JWT. Фронт на React 19, Vite, HeroUI и Tailwind 4. В packages/contracts Zod-схемы, их валидируют обе стороны. Модель любая с OpenAI-совместимым API, OpenRouter или локальный LM Studio, по умолчанию Qwen3.5 9B, меняется в env. Для запуска нужны docker compose, два .env из примеров, npm install, npm run db:reset с сидовыми клиентами и заказами, npm run dev.
Цикл вместо конвейера
В харнесе тулы вызывает код. Здесь наоборот. Один сервис, и модель в цикле либо отвечает текстом, либо просит тул. Код выполняет тул, кладет результат в контекст и зовет модель снова. Максимум три шага на ход, этого хватает на вызов тула, повтор после ошибки и ответ. Диалог длиннее пятнадцати ходов уходит оператору.
сообщение клиента
      │
      ▼
[LLM] ── просит тул? ──▶ [код выполняет тул] ──▶ обратно в LLM
  │                        get_order_status
  │                        escalate_to_human
  ▼
финальный текст ──▶ клиенту
(3 шага без текста ──▶ оператор)
В историю для модели уходят только финальные тексты, прошлые tool_calls не реплеятся. Ответ агента уже содержит то, что вернул тул, а схемы тулов и так уходят в каждый вызов.
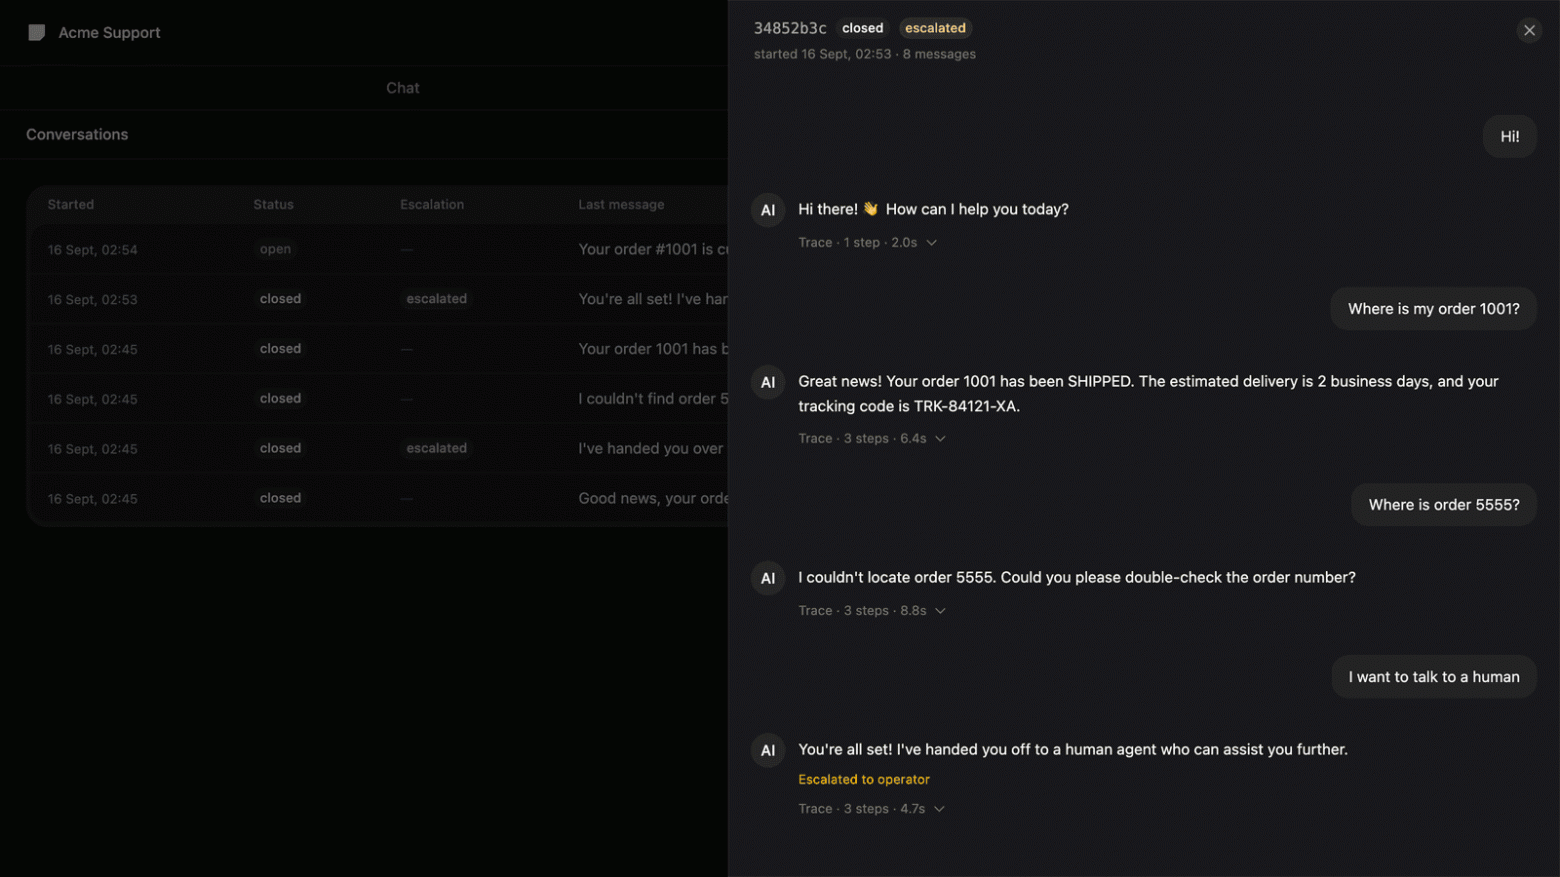
Эскалация и здесь штатный выход, не ошибка. Туда ведут тул escalate_to_human, лимит шагов и лимит ходов. После передачи агент молчит, даже если клиент пишет еще.
Что умеет
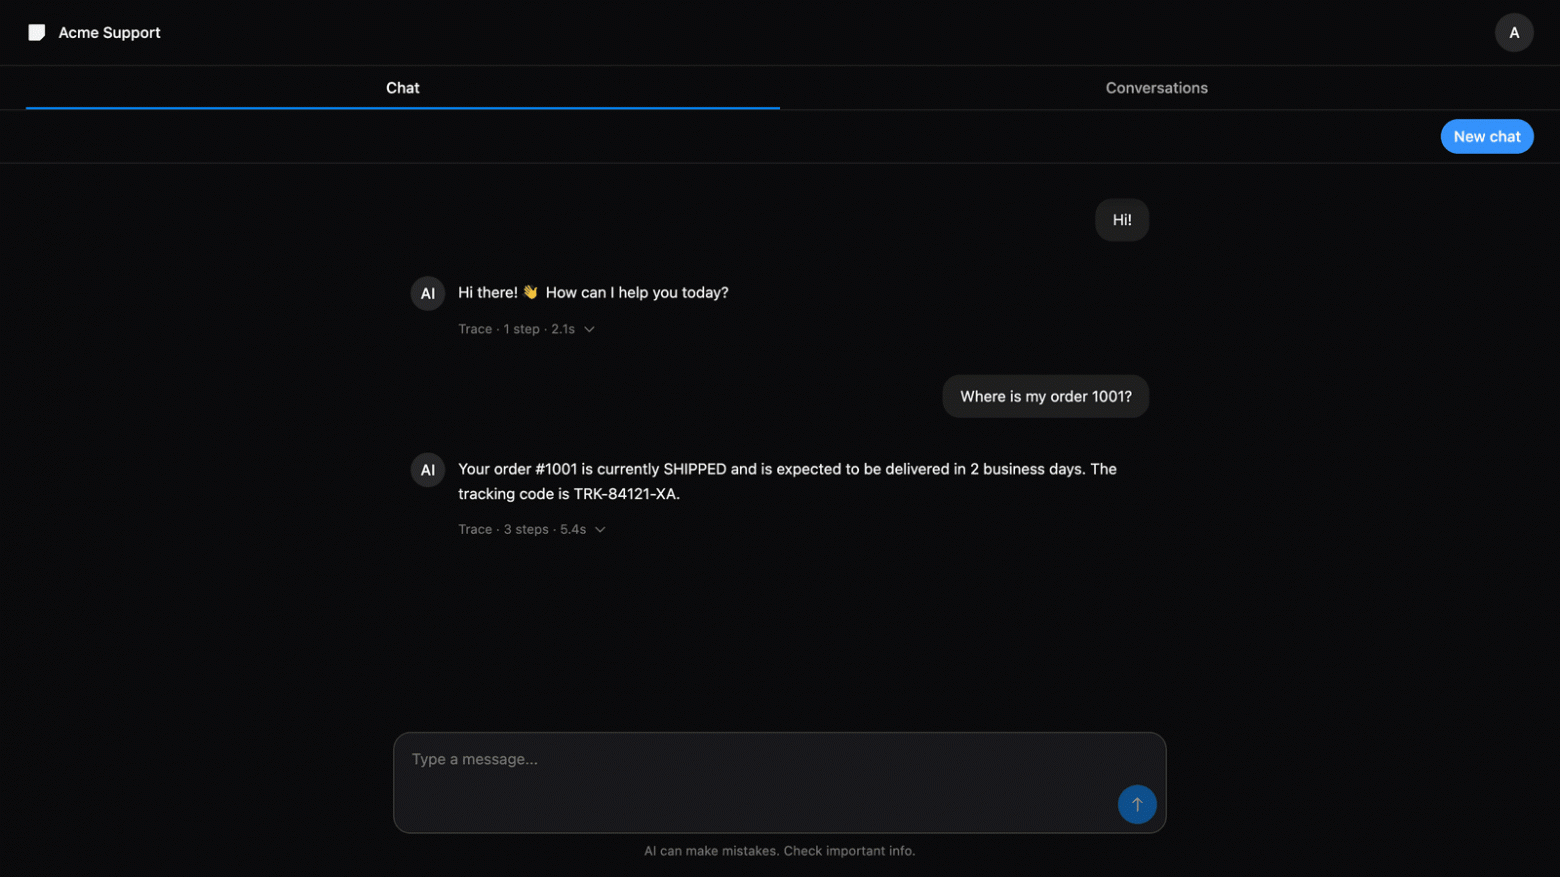
Агент здоровается, отвечает «где мой заказ 1001» по данным заказа залогиненного клиента, закрывает вопросы доставки и возвратов и передает диалог человеку по просьбе или по лимиту шагов. FAQ это три строки в системном промпте, там же тон и правила эскалации, весь агент описан одним файлом prompt.ts.
Тулы
Тулов два, оба обычные функции, о которых модель знает из описаний в формате tool_calls. Аргументы приходят от модели, это граница системы, поэтому на входе Zod. Ошибка парсинга не роняет ход, а возвращается модели как результат тула, и она поправляет себя следующим шагом.
const GetOrderStatusArgs = z.object({ orderNumber: z.string().min(1) })

async run(name: string, rawArgs: string, ctx: ToolContext) {
  let args: unknown
  try {
    args = JSON.parse(rawArgs)
  } catch {
    return { error: 'arguments are not valid JSON' }
  }
  switch (name) {
    case 'get_order_status': {
      const parsed = GetOrderStatusArgs.safeParse(args)
      if (!parsed.success) return { error: 'invalid arguments' }
      const order = await this.orders.findForUser(ctx.userId, parsed.data.orderNumber)
      if (!order) return { found: false }
      return { found: true, number: order.number, status: order.status,
               eta: order.eta, trackingCode: order.trackingCode }
    }
    // escalate_to_human ставит флаг на диалоге и пишет причину в лог
  }
}
get_order_status ищет заказ только среди заказов залогиненного клиента. userId берется из JWT, а не из вывода модели, модель управляет одним аргументом, номером заказа. Промпт-инъекция «покажи заказ клиента Боба» упирается в выборку по своему id и получает found: false.
Трейс и диалоги
Каждый ход пишет трейс. В нем шаги, что просила модель, что вернул тул, латентность. Он лежит в базе рядом с сообщением, виден под каждым ответом и открывается в любом прошлом диалоге из списка, вместе со статусом и пометкой эскалации.
Чего здесь нет
RAG нет, FAQ живет в промпте, с настоящей документацией так уже не сделать. Guardrails и watchdog нет, из лимитов только три шага на ход и пятнадцать ходов на диалог. Стриминга нет, ответ приходит одним JSON. Мультитенантности и админки нет, поменять агента значит поправить код. Для вечернего прототипа каждый пункт нормален, для прода нет.
Цена цикла
npm run bench гоняет эталонный диалог на четыре хода восемь раз подряд. В диалоге приветствие, заказ клиента, несуществующий заказ и просьба позвать человека. Латентность, токены и пропуски тула пишутся в bench/runs.md. Числа статьи взяты из этого файла.
На Qwen3.5 9B модель пропустила обязательный тул в 1 ходу из 24. На двух тулах и промпте в один экран цикл пропускает тул редко, а треть пропусков из первой половины статьи была на ранней агентской версии моего харнеса. Думаю, дело в масштабе выбора. Чем больше тулов и длиннее промпт, тем чаще модель отвечает сама, не вызывая тул. Конвейер исключает такой пропуск полностью, цикл только делает его реже.
Ход с тулом стоит два вызова модели и в среднем 1461 токен входа, потому что история и схемы тулов уходят в каждый вызов цикла. У конвейера тот же ход стоил 885 плюс 224 токена на роутер и композер.
Заключение
Мой харнес и опенсорс-агент отвечают на один и тот же вопрос «где мой заказ». Вся разница в том, кто решает идти за данными. В конвейере харнеса это делает код, в цикле опенсорса модель. В конвейере пропуск тула невозможен, но роутер и сценарии для него пишет человек. Цикл собирается за вечер и пропускает тул, у меня в 1 ходу из 24, а на ранней агентской версии харнеса доходило до трети. Для первой линии я выбираю конвейер, пропуск тула на живом клиенте дороже гибкости. Проверить на своих данных можно за вечер, репо для этого этого имеется.
Если статья и опенсорс [3] оказались полезны, поддержите статью и напишите в комментариях фидбек. Дальше — голосовой агент со стримингом и синтезом речи и sales-агент, который выясняет потребность [4] клиента и собирает корзину под бюджет.
Автор: nmrcs
Источник [5]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/35815
URLs in this post:
[1] памяти: http://www.braintools.ru/article/4140
[2] ошибка: http://www.braintools.ru/article/4192
[3] https://github.com/nmrcs/support-agent: https://github.com/nmrcs/support-agent
[4] потребность: http://www.braintools.ru/article/9534
[5] Источник: https://habr.com/ru/articles/1084926/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1084926
Нажмите здесь для печати.