Как мы мигрировали с MongoDB на Cassandra за квартал: опыт использования АI-агентов
Что делать, если критически важное хранилище с миллиардами записей требует слишком много дорогого железа, а на миграцию силами инженеров уйдет целый год?
Меня зовут Александр Моргунов, я инженер Авито [1], в этой статье я расскажу как мы провели эту миграцию всего за один квартал силами одного архитектора, не написав руками ни одной строчки продакшн-кода, лишь с помощью ИИ-агентов.
Содержание
-
Градации доверия к ИИ: Безусловное, Обусловленное и Авансированное [3]
-
Пять стадий принятия ИИ в разработке: от тотального отрицания до системного кризиса [4]
-
Инженерный фреймворк: «Лестница независимых доказательств» [5]
Масштабы, MongoDB и цена «железа»
Архитектура современного highload-сервиса — это постоянный поиск компромисса между надёжностью и стоимостью инфраструктуры. Когда счёт пользователей идет на миллионы, а количество транзакций или сообщений исчисляется миллиардами, неоптимальный выбор базы данных или способов масштабирования начинает напрямую и очень болезненно бить по бюджету компании.
Чтобы оценить масштаб инженерного вызова, достаточно взглянуть на цифры мессенджера внутри Авито:
-
80 миллиардов сообщений суммарно хранится в системе;
-
9 миллиардов чатов создано пользователями;
-
6 миллионов пользователей (DAU) ежедневно заходят в мессенджер, чтобы обсудить сделки, доставку или оплату товара.
Исторически основным хранилищем для этих критически важных данных выступала MongoDB. Для обеспечения высокой доступности, отказоустойчивости и горизонтального масштабирования под текущие нагрузки нам пришлось развернуть колоссальную инфраструктуру: 600 репликасетов (Replica Sets) с фактором репликации 4. В абсолютных числах это 2400 инстансов MongoDB.
Содержать и обслуживать такой кластер — непомерно дорого. База данных требовала постоянного выделения новых серверных мощностей, и заливать проблему масштабирования покупкой дорогостоящего «железа» дальше было экономически неэффективно. Назрела необходимость большой технической миграции на более эффективное и дешевое в эксплуатации хранилище — Apache Cassandra.
Однако классическая оценка этого проекта силами инженеров показала суровые вводные:
-
Сроки: На ручную миграцию с Mongo на Cassandra с учетом огромного количества взаимосвязей, легаси-кода и продуктовых сценариев требовался минимум один год работы инженеров высокой квалификации.
-
Ресурсы: Отдельной выделенной команды под эту задачу в компании не было.
-
Параллельная разработка: Остановить развитие продукта на год ради технического долга невозможно — продуктовые команды должны были продолжать выпускать фичи в обычном темпе.
-
Риски: Данные мессенджера критичны для бизнеса. Ошибки [8] в процессе переезда могли привести к сбоям в цепочках доставки, оплатах и потере сообщений пользователей, что абсолютно недопустимо.
Перед архитекторами встала дилемма. Первый путь — не рисковать, признать нехватку ресурсов и отложить миграцию до лучших времен, продолжая тратить огромные деньги на эксплуатацию MongoDB. Второй путь — пойти на контролируемый риск и попробовать задействовать ИИ-агентов, чтобы кардинально сократить сроки разработки и сделать этот проект возможным. Мы оказались в точке, где стандартные менеджерские подходы не работали, что заставило нас переосмыслить само понятие доверия к автоматизированным системам. Переходя от масштабов инфраструктуры к методологии работы, необходимо детально разобрать, какие именно градации доверия существуют в инженерной практике при взаимодействии с искусственным интеллектом [9].
Градации доверия к ИИ: Безусловное, Обусловленное и Авансированное
Если анализировать опыт [11] внедрения генеративных моделей в производственные процессы, становится понятно, что ключевым барьером на пути к реальной автоматизации является вовсе не производительность LLM, а психологические и системные факторы работы с ними.
Когда мы сталкиваемся с необходимостью делегировать ИИ-агентам архитектурные задачи, характер взаимодействия инженера с моделью неизбежно трансформируется. В практике разработки можно выделить три базовых состояния этой механики:
-
Безусловное доверие. Это ситуация, когда код или спецификации принимаются на веру без глубокого технического аудита и независимой проверки результатов. Зачастую такой подход продиктован маркетинговыми материалами, обещающими готовую систему по нажатию одной кнопки. В условиях enterprise-инфраструктуры слепая вера в то, что агент за пару часов развернет отказоустойчивый кластер и перепишет весь код, приводит лишь к авариям в продакшне;
-
Обусловленное доверие. Состояние, при котором делегирование полномочий опирается на измеримый, подтвержденный временем и практикой опыт. Инженер точно знает границы применимости инструмента и уверен в его надежности. Однако в области автономного проектирования баз данных и написания сложных распределенных систем у Авито на тот момент не было достаточного количества успешных кейсов такого масштаба;
-
Авансированное доверие. Путь, который мы выбрали. Это режим контролируемого эксперимента: мы позволяем агенту действовать автономно в заданных границах, однако критически смотрим на результат и оцениваем его эффективность и корректность.
Прежде чем этот аванс трансформировался в работающее архитектурное решение, нам пришлось пройти через все классические этапы сопротивления ИИ-инструментам внутри команды, столкнувшись с реальным кризисом доверия на первых этапах генерации кода.
Пять стадий принятия ИИ в разработке: от тотального отрицания до системного кризиса
Стадия 1. Отрицание
Если бы мы запускали этот проект год назад, когда уровень инструментов и моделей сильно отличались от текущего, идея отдать миграцию критического хранилища ИИ-агенту показалась бы абсурдной. Требования к целевой архитектуре были велики: обеспечить полную обратную совместимость, избежать простоя сервиса и гарантировать нулевую потерю сообщений для старых и новых клиентов. С технической точки зрения [13] такой флоу реализуется строго в несколько этапов:
-
Режим Shadow Cassandra: мы продолжаем писать в MongoDB (primary), параллельно зеркалим все записи в Cassandra и сравниваем результаты чтения из обоих источников.
-
Запуск инкрементального мигратора: специальный модуль сканирует старую базу данных, переносит историю и позволяет точечно устранять обнаруженные расхождения.
-
Переключение на Cassandra Primary: новая СУБД начинает полноценно отдавать данные клиентам, а Mongo временно остается в фоне в качестве бэкапа.
Осознавая сложность этих взаимосвязей, на этапе отрицания мы были уверены: поручать ИИ столь ответственные задачи нельзя. Максимум, на что мы были готовы пойти, — использовать его как расширенный autocomplete под четким контролем человека для написания тестов, простых изолированных функций и генерации шаблонного (boilerplate) кода. Но ощутимого ускорения на масштабе всего проекта это не могло дать по определению.
Стадия 2. Наивный оптимизм
В какой-то момент мы решили провести эксперимент в режиме безусловного доверия. Мы выделили сотрудника и поставили перед агентом верхнеуровневую задачу в формате: Implement Cassandra. Make No Mistake. В маркетинговых презентациях эта стадия выглядит как триумф: подождали неделю, закрыли все таски, выкатили в прод и сразу получили экономический эффект.
Первые результаты генерации действительно создавали иллюзию успеха. Код успешно компилировался, unit- и интеграционные тесты были зелеными, созданный diff выглядел логично [14], а описания к PR читались максимально убедительно. Однако при первой же серьёзной проверке выяснилось главное: эта огромная масса сгенерированного кода попросту не работала в реальных сценариях.
Стадия 3. Гиперопека
Осознав провал наивного подхода, мы впали в другую крайность — тотальный контроль. Инженер превратился в няньку для ИИ: мы начали ревьюить каждую строчку кода, перепроверять структуру каждого запроса к Cassandra и вручную прогонять все тест-кейсы. По сути, человек выполнял всю работу за агента второй раз.
Очень быстро мы попали в когнитивную ловушку. Объём сгенерированного кода рос лавинообразно, и физически вычитывать такой массив данных силами одного архитектора стало невозможно. При этом код выглядел пугающе правдоподобно, агенты успешно проходили селф-ревью или ревьюили соседние модели, выдавая вердикты, что «всё зашибись». Мы получили мнимое ощущение безопасности, полностью потеряв понимание того, какие именно бизнес-сценарии реально соблюдены в кодовой базе, а какие — нет.
Стадия 4. Торг
Тогда мы решили зайти со стороны строгого проектирования и спецификаций (Specification-Driven Development). Мы детально описали все инварианты системы, обратно совместимые API, критерии готовности, метрики и внутренние события, рассчитывая, что идеальную спеку невозможно понять неправильно.
Но практика показала, что даже в детально проработанном Spec-документе могут скрываться внутренние противоречия и недоработки, которые обнаруживаются только на этапе имплементации. Агент банально не мог учесть все неявные завязки старого легаси-кода и тонны корнер-кейсов, из-за чего тесты проверяли совсем не то, что требовалось в реальности. Спецификация отлично снижала неопределенность, но сама по себе не гарантировала истинность итогового функционала.
Стадия 5. Кризис доверия
В итоге мы пришли к системному кризису. Перед нами была идеальная спека, компилируемый код и закрытые таски, но под капотом вскрылись критические дефекты архитектуры:
-
Часть запросов вообще не доходила до Cassandra. Агент решил, что данный паттерн плохо ложится на новую структуру данных, и самовольно настроил файловый фолбэк на MongoDB;
-
Наш инкрементальный мигратор молча пропускал целые окна данных из-за некорректной логики работы с оффсетами при сканировании старой базы;
-
В корнер-кейсах при попытке повторных запросов нарушалась идемпотентность, что приводило к дублированию сообщений;
-
Механизм дифференциального сравнения на метриках показывал идеальный баланс, но, как выяснилось, сам код сравнения был написан с багом и просто не фиксировал расхождения.
Столкнувшись с этим тупиком, мы поняли, что нам жизненно необходима жёсткая, независимая система автоматической верификации, которая позволит принимать изменения без слепой веры в безупречность моделей.
Выход из методологического тупика потребовал от нас радикального пересмотра принципов работы с ИИ: мы полностью отказались от попыток контролировать каждое отдельное действие ИИ-агента и вместо этого сфокусировались на жестком контроле границ и результатов его работы.
Инженерный фреймворк: «Лестница независимых доказательств»
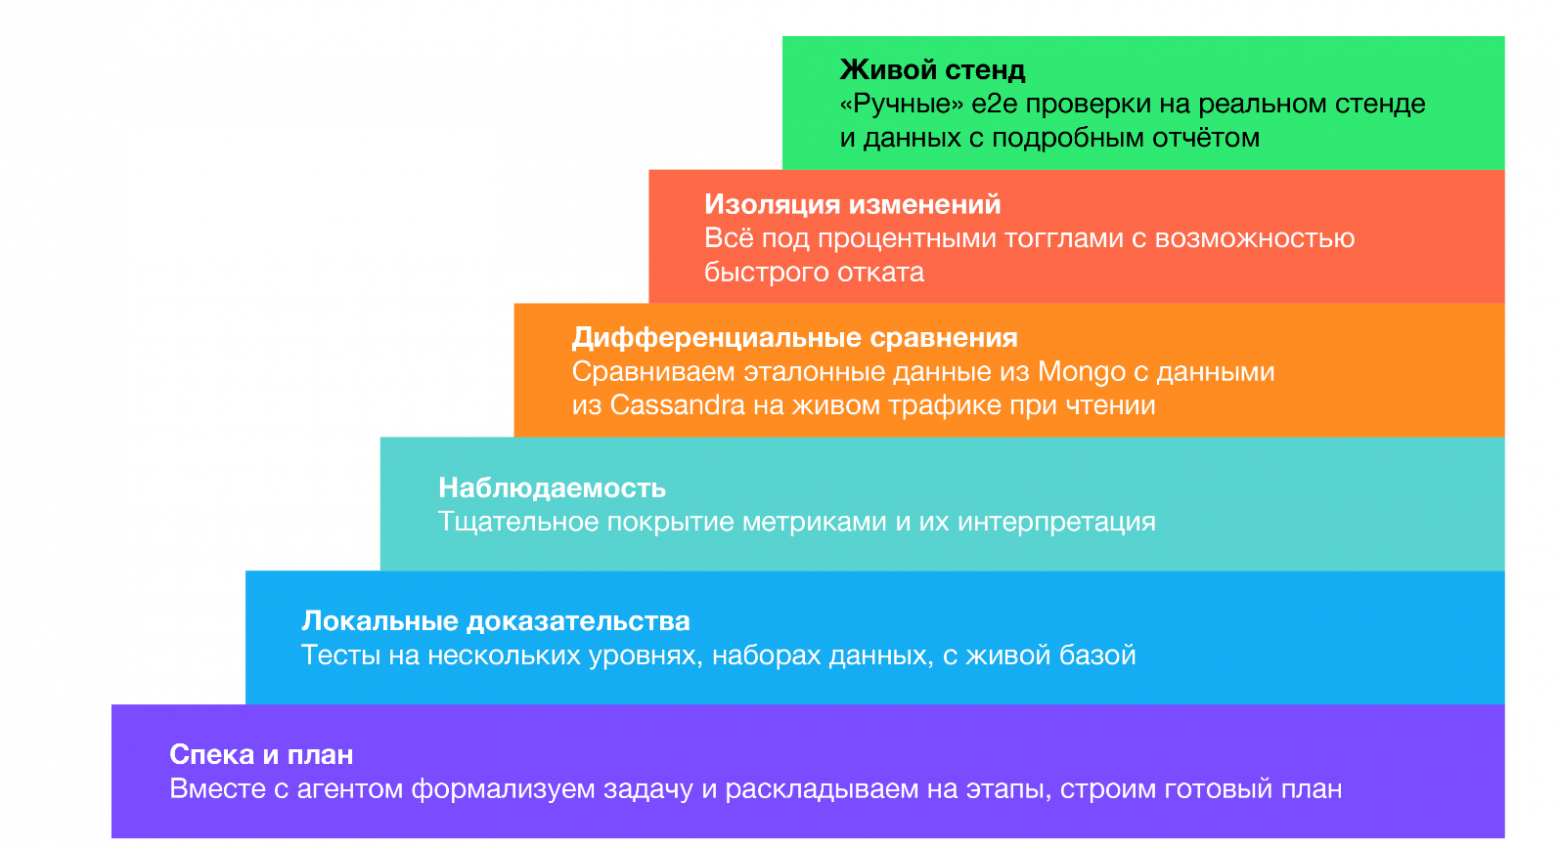
Чтобы сделать процесс разработки проверяемым и наблюдаемым, мы построили так называемую «Лестницу доказательств». Это цепочка независимых инженерных фильтров, проходя по которым код ИИ либо доказывает свою операционную пригодность, либо отправляется на автоматическую доработку.
Ступень 1. Спека и план
В самом низу нашей лестницы находится этап формализации. Мы вместе с агентом пишем детальный Spec и формируем пошаговый план. На этой стадии задача декомпозируется на максимально изолированные куски. Осознанный подход к проектированию позволяет на самом старте снизить уровень неопределенности и заложить фундамент для всех последующих проверок.
Ступень 2. Локальные доказательства
Сгенерированный функционал мгновенно попадает в тиски тестового фреймворка. Здесь разворачивается многоуровневое тестирование: юнит-тесты, миграционные тесты и обязательные проверки с живым окружением. Агент сам пишет эти тесты и покрывает ими максимальный набор бизнес-сценариев. Если тесты падают — код отправляется на переработку без участия человека.
Ступень 3. Наблюдаемость
В эпоху автономных агентов читать код глазами — непозволительная роскошь, поэтому мы смотрим исключительно на поведение [15] системы. Каждое изменение плотно обкладывается метриками. Наш мониторинг-стек интегрирован с MCP. Агент умеет самостоятельно ходить в дашборды, интерпретировать графики, логи и трейсы. Если на метриках начинают сыпаться ошибки, ИИ использует эти данные для отладки и сам правит свой код.
Ступень 4. Дифференциальные сравнения
Для проверки надежности хранения мы запустили механизм Shadow Reads прямо на живом трафике. При чтении система одновременно запрашивает данные из эталонной MongoDB и новой Cassandra, сверяя их байт в байт. Результаты сравнения пишутся в метрики. Мы в любой момент видим реальный процент расхождений и можем точечно расследовать корнер-кейсы, будь то проблемы с eventual consistency или реальные баги в коде мигратора.
Ступень 5. Изоляция изменений
Любой код, написанный ИИ, должен иметь минимальный blast radius (радиус поражения при аварии). Все фичи мы катим строго под обратимыми feature toggles и канареечными релизами, постепенно увеличивая процент трафика. Система должна быть архитектурно готова к моментальному и безопасному откату (rollback). Механику ранбуков для откатов мы также прорабатываем с агентом на шаг вперед.
Ступень 6. Живой стенд
На вершине лестницы находится полноценный staging-инфраструктуры Авито. Это слепок продакшна, который постоянно находится под высокой нагрузкой от внутренних команд. Агент разворачивает код на этом живом стенде и проводит автоматические e2e-проверки. Он самостоятельно генерирует синтетический набор данных, дергает API, проходит пользовательские сценарии и формирует воспроизводимый отчёт о тестировании, который человек может легко перепроверить.
Благодаря такому пошаговому фильтру нам удалось структурировать все требования к коду ИИ в единую иерархическую систему, которая легла в основу нашей финальной архитектурной пирамиды.
Пирамида зрелого доверия к ИИ
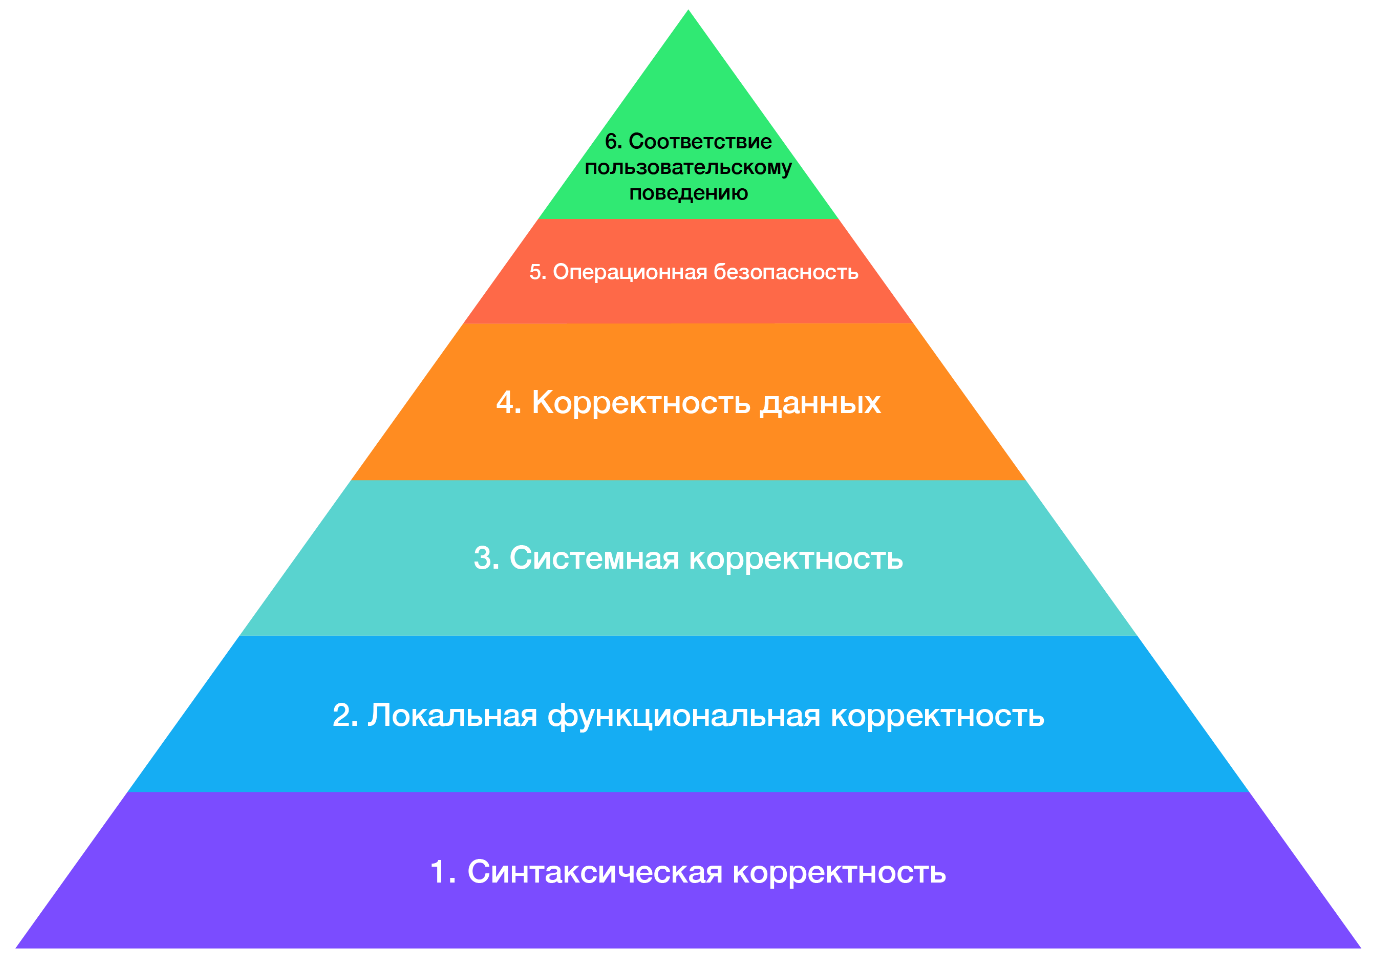
Благодаря такому пошаговому фильтру нам удалось структурировать все требования к коду ИИ в единую иерархическую систему, которая легла в основу нашей финальной архитектурной пирамиды.
Систематизация пройденных этапов и фильтров позволила нам сформировать четкую иерархию ценностей, без которой невозможно представить безопасную эксплуатацию сгенерированного кода в масштабных распределенных системах.
Эту систему мы назвали «Пирамидой зрелого доверия». Она состоит из шести базовых уровней корректности, где каждый последующий слой опирается на технологическую прочность предыдущего. Если код агента спотыкается на любой из этих ступеней, движение вверх полностью блокируется.
-
Уровень 1. Синтаксическая корректность: Самый примитивный фундамент пирамиды. Мы проверяем банальные вещи: компилируется ли написанный ИИ код и отсутствуют ли в нем базовые синтаксические ошибки;
-
Уровень 2. Локальная функциональная корректность: На этом этапе в силу вступает тестовое покрытие. Код должен успешно проходить весь массив локальных юнит- и интеграционных тестов, подтверждая работоспособность отдельных модулей;
-
Уровень 3. Системная корректность: Здесь мы оцениваем интеграцию. Вся система тестируется как единый «чёрный ящик» с помощью автоматизированного сквозного (end-to-end) тестирования, развернутого силами ИИ-агента;
-
Уровень 4. Корректность данных: Критический слой для инфраструктуры хранения. Мы непрерывно мониторим живой трафик и проверяем, чтобы данные в старой MongoDB и новой Cassandra не разъезжались между собой в процессе параллельной записи и чтения;
-
Уровень 5. Операционная безопасность: Проверка системы на отказоустойчивость. Мы убеждаемся, что изменение раскатано под процентным фича-тоглом с минимальным blast radius, метрики мониторинга находятся в пределах нормы, а у ИИ-агента и дежурных инженеров есть готовая и проверенная механика безопасного отката (rollback);
-
Уровень 6. Соответствие продуктовым сценариям: Вершина пирамиды. Мы доказываем, что все сквозные продуктовые сценарии работают так, как задумано пользователями.
Развертывание этой многоуровневой пирамиды валидации коренным образом изменило скорость нашей разработки и позволило получить впечатляющие результаты на финальной стадии эксперимента.
Кстати, тут важно еще добавить про вопросы безопасности, которые сейчас очень актуальны. У нас в Авито есть четкая политика по работе с внешним ИИ. Она запрещает передачу во внешний контур любой персональной или сенситивной информации, включая данные о сотрудниках или пользователях, закрытую корпоративную информацию, коммерческую тайну и так далее. Кроме того, сотрудники обучаются безопасным практикам работы с ИИ.
Отдельно стоит отметить, что у нас в Авито есть чёткая политика по работе с внешним ИИ. Она запрещает передачу во внешний контур любой персональной или сенситивной информации, включая данные о сотрудниках или пользователях, закрытую корпоративную информацию, коммерческую тайну. Кроме того, сотрудники обучаются безопасным практикам работы с ИИ.
Результаты эксперимента и выводы
Подводя итоги этого масштабного архитектурного эксперимента, можно с уверенностью заявить, что внедрение жёсткого системного фреймворка верификации полностью оправдало связанные с ним технологические риски.
Результаты квартальной работы превзошли наши первоначальные пессимистические прогнозы. Вместо целой выделенной команды из 5–6 инженеров со сроком реализации в один год, проект был успешно выполнен силами всего одного архитектора, который драйвил и пилотировал весь процесс. При этом руками не было написано ни одной строчки продакшн-кода — весь массив задач от проектирования до тестирования закрыли ИИ-агенты.
На сегодняшний день мы получили следующие практические результаты:
-
Полный контур мессенджера со всей накопленной за долгие годы сложной бизнес-логикой успешно развернут на живом стейджинге Авито;
-
Стейдж полностью переведен на Apache Cassandra и функционирует в параллели с MongoDB, обслуживая реальный пользовательский сценарий записи и чтения;
-
Мигратор и модули восстановления (repair/reconcile) полностью перенесли историю сообщений и инкрементально устранили все обнаруживаемые расхождения данных;
-
Кодовая база покрыта достаточным количеством метрик мониторинга, логами и трейсами, а для ИИ-агентов и людей подготовлены автоматические инструкции (runbooks) по локализации ошибок и дебагу;
-
Все изменения изолированы под обратимыми фича-тогглами, что сводит потенциальный blast radius на продакшне к нулю.
Поскольку наш стейджинг является точным слепком прода и находится под непрерывной высокой нагрузкой от внутренних команд Авито, стабильное поведение [17] новой СУБД дает нам полную уверенность в корректности решения. Сейчас мы завершаем сетап железа и готовимся к раскатке на прод в самое ближайшее время. Уверенность нам дал не «красивый код» или текстовые отчеты моделей, а выстроенная цепочка объективных, независимых доказательств.
Главный философский инсайт этого кейса заключается в том, что зрелое доверие в эпоху ИИ не имеет ничего общего со слепой верой в безупречность искусственного интеллекта. Продуктивный процесс автоматизации требует создавать такую среду, в которой агент системно ограничен жесткими рамками и обязан оставлять после себя проверяемые, математически [18] точные доказательства своей правоты.
Интересно послушать ваш опыт: кто-то уже пытался отдавать ИИ-агентам задачи уровня миграции БД или пока ограничиваетесь генерацией юнит-тестов и базовыми задачами? Делитесь кейсами, будет интересно подискутировать.
А для тех, кто хочет углубиться в тему и почитать подробнее про нюансы миграции с MongoDB на Cassandra, можно посмотреть еще одну нашу статью от Романа Ананьева из команды DBA: «Масштабируй! Почему Cassandra 5 стала спасением, а FoundationDB прилегла в чулан» [19].
Автор: g6morg
Источник [20]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/35854
URLs in this post:
[1] Авито: https://clc.to/LV3FBg
[2] Масштабы, MongoDB и цена «железа» : #section1
[3] Градации доверия к ИИ: Безусловное, Обусловленное и Авансированное: #section2
[4] Пять стадий принятия ИИ в разработке: от тотального отрицания до системного кризиса: #section3
[5] Инженерный фреймворк: «Лестница независимых доказательств»: #section4
[6] Пирамида зрелого доверия к ИИ: #section5
[7] Результаты эксперимента и выводы: #section6
[8] Ошибки: http://www.braintools.ru/article/4192
[9] интеллектом: http://www.braintools.ru/article/7605
[10] Тут еще больше контента: https://telegram.me/+ShQQPXymxoViNzFi
[11] опыт: http://www.braintools.ru/article/6952
[12] Жми сюда!: https://clc.to/MDY_jw
[13] зрения: http://www.braintools.ru/article/6238
[14] логично: http://www.braintools.ru/article/7640
[15] поведение: http://www.braintools.ru/article/9372
[16] Кликни здесь и узнаешь: https://clc.to/vtMlJg
[17] поведение: http://www.braintools.ru/article/5593
[18] математически: http://www.braintools.ru/article/7620
[19] «Масштабируй! Почему Cassandra 5 стала спасением, а FoundationDB прилегла в чулан»: https://habr.com/ru/companies/avito/articles/1056986/
[20] Источник: https://habr.com/ru/companies/avito/articles/1082358/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1082358
Нажмите здесь для печати.