Кто нашёл больше багов — агент или человек? Мои замеры 11 недель работы с AI-тестировщиком
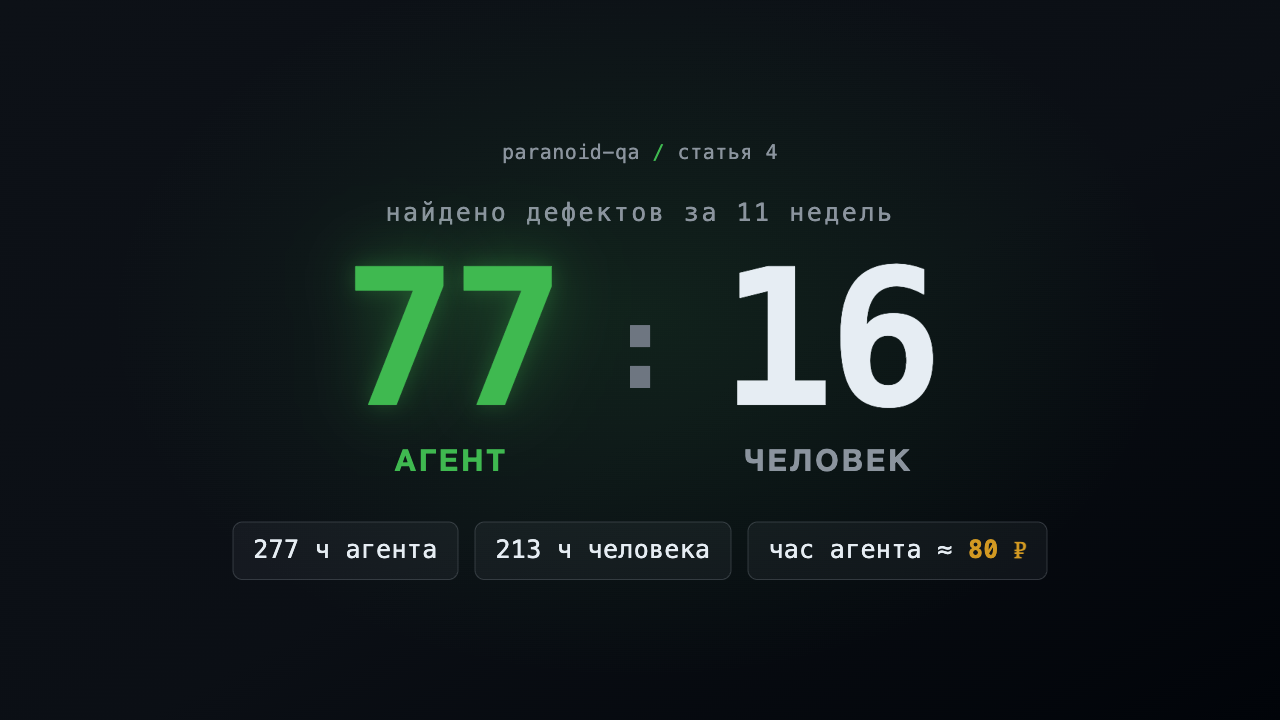
Одиннадцать недель я вёл дневник каждой рабочей сессии с Claude Code: сколько часов работал агент, сколько я был рядом, кто нашёл каждый дефект и что случилось с каждым кандидатом — подтверждён, снят или ушёл вопросом. Вместо впечатлений — таблица: 277 агентских часов, 213 моих, 94 подтверждённые находки. Первая версия этого счёта оказалась завышенной почти вдвое — куда делась половина, тоже расскажу.
Это четвёртая статья про paranoid-qa — опенсорсный пак скиллов, который заставляет Claude Code тестировать с доказательной дисциплиной. В первых трёх я показывал методику: вердикты только с пруфами [1], ревью автотестов [2], хуки-гейты [3]. Сегодня — цифры: почём час агента, где он окупился, а где нет. Обещанного «в десять раз быстрее» в них не нашлось.
Методика
Тыкать в цифры будут первым делом, поэтому начну с того, как они получены.
Источник — транскрипты сессий: Claude Code пишет каждую сессию в ~/.claude/projects/ сам, без каких-либо настроек. Оттуда добываются два числа.
Часы агента — активное время: сумма интервалов между событиями сессии, паузы длиннее 30 минут отбрасываются. Считать по wall-clock, от открытия сессии до закрытия, нельзя: сессия, провисевшая открытой неделю, отрапортует 170 часов, хотя работы в ней было часа полтора.
Часы человека — время присутствия: та же математика [4] по моим сообщениям, порог 20 минут. Это нижняя оценка: пока я молча смотрю на экран, лог пуст.
С дефектами строже. У каждого кандидата, которого выдвинул агент, четыре возможных исхода:
-
подтверждён — воспроизведён и признан дефектом по итогам сессии;
-
передан вопросом — кандидат по делу, но решение в чужой зоне: у аналитика, дизайнера, безопасников;
-
снят — не пережил проверку, свою или мою;
-
пропущен — найден, но потерян по дороге к отчёту (об этом отдельно).
В счёт «найдено» идут только подтверждённые, и только по финальному вердикту сессии. Так я стал считать после одного ожога — расскажу ниже.
Где метод врёт: при параллельной работе двух сессий моё присутствие удваивается в счёте, а баги, найденные вне сессий, в датасет не попадают вообще. Ну и вердикты по кандидатам выношу я сам — другой пары глаз в этих замерах нет.
Скрипт-сборщик [5] лежит в репозитории — можете померить свои сессии тем же способом. Одно предупреждение: транскрипты ротируются раз в 30 дней, так что сырьё архивируйте сразу.
И про примеры дефектов дальше по тексту: агента я гоняю на нескольких проектах, включая личные, а из описаний убрано всё, по чему опознаётся конкретный продукт.
Что показали 11 недель
|
|
Агент |
Человек |
|---|---|---|
|
Часы |
277 |
213 |
|
Подтверждённых находок |
77 |
16 (+1 совместно) |
|
Передано вопросами |
~45 |
— |
|
Кандидатов снято |
~130 |
— |
|
Пропусков |
6 |
— |
В 277 входит всё, что агент делал в QA: ручное тестирование и тест-дизайн — около 190 часов, работа с автотестами — 85, обвязка самого агента — ещё пара часов.
Из воронки видно главное свойство агента: он щедрый генератор гипотез. До подтверждённого дефекта доживает примерно каждый третий кандидат — остальных отсеивают его же перепроверки, мой разбор и чужие зоны ответственности. Такой у него режим работы: дёшево выдвинуть, дёшево проверить.
Соотношение часов 1 : 0.77, и от недели к неделе оно почти не менялось. Агент не заменил меня — он удвоил пропускную способность. На каждый его час я потратил три четверти своего: постановка, разбор кандидатов, решения. Кто обещает вам «отпустил агента и ушёл» — попросите логи.
Разные охотничьи угодья
Счёт 77 : 16 выглядит разгромным, пока не посмотреть, что именно нашла каждая сторона.
Агент выигрывает перебором и заглядыванием под капот. Значение из дропдауна уходило в тело запроса как [object Object] — на экране всё выглядело нормально, кнопка активна, дефект жил только в payload. На негативном вводе сервер отвечал 500 там, где по контракту ждали ошибку [6] валидации, — на экране разницы не видно, а тест обязан её различать. Виджет не инициализировался, если сторонний скрипт на странице отвечал слишком долго, — гонка на старте, невидимая в обычном прогоне. При сверке кодовых срезов тестового и боевого контуров агент нашёл расхождение, которое в браузере не проявляется вообще, — его видно только в коде. Сюда же моки: состояния «сервер вернул ошибку», «список пустой», «сторонний скрипт не ответил» агент строит за минуту, подменив ответ сети, — руками такие состояния ловить долго, а сбой по заказу не случается.
Человек выигрывает присутствием. Горизонтальный скролл от слайдера — поймал с телефона, просто листая страницу. Служебная страница ошибки без вёрстки сайта — увидел, когда сервер моргнул на секунду. Разъехавшийся контент — заметил, открыв одну и ту же страницу дважды подряд. Страница уезжала вниз при первом клике — наткнулся случайно, а причину (пересчёт высоты после инициализации карусели) за двадцать минут раскопал агент. Хороший пример совместного режима: моя чуйка, его лопата.
Закономерность: агент находит там, где надо систематически перебрать состояния или прочитать то, что человек читать не станет. Человек — там, где надо оказаться в правильном месте живого продукта. Классы почти не пересекаются.
Самый урожайный час — тот, где есть эталон
Разрежем тот же счёт по типам работы: сколько подтверждённых находок приносит час каждого типа. Баг-фиксацию не считаю — туда я прихожу с готовым багом; написание самих автотестов тоже за скобками, его валюта — стабильный прогон, дефектов там не считают:
|
Тип работы |
Часов |
Находок |
На час |
|---|---|---|---|
|
Сверка реализации с эталоном (макет, ТЗ) |
2.2 |
3 |
1.36 |
|
Исследование (куда уходят данные) |
1.4 |
1 |
0.71 |
|
UI-прогоны |
104 |
62 |
0.60 |
|
Разбор падений автотестов |
13.8 |
8 |
0.58 |
|
Сверка кодовых срезов прод/тест |
5.8 |
3 |
0.52 |
|
Тест-дизайн |
47 |
0 |
0 |
|
Релизные процессы |
3.7 |
0 |
0 |
Паттерн читается сразу: урожайность растёт там, где у агента есть эталон для сравнения — макет, ТЗ, боевой контур, ожидание упавшего теста. Сюрприз таблицы — разбор падений автотестов держится вровень с целевыми UI-прогонами, хотя туда никто не приходит искать баги продукта. Упавший тест — это уже готовый оракул: минутный сбой на боевом сервере, дефект вложений — это всплыло из вопроса «почему упал прогон», в плановых проверках такое не ищут. А тест-дизайн даёт ноль дефектов продукта, и это обманчивая строка. Основной объём прогонов у меня идёт не свободным исследованием, а по тест-кейсам, которые агент сам написал по ТЗ и макетам на этапе тест-дизайна. То есть эти 47 часов не пропали — они конвертируются в находки этажом выше, на прогоне.
Практический вывод: хочется быстрых серьёзных находок — дайте агенту эталон и просите сравнивать. «Сверь вот это с вот этим» приносит больше, чем «потыкай форму».
Прогон в несколько рук
Другой способ поднять отдачу часа появился под конец замеров: большие прогоны я перестал гонять одной сессией. Тест-кейсы делятся на пакеты — вёрстка, поведение [7], адаптив — и каждый пакет уходит отдельному субагенту. Работают они параллельно, статусы в прогон проставляют сами, а вот заводить дефекты им запрещено: все Fail стекаются ко мне на дедупликацию и личную перепроверку.
Перепроверка — не формальность. В одном из первых таких прогонов три Fail оказались ошибкой в моих же ожидаемых результатах: субагент сравнил реализацию с тем, что я написал в тест-кейсе, — а написанное было неверным. Без личного прохода по каждому Fail эти три ушли бы разработчику ложными багами.
По времени это выглядит так: полный цикл по новому блоку — тест-кейсы, прогон на всех целевых разрешениях, ретест после правок — укладывается в один рабочий день; раньше такой объём я растягивал на несколько. Точные замеры и грабли этой механики соберу к следующей статье.
Ложные срабатывания и пропуски
Главный страх [8] при работе с агентом — что он завалит команду выдуманными багами. Обоснованный: ~130 кандидатов за одиннадцать недель до подтверждения не дожили. Важно, кто и как их снял.
История первая, где дисциплина сработала. Агент проверял пачку ссылок на странице и отчитался о 31 битой. Прежде чем репортить, сходил по ним реальными переходами — все 31 открылись: без заголовка Accept: text/html сервер отдавал 404. Тридцать один ложный баг умер до отчёта. Сработало правило «кандидата проверь другим способом» — оно прописано в скиллах явно, само собой такое поведение [9] не появляется. Второй дешёвый фильтр из той же серии — прод: заметная часть кандидатов на тестовом стенде снялась одним сравнением «а на бое как?» — если там так же, это не регресс задачи.
История вторая, где дисциплина не сработала — и это интереснее. В большом прогоне агент завёл три дефекта об ошибках, которые видел на экране: техническое сообщение вместо человеческого текста. Я проверил руками — ошибки нормальные. Разбор показал: агент сам подставил в мок ответа тело {"message":"Internal Server Error"}, увидел его в интерфейсе и оформил как находку. Он тестировал эхо собственной заглушки.
Это отдельный класс ошибки: то, что ты сам положил в мок, находкой быть не может. На заглушке можно проверять поведение — не завис ли UI, разблокировалась ли кнопка, ушёл ли повторный запрос. Нельзя — тексты, коды и структуру ответа: их задал ты. В тот же день это стало тремя правилами в скиллах пака, с контрольным вопросом перед каждым дефектом «это значение сформировала система или я сам?».
История третья — про меня. Готовя эту статью, я посчитал находки по отчётам агента в середине сессий. Получилось 80. Потом прошёл по финальным вердиктам каждой сессии — осталось 39; ещё четыре подтвердились позже — итог на тот день 43, а всё, что датасет набрал после, считалось уже только по финальным вердиктам. Промежуточные списки агента завышены почти вдвое: кандидатов снимают поздние проверки самого агента и мой разбор. Если соберётесь мерить своего агента — считайте только конец сессии, любой его собственный «итог: N дефектов» по дороге — это заявка на проверку.
И шесть пропусков. Первый: агент увидел ошибку валидации там, где данные были корректны, назвал это «несущественным моментом» и не вынес в отчёт — ни в баги, ни в наблюдения. Нашёл я, читая его лог: находка лежала там дословно, он сам решил, что она не важна, и ошибся. Второй и третий — за одну сессию: агент не проверил кликабельность элементов, которые по ТЗ должны быть кликабельны, и не заметил, что текст внутри блока переверстывается прямо во время анимации. Он покадрово мерил габариты самого блока — а ширина текста внутри ехала отдельно, и проверить это, по его же признанию, «в голову не пришло». Четвёртый — сузившаяся картинка на мобильной вёрстке, которую я увидел глазами за секунду.
Пятый и шестой добавились под конец замеров, и у них общий, самый неприятный паттерн: оба случились на ретесте. Разработчик залил правки, агент перепроверил исправленное — и не заметил, что рядом сломалось другое. В одном случае контент блока стал обрываться раньше своего фона, в другом сбилось выравнивание соседних элементов. Обе регрессии поймал я, вопросом «а почему ты этого не заметил?». Агент на ретесте смотрит туда, где чинили, и не пересматривает блок целиком; после этих двух в скиллы добавилось правило: любые правки — полный визуальный проход блока заново.
Частота получается такая: 6 пропусков на 77 агентских находок, около 8% — и все шесть нашёл человек. Корень у них общий: агент проверяет то, что назвал проверкой, и не достраивает пространство проверок сам — ни на первом прогоне, ни, как выяснилось, на ретесте. После каждого пропуска появлялся тест-кейс или правило, закрывающие класс, — но следующий новый класс он снова не увидит первым. Ровно поэтому человек остаётся в контуре.
Где агент не окупился
Раздел, без которого статья была бы рекламой.
-
Ревизия статусов тест-кейсов — 2.2 часа агента там, где фильтр в TMS руками занимает минуты.
-
Микроправки тикетов — 0.1 часа агента против 0.1 часа руками. Паритет.
-
Обвязка самого агента — 1.7 часа на разбор лимитов MCP-сервера. Накладные расходы, которых у ручного тестирования не существует.
-
Оформление релизных отчётов — 3.7 часа на семь отчётов, по полчаса на каждый против пятнадцати минут руками.
Общий признак: где задача короткая и целиком в голове человека, агент проигрывает на постановке. Выигрывает он там, где работа длинная, монотонная и требует держать много состояний.
Сколько это стоит
Тариф Max 5x — 100 долларов в месяц, около девяти тысяч рублей. За одиннадцать недель агент отработал 277 часов — примерно сто десять в месяц.
Агентский час обошёлся примерно в 80 рублей.
Для сравнения возьмём штатного инженера с зарплатой 200 тысяч в месяц: при 168 рабочих часах его час обходится компании примерно в 1200 рублей, со взносами — заметно дороже. Разница с агентом в пятнадцать раз — и считать так нельзя.
Час агента не заменяет час человека: на каждый его час ушло 0.77 моего. Формула для одной задачи:
Было:  N человеко-часов
Стало: N × 0.77 человеко-часов + N × 80 ₽
При ставке 1200 ₽/час выходит экономия около 16% на тех же задачах. До «в пятнадцать раз» тут далеко, зато эта цифра выдерживает проверку.
Главная выгода в другом. Немалая часть сделанного за одиннадцать недель руками не делалась бы вообще: никто не сверяет построчно кодовые срезы двух стендов, не гоняет форму во всех режимах, когда сторонние скрипты недоступны, не ходит по четырём десяткам ссылок в трёх браузерах. Агент в первую очередь делает выполнимой ту работу, которую раньше вычёркивали из плана, — ускорение старой идёт следом. И ещё одно, что не влезает в формулу: пока агент 8 часов гоняет форму, я делаю другую работу — эти часы в таблице записаны как «присутствие», но не как простой.
Если попробуете сами
Выжимка из одиннадцати недель:
-
Мерьте активное время по транскриптам сессий, wall-clock врёт в десятки раз.
-
Считайте только финальные вердикты: промежуточные списки дефектов завышены почти вдвое.
-
Самые урожайные задачи — те, где у агента есть эталон: макет, ТЗ, боевой контур, упавший тест.
-
На моках не проверяйте то, что сами в них положили.
-
Fail от субагентов перепроверяйте лично, а после правок смотрите блок целиком: два последних пропуска случились именно на ретесте.
-
Экономику считайте как N × 0.77 человеко-часов плюс N × 80 ₽: на тех же задачах выходит около 16%.
Что дальше меряю
Одиннадцать недель — короткая дистанция. Дальше интересны доля пропусков на большей выборке, стоимость ревью агентских отчётов и как меняется соотношение часов по мере дозревания правил и гейтов. Разбор падений — тот, что в таблице удивил урожайностью, — уже начал автоматизироваться: после прогона регресса хук сам запускает разбор, и каждое падение приходит ко мне классифицированным — флак, инфраструктура или похоже на дефект. Что из этого выйдет — отдельный разговор.
А чем меряете вы? Если у вас есть цифры по агентной работе — принесите в комментарии, интересно сравнить методики.
Автор: Kova13v
Источник [10]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/35856
URLs in this post:
[1] вердикты только с пруфами: https://habr.com/ru/articles/1058134/
[2] ревью автотестов: https://habr.com/ru/articles/1058692/
[3] хуки-гейты: https://habr.com/ru/articles/1062206/
[4] математика: http://www.braintools.ru/article/7620
[5] Скрипт-сборщик: https://github.com/akovalion/paranoid-qa/tree/main/ru/examples/run-stats
[6] ошибку: http://www.braintools.ru/article/4192
[7] поведение: http://www.braintools.ru/article/9372
[8] страх: http://www.braintools.ru/article/6134
[9] поведение: http://www.braintools.ru/article/5593
[10] Источник: https://habr.com/ru/articles/1085288/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1085288
Нажмите здесь для печати.