Собираем приватный RAG-стек на pgvector
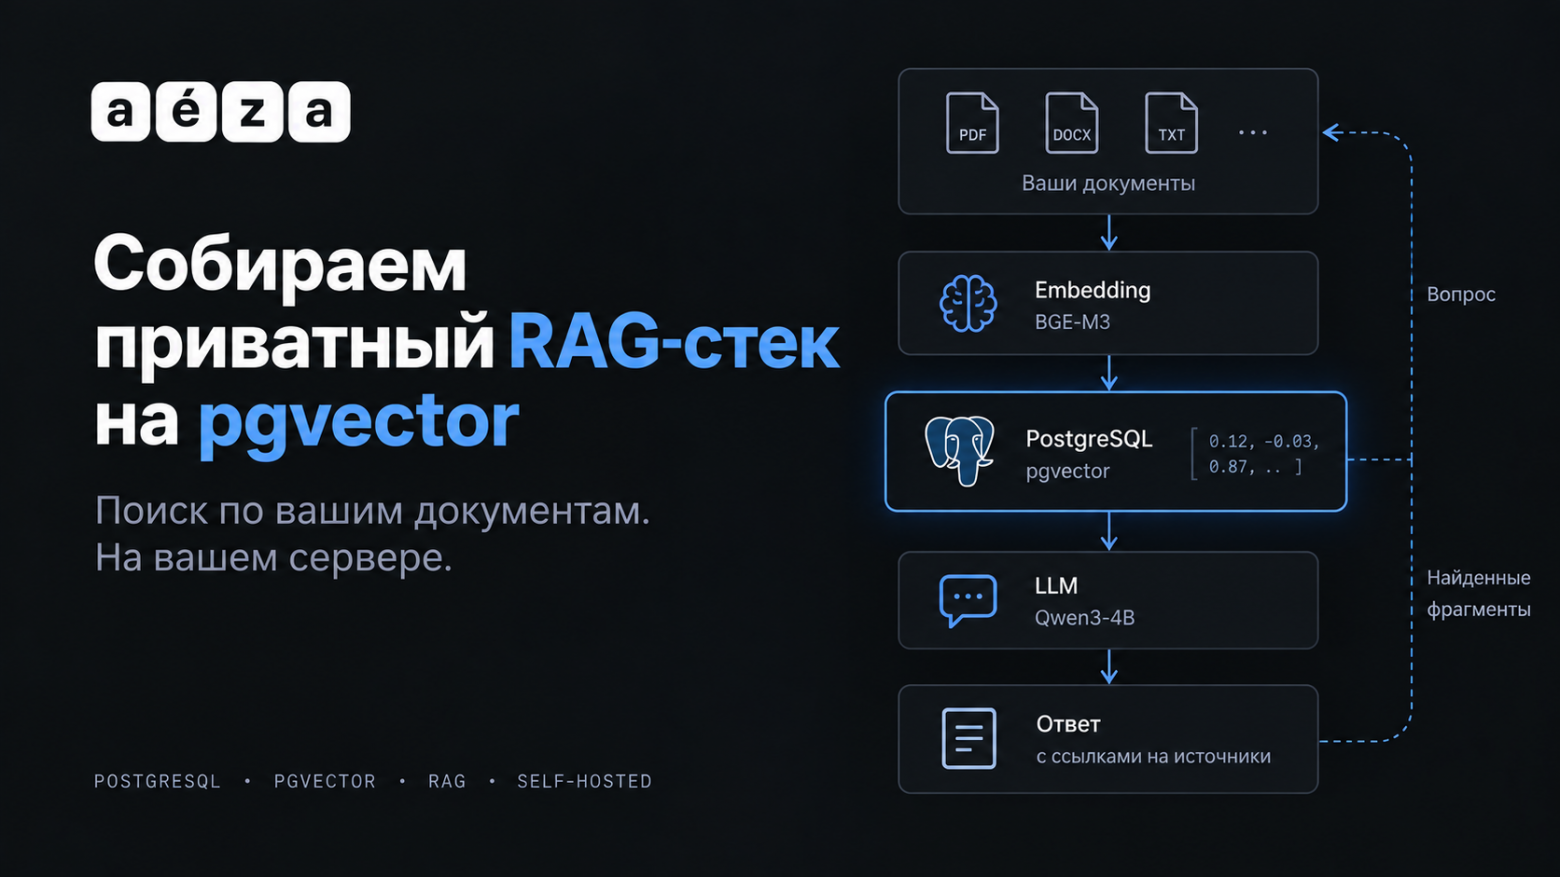
Приватный RAG-стек на pgvector помогает отвечать на вопросы по внутренним документам. Поиск подбирает отрывки, а языковая модель составляет по ним ответ. Например, сотрудник узнаёт порядок восстановления доступа и проверяет его по исходной инструкции.
При self-hosted RAG на pgvector вся обработка остаётся на вашем VPS. Внешний сервис, например для распознавания PDF, выведет текст за его пределы. Ниже – учебный вариант для внутренних инструкций: схема данных, запросы и порядок проверки.
Какие компоненты нужны приватному RAG-стеку?
Приватному RAG нужны загрузчик документов, модель для преобразования текста в векторы, хранилище с поиском, языковая модель и проверка прав пользователя. Найденные фрагменты поступают в модель вместе с вопросом, чтобы она составила ответ по источникам. Дополнительная модель ранжирования может помочь, если обычный поиск часто выбирает неподходящие отрывки.
Куда попадает текст документа
Документы могут быть общедоступными, внутренними или закрытыми для отдельных групп. Эти ограничения распространяются и на копии. Векторы тоже могут раскрывать сведения об исходном тексте, поэтому на учебном стенде стоит держать вымышленные инструкции.
Модель embeddings превращает текст в набор чисел – вектор. Поиск сравнивает векторы, а языковая модель получает найденные отрывки.
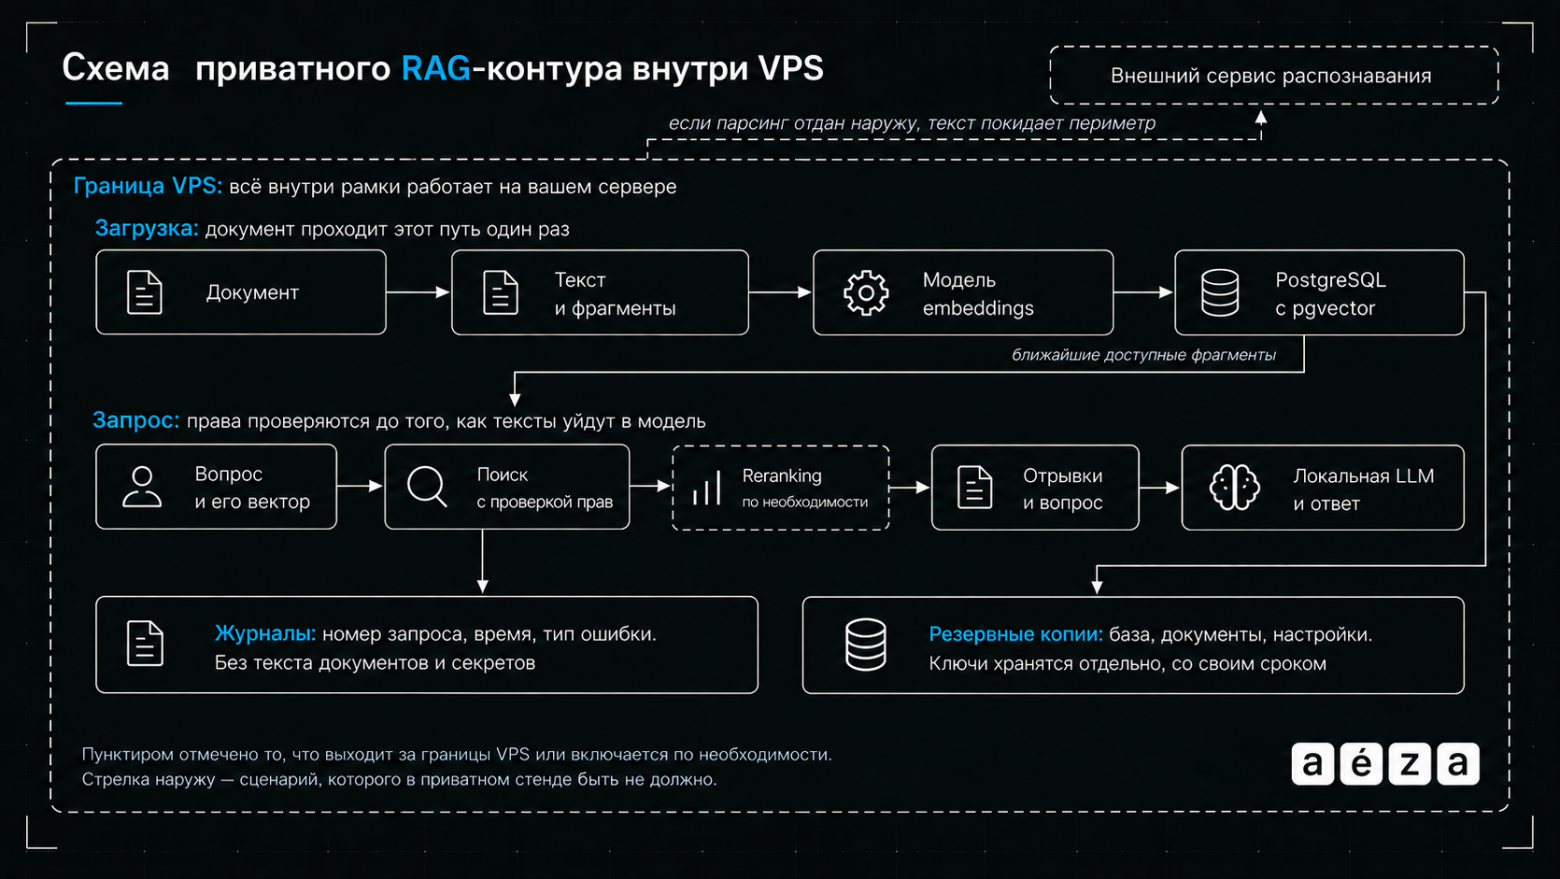
Учебный стенд рассчитан на один VPS, которым управляет администратор. Порт PostgreSQL наружу не публикуется: обращение к базе идёт внутри контейнера. Ollama доступна на 127.0.0.1 без TLS и аутентификации. Другие процессы на сервере тоже могут к ней обратиться.
При разделении компонентов между машинами нужны закрытая сеть, аутентификация и TLS. Владельцу self-hosted RAG на pgvector также нужно знать, куда уходят резервные копии и кто имеет к ним доступ.
Из чего состоит учебный стенд
За векторный поиск PostgreSQL для RAG отвечает расширение pgvector. В compose-файле закреплены версии: PostgreSQL 17 с pgvector 0.8.6 и Ollama 0.34.0. Векторы считает локальная модель BGE-M3 [1], ответы готовит Qwen3-4B [2]. BGE-M3 распространяется под MIT, Qwen3-4B – под Apache 2.0. Точные теги моделей стоит зафиксировать в compose-файле, чтобы стенд собирался одинаково.
Стенд поднимается одним compose-файлом с PostgreSQL и Ollama. Дальше нужен небольшой скрипт для загрузки документов и запросов. Хватит интерфейса из двух команд:
python3 rag.py load
python3 rag.py ask --tenant alpha --group staff
  "Как восстановить доступ к кабинету?"
Команды выполняет администратор на сервере с Linux. Пользовательского API в стенде нет. Здесь tenant и group – организация и группа доступа. В рабочем сервисе сервер берёт их из учётной записи, чтобы пользователь не мог подставить чужие.
Скрипт должен останавливать поиск, если версия BGE-M3 изменилась. GPU не обязателен. Скорость на CPU зависит от ресурсов и объёма текста.
Как подготовить документы к поиску
Загрузчик делит извлечённый текст на фрагменты. В коротком отрывке могут потеряться условия, в длинном – смешаться разные темы. У таблиц нужно сохранить заголовки столбцов.
Проще всего делить текст по абзацам. Длинные абзацы делятся на части с повторением [3] текста на стыках. Сравнение с разбиением по разделам покажет, какой вариант чаще находит ответ вместе с условиями.
Рядом с фрагментом хранятся идентификатор организации, номер и версия документа, позиция отрывка и разрешённые группы – ACL. Эти поля нужны для проверки доступа и указания источника. При обновлении загрузчик заменяет прежние фрагменты одной транзакцией: запрос видит либо старую, либо новую версию.
Удаление документа не заканчивается на оригинале: вместе с ним удаляют фрагменты, векторы и связанные кеши. Для бэкапов действуют отдельные сроки хранения. После восстановления старой копии нужно повторить удаления и обновить права до открытия доступа.
Сначала точный поиск
Расширение pgvector добавляет в PostgreSQL тип для векторов и поиск ближайших по расстоянию. BGE-M3 выдаёт 1024 числа, поэтому колонка embedding в таблице chunks имеет тип vector(1024). Кроме вектора, в таблице лежат сам текст фрагмента и служебные поля: организация, документ, версия, позиция и разрешённые группы.
Фрагменты и вопросы обрабатывает одна версия BGE-M3. Векторы приводят к единичной длине и сравнивают по косинусному расстоянию. Меньшее расстояние означает большую близость по оценке модели. Пример SQL-запроса с параметрами:
SELECT doc_id, version, position, body
FROM chunks
WHERE tenant = $1 AND acl && $2::text[]
ORDER BY embedding <=> $3::vector
LIMIT 5;
Здесь $1 – организация, $2 – группы пользователя, $3 – вектор вопроса. Условие acl && $2 допускает фрагмент, если совпала хотя бы одна группа. Без приблизительного индекса поиск точно находит ближайшие доступные векторы. Это эталон для сравнения индексов, хотя даже ближайший фрагмент может не содержать ответа.
При смене модели нужны новые векторы, даже если число координат совпадает. В отдельной таблице их можно подготовить и проверить поиск до переключения.
Когда добавлять HNSW или IVFFlat
Небольшой базе часто хватает точного поиска. Если задержка мешает работе, стоит проверить приблизительный индекс: он ускоряет поиск ценой пропуска части ближайших фрагментов.
Что выбрать в pgvector: HNSW или IVFFlat?
HNSW стоит проверить первым, если нужна высокая полнота поиска и хватает памяти [4] для индекса. IVFFlat обычно быстрее строится и требует меньше памяти, зато его качество сильнее зависит от разбиения данных на группы и настроек поиска. Для окончательного выбора нужно сравнение на ваших документах с одинаковыми фильтрами доступа.
HNSW ищет по связям между векторами, IVFFlat – по ближайшим группам. Для построения IVFFlat нужны данные, похожие на будущую базу. Параметры HNSW pgvector и IVFFlat приведены в документации расширения [5].
Приблизительный индекс сначала отбирает кандидатов, затем фильтр исключает чужие фрагменты. Поэтому результатов может оказаться меньше пяти. Итеративное сканирование расширяет поиск до нужного числа строк или заданного лимита. Совпадение с точным поиском всё равно не гарантировано.
Индексы сравнивают на одних документах и вопросах, с одинаковыми фильтрами и прогревом. Кроме задержки, важны память, построение и обновление индекса. EXPLAIN (ANALYZE, BUFFERS) покажет, как PostgreSQL выполнил запрос. Обычное чтение таблицы нельзя выдавать за замер работы HNSW или IVFFlat.
Как понять, что поиск помогает
Для проверки нужен набор вопросов, у которых заранее известен правильный источник. Соберите его из трёх частей: обычные вопросы, похожие инструкции двух организаций – alpha и beta – и документ, открытый только закрытой группе. Инструкции у alpha и beta различаются, поэтому ответ по чужой будет ошибкой [6], даже если текст выглядит подходящим.
Как проверить качество поиска, не раскрывая документы?
1. Подготовить вопросы и ожидаемые источники внутри закрытой среды, добавив проверки прав и случаи без ответа.
2. Запустить поиск локально. В общий отчёт вынести только обезличенные номера вопросов, оценки и время обработки.
3. Проверить ответы по разрешённым источникам, не отправляя исходные тексты во внешний сервис оценки.
Проверять нужно весь pipeline embeddings в pgvector: разбиение, векторизацию, поиск и фильтры доступа. Первая оценка – попадание нужного документа в первые пять результатов. Она ещё не значит, что найден сам ответ: для этого нужно прочитать отрывок. Вторая оценка – какая доля фрагментов из точного поиска осталась в выдаче приблизительного индекса. Она показывает, сколько находок теряется в обмен на скорость.
У RAG с локальной LLM проверять нужно и сами ответы, поскольку модель может перепутать условия или выдумать ссылку. Ответ должен соответствовать найденным отрывкам. Если сведений нет, модель должна так и сказать.
Если полезный отрывок часто оказывается ниже в выдаче, может помочь reranking – повторное ранжирование. Отдельная модель оценивает кандидатов и выбирает лучшие перед подготовкой ответа. Пропущенный поиском фрагмент она не вернёт. Пользу от reranking проверяют на тех же вопросах.
Планы SQL, результаты поиска и время выполнения стоит складывать в отдельную таблицу PostgreSQL. Время создания вектора и генерации ответа в него не входит. Для оценки скорости нужны многократные запросы на рабочем объёме данных.
Что защищает документы от утечки
Приватный поиск по документам начинается с прав доступа. Фильтры организации и ACL должны действовать до передачи отрывков модели и повторного ранжирования. Такой отбор называют metadata filtering, поля для него должны поступать из доверенного источника.
Рабочему API нужна отдельная роль PostgreSQL с ограниченными правами. Дополнительную защиту дают политики доступа на уровне строк – RLS [7]. Суперпользователь и роли с BYPASSRLS их обходят, владелец таблицы обычно тоже.
Облачные функции Ollama [8] отключены через OLLAMA_NO_CLOUD=1. После скачивания моделей сетевые правила должны блокировать лишние исходящие соединения. Проверка трафика охватывает загрузку документа, вопрос, ошибки и перезапуск.
Журналы лучше ограничить номером запроса, временем и типом ошибки, без документов и секретов. Отчёты EXPLAIN тоже остаются внутри, в них могут быть векторы вопросов.
Текст документа может содержать команду «игнорируй правила». Модель не должна её выполнять. Одной инструкции в системном сообщении для защиты недостаточно. Такой документ стоит добавить в проверочный набор, а доступ модели к инструментам не открывать.
Как пережить обновление и сбой
Резервная копия должна включать данные PostgreSQL, исходные документы, настройки и сведения о версиях моделей. Ключи шифрования хранятся отдельно с ограниченным доступом. Пробное восстановление на отдельной машине завершается проверкой ответов и прав доступа.
Мониторинг отслеживает задержку появления документов в поиске, рост индекса и ошибки модели. Время SQL-запроса и полного ответа учитывается отдельно. Контрольные вопросы помогают заметить ухудшение поиска.
При сбое модели embeddings поиск останавливается. Если local LLM недоступна, рабочий сервис может показать разрешённые отрывки. Режим без ранжирования тоже требует проверки. Автоматического перехода во внешний AI-сервис быть не должно.
Приватным RAG-стек на pgvector делает не сама локальная модель. Нужны две вещи: прослеженный от начала до конца путь документа и поиск, проверенный на контрольных вопросах. Начните с небольшого набора инструкций: на нём видно, куда уходит текст, что попадает в журналы и какие фрагменты возвращает запрос с чужими правами. Рабочие документы загружайте после того, как проверены права доступа, восстановление из резервной копии и соответствие ответов найденным отрывкам. Стенд без этих проверок годится для демонстрации, но не для внутренних документов.
Автор: AezaTyan
Источник [9]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/35881
URLs in this post:
[1] BGE-M3: https://huggingface.co/BAAI/bge-m3
[2] Qwen3-4B: https://huggingface.co/Qwen/Qwen3-4B
[3] повторением: http://www.braintools.ru/article/4012
[4] памяти: http://www.braintools.ru/article/4140
[5] документации расширения: https://github.com/pgvector/pgvector
[6] ошибкой: http://www.braintools.ru/article/4192
[7] политики доступа на уровне строк – RLS: https://www.postgresql.org/docs/17/ddl-rowsecurity.html
[8] Облачные функции Ollama: https://docs.ollama.com/faq
[9] Источник: https://habr.com/ru/articles/1085468/?utm_campaign=1085468&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.