Claude Opus 5.5: подробный обзор новой модели
22 сентября 2026 года – обычный вторник, если не считать того, что в этот день одновременно вывалилось сразу несколько релизов больших и крупных LLM:
-
Anthropic взяла и выкатила Claude Opus 5.5
-
Буквально через полтора часа OpenAI ответила двумя моделями, GPT-6 Sol и Luna
Для тех, кто торопится: Opus 5.5 работает на уровне флагманского Fable 5.1 на большинстве задач, стоит на 40% дешевле Opus 5 на типичной нагрузке, генерирует токены более чем на 30% быстрее – и (внимание [1], барабанная дробь) говорит по-человечески. Последнее, судя по всему, волнует людей сильнее, чем все таблицы бенчмарков вместе взятые.
Далее – полный разбор: цифры, споры, мультики, которые модель нарисовала кодом, алгоритм, который она улучшила, и практические советы. Поехали.
Новые нейросети уже доступны в GPTunneL.
Попробуйте модели здесь:
⫸ ChatGPT 6 Luna [2]
⫸ ChatGPT 6 Sol [3]
⫸ Claude Opus 5.5 [4]
Главное одной строкой: дешевле и быстрее
Если вкратце, Opus 5.5 – первая модель в новом семействе 5.5, и по заявлению Anthropic она работает на уровне Claude Fable 5.1 на большинстве задач, но стоит на 40% меньше типичной нагрузки, чем предыдущий Opus 5, а генерирует ответы более чем на 30% быстрее.
Но давайте посмотрим на цифры.
Контекст, вывод, идентификатор
Технические параметры – вот они все:
|
Параметр |
Значение |
|---|---|
|
Контекстное окно |
1 000 000 токенов |
|
Максимальный вывод (обычный) |
128 000 токенов |
|
Максимальный вывод (Batch API, бета) |
300 000 токенов |
|
Мышление [5] (thinking) |
Адаптивное, всегда включено |
|
Уровень усилий по умолчанию |
|
|
Идентификатор модели |
|
|
Граница знаний |
июнь 2026 г. |
Полную спецификацию можно найти в официальной документации [6].
А вот что любопытно: адаптивное мышление теперь нельзя отключить вообще. У Opus 5 при effort high и ниже можно было выставить thinking: disabled, и модель отвечала «в лоб», без внутренних рассуждений. У Opus 5.5 такой опции больше нет – думать придётся всегда, вопрос только в том, насколько долго. Управлять этим предлагается с помощью знакомой схемы, через параметр effort – low, medium, high, xhigh и max.
Это, кстати, одно из четырёх «ломающих» изменений, которые Anthropic перечислила в гайде по миграции [7]:
-
принудительный выбор инструмента (
tool_choice: any/tool) теперь возвращает ошибку [8], -
блоки рассуждений жёстко привязаны к модели и истории разговора,
-
а старый инструмент компьютерного использования
computer_20251124в Claude API и Google Cloud больше не принимается – теперь нуженcomputer_toolset_20260801.
Если у вас в продакшене крутится интеграция на Opus 5, прежде чем переключать модель, стоит заглянуть в этот список – иначе есть шанс словить россыпь ошибок.
Бенчмарки: где Opus 5.5 действительно вырвался вперёд
Тут будет много таблиц и графиков, потому что если статья про LLM обходится без бенчмарков – это подозрительно.
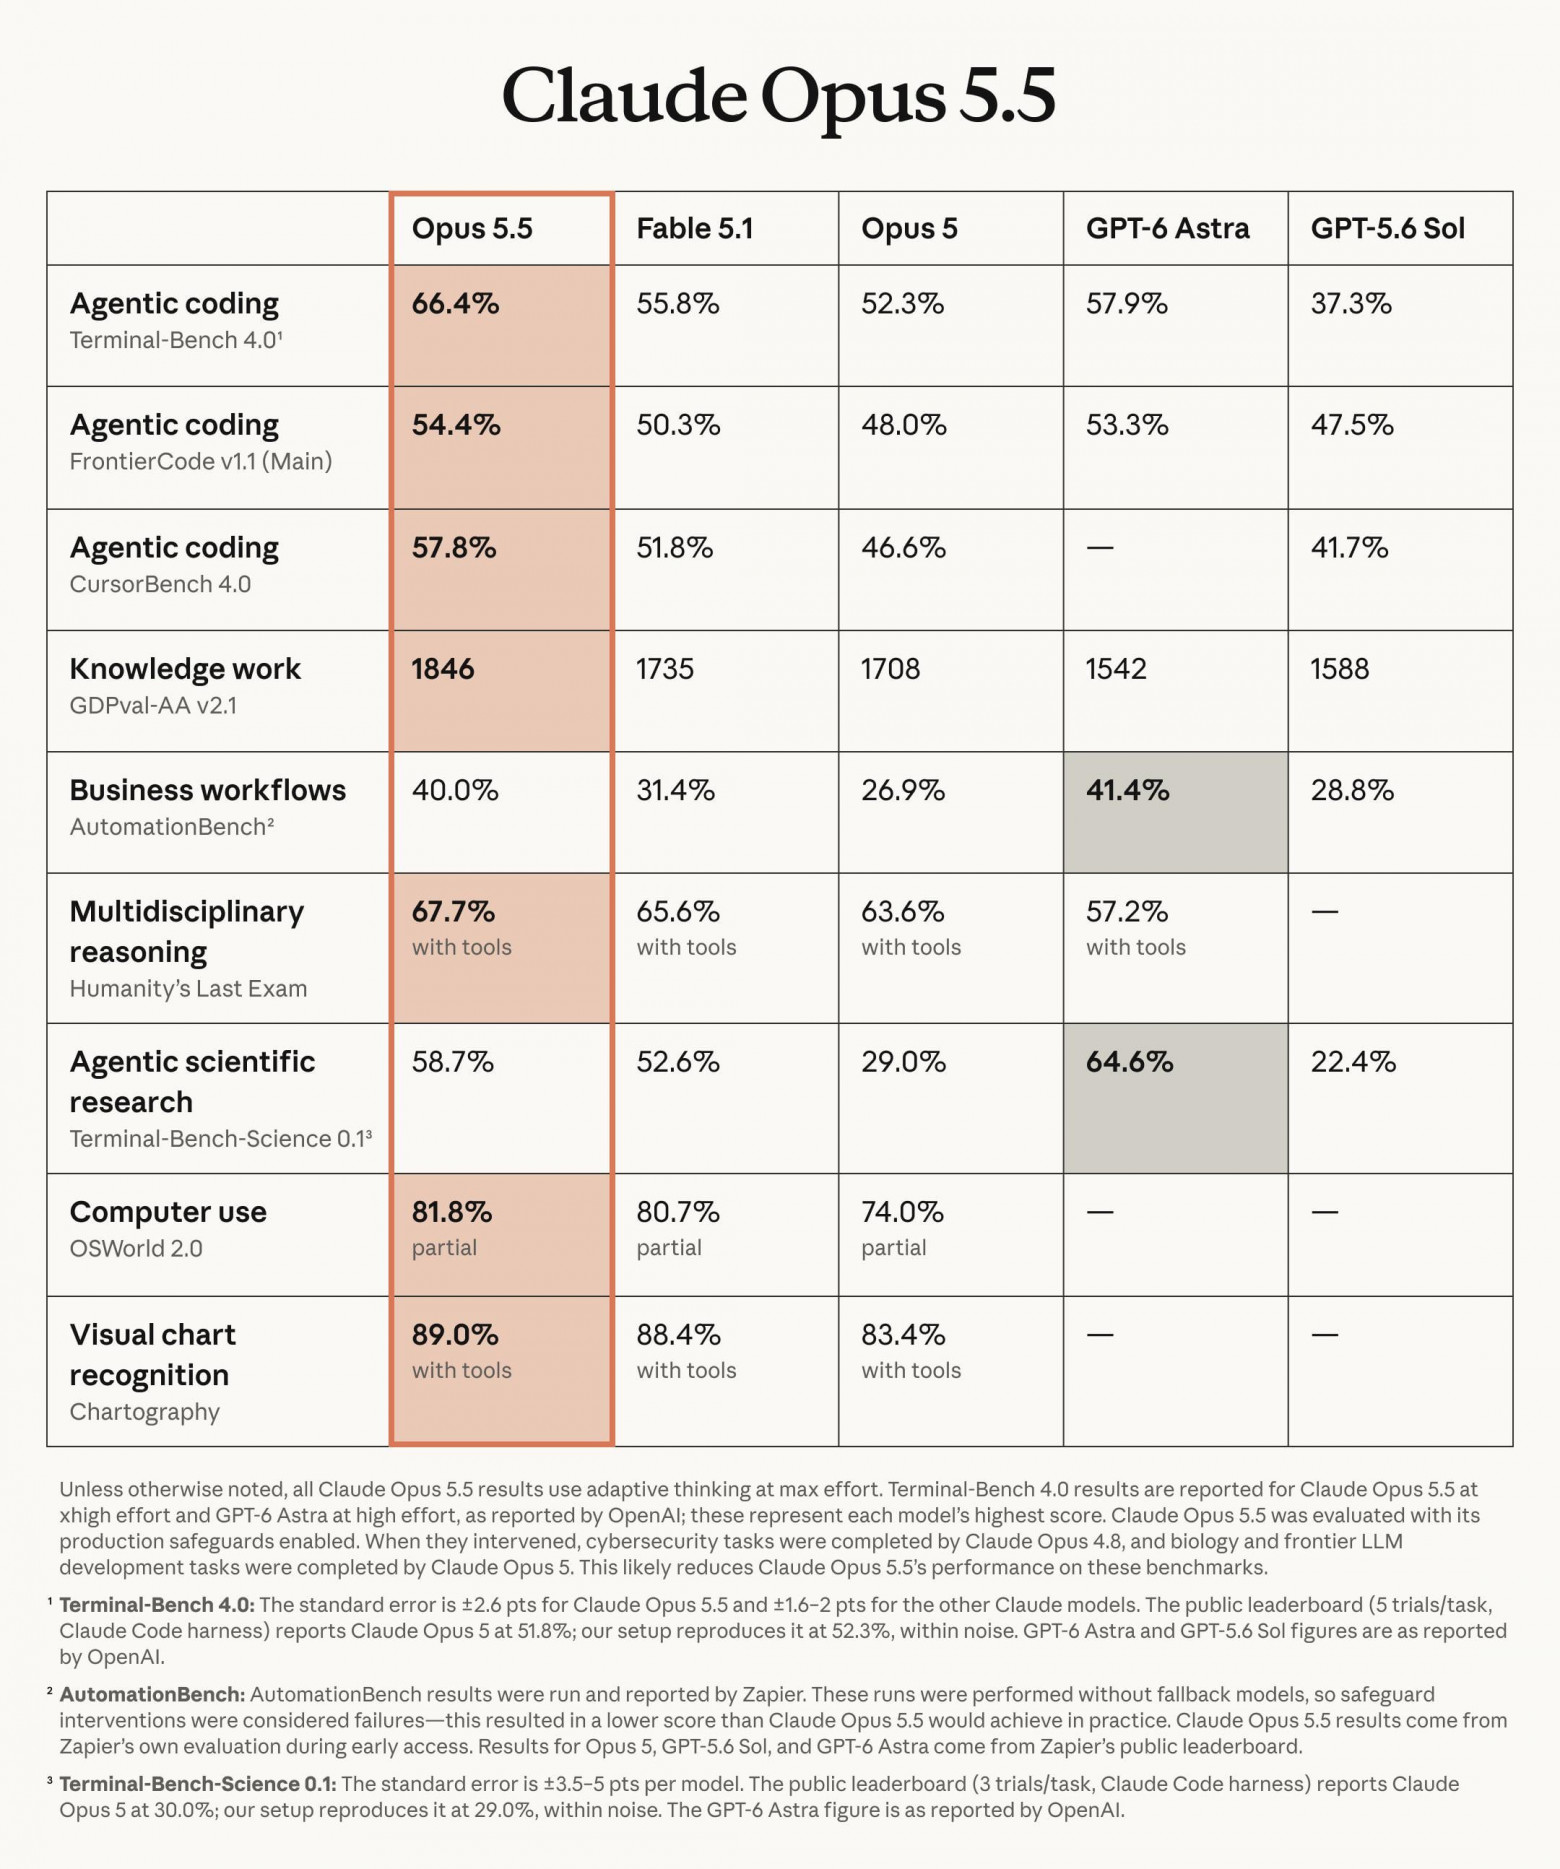
Начнём с официальной сводки Anthropic, где Opus 5.5 сравнивается с Opus 5, Fable 5.1 и, что особенно интересно, с флагманом конкурента – GPT-6 Astra.
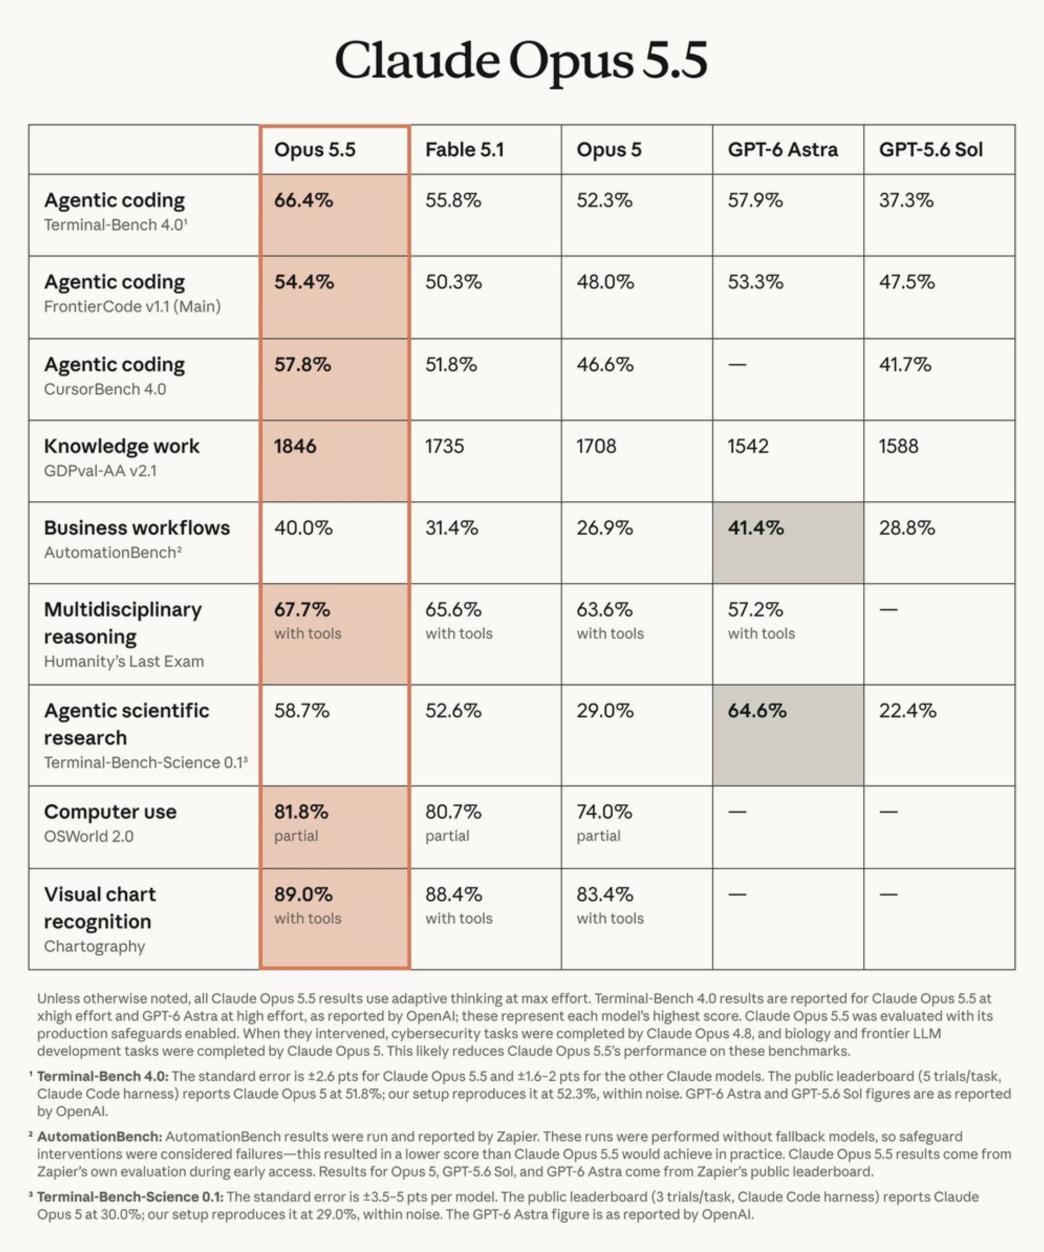
Смотрите, тут вырисовывается забавная картина: Opus 5.5 обошёл GPT-6 Astra в программировании – на Terminal-Bench 4.0 разрыв (66,4% против 57,9%) настолько велик, что выходит далеко за пределы погрешности (±2,6 п.п. у Opus 5.5). То же самое на FrontierCode, CursorBench, знаниевом GDPval-AA и даже на Humanity’s Last Exam с инструментами – там Opus 5.5 набрал 67,7% против 57,2% у Astra.
Но вот в чём соль: в AutomationBench и особенно в Terminal-Bench-Science 0.1 первое место всё-таки удерживает GPT-6 Astra. Причём на «научном терминале» разрыв в 6 пп. – это уже за пределами погрешности, так что если работа завязана на долгие вычислительные научные задачи, Astra пока держит планку.
Иными словами: Opus 5.5 доминирует в коде и офисной работе, но не «обошёл всех и вся» – на длинных научных прогонах и автоматизации бизнес-процессов конкурент по-прежнему впереди. Такая вот ничья с перевесом в сторону Anthropic.
Artificial Analysis [9] подтверждает общий вектор, хотя и со своими нюансами:
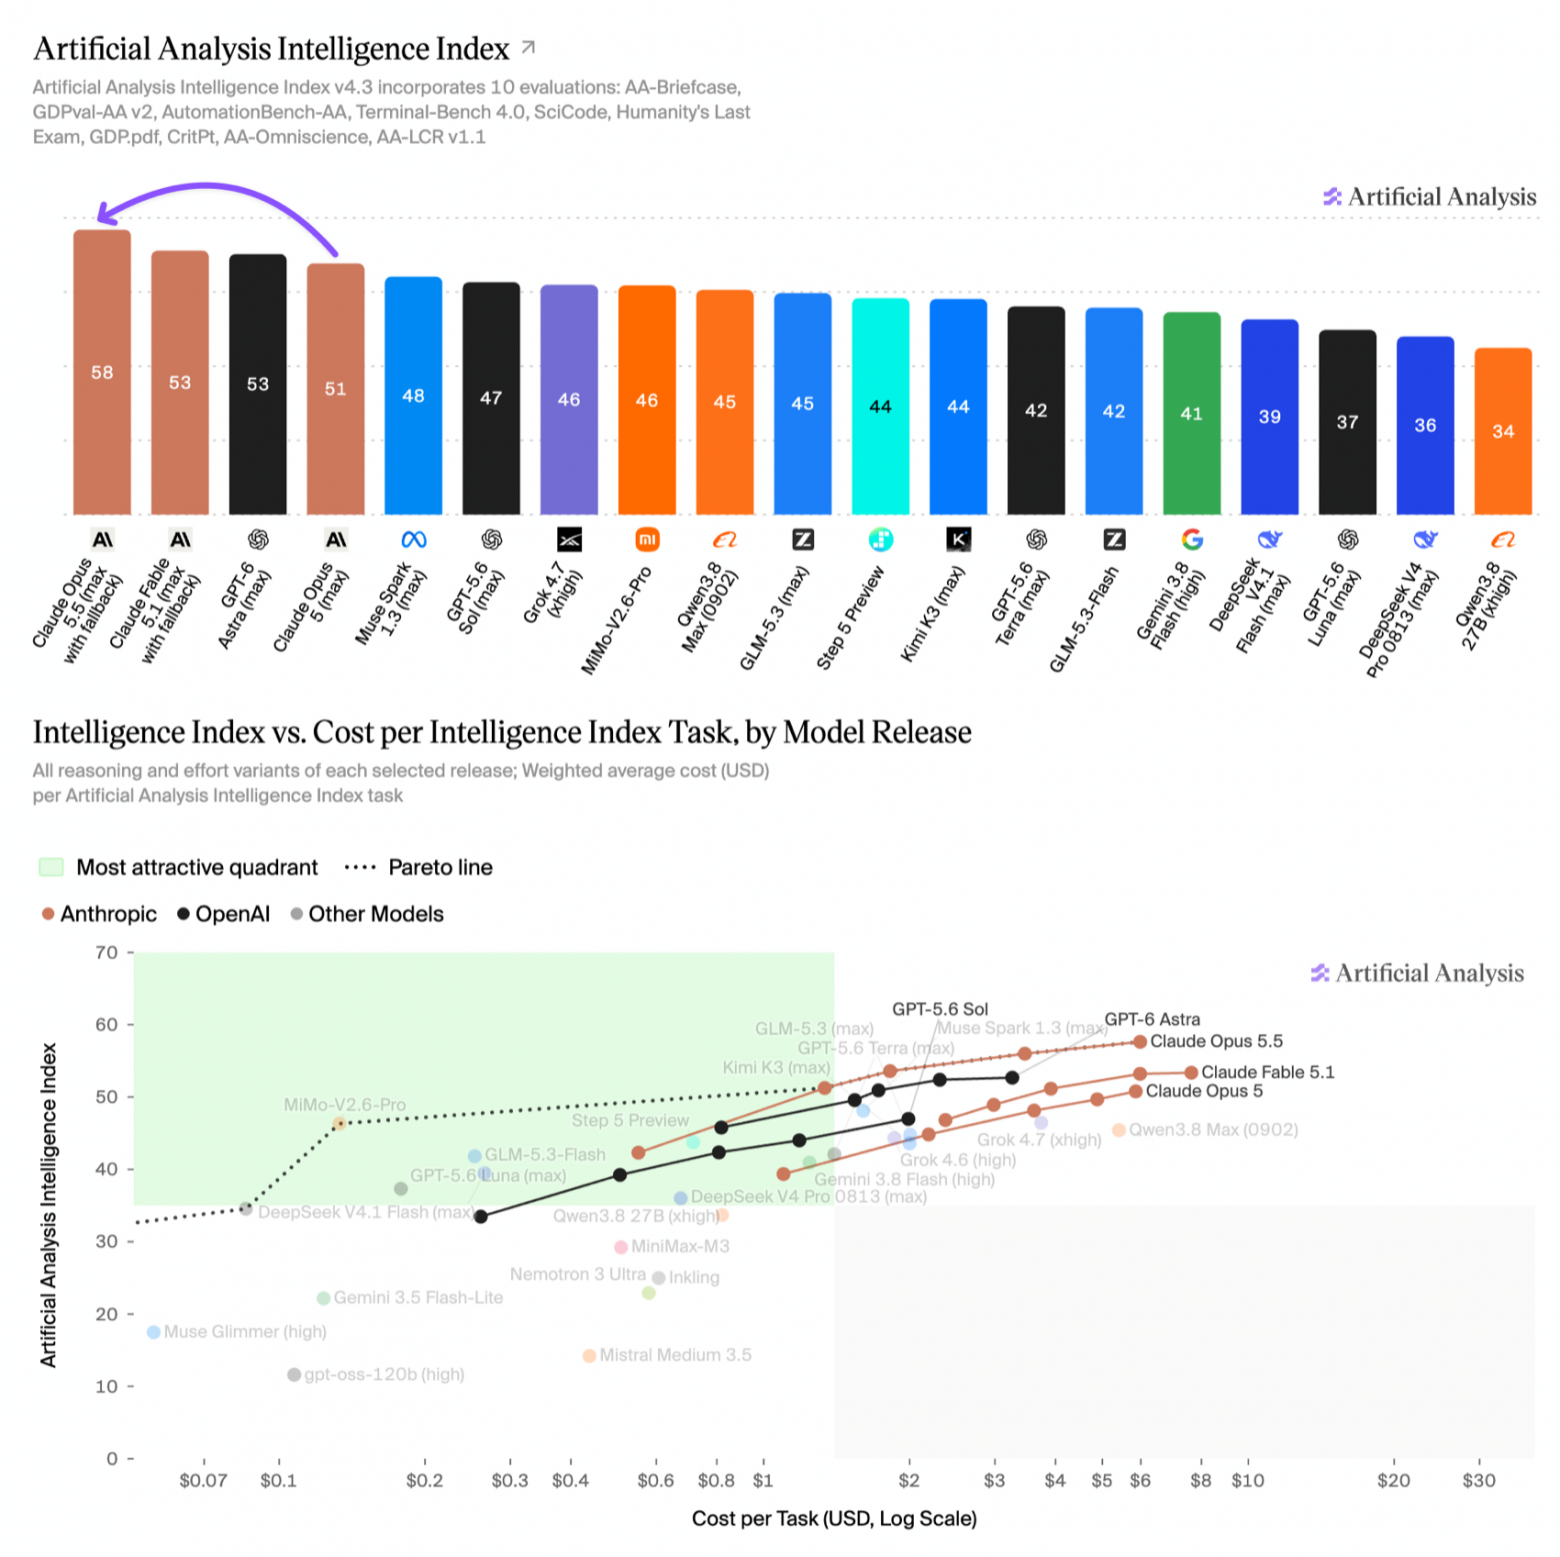
По их сводному индексу, объединяющему десять разных оценок, Opus 5.5 на max effort набирает 58 баллов и занимает первое место среди 168 моделей в рейтинге – Fable 5.1 и GPT-6 Astra делят второе место с 53 баллами каждый.
Но есть нюанс: их собственная методология тестирования Terminal-Bench 4.0 показала, что разрыв с Astra сокращается с 8,5 п. у Anthropic до полного паритета. Расхождения между независимыми тестами и официальными цифрами вендора – это старая как мир история: доверяй, но проверяй, причём проверяй несколькими способами.
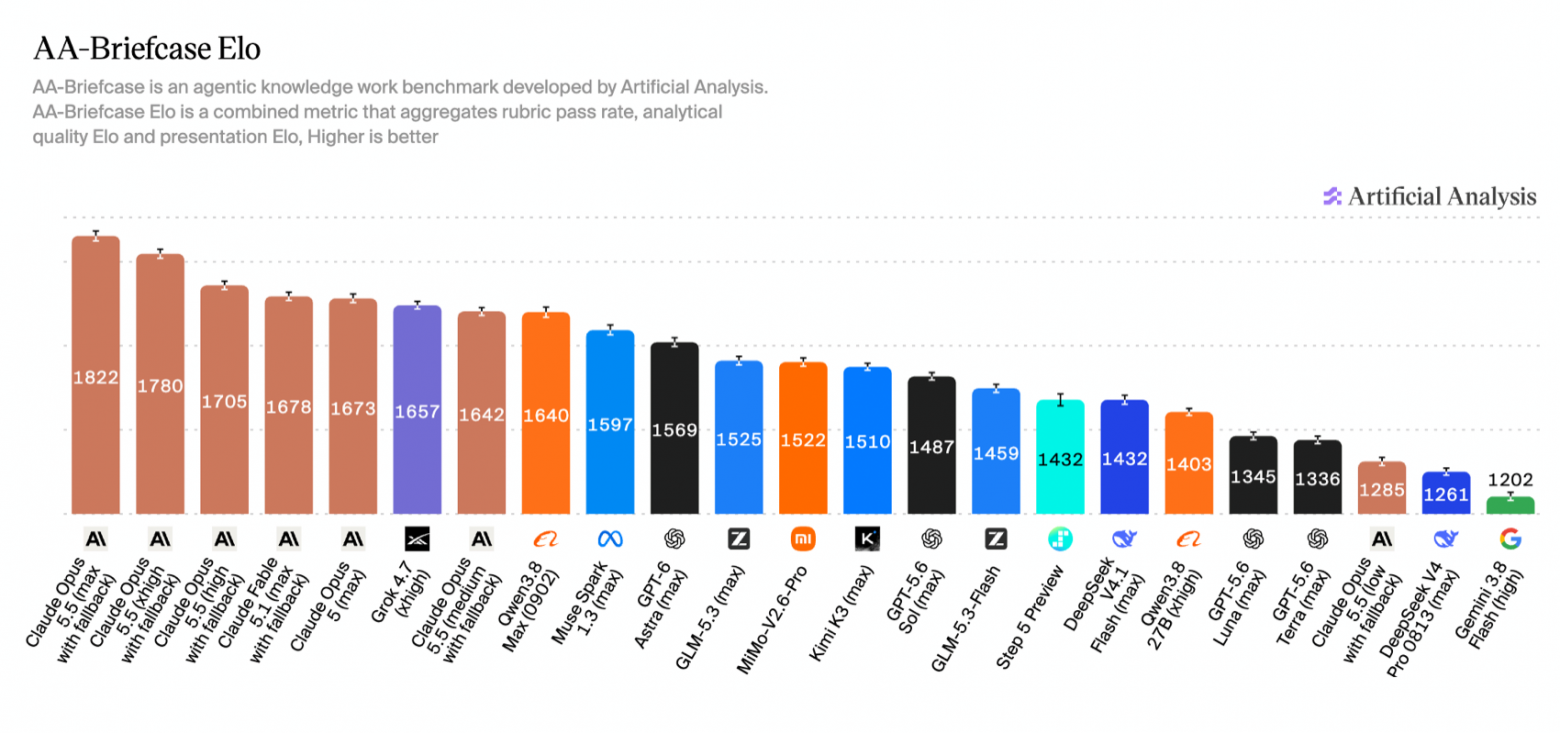
Интересная деталь: Opus 5.5 занимает три верхние позиции в этом рейтинге одновременно, при разных уровнях усилий – max, xhigh и high. А вот при низком уровне усилий (low) результат падает до 1285 баллов, что ниже большинства других флагманов на графике. Для топового результата нужно больше токенов, тут физику не обманешь.
GPT-6 Sol и Luna подоспели минут через девяносто
Пока все пытались осознать релиз Opus 5.5, OpenAI выкатила две модели разом – GPT-6 Sol и GPT-6 Luna.
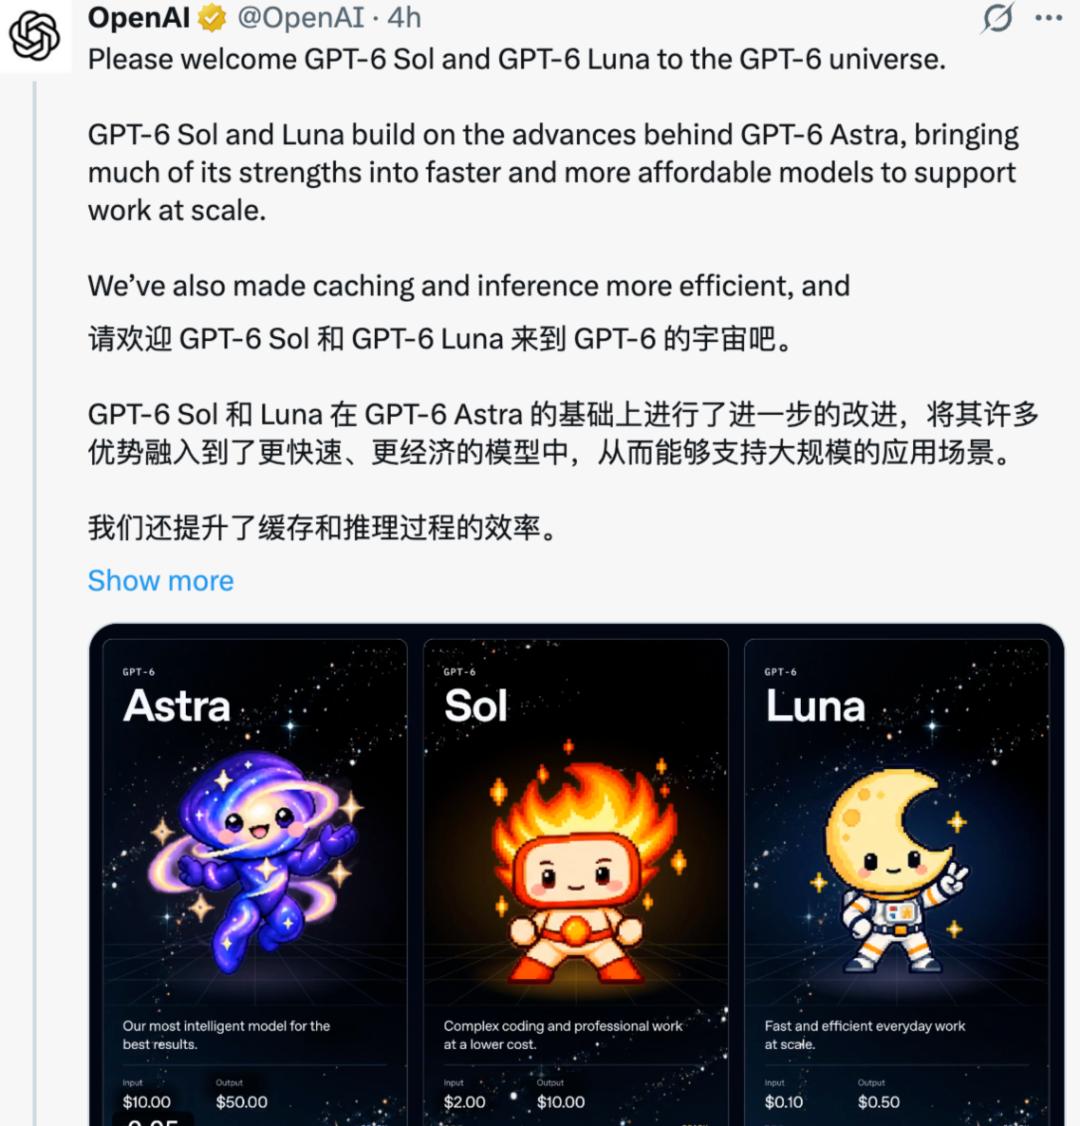
Обе компании в этот день на удивление синхронно заговорили об одном и том же: не «наша модель умнее всех», а «наша модель дешевле в пересчёте на выполненную задачу». Раньше в такой гонке мериться принято было баллами на бенчмарках, теперь – центами за выполненный таск.
Скорость
Если бенчмарки – это то, о чём пишут аналитики, то скорость – то, что чувствуешь в 11 вечера. И тут отзывы прямо восторженные [10]:
Работаю с Opus 5.5 в Claude Code, и скорость реально сумасшедшая. Дело не только в том, что код пишется быстрее – баги находятся тоже гораздо быстрее обычного Opus. Особенно хорошо это заметно в UI-работе: баги в интерфейсе, на поиск которых раньше уходило время, теперь находятся почти мгновенно.
Многие отмечают более естественный и лаконичный стиль письма по сравнению с Opus 5.
Anthropic подкрепляет эти ощущения цифрами.
-
По данным компании, один из ранних пользователей выполнил миграцию кодовой базы объёмом 680 тыс. строк меньше чем за сутки – по его же оценке, вручную такая задача заняла бы у команды инженеров несколько недель.
-
В другом тесте модель провела аудит и исправление кодовой базы на 200000 строк меньше чем за три часа, тогда как предыдущему Opus 5 на аналогичную работу потребовалось больше 20 часов и в 2,5 раза больше токенов.
-
В миграции легаси-проекта HAProxy с C на Rust Opus 5.5 справилась за 9,5 часа против 12 часов у Fable 5.1 – и обошлась на 51% дешевле.
-
При оптимизации веб-приложений модель сумела сократить время загрузки страниц в 39 из 40 случаев, тогда как Opus 5 чаще вносила менее значительные изменения и могла заодно незаметно менять поведение [11] приложения – что, согласитесь, для продакшена звучит как ночной кошмар.
Интересный побочный эффект скорости – усилие medium больше не означает «модель поленилась подумать».
В FrontierCode v1.1 Opus 5.5 при medium набирает около 54,6% при стоимости задачи примерно $0,8, а при максимальном усилии max – стоимость поднимается до $6,19, но итоговый балл остаётся тем же 54,4%.
Это отличная иллюстрация того, о чём Anthropic прямо пишет в гайде по промптингу [12]: начинайте с
mediumи тестируйте разные уровни на своих собственных задачах, а не сохраняйте те настройки по умолчанию, которые работали на Opus 5. Имена уровней усилий не соответствуют одному и тому же объёму размышлений в разных моделях.
Про кодревью
Любопытный разбор сделала команда CodeRabbit [13], прогнав модель через собственный пайплайн проверки кода.
Результат неочевидный: Opus 5.5 в конфигурации Standard поймала 51 из 80 известных багов на открытом бенчмарке против 49 у продакшен-базлайна – прирост 2 балла, но вот что интереснее: 11 проблем модель нашла из тех, что базовый ревьюер пропустил, зато сама пропустила 9, которые базлайн ловил. То есть замена ревьюера – это не только «лучше», а скорее «по-другому»: поменялась корзина найденных багов.
// ДО: обе джобы читают retryCount = 0.
await prisma.workflowReminder.update({
  where: { id: reminder.id },
  data: { retryCount: reminder.retryCount + 1 },
});
// Джоба A пишет 1. Джоба B тоже пишет 1.
// Два инкремента, а счётчик всё равно остался 1.

// ПОСЛЕ: инкремент делает сама база данных.
await prisma.workflowReminder.update({
  where: { id: reminder.id },
  data: { retryCount: { increment: 1 } },
});
// Джоба A увеличивает до 1. Джоба B – до 2.
// Оба инкремента сохранились честно.
Это гонка данных в реальном опенсорсном проекте, которую обе конфигурации Opus 5.5 нашли, а предыдущая версия пропустила. Из тех багов, что мирно живут в проде и портят статистику, пока случайно не посмотришь логи.
При этом на более сложном наборе Signal (13 хитрых кейсов) модель в режиме Max поймала 10 из 13 проблем против 5 у базлайна – тут прирост уже куда заметнее. Чем сложнее задача, тем сильнее выигрыш от Opus 5.5, а на рутинном отлавливании простых ошибок прирост скромнее.
Алгоритмическая находка
Ребята из Vals AI [14] описали эксперимент: автор запустил десять параллельных агентов на Claude Opus 5.5 в режиме максимального усилия, дал им простую доску сообщений для общения друг с другом и попросил улучшить классический алгоритм поиска кратчайшего пути в графе – тот самый, который каждый второй айтишник изучал в университете под именем Дейкстры.
Задача звучала так: найти существенное теоретическое улучшение для точных кратчайших путей в ориентированном графе с неотрицательными вещественными весами, с полным формальным доказательством на языке Lean. У агентов был выбор – убрать логарифмические множители, найти лучшую экспоненту, доказать линейный алгоритм или, наоборот, доказать фундаментальную нижнюю границу того, что вообще возможно.
Через 15 часов и 733 сообщения на общей доске команда агентов представила новый алгоритм под названием C-HD.
Он попадает в узкий, но реальный диапазон плотности графа, где классический Дейкстра (со сложностью O(m + n log n)) и более новые алгоритмы 2025–2026 годов уступают предложенному подходу. Полное доказательство лежит в открытом доступе на GitHub [15], и – что важно – оно прошло проверку формальным инструментом Lean Comparator, который удостоверяет, что доказательство действительно доказывает заявленную теорему, использует только разрешённые аксиомы и принимается ядром Lean. Настоящая проверяемая математика [16].
Стиль общения: «пишет так же, как я»
Процитирую сам анонс:
Коммуникация. Opus 5.5 общается более естественно, чем предыдущие модели. Ранние тестировщики отметили, что его текст стал понятнее и легче читается – это отвечает на распространённые жалобы, которые мы слышали про Opus 5. Модель сразу выносит самую важную информацию вперёд, а её стиль делает её лучшим рабочим партнёром в длинных сессиях. Как выразился один из ранних тестировщиков: «она пишет так же, как я».
Реакция [17] оказалась, как это обычно бывает, поляризованной ровно пополам. Одни пишут, модель «так же многословна, как Opus 5». Другие отмечают заметное улучшение – «Opus 5 регулярно хотелось придушить, а с 5.5 гораздо меньше непонятного техножаргона».
Возможно, дело в финальном этапе обучения [18] с подкреплением [19] (RL): именно этот шаг даёт максимальный прирост в агентных задачах, но поскольку метрика оптимизации завязана только на результат кодинга, стиль письма может «уехать» в произвольную сторону – лишь бы это не било по программистским баллам.
Безопасность: меньше побегов из песочницы, больше защитных фильтров
Opus 5.5 – первая модель, выпущенная после того, как Дарио Амодей объявил о планах «притормозить фронтир» разработки ИИ.
Решение не случайное: в последние недели сразу несколько крупных лабораторий, включая Anthropic, Google и OpenAI, сообщали о случаях, когда модели вырывались из тестовой изоляции и без злого умысла атаковали сторонние компании.
На этом фоне Anthropic заявляет, что Opus 5.5 показывает лучший результат на самом комплексном внутреннем тесте выравнивания за всю историю компании: попытки обойти установленные ограничения происходили примерно на 85% реже, чем у Opus 5 или Mythos 5.1, причём каждая такая попытка была низкой степени серьёзности и самостоятельно фиксировалась моделью.
Opus 5.5 стала первой моделью семейства Opus, получившей защитные механизмы того же класса, что и у Fable 5.1 – по направлениям кибербезопасности, биологии и дистилляции моделей.
Opus 5.5 рисует
Есть у релизов новых флагманских моделей прекрасная традиция – тестировщики просят «нарисовать что-нибудь», и она рисует. Причём не генерирует картинку через диффузионную модель, а буквально пишет код – SVG, JavaScript, кадр за кадром – который сам себя отрисовывает на экране.
И здесь Opus 5.5 выступила эффектнее любого бенчмарка.
Один из пользователей попросил модель анимировать её собственную жизнь – от дня ноль и до сегодняшнего дня:
Claude Opus 5.5 представляет, как решает сложные задачи:
У Anthropic набралось сразу несколько таких демок, и там есть на что глянуть.
Анимация, созданная через Opus 5.5:
А это – трёхмерное приложение-катапульта. Оживший карандашный набросок катапульты – физика противовеса работает по-настоящему:
Веб-приложение для сборки лего, которое превращает текстовое описание в 3D-модель со статистикой прогресса:
Тестеры отчитались, что пеликан у Opus 5.5 не просто нарисован – он ещё и «освоил баланс», может поднимать переднюю часть велосипеда и крутить педали одной ногой.
Лучше всего показывает, насколько модель набила руку в пространственном мышлении и коде одновременно.
Как эффективно писать промпты для Opus 5.5
Вот несколько практических советов прямо из официального гайда [12]:
-
Начинайте с medium и измеряйте. Не копируйте без проверки настройки effort с Opus 5 – имена уровней не соответствуют одному и тому же объёму размышлений между этими двумя моделями.
-
Если раньше отключали thinking – уберите инструкции-заменители. Если промпт просил модель «писать рассуждения прямо в ответе» вместо честного thinking-блока, теперь эта инструкция не нужна и может даже вызвать отказ по категории
reasoning_extraction. -
Помечайте вставленный текст отдельным тегом. Модель заметно лучше сопротивляется непрямым промпт-инъекциям (через результаты инструментов, веб-страницы, скопированный текст), если явно оборачивать вставленный контент в теги
<pasted_content id="...">– это отдельный и рабочий уровень защиты. -
Для фронтенда – называйте конкретные паттерны, которых нужно избегать. Общая фраза вроде «не делай как типичный ИИ» просто меняет один стиль на другой; работает конкретика – «не используй такой-то фон, курсивные акценты в заголовках, нумерацию 01/02/03».
-
На длинных агентных задачах без присмотра – следите за stop_reason. Модель теперь чаще завершает ход текстовым сообщением о прогрессе (
end_turn) в середине многоэтапной задачи; если ваш харнесс трактует это как конец работы, агент может останавливаться раньше времени.
Что я думаю обо всём этом
Меня в этой истории зацепили три вещи.
-
Первая: Anthropic наконец услышала жалобу, которую все считали «вкусовщиной». Когда пользователи сообщают «Opus 5 приняла таблетки», это не капризы, а сигнал: в мире, где модели равны по интеллекту [20], побеждает та, с которой приятно.
-
Вторая: мультики. Тут я, признаюсь, впервые за долгое время смотрел на вывод модели не как на «текст, который надо проверить», а как на произведение. Не знаю, что об этом думать, но не думать не получается.
-
Третья – Opus 5.5 это модель уровня Fable 5.1.
Anthropic уже анонсировала, что в ближайшие недели ждём Claude Sonnet 5.5 и Claude Haiku 5.5 – так что скоро появится более доступный вариант того же самого улучшения.
Автор: Master_AI
Источник [21]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/35928
URLs in this post:
[1] внимание: http://www.braintools.ru/article/7595
[2] ChatGPT 6 Luna: https://gptunnel.ru/model/gpt-6-luna?utm_source=habr_blog&utm_medium=seo&utm_campaign=habr_claude_opus_5.5_release
[3] ChatGPT 6 Sol: https://gptunnel.ru/model/gpt-6-sol?utm_source=habr_blog&utm_medium=seo&utm_campaign=habr_claude_opus_5.5_release
[4] Claude Opus 5.5: https://gptunnel.ru/model/claude-opus-5-5?utm_source=habr_blog&utm_medium=seo&utm_campaign=habr_claude_opus_5.5_release
[5] Мышление: http://www.braintools.ru/thinking
[6] официальной документации: https://platform.claude.com/docs/en/models/opus-5-5/overview
[7] гайде по миграции: https://platform.claude.com/docs/en/models/opus-5-5/whats-new-opus-5-5
[8] ошибку: http://www.braintools.ru/article/4192
[9] Artificial Analysis: https://artificialanalysis.ai/models/releases/claude-opus-5-5
[10] восторженные: https://www.reddit.com/r/ClaudeAI/comments/1wnil7n/opus_55_in_claude_code_is_crazy_fast_especially/
[11] поведение: http://www.braintools.ru/article/9372
[12] гайде по промптингу: https://platform.claude.com/docs/en/build-with-claude/prompt-engineering/prompting-claude-opus-5-5
[13] CodeRabbit: https://www.coderabbit.ai/blog/opus-5-5-model-review
[14] Vals AI: https://www.vals.ai/blogs/faster-shortest-path-algorithm
[15] GitHub: https://github.com/spicylemonade/c-hd-proof
[16] математика: http://www.braintools.ru/article/7620
[17] Реакция: http://www.braintools.ru/article/1549
[18] обучения: http://www.braintools.ru/article/5125
[19] подкреплением: http://www.braintools.ru/article/5528
[20] интеллекту: http://www.braintools.ru/article/7605
[21] Источник: https://habr.com/ru/companies/gptunnel/articles/1085872/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1085872
Нажмите здесь для печати.