Строим продвинутый каркас для ИИ-агента
В основе базового agentic harness — простой цикл: LLM получает задачу, выбирает и вызывает инструмент, результат возвращается в контекст, после чего модель решает, какое действие выполнить следующим. Цикл продолжается, пока модель не решит, что задача выполнена.
Этот цикл корректен, но наивен. Один пилот на хорошем истребителе вполне может выиграть воздушный бой, но никто не ведёт так целую воздушную операцию. В реальных операциях есть планировщики миссий, которые ещё до взлёта определяют, какие вылеты предстоит выполнить; эскадрильи, параллельно выполняющие независимые задачи; топливные лимиты и сигнал bingo fuel, после которого нужно возвращаться на базу; бортовые самописцы, позволяющие восстановить ход каждого вылета; наконец, разборы после выполнения, на которых определяют, была ли миссия действительно успешной.
Ничто из этого не заменяет пилота. Всё это создаёт вокруг него инфраструктуру, благодаря которой система в целом остаётся быстрой, безопасной, удобной для отладки и измеримой.
С агентами происходит то же самое. В этой статье мы возьмём базовый агентный цикл и последовательно добавим к нему типизированные инструменты, DAG и параллельное выполнение, многоуровневую память [1], верификацию, разделение ролей Planner / Worker / Critic, многомерные бюджеты и трассировку — а затем соединим всё это тонким оркестратором.
Весь эксперимент строится вокруг одного вопроса:
Как превратить простой агентный цикл в надёжную систему, способную планировать, действовать, восстанавливаться после ошибок и доказывать, что она действительно сделала всё правильно?
Эта публикация — перевод и адаптация статьи Бруно Гонсалвеса Building an Advanced Agentic Harness, подготовленные командой Островка. В оригинале материал продолжает серию Data For Science об устройстве agentic harness.
Сквозной пример
В оригинальной серии автор начинает с минимального agentic harness — цикла, в котором модель получает задачу, при необходимости вызывает инструмент, возвращает результат в контекст и продолжает работу до завершения задачи. Мы не переводили отдельную статью про базовый вариант, поэтому здесь приведём только исходную точку, от которой дальше будет наращиваться архитектура.
def run_agent(goal: str, llm_provider, budget: Budget | None = None) -> AgentState:
    state = AgentState(goal=goal, budget=budget or Budget())
    system = build_system_prompt()
    consecutive_errors = 0

    while state.status == "running" and state.budget.has_room():
        state.budget.steps_used += 1
        user = build_user_prompt(state)

        t0 = time.time()
        raw = llm_provider.complete(system=system, user=user)
        latency = int((time.time() - t0) * 1000)

        result = validate_proposal(raw)
        if not result.ok:
            consecutive_errors += 1
            state.trace.append(Step(
                index=state.budget.steps_used,
                thought="(parser)",
                action={"type": "invalid", "raw": raw[:200]},
                observation=f"VALIDATION_ERROR: {result.error}",
                latency_ms=latency,
            ))
            if consecutive_errors >= 3:
                state.status = "failed"
            continue

        consecutive_errors = 0
        proposal = result.parsed
        action = proposal["action"]

        if action["type"] == "final":
            state.status = "done"
            state.final_answer = action["answer"]
        else:
            tool = TOOLS[action["name"]]
            try:
                obs = tool.fn(**action["args"])
                state.budget.tool_calls_used += 1
            except Exception as e:
                obs = f"TOOL_ERROR: {type(e).__name__}: {e}"
            state.trace.append(Step(
                index=state.budget.steps_used,
                thought=proposal.get("thought", ""),
                action=action,
                observation=obs,
                latency_ms=latency,
            ))

    return state
На протяжении статьи мы будем собирать агента для сравнения городов. Получив список городов, он формирует отчёт, где сравниваются численность населения и часовые пояса и даётся краткое текстовое описание каждого города.
Задача выглядит почти до смешного простой, но выбрана она не случайно.
Каждый запрос одного атрибута для одного города не зависит от остальных. Поэтому задача для трёх городов естественно раскладывается на девять вызовов инструментов, которые потенциально можно выполнить одновременно.
Итоговый отчёт, напротив, зависит от завершения всех этих вызовов: прежде чем его составлять, нужно дождаться каждого результата. Значит, перед нами уже не плоский последовательный список шагов, а настоящий граф зависимостей.
Кроме того, результат легко проверить программно: например, убедиться, что каждый запрошенный город действительно присутствует в итоговом отчёте.
Наконец, стоимость инструментов сильно различается. Получение численности населения и часового пояса — обычное чтение из словаря в памяти, а краткие описания городов и итоговая агрегация требуют вызовов LLM. Так возникает достаточно реалистичное давление на бюджет выполнения.
Для воспроизводимости инструменты получения справочных данных читают из небольшого тестового словаря CITY_FACTS, поэтому весь ноутбук можно запустить без доступа к сети. Компоненты с LLM могут работать либо с реальной моделью Anthropic, либо с детерминированным моком.
Это и подводит нас к первому примитиву.
Подключаемый «мозг»
Почти каждый компонент, который мы собираемся построить, в итоге обращается к LLM: планировщик, суммаризатор, агрегатор, критик. Если жёстко привязать этот вызов к одному SDK, весь harness станет плохо тестируемым и привязанным к конкретному провайдеру.
Поэтому прежде всего определим базовый класс, абстрагирующий детали API разных LLM-провайдеров:
class LLMProvider:
    """Shared interface. Subclass to plug in a different backend."""

    def complete(self, system: str, user: str, role: str = “default”) -> str:
        raise NotImplementedError

    async def acomplete(self, system: str, user: str, role: str = “default”) -> str:
        # Wrap sync call in a thread; works for any SDK.
        return await asyncio.to_thread(self.complete, system, user, role)
Для тестирования и отладки реализуем также MockProvider, который возвращает детерминированные ответы с учётом роли: эталонный план — когда его просят что-то спланировать, шаблонное однострочное описание — при суммаризации и вердикт pass/fail на основе правил — при проверке результата.
Это позволяет во время разработки разделить две принципиально разные проблемы: «У меня сломана оркестрация?» или «Модель просто плохо составила план?».
Благодаря мок-провайдеру все эксперименты в этой статье можно воспроизвести на любой машине, не полагаясь на поведение [2] конкретной модели.
Типизированные инструменты
В базовом harness мы вручную валидировали аргументы инструментов. Такой подход быстро перестаёт работать: каждый новый инструмент дублирует логику [3] валидации, LLM не видит формальной схемы и вынуждена угадывать структуру аргументов, а ошибки [4] превращаются в произвольные строки, по которым модели трудно понять, что именно нужно исправить.
Вместо этого опишем аргументы каждого инструмента моделью Pydantic и будем использовать одно определение сразу для всех задач:
@dataclass
class TypedTool:
    name: str
    description: str
    args_model: type[BaseModel]     # Pydantic model defining the arg schema
    fn: Callable[..., Any]
    cost_hint: float = 0.0          # relative cost for budget accounting

    def schema(self) -> dict:
        """Shape expected by Anthropic/OpenAI tool-use APIs."""

        return {
            "name": self.name,
            "description": self.description,
            "input_schema": self.args_model.model_json_schema(),
        }

    def run(self, raw_args: dict) -> Any:
        args, err = self.validate_args(raw_args)

        if err is not None:
            raise ValueError(err)
        return self.fn(**args.model_dump())
Такое решение сразу даёт несколько вещей: валидацию во время выполнения, JSON Schema для аргументов, документацию и точку учёта относительной стоимости через cost_hint. Одну и ту же схему аргументов можно использовать при описании инструментов и для Anthropic, и для OpenAI, хотя внешняя обёртка у их API различается: Anthropic использует input_schema, а OpenAI — parameters внутри function tool.
Описание каждого поля в Field(..., description=...) становится частью каталога инструментов, который получает Planner. Таким образом, одна схема служит и для проверки, и для объяснения модели, какие аргументы принимает инструмент.
Но важнее всего то, где именно возникает ошибка.
Если аргументы некорректны, мы узнаем об этом до запуска инструмента. Это особенно важно для дорогих операций и действий с побочными эффектами.
Плохой план должен fail fast — отклоняться уже на этапе валидации, а не падать где-то глубоко внутри запроса к базе данных.
К этому подходу в той или иной форме сходятся и полноценные фреймворки и API: инструменты LangChain, tool use в Anthropic и function calling в OpenAI.
В нашем реестре будет четыре инструмента с тремя уровнями стоимости:
-
get_population()иget_timezone()практически бесплатны: это обычные обращения к словарю, поэтому для них зададимcost_hint=0.1; -
summarize_city()выполняет один вызов LLM для каждого города, поэтому его относительная стоимость выше —cost_hint=1.0; -
Наконец,
aggregate_report()выполняет наиболее токеноёмкий синтезирующий вызов: он собирает все полученные данные в итоговый Markdown-отчёт. Для него зададимcost_hint=2.0.
Здесь стоит обратить внимание [5] на одну важную деталь: два последних инструмента сами обращаются к LLM.
Для Worker все инструменты выглядят одинаково, но некоторые из них — обёртки над дополнительными промптами к LLM. Иными словами, LLM-вызов здесь инкапсулирован внутри инструмента, а не является отдельным типом шага.
Поэтому такие внутренние вызовы можно кешировать, ограничивать по частоте или даже переводить на другую модель независимо от остальной части harness.
План — это граф
Базовый harness выполнял по одному действию за итерацию. Такой подход работает, пока шаги строго последовательны, но в нашей задаче есть девять независимых запросов, результаты которых сходятся в одну финальную агрегацию:
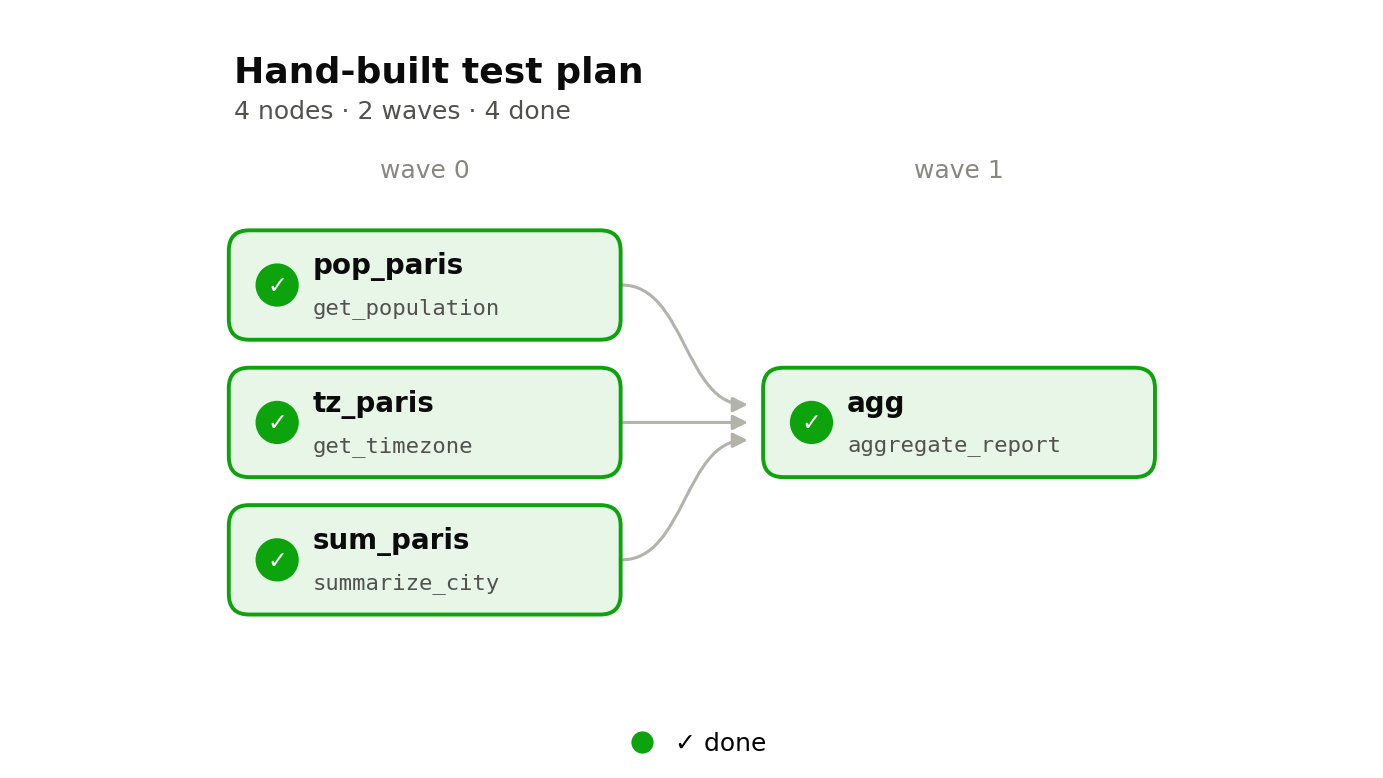
Обычный цикл while выполнял бы эти операции одну за другой. Ориентированный ациклический граф (Directed Acyclic Graph, DAG) явно описывает зависимости и позволяет исполнителю конкурентно запускать всё, что готово к выполнению прямо сейчас.
Поэтому вместо того, чтобы на каждой итерации спрашивать LLM о следующем действии, мы просим Planner сразу построить весь граф. Иными словами, модель объявляет структуру задачи до начала выполнения.
Но Planner — тоже LLM, а значит, он может галлюцинировать не только данные, но и структуру плана: например, сослаться на несуществующий ID узла или создать циклическую зависимость, которая никогда не разрешится.
Поэтому первое, что мы делаем с полученным планом, — валидируем его, прежде чем тратить токены и ресурсы на выполнение заведомо сломанного графа.
def ready_nodes(self) -> list[PlanNode]:
    """Nodes whose deps are all DONE and are themselves PENDING."""

    out = []
    for n in self.nodes.values():
        if n.status != NodeStatus.PENDING:
            continue

        if all(self.nodes[d].status == NodeStatus.DONE for d in n.deps):
            out.append(n)

    return out
ready_nodes() — сердце планировщика исполнения (scheduler): в любой момент эта функция возвращает множество узлов, все зависимости которых уже удовлетворены.
Для задачи с тремя городами Planner создаёт десять узлов: девять операций получения данных с пустыми списками зависимостей — все они готовы к конкурентному запуску — и финальный aggregate_report, который зависит от завершения всех девяти.
Параллельное выполнение графа
Executor выполняет синхронный по уровням обход DAG: вычисляет множество готовых узлов, конкурентно запускает их через asyncio.gather, помечает каждый как выполненный или завершившийся ошибкой, а затем повторяет процесс, пока работа не закончится или дальнейший прогресс не станет невозможен.
MAX_CONCURRENT = 5  # cap concurrent tool/LLM calls

async def execute_dag(dag, tools, on_step=None):
    semaphore = asyncio.Semaphore(MAX_CONCURRENT)

    async def run_node(node):
        node.status = NodeStatus.RUNNING

        async with semaphore:
            try:
                # Sync tools run in a thread pool so other nodes can proceed
                node.result = await asyncio.to_thread(tools[node.tool].run, node.args)
                node.status = NodeStatus.DONE

            except Exception as exc:
                node.error = f”{type(exc).__name__}: {exc}”
                node.status = NodeStatus.FAILED

    while not dag.is_done():
        ready = dag.ready_nodes()

        if not ready:
            break  # remaining nodes depend on FAILED ancestors

        await asyncio.gather(*(run_node(n) for n in ready))
Здесь основную работу делают два небольших архитектурных решения.
Во-первых, asyncio.to_thread выносит наши синхронные функции-инструменты в пул потоков. Поэтому не приходится переписывать каждый инструмент как async def или привязывать весь harness к SDK с нативным async API.
Во-вторых, asyncio.Semaphore ограничивает конкурентность. Без семафора большой набор готовых узлов мог бы запустить десятки конкурентных LLM-вызовов, быстро упереться в rate limit и вызвать резкий скачок расходов.
Мы намеренно не строим полноценный динамический scheduler с work stealing, очередями приоритетов и другими сложными механизмами. Для агентных задач вроде нашей, где каждый узел — API-вызов длительностью от сотен миллисекунд до нескольких секунд, синхронного по уровням выполнения достаточно, чтобы получить большую часть выигрыша.
При последовательном выполнении wall-clock time примерно равно сумме задержек операций. При конкурентном выполнении оно определяется критическим путём DAG и ограничением MAX_CONCURRENT; без ограничения конкурентности для одного независимого слоя время приближается к задержке самого медленного узла плюс времени финальной агрегации.
Запоминать только нужное
Наивные агенты складывают в промпт всё подряд: полную историю диалога, результаты каждого вызова инструмента, данные всех предыдущих задач.
Такой подход ломается сразу по двум причинам. Во-первых, мы платим за токены, которые модели, скорее всего, вообще не понадобятся. Во-вторых, качество модели заметно снижается, когда цель задачи тонет среди нерелевантного текста.
Поэтому продакшен-агенты используют многоуровневую память, отчасти вдохновлённую когнитивной наукой [6].
-
Рабочая память (working memory) — это постоянно находящийся в контексте «черновик»: текущая цель, краткое описание плана и несколько последних результатов.
-
Эпизодическая память (episodic memory) хранит результаты предыдущих запусков и извлекается, когда прошлая задача похожа на текущую.
-
Семантическая память (semantic memory) содержит фоновые факты, которые извлекаются тем же способом, но не привязаны к конкретному запуску агента.
Но главное правило — никогда не помещать в контекст всё сразу. Вместо этого мы извлекаем top-k воспоминаний, наиболее похожих на текущую цель, и собираем контекст в рамках жёсткого бюджета по символам:
def build_context(working: WorkingMemory, store: MemoryStore,
                  budget_chars: int = 4000) -> str:
    """Assemble working memory + retrieved memories, respecting a char budget."""

    pieces = [working.to_prompt()]
    used = len(pieces[0])

    # Episodic first (past similar tasks), then semantic (facts)
    for kind in (”episodic”, “semantic”):
        for m in store.retrieve(working.goal, k=3, kind=kind):
            snippet = f”[{kind}] {m.content}”

            if used + len(snippet) + 1 > budget_chars:
                return “n”.join(pieces) + “n(...truncated at budget...)”

            pieces.append(snippet)
            used += len(snippet) + 1

    return "n".join(pieces)
Эпизодические воспоминания получают приоритет перед семантическими: опыт [7] и ошибки из похожих прошлых задач обычно полезнее общих фактов.
Если бюджет заканчивается, усечение происходит явно, а не незаметно. Иными словами: контекст нужно активно собирать, а не пассивно накапливать.
Для вычисления сходства MemoryStore поддерживает два бэкенда:
-
Первый — коэффициент Жаккара (Jaccard similarity). Он практически бесплатен и хорошо подходит для учебного примера, но плохо работает с перефразированием. Например, фразы «известные достопримечательности Франции» и «Париж известен Эйфелевой башней» почти не имеют общих слов, хотя семантически тесно связаны.
-
Второй вариант — полноценные эмбеддинги предложений (sentence эмбеддинги): модель all-MiniLM-L6-v2 преобразует текст в 384-мерные векторы, поэтому перефразированные фрагменты оказываются близко друг к другу в векторном пространстве.
MemoryStore сначала пытается использовать эмбеддинги, а если модель недоступна — откатывается к Jaccard.
Чтобы количественно оценить эффект этой замены, нужен полноценный бенчмарк — к этому мы вернёмся в отдельной статье.
Доверяй, но проверяй
Агенты умеют выдавать связные, уверенные и при этом неправильные ответы.
Без отдельной проверки отчёт может, например, незаметно потерять один из городов и отправиться пользователю как ни в чём не бывало. А регрессия останется незамеченной, пока результат случайно не прочитает человек.
Но разные проверки имеют разную стоимость. Поэтому выстроим их в иерархию: сначала практически бесплатные детерминированные структурные проверки; только затем — LLM-судья для субъективной оценки качества, которая уже требует токенов и денег.
Правило простое: сначала всегда выполняем дешёвую проверку и обращаемся к дорогой только для тех результатов, которые прошли первый уровень.
def verify_report(report, goal, required_cities, provider) -> Verdict:
    det = deterministic_check_report(report, required_cities)

    if not det.passed:
        return det                # Cheap tier caught it — don’t bother the LLM

    # Deterministic passed → escalate to LLM judge for subjective quality
    return llm_judge_report(report, goal, provider)
Если передать сюда заведомо неполный отчёт — например, только по Парижу, хотя были запрошены три города, — он будет отклонён уже на детерминированном уровне:reason = "Missing cities: ['Tokyo', 'New York']".
На оценивание не потрачено ни одного токена, а строка причины достаточно конкретна, чтобы шаг перепланирования — или человек — сразу понял, что пошло не так.
Такая двухступенчатая схема лежит в основе многих продакшен-пайплайнов оценки: сначала дешёвые фильтры, затем дорогая проверка только тех результатов, которые их прошли.
Не менее важно разделение ответственности: Worker создаёт результат, Critic его оценивает. Генератор не должен проверять собственную домашнюю работу.
Знакомьтесь: Planner, Worker и Critic
Один промпт, который одновременно планирует, выполняет действия, суммаризирует результаты и критикует собственный ответ, склонен путать цели: ограничения планирования просачиваются в стиль итогового текста, а «планирующую часть» становится трудно изолировать, что усложняет и тестирование, и замену.
Поэтому разделим работу между несколькими узкоспециализированными агентами. У каждого будет короткий системный промпт и один чётко определённый контракт.
-
Planner получает цель и схемы доступных инструментов и возвращает DAG в JSON, который мы валидируем перед выполнением.
-
Worker получает готовый DAG и просто исполняет его.
-
Critic получает исходную цель и готовый отчёт и выносит вердикт.
Каталог реально доступных инструментов подставляется прямо в системный промпт Planner, поэтому он может ссылаться только на действительно существующие инструменты:
PLANNER_SYSTEM = """You are a Planner agent. Given a GOAL, produce a dependency graph
of tool calls that will satisfy it.

Output ONLY JSON in this shape (no prose, no markdown):

{”nodes”: [{”id”: “...”, “tool”: “...”, “args”: {...}, “deps”: [...]}, ...]}

Nodes may run in parallel if their `deps` are empty or already satisfied.
The final aggregate_report node must depend on all upstream fetch/summary nodes.
Prefer id “aggregate” for that capstone node (any unique id is acceptable).
Available tools (name and schema):

<<TOOLS_JSON>>
"""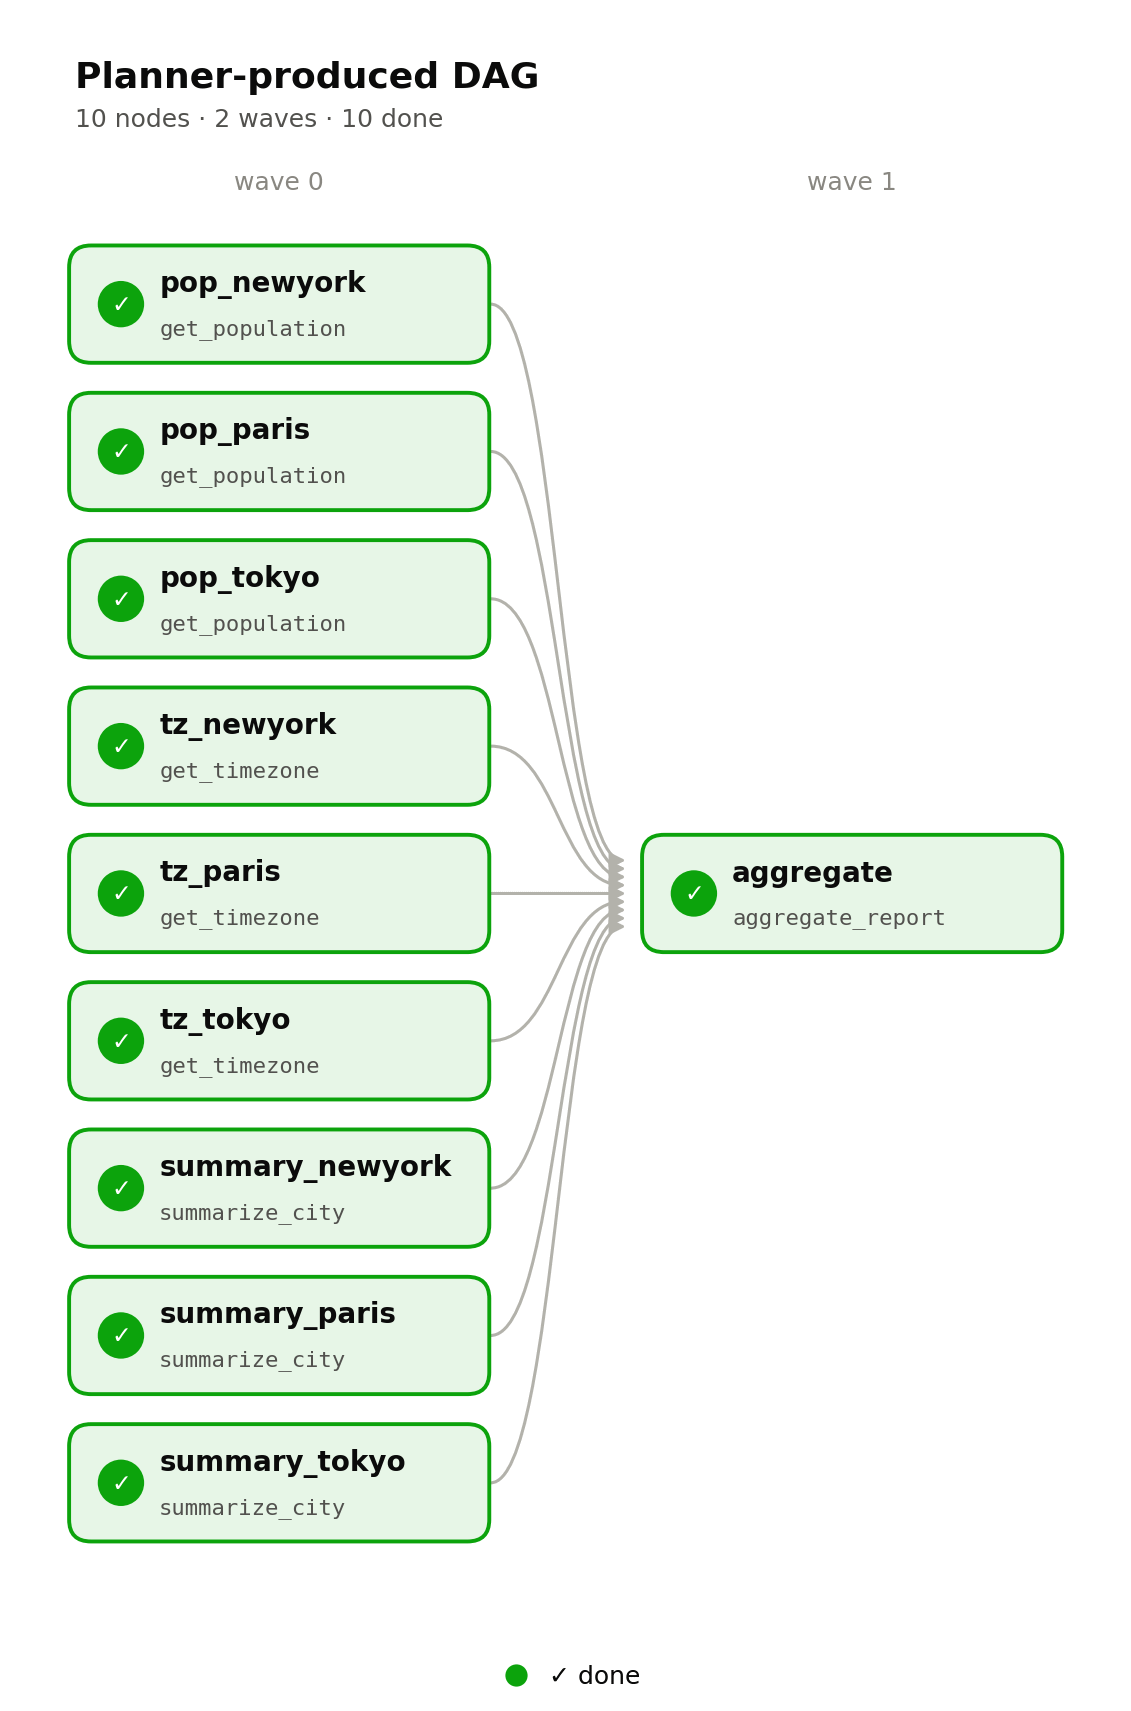
Если подключить к Planner реальную модель, планы обычно оказываются структурно корректными, но могут различаться по стилю и деталям. Если оркестратору позже понадобится найти конкретный узел — например, финальный aggregate_report, — дешевле заранее попросить модель использовать предсказуемый ID, чем писать код, разбирающий все возможные варианты её ответа.
Такое разделение похоже на то, как устроены продакшен-системы: планировщики в стиле AutoGPT, Worker-агенты вроде SWE-agent и оценивание через LLM-as-a-judge. При этом наша реализация остаётся достаточно компактной, чтобы её можно было прочитать целиком.
Поскольку все три роли работают через единый интерфейс LLMProvider.complete(…, role=…), заменить модель Planner или подменить Critic мок-реализацией можно одной строкой.
Топливные датчики и режимы отказа
В базовом harness было единственное ограничение — счётчик max_steps. Но число шагов плохо отражает реальные ограничения агента.
Шаги ещё могут оставаться, когда токены уже закончились. Можно укладываться в бюджет токенов, но исчерпать лимит вызовов инструментов. А зависший сетевой запрос способен съесть весь лимит реального времени (wall-clock time), вообще не увеличив счётчик шагов.
Поэтому BudgetMulti одновременно отслеживает четыре ресурса:
-
токены;
-
вызовы инструментов;
-
реальное время выполнения;
-
оценочную стоимость в долларах.
Запуск останавливается, как только исчерпан хотя бы один из этих ресурсов.
Но самый полезный показатель здесь — одно число. pressure показывает, насколько близок агент к исчерпанию самого напряжённого из своих бюджетов. Для каждого ресурса мы считаем долю уже использованного лимита, а затем берём максимальную:
def pressure(self) -> float:

    return max(
        self.tokens_used / self.max_tokens,
        self.tool_calls_used / self.max_tool_calls,
        self.elapsed() / self.max_wall_seconds,
        self.cost_usd / self.max_cost_usd,
    )
Это одно число управляет плавной деградацией: при pressure < 0.7 выполняется полный пайплайн, включая LLM-судью; при pressure > 0.9 оркестратор пропускает дорогого Critic и использует только детерминированные проверки; при 1.0 выполнение останавливается с частичными результатами.
Продакшен-агенты могут использовать похожий сигнал, чтобы переключаться на более дешёвые модели, сокращать глубину извлечения или запрашивать подтверждение пользователя.
Одних бюджетов, однако, недостаточно. Вторая составляющая операционной устойчивости — понимание того, что не каждая ошибка требует одинаковой реакции [8]:
-
Rate limit или timeout — временная ошибка: здесь уместен повтор с экспоненциальной задержкой (exponential backoff) и случайным разбросом (jitter), чтобы множество агентов не повторяло запросы синхронно.
-
Ошибка валидации — это неправильное использование инструмента: мы возвращаем LLM структурированную ошибку, чтобы она могла самостоятельно исправить аргументы.
-
Неизвестная сущность — это отсутствующая информация, поэтому повторять [9] тот же запрос не просто бесполезно, а вредно: если модель выдумала название города, каждая повторная попытка завершится той же ошибкой. Правильное действие — перепланировать задачу без этой сущности.
-
Нарушение политики — фатальная ошибка, при которой выполнение следует немедленно остановить.
Небольшая функция classify_error() сопоставляет строки ошибок с этими четырьмя классами, а политика восстановления определяется классом ошибки, а не слепыми повторными попытками.
Бортовой самописец
Когда агент терпит неудачу, нужен append-only-журнал структурированных событий, позволяющий ответить на вопросы: что и в каком порядке произошло, сколько времени занял каждый шаг, какая роль расходовала токены и рос ли budget pressure до того, как что-то пошло не так.
Каждое событие в Tracer содержит идентификацию — step ID и parent ID, связывающий шаг Worker с породившим его планом; семантику — роль и выполненное действие; метрики исполнения и стоимости — latency, токены, стоимость и снимок budget pressure на момент записи; а для событий Critic — ещё и вердикт.
Схема намеренно плоская и скучная: список сериализуемых в JSON словарей, который можно сохранить в файл, отправить в OpenTelemetry или LangSmith либо напрямую построить по нему графики в matplotlib.
Для настоящей наблюдаемости (observability) не нужен проприетарный формат — достаточно подходящей схемы.
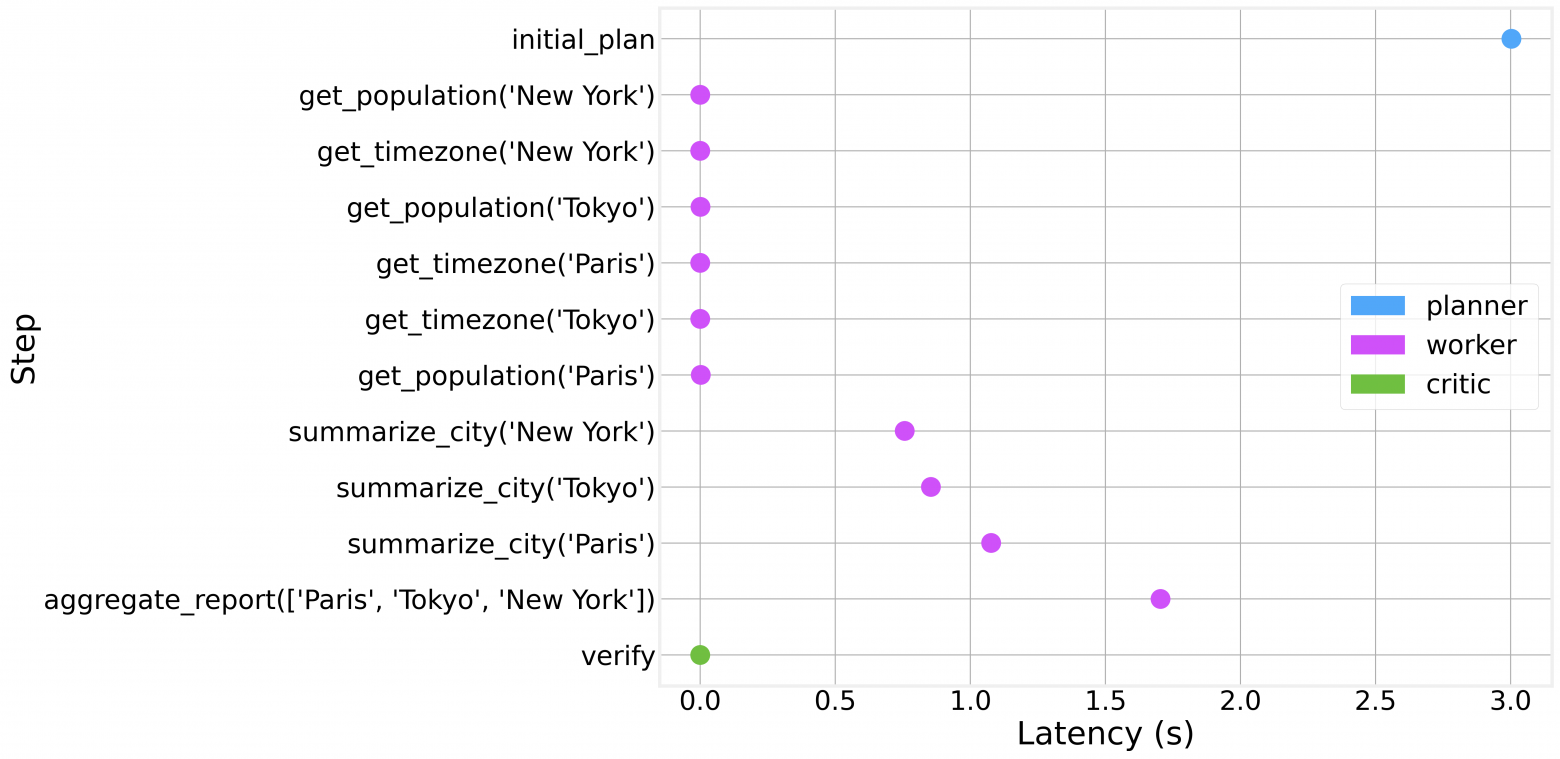
Задержка (latency) по шагам и ролям сразу показывает, что узлы summarize_city() и aggregate_report() определяют основную часть wall-clock time, тогда как lookup-операции почти незаметны.
Основное время уходит на вызовы LLM — именно поэтому их конкурентное выполнение так важно.
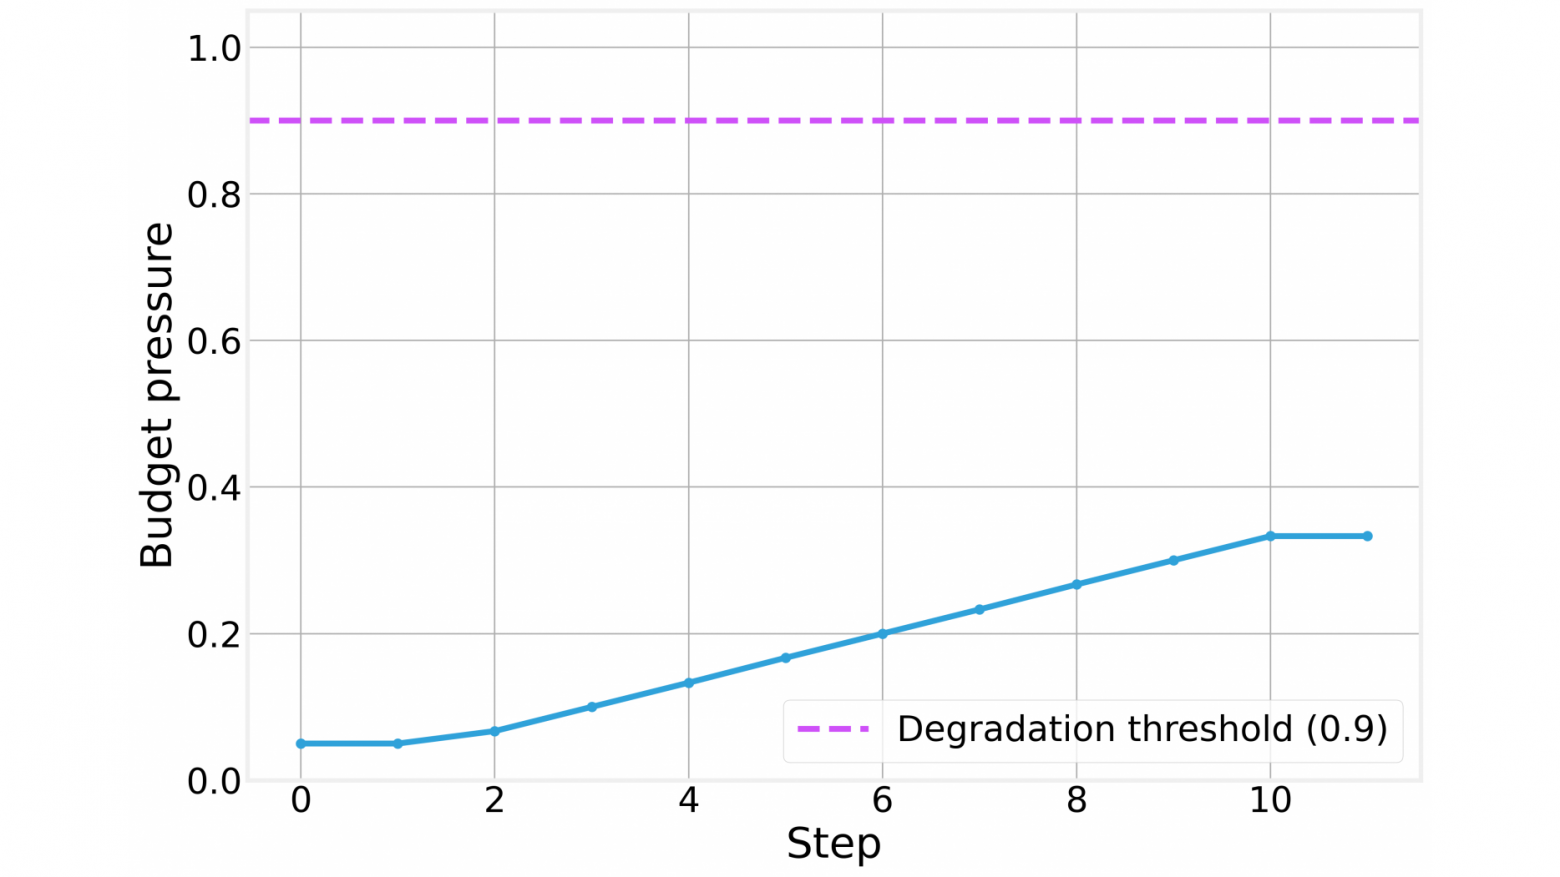
Budget pressure со временем монотонно растёт и резко увеличивается на этапе агрегатора. Если до запуска Critic он пересекает порог деградации 0.9, сам трейс объясняет, почему LLM-судья был пропущен.
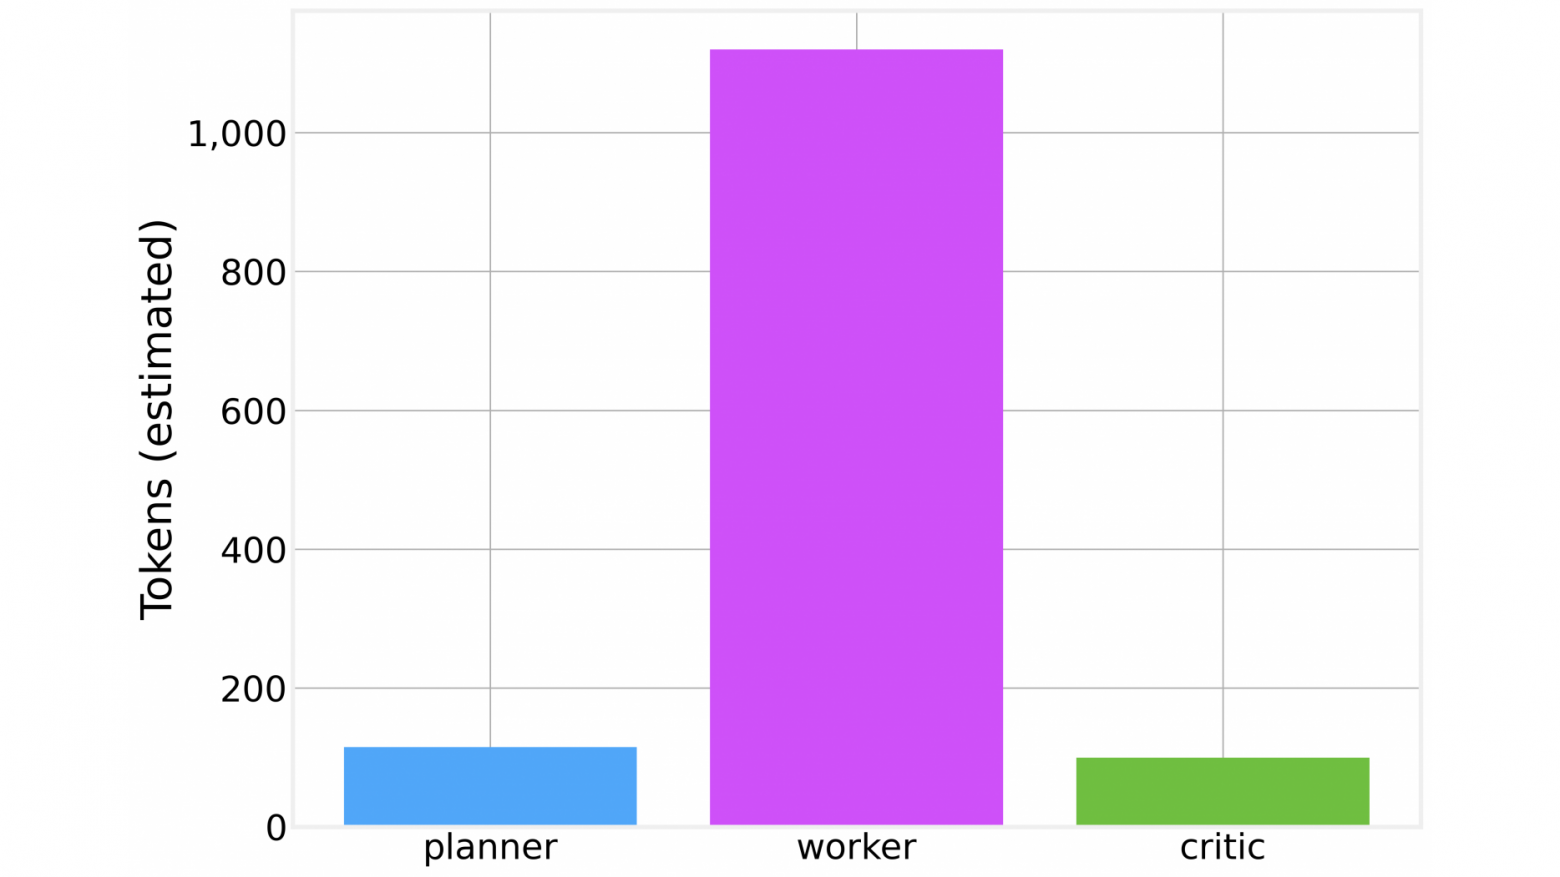
Наконец, распределение токенов по ролям показывает, на что уходит бюджет — на планирование или выполнение. В этой задаче основная доля приходится на Worker из-за множества вызовов summarize_city().
Собираем всё вместе
Когда все примитивы готовы, Orchestrator становится почти скучным. Он собирает контекст из памяти, просит Planner построить DAG, передаёт DAG Worker вместе с callback-функцией, которая при каждом вызове инструмента записывает событие в трейс и списывает бюджет, проверяет ошибки, верифицирует результат с деградацией в зависимости от pressure, сохраняет исход в эпизодическую память для будущих запусков и возвращает RunResult, объединяющий отчёт, вердикт, DAG, трейс и состояние бюджета.
Единственное новое поведение [10], которое он добавляет, — цикл перепланирования. Если выполнение завершается ошибкой класса missing information, Orchestrator отправляет контекст ошибки обратно Planner вместо слепого повтора. Число таких попыток ограничено параметром max_replans.
Суть метода умещается в нескольких строках:
for attempt in range(self._max_replans + 1):
    dag = self.planner.plan(goal) if attempt == 0 else self.planner.replan(goal, dag)

    await self.worker.execute(dag, on_step=on_step)

    if dag.any_failed():
        failed = (n for n in dag.nodes.values() if n.status == NodeStatus.FAILED)

        if any(classify_error(n.error or “”) == ErrorClass.MISSING_INFO for n in failed)
                and attempt < self._max_replans and budget.has_room():
            continue          # informed re-plan, not a blind retry

        return RunResult(..., status=”failed_execute”)
    break                     # success

# Pressure-aware degradation: skip the LLM judge if budget is tight
if budget.pressure() > 0.9:
    verdict = deterministic_check_report(report, required_cities)
else:
    verdict = self.critic.judge(report, goal, required_cities)
Чего нам всё ещё не хватает
Мы начали с базового агентного цикла и постепенно обросли инфраструктурой: типизированными инструментами, DAG, памятью, верификацией, разделением ролей, многомерными бюджетами и трассировкой.
Важно, что эти компоненты не образуют монолит. Их можно менять независимо друг от друга: добавить новый инструмент — и Planner получит его схему; ужесточить verify_report() — и следующие запуски будут проверяться по новым правилам; заменить LLM-бэкенд — и остальная архитектура останется прежней. Именно эта компонуемость и позволяет удерживать Orchestrator тонким, а весь harness — расширяемым.
При этом до полноценной продакшен-системы здесь ещё далеко. Память хранится внутри процесса, тогда как в реальных системах эмбеддинги обычно выносят во внешнее хранилище вроде Chroma, Weaviate или pgvector. Результаты инструментов у нас считаются доверенными, хотя в продакшене их нужно обрабатывать как недоверенные данные и отделять от инструкций, чтобы снижать риск prompt injection. Необратимые действия должны проходить через подтверждение человека, а фактический расход токенов лучше получать из метаданных SDK, а не оценивать по длине текста.
Но есть более важное ограничение.
Один успешный запуск показывает лишь то, что harness может работать. Он ничего не говорит о том, насколько стабильно система справляется с разными задачами, как часто ошибается, сколько стоит её работа и где именно она деградирует.
Чтобы ответить на эти вопросы, нужен уже не новый компонент самого агента, а отдельный eval harness. Но это уже тема другой статьи [11].
Автор: eds88
Источник [13]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/35973
URLs in this post:
[1] память: http://www.braintools.ru/article/4140
[2] поведение: http://www.braintools.ru/article/9372
[3] логику: http://www.braintools.ru/article/7640
[4] ошибки: http://www.braintools.ru/article/4192
[5] внимание: http://www.braintools.ru/article/7595
[6] наукой: http://www.braintools.ru/article/7634
[7] опыт: http://www.braintools.ru/article/6952
[8] реакции: http://www.braintools.ru/article/1549
[9] повторять: http://www.braintools.ru/article/4012
[10] поведение: http://www.braintools.ru/article/5593
[11] другой статьи: https://data4sci.com/blog/evaluating-your-agentic-harnesses
[12] TG-канал Ostrovok! Tech: https://t.me/ostrovok_tech
[13] Источник: https://habr.com/ru/companies/ostrovok/articles/1084568/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1084568
Нажмите здесь для печати.