VK Data Platform под капотом: как устроена платформа для Data Lakehouse
Отечественный рынок решений Data Lakehouse активно развивается: после периода пилотных проектов наблюдается массовый переход к промышленным внедрениям. Растущий спрос на такие платформы обусловлен необходимостью обрабатывать разнородные данные в условиях строгих требований к информационной безопасности.
Но нюанс в том, что реализации Data Lakehouse от разных вендоров могут значительно отличаться как на уровне архитектуры, так и на уровне доступных возможностей. Поэтому при выборе решения надо понимать, как оно устроено «под капотом».
В статье расскажем, как именно реализована наша Data Lakehouse платформа для аналитики и ML — VK Data Platform [1] от VK Tech.
Немного общей информации о VK Data Platform
VK Data Platform [1] — универсальная платформа для комплексной работы с большими объемами данных, нейросетями и искусственным интеллектом [2]. С ее помощью можно:
-
ускорять обработку, управление, обогащение и анализ данных;
-
быстро внедрять алгоритмы искусственного интеллекта и нейросети в бизнес.
Платформа построена на базе Data Lakehouse-архитектуры, которая объединяет преимущества DWH и Data Lake архитектур для экономного хранения данных и масштабирования платформы, а также унификации аналитического стека для сбора, хранения, обработки и управления данными.
Архитектура VK Data Platform
Архитектура VK Data Platform разделена на функциональные блоки:
-
Источники данных. СУБД, CRM/ERP, потоковые данные, полуструктурированные файлы, медиа, которые подключаются и передаются в платформу через интеграционные механизмы.
-
Платформенные сервисы. Отвечают за хранение, вычисления, оркестрацию, сбор данных.
-
Безопасность. Интегрирована на всех этапах — от контроля доступа до шифрования и защиты данных.
-
Интерфейс управления. Централизованное администрирование обеспечивается с помощью UI/API, Helm/Operators, механизмов восстановления, журналов.
-
Прикладные и CedrusData‑сервисы. ML‑инструменты, Data Catalog, BI, CedrusData Engine/Catalog, которые предоставляют конечные возможности для пользователей.
-
Потребители. Аналитики, бизнес, Data Science & ML, Data‑инженеры, приложения, которые взаимодействуют с платформой через соответствующие инструменты и API.
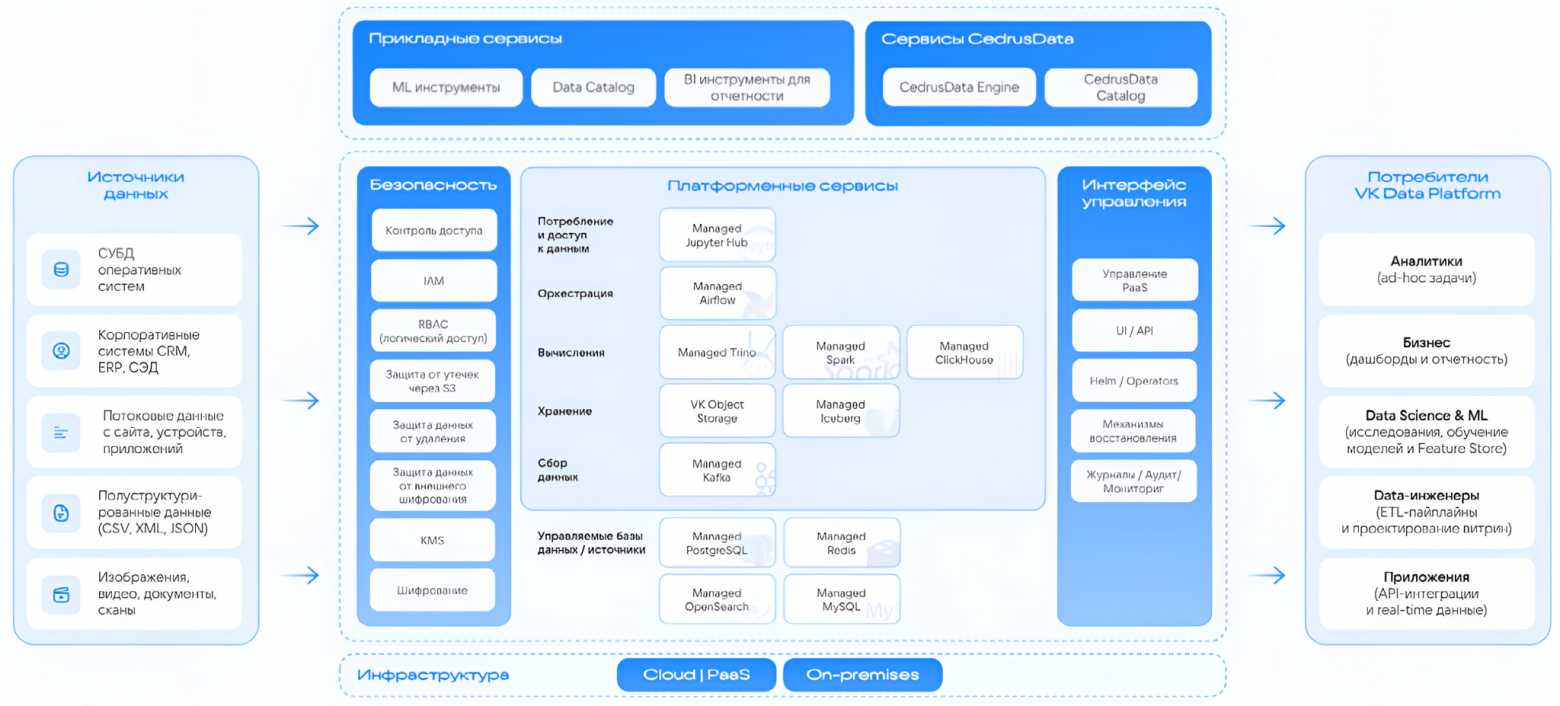
Такая структура позволяет гибко масштабировать решение под задачи компании, сохраняя единый слой данных, управляемость и безопасность на всех этапах жизненного цикла аналитики и ML‑проектов.
Теперь подробнее остановимся на отдельных составляющих архитектуры «под капотом».
Потоковая загрузка и управление метаданными
Для приема потоковых данных и событий в реальном времени используется Managed Kafka — она служит транспортным слоем, буферизуя потоки от приложений, сайтов, IoT‑устройств и других источников перед дальнейшей обработкой. Этот поток можно обработать с помощью специализированного приложения, а можно построить near real time витрину с помощью Managed Clickhouse, также входящего в состав VK Data Platform.
Управление метаданными для Data Lakehouse реализовано через CedrusData Catalog. Он координирует доступ разных движков к Iceberg‑таблицам, обеспечивая согласованное состояние данных и упрощая эксплуатацию при высокой нагрузке.
Хранение данных
Ядром дата-платформы является объектное хранилище VK Object Storage. Его отличает:
-
высокая масштабируемость (1000+ петабайт) и доступность;
-
высокая производительность (60 000+ запросов в секунду, <20 мс среднее время отклика);
-
высокая пропускная способность (450+ Гб/с).
Для эффективного хранения данных используется колоночный формат Apache Parquet: он снижает объем хранимых данных (вплоть до 10‑кратного сжатия по сравнению с CSV/JSON) и ускоряет аналитические запросы за счет чтения только необходимых колонок.
В качестве табличного слоя применяется Apache Iceberg — он превращает файлы в S3 в управляемые таблицы с поддержкой ACID‑транзакций, Time Travel (отката к предыдущим версиям), Schema Evolution (изменения схемы без перезаписи данных) и Data Pruning (исключения лишних файлов при чтении). Такой подход позволяет разным вычислительным движкам работать с единым слоем данных без их дублирования.
Вычислительные движки
VK Data Platform предоставляет набор движков под разные типы нагрузок — выбор определяется профилем задач и требованиями к скорости отклика.
-
Managed ClickHouse. Применяют для интерактивных дашбордов и «горячих» витрин с субсекундным откликом (на локальных дисках) либо для ad‑hoc‑анализа и сверок через прямой доступ к Iceberg/S3. Оптимален для агрегатов и повторяемых запросов. JOIN‑операции поддерживаются, но требуют оптимизации.
-
Managed Trino. Используют для SQL‑аналитики, сложных запросов с множественными JOIN, федеративного доступа к источникам и SQL‑based ETL/ELT.
-
Managed Spark. Закрывает тяжелые сценарии: ресурсоемкие ETL/ELT‑пайплайны, подготовку и обогащение данных, обслуживание Iceberg‑таблиц, batch/streaming‑обработку и ML‑задачи.
-
CedrusData Engine. Обеспечивает высокопроизводительную SQL‑аналитику: за счет оптимизированных коннекторов и внутренних улучшений дает прирост скорости в 2–5 раз относительно базового Trino, подходит для сложных запросов, федеративного доступа и BI‑сценариев.
Примечание: Помимо этого по модели XaaS можно подключить и другие вычислительные движки.
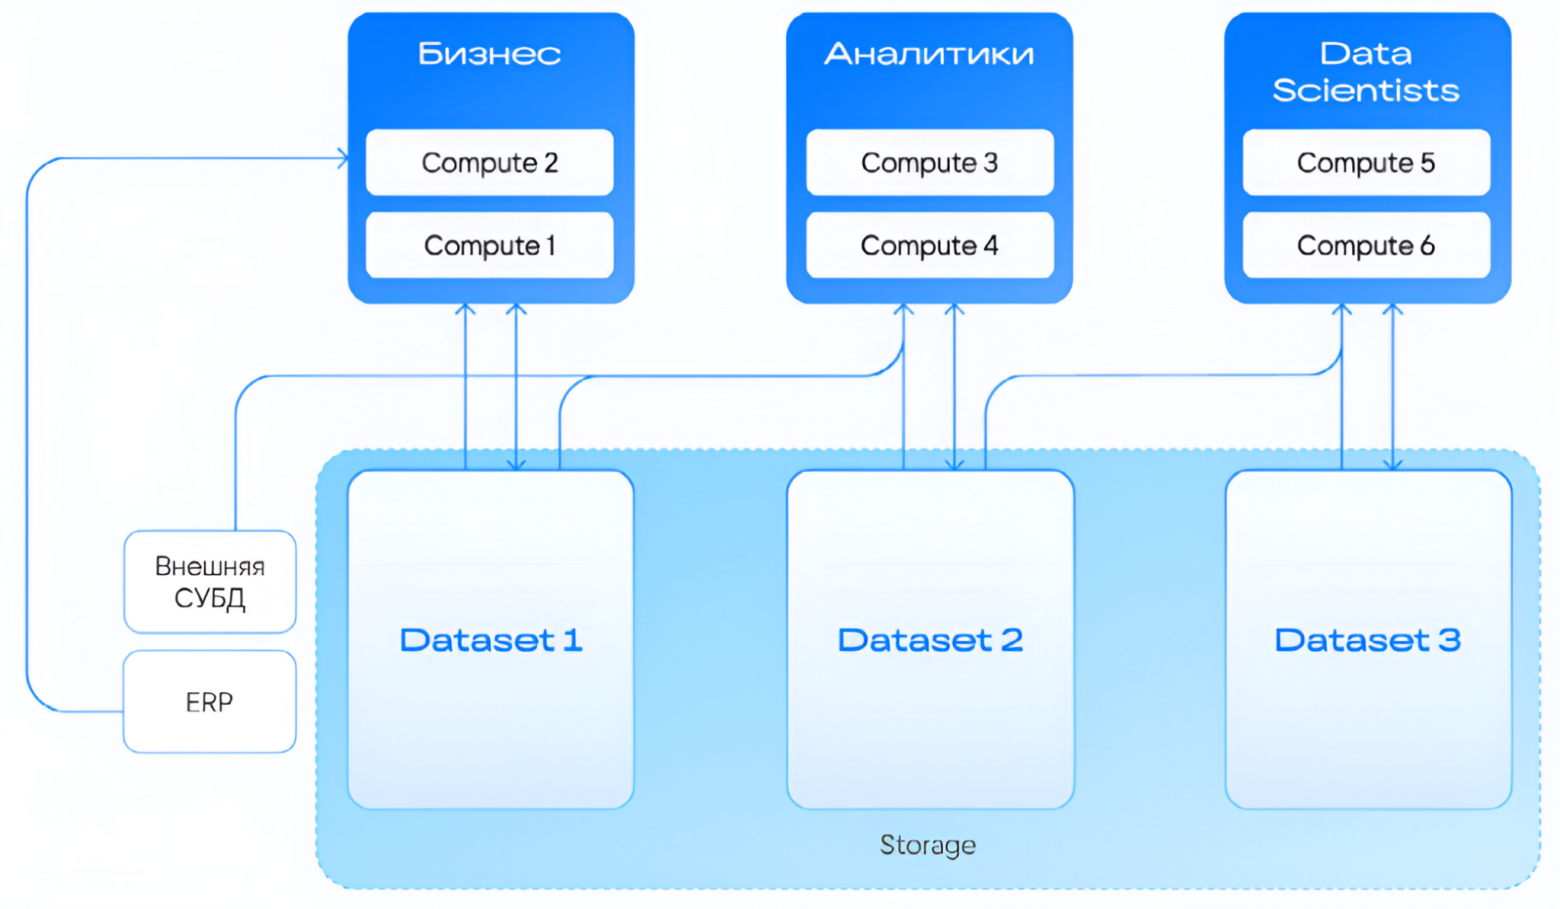
Все движки обращаются к единому слою данных в Iceberg поверх S3 — это исключает дублирование и поддерживает единый источник истины. При этом архитектура допускает создание «горячего» слоя: для сценариев с жесткими требованиями к скорости данные материализуют в нативные таблицы ClickHouse на локальных дисках.
Вычислительные ресурсы можно выделять под конкретный движок, задачу, аналитика или команду в рамках изолированных пулов. Например, отдельный пул под BI-отчетность, отдельный пул под ad-hoc аналитику, отдельный пул под Spark ETL/ML. Такие нагрузки не конкурируют за один общий кластер: тяжелый расчет Spark не замедляет операции создания BI-дашбордов, а ad-hoc-запрос аналитика не блокирует задачи другой команды.
Оркестрация пайплайнов
Для оркестрации загрузок, пересчетов и регулярных операций обработки данных (data-пайплайнов) в VK Data Platform используется Managed Airflow. Сервис управляет порядком выполнения задач: когда запустить загрузку, какой шаг выполнить первым, что делать при ошибке [3], сколько раз повторить задачу, кого уведомить и какой следующий процесс запускать после успешного завершения.
Среда разработки
Для работы аналитиков, инженеров данных и ML-команд используется Managed JupyterHub, который предоставляет пользователям рабочие ноутбуки, где можно писать Python/SQL-код, исследовать данные, строить графики, проверять гипотезы, готовить признаки и прототипировать ML-модели.
Единый контур управления
В целостную систему весь набор отдельных компонентов превращает Data Platformer. Это единый компонент управления VK Data Platform, обеспечивающий унифицированное администрирование как в облачной, так и в on-premise-среде.
Так, через Data Platformer настраиваются и контролируются все аспекты работы платформы:
-
жизненный цикл сервисов (развёртывание, настройка, масштабирование, удаление);
-
ресурсы (CPU, RAM, хранилище, квоты);
-
безопасность (ролевая модель доступа, управление сертификатами и секретами);
-
эксплуатация (мониторинг, аудит, резервное копирование);
-
отказоустойчивость (автоматическое восстановление, размещение сервисов).
Lakehouse-платформа для аналитики и ML
Объединяйте данные из разных систем и снижайте расходы на хранение в 7–10 раз
О реализованных мерах безопасности
В VK Data Platform выстроена и применяется многоуровневая модель безопасности, которая базируется на трех составляющих:
-
IAM. Управление пользователями, группами и доступом к платформе, сервисам и административным операциям.
-
RBAC на уровне Data Plane. Права внутри аналитических сервисов: Managed Trino, Managed ClickHouse, REST Iceberg Catalog и других компонентов.
-
Защита на уровне S3‑хранилища. Bucket policy, сервисные аккаунты, шифрование, Object Lock, версионирование и контроль операций с объектами.
Такой подход разделяет административный доступ к платформе, логический доступ к данным в сервисах и физическую защиту объектов в хранилище. Это повышает управляемость, снижает риск несанкционированного доступа и упрощает расследование инцидентов безопасности.
Принципы масштабирования платформы
Компоненты VK Data Platform адаптированы для работы в Kubernetes. Это позволяет гибко управлять вычислительными ресурсами: выделять дополнительные мощности под пиковые нагрузки и снижать их после завершения расчетов.
Это особенно важно для сценариев, где нагрузка меняется в течение суток: ночные ETL/ELT-пайплайны, дневная BI-отчетность, ad-hoc аналитика, ML-эксперименты.
В облачном формате поставки по модели PAYG этот эффект особенно заметен: вычислительные ресурсы можно включать, увеличивать, уменьшать или отключать по потребности [5].
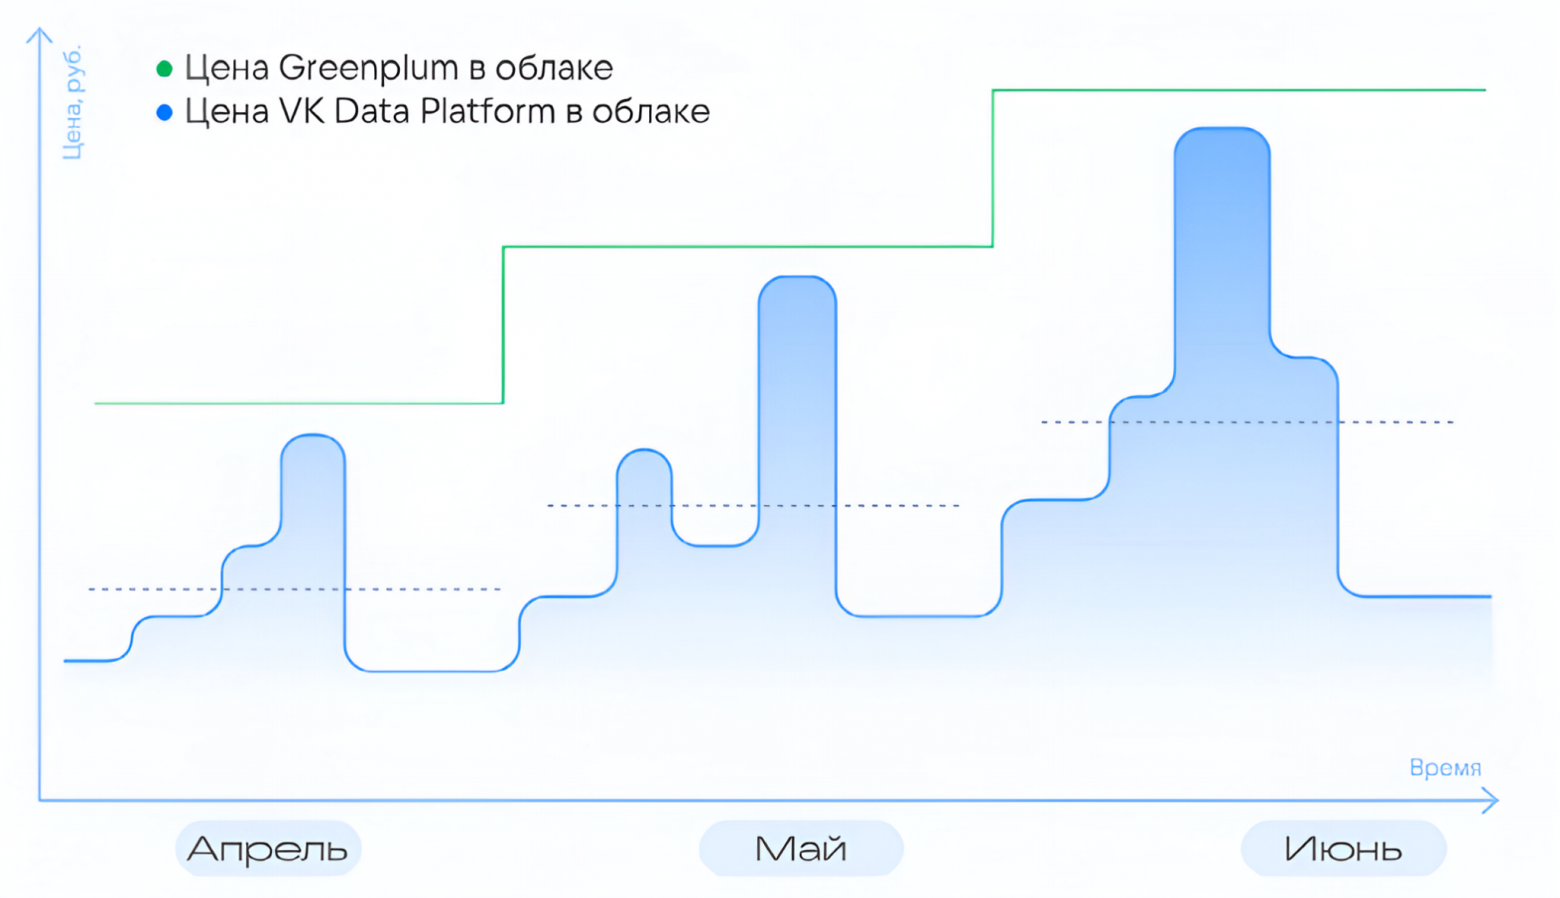
Примечание: Наиболее гибко масштабируются stateless-сервисы и «вычислители», такие как Managed Spark и Managed Trino. Stateful-компоненты, например, Managed ClickHouse с локальным хранением, Managed Kafka и Managed PostgreSQL, масштабируются осторожнее: для них учитываются репликация, размещение данных, диски, балансировка и требования к отказоустойчивости.
Меры обеспечения доступности и отказоустойчивости
Отказоустойчивость и доступность VK Data Platform обеспечивается распределенной архитектурой, резервированием сервисов и работой компонентов в среде Kubernetes. Причем реализованные меры покрывают практически все сценарии. Так:
-
При отказе сервера сервисы автоматически перезапускаются или переносятся Kubernetes на доступные серверы. Сайзинг платформы рассчитывается с учетом отказа минимум одного сервера, чтобы сохранить работоспособность ключевых сервисов и снизить влияние отказа на пользователей.
-
Сервисы управления VK Data Platform развертываются минимум в двух экземплярах и распределяются минимум по трем серверам. При отказе одного экземпляра нагрузка автоматически перераспределяется на доступный, а отказавший экземпляр автоматически восстанавливается средствами Kubernetes.
-
Минимальная конфигурация включает три управляющих узла Kubernetes (control plane). При отказе одного управляющего узла кластер продолжает работать за счет оставшихся узлов control plane, а отказавший узел восстанавливается штатными механизмами платформы и инфраструктуры.
-
Сохранность данных в случае недоступности объектного S3‑хранилища VK Object Storage обеспечивается отказоустойчивой архитектурой, настраиваемым фактором репликации, erasure coding и отказоустойчивым хранением метаданных на базе Tarantool. Отказ отдельного сервера или компонента S3 не приводит к потере данных.
-
При отказе компонентов VK Data Platform, ответственных за работу с данными, используется комбинация Kubernetes-восстановления и нативных HA-механизмов сервисов. Stateless компоненты, такие как Managed Trino, Managed Spark, Managed Airflow, Managed Lakekeeper перезапускаются или переносятся Kubernetes на доступные узлы. Stateful-компоненты, такие как Managed Kafka, Managed ClickHouse и Managed PostgreSQL, опираются на репликацию.
-
Для Managed PostgreSQL, Managed ClickHouse и VK Object Storage настраивается резервное копирование и восстановление, политики хранения, восстановление таблиц/кластеров ClickHouse, версионирование, репликация и Object Lock для защиты объектов в S3.
Преимущества Data Lakehouse на основе VK Data Platform
По сравнению с DWH и Data Lake, архитектура Data Lakehouse на основе VK Data Platform предоставляет вполне очевидные преимущества, среди которых:
-
Дешевое хранение. Данные хранятся в S3‑совместимом объектном хранилище, что дешевле для больших объемов исторических и «холодных» данных, чем хранение всего массива в DWH на дорогих SSD/NVMe. Разница в стоимости закупки между HDD для S3 и SSD/NVME в 5–13 раз.
-
Дешевое и простое масштабирование. Система хранения данных и вычислители масштабируются отдельно: если растет только объем данных, не нужно пропорционально докупать вычислительные ресурсы.
-
Единый стек под BI/ML/AI. Архитектура Data Lakehouse дает единый контур данных для отчетности, ad hoc-аналитики, ML и AI-сценариев. Командам не нужно держать отдельные хранилища и копии данных под BI, Data Science и новые AI-сценарии.
-
Выделение отдельных движков. Под разные задачи можно выделять отдельные вычислители или пулы: для BI, тяжелых расчетов, Data Science, команд и доменов. Это снижает взаимное влияние нагрузок и упрощает реализацию Data Mesh-подхода к организации доменного подхода к построению корпоративных систем управления данными.
-
Повышение производительности работы бизнес-аналитиков. Аналитика ускоряется за счет меньшего числа копий данных, сокращения ETL/ELT переходов, выбора подходящего движка под задачу и работы с метаданными. В результате путь от бизнес-вопроса до отчета, витрины или ML-датасета становится короче.
-
Собственный движок для ad hoc-аналитики — CedrusData Engine. Решение является форком Trino. На данный момент ключевые элементы ядра движка переписаны на Rust для ускорения вычислений и разделения CPU и I/O нагрузок. CedrusData Engine включает эффективные и высокопроизводительные коннекторы к Greenplum, Vertica, Clickhouse. В продукте реализованы внутренние оптимизации, которые в продовых нагрузках дают прирост в производительности в 2–5 раз в сравнении с ванильным Trino.
Сценарии использования VK Data Platform
Реализация, архитектура и возможность кастомизации позволяют применять VK Data Platform в разных сценариях. Разберем некоторые из таких.
Построение дата-офиса с нуля
VK Data Platform может быть задействована в качестве базового контура данных в компаниях, где отчетность и аналитика сейчас собраны на Excel, 1С, ERP, CRM, локальных БД и ручных выгрузках. При этом платформа способна закрыть основные этапы пайплайна работы с данными: от сбора данных из источников и хранения до обработки и передачи потребителям.
Причем на старте достаточно простого стека: S3‑хранилища, табличного слоя Iceberg и Managed Trino для аналитики, BI и простых преобразований.
Реализация такого подхода позволяет перейти от ручной сборки отчетов к управляемому производству данных: показатели считаются по единым правилам, отчеты обновляются предсказуемо, а руководство меньше тратит время на сверку цифр.
Аналитическая песочница
VK Data Platform может использоваться как аналитическая песочница для проверки гипотез, ad hoc-запросов, прототипирования витрин и исследования данных без влияния на промышленный BI-контур. Аналитикам можно выделять отдельные пулы вычислителей, подключая Managed Trino, Managed Spark, Managed ClickHouse или Managed JupyterHub и давать доступ к нужным данным с контролем прав.
При этом песочница не превращается в хаос: данные остаются в общем управляемом слое, доступы контролируются, а удачные гипотезы можно перевести в прод.
Data Mesh
VK Data Platform подходит для реализации Data Mesh-подхода, когда разные домены или бизнес-команды работают со своими витринами и дата-продуктами, но используют общий слой хранения и единые правила доступа. Для команд можно выделять отдельные вычислительные пулы, чтобы BI, ad hoc, ETL и ML не мешали друг другу.
Подготовка данных для ML/AI
VK Data Platform можно задействовать в ИТ-контуре в качестве слоя накопления и подготовки данных для ML-моделей, RAG, AI-ассистентов и AI-агентов. Так, в платформу собираются данные (транзакции, события, документы, логи, телеметрия, обращения, регламенты и другие), после чего они очищаются, нормализуются, обогащаются метаданными и передаются в ML/AI-контуры.
Ускорение аналитики
Внедрение VK Data Platform может способствовать ускорению аналитики. И обусловлено это не только свойствами движков, но и архитектурой: меньше копий данных, меньше ручных ETL/ELT-переходов, единый слой данных и отдельные compute-пулы под разные типы нагрузки, Iceberg фичи. То есть новые отчеты, витрины и ML-датасеты запускаются быстрее, потому что данные уже собраны и подготовлены в одном контуре.
Подведем итоги
Безусловно, VK Data Platform [1] — не серебряная пуля: результат внедрения зависит от качества данных, зрелости процессов и компетенций команды. Но Lakehouse-архитектура позволяет сократить количество разрозненных хранилищ, копий данных и отдельных ETL-процессов. Одни и те же данные можно использовать для отчётности, аналитики и ML-сценариев в рамках общего контура.
Для AI-проектов это особенно важно.
Выбор модели — только часть задачи: гораздо больше времени обычно занимают сбор, очистка и регулярное обновление данных. Feature Store помогает использовать единую логику [6] расчёта признаков при обучении [7] и инференсе, а Model Registry — управлять версиями моделей и их метриками. В RAG-сценариях общий контур упрощает подключение корпоративных источников, обновление индексов и разграничение доступа к документам.
При этом платформа не решает организационные проблемы автоматически. Она не исправит некачественные данные, не спроектирует признаки и не заменит проверку модели перед релизом. Data governance, безопасность и правила эксплуатации моделей по-прежнему остаются ответственностью команды.
Поэтому внедрение разумнее начинать с одного измеримого сценария: например, ускорить подготовку отчётности, сократить время формирования обучающей выборки или вывести ML-модель в продакшен. VK Data Platform поддерживает on-premise, managed- и гибридные варианты поставки, поэтому инфраструктуру можно развивать постепенно. Пилот на собственных данных покажет, где консолидация действительно даст эффект и стоит ли масштабировать решение.
Автор: qqrew
Источник [8]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/35976
URLs in this post:
[1] VK Data Platform: https://cloud.vk.ru/data-platform/?ysclid=mtcuwspezs703677336
[2] интеллектом: http://www.braintools.ru/article/7605
[3] ошибке: http://www.braintools.ru/article/4192
[4] Получить консультацию: https://cloud.vk.ru/data-platform/?utm_source=habr&utm_medium=referral&utm_campaign=vkcloud_article_1086190
[5] потребности: http://www.braintools.ru/article/9534
[6] логику: http://www.braintools.ru/article/7640
[7] обучении: http://www.braintools.ru/article/5125
[8] Источник: https://habr.com/ru/companies/vktech/articles/1086190/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1086190
Нажмите здесь для печати.