VM упадёт через 30 минут. Можно ли узнать об этом раньше мониторинга?
Предсказываем перегрузку VM за 30 минут: LSTM, численные методы и промышленный контур в Yandex Cloud
Обычный мониторинг хорошо отвечает на вопрос:
что происходит с инфраструктурой прямо сейчас?
Но в некоторых задачах важнее другой вопрос:
что произойдёт через полчаса и успеет ли система подготовиться к росту нагрузки до того, как пользователи заметят проблемы?
Возьмём интернет-магазин, API или внутреннюю корпоративную систему. Нагрузка постепенно растёт, но загрузка процессора ещё не достигла критического уровня, поэтому система мониторинга пока не подаёт сигнал. Через 20–30 минут процессор уже загружен на 80–90%, увеличивается время отклика, часть запросов начинает завершаться с ошибками, а автоматическое масштабирование только в этот момент начинает добавлять вычислительные ресурсы.
Классическая схема выглядит так:
загрузка процессора ≥ 80%
          ↓
срабатывает предупреждение
          ↓
проходит несколько минут
          ↓
добавляются вычислительные ресурсы
Идея статьи — добавить к этой схеме ещё один, упреждающий контур:
телеметрия за последний час
          ↓
прогноз на 30 минут вперёд
          ↓
ожидается avg_cpu ≥ 80%
          ↓
масштабирование начинается заранее
То есть речь не о замене обычного автоматического масштабирования, а о том, чтобы дать инфраструктуре запас времени на реакцию [1].
Эксперимент построен на публичной трассе нагрузки Microsoft Azure: сравниваем простые численные методы с Dense, LSTM, GRU и небольшим Transformer, отслеживаем эксперименты через MLflow и собираем промышленный контур в Yandex Cloud.
Главный вопрос здесь не «какая нейросеть моднее», а гораздо практичнее:
можно ли достаточно точно увидеть будущую перегрузку заранее и даст ли это реальную пользу при эксплуатации инфраструктуры?
И заодно это хороший повод напомнить: далеко не каждую реальную задачу нужно решать с помощью большой языковой модели или огромного Transformer. Иногда компактная модель для временных рядов, несколько численных методов и правильно построенный контур мониторинга дают более понятный, дешёвый и практически полезный результат.
Сначала результат — без сложной математики
На тесте было:
11 408 окон
2 450 будущих перегрузок
порог перегрузки: CPU ≥ 80%
горизонт прогноза: 30 минут
Что это за модели
|
Подход |
Что это такое |
|---|---|
|
GRU |
Рекуррентная нейросеть для последовательностей, которая учитывает предыдущие значения и при этом устроена проще LSTM. |
|
LSTM |
Рекуррентная нейросеть с памятью [2], рассчитанная на работу с зависимостями во временных рядах. |
|
Transformer |
Модель на механизме внимания [3], которая оценивает связи между точками последовательности без классической рекуррентной памяти. |
|
Скользящее среднее |
Простой численный метод: сглаживает последние значения и использует их как ориентир для прогноза. |
|
Наивный прогноз |
Предполагает, что через 30 минут загрузка будет примерно такой же, как сейчас. |
|
Dense |
Полносвязная нейросеть без специального механизма работы с временной последовательностью. |
То есть в эксперименте сравниваются не только нейросети, но и простые базовые методы. Это важно: сложная модель имеет смысл только в том случае, если она действительно обгоняет простые и дешёвые подходы.
Лучший результат показала GRU:
|
модель |
MAE |
RMSE |
precision@80 |
recall@80 |
параметры |
эпохи |
|---|---|---|---|---|---|---|
|
GRU |
7.61 |
9.80 |
0.793 |
0.830 |
23 745 |
21 |
|
LSTM |
7.97 |
10.34 |
0.774 |
0.829 |
30 913 |
24 |
|
Transformer |
9.26 |
12.05 |
0.727 |
0.800 |
35 841 |
25 |
|
скользящее среднее |
8.73 |
12.85 |
0.708 |
0.791 |
— |
— |
|
наивный |
9.16 |
14.37 |
0.520 |
0.620 |
— |
— |
|
Dense |
14.86 |
18.35 |
0.783 |
0.245 |
2 369 |
25 |
Что означают показатели
|
Показатель |
Что означает |
|---|---|
|
MAE |
Средняя абсолютная ошибка [4] прогноза загрузки процессора. Например, MAE = 7.61 означает среднюю ошибку примерно в 7.6 процентного пункта CPU. |
|
RMSE |
Ошибка, которая сильнее штрафует крупные промахи. Чем она выше относительно MAE, тем чаще встречаются большие ошибки. |
|
precision@80 |
Какая доля предупреждений о перегрузке действительно оказалась перегрузкой. Для GRU значение 0.793 означает примерно 8 правильных предупреждений из 10. |
|
recall@80 |
Какую долю реальных перегрузок удалось обнаружить заранее. Для GRU 0.830 означает, что модель замечает примерно 83% таких случаев. |
|
параметры |
Количество обучаемых параметров модели. Косвенно показывает её размер и вычислительную сложность. |
|
эпохи |
Сколько полных проходов по обучающим данным потребовалось до завершения обучения [5]. |
Здесь @80 означает, что перегрузкой считается ситуация, когда загрузка процессора достигает 80% или выше.
Для этой задачи особенно важен баланс между precision@80 и recall@80: слишком низкая precision (точность срабатываний) даёт много лишних масштабирований, а слишком низкая полнота означает, что значительная часть реальных перегрузок останется незамеченной.
Что означают эти цифры без ML-терминологии:
-
средняя абсолютная ошибка GRU — около 7,6 процентного пункта CPU. То есть в среднем прогноз отличается от фактической загрузки примерно на 7,6 п.п.;
-
модель заранее видит около 83% будущих перегрузок. Проще говоря, из 10 перегрузок примерно 8 можно заметить заранее и успеть подготовить дополнительные ресурсы;
-
примерно 79% тревог действительно соответствуют будущей перегрузке. То есть из 10 предупреждений около 8 будут оправданными, а примерно 2 приведут к преждевременному масштабированию;
-
простое правило «через 30 минут будет примерно столько же CPU, сколько сейчас» заметно хуже. Оно хорошо работает, пока нагрузка почти не меняется, но именно быстрый рост нагрузки представляет наибольший интерес [6].
Если совсем просто: модель не пытается идеально угадать будущую загрузку процессора. Её задача — дать инфраструктуре несколько десятков минут форы перед перегрузкой.
Но самая интересная цифра другая.
Из 2450 будущих перегрузок:
1519 (62%) — CPU уже сейчас ≥ 80%
 931 (38%) — CPU сейчас < 80%, но через 30 минут ≥ 80%
Первые 62% и так видны обычному мониторингу.
А вот 38% — это именно те случаи, ради которых упреждающее масштабирование вообще имеет смысл.
Назовём такие случаи surprise overload:
сейчас CPU < 80%
        ↓
через 30 минут CPU ≥ 80%
Для них отдельно считаем surprise_recall — долю таких будущих перегрузок, которые модель обнаруживает заранее.
GRU при пороге 80% показывает:
surprise_recall ≈ 0.85
То есть модель заранее замечает примерно 85% перегрузок, которые в момент прогноза ещё не видны обычному пороговому мониторингу.
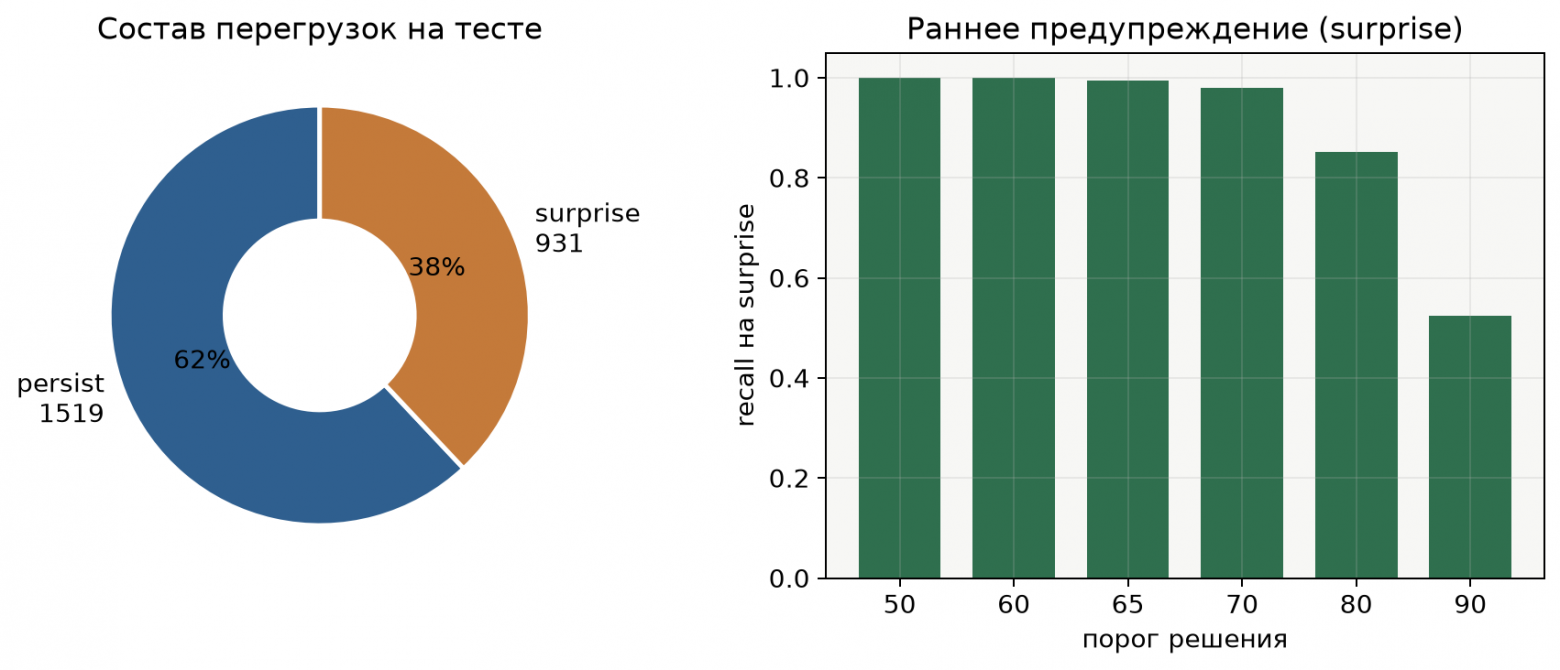
Рис. 1. Слева — состав будущих перегрузок. Справа — какая доля surprise overload у GRU удаётся увидеть заранее.
Это уже не «ещё одна метрика модели», а потенциальные минуты, которые получает инфраструктура на запуск новой виртуальной машины, пода или реплики.
Где здесь деньги
Для бизнеса ложная тревога и пропуск события стоят по-разному.
ложная тревога:
запустили лишнюю VM
→ потратили немного больше денег

пропуск перегрузки:
не увидели перегрузку
→ рост задержки / таймауты / потерянные запросы / нарушение SLA
Если дополнительная VM стоит условную единицу, а пропущенный пик — пять или десять таких единиц, оптимальный порог решения меняется.
Стоимость разных стратегий
|
Обозначение |
Что означает |
|---|---|
|
FP |
Ложная тревога: ресурсы добавили, хотя перегрузки не произошло. |
|
FN |
Пропущенная перегрузка: система не успела отреагировать заранее. |
|
C_fn |
Во сколько раз пропущенная перегрузка считается дороже одной ложной тревоги. |
|
GRU@80 |
Масштабируемся, если прогноз загрузки достигает 80% или выше. |
|
GRU@70 |
Более осторожная политика: начинаем масштабирование уже при прогнозе ≥ 70%. |
На тесте:
|
Политика |
FP |
FN |
Стоимость при |
|
|
|---|---|---|---|---|---|
|
наивный@80 |
1401 |
931 |
3263 |
6056 |
10711 |
|
GRU@80 |
530 |
416 |
1362 |
2610 |
4690 |
|
GRU@70 |
1442 |
78 |
1598 |
1832 |
2222 |
|
GRU@65 |
2056 |
20 |
2096 |
2156 |
2256 |
Здесь C_fn показывает, насколько пропущенная перегрузка дороже лишнего масштабирования.
Если простой сервиса относительно дешёвый, можно держать порог ближе к 80% и реже запускать лишние ресурсы.
Если же пропущенная перегрузка дорого обходится бизнесу, имеет смысл снижать порог до 70% и заранее масштабироваться чаще.
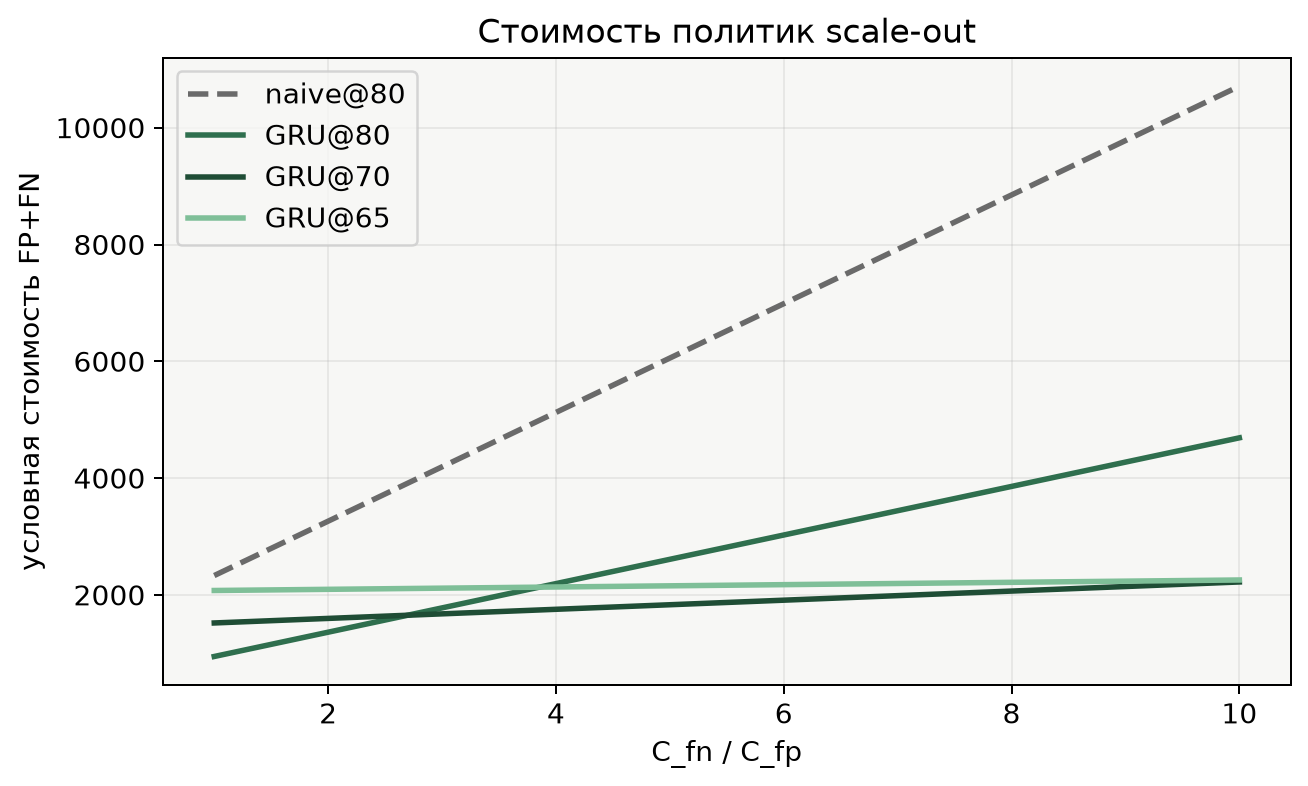
Рис. 2. Условная стоимость FP + C_fn × FN. Чем дороже пропущенный пик относительно лишнего масштабирования, тем полезнее более ранний упреждающий сигнал.
Это один из главных практических выводов:
порог решения — не просто техническое число. Это бизнес-компромисс между стоимостью лишней вычислительной мощности и стоимостью пропущенной перегрузки.
Почему нельзя просто начинать масштабирование при прогнозе 70%
Потому что чем раньше реагируем, тем больше ложных тревог.
Для GRU:
|
порог решения |
precision |
recall |
F1 |
доля тревог |
|---|---|---|---|---|
|
50 |
0.38 |
1.00 |
0.55 |
56% |
|
60 |
0.47 |
1.00 |
0.64 |
45% |
|
65 |
0.54 |
0.99 |
0.70 |
39% |
|
70 |
0.62 |
0.97 |
0.76 |
33% |
|
75 |
0.70 |
0.92 |
0.80 |
28% |
|
80 |
0.79 |
0.83 |
0.81 |
22% |
|
85 |
0.87 |
0.69 |
0.77 |
17% |
|
90 |
0.92 |
0.53 |
0.67 |
12% |
При пороге 50% модель почти ничего не пропускает, но больше половины тревог оказываются лишними.
При 90% тревоги очень точные по precision, но почти половину перегрузок мы уже пропускаем.
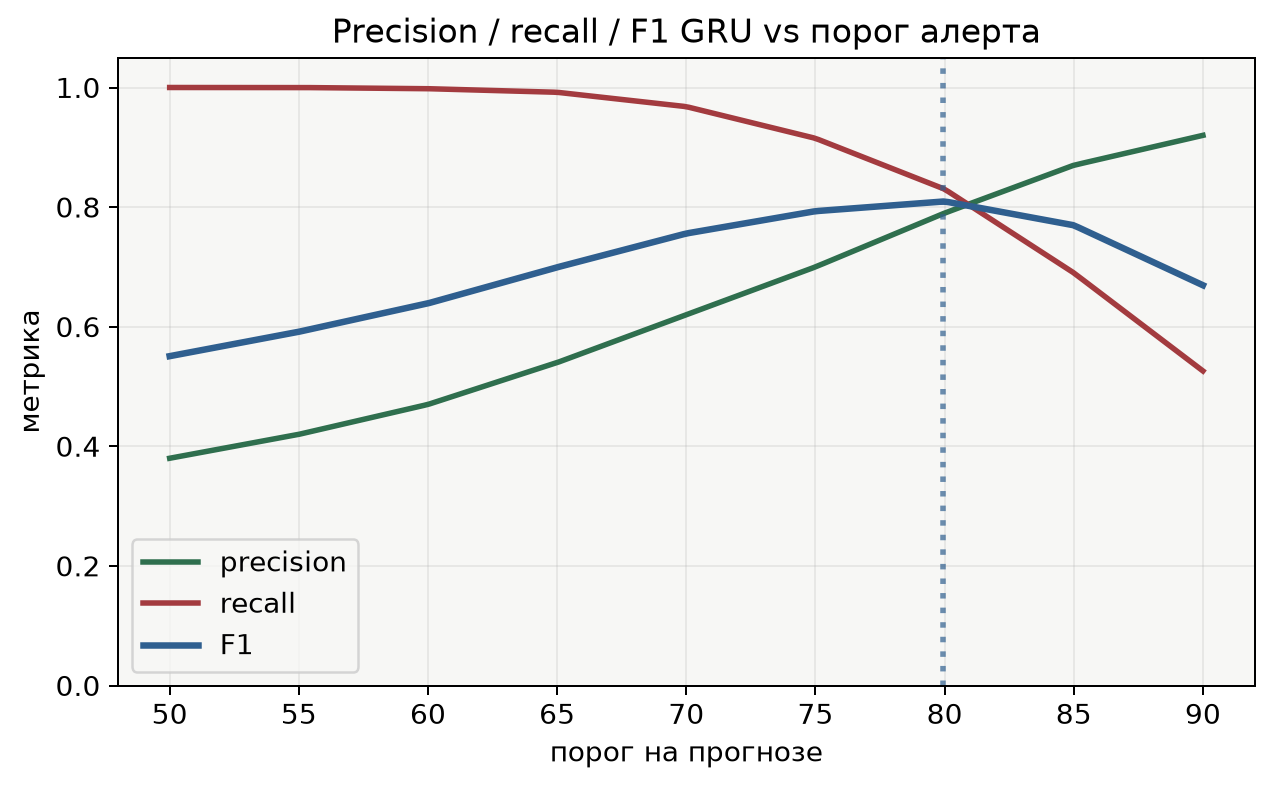
Рис. 3. Precision / recall / F1 GRU при разных порогах решения.
Поэтому важно разделять две вещи:
порог перегрузки (OVERLOAD_THRESHOLD):
факт CPU ≥ 80%

порог решения (DECISION_THRESHOLD):
прогноз 70–80%, в зависимости от цены ошибки
Откуда я взял данные
Используем AzurePublicDatasetV1 (Cortez et al., 2017).
Это набор реальных данных о нагрузке из одного региона Azure:
30 последовательных дней 2 013 767 виртуальных машин 1 246 539 221 измерение загрузки процессора шаг — 5 минут
Для каждого измерения доступны минимальная, максимальная и средняя загрузка процессора, а для виртуальных машин — количество виртуальных процессоров и объём памяти.
Полный набор занимает десятки гигабайт. Загружать его целиком бессмысленно: большая часть виртуальных машин почти всё время простаивает, и на них задача «предсказать перегрузку» превращается в прогноз небольших колебаний около нуля.
Поэтому используем стратифицированную выборку:
3 шарда Azure CPU readings из 125 (~10M строк каждый)
потоковая статистика по ~160k VM, встреченным в этих шардах

страты по mean avg CPU:
0–10 / 10–25 / 25–40 / 40–60 / 60–80 / 80–100

итог:
400 VM
seed = 42
Эксперимент опирается не на полные 30 дней для всех отобранных VM, а на измерения, доступные в трёх проанализированных шардах: после стратификации и выравнивания на 5-минутную сетку получается компактный рабочий набор, а не полный продольный срез Azure.
Распределение данных:
25–40% : 100
10–25% :  80
40–60% :  80
60–80% :  60
 0–10% :  40
80–100%:  40
После выравнивания на сетку 5 минут:
82 113 строк
400 VM
доля avg CPU ≥ 80% ≈ 25%
доля avg CPU ≥ 40% ≈ 40%
Важно: выборка намеренно стратифицирована по средней загрузке CPU и содержит повышенную долю нагруженных VM. Поэтому доля перегрузок, абсолютные значения FP/FN и приведённые ниже оценки условной стоимости относятся к этому экспериментальному набору и не должны интерпретироваться как частота перегрузок во всей инфраструктуре Azure.
На тесте получилось 2450 окон с будущей перегрузкой, то есть около 21.5%.
Что именно прогнозируем
Каждая точка телеметрии приходит раз в 5 минут.
Берём последний час:
12 точек × 5 минут = 60 минут истории
и пытаемся ответить:
каким будет avg_cpu через 30 минут?
Целевая переменная — avg_cpu через 30 минут, то есть y = avg_cpu(t+30). Будущей перегрузкой считаем окно, для которого avg_cpu(t+30) ≥ 80%.
Схема:
t-55 → t-50 → ... → t-5 → t
                         ↓
                       модель
                         ↓
                 y = avg_cpu(t+30)
Почему выбран именно горизонт в 30 минут?
Слишком короткий горизонт плохо подходит для упреждающего масштабирования. Прогноз на 5–10 минут вперёд может быть достаточно близким к факту, но практическая ценность такой ошибки прогноза ограничена: инфраструктура получает слишком мало времени между сигналом модели и фактическим ростом нагрузки.
Важен не минимальный прогнозируемый горизонт, а время упреждения, достаточное для выполнения инфраструктурных действий.
За 30 минут система успевает не просто зафиксировать риск, а подготовиться к нему:
-
запустить дополнительные экземпляры приложения;
-
дождаться их полной готовности;
-
прогреть кэши и соединения;
-
перераспределить трафик;
-
увеличить запас вычислительных ресурсов до начала деградации сервиса.
Таким образом, горизонт в 30 минут выбран не потому, что прогноз на 5 минут «слишком простой», а потому, что короткий горизонт даёт существенно меньшую операционную ценность.
В коде:
WINDOW = 12   # 60 минут истории
HORIZON = 6   # 6 × 5 мин = 30 минут вперёд
FEATURES = ["min_cpu", "max_cpu", "avg_cpu"]
OVERLOAD_THRESHOLD = 80.0
DECISION_THRESHOLD = 80.0  # в политике может быть 70–80
Признаки CPU перед обучением стандартизуются: StandardScaler подгоняется только на train-VM и применяется к validation и test. Целевая переменная y = avg_cpu(t+30) для метрик и порогов переводится обратно в исходную шкалу 0–100%.
Что делать с пропусками в данных?
Реальные данные выглядят не идеально:
10:00  32
10:05  34
10:10  NaN
10:15  NaN
10:20  42
Если просто удалить все неполные куски, теряем данные.
Если бездумно восстанавливать час отсутствующей телеметрии, начинаем обучать модель на фактически выдуманных значениях.
Поэтому используем гибридное правило:
|
стратегия |
идея |
длинный разрыв |
|---|---|---|
|
|
линейная интерполяция с ограничением длины |
сегмент разрезается |
|
|
заполнение вперёд/назад с лимитом |
сегмент разрезается |
|
|
≤3 шага линейной интерполяции, ≤12 ffill, дальше разрез |
сегмент разрезается |
При шаге 5 минут это то же самое, что:
пропуск ≤ 15 минут
→ интерполяция

пропуск ≤ 1 часа
→ ограниченное заполнение + is_imputed = 1

пропуск > 1 часа
→ разрываем последовательность
Как заполняем пропуски
|
Ситуация |
Было |
Что делаем |
Получаем |
|---|---|---|---|
|
Пропущена одна точка |
|
Линейная интерполяция |
|
|
Пропущены две точки |
|
Интерполяция между соседними измерениями |
|
|
Небольшой разрыв до 15 минут |
|
Интерполяция или короткое заполнение предыдущим значением |
Восстанавливаем только короткий участок |
|
Данные отсутствуют дольше 15 минут, но меньше часа |
|
Ограниченное заполнение предыдущим значением и ставим признак |
Модель знает, что эти значения восстановлены |
|
Телеметрии нет больше часа |
|
Не восстанавливаем значения |
Разрываем последовательность и не используем окно |
Например, при шаге телеметрии в 5 минут:
10:00   32
10:05   34
10:10   ?
10:15   ?
10:20   42
после интерполяции получаем:
10:00   32
10:05   34
10:10   36.7
10:15   39.3
10:20   42
А вот такой участок:
10:00   32
10:05   34
10:10   ?
...
11:20   ?
11:25   47
уже не стоит «дорисовывать». Мы не знаем, что происходило с нагрузкой в течение этого часа, поэтому такой фрагмент лучше исключить из последовательности, чем подменять реальные данные предположениями.
Практически:
разрыв ≤ 15 мин  → интерполяция / короткий ffill
разрыв ≤ 1 час   → осторожный ffill + флаг is_imputed
разрыв длиннее   → режем сегмент
На выбранных 400 VM сетка почти плотная: дозаполнить пришлось всего 29 точек.
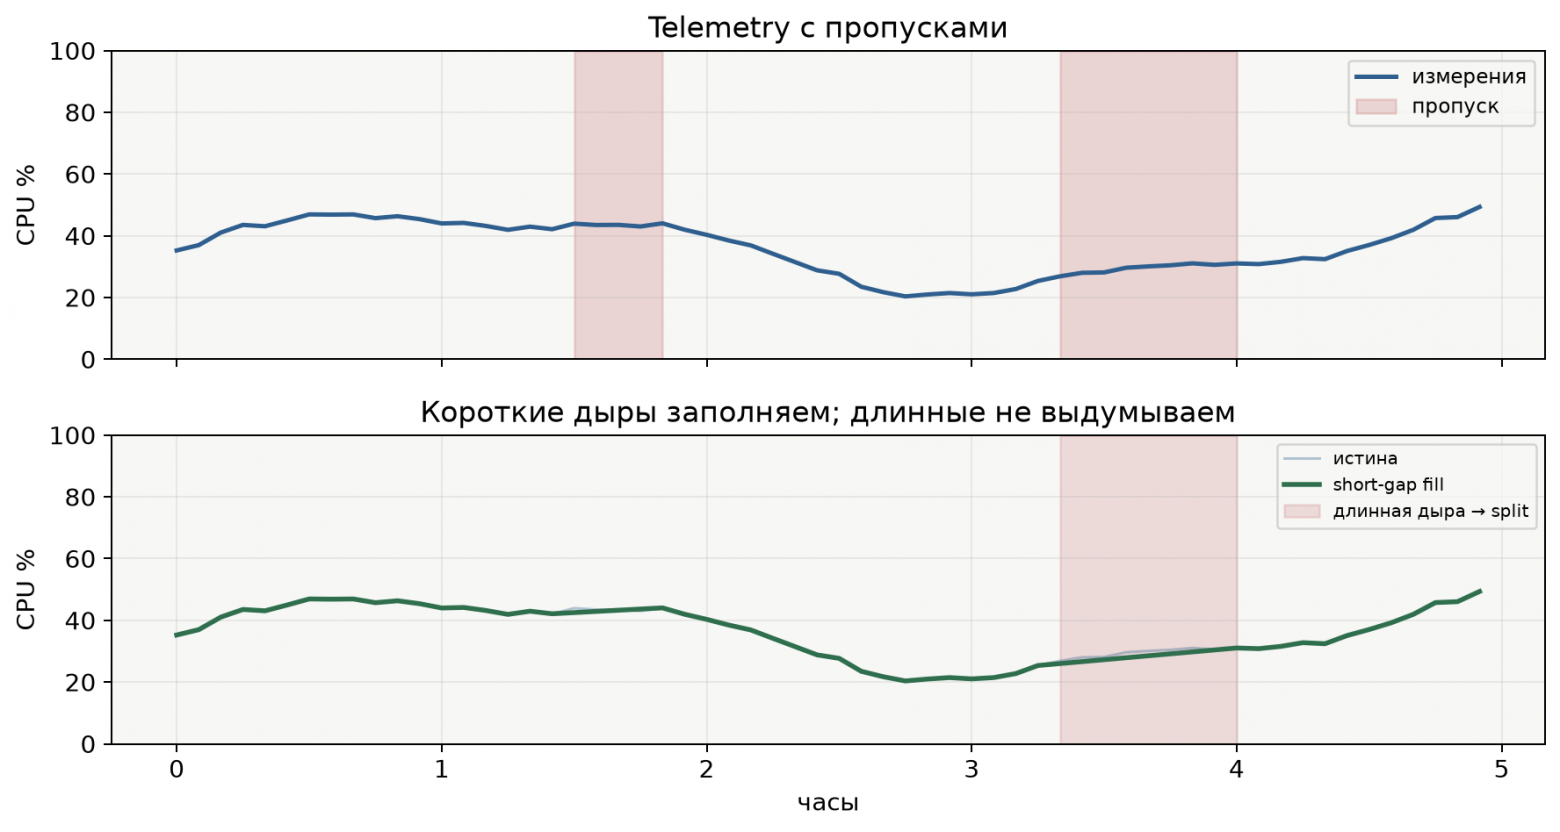
Рис. 4. Короткий разрыв можно восстановить; длинную дыру лучше разорвать, чем придумывать поведение [7] CPU.
В промышленном контуре полезно дополнительно сохранять признак:
is_imputed = 0 / 1
Он показывает, было ли значение получено непосредственно из телеметрии или восстановлено при обработке пропуска — независимо от того, использовалась интерполяция или ограниченный ffill.
В текущем эксперименте этот признак не подаётся на вход модели — он используется только как служебная информация о качестве данных.
Поэтому вход модели по-прежнему состоит из трёх признаков:
min_cpu
max_cpu
avg_cpu
и имеет форму:
12 временных шагов × 3 признака
Осторожно, математика!
В самом эксперименте для коротких пропусков используется линейная интерполяция с ограничением по длине разрыва. Для 5-минутной сетки этого достаточно, тем более что на выбранных 400 VM восстановить пришлось всего 29 точек.
Но сама задача восстановления пропусков хорошо показывает, где в подготовке данных появляется классическая вычислительная математика [8].
Например, если вместо линейной интерполяции использовать кубический сплайн, построение интерполирующей функции приводит к решению трёхдиагональной системы линейных уравнений:
b1 a1  0  0  0
c1 b2 a2  0  0
 0 c2 b3 a3  0
 0  0 c3 b4 a4
...
Такую систему не нужно рассматривать как произвольную плотную матрицу: её специальная структура позволяет решать задачу существенно эффективнее.
В SciPy это можно записать так:
import numpy as np
from scipy.interpolate import CubicSpline

def fill_small_gap_with_spline(t, y):
    mask = ~np.isnan(y)

    spline = CubicSpline(
        t[mask],
        y[mask]
    )

    result = y.copy()
    result[~mask] = spline(t[~mask])

    return result
Здесь сплайн приведён как отдельный численный вариант, а не как подготовка данных, использованная для получения результатов ниже.
Для длинных пропусков ни линейную интерполяцию, ни сплайн использовать не стоит: если телеметрия отсутствовала слишком долго, лучше разорвать временной сегмент, чем обучать модель на искусственно восстановленной траектории CPU.
Базовый метод №1: «через 30 минут будет как сейчас»
Самый простой прогноз:
CPU(t+30) = CPU(t)
В коде:
y_pred = current_cpu
Зачем вообще сравниваться с такой примитивной моделью?
Потому что нейросеть, которая обучалась несколько часов и не обгоняет одно присваивание, никому не нужна.
Базовый метод №2: скользящее среднее
В таблице результатов — скользящее среднее: сглаживаем последние значения окна и берём это как прогноз на t+30.
Это дешёвый численный ориентир: если GRU/LSTM не обгоняют его заметно по precision/recall, сложная модель в эксплуатации не оправдана.
Дополнительный базовый метод: локальный тренд
Помимо базовых методов, вошедших в итоговую таблицу, полезно рассмотреть ещё один простой подход — локальную линейную экстраполяцию.
Ниже он нужен прежде всего для иллюстрации численного метода. В итоговый эталонный прогон локальный тренд не включён, поэтому сравнивать его метрики с GRU/LSTM по приведённой далее таблице нельзя.
Можно взять последний час CPU, провести через него прямую:

и продолжить её ещё на 30 минут.
Коэффициенты ищем методом наименьших квадратов:
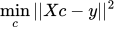
В коде:
t = np.arange(12)

X = np.column_stack([
    np.ones_like(t),
    t
])

coef, *_ = np.linalg.lstsq(
    X,
    cpu_history,
    rcond=None
)

future_t = 17  # текущий шаг t=11, горизонт +6 → 17

prediction = (
    coef[0]
    + coef[1] * future_t
)
Здесь специально используется np.linalg.lstsq, а не решение через нормальные уравнения:
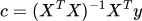
Явное построение обратной матрицы обычно не нужно и может ухудшать численную устойчивость вычислений.
В данном базовом методе матрица признаков очень простая:
X = [1, t]
поэтому проблема плохой обусловленности практически не возникает.
Она становится важнее, если строить линейную модель сразу по нескольким коррелирующим признакам, например:
avg_cpu
rolling_avg_cpu
rolling_avg_cpu_5
smoothed_cpu
Тогда близкие по смыслу столбцы могут сделать задачу численно неустойчивой, и число обусловленности действительно становится полезной диагностикой.
Но для показанного выше базового метода с одним временным трендом отдельно логировать cond(X) особого смысла нет.
Линейный тренд в этом разделе — иллюстрация численной постановки; в итоговой таблице сравнения моделей его нет, там — наивный прогноз и скользящее среднее.
Теперь нейросети
После очистки одно окно имеет форму:
12 временных шагов × 3 признака

min CPU
max CPU
avg CPU
То есть модель видит час поведения [9] VM и должна вернуть одно число — CPU через 30 минут.
LSTM
model = keras.Sequential([
    keras.layers.Input(shape=(12, 3)),

    keras.layers.LSTM(
        64,
        return_sequences=True
    ),

    keras.layers.LSTM(32),

    keras.layers.Dense(
        32,
        activation="relu"
    ),

    keras.layers.Dense(1)
])
GRU
gru = keras.Sequential([
    keras.layers.Input(shape=(12, 3)),

    keras.layers.GRU(
        64,
        return_sequences=True
    ),

    keras.layers.GRU(32),

    keras.layers.Dense(
        32,
        activation="relu"
    ),

    keras.layers.Dense(1)
])
Небольшой Transformer
inputs = keras.Input(shape=(12, 3))
x = keras.layers.Dense(64)(inputs)

attn = keras.layers.MultiHeadAttention(
    num_heads=4,
    key_dim=16
)(x, x)

x = keras.layers.LayerNormalization()(x + attn)

ff = keras.layers.Dense(
    128,
    activation="relu"
)(x)

ff = keras.layers.Dense(64)(ff)
x = keras.layers.LayerNormalization()(x + ff)

x = keras.layers.GlobalAveragePooling1D()(x)
x = keras.layers.Dense(32, activation="relu")(x)
outputs = keras.layers.Dense(1)(x)
Ключевое слово — небольшой.
У нас 12 временных точек, а не миллион токенов контекста. Transformer на сотни миллионов параметров здесь был бы дорогим способом решить маленькую задачу.
Как не обмануть себя на тесте
Нельзя случайно перемешать все окна:
train_test_split(
    data,
    shuffle=True
)
Тогда фрагменты одной VM попадут и в train, и в test, а модель фактически увидит очень похожие куски той же машины.
В эксперименте разбиение сделано по vm_id:
70% VM → train   (280)
15% VM → val     (60)
15% VM → test    (60)
seed = 42
Количество окон:
train  52 620
val    11 285
test   11 408

форма:
(N, 12, 3)
Так test действительно проверяет, как модель работает на других VM.
Какие показатели важны для бизнеса
MAE (средняя абсолютная ошибка) и RMSE (среднеквадратичная ошибка) полезны для оценки точности прогноза, но сами по себе не отвечают на главный вопрос: поможет ли такое прогнозирование вовремя увеличить вычислительные ресурсы и избежать перегрузки?
MAE
→ средняя ошибка прогноза CPU

RMSE
→ сильнее штрафует крупные промахи
Для операционной инфраструктуры важнее:
precision
→ какая доля тревог была оправданной

recall
→ какую долю реальных перегрузок мы заметили
Если:
precision = 0.80
то примерно 8 из 10 упреждающих масштабирований были оправданы.
Если:
recall = 0.85
то модель увидела около 85% реальных перегрузок.
Именно поэтому в этой задаче нельзя выбирать модель только по MAE.
Что получилось
Полный прогон в контуре Yandex Cloud:
window = 12
horizon = 6
overload = 80
test = 11 408 окон
n_overload = 2450
Итог:
|
модель |
MAE |
RMSE |
precision@80 |
recall@80 |
параметры |
эпохи |
|---|---|---|---|---|---|---|
|
GRU |
7.61 |
9.80 |
0.793 |
0.830 |
23 745 |
21 |
|
LSTM |
7.97 |
10.34 |
0.774 |
0.829 |
30 913 |
24 |
|
Transformer |
9.26 |
12.05 |
0.727 |
0.800 |
35 841 |
25 |
|
скользящее среднее |
8.73 |
12.85 |
0.708 |
0.791 |
— |
— |
|
наивный |
9.16 |
14.37 |
0.520 |
0.620 |
— |
— |
|
Dense |
14.86 |
18.35 |
0.783 |
0.245 |
2 369 |
25 |
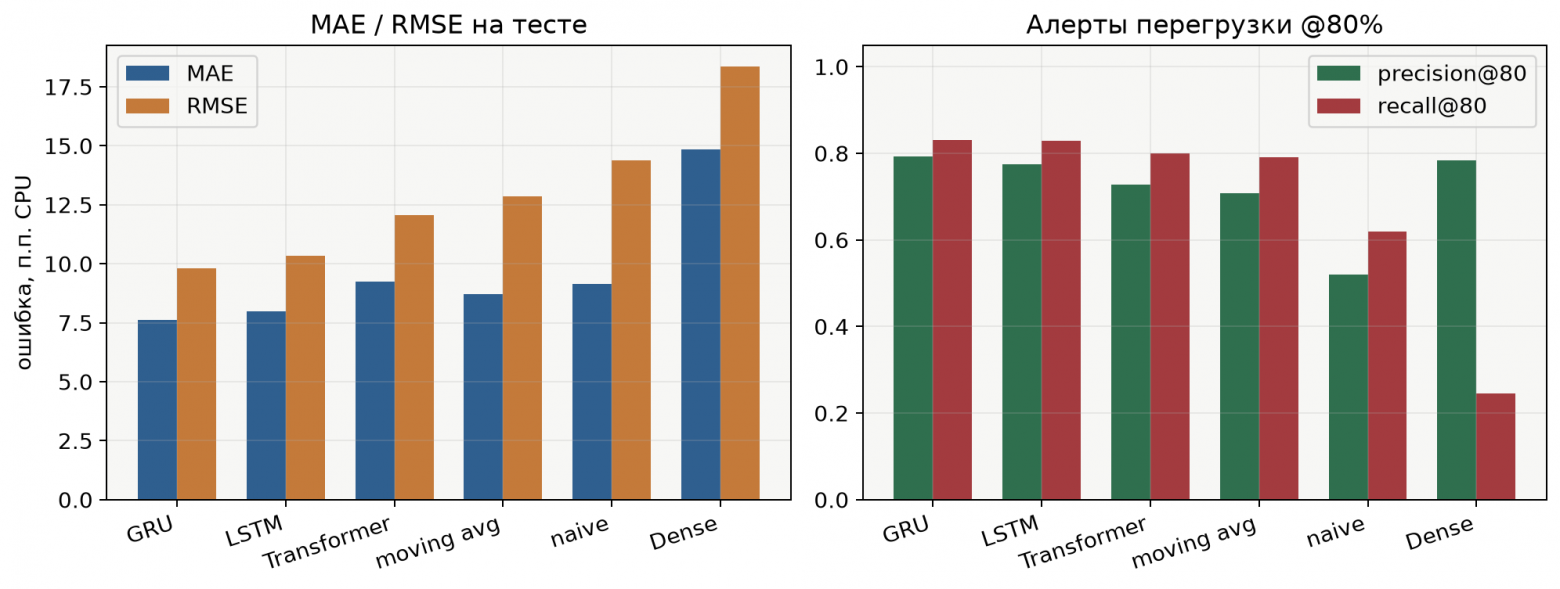
Рис. 5. Ошибка прогноза и качество обнаружения перегрузки. GRU/LSTM дают лучший баланс.
GRU и LSTM показывают очень близкие результаты.
Это тоже полезный вывод: здесь нет необходимости принципиально выбирать одну архитектуру и считать её единственно правильной. Если две модели дают почти одинаковый практический эффект, в промышленной эксплуатации разумнее выбрать ту, которую проще, дешевле и удобнее сопровождать.
Dense хорошо показывает типичную ловушку: точность срабатываний высокая, но полнота составляет всего около 0,25.
Иными словами, когда Dense подаёт сигнал о будущей перегрузке, он часто оказывается верным. Проблема в другом: большую часть реальных пиков модель просто не замечает.
Для системы раннего предупреждения такое поведение плохо подходит.
Где именно появляется выигрыш
Посмотрим на реальный фрагмент нагрузки.
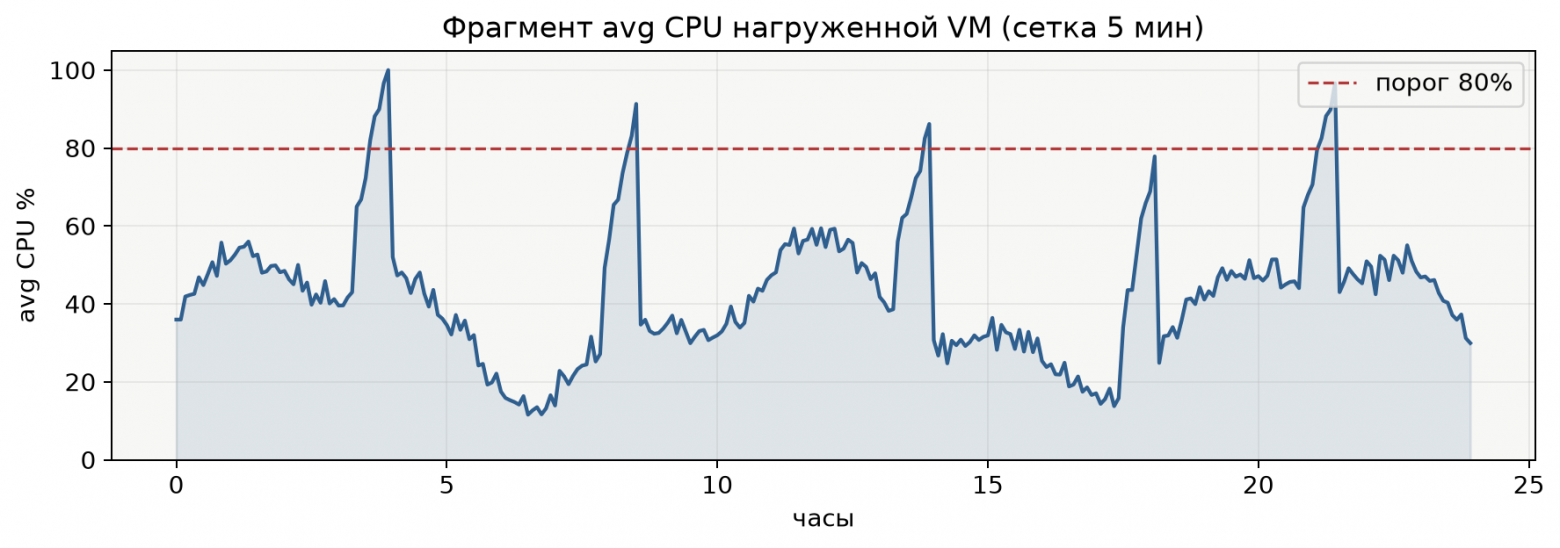
Рис. 6. Фрагмент avg CPU одной VM. Порог перегрузки — 80%.
Спокойные периоды сменяются резкими всплесками.
Задача прогноза не в том, чтобы красиво аппроксимировать всю кривую. Его задача — увидеть момент, когда через полчаса VM уйдёт в опасную зону.
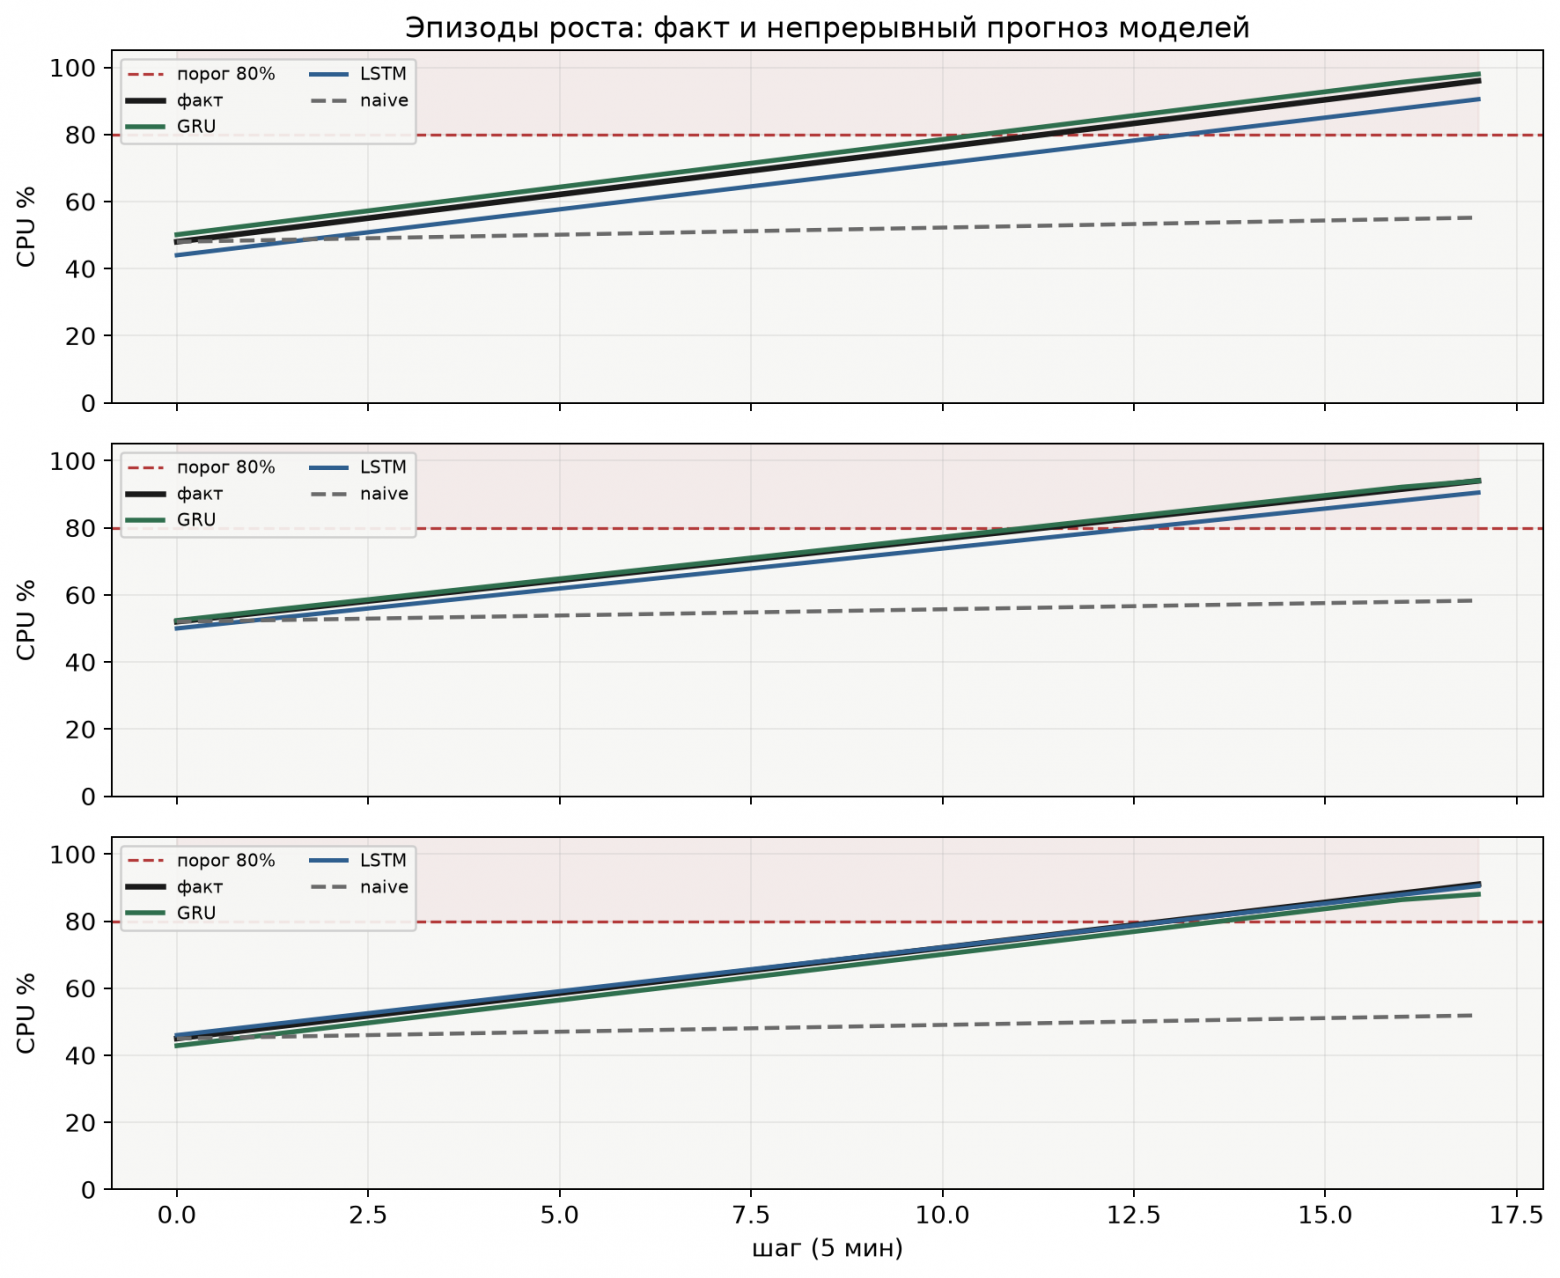
Рис. 7. Эпизоды роста CPU: факт и прогнозы GRU / LSTM / наивного метода.
Наивный метод закономерно запаздывает: он считает, что будущее примерно равно настоящему.
GRU/LSTM начинают двигаться вверх раньше и дают запас времени до фактического пересечения 80%.
Не только средняя ошибка
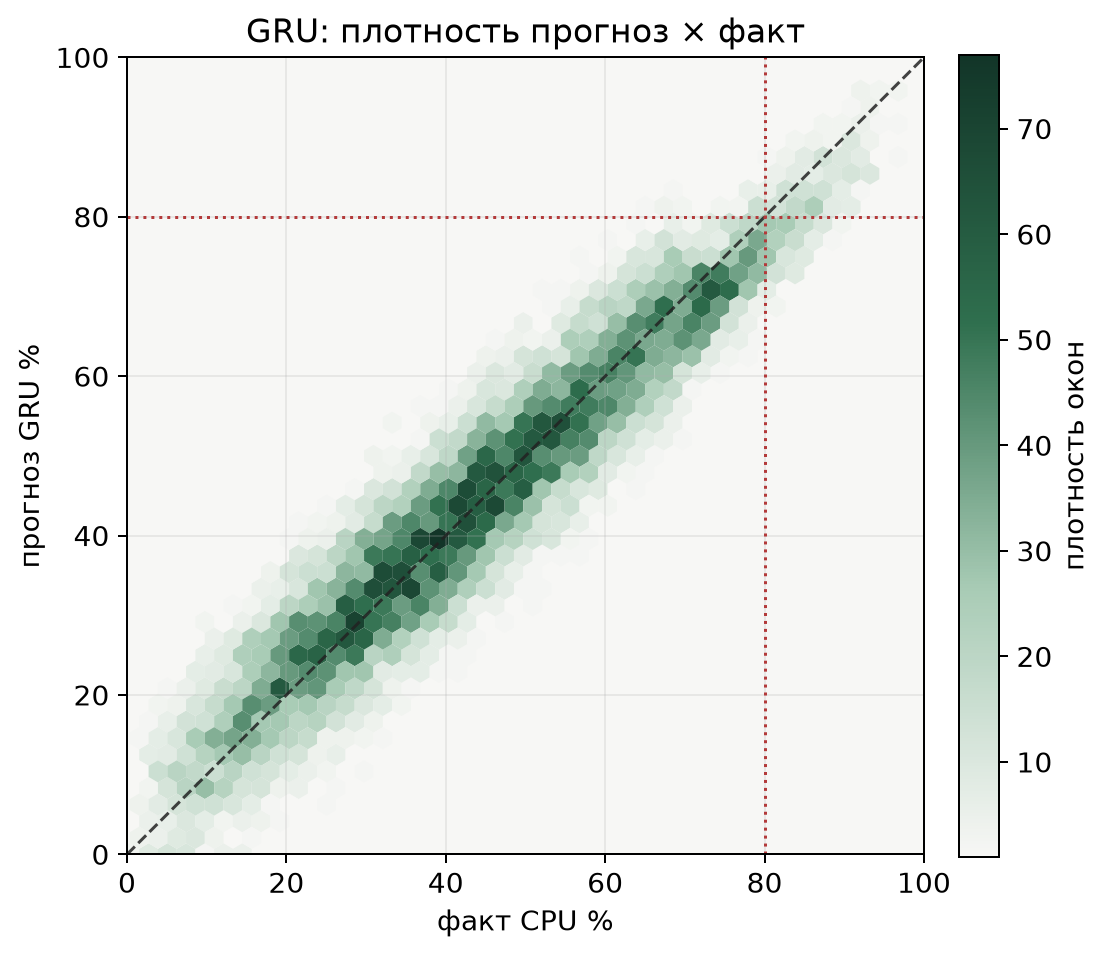
Рис. 8. GRU: прогноз против факта.
Чем ближе точки к диагонали, тем лучше прогноз.
На высоких CPU облако точек не проваливается систематически вниз. Это важно: модель не должна постоянно занижать пики.
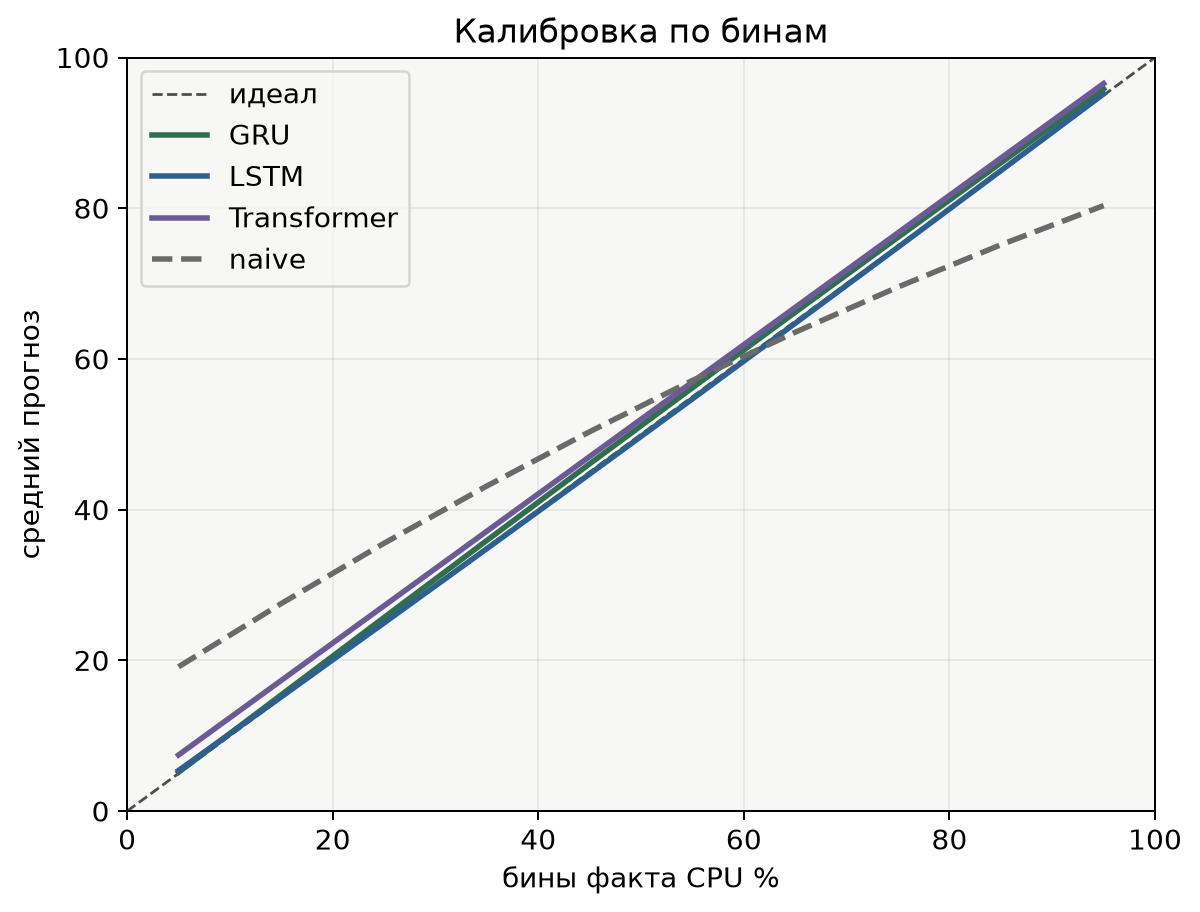
Рис. 9. Калибровка прогнозов.
Если фактический CPU около 90%, средний прогноз GRU тоже остаётся около верхнего диапазона.
Наивный метод чаще недооценивает верхние значения — отсюда дополнительные пропуски.
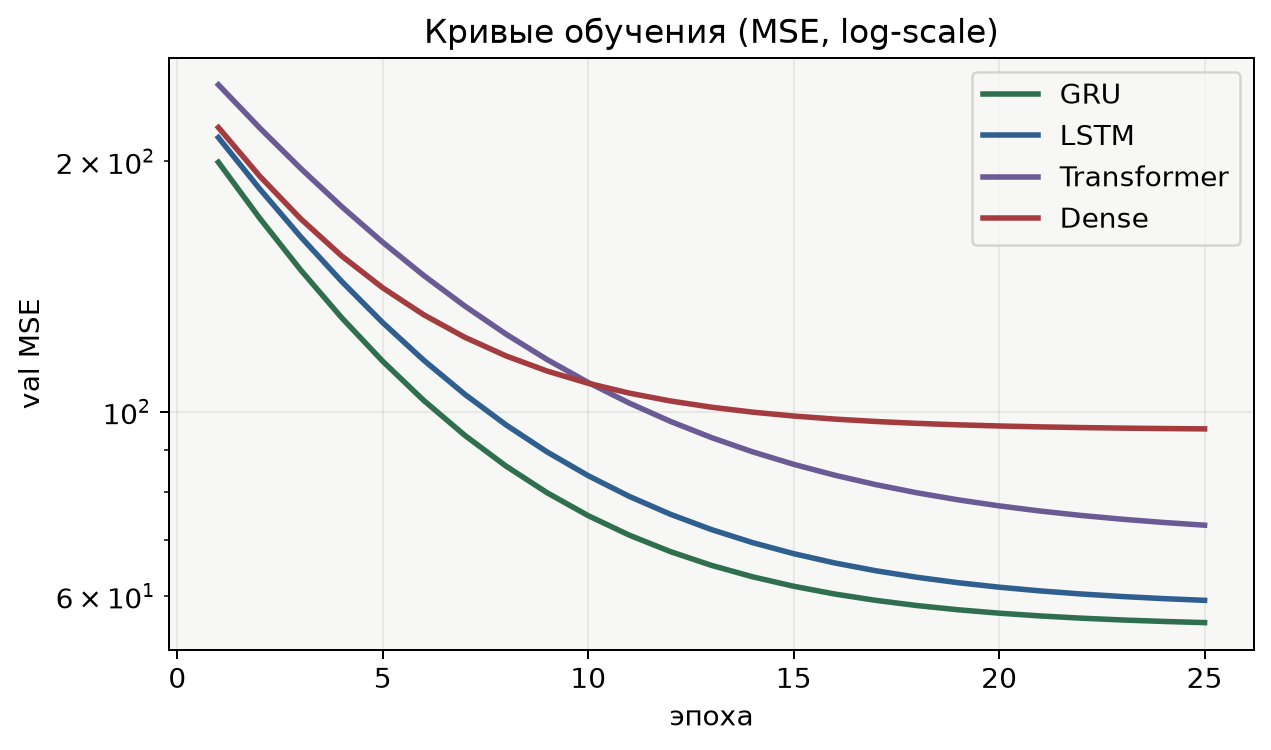
Рис. 10. Кривые обучения.
Все сети выходят на плато примерно к 20-й эпохе; после этого дальнейшее обучение почти не улучшает результат.
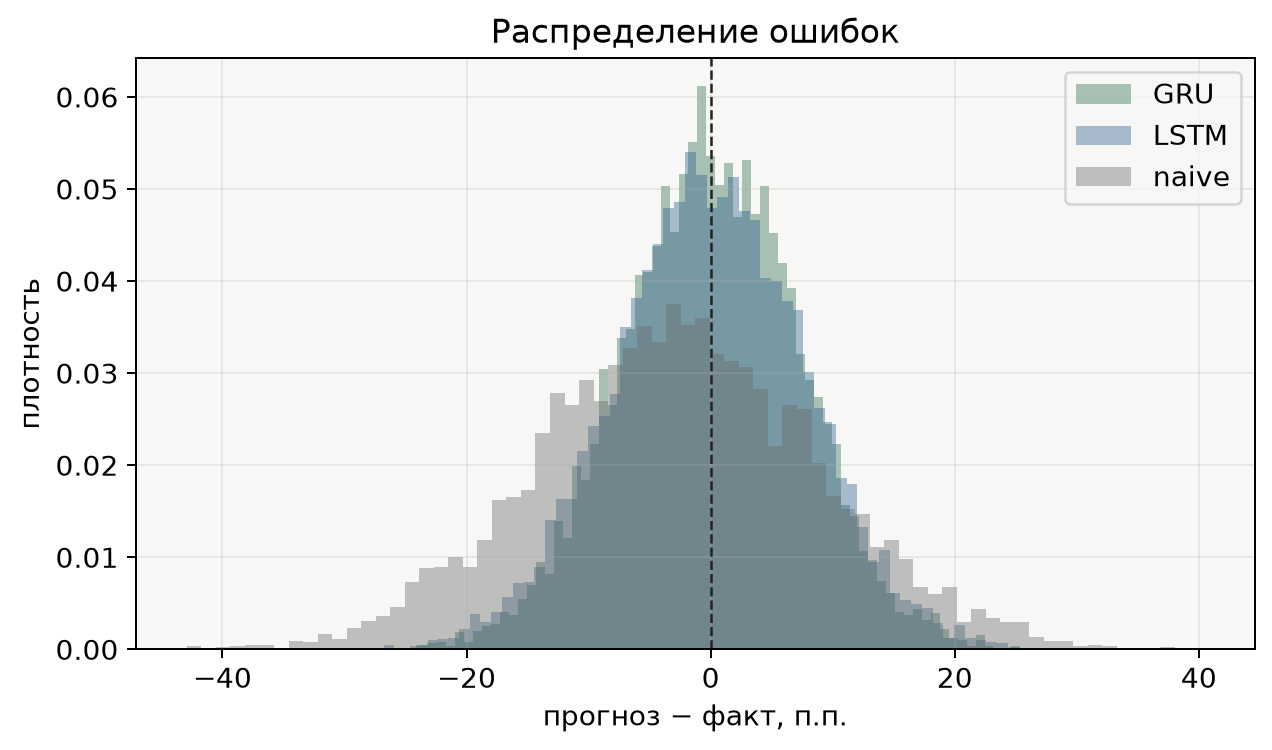
Рис. 11. Распределение ошибки «прогноз − факт».
У GRU меньше крупных ошибок на десятки процентных пунктов CPU.
Для инфраструктуры это важнее, чем несколько десятых MAE: одна большая ошибка может прийтись именно на момент пикового трафика.
Модель обучена. Теперь переносим её в промышленный контур
До этого момента мы работали как с исследовательской задачей: подготовили данные, сравнили несколько подходов, измерили качество и выбрали модель.
Теперь требования меняются.
Нужно решить уже не вопрос «какая модель точнее», а четыре вполне прикладные задачи:
как воспроизвести выбранный эксперимент
как доставить модель в рабочую среду
откуда получать свежую телеметрию
как безопасно превратить прогноз в масштабирование
Для этого используем несколько компонентов.
MLflow будет хранить параметры, метрики и версии экспериментов, чтобы всегда можно было понять, какая модель и с какими настройками попала в эксплуатацию.
Yandex DataSphere используем для обучения и запуска экспериментов, Object Storage — для хранения моделей и артефактов, Managed Service for Prometheus — для сбора и запроса рабочих метрик, а Yandex Monitoring — для панелей, визуализации и оповещений.
Саму модель завернём в сервис прогнозирования, который будет получать историю нагрузки и возвращать прогноз на 30 минут вперёд. Отдельный слой правил будет решать, когда действительно запускать масштабирование, а обычное реактивное масштабирование останется резервной защитой на случай ошибки или недоступности модели.
При этом обычное автоматическое масштабирование никуда не исчезает. Прогноз дополняет его, а не заменяет.
MLflow: фиксируем, что именно попало в эксплуатацию
После нескольких запусков быстро возникает проблема воспроизводимости:
какое окно истории использовали?

какое начальное значение генератора случайных чисел?

горизонт прогноза — 15 или 30 минут?

какая версия модели построила этот график?

как масштабировались признаки?

на какой версии набора данных обучалась модель?
Если ответы хранятся только в ноутбуке или названии файла, через месяц восстановить эксперимент становится затруднительно.
Поэтому параметры и результаты фиксируем в MLflow.
import mlflow

mlflow.set_experiment("vm-cpu-forecast")

with mlflow.start_run():

    mlflow.log_params({
        "window": 12,
        "horizon": 6,
        "seed": 42,
        "model": "gru",
        "overload_threshold": 80.0,
        "feature_scaler": "StandardScaler",
    })

    mlflow.log_metrics({
        "mae": mae,
        "rmse": rmse,
        "overload_precision": precision,
        "overload_recall": recall,
    })

    mlflow.log_artifact(
        "predicted_vs_actual.png"
    )
В результате для каждого запуска сохраняются:
параметры эксперимента
показатели качества
кривые обучения
графики прогнозов
модель
параметры преобразования данных
список признаков
версия набора данных
Смысл здесь простой: через месяц можно точно определить, какая версия модели работала в промышленной среде, на каких данных она была обучена, какие результаты показывала и почему для эксплуатации выбрали именно её.
Где размещаем MLflow в Yandex Cloud
Контур экспериментов можно собрать следующим образом:
исходные данные
      ↓
Object Storage
      ↓
DataSphere
      ↓
подготовка данных
      ↓
GRU / LSTM / Transformer / базовые методы
      ↓
MLflow
      ↓
артефакт модели
DataSphere здесь отвечает за вычисления и обучение.
Сам сервер MLflow можно разместить на небольшой виртуальной машине Compute Cloud:
                    MLflow
                   /
                  /
Managed PostgreSQL          Object Storage
   параметры и метрики       модели и артефакты
То есть PostgreSQL хранит сведения об экспериментах, а крупные файлы — модели, графики и другие артефакты — отправляются в Object Storage.
DataSphere передаёт результаты в MLflow:
DataSphere
    ↓
MLflow API
    ↓
Compute Cloud VM
   ↙              ↘
PostgreSQL     Object Storage
Пример запуска сервера:
mlflow server
  --backend-store-uri
    "postgresql://USER:PASSWORD@HOST:6432/db1?sslmode=verify-full"
  --default-artifact-root s3://BUCKET/artifacts
  -h 0.0.0.0
  -p 8000
А клиенту достаточно указать адрес сервера и Object Storage:
os.environ["MLFLOW_TRACKING_URI"] = "http://<VM_INTERNAL_IP>:8000"
os.environ["MLFLOW_S3_ENDPOINT_URL"] = "https://storage.yandexcloud.net"
MLflow при этом остаётся обычным открытым компонентом: история экспериментов не привязана к конкретному ноутбуку или вычислительной сессии.
Разворачиваем выбранную модель
После выбора модели сохраняем её:
model.save(
    "cpu_forecast.keras"
)
При необходимости можно экспортировать модель в ONNX и запускать её независимо от среды, в которой проходило обучение.
С точки зрения [10] остальной инфраструктуры модель удобнее представить как обычный сервис.
Например:
POST /forecast
Запрос:
{
  "vm_id": "...",
  "history": [...]
}
Ответ:
{
  "current_cpu": 63.4,
  "predicted_cpu_30m": 86.2,
  "overload_threshold": 80.0,
  "decision_threshold": 70.0,
  "risk": "high"
}
То есть вместо прямого вызова:
model.predict(...)
получаем сетевой интерфейс, к которому могут обращаться системы мониторинга и управления инфраструктурой.
Для демонстрационного контура модель можно развернуть через DataSphere Node типа Model или Docker. Если нужна переносимость между средами, модель можно экспортировать в ONNX или упаковать вместе с сервисом вывода в Docker-образ.
Исторический набор данных больше не нужен
При обучении мы использовали AzurePublicDatasetV1.
В рабочей среде источник данных уже другой: реальные виртуальные машины, Kubernetes и приложения.
Compute Cloud
Managed Kubernetes
приложения
Телеметрия поступает в систему мониторинга:
VM / Kubernetes
       ↓
Unified Agent / Prometheus
       ↓
Managed Service for Prometheus
       ↓
PromQL
       ↓
сервис прогнозирования
Для модели важно сохранить тот же смысл входных признаков:
timestamp
min_cpu
max_cpu
avg_cpu
В рабочем контуре исходную метрику CPU нужно агрегировать по тем же пятиминутным интервалам, что и в обучающем наборе: для каждого интервала вычисляются min, max и avg. В Prometheus это можно реализовать через соответствующие функции *_over_time либо предварительные recording rules.
Источник данных при обучении и в эксплуатации может быть разным. Критично другое: одинаковая семантика признаков, единицы измерения и временной шаг.
Иначе модель формально продолжит работать, но прогнозировать будет уже совсем не тот процесс, на котором обучалась.
Прогноз сам по себе ничего не масштабирует
Пусть модель вернула:
загрузка процессора через 30 минут:
86%
Этого недостаточно, чтобы немедленно запускать новую виртуальную машину.
Между прогнозом и инфраструктурой нужен отдельный слой правил.
Например:
OVERLOAD_THRESHOLD = 80.0
DECISION_THRESHOLD = 70.0

if (
    prediction >= DECISION_THRESHOLD
    and consecutive_predictions >= 3
    and cooldown_expired
):
    scale_out()
В нём задаются:
порог срабатывания
гистерезис
период ожидания между масштабированиями
минимальное и максимальное число экземпляров
запас мощности
число последовательных подтверждений
Разделение принципиальное:
прогноз модели ≠ решение инфраструктуры
Модель оценивает будущую нагрузку.
Инфраструктурные правила решают, что с этой оценкой делать.
Это позволяет менять модель независимо от логики масштабирования и не давать ошибочному единичному прогнозу напрямую управлять вычислительными ресурсами.
Рабочий контур целиком
Теперь вся схема выглядит так:
              ПРИЛОЖЕНИЕ
                  ↓
            VM / Kubernetes
                  ↓
              ТЕЛЕМЕТРИЯ
                  ↓
         Managed Service for Prometheus
                  ↓
                PromQL
                  ↓
         подготовка признаков
                  ↓
       проверка и заполнение пропусков
                  ↓
          модель прогнозирования
                  ↓
             прогноз модели
                  ↓
             слой правил
              ↙        ↘
 упреждающее правило   реактивное правило
              ↘        ↙
          масштабирование
Обучение идёт отдельно:
DataSphere
    ↓
обучение
    ↓
MLflow
 ↙      ↘
БД    артефакты
Получается важное разделение:
обучение модели
        ≠
работа модели
        ≠
решение о масштабировании
Изменение одной части не требует перестраивать весь контур.
Контролировать нужно не только сервер, но и модель
После развёртывания появляется ещё один объект наблюдения — сам прогноз.
Полезно собирать:
прогноз_cpu_30м
фактический_cpu
ошибка_прогноза
признак_перегрузки
задержка_вывода
версия_модели
Например:
from prometheus_client import Gauge

forecast = Gauge(
    "cpu_forecast_30m",
    "Прогноз CPU через 30 минут"
)

error = Gauge(
    "cpu_forecast_error",
    "Ошибка прогноза"
)
На панели мониторинга это может выглядеть так:
ТЕКУЩИЙ CPU          62%
ПРОГНОЗ +30 МИН      84%

MAE ЗА 24 ЧАСА        7.4
P95 ВРЕМЕНИ ОТВЕТА   18 мс
ПОЛНОТА ПЕРЕГРУЗОК   0.84
Здесь уже можно одновременно видеть и инфраструктуру, и качество прогноза:
сейчас CPU = 62%

через 30 минут ожидается 84%

→ требуется подготовить дополнительную мощность
MLflow при этом отвечает на вопрос:
как была получена эта версия модели?
А рабочий мониторинг — на другой:
как эта версия ведёт себя сейчас?
Главная рабочая метрика — сколько времени удалось выиграть
В эксплуатации нас меньше интересует график функции потерь во время обучения.
Гораздо важнее увидеть момент, когда прогноз впервые сообщил о будущем превышении порога.
CPU

100 |                         факт
 90 |                         /
 80 |             прогноз   /
 70 |               /     /
 60 |______________/_____/__________

       ↑ раннее предупреждение

                        ↑ обычное предупреждение
Например:
прогноз сработал:            14:30
обычный пороговый контроль:  14:50

запас времени:
20 минут
Эти 20 минут и есть практический результат системы.
Если новая мощность запускается за 5 минут — такого запаса более чем достаточно.
Если запуск и прогрев приложения занимают 25 минут, то те же 20 минут уже не решают задачу полностью.
Поэтому оценивать прогноз нужно не только по MAE и RMSE, но и по реальному времени упреждения относительно обычного мониторинга.
Нужен резервный сценарий
Прогноз не должен становиться единственной защитой инфраструктуры.
Если сервис модели недоступен:
прогноз недоступен
        ↓
обычное автоматическое масштабирование продолжает работать
Если модель вернула явно невозможное значение:
прогноз CPU = 312%
результат отклоняем.
Если для новой виртуальной машины ещё недостаточно истории:
недостаточно данных
        ↓
обычные правила масштабирования
Таким образом прогнозирующий слой остаётся дополнительным механизмом раннего предупреждения, а не единственной точкой принятия решения.
Почему здесь не нужен огромный Transformer
Вход маленький:
12 временных шагов
3 числовых признака
короткие независимые окна
быстрый вывод модели
Это не большая языковая модель и не задача с огромным окном контекста. Для такой задачи нет необходимости использовать модель на сотни миллионов параметров.
Мы сравнили:
наивный прогноз
скользящее среднее
Dense
LSTM
GRU
Transformer
и выбрали подход по фактическому качеству обнаружения перегрузок.
В нашем эксперименте GRU немного опередила остальные варианты.
Но это не означает, что GRU должна использоваться всегда.
Если на другой инфраструктуре скользящее среднее даст почти тот же экономический результат, именно оно может оказаться лучшим инженерным решением: меньше зависимостей, проще эксплуатация, быстрее диагностика и практически нулевая стоимость вычислений.
Сложность модели оправдана только тогда, когда она даёт измеримый дополнительный эффект.
Что получает бизнес
Если убрать названия моделей и библиотек, весь контур сводится к следующей последовательности:
1. собираем телеметрию

2. оцениваем нагрузку на 30 минут вперёд

3. определяем цену лишнего масштабирования

4. определяем цену пропущенной перегрузки

5. выбираем порог упреждающей реакции

6. контролируем фактический выигрыш во времени

7. сохраняем обычное автоматическое масштабирование как резерв
В нашем эксперименте:
GRU:

MAE               7.61
RMSE              9.80
precision@80      0.793
recall@80         0.830

38% будущих перегрузок
ещё не видны обычному пороговому мониторингу
в момент формирования прогноза

surprise_recall GRU:
≈ 0.85

рабочий порог решения:
примерно 70–80%
в зависимости от стоимости FN/FP
Главный вывод здесь не в том, что GRU оказалась немного лучше LSTM.
Он в другом:
прогноз загрузки становится полезной инфраструктурной функцией только тогда, когда его можно выразить в дополнительном времени на реакцию, стоимости лишней мощности и стоимости пропущенной перегрузки.
Поэтому промышленный контур состоит не только из модели. В него входят воспроизводимость экспериментов, сбор телеметрии, правила принятия решений, контроль качества и резервное автоматическое масштабирование.
На другой инфраструктуре лучшая модель может измениться.
Критерий останется тем же:
даёт ли прогноз достаточно времени, чтобы защитить доступность сервиса дешевле и надёжнее, чем одно только реактивное масштабирование?
Словарь
-
AzurePublicDatasetV1 — публичные трассы нагрузки Azure, включая измерения CPU.
-
Кубический сплайн — кубическая интерполяция; в статье показан как численный вариант, в эксперименте для коротких пропусков использована линейная интерполяция.
-
LSTM / GRU — рекуррентные нейросетевые слои для последовательностей.
-
Transformer — архитектура на механизме внимания.
-
Precision — какая доля тревог оказалась правильной.
-
Recall — какую долю реальных перегрузок удалось заметить.
-
surprise_recall — доля будущих перегрузок типа
surprise overload, обнаруженных заранее. -
MLflow Tracking — хранение параметров, метрик и артефактов экспериментов.
-
DataSphere Node — вариант развёртывания модели или Docker-образа как сервиса вывода.
-
Managed Service for Prometheus — совместимый с Prometheus мониторинг в Yandex Cloud.
References
Cho, K., van Merriënboer, B., Gulcehre, C., Bahdanau, D., Bougares, F., Schwenk, H. and Bengio, Y. (2014) ‘Learning Phrase Representations using RNN Encoder–Decoder for Statistical Machine Translation’. arXiv preprint arXiv:1406.1078. Available at: https://arxiv.org/abs/1406.1078 [11] (Accessed: 24 September 2026).
Cortez, E., Bonde, A., Muzio, A., Russinovich, M., Fontoura, M. and Bianchini, R. (2017) ‘Resource Central: Understanding and Predicting Workloads for Improved Resource Management in Large Cloud Platforms’, in Proceedings of the 26th Symposium on Operating Systems Principles (SOSP ’17). Dataset: AzurePublicDataset. Available at: https://github.com/Azure/AzurePublicDataset [12] (Accessed: 24 September 2026).
Hochreiter, S. and Schmidhuber, J. (1997) ‘Long Short-Term Memory’, Neural Computation, 9(8), pp. 1735–1780.
Keras (2026a) LSTM layer. Available at: https://keras.io/api/layers/recurrent_layers/lstm/ [13] (Accessed: 24 September 2026).
Keras (2026b) GRU layer. Available at: https://keras.io/api/layers/recurrent_layers/gru/ [14] (Accessed: 24 September 2026).
MLflow (2026) MLflow Tracking. Available at: https://mlflow.org/docs/latest/tracking.html [15] (Accessed: 24 September 2026).
SciPy (2026) scipy.interpolate.CubicSpline. Available at: https://docs.scipy.org/doc/scipy/reference/generated/scipy.interpolate.CubicSpline.html [16] (Accessed: 24 September 2026).
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A.N., Kaiser, Ł. and Polosukhin, I. (2017) ‘Attention Is All You Need’, in Advances in Neural Information Processing Systems (NeurIPS). Available at: https://papers.nips.cc/paper/7181-attention-is-all-you-need [17] (Accessed: 24 September 2026).
Virtanen, P., Gommers, R., Oliphant, T.E., Haberland, M., Reddy, T., Cournapeau, D., Burovski, E., Peterson, P., Weckesser, W., Bright, J., van der Walt, S.J., Brett, M., Wilson, J., Millman, K.J., Mayorov, N., Nelson, A.R.J., Jones, E., Kern, R., Larson, E., Carey, C.J., Polat, İ., Feng, Y., Moore, E.W., VanderPlas, J., Laxalde, D., Perktold, J., Cimrman, R., Henriksen, I., Quintero, E.A., Harris, C.R., Archibald, A.M., Ribeiro, A.H., Pedregosa, F., van Mulbregt, P. and SciPy 1.0 Contributors (2020) ‘SciPy 1.0: fundamental algorithms for scientific computing in Python’, Nature Methods, 17, pp. 261–272.
Yandex Cloud (2026a) Creating an MLflow server for logging experiments and artifacts. Available at: https://yandex.cloud/ru/docs/datasphere/tutorials/mlflow-datasphere [18] (Accessed: 24 September 2026).
Yandex Cloud (2026b) DataSphere: creating a node. Available at: https://yandex.cloud/ru/docs/datasphere/operations/deploy/node-create [19] (Accessed: 24 September 2026).
Yandex Cloud (2026c) Creating an inference service from an ONNX model. Available at: https://yandex.cloud/ru/docs/datasphere/tutorials/node-from-model [20] (Accessed: 24 September 2026).
Yandex Cloud (2026d) Managed Service for Prometheus. Available at: https://yandex.cloud/ru/docs/monitoring/operations/prometheus/ [21] (Accessed: 24 September 2026).
Автор: fuwiak
Источник [22]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/35991
URLs in this post:
[1] реакцию: http://www.braintools.ru/article/1549
[2] памятью: http://www.braintools.ru/article/4140
[3] внимания: http://www.braintools.ru/article/7595
[4] ошибка: http://www.braintools.ru/article/4192
[5] обучения: http://www.braintools.ru/article/5125
[6] интерес: http://www.braintools.ru/article/4220
[7] поведение: http://www.braintools.ru/article/9372
[8] математика: http://www.braintools.ru/article/7620
[9] поведения: http://www.braintools.ru/article/5593
[10] зрения: http://www.braintools.ru/article/6238
[11] https://arxiv.org/abs/1406.1078: https://arxiv.org/abs/1406.1078
[12] https://github.com/Azure/AzurePublicDataset: https://github.com/Azure/AzurePublicDataset
[13] https://keras.io/api/layers/recurrent_layers/lstm/: https://keras.io/api/layers/recurrent_layers/lstm/
[14] https://keras.io/api/layers/recurrent_layers/gru/: https://keras.io/api/layers/recurrent_layers/gru/
[15] https://mlflow.org/docs/latest/tracking.html: https://mlflow.org/docs/latest/tracking.html
[16] https://docs.scipy.org/doc/scipy/reference/generated/scipy.interpolate.CubicSpline.html: https://docs.scipy.org/doc/scipy/reference/generated/scipy.interpolate.CubicSpline.html
[17] https://papers.nips.cc/paper/7181-attention-is-all-you-need: https://papers.nips.cc/paper/7181-attention-is-all-you-need
[18] https://yandex.cloud/ru/docs/datasphere/tutorials/mlflow-datasphere: https://yandex.cloud/ru/docs/datasphere/tutorials/mlflow-datasphere
[19] https://yandex.cloud/ru/docs/datasphere/operations/deploy/node-create: https://yandex.cloud/ru/docs/datasphere/operations/deploy/node-create
[20] https://yandex.cloud/ru/docs/datasphere/tutorials/node-from-model: https://yandex.cloud/ru/docs/datasphere/tutorials/node-from-model
[21] https://yandex.cloud/ru/docs/monitoring/operations/prometheus/: https://yandex.cloud/ru/docs/monitoring/operations/prometheus/
[22] Источник: https://habr.com/ru/articles/1085920/?utm_campaign=1085920&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.