Как мы научили LLMCOD собирать базу знаний не только из HTML, но и из SPA и открытых API
Обычно задача «создать базу знаний из сайта» звучит просто: взять HTML, извлечь текст, разбить его на фрагменты, построить embeddings и отправить всё в RAG.
На современных сайтах этот подход всё чаще перестаёт работать.
Главная причина — сайт может практически не содержать данных в исходном HTML. Пользователь открывает страницу, браузер загружает JavaScript, JavaScript обращается к API, а уже API возвращает услуги, товары, объекты, статьи, цены и другие данные.
Именно с такой проблемой мы столкнулись при разработке новой возможности в LLMCOD.
Теперь система умеет работать не только с обычными страницами, но и с SPA-сайтами и доступными открытыми API.
В этой статье расскажу, как мы это сделали, какие проблемы встретили по дороге и почему одного vector search для такой задачи оказалось недостаточно.
С чего всё началось
У нас уже существовал механизм создания базы знаний из сайта.
Классический сценарий выглядел примерно так: URL сайта ↓ HTTP GET ↓ HTML ↓ извлечение текста ↓ chunks ↓ embeddings ↓ RAG
Для обычного корпоративного сайта этого достаточно.
Но при проверке одного из реальных сайтов мы получили: HTTP 200 HTML ≈ 4.7 KB текст в HTML = 0
При этом в браузере сайт был полностью заполнен:
-
объектами недвижимости;
-
услугами;
-
статьями;
-
ипотечными программами;
-
командами;
-
видео;
-
другими разделами.
То есть проблема была не в том, что сайт пустой.
Проблема была в том, что данные находились не в HTML.
Мы перестали смотреть только на HTML
Вместо попытки заставить старый парсер работать со SPA мы пошли другим путём.
Новая схема стала такой: HTML ↓ определяем SPA ↓ ищем JavaScript ↓ анализируем JS ↓ находим API-маршруты ↓ проверяем API ↓ получаем JSON ↓ нормализуем данные ↓ создаём chunks ↓ embeddings ↓ RAG
При этом старую механику site-preview мы сознательно не стали переделывать.
Новый механизм был сделан отдельным контуром.
Это оказалось важным архитектурным решением: новая функция развивается независимо, а старые клиенты и существующая логика [1] продолжают работать как раньше.
Шаг 1. Анализ сайта
Мы добавили отдельный диагностический endpoint: POST /api/widget-admin/clients/{client_id}/knowledge/site-analyze
Его задача — не импортировать данные, а сначала понять, что вообще находится за URL.
Система проверяет:
-
корректность URL;
-
безопасность адреса;
-
DNS;
-
возможность SSRF;
-
HTTP-ответ;
-
redirects;
-
тип страницы;
-
наличие JavaScript;
-
потенциальные API-маршруты;
-
ответы этих API;
-
типы содержащихся данных.
Это позволяет сначала получить картину сайта, а уже потом решать, что действительно стоит импортировать.
Почему отдельно пришлось заниматься SSRF
Как только сервер начинает самостоятельно запрашивать URL, появляется очевидная проблема безопасности.
Нельзя просто сделать: requests.get(user_url)
и считать задачу решённой.
Пользовательский URL — это потенциальная точка для SSRF.
Поэтому в новой логике мы отдельно проверяем адрес и запрещаем запросы к внутренним ресурсам.
Дополнительно контролируем redirect, чтобы безопасный исходный URL не превратился после перенаправления во внутренний адрес.
Для нас это было обязательной частью архитектуры, а не дополнительной оптимизацией.
Отдельная проблема — IDN и кириллические домены
Тестовый сайт использовал кириллический домен.
Для браузера это выглядит нормально: https://квартирка-64.рф/ [2]
Но сетевые библиотеки и DNS на разных этапах работают с Punycode.
Поэтому мы добавили канонизацию URL и нормальную работу с IDN.
Это небольшой технический момент, который легко не заметить на тестовом сервере, но потом он превращается в очень неприятный production-баг.
Шаг 2. Ищем API в JavaScript
После определения SPA нам нужно было понять, куда приложение ходит за данными.
Мы анализируем загруженные JavaScript-файлы и извлекаем потенциальные API-маршруты.
Для тестового сайта нашли десятки маршрутов /api/….
После проверки выяснилось, что часть из них возвращает реальные бизнес-данные, а часть является техническими, служебными или требует дополнительных условий.
Поэтому мы не импортируем всё подряд.
Шаг 3. Система сначала анализирует, человек выбирает
Это один из важных моментов нашей реализации.
После анализа сайт не отправляется автоматически целиком в базу знаний.
В админке появилась отдельная кнопка:
«🔬 Анализ сайта»
После анализа показываются найденные API.
Для каждого API система определяет:
-
работает ли он;
-
какой тип данных возвращает;
-
подходит ли он для RAG;
-
сколько объектов найдено.
Для RAG-кандидатов появились checkbox.
То есть оператор сам выбирает, что импортировать.
Это решает сразу две задачи:
-
не тащить в базу технические endpoint;
-
сохранить человеку контроль над содержимым базы знаний.
На реальном сайте получилось 10 источников
После анализа один из сайтов дал 10 пригодных источников: /api/blog /api/complexes /api/custom-pages /api/mortgage/banks /api/mortgage/programs /api/properties /api/services /api/team /api/videos /api/workflow-steps
Всего после обработки мы получили: 163 RAG chunks 163 embeddings 10 API-источников
Но здесь началась следующая интересная часть.
JSON сам по себе в RAG не очень удобен
API возвращает структурированные данные.
Например, объект недвижимости может содержать: { “id”: 16458, “type”: “apartment”, “rooms”: 3, “area”: 61.9, “address”: “Трнавская улица,63А”, “price”: 6000000 }
Для RAG нам удобнее нормализовать это в текстовый документ: Тип: Объект недвижимости Название: 3-комн. квартира, 61.9 м², Трнавская улица,63А Тип: apartment Категория: secondary Статус: sale Город: Балаково Адрес: Трнавская улица,63А Цена: 6000000 Площадь: 61.9 Комнаты: 3 … Источник API: /api/properties Источник URL: …
Теперь embeddings и текстовый поиск могут работать с этим материалом значительно удобнее.
Мы добавили метаданные источника
Для каждого объекта сохраняем: source_type source_api source_id source_url
Например: source_type = property source_api = /api/properties source_id = 16458
Это даёт несколько преимуществ.
Можно понять, откуда пришёл ответ.
Можно удалить или заменить конкретный источник.
Можно фильтровать поиск по типу данных.
Можно отличить новые API-данные от старых карточек и FAQ.
И главное — появляется нормальная модель для дальнейшего развития RAG.
Pagination тоже оказалась обязательной
Нельзя предполагать, что API всегда возвращает все данные одним запросом.
Например: /api/blog?page=1 /api/blog?page=2 /api/blog?page=3 …
Поэтому импортёр умеет обрабатывать pagination.
Мы поддержали:
-
next_page_url;
-
current_page;
-
last_page.
При этом поставили ограничения:
-
до 20 страниц;
-
до 300 объектов;
-
до 600 000 символов.
То есть импорт не может бесконтрольно съесть память [3] и трафик.
Самый неприятный баг был связан с chunks
Допустим, одна статья слишком длинная.
Она превращается в: article id=100 chunk 1 article id=100 chunk 2
У обоих chunks должен оставаться один: source_id = 100
И здесь мы поймали очень интересную ошибку [4].
Сначала replace-механизм удалял предыдущий объект по source_id перед вставкой следующего.
В результате: chunk 1 ↓ insert chunk 2 ↓ delete source_id=100 ↓ insert chunk 2
и в базе оставался только последний chunk.
Исправили архитектуру.
Теперь replacement работает так: удалить весь source один раз ↓ вставить все его chunks
После исправления тест дал: 2 chunks 1 source_id 2 embeddings 2 rows
Теперь длинный документ сохраняется правильно.
Только embeddings оказалось недостаточно
После первого импорта мы запустили RAG.
И увидели типичную проблему семантического поиска.
Запрос:
Покупка недвижимости
мог вернуть:
Выкуп недвижимости
вместо услуги:
Покупка недвижимости
Почему?
Потому что для embedding-модели это семантически очень близкие фразы.
С объектами недвижимости ситуация была ещё заметнее.
Запрос:
3-комн. квартира, 61.9 м², Трнавская улица,63А
не гарантировал, что нужный объект будет первым.
Для человека адрес и площадь практически уникальны.
Для чистого vector search — совсем не обязательно.
Поэтому мы добавили PostgreSQL FTS
Мы протестировали текстовый поиск через PostgreSQL: ts_rank_cd( to_tsvector(‘russian’, content), plainto_tsquery(‘russian’, query) )
И получили очень хороший результат для точных запросов.
Например: Покупка недвижимости ↓ service id=158
Адрес: 3-комн. квартира, 61.9 м², Трнавская улица,63А ↓ property id=16458
Налоговый вычет: Налоговый вычет при покупке недвижимости в 2026 году ↓ article id=100
То есть стало понятно:
vector search хорошо ищет по смыслу, FTS хорошо ищет точные сущности.
Мы попробовали RRF — и тоже нашли проблему
Следующей попыткой был Reciprocal Rank Fusion.
Идея простая: vector rank + lexical rank = общий rank
Но появилась новая проблема.
Старые legacy FAQ-записи иногда попадали слишком высоко.
Например, вопрос:
3-комн. квартира, 61.9 м²…
мог приводить к старому FAQ про аренду квартиры.
Формально это был «релевантный по теме» текст.
Но фактически он совершенно не отвечал на вопрос про конкретный объект.
Поэтому появился отдельный boost для названия
Мы добавили ещё один сигнал: exact title
Если пользователь спрашивает:
Покупка недвижимости
и в документе есть: Название: Покупка недвижимости
такой документ получает сильный дополнительный вес.
То же самое работает для объекта и статьи.
Для запроса:
3-комн. квартира, 61.9 м², Трнавская улица,63А
точное название сразу поднимает нужный: property id=16458
А для:
Налоговый вычет при покупке недвижимости в 2026 году
вверх поднимается: article id=100
В итоге RAG стал гибридным
Финальная схема поиска сейчас выглядит примерно так: ┌── Vector search ──┐ Query ────────────┤ ├── кандидаты └── Russian FTS ────┘ ↓ объединение ↓ анализ “Название” ↓ ранжирование ↓ topK
При этом сохраняется fallback:
если RAG падает, основной запрос не должен падать вместе с ним.
Это важная production-практика:
ошибка базы знаний не должна превращаться в ошибку самого чата.
Мы проверяли не только функцию, но и production endpoint
После изменения lib/rag.ts мы сначала протестировали функцию напрямую.
Получили: Покупка недвижимости → service 158 3-комн. квартира… → property 16458 Налоговый вычет… → article 100
После этого пересобрали Next.js без опасного prisma db push и перезапустили production.
Затем повторили тест уже через HTTP: POST /api/internal/rag-retrieve
И production endpoint вернул те же правильные документы.
То есть мы проверяли не только код, а весь путь: HTTP ↓ Next.js ↓ retrieveContext() ↓ PostgreSQL ↓ RAG
Отдельно важно было не сломать существующий проект
При работе над этой функцией мы сознательно разделили старый и новый workflow.
Старый: site-preview
не трогали.
Новый: site-analyze site-api-import
работает отдельно.
Это позволяет постепенно развивать новый механизм, не ломая существующих клиентов.
Что в итоге умеет LLMCOD
Сейчас архитектура выглядит так: САЙТ │ │ HTML/SSR SPA │ │ JavaScript │ │ Open API │ ↓ SITE ANALYZER ↓ найденные источники ↓ выбор оператором ↓ API IMPORTER ↓ нормализация ↓ metadata ↓ chunks ↓ embeddings ↓ hybrid RAG ↓ ИИ-ответ
То есть для современного сайта теперь не обязательно, чтобы вся информация находилась непосредственно в HTML.
Почему это полезно именно для бизнеса
Для интернет-магазина это могут быть:
-
товары;
-
цены;
-
категории;
-
характеристики;
-
наличие;
-
условия доставки.
Для недвижимости:
-
объекты;
-
цены;
-
адреса;
-
площади;
-
количество комнат;
-
комплексы;
-
ипотечные программы.
Для сервисного бизнеса:
-
услуги;
-
тарифы;
-
условия;
-
сотрудники;
-
FAQ;
-
расписание.
Причём данные могут приходить не из видимого HTML, а из API, которое использует frontend.
Что пока сознательно ограничено
Новая возможность работает только с открытыми публичными данными.
Закрытые кабинеты, административные панели и API с авторизацией не импортируются.
Это важно и с точки зрения [5] безопасности, и с точки зрения архитектуры продукта.
Также пока нет непрерывной автоматической синхронизации.
После существенных изменений сайта базу можно обновить повторным импортом.
Что будем улучшать дальше
Следующий очевидный этап — сделать RAG ещё более aware относительно типов источников.
Например, для запроса:
какая квартира стоит 6 млн на Трнавской?
система должна понимать, что искать прежде всего нужно среди: property
а не среди: article service legacy FAQ
Следующий шаг — ещё лучше использовать metadata: source_type source_api source_id address price area rooms
И отдельно развивать импорт detail endpoint для тех API, где список объектов содержит только краткие данные.
Главное, что мы поняли
Главная проблема автоматического создания базы знаний из сайта сегодня уже не сводится к вопросу:
«Как распарсить HTML?»
Гораздо правильнее задавать вопрос:
«Откуда frontend получает реальные данные?»
Если сайт — SPA, HTML может быть практически пустым.
Но это не означает, что данные недоступны.
Часто они просто находятся на следующем уровне: JavaScript → API → JSON
И если научить систему безопасно находить этот уровень, а затем нормализовать данные для RAG, можно превратить современное веб-приложение в полноценный источник знаний для ИИ.
Именно этот подход мы сейчас реализовали в LLMCOD.
Что делать пользователю
Новая возможность уже работает, но пока не выведена отдельной кнопкой в личном кабинете для всех пользователей.
Чтобы подключить импорт данных из SPA и открытых API, нужно отправить запрос в LLMCOD или поставить галочку при подключении
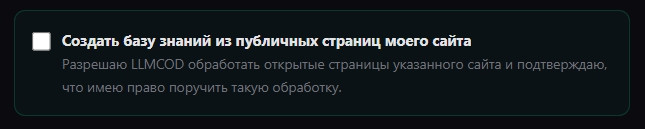
В запросе достаточно указать адрес сайта и написать, что требуется:
«Импорт базы знаний из SPA / открытых API».
Автор: llmcod
Источник [6]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/35996
URLs in this post:
[1] логика: http://www.braintools.ru/article/7640
[2] https://квартирка-64.рф/: https://%D0%BA%D0%B2%D0%B0%D1%80%D1%82%D0%B8%D1%80%D0%BA%D0%B0-64.%D1%80%D1%84/
[3] память: http://www.braintools.ru/article/4140
[4] ошибку: http://www.braintools.ru/article/4192
[5] зрения: http://www.braintools.ru/article/6238
[6] Источник: https://habr.com/ru/articles/1086396/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1086396
Нажмите здесь для печати.