Отчет о посещении конференции «Управление данными 2026»
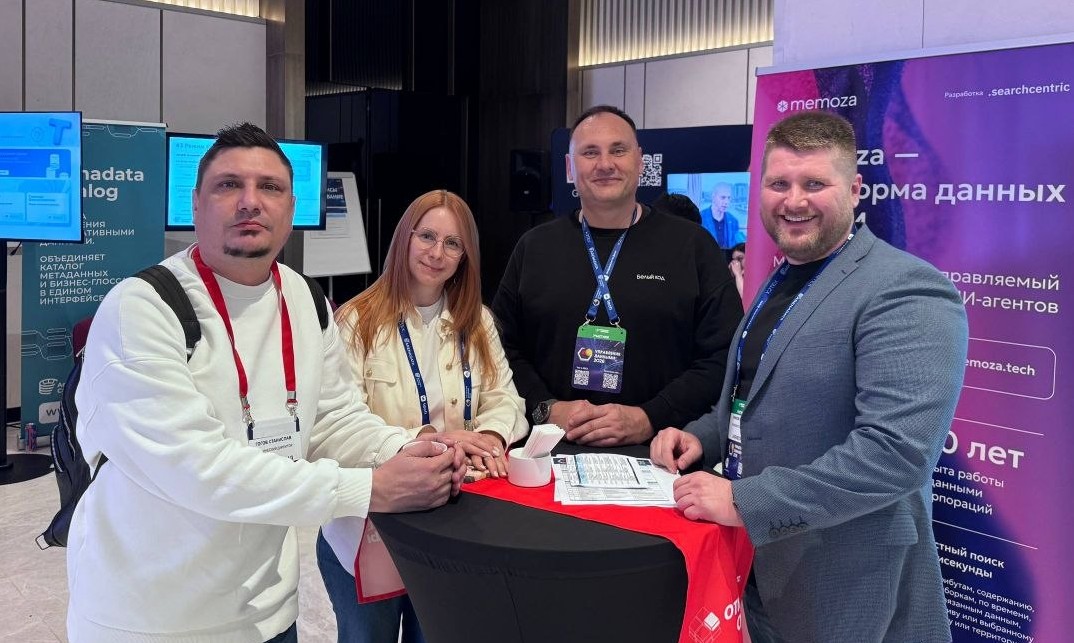
На связи Сергей Скирдин, технический директор ИТ-интегратора «Белый код». Вчера был на форуме «Управление данными 2026» от «Открытых систем». Это уже XI форум, посвящённый управлению данными, архитектуре, качеству данных и применению ИИ в корпоративной среде. В этом году тема ИИ ожидаемо проходила практически через всю программу: как готовить данные для агентов, какой должна быть архитектура, зачем бизнесу семантика и как вообще управлять всем этим хозяйством.
Из терминов, которые звучали особенно часто:
КМД (Корпоративная Модель Данных) — согласованное описание ключевых сущностей предприятия, их атрибутов и взаимосвязей: что такое клиент, договор, продукт, подразделение и т. д. По сути, попытка договориться о едином языке данных на уровне компании.
Семантический слой — слой между физическими данными и их потребителями, который переводит технические таблицы, поля и источники в понятные бизнесу сущности, показатели и связи.
MDM (Master Data Management) — управление мастер-данными, то есть ключевыми справочными сущностями предприятия: клиентами, контрагентами, товарами, материалами, организациями и т. п. Задача MDM — обеспечить единое, качественное и согласованное представление этих объектов во всех системах.
Онтология — формальное описание понятий предметной области, их смысла, типов отношений и правил взаимодействия. Если КМД в первую очередь отвечает на вопрос «какие у нас сущности и данные», то онтология идёт дальше и пытается зафиксировать, что именно эти сущности означают и как они связаны между собой.
Граф знаний / граф связей — представление информации в виде объектов и отношений между ними. Например: «сотрудник → работает в → подразделении → отвечает за → продукт → продаётся клиенту». Такая структура хорошо подходит для поиска контекста и навигации по связанным знаниям, в том числе для ИИ-агентов.
При этом часть выступлений была довольно водянистой. Тезис «чтобы ИИ-агент давал правильные ответы, нужно сначала привести в порядок данные» звучал в разных вариантах много раз. Спасибо, капитан, это мы примерно знали и до конференции.
С удовольствием послушал архитектурный баттл «Оптимальная для ИИ архитектура управления данными». Сам формат с обсуждением разных подходов оказался полезнее обычных презентаций: участники говорили не только о том, что нужно построить, но и о цене, сложности и реальной применимости этих идей. В программе форума этот баттл как раз был заявлен как обсуждение выбора архитектуры с учётом задач компании, её зрелости и организационной структуры.
Для себя записал несколько вещей.
Во-первых, при внедрении ИИ-агентов нужно заранее думать о том, как дебажить неверные ответы. Нужно понимать, какие данные он использовал, какой контекст получил, какие связи и правила применил и где именно произошла ошибка [1].
Во-вторых, важно следить не только за формальным качеством данных, но и за их адекватностью бизнес-контексту. Аналитик, который десять лет работает внутри компании, многое понимает неявно. Для него очевидно, что один показатель нельзя сравнивать с другим или что конкретное значение нужно трактовать особым образом. Агент этого не знает, пока мы явно не передали ему этот контекст.
И, пожалуй, главный вывод для меня связан с семантикой, онтологиями и графами знаний.
Это потенциально очень дорогие проекты. Можно потратить годы на попытку описать всё предприятие, но совершенно не факт, что затраты когда-нибудь окупятся. На баттле участники в какой-то момент фактически пришли к тому, что интересно будет вернуться к этому разговору через год и посмотреть, какие из сегодняшних подходов действительно дали бизнес-эффект.
Мне видится рациональным такой путь: сначала определить конкретную задачу, которую должен решать агент, а затем описывать только те сущности, связи, термины и правила, которые нужны ему в этой предметной области. Не пытаться сразу построить онтологию всего предприятия ради самой онтологии, а расширять модель по мере появления новых практических задач.
Отдельно отмечу выступление Алины Романовской из Т-Банка про контроль ИИ-агентов в клиентской поддержке. Она как раз отвечает за автоматизацию поддержки на базе ИИ-агентов. Я сам пользуюсь Т-Банком и считаю их поддержку одной из наиболее адекватных, поэтому было особенно интересно посмотреть, как это устроено изнутри.
Из её выступления сохранил слайд с простыми правилами для базы знаний:
-
Фрагмент должен быть самодостаточным.
-
Заголовок должен формулироваться как вопрос пользователя.
-
Термины нужно раскрывать непосредственно в тексте.
-
Таблицы желательно дублировать текстовым описанием.
-
База знаний должна версионироваться так же, как код.
Особенно ценно, что это не теория, а рекомендации, выработанные на практике.
После конференции у меня осталось ощущение, что индустрия сейчас находится в интересной точке. Все уже поняли, что просто подключить LLM к корпоративным данным недостаточно. Следующий этап — научить машины понимать смысл этих данных. Но здесь есть риск построить очередной огромный инфраструктурный проект ради красивой архитектурной картинки.
Много говорят о том, что компаниям нужен семантический слой, КМД, онтология и граф знаний. А кто-нибудь уже пробовал посчитать их окупаемость? Сколько стоит всё это построить и поддерживать и какой измеримый эффект должен вернуть эти инвестиции?
Автор: SergeySkirdin
Источник [2]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36025
URLs in this post:
[1] ошибка: http://www.braintools.ru/article/4192
[2] Источник: https://habr.com/ru/companies/w_code/articles/1086544/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1086544
Нажмите здесь для печати.