Теория возможностей заменит теорию вероятностей в ML?
Современные генеративные модели используют мощный аппарат теории вероятностей: байесовскую оптимизацию, оценки максимального правдоподобия и тп. Но у этого подхода есть свои недостатки, например, галлюцинации, с которыми, наверняка, большинство сталкивалось при работе с ИИ.
Проведем обзор не новой, но набирающей популярность теории возможностей и ее использования в машинном обучении [1]. Для этого проанализируем доклад профессора Наньянского технологического (Сингапур) и Уорикского университетов (Великобритания) Jeremie Houssineau.
Начнем с примера, демонстрирующего, как в космонавтике и теории рисков отличают две неопределенности: алеаторную (случайную) и эпистемическую (связанную с нехваткой знаний).
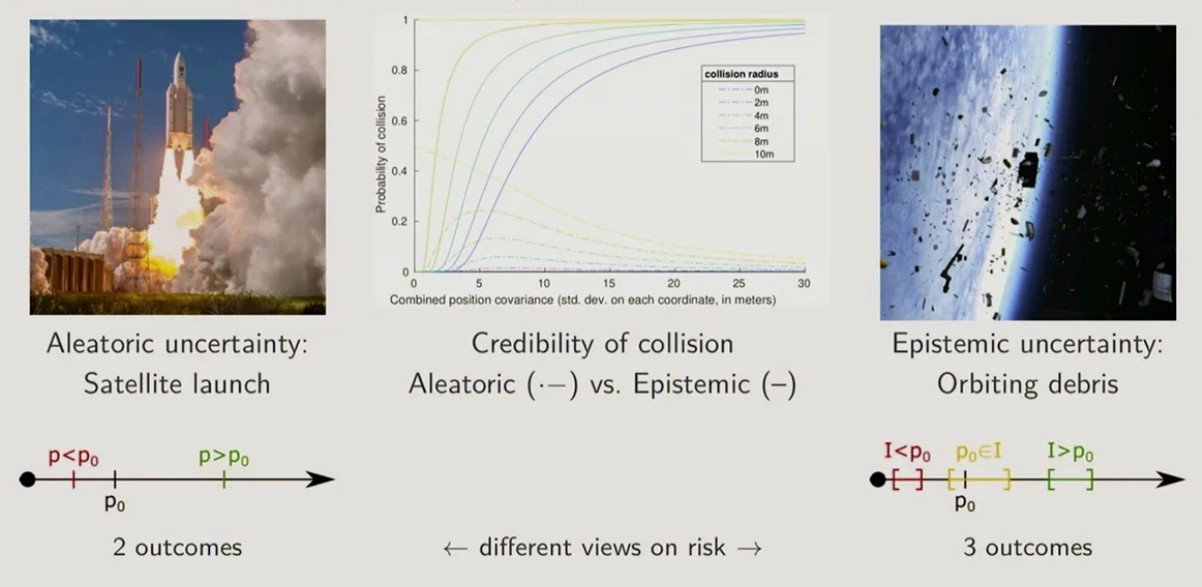
Поломка ракеты при запуске – это бинарное событие: даже зная все о ракете и ее траектории, мы не можем со 100%-ной уверенностью сказать, произойдет ли авария. Поэтому 2 исхода с порогом вероятности  .
Справа находится пример эпистемической неопределенности: космический мусор на орбите. Мы не знаем, где находится каждый объект, его скорость или массу, поэтому не можем сказать, прилетит ли он в МКС. Так появляется третья зона (желтая).
График по центру отвечает за вероятность столкновения в зависимости от точности данных (ковариации позиции). Разные цвета обозначают разные размеры обломков. Пунктиром отмечена алеаторная неопределенность, т.е. игнорирование отсутствия информации и использование только физической случайности [2]. Вероятность здесь низкая и убывает. Сплошной линией – эпистимическая и здесь вероятность столкновения высокая: чем меньше знаем, тем больше риск, причем по мере уточнения данных вероятность падает, что логично [3].
Таким образом, мы приходим к концепции: “Если нет информации, возможно все”. Немного формализуем задачу и заодно отметим различия с теорией вероятностей.
|
|
Теория вероятностей |
Теория возможностей |
|
исследуемый параметр |
случайная величина |
неопределенная переменная (uncertain variable) |
|
основная функция |
плотность распределения и нормировка через интеграл |
possibility function |
|
“среднее” |
математическое ожидание через интеграл плотности |
|
|
дисперсия |
|
|


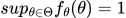
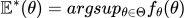
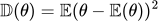
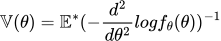
Особый случай: если нет информации, считаем  для любого
 . Также одним из интересных свойств является независимость от параметризации (в отличие от появляющегося якобиана при замене в плотности), это объясняется очень просто: если мы ничего не знаем в одном пространстве, то ничего не знаем и в другом.
Продолжим анализ свойств функций возможностей и сравнение с аппаратом теории вероятностей.
|
|
Теория вероятностей |
Теория возможностей |
|
работа с выборками |
можно сэмплировать |
нельзя сэмплировать |
|
inference |
условная вероятность |
|
|
независимость величин |
независимость событий |
|
|
факторизация |
при независимости случайных величин совместная плотность представляется в виде произведения единственным образом. |
при независимости разложение совместного распределения на множители не является единственно возможным. |
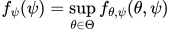
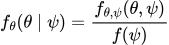
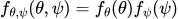
Теорема Байеса
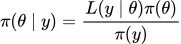 , где:
 – правдоподобие,
 – априорная вероятность,
 – апостериорная вероятность и знаменатель вычисляется как:
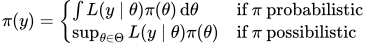
Вероятностная часть была известна уже давно, а возможностная была представлена [4] в 2026 году.
Рассмотрим еще один относительно свежий результат (2025 года). В теории вероятностей формула Донскера-Варадхана связывает математическое ожидание экспоненты случайной величины с относительной энтропией (KL-дивергенцией) и в машинном обучении используется для поиска верхних границ вероятности переобучения нейросетей. Ученые из Наньянского технологического университета представили [5] аналог этой теоремы для теории возможностей. Главное отличие в том, что во втором случае мы получаем две формулы, это объясняется тем, что, в отличие от теории вероятностей, у нас нет жесткого ограничения на плотность распределения (интеграл = 1), поэтому приближать можно по-разному (см. график). То есть на множестве функций возможностей можно ввести частичный порядок.
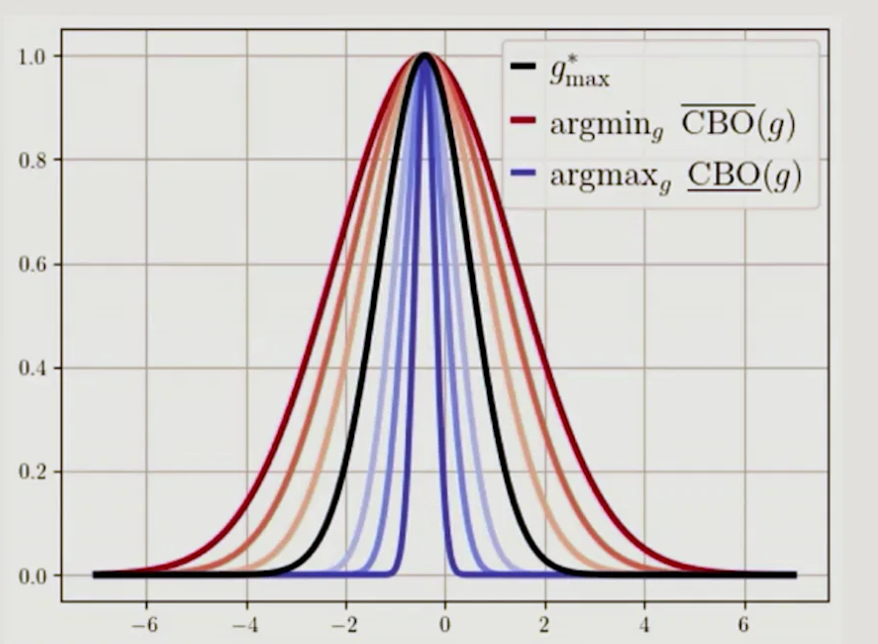
Комментарий к графику:
CBO(g) – аналог ELBO в байесовском выводе, но для теории возможностей.
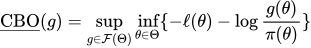
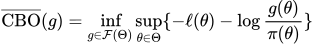


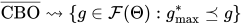
Также под теорию возможностей было адаптировано “ядро” обучения – градиентный спуск. Ниже приводится алгоритм upper CBO Optimisation (uCBOpt):
-
 скорости обучения
 , коэффициент затухания весов
 , параметр кривизны
![vartheta in (0, delta]](https://www.braintools.ru/images/2026/09/27/teoriya-vozmojnostei-zamenit-teoriyu-veroyatnostei-v-ML-32.svg "Теория возможностей заменит теорию вероятностей в ML? - 32") , параметры момента
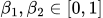 , и начальное значение гессиана
 .
-
 (веса нейросети),
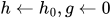 .
-

-
 – Стохастический градиент
-

-
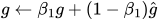
-
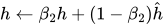
-
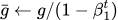
-
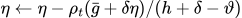
-
-

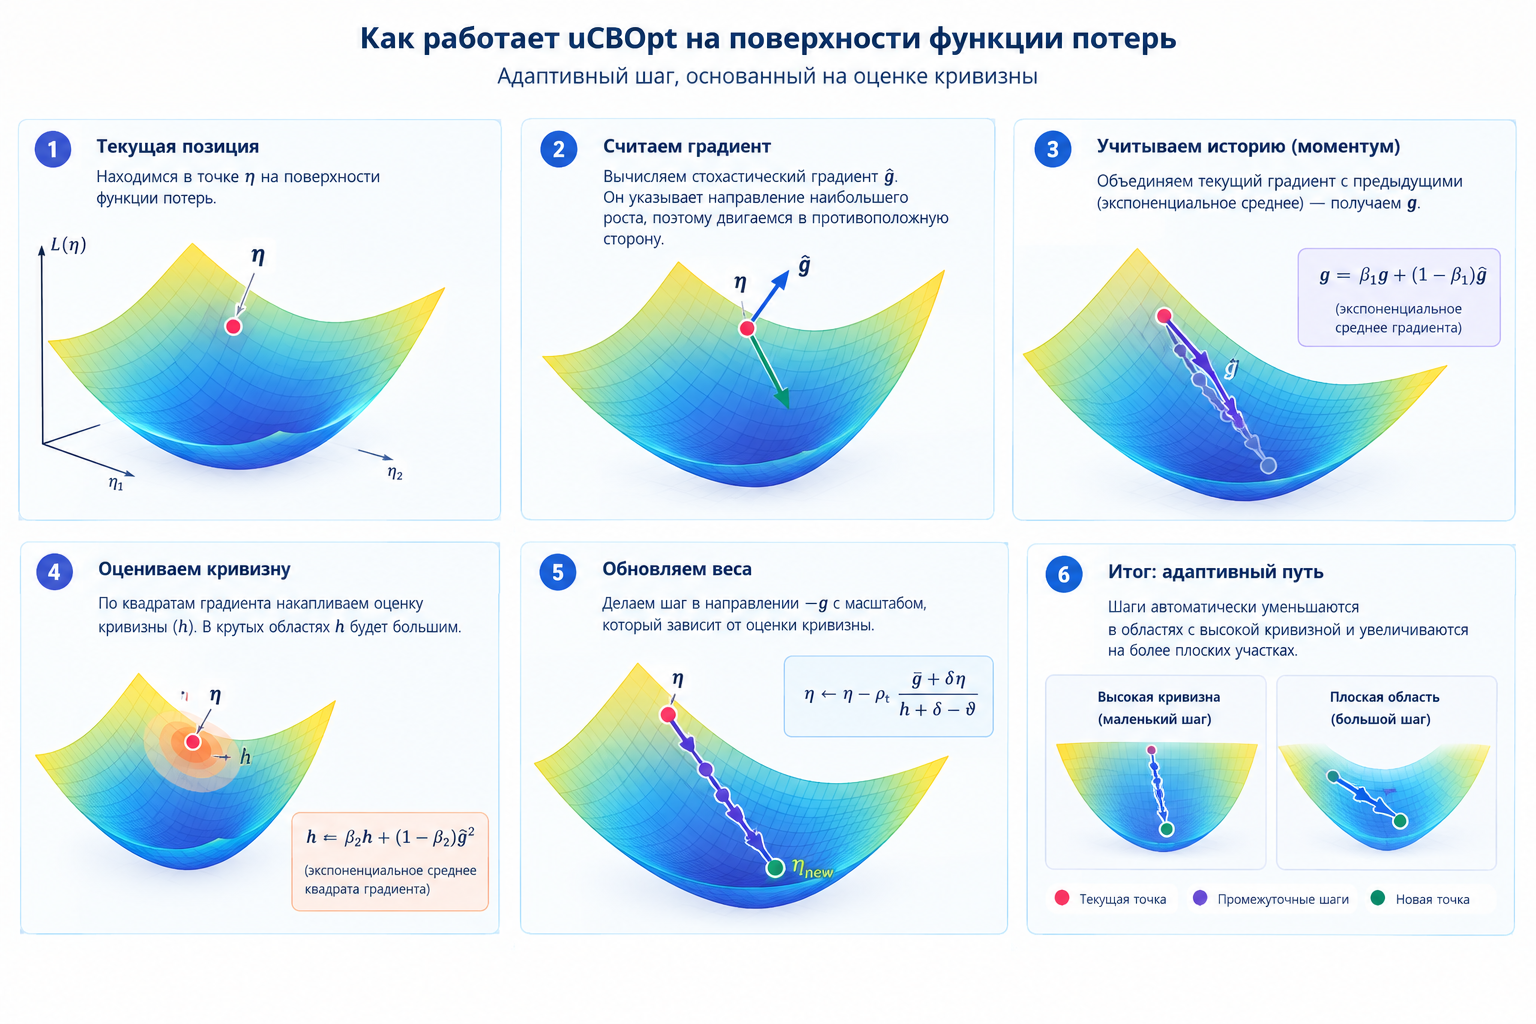
Сравнение с Adam:
|
Adam |
uCBOpt |
|---|---|
|
|
|
|
деление на |
деление на |
|
|
|
|
нет weight decay в формуле шага |
|
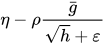
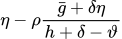


Встраивание weight decay напрямую в обновление позволяет лучше контролировать регуляризацию.
Также авторами была приведена [6]сравнительная таблицу для разных датасетов.
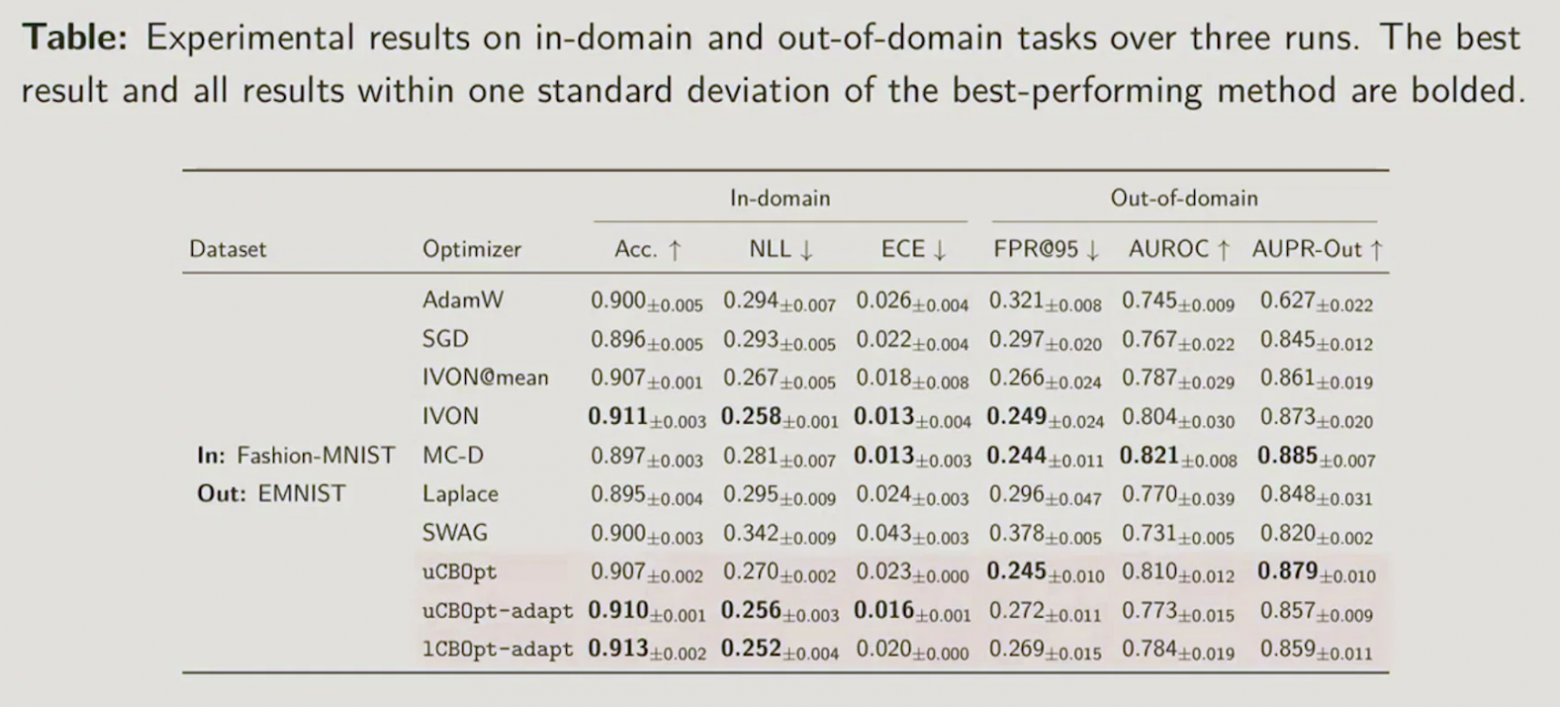
Сравнение проводилось на данных, которые модель видела во время обучения, и на незнакомых. В качестве метрик были выбраны: Accuracy, Negative Log-Likelihood, Expected Calibration Error, False Positive Rate at 95% True Positive Rate, Area Under the Receiver Operating Characteristic curve, Area Under the Precision-Recall curve for Out-of-domain. Рассмотрим результаты для нового алгоритма подробнее.
In-domain.
Доля правильных ответов (точность) на “знакомой” выборке выше относительно остальных. Низкое отрицательное лог. правдоподобие означает, что модель не просто угадывает класс, но и выдает высокую вероятность для правильного класса и низкую для неправильных. Ожидаемая ошибка [7] калибровки измеряет разницу между уверенностью модели и её реальной точностью, низкий результат у uCBOpt-adapt (алгоритм выше с адаптацией гиперпараметров в процессе обучения).
Метрики говорит о том, что когда информация есть, теория возможностей работает не хуже теории вероятностей: uCBOpt-adapt показывает лучшие результаты по ключевым метрикам
Out-of-domain.
FPR@95 для детекции аномалий: показывает, как часто модель ошибочно принимает “незнакомый” объект за “знакомый”, когда мы настроены на то, чтобы поймать 95% всех аномалий, один из новых алгоритмов оказался в топе лучших. AUPR-Out, альтернатива AUROC, которая лучше работает в условиях сильного дисбаланса классов. Она показывает, насколько хорошо модель находит “чужие” объекты, не ошибаясь при этом на “своих”.
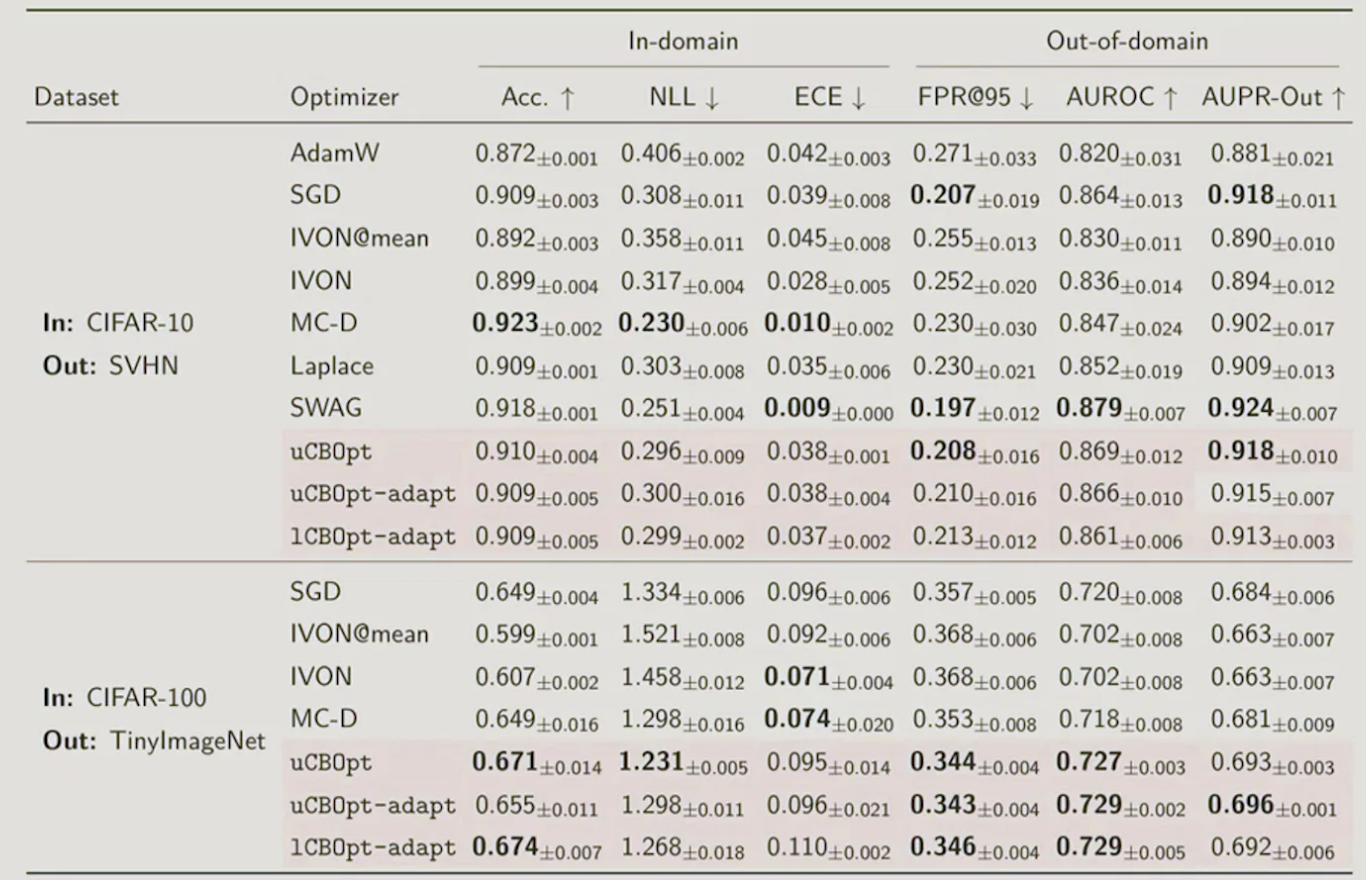
Также авторами для сравнения были использованы и другие датасеты: CIFAR-10, CIFAR-100. Таблица приводится ниже, для краткости, без анализа.
Заключение
Таким образом, теория возможностей предлагает альтернативный подход к описанию неопределенности. Повторяя некоторые аспекты теории вероятностей (независимость, теорема Байеса), она меняет общее представление об информации. Теория вероятностей в машинном обучении является фундаментом, имеет удобный аппарат для описания большинства процессов, поэтому неудивительно, что для теория возможностей доказываются аналоги теорем. Появление приведенного алгоритма и построение новой теории является примером непрерывного развития науки. Так машинное обучение помогает двигать вперед математику [8], а не только отбирает ее хлеб.
Автор: Ir1na
Источник [9]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36102
URLs in this post:
[1] обучении: http://www.braintools.ru/article/5125
[2] случайности: http://www.braintools.ru/article/6560
[3] логично: http://www.braintools.ru/article/7640
[4] была представлена: https://arxiv.org/pdf/2607.08019
[5] представили: https://arxiv.org/pdf/2511.21223
[6] была приведена : https://icml.cc/virtual/2026/84050
[7] ошибка: http://www.braintools.ru/article/4192
[8] математику: http://www.braintools.ru/article/7620
[9] Источник: https://habr.com/ru/articles/1087094/?utm_source=habrahabr&utm_medium=rss&utm_campaign=1087094
Нажмите здесь для печати.