Модель предлагает, код решает: проверяемые бизнес-решения на Python с маленькими моделями
Коротко. Если спросить языковую модель «одобрить возврат?», она вернёт ответ и вероятность. Правила, которое гарантированно выполнится, доказательства, которые можно проверить, и записи, которую можно воспроизвести через полгода, она не вернёт. solvi [1] — открытая библиотека на Python (Apache-2.0), которая делит работу пополам: модели предлагают факты (цитату из документа, выбор из списка), обычный код их проверяет и считает ответ, а каждый шаг попадает в след, сцеплённый хешами. В версии 0.5.0 контрактом стали типы Python: аннотации описывают факты, вопросы и виды ответов, включая «в тексте не сказано», точный фрагмент текста и цитату-довод. Ниже — пример с настоящим кодом и настоящим выводом, цифры, три обучаемых компонента, которые проиграли простому коду, и ограничения.
Я автор solvi.
Как я к этому пришёл и что пытался решить
Начинал я вообще с другого: проверял, дают ли нейросетям реальное преимущество гиперкомплексные числа — кватернионы, октонионы и то, что выше. Честный ответ оказался скромным: только там, где задачу покрывает точный закон, например композиция поворотов. В остальном «настоящая» алгебра работала не лучше подделки. Самым полезным оказалась не сама алгебра, а вычисляемая часть рядом с обучаемой: она знает, когда сети не стоит верить.
Потом я смотрел на «решающие модели», которые напрямую отвечают на типизированные вопросы: закрытую Jev и её открытый аналог Laya. Они быстрые, но нельзя проверить, почему они ответили именно так, они могут перебить правило и выдумать число или цитату. А мне нужно было другое: решения в бизнес-процессах, которые обязаны соблюдать жёсткие правила, объясняться аудитору и не галлюцинировать. Отсюда и устройство solvi: модель только предлагает, код проверяет и решает, а весь путь записан в след, который можно воспроизвести. Дальше — о том, как это выглядит на практике.
Почему не стоит отдавать решение модели целиком
Большая часть решений внутри компании мелкие и частые: одобрить авансовый отчёт, отправить обращение в нужную очередь, оплатить счёт, заморозить аккаунт. У них три общих свойства.
-
Часть правил не обсуждается. Заявке на возврат старше 30 дней — отказ. Угроза судом — в юротдел. Счёт, который не сходится с заказом, не оплачивается.
-
Кто-то спросит «почему». Аудитор, регулятор, клиент или коллега, который разбирает спорный случай.
-
Большая часть ответа — арифметика. Сумма в пределах лимита, доставка была 12 дней назад, переводы в сумме чуть-чуть не дотягивают до порога обязательного контроля.
Модель, которая отвечает на такие вопросы напрямую, слаба во всех трёх пунктах. Правило можно написать в промпте, но вероятность всё равно может его перебить. В одном из наших сравнений модели, которая просто отвечает на вопросы, прямо сказали: угроза судом — высокий приоритет и очередь legal. На обращении со словом «юрист» она ответила «очередь: billing» (0.94) и «приоритет: normal» (0.49). Она может сослаться на то, чего в документе нет. Числа она «считает» по сходству, поэтому они выходят примерно правильными. А когда через месяц спрашиваешь, почему она что-то одобрила, в ответ снова получаешь вероятность.
Проверка вывода по JSON-схеме помогает с формой ответа, но не с его опорой на документ. Идеально оформленный {"approve": true, "evidence": "Total: 488.60"} всё равно неверен, если в документе написано 48.60.
Как вы сейчас проверяете, что LLM не выдумала сумму? Сверяете регуляркой, просите вторую модель перепроверить или просто верите? Мне правда интересно, какой способ прижился у вас, — напишите в комментариях.
Идея: модель предлагает, код решает
Принцип solvi умещается в одну строку: модель предлагает, детерминированный код решает, всё записано в след.
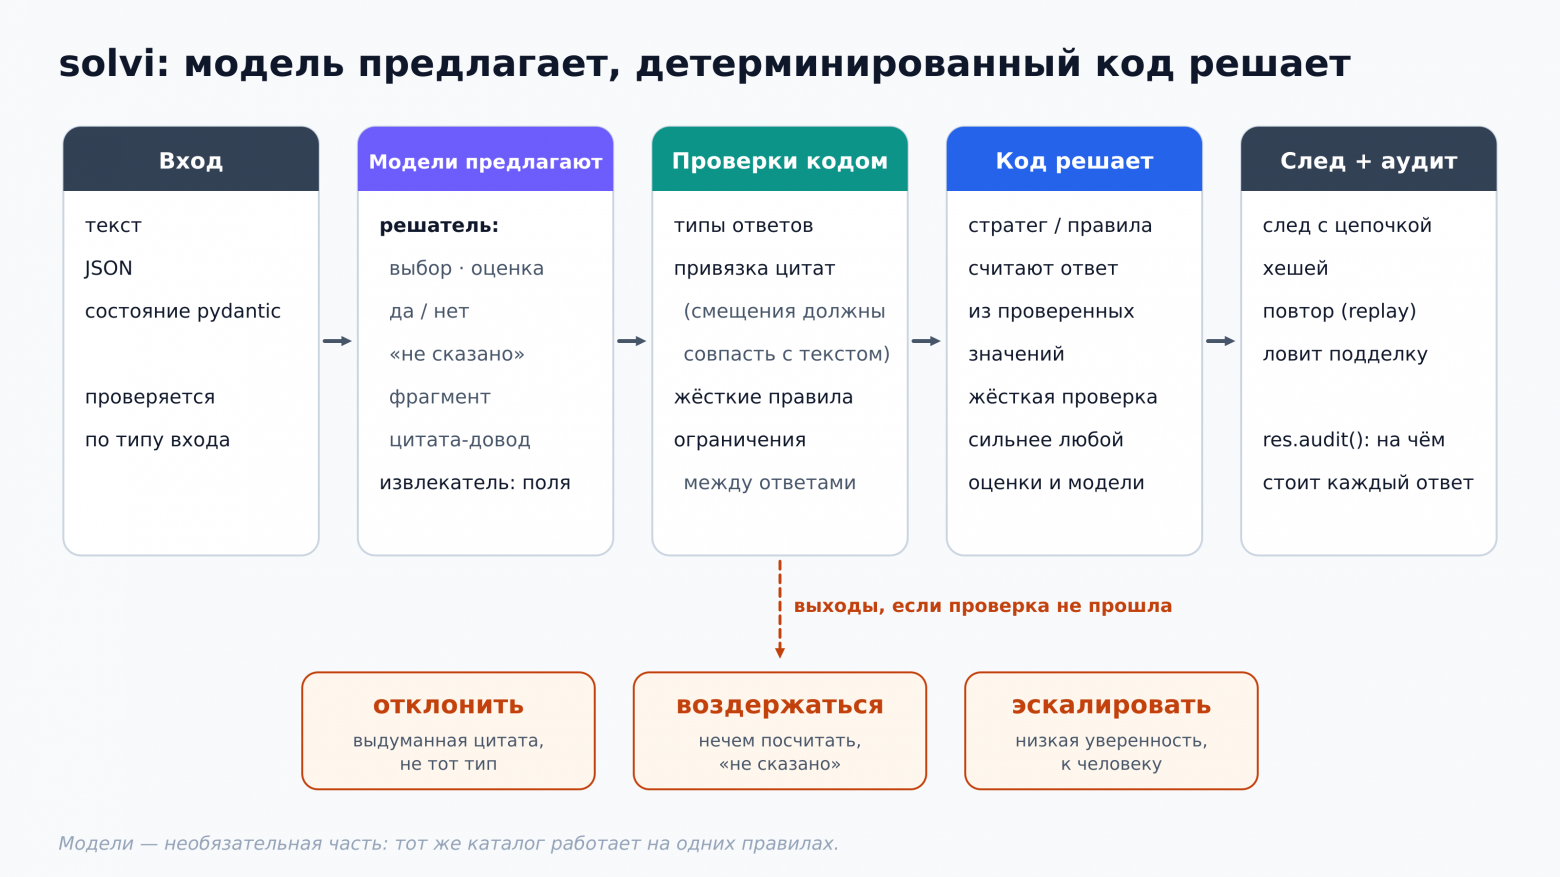
Задача описывается каталогом обычных функций Python:
-
@cat.fn— вычисление (refund_amount,days_since_delivery); -
@cat.check— проверка «да/нет», мягкая или жёсткая. Проваленная жёсткая проверка сама задаёт ответ, и ничто её не перебьёт; -
@cat.extract— значение, найденное в тексте; возвращается какQuoteсо смещениями символов; -
@cat.rule(question)— правило, которое выдаёт типизированный ответ.
Сигнатура функции — это её контракт: имена аргументов — факты, которые она читает, имя функции — факт, который она задаёт. Дальше вы задаёте типизированные вопросы: да/нет, выбор из списка, порядковая шкала, набор меток, а с 0.5.0 ещё «не сказано», точный фрагмент текста, ранжирование и число с интервалом. Ответов свободным текстом нет.
На каждый запрос стратег идёт от заданных вопросов назад по сигнатурам и исполняет только то, что нужно. Жёсткие проверки идут первыми; если одна провалилась, шаги, нужные только уже решённым вопросам, пропускаются. Независимые медленные части — вызовы API, инференс моделей — идут параллельно.
У каждого факта есть происхождение:
|
вид |
откуда значение |
что держит его честным |
|---|---|---|
|
|
из запроса |
хеш входа — в начале следа |
|
|
обычная функция |
при повторе её пересчитывают и сравнивают |
|
|
извлекатель |
цитата обязана быть текстом ровно по своим смещениям |
|
|
выбор модели среди объявленных вариантов |
значение обязано быть одним из вариантов |
|
|
обученная голова или выученный список правил |
записан отпечаток модели |
Прежде чем что-то использует вывод модели, он проходит защиты:
-
цитата модели, которая не совпадает буквально с
doc[start:end], отклоняется (grounding); -
выбор вне объявленных вариантов отклоняется (closed set);
-
при низкой уверенности вопрос воздерживается и говорит, что ответил бы;
-
значение, которое не проходит свою аннотацию типа, отклоняется (type rejected, новое в 0.5.0);
-
жёсткая проверка решает независимо от любой уверенности.
Отклонённый факт просто отсутствует: запускается следующий производитель из цепочки запасных или зависимые ответы воздерживаются. Каждое событие считается и видно в аудите.
Пример: авансовый отчёт, который решают дважды
Возьмём авансовый отчёт за такси и решим его одним каталогом дважды: сначала только кодом, потом с моделями за двумя его частями. Модели здесь — маленькие заглушки, чтобы пример запускался без torch; настоящий извлекатель на ModernBERT записывается в след точно так же. Полный скрипт — examples/12_grounded_audit.py в репозитории.
CLAIM = """Expense claim #2291
Vendor: City Taxi Ltd
Taxi from the airport to the client office, 14 km.
Total: 48.60 EUR
"""

def build(extractor=None, classifier=None):
    cat = Catalog()

    def regex_total(doc):
        m = re.search(r"Total:s*([0-9]+.[0-9]{2})", doc)
        if m is None:
            raise ValueError("no total in the document")
        return Quote(m.group(1), m.start(1), m.end(1))

    if extractor is None:                    # без модели: сумму находит только регулярка
        @cat.extract
        def total(doc):
            return regex_total(doc)
    else:                                    # сначала модель, регулярка — запасной вариант
        cat.extract(extractor.field("total_model", r"Total:s*([0-9.,]+)"), provides="total")

        @cat.extract(provides="total")
        def total_regex(doc):
            return regex_total(doc)

    if classifier is not None:
        @cat.fn(model=classifier, options=CATEGORIES)
        def category(doc):
            p = classifier.predict(doc)
            best = max(p, key=p.get)
            return Decision("luxury" if classifier.rogue else best, p)
    else:
        @cat.fn
        def category(doc):
            low = doc.lower()
            return max(CATEGORIES, key=lambda c: sum(low.count(w) for w in KEYWORDS[c]))

    @cat.fn
    def amount(total):
        return float(total.replace(",", ""))

    @cat.check(hard=True, then={"approve": "no"})
    def amount_positive(amount):
        return amount > 0

    @cat.rule("approve")
    def approve(amount, category, limit):
        return amount <= limit[category]

    @cat.rule("category")
    def category_answer(category):
        return category

    return cat

QUESTIONS = [Question("approve", "Approve the claim?", Answer.yes_no(), checkpoints=["amount_positive"]),
             Question("category", "Expense category", Answer.choice(CATEGORIES), min_confidence=0.5)]
С моделями за total и category вызов print(res.audit()) для одобрения выглядит так:
overall: confidence 0.36, weakest approve 0.60; 2/2 answered
approve = 'yes'  [ok]  confidence 0.60  ← computed by approve
  given       doc = 'Expense claim #2291nVendor: C…; limit = {'travel': 100, 'meals': 60, 'e…
  computed    amount = 48.6
  quoted      total = '48.60'  doc[100:105] literal '48.60'  confidence 0.93  [StandInExtractor demo/extract-total #3d7febfb]
  decided     category = 'travel'  (travel 0.60, meals 0.20, equipment 0.20)  [StandInClassifier demo/expense-category #bb3352d4]
  check       amount_positive = True (hard)
  rule        approve (computed)
  → answer    'yes' — amount = 48.6; category = 'travel'; limit = {'travel': 100, 'meals': 60, 'equipment': 800}
  support     7 items (2 given, 3 computed, 1 quoted by model, 1 decided): 71% deterministic, 2 from models
  safeguards  none fired
Тот же каталог без моделей пишет 100% deterministic. Правила, жёсткая проверка и вопросы одни и те же; меняется только происхождение фактов.
Теперь извлекатель галлюцинирует: возвращает 488.60 с правдоподобными смещениями.
approve = 'yes'  [ok]  confidence 0.60  ← computed by approve
  quoted      total = '48.60'  doc[100:105] literal '48.60'
  ...
  safeguards  grounding rejected ×1, fallback producer ×1
              · grounding rejected: total — total_model: not grounded: '488.60' is not the text at [100:105] ('48.60')
              · fallback producer: total — total_regex used after total_model rejected
Выдуманное значение до правила не доходит, настоящее подставляет запасная регулярка. Дальше классификатор отвечает luxury — категорией, которую никто не объявлял:
category = '—'  [abstain]  confidence 0.00
  decided     category: REJECTED — decision 'luxury' is outside the options ['travel', 'meals', 'equipment']
  → answer    '—' — rule not computed: missing inputs: category; missing category
  safeguards  outside the options ×1
Двусмысленный отчёт («Lunch with the client, taxi back to the office.») получает travel 0.40, meals 0.40 — ниже min_confidence вопроса:
category = '—'  [abstain]  confidence 0.40  ← computed by category_answer
  → answer    '—' — low confidence 0.40 < 0.5; would have answered 'travel' (category = 'travel')
Обратите внимание [2]: система не просто молчит, а говорит, что ответила бы. Такой случай удобно отправлять человеку — у него сразу есть черновик.
Наконец, извлекатель переобучили уже после того, как решение было принято. Повтор старого решения это замечает:
replay of decision 2: False [(1, 'total', 'model changed since this decision: demo/extract-total #3d7febfb2bda3e6d was used,
                              the catalog now has #3abd2fee27f66827')]
За всё время работы system.safeguard_report() считает, что было поймано:
asks 5, answers 7, abstained 3, model outputs 10
  grounding rejected     1
  outside the options    1
  low confidence         1
  fallback producer      1
  ...
Вот что здесь значит «опора на документ». Модель от этого лучше не становится. Зато неверный вывод модели либо ловится до того, как станет ответом, либо виден в аудите — и никогда молча не становится ответом.
След сцеплён хешами в порядке исполнения. replay заново исполняет каждый шаг по записанным входам и называет шаг, который изменили, даже если злоумышленник пересчитал хеши. На 1 000 чистых следах ложных тревог не было, а 500/500 наивных и 500/500 согласованных по хешам подмен пойманы с указанием изменённого шага. Одно ограничение описано в документации: след, честно построенный заново по другому входу, согласован сам с собой. Чтобы поймать такое, сравнивайте хеш входа в следе с квитанцией, опубликованной где-то ещё.
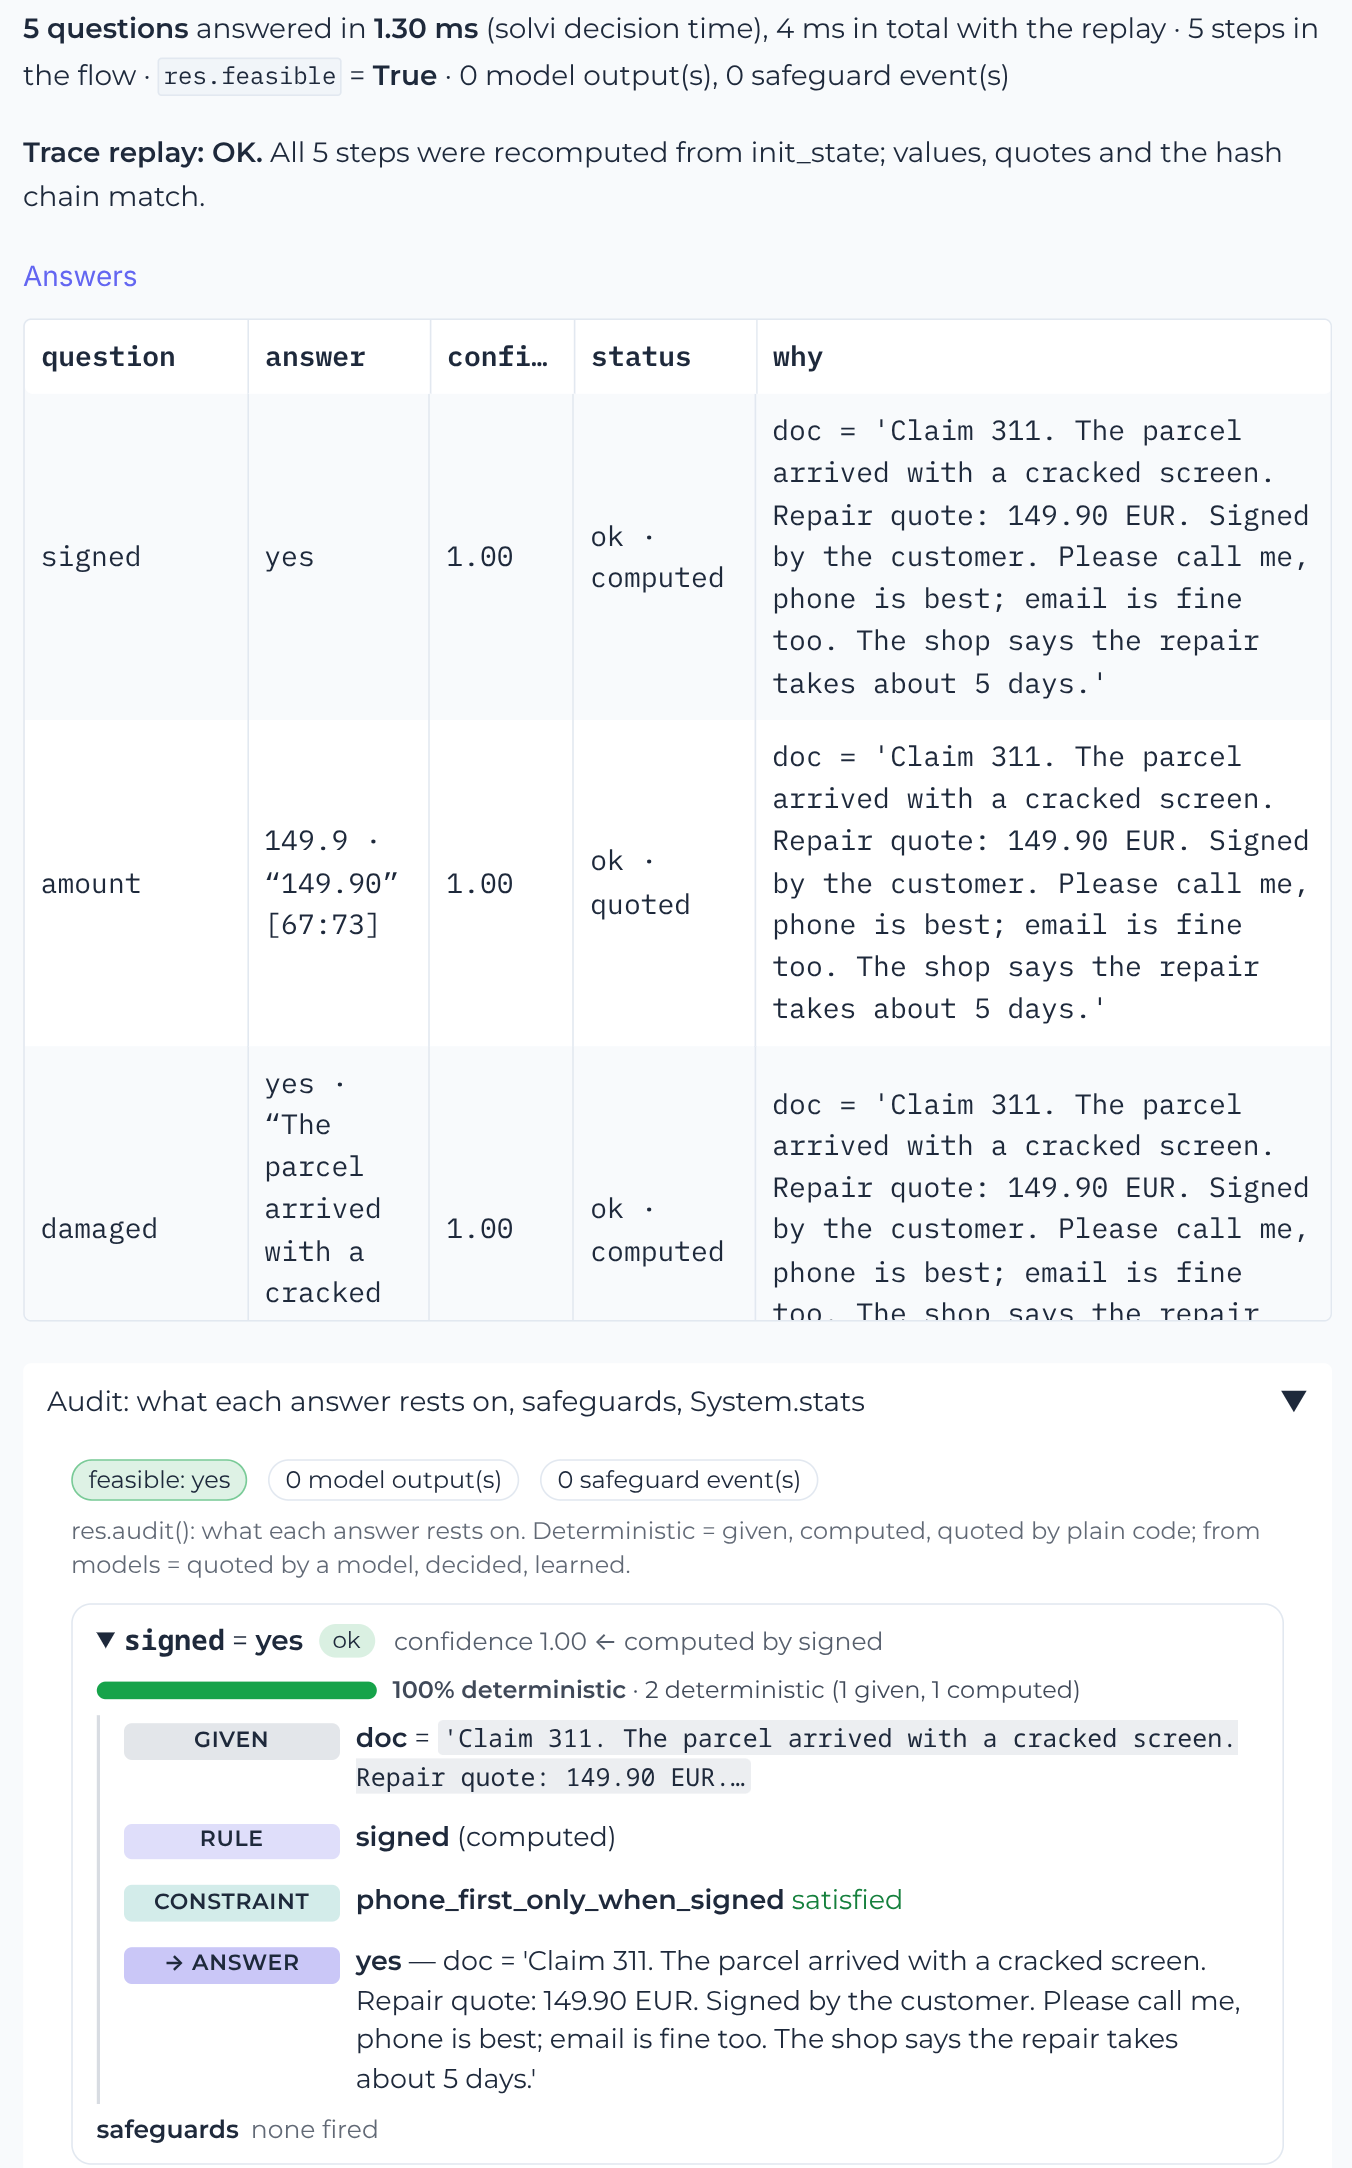
Песочница работает прямо в браузере: пресет «New in 0.5 · Answer primitives», ответы, повтор и аудит.
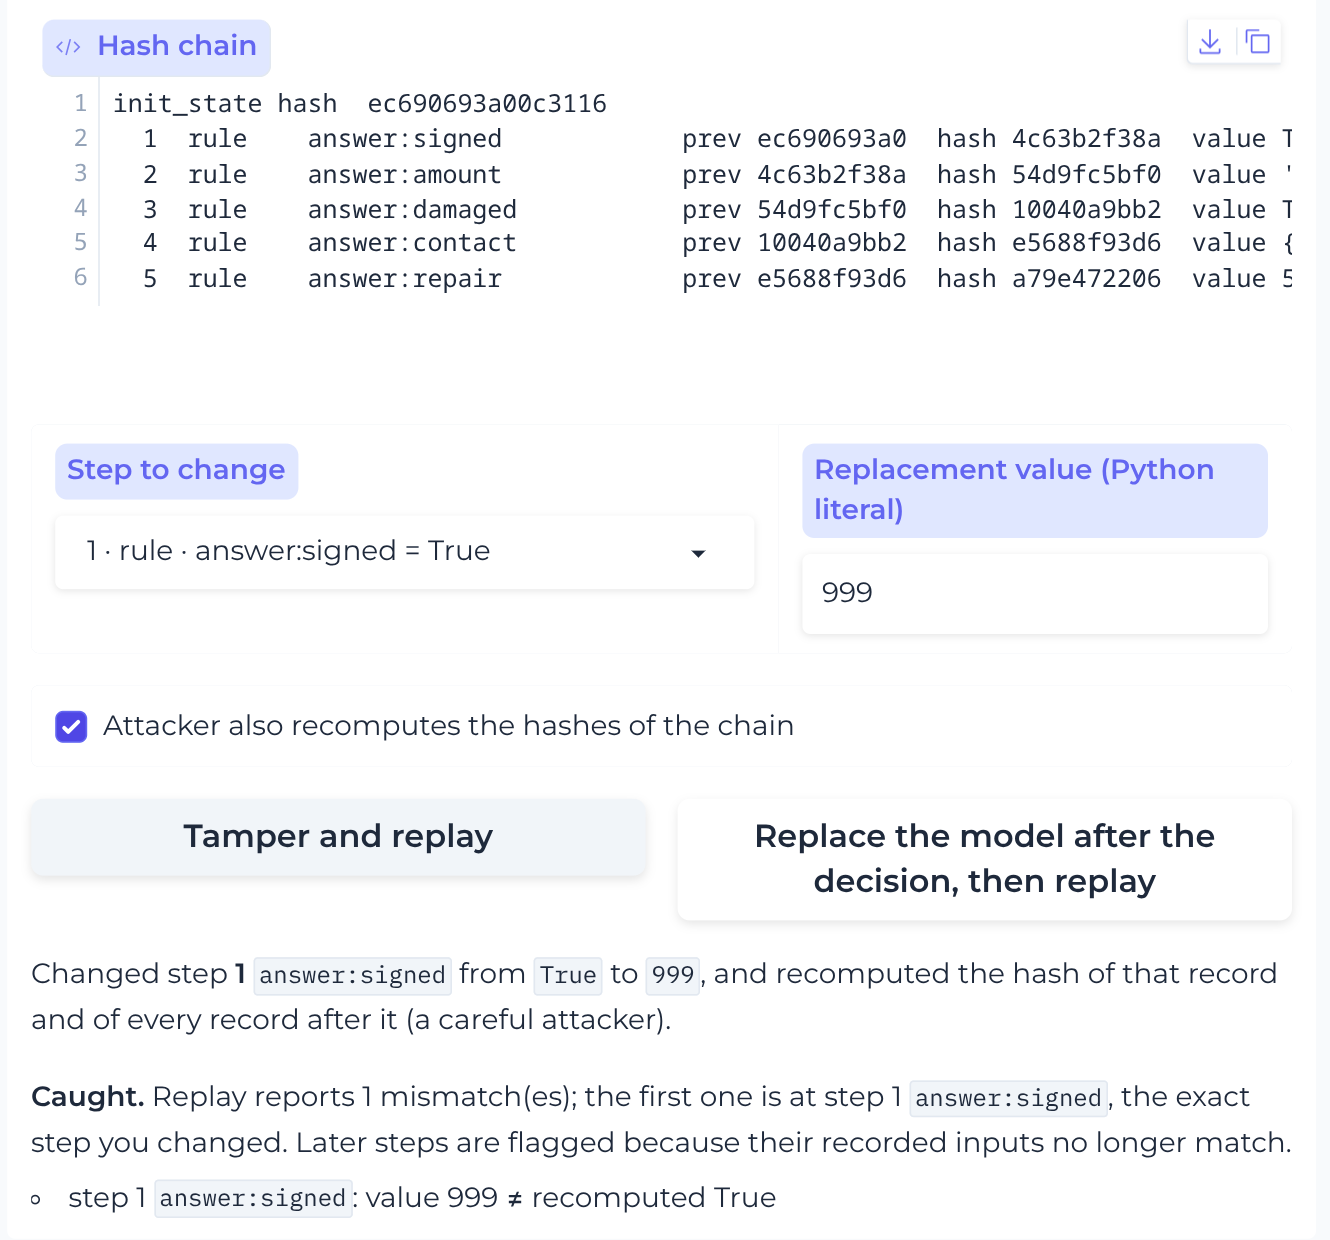
Там же можно попробовать подделать след самому: поменять значение, пересчитать хеши и посмотреть, где повтор это заметит.
Типизированные вопросы в 0.5.0
В 0.5.0 контрактом стали аннотации типов. Тип возврата правила — это тип ответа на его вопрос, а модель pydantic — это вход. Пример из разбора обращений в поддержку:
class Ticket(BaseModel):
    message: str
    tier: Literal["free", "pro", "vip"]
    waiting_hours: float

@cat.rule("route")
def route(refund_ask: bool, message: str) -> Literal["billing", "tech_support", "general", "legal"]: ...

@cat.rule("priority")
def priority(time_pressure: bool, anger: bool, tier: str) -> Scale[Literal["low", "normal", "high"]]: ...

@cat.rule("order_id")
def order_id(message: str) -> Maybe[Span[str]]:
    m = re.search(r"borders+#?(d{4,})", message, re.I)
    return Quote(m.group(1), m.start(1), m.end(1), source="message") if m else Unknown   # в обращении не сказано
Maybe[Span[str]] означает: ответ — точный кусок сообщения (смещения проверяются) или «не сказано». Это настоящий ответ с уверенностью. Он не равен «нет» и не равен воздержанию, когда solvi отказывается отвечать. Разница важна: «клиент не указал номер заказа» и «я не смог понять, указал ли он» ведут к разным действиям.
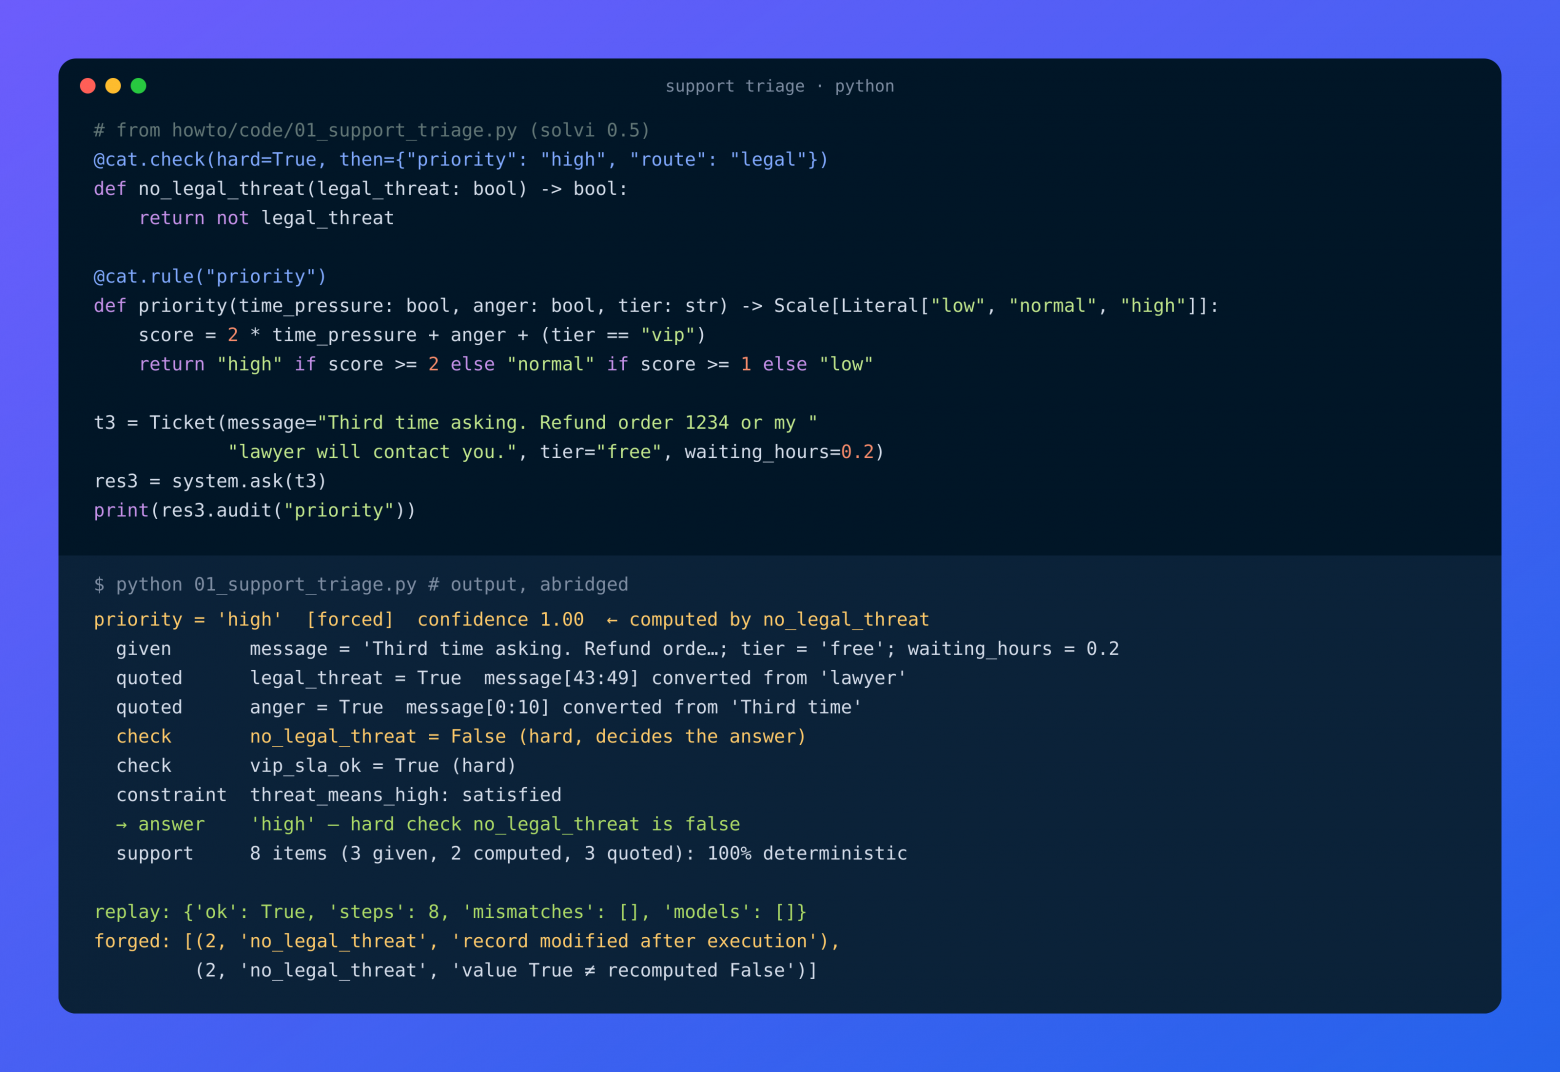
На обращении с угрозой юристом приоритет решает жёсткая проверка, и аудит это показывает:
priority = 'high'  [forced]  confidence 1.00  ← computed by no_legal_threat
  quoted      legal_threat = True  message[43:49] converted from 'lawyer'
  quoted      anger = True  message[0:10] converted from 'Third time'
  check       no_legal_threat = False (hard, decides the answer)
  constraint  threat_means_high: satisfied
  support     8 items (3 given, 2 computed, 3 quoted): 100% deterministic
  safeguards  hard check decided ×1
Уверенность у всех видов ответов значит одно и то же: вероятность, что ответ в таком виде верен. Поэтому у ответа целиком есть одна общая уверенность — произведение по отвеченным вопросам — и самый слабый вопрос. Несовпадение типов между двумя функциями падает сразу при регистрации второй. Значение, которое не прошло свой тип во время исполнения, отклоняется так же, как выдуманная цитата: запускается следующий производитель или ответ воздерживается.
Те же типы объявляют вопросы и для модели. Поля модели pydantic становятся вопросами к решателю (decider). Он отвечает на них по тексту или по состоянию в JSON, у каждого ответа — калиброванная уверенность и сигнал «действовать / эскалировать». Эскалированный ответ воздерживается и говорит, что ответил бы, — его можно отдать человеку.
Где для вас проходит граница: что модель может решить сама, а что — только правило? У нас, например, «угроза судом» всегда жёсткая проверка, а «клиент раздражён» спокойно отдаётся модели. Любопытно, как такую границу проводят в других командах — особенно там, где решения потом проверяет аудит.
Обучение без отказа от гарантий
Некоторые ответы трудно записать правилом — например, флаг «проверить на мошенничество» или уровень риска. solvi учит их по фактам, которые считает каталог, а не по сырому тексту:
-
system.fit_fast(question, examples)подгоняет гребневую голову в замкнутой форме за миллисекунды. В примере с заказами интернет-магазина 200 примеров обучились за 109 мс (точность 0.973) против 1.2 с у логистической регрессииfit(0.923). -
system.teach(question, state, correct)принимает одно исправление проверяющего поправкой ранга 1. В том же примере медиана — 0.09 мс на исправление; ничего не переобучается, правила и жёсткие проверки не меняются. -
system.learn_ruleвыучивает читаемый список правил. На чеках SROIE регион по распознанному адресу выучился в виде 21 однострочного правила вроде «в адресе есть число, начинающееся с 43 → Selangor». Это дало 89.2% там, где написанное руками правило давало 60.9%.
Обученные части помечены в аудите как learned, с отпечатком. Изменённая голова видна при повторе так же, как изменённая модель.
Цифры
Документы. Для сравнения взята та самая Laya — открытая модель на ModernBERT-large, которая отвечает на типизированные вопросы напрямую. Её дообучили по рецепту авторов на тех же обучающих документах.
|
задача |
solvi |
модель, которая отвечает сама |
|---|---|---|
|
SROIE, чеки, 6 вопросов (361 чек) |
97.8% |
92.6% |
|
SROIE, только 100 обучающих чеков |
95.9% |
80.0% |
|
CORD, чеки, 4 вопроса |
98.5% |
96.0% |
|
CORD, доля ответов при точности ≥ 99% |
99.7% |
14.2% |
|
CUAD, договоры, 5 вопросов (медиана 33 тыс. символов) |
94.8% |
77.5% |
Ошибка [3] калибровки (ECE) — 0.008 / 0.011 / 0.027. На документах каждый ответ опирается на цитату по указанным смещениям, либо система воздерживается.
Оговорки. Один сид на конфигурацию. Метки вопросов SROIE выведены правилами из эталонных полей — это на руку вычисляемым вопросам. На CUAD модель для сравнения видит только первые 1024 токена, а solvi читает договор целиком и там примерно в 10 раз медленнее.
Галерея. Двенадцать задач: разбор обращений, маршрутизация писем, модерация контента, алерты безопасности, аудит действий ИИ-агента, выкатка релиза, KYC/AML, клинический скрининг, отказ в кредите с объяснением, трёхсторонняя сверка в закупках, возвраты за двойное списание и предиктивное обслуживание. Шесть из них прогнали и через Laya без дообучения, с правилами прямо в тексте вопросов: разбор обращений 50/50 против 33/50, маршрутизация писем 18/18 против 11/18, модерация 30/30 против 18/30, алерты безопасности 18/18 против 8/18. Это демонстрация, а не бенчмарк: случаи мы писали вместе с каталогами. Что остаётся верным в любом случае — это устройство: жёсткие правила не перебить, числа считаются, у цитат есть смещения, а при нехватке данных система воздерживается.
Скорость. Решение только на правилах — около 0.4 мс. Стратег планирует каталог из 10 000 частей примерно за 6 мс и исполняет 2.4% из них. На столе страховых выплат с шестью медленными сервисами (по 100–300 мс) полное решение занимает 463 мс против 1 122 мс у скрипта, который считает всё подряд. Если первым выясняется, что полис истёк, — 152 мс.
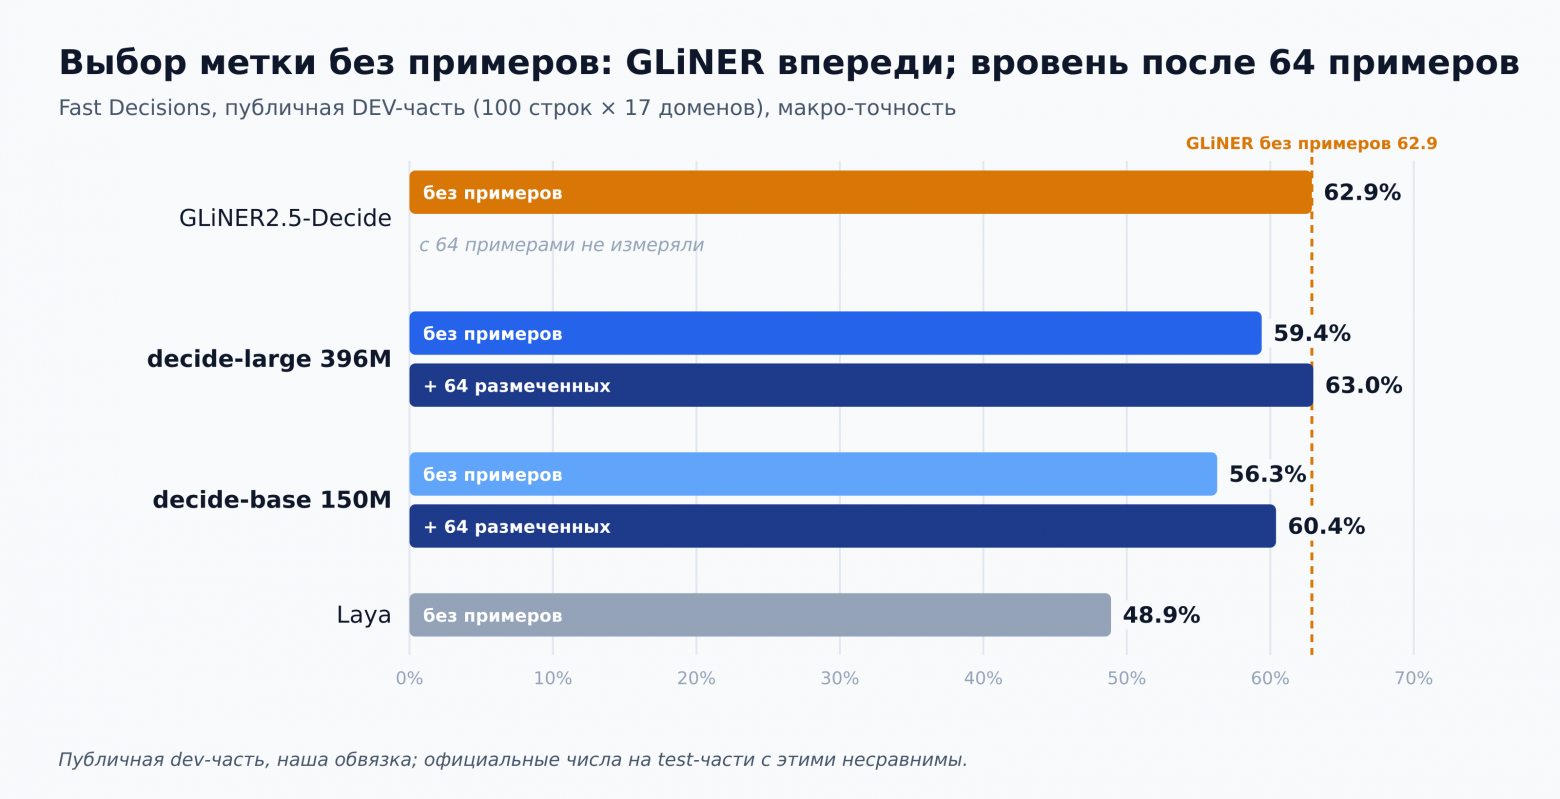
Маленькие модели. solvi-ai/extract-base (ModernBERT-large) находит поле по его описанию; его граф ONNX fp16 работает прямо в браузере. Решатель solvi-ai/decide-large (396M) отвечает на типизированные вопросы по тексту или по состоянию в JSON. На публичной части набора Fast Decisions от Fastino без примеров он даёт 59.4% против 62.9% у GLiNER2.5-Decide (340M) в той же обвязке — то есть на выборе без примеров GLiNER он не обгоняет; с 64 размеченными примерами доходит до 63.0%, вровень. Важно: публичная часть — это dev-часть. Официальная таблица лидеров посчитана на тестовой части, и сравнивать наши числа с ней напрямую нельзя.
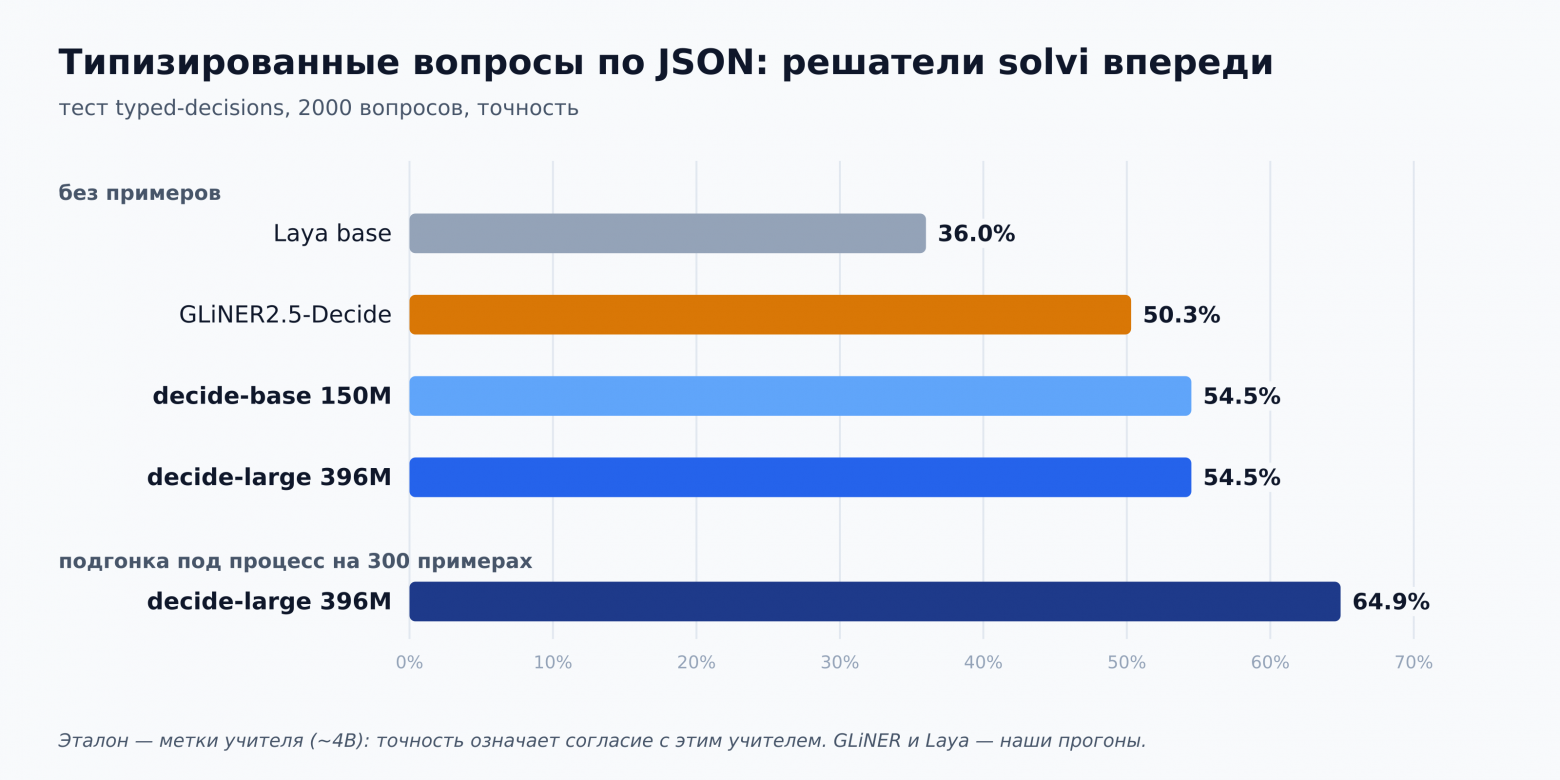
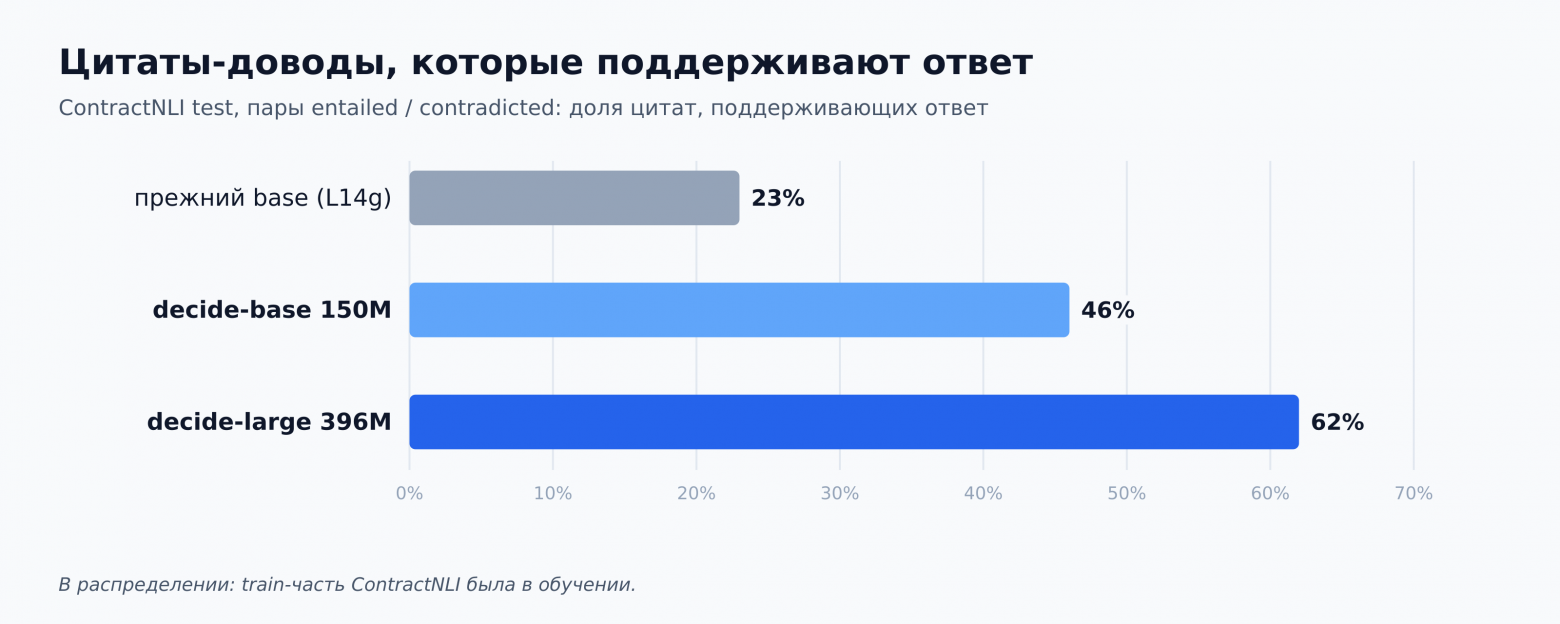
Впереди большая модель decide-large на типизированных вопросах по состояниям в JSON: 54.5% против 50.3% у GLiNER и 36.0% у базовой Laya. Её цитаты-доводы поддерживают ответ в 62% случаев на ContractNLI — но этот тест «в распределении»: его обучающая часть была в обучении [4]. На CPU с ONNX fp16 ей нужно 137 мс на вопрос, так что лучше GPU. Ученик solvi-ai/decide-base (150M) укладывается примерно в 50 мс (Fast Decisions dev 56.3%, типизированные вопросы 54.5%). «Суждения» большой LLM-учительницы нет ни у одной из них — поэтому они и работают за проверками и эскалацией.
Три обучаемых компонента, которые проиграли простому коду
Всё выше — итог длинной серии опытов, в которых критерии успеха записывались до запуска, а результат сообщался как есть; журнал и код — в репозитории [1]. Три отрицательных результата определили, какой получилась 0.5.0:
-
Дешёвые приёмы для решателя — усреднение весов, перестановки вариантов, температура по проверочной выборке, третий этап обучения — сдвинули Fast Decisions не больше чем на ±0.8 пункта, всё в пределах шума. Температура по проверке даже ухудшила калибровку без примеров (ECE 0.233 → 0.326). Потолок задают обучающие данные, а не трюки.
-
Попытка сопоставлять имена функций моделью. Задача — связать функции, которые писали разные команды, каждая со своими именами. На знакомых стилях имён модель строила 82% точных планов, на новых — 11.5%. А проверка типами и пробным исполнением не отвергла ни одного плана, хотя 72% отвеченных планов дали неверный ответ. В библиотеку это вошло только как экспериментальная функция: принятые псевдонимы — лишь подсказка, которую надо просмотреть.
-
Эксперимент с обучаемым стратегом (34.5M параметров) на каталогах до 128 шагов. Он снизил цену плана с 1.48 до 1.07 от оптимума — ровно столько же, сколько список из 10 ключевых слов. Простой код с объявленными ценами находит точный оптимум за 9 мс, модели нужно 420 мс. В релиз вошёл код: он обходит тупики и решает задачу 0/1 по объявленным ценам. Стратег из 0.4 на каталогах из 65–128 шагов с тупиками доходил до цели в 0% случаев, новый кодовый — в 100%. Мемоизация старого стратега ускорила один план из 127 шагов со 130 с до 0.8 мс.
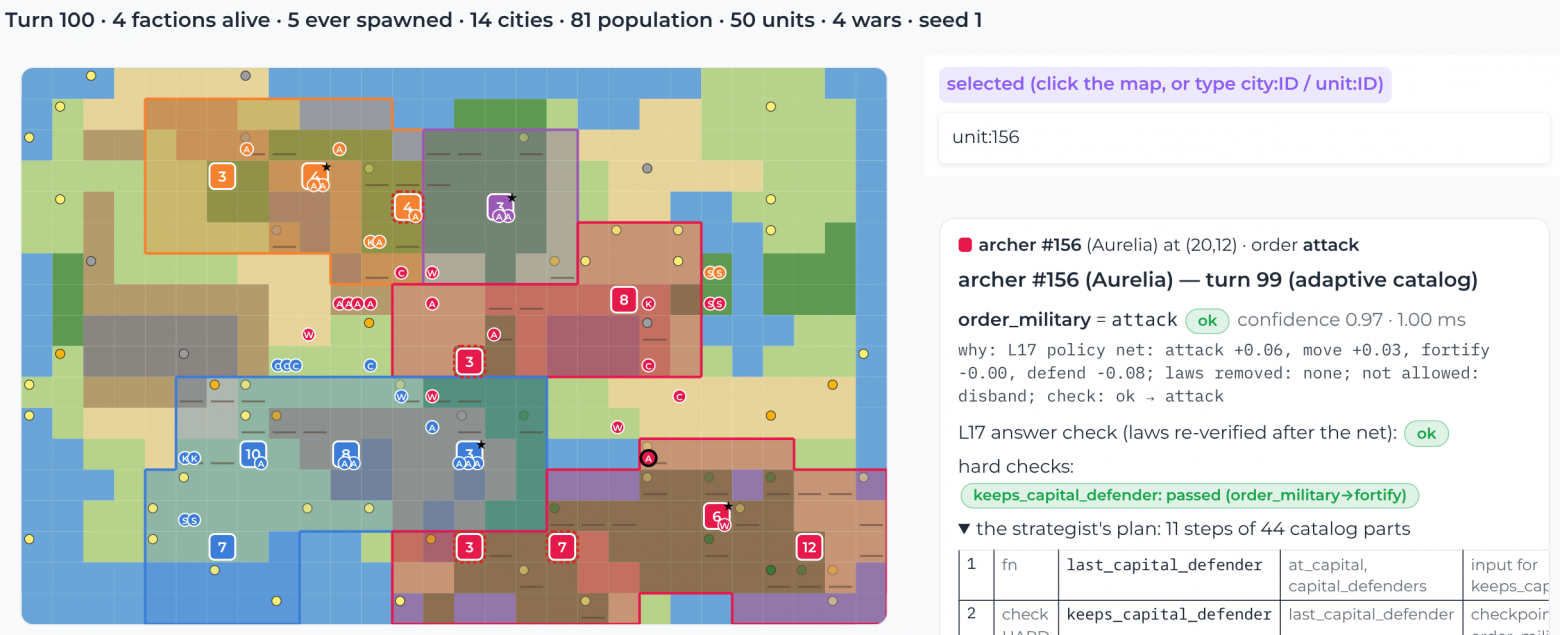
Один обучаемый компонент всё-таки выиграл — там, где у кода готового ответа нет: стратег для пошаговой стратегии в духе 4X. Три маленькие сети (около 23 тыс. весов) выбирают среди ходов, которые разрешили жёсткие «законы», а независимая проверка перепроверяет каждое решение. На 32 новых картах фракция была сильнее среднего соперника на 26 и лидировала на 23; нарушений законов — 0 на 9.4 млн решений, 0.11 мс на решение. Значимо лучше, чем простой просмотр на ход вперёд с проверкой, она не оказалась, а одна из четырёх партий на 20 000 ходов развалилась. Сыграть против неё можно в Space realms [5].
Ограничения
-
Новым полям нужны метки. Найти поле по одному описанию получается плохо: базовый извлекатель даёт 46.5% и 67.9% на двух незнакомых полях чеков и 73.1% на незнакомых видах условий в договорах. С 40 размеченными договорами — 85.5%. Закладывайте 25–100 размеченных документов на задачу.
-
int8 на CPU теряет точность: 11–12 пунктов на суммах, названиях компаний и адресах. fp16 точность сохраняет.
-
Сырая уверенность решателя не калибрована между доменами. Порог «действовать», подобранный на наших данных, не держит свою долю ошибок на новом домене. Подгоните и откалибруйте его на 30–60 размеченных примерах своей задачи (
part.fit,part.calibrate_for(examples, error=0.05)). Порог, который идёт вместе с моделью, на новых настоящих текстах слишком уверен: при пороге «ошибка ≤ 10%» реальная ошибка на трёх наших отложенных наборах была 32–39%. Цитаты-доводы всегда дословные — solvi отвергает всё остальное, — но не всегда именно то условие, которое поддерживает ответ (62% на ContractNLI у decide-large, 46% у decide-base). -
Обучаемый стратег почти не помогает. Выученный порядок жёстких проверок экономил 0–11% времени, оракул — 0–12%. Предел задаёт устройство каталога, а не предсказатель. По умолчанию он выключен.
-
Никакого сгенерированного текста. Только типизированные ответы: да/нет, выбор, шкала, набор меток, «не сказано», фрагменты, ранжирование, оценки чисел.
Что дальше
-
Догнать GLiNER2.5-Decide на выборе без примеров. Большая модель и ученик для CPU вышли, но без примеров всё ещё отстают на 3.5 пункта. Дальше — больший набор для оценки, похожий на Fast Decisions (на нынешнем рецепты не различить), и режим «несколько вопросов за проход», который совпадает с «одним вопросом за проход» на настоящих текстах. Цифры опубликуем в любом случае.
-
Цены из измерений. Стратег уже записывает, сколько длится каждая часть; дальше он будет планировать по измеренным ценам и писать в след, какими пользовался.
-
Цитаты, которые поддерживают ответ, а не просто дословно есть в тексте.
-
Руководства под типовые задачи: разбор обращений, классификация с эскалацией, solvi как инструмент для LLM-агента, модерация и персональные данные — у каждого скрипт и пресет в песочнице.
Попробовать:
-
песочница (работает в браузере, без сервера): https://huggingface.co/spaces/solvi-ai/playground [6]
-
документы (извлекатель в браузере): https://huggingface.co/spaces/solvi-ai/documents [7]
-
аркада («взломай след», объяснимые игровые агенты): https://huggingface.co/spaces/solvi-ai/arcade [8]
-
код: https://github.com/solvi-ai/solvi [1] ·
pip install solvi -
модели: https://huggingface.co/solvi-ai [9]
Вместо заключения
У вас бывало, что модель уверенно ответила там, где ответ должно было дать правило, — и это всплыло только на разборе инцидента? Или наоборот: правила разрослись до сотен if, и хочется отдать часть модели, но страшно?
Мне полезнее всего не список желаемых функций, а конкретный случай. Если есть минута, опишите в комментариях один сценарий из своей работы в таком виде: какое решение принимается, на каких данных, какое правило нельзя нарушать ни при каких условиях и кто потом спрашивает «почему». Самые показательные случаи я попробую собрать в каталог solvi и покажу, где связка «модель + код» справилась, а где нет.
Автор: Exactor
Источник [10]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36134
URLs in this post:
[1] solvi: https://github.com/solvi-ai/solvi
[2] внимание: http://www.braintools.ru/article/7595
[3] Ошибка: http://www.braintools.ru/article/4192
[4] обучении: http://www.braintools.ru/article/5125
[5] realms: https://huggingface.co/spaces/solvi-ai/realms
[6] https://huggingface.co/spaces/solvi-ai/playground: https://huggingface.co/spaces/solvi-ai/playground
[7] https://huggingface.co/spaces/solvi-ai/documents: https://huggingface.co/spaces/solvi-ai/documents
[8] https://huggingface.co/spaces/solvi-ai/arcade: https://huggingface.co/spaces/solvi-ai/arcade
[9] https://huggingface.co/solvi-ai: https://huggingface.co/solvi-ai
[10] Источник: https://habr.com/ru/articles/1087360/?utm_campaign=1087360&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.