WebPageBench: веб-среда для оценки агентов
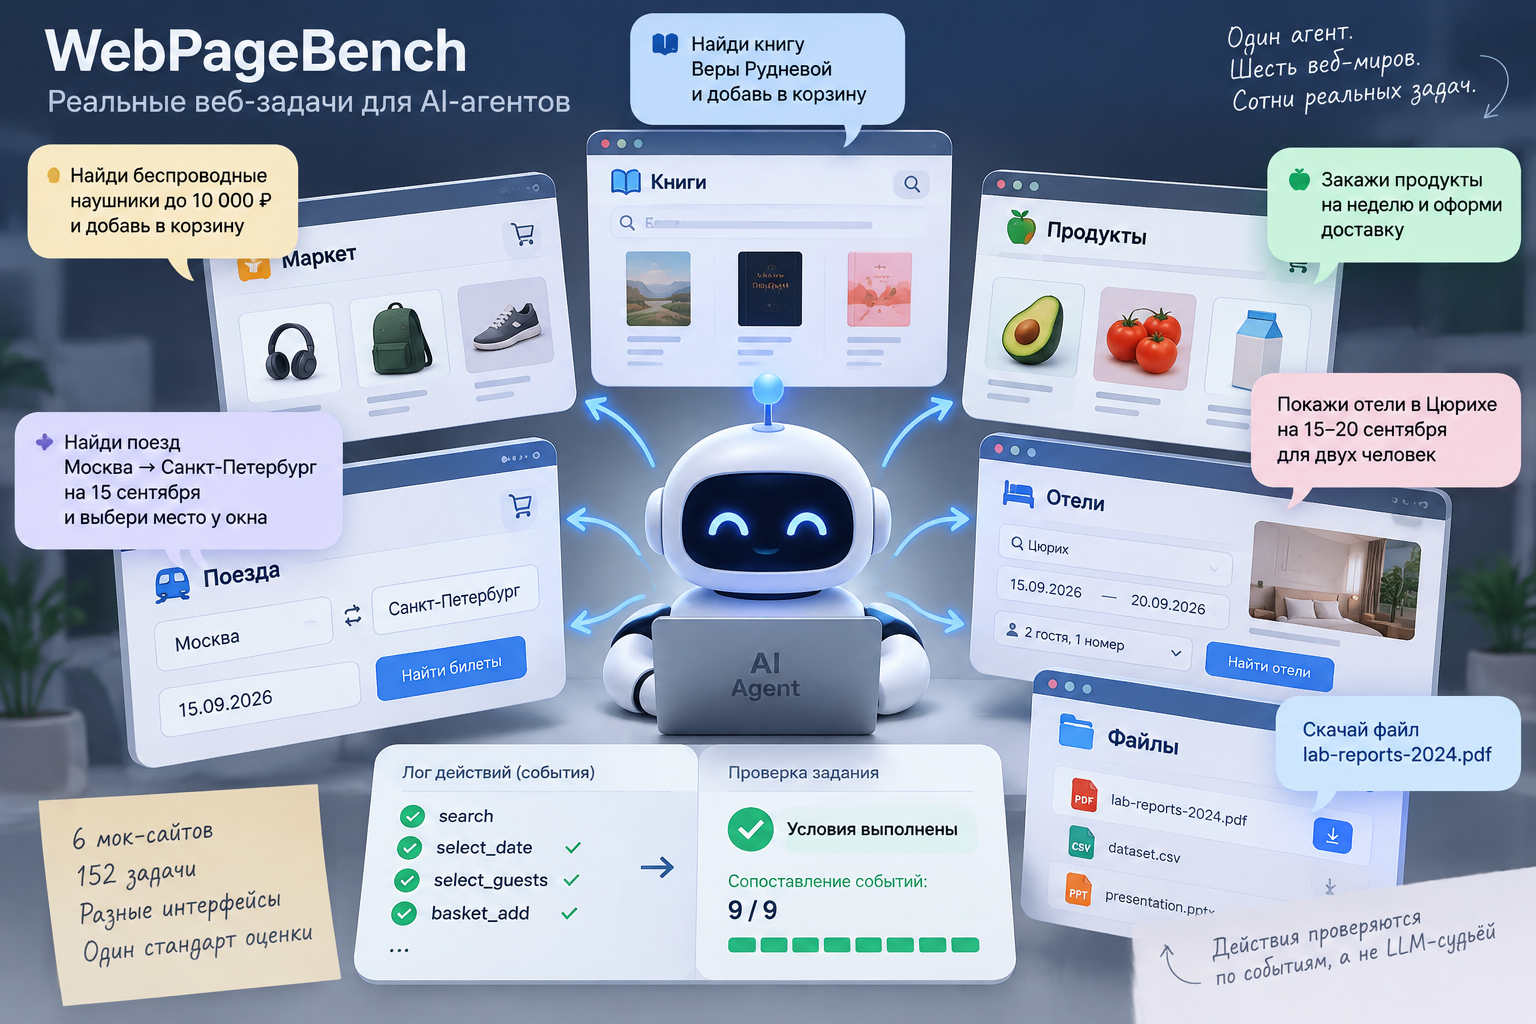
Салют, Хабр! На связи команды AGI NLP & Computer Operator. Мы представляем WebPageBench — открытый веб-бенчмарк из большого набора задач на шести имитациях популярных сайтов (моках), в котором от агента требуется выполнить типовые пользовательские задачи (купить товар, забронировать отель, заказать справку), а его успех проверяется по истории событий (логу). Вместе с бенчмарком мы выпускаем код для запуска локальной среды, в которой любого агента можно прогнать с помощью одной команды, и публичная рейтинговая таблица с оценкой моделей в разных популярных обвязках (harness).
Код и задачи лежат в репозитории [1], рейтинговая таблица — на Hugging Face [2], препринт статьи — на arXiv. [3] Ниже расскажем, зачем мы это сделали, как бенчмарк устроен, что уже видно по результатам и как запустить его у себя.
Зачем ещё один бенчмарк?
Веб-агентов сейчас много, и они устроены по-разному. Одни работают с деревом элементов страницы (DOM) и кликают по ним через обвязку вроде browser-use [4], OpenManus [5] или OpenHands [6], другие смотрят только на скриншот и возвращают координаты клика — так работают UI-TARS, OpenCUA, Fara и похожие модели. Во всех случаях мы сами столкнулись с одним и тем же вопросом: как понять, что агент стал лучше, а не просто увереннее отчитывается?
Проверять агента на настоящих сайтах неудобно по нескольким причинам:
-
Сайты меняются (появляются новые функции, дополняются списки товаров, меняется интерфейс), и вчерашняя задача сегодня решается иначе или не решается вовсе.
-
Защита от ботов срезает часть прогонов ещё до первой страницы.
-
Сценарии с корзиной, бронированием и оплатой на живом сервисе — это настоящие заказы, которые никто не хочет оформлять в цикле по сто раз.
-
И главное, на живом сайте нет способа узнать, что агент на самом деле сделал: приходится либо верить его ответу «готово», либо ставить сверху модель-судью, у которой свои ошибки [7].
Существующие бенчмарки обходят эти сложности по-разному: сравнивают траекторию агента с человеческой, ставят LLM-судью или поднимают копии сайтов у себя и смотрят на состояние в конце эпизода, но ни один из них не отвечает на два вопроса, которые волновали нас больше всего:
-
Агент заявил, что сделал, а сделал ли?
-
Если он провалил задачу, то это потому, что он не понял задание, или потому, что не справился с конкретной реализацией функциональности (например, календаря или выпадающего списка)?
И ещё одно: почти все известные нам бенчмарки построены на англоязычных сайтах, а наши агенты работают с сайтами на русском.
Поэтому мы сделали свой веб-бенчмарк — WebPageBench. Он позволяет безопасно проверять агентов на имитациях сайтах (моках), повторяющих интерфейсы популярных в России сервисов, но в анонимизированном виде: маркетплейсы, книжный магазин, доставка продуктов, ЖД-билеты, отели и файловый кабинет. Моки развёртывают на стороне разработчика, поэтому каждое действие на них записывается в лог как событие с параметрами, и успех проверяют по этому логу — без судьи-модели и без доверия к отчёту агента. По той же причине один и тот же элемент управления можно нарисовать несколькими способами и прогнать одну и ту же задачу через разные реализации календаря или счётчика.
WebPageBench состоит из трёх компонентов:
-
Среда: шесть русскоязычных сайтов-имитаций под одним общим хабом, которые пишут типизированные события обо всём, что на них происходит.
-
Задачи: 152 задания — 65 написанных руками сценариев и 87 их вариаций, где та же задача нарисована через другую реализацию одного элемента управления или в тёмной теме.
-
Запуск и рейтинг моделей: скрипты, которые прогоняют любую из поддерживаемых обвязок или GUI-моделей по всем задачам за одну команду и выгружают результат в публичный рейтинг. Сейчас в нем 24 связки «модель + обвязка».
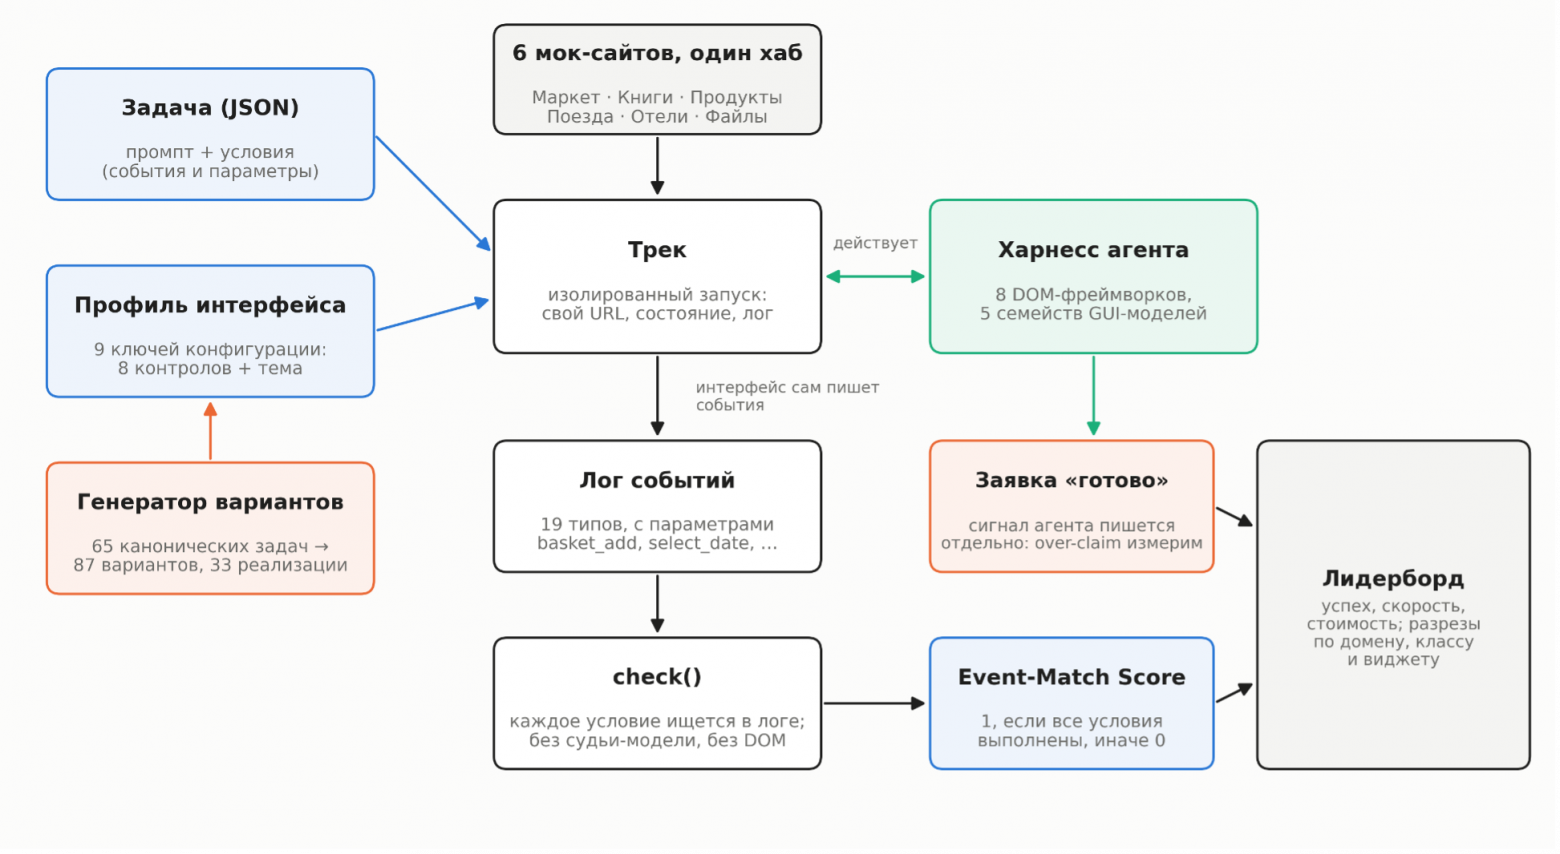
Как устроен один прогон: задача и профиль интерфейса собираются в траекторию, агент действует на сайте-имитации, сайт сам пишет события, а check() сверяет их с условиями задачи. Заявка агента «готово» хранится отдельно от вердикта.
Что мы сделали и как работает бенчмарк
Среда: шесть сайтов-имитаций
Сайты живут под одним нейтральным хабом с шестью вкладками: Маркет (маркетплейс), Книги (книги и аудиокниги), Продукты (доставка), Поезда (ЖД-билеты с выбором места, тарифа и оплатой), Отели (поиск жилья) и Файлы (кабинет с настоящими PDF и CSV на скачивание).
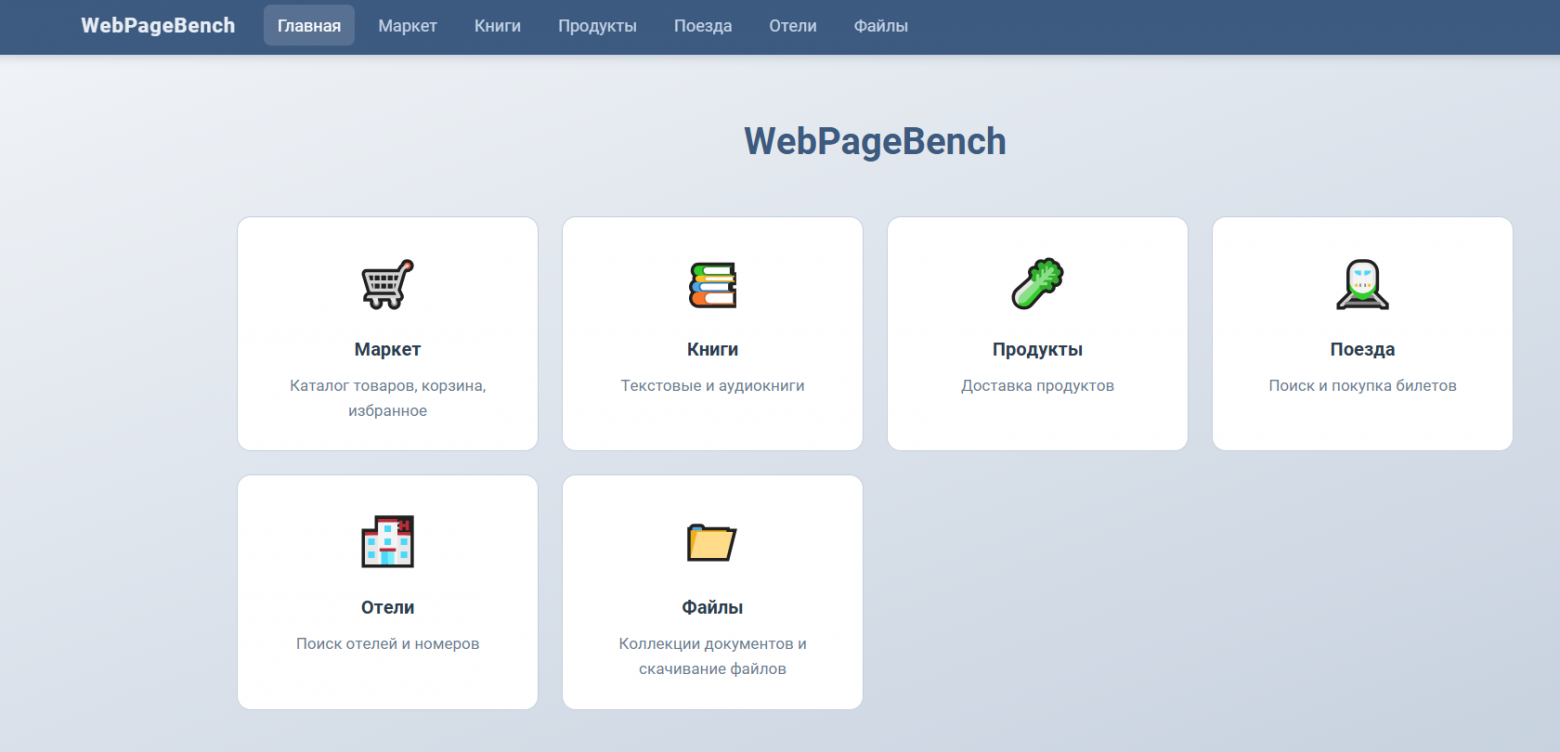
Хаб с шестью вкладками. Логотипов и названий реальных сервисов на сайтах нет, названия маршрутов нейтральные (bench_catalog_main, bench_hotel_search) — ни адрес, ни структура страницы не подсказывают модели, чей это интерфейс.
Сайты сделаны по мотивам реальных сервисов (каких именно, раскрывать не будем), но обезличены. Книжный каталог переписали детерминированным скриптом: 226 товаров, 75 авторов, 229 названий и 86 серий заменены синтетическими русскими именами вместе с падежными формами, чтобы задание «найди книгу Веры Рудневой» оставалось грамотным. В маркете 42 товара, в продуктах — 277. Фотографии карточек в маркете, продуктах и отелях заменили на 590 изображений с открытыми лицензиями (CC BY, CC BY-SA, CC0 и общественное достояние; ничего с NC или ND). Все тексты, задания и данные — на русском языке.
Как проверяется задача: траектория, событие, условие
Каждый запуск задачи — это траектория: изолированный экземпляр сайта со своим адресом, состоянием и журналом. Параллельные прогоны одной задачи друг друга не видят. Всё, что происходит на странице, сайт записывает в траекторию в виде событий: имя плюс словарь параметров. basket_add хранит идентификатор товара и количество, select_tariff — название тарифа, bench_hotel_select_city — идентификатор города, его название и страну. События пишут сами страницы, никто не восстанавливает их из DOM и не угадывает по скриншоту. Семантических типов событий 19, низкоуровневые click, keypress и scroll тоже сохраняются в лог, но условия задач на них не ссылаются.
Условие — это событие, которое должно появиться в логе с нужными параметрами. Вот условие из задачи про отель и событие, которое ему удовлетворяет:
// условие в JSON задачи
{"event_name": "bench_hotel_select_guests",
 "parameters": {"roomsCount": 1, "guestsCount": 2}}

// событие, которое записал сайт
{"type": "bench_hotel_select_guests",
 "roomsCount": 1, "guestsCount": 2,
 "widget": "pill_buttons"}
Правила сверки простые:
-
Каждое условие проверяется независимо по всему логу траектории: оно выполнено, если хоть одно событие с таким именем несёт нужные параметры. Порядок событий не проверяется — задача фиксирует, какие шаги произошли и с какими значениями.
-
Строки сравниваются точно или по маске с
*, для чисел есть операторы сравнения, условия с однимgroupобъединяются по ИЛИ. -
Количества — исключение: для корзины, мест и гостей сверяется последнее событие по товару. Добавил две единицы, потом ещё одну — условие «2» не выполнено.
Основная метрика — Event-Match Score (EMS) — равна 1, если все условия задачи выполнены, иначе 0. Метрика считается для каждой задачи, а потом по набору задач берём среднее. Никакая модель в этой цепочке не участвует, а поскольку проверка читает события, а не текст интерфейса, то она не зависит от языка сайта. Отдельно от EMS записывается Completion — доля задач, в которых агент сам сообщил, что закончил. Когда эти два числа расходятся, видно, насколько отчёту агента можно верить; ниже мы покажем, что расходятся они сильно и не всегда в одну сторону.
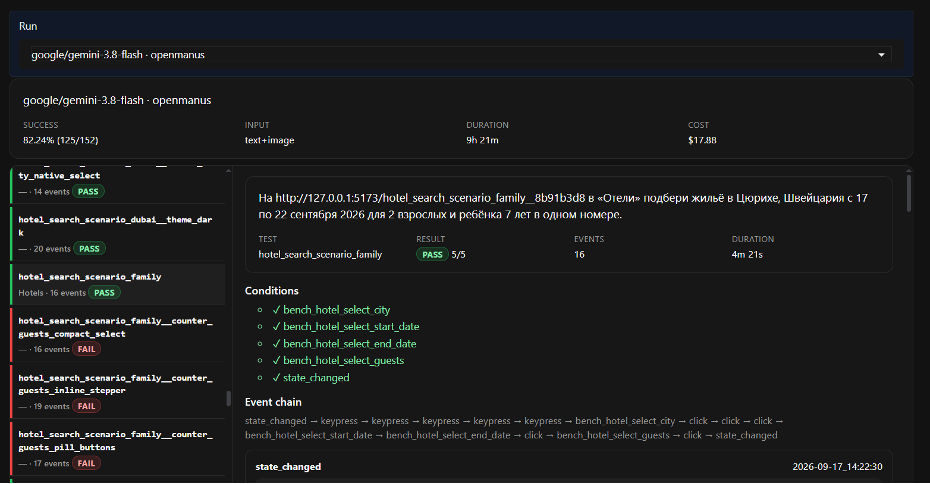
Страница траектории: слева список задач прогона с вердиктами, справа — текст задания, пять условий с отметками и цепочка событий. Здесь связка Gemini-3.8-flash + OpenManus выполнила все пять условий задачи про отель в Цюрихе.
Ещё одна мелочь, которая избавляет от проблем: даты в задачах не протухают. Формы бронирования не дают выбрать прошедшую дату, поэтому набор с зашитыми датами через полгода перестал бы решаться. Перед созданием траектории все даты в условиях сдвигаются вперёд одной общей дельтой, а в тексте задания переписываются во всех написаниях (04.10.2026, «4 октября 2026», диапазоны). Файлы задач при этом не меняются.
Задачи
Все задания — на русском, %HOST% при запуске подставляется адресом траектории. Ниже даны примеры трёх разных задач:
Пример 1. На %HOST% в «Продукты» открой главную, перейди по категориям меню и добавь товар в корзину.
При проверке проверяются два условия: переход в категорию и совершается действие basket_add без параметров для произвольного товара.
Пример 2. На %HOST% в «Отели» покажи варианты: Цюрих, Швейцария, заезд 15.09.2026, выезд 20.09.2026, 2 гостя.
Для задания проверяется пять условий: город, дата заезда, дата выезда, состав гостей и переход на страницу выдачи.
Пример 3. На %HOST% в «Поездах» найди поезд Москва — Санкт-Петербург на 04.10.2026, 1 пассажир, тариф «Эконом», добавь в корзину.
В этом примере проверяется сразу девять условий: два города, дата, поиск, поезд, тариф, место, пассажир, корзина. Агент, который дошёл до корзины с неправильным тарифом, выполнит восемь условий из девяти и получит ноль, а на странице траектории будет видно, какой именно шаг не сошёлся.
Задачи делятся на канонические (написанные вручную) и их вариации — копии канонической задачи с другой реализацией одного элемента управления (о них расскажем в следующем разделе). Ниже представлено распределение задач по сайтам:
|
Сайт |
Что делаем |
Канонических |
Вариантов |
Всего |
|
Маркет |
маркетплейс |
18 |
14 |
32 |
|
Книги |
книги, аудиокниги |
11 |
10 |
21 |
|
Файлы |
файловый кабинет |
11 |
7 |
18 |
|
Поезда |
ЖД-билеты |
9 |
17 |
26 |
|
Продукты |
доставка продуктов |
8 |
2 |
10 |
|
Отели |
поиск отелей |
8 |
37 |
45 |
|
Итого |
|
65 |
87 |
152 |
Таблица 1. Задачи по сайтам. Перекос в сторону отелей объясняется просто: там сходятся три самых вариативных элемента — дата, город и счётчик гостей, — и восемь канонических задач дают 37 вариантов. В продуктах варьировать почти нечего.
У каждой задачи есть классы UI-паттернов (навигация, корзина, дата, счётчик, оплата и так далее), один из них основной. Рейтинг показывает разрезы по основным, какие элементы интерфейса даются агенту хуже всего.
Классы UI-паттернов в наборе и результат лучшей связки по ним
Таблица 2. Классы UI-паттернов. «Основной» — число задач, где класс основной, «Встречается» — где он есть вообще. Последняя колонка — сколько задач с этим основным классом решила лучшая связка из рейтинговой таблицы, Gemini-3.8-flash + OpenManus. Классы, которые основными не бывают, в таблицу не входят.
|
Класс |
Что это |
Основной |
Встречается |
Решено лучшей связкой |
|
BASKET |
добавить / убрать / количество |
66 |
70 |
48 / 66 |
|
COUNTER |
счётчик, число гостей |
33 |
42 |
26 / 33 |
|
FILES |
коллекции, год, скачивание |
18 |
18 |
18 / 18 |
|
FAV |
избранное |
14 |
16 |
14 / 14 |
|
CARD |
карточка в сетке или карусели |
9 |
53 |
9 / 9 |
|
DATE |
дата или диапазон |
4 |
67 |
4 / 4 |
|
PAY |
форма оплаты |
4 |
4 |
2 / 4 |
|
SELECT_AC |
поле с подсказками |
2 |
44 |
2 / 2 |
|
SELECT_LIST |
список с выбором кликом |
2 |
40 |
2 / 2 |
|
NAV |
вкладки хаба, меню, логотип |
0 |
57 |
— |
|
RADIO |
радиокнопки, табы |
0 |
20 |
— |
|
SEARCH |
поиск с подсказками |
0 |
13 |
— |
|
SEAT |
схема мест |
0 |
10 |
— |
Варианты интерфейса: один элемент, несколько реализаций
Агент может провалить задачу, потому что не понял, чего от него хотят, или потому что не справился с конкретным элементом в конкретной реализации интерфейса (например, календарём, который открывается по клику, полем города с подсказками, счётчиком гостей из кнопок и так далее). Большинство веб-бенчмарков эти случаи не различают, в отличие от WebPageBench. Здесь конкретная реализация элемента — это значение в конфигурации траектории. При этом варьироваться могут девять аспектов интерфейса: восемь элементов управления и цветовая тема.
export const UI_VARIANT_IDS = {
  date: ['split_popup', 'inline_calendar', 'text_input', 'single_popup', 'popup_grid', 'native_input'],
  select_city: ['autocomplete', 'native_select'],
  select_station: ['typeahead', 'native_select'],
  counter_guests: ['rooms_popup', 'inline_stepper', 'compact_select', 'pill_buttons'],
  text_search: ['standard', 'outlined', 'filled', 'underlined', 'pill', 'large'],
  collections: ['cards', 'list', 'tree', 'compact'],
  years: ['select', 'buttons', 'radio'],
  buttons: ['solid', 'outline', 'icon', 'split'],
  theme: ['light', 'dark'],
};
Итого 33 реализации. Какая бы ни была реализована в конкретной траектории, событие остаётся одно и то же, и условие задачи остаётся верным. Вариант — это копия канонической задачи с побайтово тем же текстом и условиями, где отличается только реализация элемента и всё, что она тянет за собой: структура DOM, количество действий, координаты на скриншоте. Сегодня в релизе WebPageBench 87 вариантов от 25 канонических задач; 82 из них меняют ровно один ключ (12 — только тему), ещё 5 меняют три элемента файлового кабинета сразу, потому что те живут на одном экране.
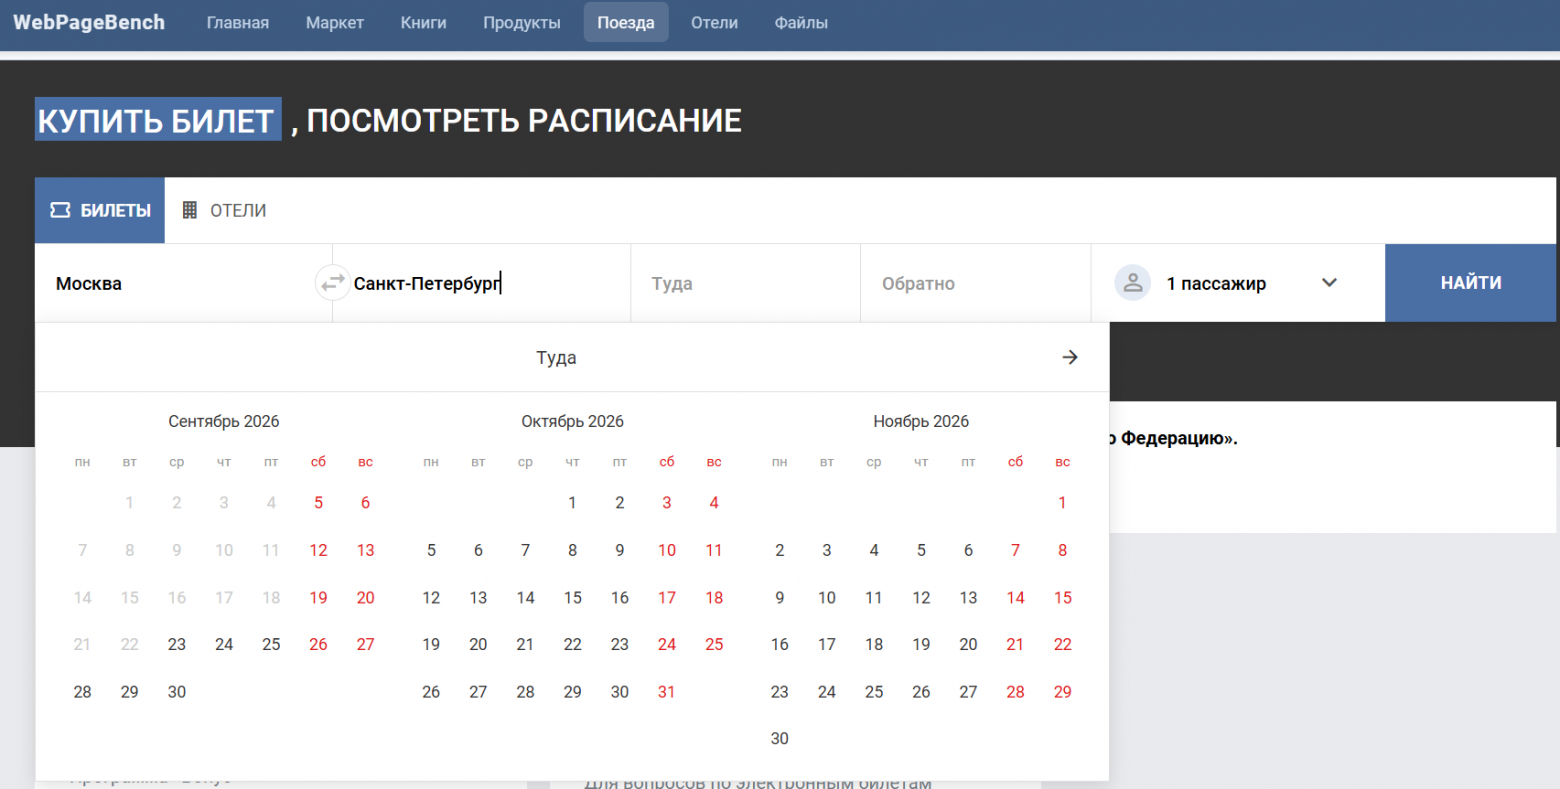
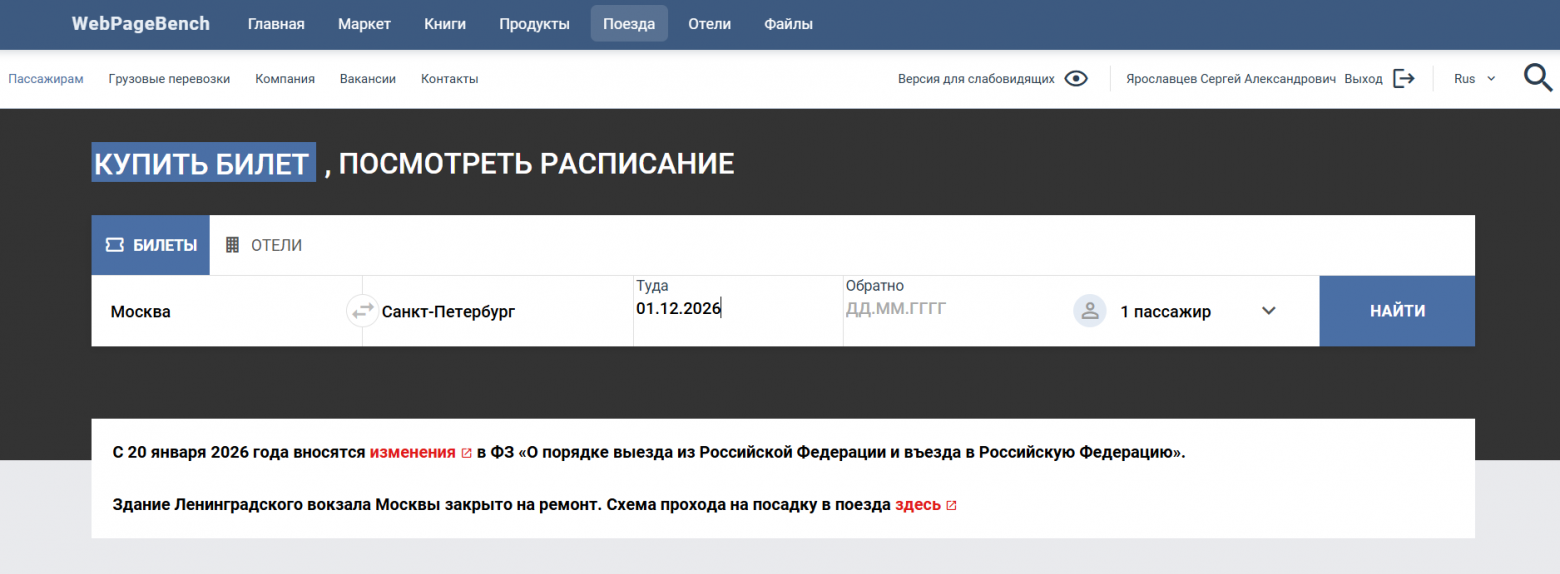
Одна и та же задача про билет Москва — Санкт-Петербург в двух реализациях даты. Слева календарь-сетка, реализация по умолчанию для сайта поездов; справа профиль rail_date_native — нативное поле <input type="date">, в которое агенту нужно ввести «4 октября 2026» в формате, который ожидает поле. Текст задания и условия не изменились ни на байт.
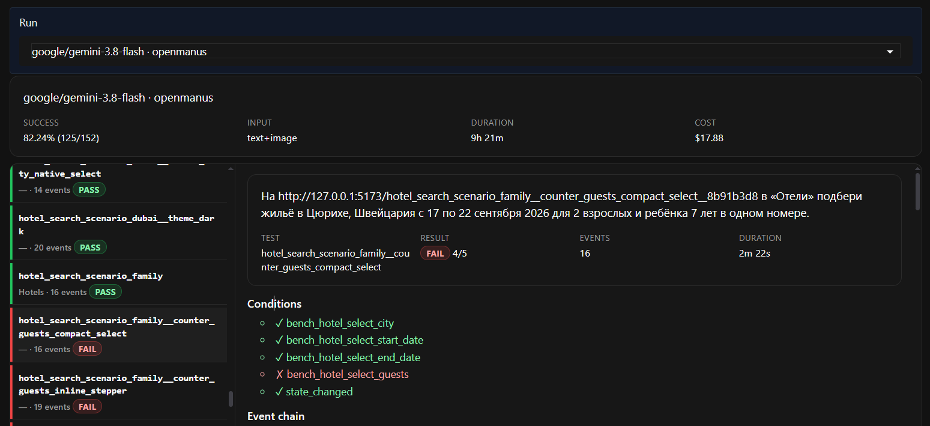
Как это выглядит на странице траектории. Каноническую задачу про отель для семьи с ребёнком связка Gemini-3.8-flash + OpenManus решила, а её вариант со счётчиком гостей в виде компактного выпадающего списка — нет: четыре условия из пяти сошлись, bench_hotel_select_guests не записалось.
Примеры вариантов: одна каноническая задача на сайт
Таблица 3. Одна каноническая задача на сайт и её варианты. Текст и условия каждого варианта совпадают с исходными; меняется только названный элемент.
|
Задача |
Текст и реализации по умолчанию |
Варианты в релизе |
|
Отели
|
«В „Отели“ покажи варианты: Цюрих, Швейцария, заезд 15.09.2026, выезд 20.09.2026, 2 гостя». По умолчанию: раздельный всплывающий календарь, город с подсказками, гости во всплывающем окне по комнатам. |
|
|
Поезда
|
«В „Поездах“ найди поезд Москва — Санкт-Петербург на 04.10.2026, 1 пассажир, тариф „Эконом“, добавь в корзину». По умолчанию: календарь-сетка, станция с подсказками. |
|
|
Книги
|
«В „Книги“ найди „Тихий янтарь в последнем вагоне“ Веры Рудневой (текст) и добавь в корзину». По умолчанию: стандартное поле поиска. Автор и название синтетические. |
|
|
Файлы
|
«В разделе „Файлы“ открой „Отчёты лаборатории“, выбери 2024 год и скачай lab-reports-2024.pdf». По умолчанию: карточки, год в |
Один профиль на три ключа сразу: |
Результаты
В публичном лидерборде WebPageBench сейчас 24 связки «модель + обвязка», каждая прогнана по всем 152 задачам одним запуском с настройками обвязки по умолчанию. Для каждой связки в таблице показаны EMS, Completion, среднее число шагов и время на задачу и стоимость прогона; для моделей, которые крутились локально, стоимости нет. Добавили ещё одну колонку — «Сделано и подтверждено»: доля задач, на которых агент сам сообщил «готово» и при этом лог подтвердил все условия. Она посчитана по логам прогонов так же, как на лидерборде, и показывает, насколько собственный отчёт агента совпадает с проверкой. Связки сгруппированы по модели; там, где у модели несколько обвязок, выделены лучший EMS, наименьшее время и наименьшая стоимость внутри группы.
Таблица 4. Публичный лидерборд, 24 связки, группировка по модели. Модели упорядочены по лучшему EMS, внутри модели — по EMS. Там, где у модели несколько обвязок, выделены лучший EMS, наименьшее время и наименьшая стоимость в группе; у моделей с одной обвязкой выделения нет. «Сделано и подтверждено» — доля задач, которые агент объявил выполненными и у которых сошлись все условия, посчитана по логам прогонов. Шаги и время — средние на задачу, стоимость — за весь прогон; прочерк — модель работала локально.
|
Модель |
Обвязка |
EMS |
Completion |
Сделано и подтверждено |
Шаги |
Время, с |
Стоимость, $ |
|
Gemini-3.8-flash |
OpenManus |
0,822 |
1,000 |
0,822 |
7,8 |
221 |
17,88 |
|
|
Browser-use |
0,711 |
0,993 |
0,711 |
9,5 |
220 |
23,65 |
|
|
OpenHands |
0,572 |
0,461 |
0,454 |
131,7 |
132 |
53,12 |
|
Gpt-5.6-luna |
Ouroboros-full-isolated |
0,796 |
0,868 |
0,796 |
27,8 |
177 |
6,69 |
|
|
Browser-use |
0,704 |
0,993 |
0,704 |
10,8 |
356 |
3,23 |
|
|
Ouroboros-full-evolving |
0,697 |
0,717 |
0,678 |
13,1 |
297 |
3,91 |
|
|
OpenHands |
0,625 |
0,638 |
0,605 |
18,1 |
158 |
23,19 |
|
|
OpenManus |
0,592 |
1,000 |
0,592 |
10,8 |
296 |
3,04 |
|
Deepseek-v4.1-flash |
Browser-use |
0,789 |
0,993 |
0,783 |
14,2 |
467 |
8,28 |
|
|
OpenManus |
0,711 |
0,974 |
0,704 |
14,7 |
472 |
9,03 |
|
|
OpenHands |
0,454 |
0,342 |
0,336 |
23,5 |
148 |
39,66 |
|
Qwen3.8-27b |
OpenManus |
0,763 |
1,000 |
0,763 |
9,9 |
84 |
— |
|
|
Ouroboros-cut |
0,750 |
1,000 |
0,750 |
10,4 |
83 |
— |
|
|
Browser-use |
0,737 |
1,000 |
0,737 |
10,8 |
91 |
— |
|
|
Qwen3-vl (по скриншоту) |
0,480 |
0,493 |
0,375 |
17,0 |
74 |
— |
|
Fara-1.5-9b |
Fara |
0,638 |
0,572 |
0,493 |
16,4 |
44 |
— |
|
Fara-1.5-27b |
Fara |
0,625 |
0,625 |
0,553 |
16,5 |
72 |
— |
|
Glm-5.2 |
OpenHands |
0,500 |
0,428 |
0,408 |
22,7 |
90 |
76,08 |
|
OpenCUA-72b |
OpenCUA |
0,421 |
0,724 |
0,421 |
13,2 |
437 |
— |
|
Minimax-m2.7 |
OpenHands |
0,368 |
0,257 |
0,230 |
21,5 |
103 |
24,96 |
|
OpenCUA-32b |
OpenCUA |
0,336 |
0,559 |
0,336 |
15,3 |
271 |
— |
|
Uitars-1.5-7b |
Uitars |
0,336 |
0,382 |
0,289 |
19,1 |
42 |
— |
|
EvoCUA-32b-s1 |
EvoCUA |
0,092 |
0,112 |
0,079 |
23,5 |
259 |
— |
|
EvoCUA-32b-s2 |
EvoCUA |
0,079 |
0,191 |
0,072 |
22,5 |
143 |
— |
Какие выводы можно сделать из результатов:
-
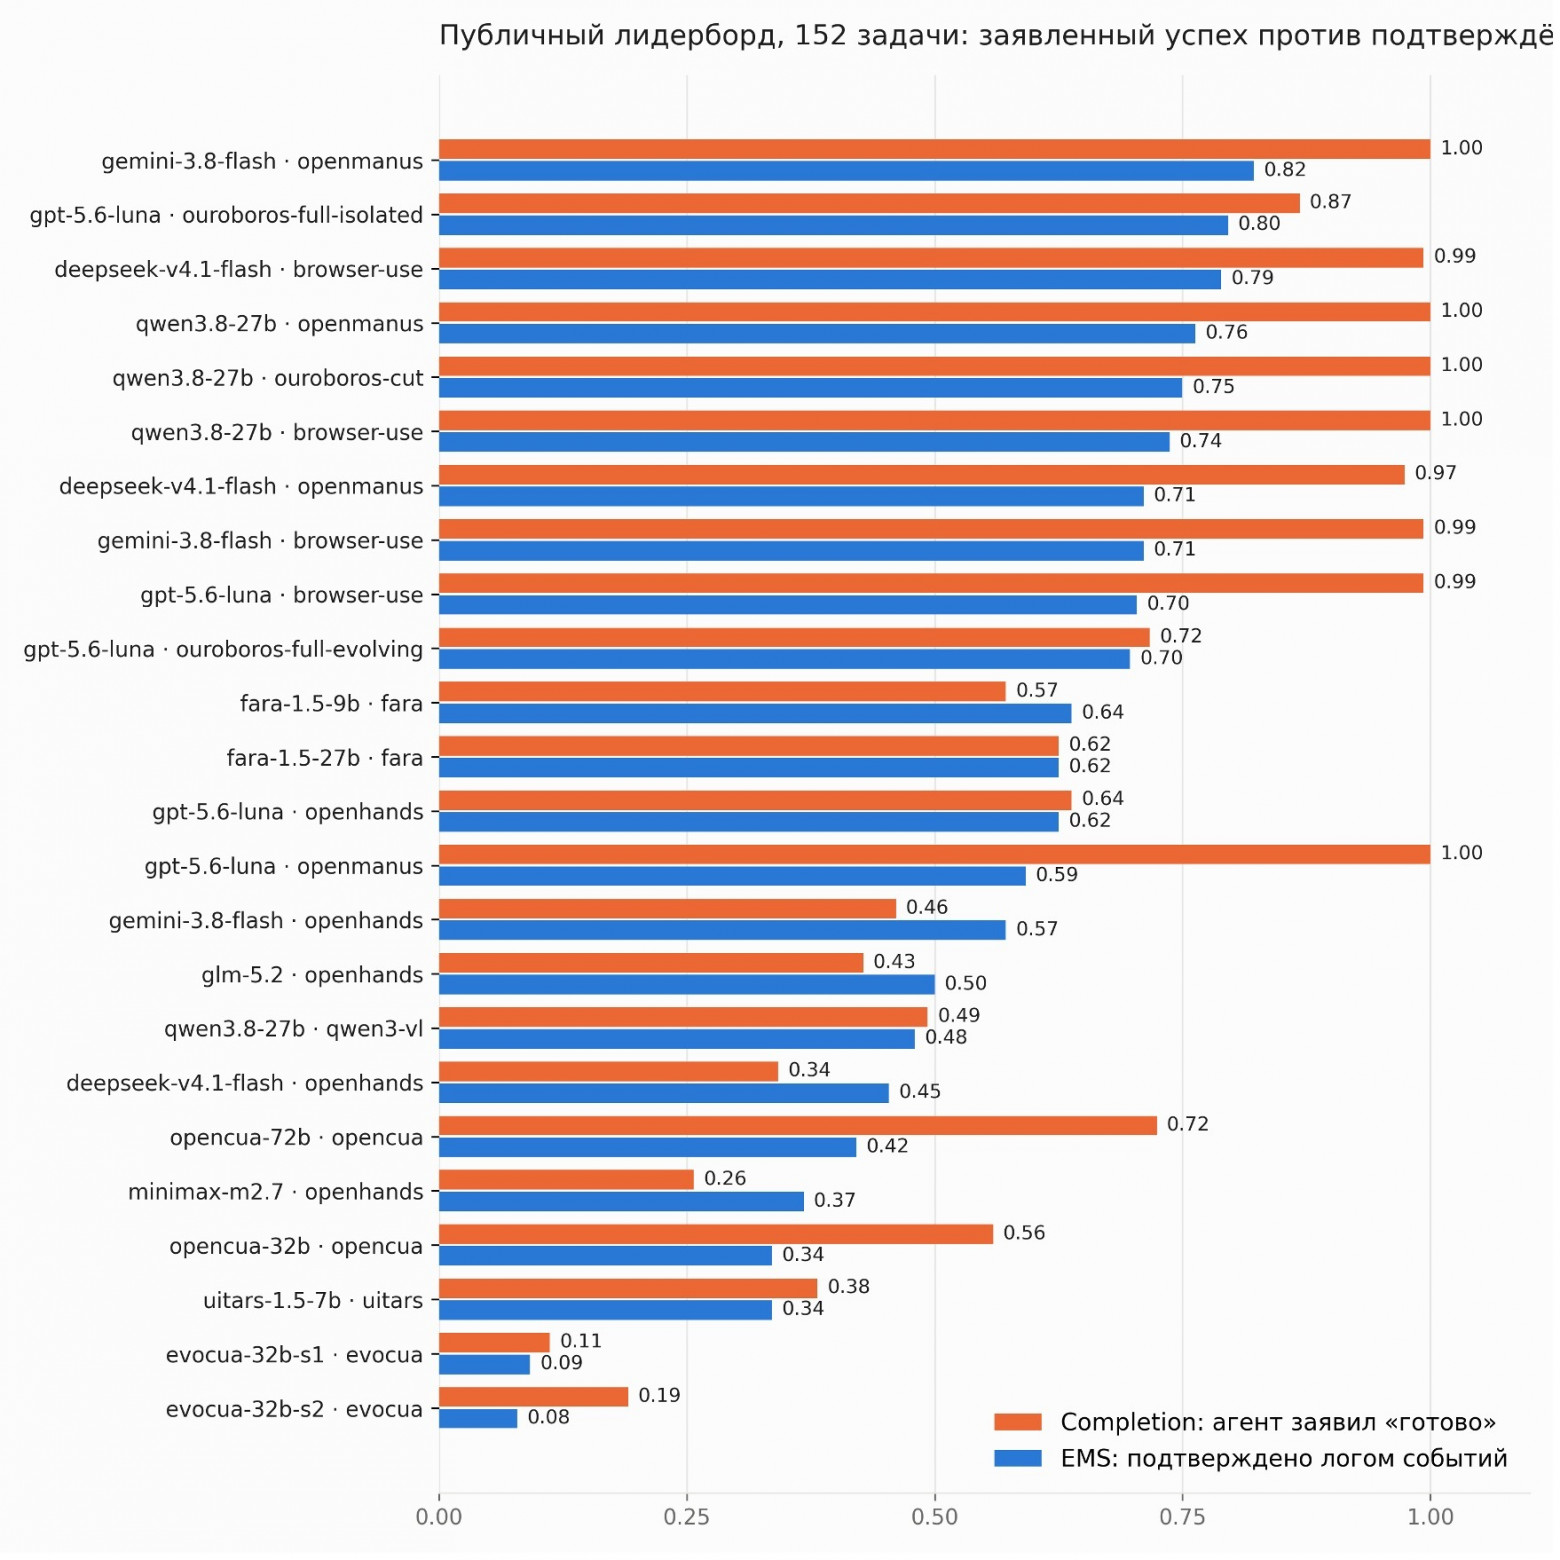
Агенты завышают свои результаты, и размер завышения зависит от обвязки. Gpt-5.6-luna с OpenManus отчиталась о выполнении всех задач до единой, а лог подтвердил 59 % — разрыв в 41 пункт; «сделано и подтверждено» у этой связки ровно 0,592, то есть все её настоящие успехи спрятаны среди ста процентов заявленных. Та же модель с OpenHands почти честна: 0,638 против 0,625. Есть и обратный случай: Gemini-3.8-flash с OpenHands решила больше, чем сама о себе доложила (0,572 против 0,461), и «сделано и подтверждено» у неё 0,454 — 18 задач из 152 агент довёл до конца, но сигнала «готово» так и не дал. Так что оценивать агента по его же сигналу «готово» нельзя, и в какую сторону он ошибётся — заранее неизвестно.
-
Лучшая обвязка зависит от модели. Для Gemini-3.8-flash лучший результат даёт OpenManus (0,822), для Gpt-5.6-luna — Ouroboros-full-isolated (0,796), для Deepseek-v4.1-flash — обычный Browser-use (0,789). Обвязка, которая подняла одну модель, может уронить другую: OpenManus для Gpt-5.6-luna — худший из пяти вариантов.
-
Открытая 27B-модель почти догнала лидеров. Qwen3.8-27b с OpenManus даёт 0,763 — на шесть пунктов ниже лучшего результата, и это на модели, которая крутится локально на своём железе.
-
Агенты, использующие скриншоты, пока заметно отстают от агентов, работающих с DOM. Лучшая GUI-модель, Fara-1.5-9B, даёт 0,638; OpenCUA-72B — 0,421, UI-TARS-1.5-7B — 0,336, EvoCUA — меньше 0,10. Показательно и сравнение внутри одной модели: Qwen3.8-27b по DOM решает 0,737–0,763, а по скриншотам — 0,480.
-
У агентов по скриншотам расходятся не только Completion и EMS, но и сами успехи с отчётом о них. У DOM-обвязок «сделано и подтверждено» почти совпадает с EMS: у OpenManus и Browser-use разница не больше одного пункта, то есть если задача решена, агент об этом и сообщил. У GUI-моделей картина другая: Fara-1.5-9B решила 0,638, но объявила выполненными и решила одновременно только 0,493; Qwen3.8-27b по скриншотам — 0,480 против 0,375; Fara-1.5-27B — 0,625 против 0,553. От каждой девятой до каждой четвёртой решённой задачи у таких моделей завершается без сигнала «готово»: агент делает нужные действия, но не понимает, что уже закончил.
-
Дорого не значит хорошо. Самый дорогой прогон в таблице — Glm-5.2 с OpenHands за $76 — даёт EMS 0,500, а Gpt-5.6-luna с Browser-use укладывается в $3,23 при 0,704. Внутри одной модели связь тоже не в пользу цены: у Gpt-5.6-luna самая дешёвая обвязка (OpenManus, $3,04) одновременно худшая по EMS, а самая дорогая (OpenHands, $23,19) — четвёртая из пяти. OpenHands вообще самая дорогая обвязка: на Gemini-3.8-flash она сделала в среднем 132 шага на задачу — при этом по времени на задачу она у всех трёх моделей самая быстрая, потому что шаги короткие.
-
Что даётся хуже всего. Лучшая связка полностью решает файлы, избранное, карточки и даты, но не решает 18 из 66 задач с корзиной, 7 из 33 со счётчиками и половину задач с оплатой. Задачи корзины с несколькими товарами, ограничением по цене и точным количеством она закрывает: магазин в этом классе — 27 из 28, книги и продукты целиком. Семнадцать провалов из восемнадцати — все траектории «билет в корзину» на поездах, в каждом варианте даты и выбора станции. Агент доходит до экрана «Укажите данные пассажиров», видит промежуточную надпись «добавлена в корзину» и завершает задачу: пассажир не выбран, кнопка «Оформить заказ» неактивна, билет в корзину не попадает. Оставшийся провал — базовая траектория именованного смартфона: кнопка добавления не нашлась, клик пришёлся на шапку «Корзина», и на 24-м шаге из 25 агент остановился.
Все прогоны для лидерборда сделаны на вычислительных мощностях cloud.ru [8]. Больше разрезов — по сайтам, по классам UI-паттернов, по скорости и цене — есть на HuggingFace [2].
Как пользоваться бенчмарком?
Запуск
Бенчмарк запускается полностью локально: бэкенд с хранилищем событий, собранный фронтенд и контейнер оценки. Код предусматривает как Docker-композицию, так и скрипты для запуска без Docker. Прогон — одна команда; обвязка и модель задаются одним аргументом, готовые связки лежат в envs/runs/<обвязка>/<модель>.env, ключи к API — в .env.
git clone https://github.com/ai-forever/WebPageBench && cd WebPageBench
cp .env.eval.example .env      	# ключи к API моделей
./scripts/start_dab_preview.sh 	# бэкенд + фронтенд, в отдельном терминале

# DOM-обвязка + модель через OpenRouter, все 152 задачи
./scripts/run_eval.sh browser-use/deepseek-v4.1-flash

# быстрая проверка: три задачи или задачи по маске имени
EVAL_MAX_TASKS=3 ./scripts/run_eval.sh browser-use/gemini-3.8-flash
EVAL_TASK_FILTER=hotel_search ./scripts/run_eval.sh openmanus/gemini-3.8-flash

# модель по скриншотам: поднять через vLLM и прогнать
python -m bench_eval.agents.cli.serve qwen3-vl-8b --port 8000
./scripts/run_eval.sh qwen3-vl/qwen3-vl-8b

# выгрузить результаты в формат лидерборда
./scripts/export_leaderboard.sh
Скрипт создаёт траекторию под каждую задачу, отдаёт агенту адрес, ждёт, пока агент остановится, и вызывает check(). Задачи идут параллельно в несколько процессов, один бэкенд обслуживает всех. И так как работа любого агента в реальных задачах должна быть конечна, то у каждой задачи есть общий лимит времени. Если агент не уложился в него, то он получает 0.
Все обвязки и GUI-модели подключаются одним переключателем AGENT_HARNESS. Из коробки поддерживаются:
|
Обвязка |
Что видит агент |
Что это |
|
Browser-use |
DOM + скриншот |
browser-use [4], базовый исполнитель |
|
OpenManus |
DOM + скриншот |
промпты OpenManus [5] на исполнителе Browser-use |
|
OpenHands |
текст DOM |
OpenHands [6] SDK с его браузерными инструментами; один процесс |
|
Ouroboros-cut |
DOM + скриншот |
промпты Ouroboros [9] на исполнителе Browser-use |
|
Ouroboros-full-isolated |
текст + скриншот |
полный агент Ouroboros, память [10] с нуля на каждую задачу |
|
Ouroboros-full-evolving |
текст + скриншот |
Ouroboros с общей памятью между задачами; один процесс |
|
Hermes-Ouroboros |
DOM |
планировщик Hermes Agent [11], исполнитель Browser-use; в таблице пока нет |
|
Qwen3-vl |
скриншот |
семейство Qwen3-VL [12] |
|
Uitars |
скриншот |
UI-TARS [13] |
|
OpenCUA |
скриншот |
OpenCUA [14] |
|
EvoCUA |
скриншот |
EvoCUA |
|
Fara |
скриншот |
Fara [15] |
Таблица 5. Обвязки и семейства GUI-моделей, которые умеет запускать бенчмарк. «DOM» — дерево элементов, по которому агент действует через ссылки на элементы; «текст» — извлечённый текст страницы без дерева; скриншот, если указан, отправляется дополнительно. Модели по скриншотам возвращают координаты, клики за них делает наш драйвер на Playwright. Связки с DeepSeek получают только текст DOM, без скриншотов.
Своя обвязка подключается одним адаптером: нужно уметь открыть адрес траектории, поработать и остановиться; остальное — траектория, события, проверка — делает стенд.
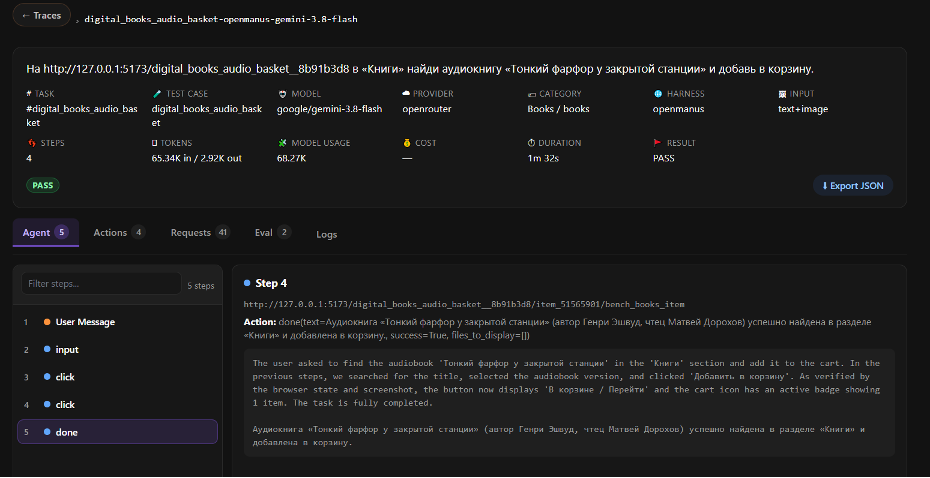
Страница прогона одной задачи: шаги агента, действия, запросы к модели, токены и время. Здесь видно, на каком шаге агент сказал «готово» и что он при этом написал.
Добавление задачи и размножение сценариев
Новая задача — один JSON-файл в tests/bench/tasks/: с какого сайта и состояния начинаем, текст задания и список условий. Вот задача про продукты целиком, без служебных полей:
{
  "test_data": {
	"bench_first_domain": "grocery",
    "bench_first_state": "state_grocery_main",
	"task": "На %HOST% в «Продукты» открой главную, перейди по категориям меню и добавь товар в корзину.",
	"conditions": [
      {"event_name": "state_changed", "parameters": {"new_state": "bench_grocery_category"}},
      {"event_name": "basket_add", "parameters": {}}
	],
    "ui_taxonomy": {"primary": "BASKET", "classes": ["NAV", "BASKET"]}
  }
}
Чтобы понять, какие события пишет нужный экран и с какими параметрами, проще всего пройти сценарий руками на локальном стенде и открыть страницу траектории: там будет вся цепочка событий с параметрами, из которой условия переписываются один в один.
Размножать сценарии по реализациям элементов руками не нужно. Варианты не пишутся, а генерируются: в scripts/ui_pattern_task_map.py [16] перечислено, какие канонические задачи под какие профили клонировать, а scripts/build_bench_tasks.py [17] собирает из этого файлы вариантов. Чтобы прогнать новые задачи про отели через все реализации календаря и счётчика, достаточно добавить их имена в один кортеж:
# scripts/ui_pattern_task_map.py
HOTEL_SEARCH_STEMS = (
    "hotel_search_scenario",
    "hotel_search_scenario_dubai",
    "hotel_search_scenario_family",
	"my_new_hotel_task",      	# ← новая каноническая задача
)
# ... и она получит все профили отелей:
# date → inline_calendar / text_input / single_popup,
# select_city → native_select,
# counter_guests → inline_stepper / compact_select / pill_buttons

python3 scripts/build_bench_tasks.py 	# пересобрать tests/bench/tasks/
pytest tests/bench/test_verify_bench.py  # проверить структуру всех задач
Сгенерированный вариант отличается от исходной задачи только блоком ui_variants с профилем, например {"date": "inline_calendar"}; текст и условия копируются как есть. Новая реализация элемента — это одно значение ключа в UI_VARIANT_IDS и компонент на фронтенде, после чего под неё можно клонировать все задачи сайта. Новый сайт — набор страниц, файл каталога и вызовы, которые пишут события; статическая проверка test_verify_bench прогоняет структуру, маршруты и профили всех файлов задач.
Вместо послесловия
Если вы делаете веб-агента, то обязательно присылайте свои результаты на WebPageBench: бенчмарк уже умеет запускать широкий набор DOM-обвязок и пять семейств GUI-моделей, а подключить свою — это один адаптер. Мы будем рады новым задачам и реализациям элементов в репозитории, а ещё — прогонам, в которых канонические задачи и варианты оцениваются раздельно: пока в рейтинговой таблице их результаты не разделены, и чувствительность агентов к реализации элемента мы измерить не можем.
-
Код, задачи и инструкция по запуску: github.com/ai-forever/WebPageBench [1]
-
Рейтинговая таблица: huggingface.co/spaces/ai-forever/WebPageBench [2]
-
Препринт с подробностями про контракт событий, генератор вариантов и сравнение с другими бенчмарками: [TODO: ссылка]
-
Лицензия: код — Apache 2.0; изображения каталогов сохраняют лицензии источников (CC BY, CC BY-SA, CC0, общественное достояние)
Благодарности
Спасибо коллегам, которые участвовали в разработке бенчмарка: Антону Емельянову, Завену Мартиросяну, Алёне Феногеновой, Сергею Аверкиеву, Марии Глушковой, Дмитрию Балиеву, Анастасии Филоновой, Александру Мазурину, Элине Басыровой, Анне Костиковой. Вычислительные ресурсы для прогонов лидерборда предоставил cloud.ru [8].
Автор: mashkka_t
Источник [18]
Сайт-источник BrainTools: https://www.braintools.ru
Путь до страницы источника: https://www.braintools.ru/article/36202
URLs in this post:
[1] репозитории: https://github.com/ai-forever/WebPageBench
[2] Hugging Face: https://huggingface.co/spaces/ai-forever/WebPageBench
[3] arXiv.: http://arxiv.org/abs/2609.35026
[4] browser-use: https://github.com/browser-use/browser-use
[5] OpenManus: https://github.com/FoundationAgents/OpenManus
[6] OpenHands: https://github.com/All-Hands-AI/OpenHands
[7] ошибки: http://www.braintools.ru/article/4192
[8] cloud.ru: http://cloud.ru
[9] Ouroboros: https://github.com/razzant/ouroboros
[10] память: http://www.braintools.ru/article/4140
[11] Hermes Agent: https://github.com/NousResearch/hermes-agent
[12] Qwen3-VL: https://github.com/QwenLM/Qwen3-VL
[13] UI-TARS: https://github.com/bytedance/UI-TARS
[14] OpenCUA: https://github.com/xlang-ai/OpenCUA
[15] Fara: https://github.com/microsoft/fara
[16] map.py: http://map.py
[17] tasks.py: http://tasks.py
[18] Источник: https://habr.com/ru/companies/sberbank/articles/1087532/?utm_campaign=1087532&utm_source=habrahabr&utm_medium=rss
Нажмите здесь для печати.